爬虫 Etsy是指从 Etsy 的公开页面采集商品、店铺和评论数据。Etsy 在 2025 年年度报告中披露,其平台拥有超过 1 亿件商品和 560 万活跃卖家。Etsy 使用 DataDome。直接发送请求会返回 403 和拦截页面。通常首先尝试的两个修复方法是使用 Chrome User-Agent 和 TLS 模拟,但两者仍会收到 403。本指南将说明哪些改变会影响 403、robots.txt 会阻止什么,以及哪些提取问题会在不报错的情况下破坏 Etsy 数据集。
简要总结
- Etsy 在 Fastly 后方运行 DataDome。DataDome 会在自己的响应标头中写入风险评分。你甚至可以在编写爬虫之前对请求进行评级。
- Etsy 拒绝了我们尝试的全部 9 种传输方式。有头浏览器在 2.2 秒内加载了第一个页面,但 Etsy 拒绝了第二个请求。
- robots.txt 禁止关键词搜索和已售商品历史,并声明没有站点地图。其中仍允许访问商品页面和店铺页面,但 Etsy 的条款更加严格。
- 货币和价格取决于出口 IP。我们的数据集样本包含 19 种货币。若不经过筛选,直接计算该列的平均值,结果会高出 227 倍。
Etsy 会向自动化请求返回什么
先读取拒绝信息,不要重试请求。一个普通请求就能告诉你边缘节点使用的是哪家供应商,以及该供应商如何评估你的请求。任何商品 URL 都可以。下面这个 URL 属于某位卖家,因此现在可能已经失效:
curl -sD - -o /dev/null https://www.etsy.com/listing/753913297/smoky-quartz-ring-rose-gold-ring-women服务器返回 403,并包含以下标头:
HTTP/2 403
server: DataDome
x-datadome: protected
x-datadome-riskscore: 0.9230727100377928
accept-ch: Sec-CH-UA,Sec-CH-UA-Mobile,Sec-CH-UA-Platform,Sec-CH-UA-Arch,Sec-CH-UA-Full-Version-List,Sec-CH-UA-Model,Sec-CH-Device-Memory
set-cookie: datadome=ovuDEZ4S0taK1jDAOvZ9W3Uq2qUujN_iPPE3uXp7~r3msKXSvMFPp4j30em5IvR0...
via: 1.1 varnish
x-served-by: cache-del-vibw2260027-DEL
这个拦截响应包含 3 个事实。Etsy 使用的是 DataDome,而不是旧版指南仍在提及的 Akamai Bot Manager,因此应针对 DataDome 的检测层制定方案。Fastly 位于 Etsy 前端Via 和 X-Served-By 标头显示了这一跳。X-DataDome-riskscore 是 DataDome 对请求看起来有多像机器人的评分,1.0 表示最差。Etsy 可能更换供应商,因此在根据这 3 个事实制定方案前,请重新运行该命令。
这个标头为你提供了一个可用于对比的数值。在我们的测试中,评分是确定性的。对同一请求交错发送的全部 6 个样本都返回 0.9230727100377928。该评分取决于请求签名、发起请求的 IP,以及你开始回传 datadome cookie 后的该 cookie,而不是请求次数的累计值。因此,你得到的数字可能不同;换一个地址后,不同客户端配置之间的排名也可能发生变化。
在我们的测试中,响应正文为 776 字节,是一个会加载 ct.captcha-delivery.com/c.js 的 DataDome 拦截页面。该页面包含挑战脚本,而不是商品数据,因此解析器读取它时会返回空字段,而不是报错。嵌入的配置包含 DataDome 的设备检查 't':'fe'这意味着该请求收到的是可由真实浏览器完成的挑战,而不是永久封禁。't' 字段显示当前评级,并会随评级变化而采用其他值,因此请读取你自己的值,不要假定它一定是 'fe'。
我们从一个仅含 3 个标头的最简客户端发送所有请求,并且只改变路径。我们尝试的每个内容路径都返回相同的 403 和 0.482 分,而 /robots.txt 和一个无法解析到任何内容的 URL 则进入了未受保护的 Apache:
path                                       HTTP server     riskscore
/                                          403  DataDome   0.482
/listing/753913297/smoky-quartz-ring...    403  DataDome   0.482
/shop/AnemoneJewelry                       403  DataDome   0.482
/legal/terms/                              403  DataDome   0.482
/robots.txt                                200  Apache     -
/nonexistent-path-xyz                      404  Apache     -
因此,在 DataDome 保护的路径上,它评估的是请求方,而不是 URL。
带 Googlebot User-Agent 的请求绕过了 DataDome,但进入了限速器。Apache 返回 429 Too Many Requests并附带 nicki_ 引用字符串。至少有一个声明身份的搜索引擎爬虫会进入独立于 DataDome 的限速器。
为什么标头和 TLS 指纹还不够
风险评分可以让你测试有关标头的常见建议,其中数值越低,表示越不像机器人。我们保持 IP 和 URL 不变,仅改变 requests 客户端的请求标头,并记录 DataDome 返回的评分:
headers sent                                         score    HTTP
requests, library default headers                    0.977    403
+ Chrome User-Agent only                             0.923    403
full 12-header Chrome set                            0.503    403
User-Agent + accept + sec-fetch-site (3 headers)     0.482    403
该表显示了两个结果。添加 Chrome User-Agent 几乎没有改变评分,因为请求中的其他所有内容仍来自 requests。而且,3 标头组合的评分实际上比完整的 12 标头组合更好因此对这个目标而言,一致性比标头数量更重要。
以下 3 个标头的评分为 0.482,因此请准确复制 accept 的值:
User-Agent:      Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36
                 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36
accept:          text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,
                 image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
sec-fetch-site:  none
我们每次从完整标头组合中删除一个标头,并记录每次变化,其中加号表示评分变差:
run                              score     change
full set (baseline)              0.503
minus accept                     0.845     +0.342
minus user-agent                 0.784     +0.281
minus sec-fetch-site             0.669     +0.166
minus every sec-ch-ua* header    0.503      0.000
DataDome 在自己的 Accept-CH 响应标头中公布了 7 个客户端提示。我们的完整组合包含其中 3 个,但移除所有 sec-ch-ua 标头后评分毫无变化。accept 标头对评分的影响比 User-Agent 更大。
TLS 模拟通常是下一步,因此我们单独测试了它。每次运行都发送相同的 3 个标头,只有 TLS 和 HTTP/2 指纹发生变化。以下 JA4 值来自 curl_cffi 而不是 Etsy,因此每当该库更新配置文件时都会变化:
transport                             JA4                      riskscore  HTTP
python requests (OpenSSL, HTTP/1.1)   t13d1712h1_ab0a1bf427ad  0.482      403
curl_cffi impersonate=chrome110       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome116       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome124       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome131       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome133a      t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=firefox133      t13d1716h2_5b57614c22b0  0.503      403
curl_cffi impersonate=safari17_0      t13d2014h2_a09f3c656075  0.663      403
curl_cffi impersonate=safari17_2_ios  t13d2014h2_a09f3c656075  0.663      403
该表包含 3 种不同的指纹,分别对应 Chrome、Firefox 和 Safari。使用 HTTP/1.1 的普通 requests 得分仍优于这 3 种配置。该列只打印 JA4 的前两部分。第三部分对扩展列表进行编码,因此此处前缀相同的 Chrome 配置仍会有所不同。
在最佳与最差的运行之间,传输方式使评分相差 0.181,但没有任何一次运行成功返回页面。我们测试的所有指纹都不足以单独解决问题。
因此,对这个目标来说TLS 指纹不值得投入精力。我们读取了每个配置返回的 HTTP/2 帧,包括各浏览器引擎不同的伪标头顺序:
profile      SETTINGS                       | window   | pri | pseudo-header order
chrome131    1:65536;2:0;4:6291456;6:262144 | 15663105 | 0   | m,a,s,p
firefox133   1:65536;2:0;4:131072;5:16384   | 12517377 | 0   | m,p,a,s
safari17_0   2:0;4:4194304;3:100            | 10485760 | 0   | m,s,p,a
这 3 次握手都是正确的复刻,但 Etsy 全部拒绝。因此,DataDome 的判断依据并非握手本身。
实际执行检查的内容
在有头浏览器中,DataDome 的挑战会呈现为滑块,其 4 个原因中有两个是发起请求的 IP 和开发者工具的使用情况:
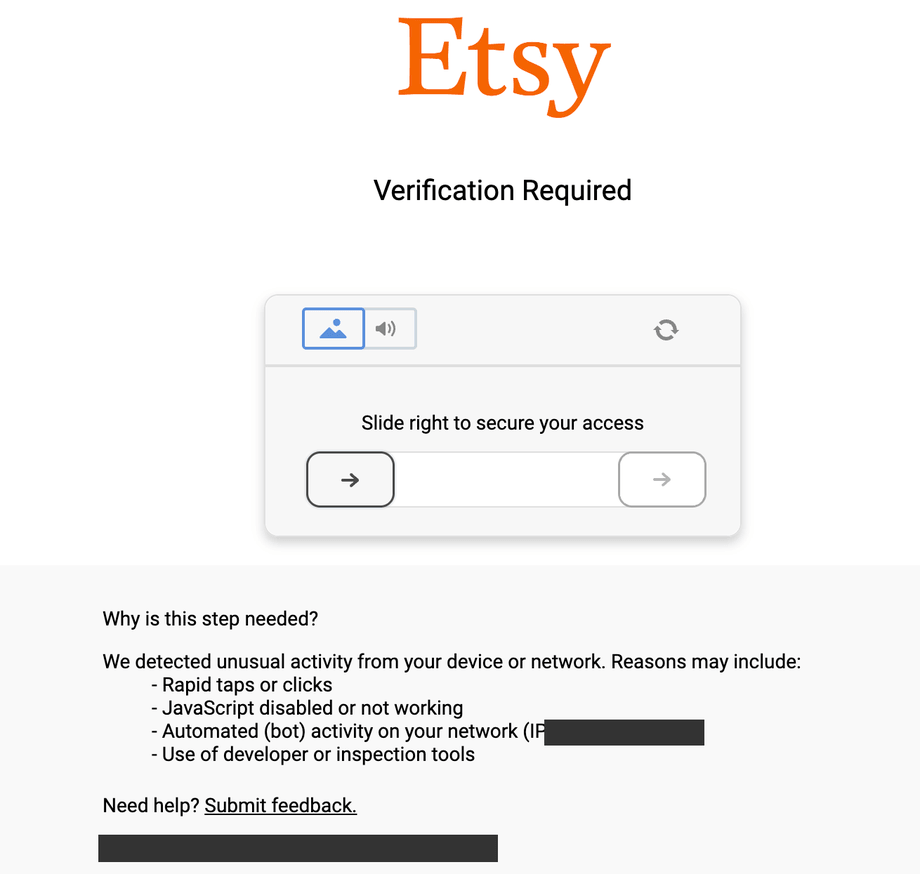
该 c.js 加载器大小为 14 KB,它会构建 iframe URL 并请求第二个页面。我们爬虫时,该页面包含一个 596 KB 的内联脚本,其中的模块名称揭示了你需要重新实现的内容:
detection-js/dist/vm-obf.js     the detection engine, VM-obfuscated
detection-js/dist/captcha.js    challenge coordination
./picasso                       canvas-based device-class fingerprinting
./mouseMaths                    pointer-movement analysis
./slidercaptcha  ./hash  ./helpers  ./bean
检测模块以字节码形式存储,供同一文件内置的解释器执行。这就是为什么在该代码包中进行文本搜索时找不到 webdriver、cdc_、headless 和 _phantom。无论这些探测是否实际运行,字节码包都会隐藏这些字符串,因此搜索结果说明不了任何问题。
我们抓取的构建版本将自身报告为 1.34.0会测量自身执行时间,并将该时长作为信号发送。该版本还会在控制台输出警告,要求你关闭 DevTools 后再继续。等你查看时,版本和模块列表很可能已经不同,因为该引擎遵循 DataDome 的发布周期,而不是 Etsy 的发布周期。但这些名称背后的架构变化要慢得多。
检查请求包含 16 个字段,并将浏览器环境编码到 userEnv、ddCaptchaEnv 和 plv3 中。
因此有两个实际结论。第一,通过 requests 复现该输出意味着要针对持续递增的版本字符串重新实现一台经过混淆的虚拟机。第二,DataDome 会采集 Canvas 输出和指针移动,而这些信息只有在真实浏览器引擎渲染页面后才会存在。针对 DataDome 的解锁服务会以服务形式运行该浏览器引擎,其设计目标是返回渲染后的页面,而不是拦截页面。
第二个结论可以测试,因此我们运行了未使用任何隐身补丁和代理的普通 Playwright Chromium。每种模式都从上述所有传输方式均被拒绝的同一地址运行 3 次:
headless=True (default)        403  403  403     1,530 B    0.5s
headless=True --headless=new   403  403  403     1,530 B    0.4s
headless=False (headed)        200  200  200   532,049 B    2.2s   Product JSON-LD present
两个窗口都从同一台无代理的机器运行,因此有头窗口会以当地货币显示价格:
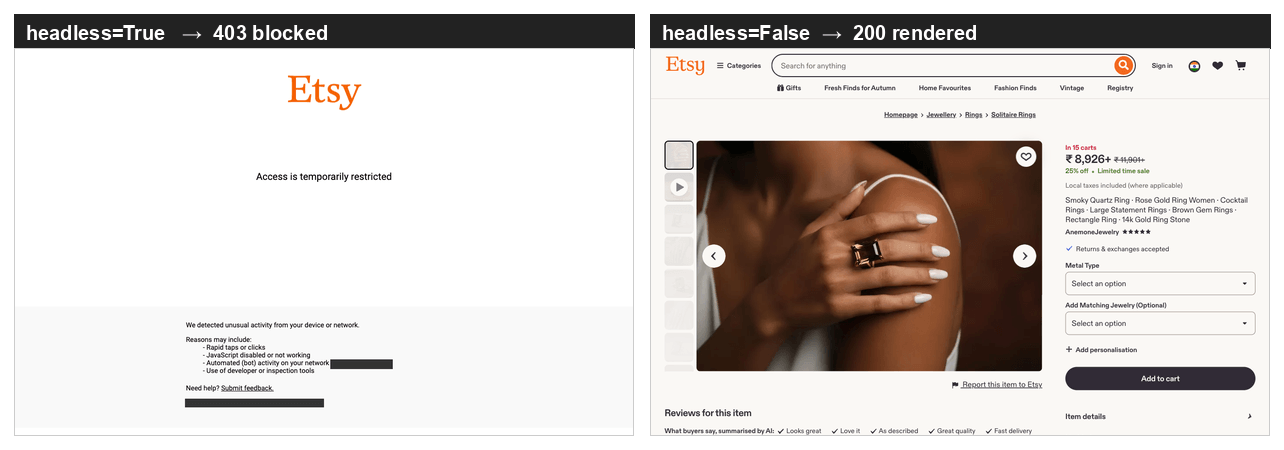
无头 Chromium 会在自己的 User-Agent 中包含 HeadlessChrome所以这些行之间的差异不只是窗口模式。若要手动检查页面或抓取少量页面,有头浏览器是最简单的答案。解锁基础设施适用于首次请求之后的后续请求;如果只抓取一次,有头浏览器的速度大约比经由该基础设施路由快 10 倍。
为什么一个浏览器并不等于爬虫
我们在同一个浏览器页面中逐个加载了 12 个商品页面,每次间隔 2 秒,结果只有 1 次成功,其余 11 次均被拒绝:
#1   200   444,123 B
#2   403     1,527 B
#3-12 403   ~1,530 B each
在两次导航之间丢弃浏览上下文后,状态码恢复为 200,说明拒绝来自会话状态而不是地址。但在同一测试周期的后期,这种修复方法也失效了。此后,无论上下文有多新,Etsy 都拒绝了来自该地址的所有请求。
当成功率从每次成功降至全部失败时,风险评分没有变化。首次读取数小时、数百次请求之后,3 标头请求的评分仍精确到小数点后 4 位,为 0.4822。
X-DataDome-riskscore 标头每次只评估一个请求,因此适合测试单项改动,但不适合监控抓取任务。监控该标头的流水线会在什么都没有采集到时仍报告成功。
采集少量页面以上的数据需要两样东西:新的浏览上下文,以及一个尚未被 DataDome 拒绝的地址。在导航之间丢弃上下文成本很低,因此可以先从这里开始,但该方法只能维持到 DataDome 拒绝该地址为止。住宅代理可提供一组能够轮换使用的地址。
网络解锁器会同时处理这两项,后文脚本的用量也不会超出免费额度。Browser API则会在由你的 Playwright 代码控制的托管浏览器内同时处理这两项。
robots.txt 和 Etsy 条款不允许什么
在构建任何内容之前,请自行阅读 Etsy 的 robots.txt因为该文件禁止关键词搜索,而且 Etsy 会在不通知的情况下重写它。我们读取时,该文件共有 1,818 行,并且只声明了 3 个 user-agent 组:*、AdsBot-Google-Mobile 和 Spinn3r:
User-agent: *
Disallow: /search?*q=
Disallow: /search/?*q=
Disallow: */shop/*/sold*
Disallow: */listing/*/favoriters*
Disallow: /api/
Allow:    /search/shops
通配符组禁止所有区域设置变体中的关键词搜索结果。该组适用于另外两组未指名的所有爬虫。已售商品历史和收藏人数也被禁止,而它们恰好是 Etsy 公布的最明确需求信号之一。商品页面和店铺页面没有 Disallow 规则,因此两者均保持开放。
该文件没有声明 Sitemap: 指令,而 /sitemaps.xml 会返回正文为空的 403。这两个缺失项与上述 Disallow 规则同样重要。两者都只需一行命令即可检查,值得重复执行,因为 Etsy 随时可能在不通知的情况下恢复其中任何一项。只要它们仍然缺失,你就必须从 Etsy 保持开放的页面中发现商品。
我们读取时,Etsy 没有在文件中的任何位置指名 AI 爬虫,也没有发布 llms.txt 或 ai.txt。本节中最有可能在我们检查后发生变化的就是这一点。
无论如何,DataDome 都会在边缘节点拒绝这些爬虫。GPTBot 和 ClaudeBot 均收到 403,而且在我们的测试中两者评分均为 0.9814,高于同一地址使用 Chrome User-Agent 时的 0.923。使用相同标头的无意义 User-Agent 字符串得到相同评分,因此 DataDome 评估的是是否缺少已知浏览器身份,而不是爬虫名称。
最后更新于 2025 年 8 月 26 日的 Etsy 使用条款规定,未经明确许可,你同意“不会对服务的任何页面进行 crawl、scrape 或 spider 操作”。
请检查你的采集层是否会替你执行 robots.txt,以及它在什么阶段作出判断。住宅代理解锁端点会逐个请求作出判断。在未完成 KYC 的账户上,请求被禁止的搜索路径会返回相应规则和 KYC 表单:
Residential Failed (bad_endpoint): Requested site is not available for immediate
residential (no KYC) access mode in accordance with robots.txt. To get full
residential access for targeting this site, fill in the KYC form:
https://brightdata.com/cp/kyc
同一账户可以无错误地抓取 /shop/AnemoneJewelry响应大小为 983,937 字节。该端点会读取与你相同的 robots.txt,随后提供允许访问的路径,并将禁止访问的路径送交合规审查,而不是转发给代理。在开始构建之前,请先确定你的用例是否需要这些被禁止的路径。
如果你自行构建抓取层,就需要在代码中作出该决定,并针对每个目标负责实现和维护 robots.txt 处理。
Etsy 官方 API 返回什么,又遗漏了什么
API 是获得授权的路径,因此在排除它之前,应先检查它能提供什么。在官方 API 与网页爬虫之间作出选择是一个普遍问题,而对 Etsy 来说,选择取决于规范中遗漏了哪些字段。我们直接获取了 OpenAPI 规范并统计出 76 条路径,其中 31 个 GET 操作只需要应用密钥,无需卖家 OAuth。每当 Etsy 添加或删除端点时,这些总数都会变化,因此请根据该文件重新统计,不要依赖本段数字。
关于 v3 API 的常见说法有 3 点是错误的。findAllListingsActive 并未被移除,而且它接受 keywords、min_price、max_price、taxonomy_id、shop_location、currency 和 buyer_country每次调用的 limit 上限为 100。getReviewsByListing 和 getReviewsByShop 只需应用密钥即可返回评论文本。getShop 可为任何店铺返回 transaction_sold_count、review_count、review_average、num_favorers 和 listing_active_count。
该规范只包含一个需求字段,遗漏了其余字段。getListing 只需应用密钥,并会在 ShopListingWithAssociations schema 中返回 views即每天刷新一次的累计浏览次数。搜索整个文档都找不到搜索量、展示量、转化率或单个商品销量字段。我们统计时ShopListing schema 有 50 个属性,包括 num_favorers、quantity 和 price但没有一个是销量。请根据规范重新核对数量,但到目前为止仍未出现销量字段。
单个商品的交易确实有对应端点 getShopReceiptTransactionsByListing但它需要 transactions_r OAuth scope,而店铺所有者只能为自己的店铺授予该权限。对于任何并非由你运营的店铺,Etsy 仅以当前总数形式公布店铺级别的终身销量,不提供历史记录,也不提供单个商品的数据。
这一缺口解释了 Etsy 周边第三方工具市场存在的原因。一些产品会销售并非由其运营的店铺的单商品销量估算值或关键词搜索量。我们阅读的规范不会为你不拥有的店铺返回这些数字,因此此类数据必然来自该 API 之外。
Etsy 会按应用密钥、每秒和每天执行速率限制。x-limit-per-second 和 x-limit-per-day 响应标头会报告这两种限制,超过其中任一限制时,Etsy 会返回带有 retry-after 的 429。
速率限制页面将其中的数字标记为“示例值”,而不是默认值。我们阅读该页面时,旧版的“每天 10,000 次、每秒 10 次”组合已经消失。请从 Developer Portal 中读取你自己的限制。
使用 Python 爬虫 Etsy 商品和店铺页面
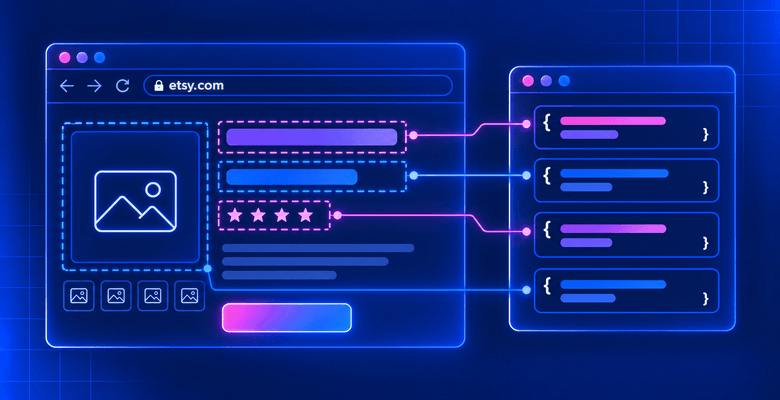
Etsy 商品页面嵌入了 schema.org JSON-LD,因此提取步骤不需要 CSS 选择器,而且 Etsy 重新设计周边标记样式时也不会失效。爬虫步骤需要基础设施,你有两种实现方式。解锁 API 可在任何地方运行,但需要账户;本地浏览器无需账户,适合少量页面。
下面的脚本需要一个库和两个环境变量:
python3 -m venv .venv && source .venv/bin/activate
pip install requests
export BRIGHTDATA_API_KEY="your-api-token"
export BRIGHTDATA_ZONE="web_unlocker"
令牌来自 Bright Data 控制面板。使用该令牌的每个请求都会消耗账户余额,因此请将其保存在环境变量中,不要写入提交到代码仓库的脚本。
你需要在 Web Access → Add API → 网络解锁器 API 下创建第二个值。请求载荷将其称为 zone但我们设置时,控制面板将其标记为 API,因此在面板中搜索“区域”找不到任何结果。BRIGHTDATA_ZONE 必须与你在那里输入的名称一致,因为脚本默认使用 web_unlocker。表单会警告该名称一经设置便无法更改:
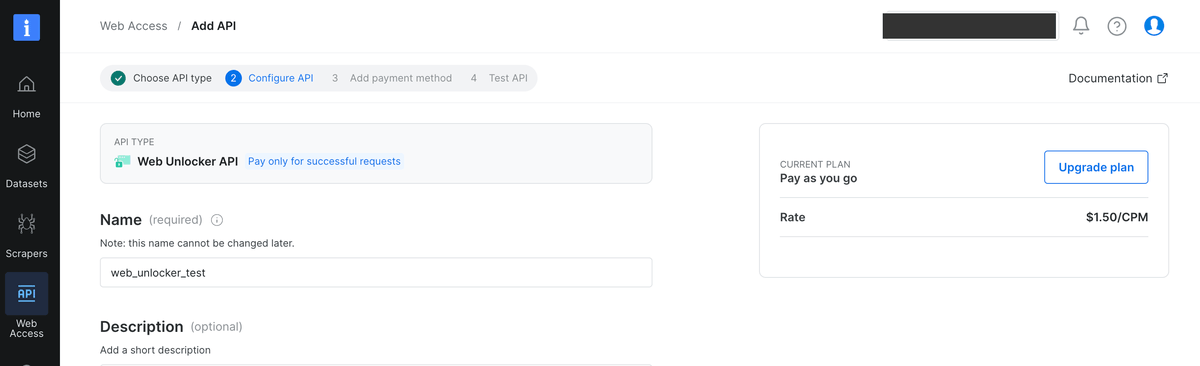
该截图中的区域名为 web_unlocker_test因此脚本默认值无法匹配。你可以将 BRIGHTDATA_ZONE 设置为自己输入的名称,也可以使用 web_unlocker 并保留默认值。网络解锁器快速入门记录了这两种方法;我们设置时无需银行卡便能从免费额度开始。网络解锁器定价页面列出了当前免费额度,以及超出额度后的按量计费价格,并以每 1,000 个成功请求为单位报价。面板将该费率写作 CPM。
该脚本通过网络解锁器端点发送请求并解析结果:
import json
import os
import re
import requests

API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
ZONE = os.environ.get("BRIGHTDATA_ZONE", "web_unlocker")
ENDPOINT = "https://api.brightdata.com/request"

LD_JSON = re.compile(
    r'<script[^>]*type\s*=\s*[\'"]application/ld\+json[\'"][^>]*>(.*?)</script\s*>',
    re.S | re.I,
)


def fetch_html(url, country="us"):
    """Return the rendered HTML for an Etsy URL, or raise on failure."""
    # Checked here rather than at import, so the browser path below runs
    # without an account.
    if not API_KEY:
        raise SystemExit("BRIGHTDATA_API_KEY is not set, see the exports above")
    response = requests.post(
        ENDPOINT,
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": country},
        timeout=90,
    )
    response.raise_for_status()
    body = response.text
    # A quota error arrives as HTTP 200 with a short text body, and a block page
    # arrives as HTTP 200 of valid HTML. Neither contains ld+json, which is the
    # content this actually wants, so test for that rather than for either error.
    if not LD_JSON.search(body):
        raise RuntimeError(f"no ld+json in response, most likely blocked: {body[:200]!r}")
    return body


def product_jsonld(html):
    """Pick the Product block by @type. Every listing we opened had four."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "Product":
                return node
    return None


def parse_listing(node):
    """Flatten a Product node, keeping the offer's range rather than its lowest price."""
    offer = node.get("offers", {})
    # schema.org allows a list of offers and a single priceSpecification object,
    # and Etsy serves both, so normalize before indexing into them.
    if isinstance(offer, list):
        offer = offer[0] if offer else {}
    specs = offer.get("priceSpecification", [])
    if isinstance(specs, dict):
        specs = [specs]
    base = next((s for s in specs if "priceType" not in s), {})
    was = next(
        (s for s in specs if "Strikethrough" in str(s.get("priceType", ""))), {}
    )
    # Not every listing carries a priceSpecification. Without this fallback a
    # single-variant listing records a null price and raises nothing.
    # A range arrives three ways: nested in priceSpecification, as AggregateOffer's
    # own lowPrice and highPrice, or not at all. Try them in that order.
    low = base.get("minPrice") or offer.get("lowPrice") or offer.get("price")
    high = base.get("maxPrice") or offer.get("highPrice") or offer.get("price")
    # availability is the only field that marks a dead listing, and JSON-LD lets it
    # arrive as a bare term, an array, or an @id object. Normalize before comparing.
    avail = offer.get("availability") or ""
    if isinstance(avail, list):
        avail = avail[0] if avail else ""
    if isinstance(avail, dict):
        avail = avail.get("@id", "")
    rating = node.get("aggregateRating", {})
    return {
        "sku": node.get("sku"),
        "title": node.get("name"),
        # Etsy serves a dead listing as a full HTTP 200 page that still
        # carries a price, so availability is the only field that says so.
        "availability": str(avail).rsplit("/", 1)[-1],
        "currency": offer.get("priceCurrency"),
        "price_min": low,
        # high can be a bundle maximum rather than the item's, where a listing
        # has an add-on axis. Count the axes before trusting it as a maximum.
        "price_max": high,
        "list_price": was.get("price"),
        # True only where the variations differ in price. Same-price variants
        # read false, so this is a price-spread test, not a variation test.
        "has_variations": None if low is None else low != high,
        "rating": rating.get("ratingValue"),
        "review_count": rating.get("reviewCount"),
        "shop": node.get("brand", {}).get("name"),
    }


if __name__ == "__main__":
    url = (
        "https://www.etsy.com/listing/753913297/"
        "smoky-quartz-ring-rose-gold-ring-women"
    )
    node = product_jsonld(fetch_html(url, country="us"))
    if node is None:
        raise SystemExit("no Product block on page: blocked, or the layout changed")
    print(json.dumps(parse_listing(node), indent=2))
我们对一个在线商品运行了该脚本,它返回了一条扁平记录。价格范围来自一个包含多个独立定价变体的商品:
{
  "sku": "753913297",
  "title": "Smoky Quartz Ring · Rose Gold Ring Women · Cocktail Rings · ...",
  "availability": "InStock",
  "currency": "USD",
  "price_min": "89.25",
  "price_max": "5613.75",
  "list_price": "119.00",
  "has_variations": true,
  "rating": "4.5",
  "review_count": 99,
  "shop": "AnemoneJewelry"
}
针对同一商品的 3 次运行中,抓取耗时为 23 至 27 秒,返回 540 KB 至 750 KB 数据。这些数字体现了解锁步骤的成本。请按这一范围预算延迟,而不要按照拦截响应不到一秒的速度估算。
如果你只需要几个页面,而且不想开设账户,本地浏览器可以用大致相同数量的代码得到相同结果。该浏览器需要从一个尚未被 DataDome 拒绝的地址运行。它需要显示环境,因此在服务器上应通过 Xvfb 等虚拟显示器以有头模式运行,而不是使用无头模式。只需安装一次 Playwright 和 Chromium:
python3 -m venv .venv && source .venv/bin/activate   # skip if already active
pip install playwright requests
playwright install chromium
然后替换抓取函数,保留相同的两个解析函数。将下面内容放在 __main__ 代码块上方,与其他函数放在一起:
from playwright.sync_api import sync_playwright


def fetch_html_browser(url):
    """Fetch one page with a visible browser, since headless returns a 403."""
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=False)
        context = browser.new_context(locale="en-US")
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        html = page.content()
        browser.close()
        # Same rule as the guard above: test for the content you want. A block
        # page is valid HTML, so only the missing ld+json shows it.
        if not LD_JSON.search(html):
            raise RuntimeError("no ld+json on page, most likely a block page")
        return html
只需修改 __main__ 代码块内的一行,其他内容保持不变:
node = product_jsonld(fetch_html_browser(url)) # was: fetch_html(url, country="us")我们的运行返回了 535,247 字节,并由相同的两个函数顺利解析。页面价格也以 INR 计价,因为你机器上的浏览器会从你自己的地址退出,而且浏览器路径不接受 country 参数。没有该参数就无法设置出口国家/地区,因此这种方式适合少量页面,而不是数据集。
上述代码会解析页面,而不是将页面发送给模型。Etsy 以结构化数据形式发布这些字段,因此读取过程具有确定性,而且实际上没有成本。对我们测量的商品来说,选择 Product 块并将其扁平化的中位耗时为 0.3 毫秒。
如果把同一页面交给语言模型处理,则原始 HTML 会占用 179,599 个 token,一个商品就会耗掉 200K-token 上下文窗口的大部分容量。先移除标记可将其减少到 5,352 个 token,降幅达 97%。这个比例比选择哪种模型更重要。
但不再匹配的解析器只会返回空字段而不报错,而模型至少会生成明显可见的错误内容。因此,在发布 schema.org 数据的网站上应选择确定性方案。把节省的时间用于检查解析器是否仍然返回你期望的字段。
店铺页面也包含 4 个这样的块,但类型不同,其中一个会显示商品 URL 的来源。/shop/{shop_name} 返回一个描述店铺的 Organization 节点,以及一个 ItemList 节点,后者的 itemListElement 包含完整商品 URL。shop_itemlist 会按 @type 选择 ItemList因此在同一函数中改用 Organization即可返回店铺自身的字段。在我们测试的店铺上numberOfItems 为 1,842,而单个页面返回 36 个 URL;?page=2 又返回 36 个完全不重复的 URL。
枚举器以店铺名称作为输入,因此你需要店铺名称来源。有 3 种来源无需触碰被禁止的搜索路径:使用你已在跟踪的店铺、使用上述 findAllListingsActive 端点,或使用准备好的数据集。该端点只需应用密钥即可接受 keywords并且会在返回的每个商品中包含 shop_id。
我们抓取了该范围内以及超过声明终点的页面:
page  2    36 items
page 25    36 items
page 51    36 items
page 52     6 items      51 x 36 + 6 = 1,842
page 53    no ItemList block
page 60    no ItemList block
总数与店铺声明的 1,842 一致。超过终点后,Etsy 仍会返回约 420 KB 的完整页面,但不包含 ItemList。
Etsy 不会返回错误或空数组作为终止信号,因此等待其中任一情况的循环会针对看似正常的页面无限翻页。应在该块缺失时终止,并使用声明的数量检查结果。分页采集的常见模式假定存在上述两个信号之一,因此在这里不适用。
这两个函数应与前面的函数放在同一文件中,因为它们使用 LD_JSON 和 fetch_html。请注释掉当前不运行的入口点,因为枚举器需要运行 20 分钟:
def shop_itemlist(html):
    """Pick the ItemList block. The first block on a shop page is a video."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "ItemList":
                return node
    return None


def enumerate_shop(shop_name, country="us"):
    """Page a shop until the ItemList stops appearing, and hand back the declared
    count so the caller can check it."""
    base = f"https://www.etsy.com/shop/{shop_name}"
    urls, declared, page = [], None, 1
    while True:
        suffix = "" if page == 1 else f"?page={page}"
        try:
            node = shop_itemlist(fetch_html(base + suffix, country=country))
            if node is None:
                break
            declared = node.get("numberOfItems", declared)
            urls += [item["item"]["url"] for item in node["itemListElement"]]
        except (RuntimeError, requests.RequestException, KeyError, TypeError,
            AttributeError) as err:
            print(f"stopped at page {page}: {err}", flush=True)
            break
        print(f"page {page}: {len(urls)} of {declared}", flush=True)
        # Breaking on the declared count here would make the comparison below
        # vacuous, so page until the ItemList block stops appearing.
        page += 1
    return urls, declared


if __name__ == "__main__":
    urls, declared = enumerate_shop("AnemoneJewelry")
    print(len(urls), "collected,", declared, "declared")
针对上述页面,枚举器会执行 53 次爬虫,返回 1,842 个 URL,并根据店铺声明的数量检查总数。每次运行都应比较这两个数字,因为读取不完整时会返回较少 URL,却不会触发任何错误。
try 必须同时覆盖解析和爬虫。包含 53 个请求的循环足够长,可能收到速率限制响应,而一个格式错误的 itemListElement 也会造成与请求失败相同的后果。如果没有保护逻辑,两种情况都会在第 30 页抛出异常,并丢弃此前采集的所有 URL。捕获两者后,你得到的是一次不完整读取,而不是一次完全丢失的运行,并且数量比较会暴露问题。在 Python 中处理失败请求遵循标准模式,唯一针对 Etsy 的部分是将解析步骤也放入保护逻辑中。
按上述延迟计算,53 次爬虫需要 20 至 24 分钟,并会为一个店铺消耗每月免费额度中的 53 个请求。请先在小型店铺上运行枚举器并观察页数增长,再将其用于拥有 1,842 个商品的店铺。还应为区域设置用量上限,这样出现异常的运行会在达到上限时停止,而不是耗尽余额后才停止。
我们还通过网页爬虫工具 API 的 Etsy 店铺端点以批处理任务执行了同样的发现过程。我们对店铺而非商品 URL 运行任务,并将记录限制为 50 条以进行比较。它在 168.9 秒内返回 50 个商品,即每条记录约 3.4 秒;该次运行没有重复记录,也没有带区域设置前缀的 URL。
采集整个店铺需要 53 次枚举爬虫加 1,842 次商品爬虫,共 1,895 个请求;若采用单线程,大约需要 13 小时。开始前请将这 1,895 个请求与当前免费额度进行比较。超出免费额度后,相同工作会按每 1,000 个成功请求的按量费率计费。
这里也要固定 country。我们未固定该值爬虫同一店铺时,得到了 /de/listing/ URL 和德语标题。这些 URL 会作为不同的键进入数据集,即使对应商品已经以 /listing/ 形式存储。
会在无提示情况下破坏 Etsy 数据集的提取问题
这里的每个问题都会返回 HTTP 200,而且不会抛出异常。在 5 个问题中,4 个会写入看似合理但实际错误的行,第 5 个会写入空行。最终,你可能要到数月后才发现错误数字。数据质量指标可以在数据存储后发现此类故障,但不写入错误行的成本更低。
一个商品页面有 4 个 JSON-LD 块,而不是 1 个。在我们打开的每个商品页面中,Etsy 都把 Product、VideoObject、BreadcrumbList 和 FAQPage 放在 4 个独立的 script 标签内,所有标签均使用 application/ld+json 类型。页面源代码会在连续 4 行中显示它们:
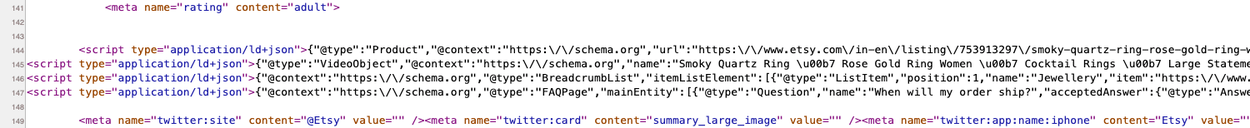
调用 find() 并获取第一个匹配项的代码在商品页面上可以工作,但在店铺页面上会悄无声息地返回视频块。应按 @type 进行选择,而不是按位置选择。使用 Python 解析 JSON的其他机制无需改变。
店铺页面也有自己的 4 个块,但顺序不同:
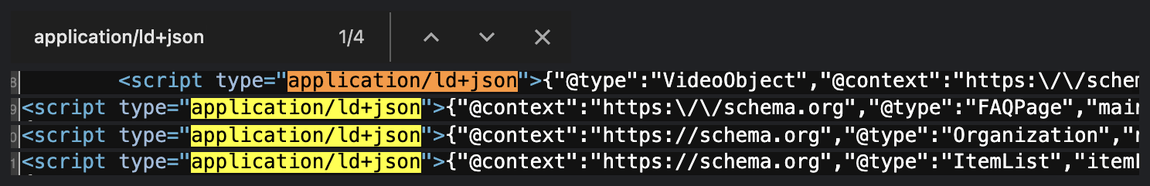
在我们测试的店铺中,第一个块是视频,而你需要的 ItemList 位于最后,因此获取第一个匹配项会失败。上述脚本改为按 @type 选择。
对于包含变体的商品offers.price 是价格范围中的最低价,而不是整个范围。在我们测试的商品中offers.price 为 89.25但嵌套在 offers 中的 priceSpecification 条目声明了 minPrice 89.25 和 maxPrice 5613.75。读取 offers.price 的解析器会记录最便宜的变体,并丢失价格范围。改为存储 maxPrice 也无法解决问题,因为对于该商品maxPrice 是套装价格,而不是单件商品的价格。
我们开启变体采集后抓取了同一个 URL,得到了 61 条独立记录,每种变体一条,价格从 89.25 到 1,871.25。表格中的一条商品记录实际代表 61 个可购买 SKU,价格范围相差 21 倍。
页面上的第二个下拉列表会进一步放大该范围:
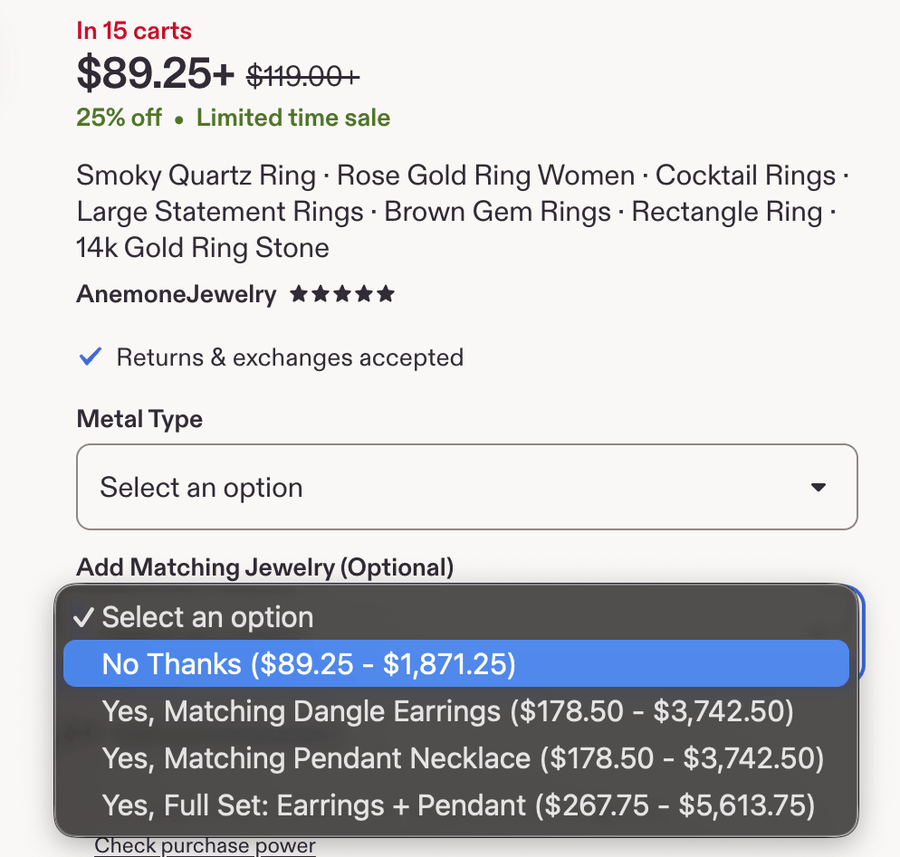
这两个最大值衡量的是不同内容,而且该商品有两个变体维度。Metal Type 从价格为 89.25 的 14k Gold Filled 一直到价格为 1,871.25 的 3 个纯金选项。随后 Add Matching Jewelry (Optional) 会将该范围倍增。No Thanks 的价格从 89.25 到 1,871.25;任一单件配套商品的价格从 178.50 到 3,742.50;Full Set: Earrings + Pendant 的价格则从 267.75 到 5,613.75。
声明的 maxPrice 是纯金戒指加两件配套商品,即 3 件商品合并为一个价格。变体提取结果返回的是单独的戒指,而且与 No Thanks 行的价格精确到分完全一致。
因此,只要商品具有附加项维度maxPrice 就可能是套装而非单件商品的最高价格。基于该值建立的价格序列会悄无声息地跟踪套装价格。在把价格范围存为商品自身的价格之前,请先统计变体维度。这些信息不在 JSON-LD 中,因此需要从渲染页面读取,或提取变体数据。
同一 priceSpecification 数组还包含标记为 StrikethroughPrice 的第二个条目,因此促销价和标价会并列出现,两者仅通过 schema.org URL 区分。该条目有自己的 minPrice 和 maxPrice。脚本记录的 list_price 是标价范围中的最低价格,就像 offers.price 是当前价格范围中的最低价格一样。
区域设置取决于出口 IP,而且改变的不只是货币符号。我们在同一小时内抓取同一商品 3 次,每次只改变出口国家/地区:
country   currency   price    variation range      title
us        USD        89.25    89.25 - 5613.75      Smoky Quartz Ring, Rose Gold Ring Women
de        EUR        95.71    95.71 - 5058.76      Rauchquarzring, Damenring aus Roségold
gb        GBP        82.77    82.77 - 4338.22      Smoky Quartz Ring, Rose Gold Ring Women
同一商品在不同出口国家/地区下的渲染结果不同:
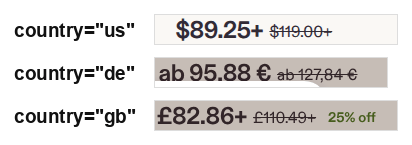
这些截图来自比上述 3 行更晚的一次爬虫,其中只有美元数值保持不变。德语页面还会将最低价格写为 ab即“起价”,而另外两个页面中的 + 表示相同含义。
这 3 次抓取返回相同的 SKU、评分和评论数,但使用 3 种货币显示 3 个不同价格。最低价与最高价之比在 3 行中也不同:美国行是 62.9 倍,另外两行分别是 52.9 倍和 52.4 倍,因此两次爬虫之间的变化不只是汇率。德国出口还返回了机器翻译的标题,而两个英语区域则保留原始标题。
忽略地理位置的动态代理池会生成混合 3 种货币的价格序列和混合多种语言的文本语料库,而且流水线不会报告任何问题。请为每次采集固定出口国家/地区,并在每个价格旁存储货币。
同样的问题也会出现在准备好的数据中。我们下载的 1,000 条记录样本包含 19 种货币,其中 109 行不是以 USD 计价,14 行使用越南盾。该样本会刷新,因此你的副本会与这些数字不同。请在自己的副本上执行相同的比较。
如果不读取货币列就对价格列求平均值,会抬高平均值:
mean(final_price), all rows          31,238.84   n=991
mean(final_price), currency = USD       137.57   n=882
                                        ~227x
median(final_price), all rows            26.00
在该列中,991 行里的 14 行贡献了总额的 87%,但总共有 109 行并非 USD,所有这些行都需要处理。查询可以正常运行,该列也是干净的浮点数,但答案会错两个数量级。中位数几乎没有变化,因为非 USD 行只占该列的一小部分。平均值与中位数存在如此大的差异,只能说明数据存在重尾分布。按货币列分组,才能将单位混杂与普通偏态区分开来。
下文还会再次引用一篇 2026 年 3 月关于市场商品的 arXiv 论文。该论文在执行任何分析之前,将样本限制为以 USD 计价的商品。这是在采集后而非采集过程中解决问题。以这种方式筛选也会改变平均值所描述的总体,因为它直接丢弃其他货币的商品,而不是进行换算。
这个问题在智能体路径中最难发现。我们通过一个 schema 只接受 URL 的 MCP 服务器抓取该商品,结果得到了以 CZK 定价的捷克店面。固定国家/地区的 REST 调用则将同一商品报告为 89.25 USD。
原因在于工具接口,而不是爬虫本身。如果没有国家/地区或区域设置参数可供指定,你只能接受服务器正在使用的出口。在将任何此类服务器连接到智能体之前,请先检查其行为,因为出口会决定所有下游答案使用的货币。
因此,应在固定区域设置下将 Etsy 数据采集到你自己的存储中,再让智能体读取该存储,而不是针对每个问题进行实时爬虫。每次都悄无声息地使用不同货币回答问题的智能体,比无法回答问题的智能体更糟。
失效商品页面仍然是带有价格的完整页面。Etsy 不会为已过期或售罄的商品返回 404。我们爬虫了一个 2007 年的商品,得到 HTTP 200、465,563 字节、完整的 Product 块,以及 price 13.00 USD。
页面会完整渲染,同时显示售罄横幅和价格:
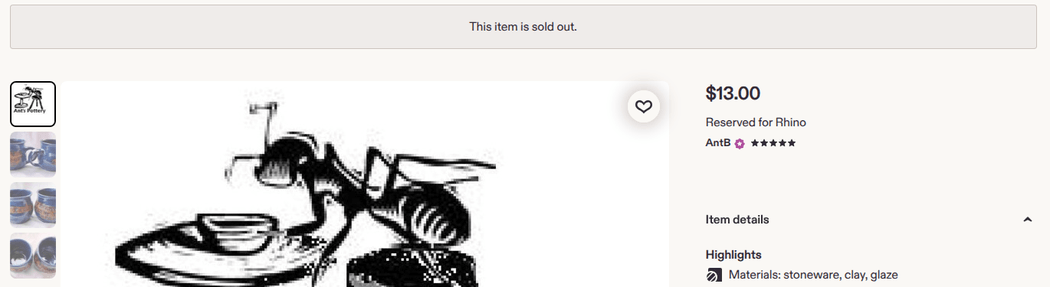
offers.availability 是唯一与价格冲突的字段,其值为 schema.org/OutOfStock。跳过该字段的解析器会按全价记录一个失效商品,因此上述脚本会读取该字段。
在准备好的数据中,该字段不如页面本身可靠。在同一副本中,1,000 行有 74 行是售罄商品,全部 74 行的 availability 都为空,其中 65 行仍显示数值价格。此处的标志是已存储 URL 上的 show_sold_out_detail 参数。如果只保留 availability 值为 InStock 的行,则会错误丢弃 798 个仍在销售的商品,因为大多数商品同样缺少该字段。
2xx 响应并不代表你拿到了数据。这个问题出现在采集层,而不是载荷中;测试上述脚本时我们遇到了它。解锁端点会在正文中说明自身状态。当账户达到请求速率限制时,它返回 200正文是一个 111 字节的纯文本,内容为 Your system is sending too many of this type of request。状态行仍然表示成功,因此 raise_for_status() 会通过,解析器找不到 Product 块,而循环会在不抛出任何异常的情况下写入空行。
网页爬虫工具 API 按设计处理同一种情况。其同步采集端点会在 1 分钟内返回记录,耗时更长的任务会继续异步运行。当任务超过该时限时,同一端点会返回带有 snapshot_id 和 retry-after 的 202你可以在任务就绪后采集结果,具体方式见 API 参考文档。两种响应都是成功状态,因此应先根据状态码进行分支,再索引记录列表。
fetch_html 中的保护逻辑只有两行,它检查页面是否包含 ld+json,而不是检查某种具体错误。针对在线店铺运行枚举器时,我们还发现了第三种情况:正文为空的 200同一保护逻辑无需修改即可捕获它。因此,请检查响应中是否包含你需要的内容,而不是只匹配已经见过的错误,因为供应商的错误文本不是稳定接口。无论你使用哪种爬虫层,都应编写等效检查,因为成功状态无法保证载荷有效。
一个有效示例只能证明问题存在,不能证明问题常见。我们使用两种发现路径各自得到的 100 个商品,检查了价格范围和删除线价格问题。100 个商品中有 98 个包含变体,而且在同样的 98 个商品中initial_price 与 final_price 不同。这两个问题都不是可以推迟处理的边缘情况。这 100 个商品来自上述两种发现路径,而不是 Etsy 全品类的随机样本。因此,应将 98 视为珠宝商品的最低值,而不是整个平台的发生率。
同一项检查表明,上述示例商品在一个方面比较特殊。该商品有 99 条评论,而此次抓取的中位数为 1,已发布数据集样本的中位数为 0。
何时应获取托管数据集,而不是维护爬虫工具
你可以自行构建爬虫工具,而且上述代码已经包含了大部分内容。真正需要决定的是,你想自行处理哪些故障。
我们再次通过网页爬虫工具 API处理同一商品,这次按 URL 采集,而不是从店铺中发现。它返回了 58 个字段,而原始 Product 块只有 14 个字段;额外字段处理了上述大多数问题:
raw JSON-LD (geo=us)          Web Scraper API
-----------------------------------------------------
price 89.25 (range minimum)   final_price 89.25
119.00 (StrikethroughPrice)   initial_price 119
not present                   discount_percentage 25
not present                   listing_has_variations true
not present                   reviews_count_shop 15129
not present                   is_star_seller false
4 embedded reviews            6 top_reviews
14 fields                     58 fields
你需要按输入 URL 配置该提取器,并将 all_variations 设置为 true,以处理价格范围问题:
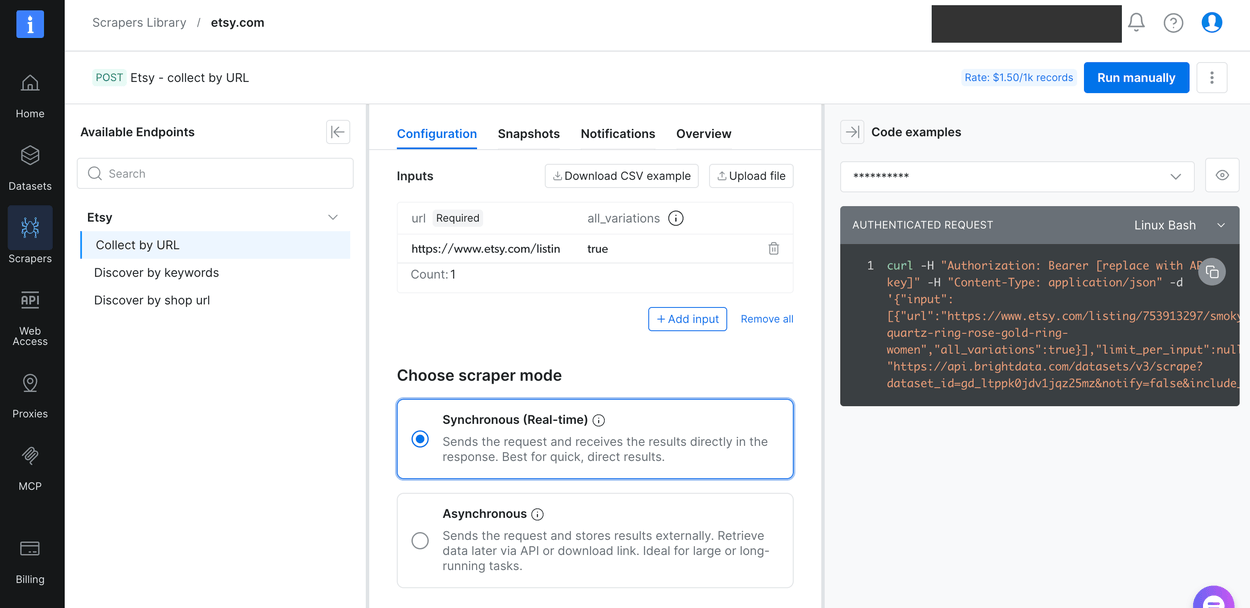
我们比较了两种路径中的 6 个字段,它们完全一致,分别是货币、实际售价、标价、评分、商品评论数和发货地。在信任任何一种路径之前,都应执行这项检查。
两种方式的耗时对比会发生反转,而模式决定反转幅度。通过同步端点提取单条结构化记录大约需要 50 秒,而原始爬虫需要 27 秒。前者会执行渲染和标准化,而不是直接返回字节。50 秒意味着在上述 1 分钟超时限制内只剩约 10 秒余量。该端点适用于输入一个 URL 并立即获得答案。
我们改为以批处理任务运行同一爬虫工具,得到上述 50 条记录,平均每条 3.4 秒。每条记录的耗时约为原始爬虫 27 秒的八分之一。在批处理模式中202 是预期响应,而不是需要处理的错误。
对于周期性爬虫任务,在结构化路径返回的字段范围内,它可以替你的团队免去选择器维护、区域设置固定和价格范围处理。对于单个商品,无论选择哪种模式,它都更慢。上述差异比较证明价格处理已经解决,而 50 条记录的运行中没有出现带区域设置前缀的 URL。选择器维护是唯一无法通过单次运行验证的部分。结构化路径的计费方式与网络解锁器相同,当前免费额度和每 1,000 条记录的费率可在网页爬虫工具 API 定价页面查看。
同一样本包含两类记录,而不是一类,因此获取数据时需要同时考虑两者。在 1,000 行中,128 行拥有完整字段集,另外 872 行有 12 个字段为空,其中包括 description、product_category 和 store_country。
这种差异与商品发布时间相关,从 2025 年末开始上架的商品拥有完整记录。因此,跨越多年的批量提取会在同一文件中混合两种记录。随着数据总体逐渐更新,完整记录的比例应该会上升。在确定订单规模之前,而不是之后,请根据自己所需的列检查字段覆盖率。
订购前也需要检查评论量。在我们获取的副本中,1,000 个商品有 753 个没有评论,因此中位数为零。评论数最高的 10% 商品贡献了全部评论的 98%。平均每个商品 52.5 条评论只能描述整个文件,并不能描述你实际打开的任何一个商品。
评论偏态看起来与货币问题相似,但它们是不同的故障,需要不同的修复方式。上述货币问题是单位错误,平均值是错误的。评论量则是偏态分布,在计算总量时平均值仍然正确。随机抽取 1,000 个商品应得到大约 52,500 条评论,因此在规划批量语料库时可以使用平均值。但对于试点规模的样本,这种高度集中会使估算不可靠。
覆盖率则是另一个问题。由于 1,000 条记录中有 753 条为零,你获取的行中只有约 25% 包含任何评论。
如果你需要的是历史数据而不是实时数据,准备好的数据集可以省去爬虫过程。Etsy 数据集页面列出了当前字段数、记录总数、单条记录价格和最低订购量,这 4 个数字就是获取数据时需要计算的项目。
该页面显示的单条记录价格是一次性费率;从每半年到每天的刷新计划则以订阅形式提供,并可享受折扣。数据的新旧程度也很重要。该页面将预采集记录描述为数天至数月前的数据,而按需采集允许你在结账前设置时效上限。你可以直接在数据集页面选择刷新计划和数据量级。
这些数字可能随时变化,因此预算前请直接从页面读取,并以相同方式对待另外两个定价页面。数据集页面会在摘要行下方显示记录样本,但在你申请访问之前会进行模糊处理:
在这里,一个外部参考点比供应商自己的说法更有价值。同一篇论文 Mecha-nudges for Machines 在附录 B 中说明了数据来源。作者表示,原始数据“来自 Bright Data 公司,该公司提供 Etsy 商品信息的结构化数据集”。他们的数据“于 2025 年 11 月 12 日采集,并于当天交付”。论文描述了两个快照,分别包含 500 万和 106 万个商品。该附录可以核验,而供应商案例研究无法提供同等独立性。
这里的规则很明确:当你只需要数千个能够按 URL 枚举的商品,并且可以接受固定一种区域设置时,自行构建爬虫工具。当 URL 列表本身是最困难的部分,或者爬虫任务必须持续运行时,购买采集层。若数据集用于定价工作,也应购买采集层,因为价格范围字段和删除线价格字段已经分离。无论选择哪种路径,货币列仍然需要筛选。
对于上述店铺,自行构建需要 1,895 个请求;以单线程采集 1,842 个商品大约需要 13 小时。获取数据的一方则需要满足准备好记录的最低订购量。这两个数字不能直接比较,因为构建成本按店铺计算,而获取成本存在可分摊到多个店铺的最低消费。
总结
Etsy 一边阻止普通爬虫,一边在同样的公开页面上发布 schema.org JSON-LD,因此数据提取本身工作量很小,访问才是主要工作。传输方式并不能决定能否访问,因为有头浏览器能够加载 9 个经过调优的 HTTP 客户端都无法加载的页面,但 Etsy 在第二个请求时又拒绝了同一浏览器。因此,工程问题是如何持续采集,而不是如何伪装成浏览器。无论选择哪条路径,数据故障的代价都高于访问故障,因为混合货币的列或按全价记录的失效商品都能顺利解析,你可能数月后才发现问题。请分别通过原始爬虫和结构化提取器处理同一个商品,比较字段差异,并让结果在你编写爬虫之前决定是自行构建还是购买。
常见问题
Etsy 有 API 吗?
有。我们统计时,Etsy Open API v3 列出了 76 条路径,其中 31 个 GET 操作只需要应用密钥。它会返回商品、店铺、评论和分类数据。但对于并非由你运营的店铺,它不提供单商品销量、关键词搜索量、转化率和历史记录,而许多数据项目都需要这些信息。
Etsy API 免费吗?
API 本身没有公开定价,但访问权限取决于审批结果和针对各应用密钥设置的速率限制。Etsy 会决定哪些用户可以获得更高限制,并可能附加额外条款或费用。实际成本主要来自速率限制,而不是固定费用。
为什么我的 Etsy 爬虫工具会被拦截?
Etsy 使用 DataDome,后者会返回 403、一个简短的拦截页面,以及一个对请求进行评分的 X-DataDome-riskscore 响应头,其中 1.0 表示最差。该分数取决于发起请求的 IP 和请求特征。在我们的测试中,修改请求头会降低分数,模拟 Chrome TLS 则会提高分数,但两种方式都未能返回页面。
Etsy 允许网页爬虫吗?
除非获得 Etsy 的明确许可,否则不允许。其条款是约束更严格的文件。robots.txt 禁止爬虫所有语言区域版本中的关键词搜索、售出历史记录和收藏者信息,但允许访问商品详情页和店铺页面。Etsy 可能会在不另行通知的情况下重写该文件,因此请在构建爬虫工具前读取其实时版本。
可以使用 Python 爬虫 Etsy 吗?
可以。商品详情页嵌入了 schema.org JSON-LD,因此提取数据不需要 CSS 选择器。选择 @type 为 Product 的 application/ld+json 块,然后将 offer 对象扁平化。获取页面才是难点,而大规模采集则需要创建新的浏览上下文并使用动态 IP 地址。
如何获取 Etsy 销售数据?
销售数据仅在店铺层级公开。getShop 端点返回 transaction_sold_count即整个店铺的累计销售数字。对于并非由你运营的店铺,没有任何数据会将该数字细分到各个商品,因此工具提供的单个商品销售数字来自其他来源。应将这些数字视为估算值,并对照店铺总销量进行核验。
Etsy 是否提供用于爬虫爬虫的站点地图?
截至我们上次检查时,并未提供。robots.txt 文件中没有声明任何 Sitemap: 指令,而 /sitemaps.xml 返回 403,且响应正文为空。由于没有站点地图,你必须从店铺页面、API 的 findAllListingsActive 端点或预先准备的数据集中发现 URL。这三种方式都不会访问被禁止的搜索路径。
Etsy 是否会屏蔽 GPTBot 等 AI 爬虫?
我们检查时,Etsy 并未按名称屏蔽它们。robots.txt 文件仅声明了 3 个 User-Agent 组,其中没有任何 AI 爬虫,而且 Etsy 也未发布 llms.txt 或 ai.txt。不过,DataDome 仍然拒绝了 GPTBot 和 ClaudeBot;两者得到的 0.9814 分比 Chrome User-Agent 得到的 0.923 分更差。无意义字符串得到的分数也相同。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。