爬虫 AliExpress 可采集价格、库存、变体、评分和评论,这些正是价格监控和竞品跟踪所需的数据。大部分数据并不在 HTML 中,因为页面随后会从一个需要签名的内部 API 加载它们。
在我的测试中,普通请求返回了 HTTP 200,但没有价格,因此管道会将其记录为成功,而结果行却是空的。从一个 IP 地址发起请求时,这个签名 API 在十几次请求内就开始拦截调用。
本指南将介绍如何获取这些数据、检测看似成功的失败,以及如何大规模使用 Bright Data 的 AliExpress 爬虫工具 API。
简要总结
- 旧版教程解析的
window.runParams对象现在是空的。价格、库存和 SKU 数据从mtop.aliexpress.pdp.pc.query加载,而该接口需要 MD5 签名。 - 应通过标记而非状态码检测拦截。被拦截的请求会返回 HTTP 200、一个
bxpunish标头,以及正文中的rgv587_flag等标记。 - 正确的签名也无法避免拦截。从一个 IP 地址连续进行两轮各 60 次调用且不设置延迟,分别只有 7 次和 15 次成功获得数据。
- 大规模抓取时,应抓取公开的
/item/商品页面。Bright Data 的 AliExpress 爬虫工具 API 可提取结构化数据,而 Browser API 可让你的脚本读取每个页面的完整 API 响应。
使用 HTTP 客户端爬虫 AliExpress 时会发生什么
先发送一个 HTTP 请求,不使用浏览器或代理。如果请求超时,说明你的网络无法直接访问 AliExpress,而代理或下文介绍的某种托管方法可以从能够访问该网站的网络发送请求。
下文所有内容都使用 3 个软件包。后面章节中的爬虫 API 脚本会从环境变量读取你的 Bright Data API 密钥:
pip install curl_cffi playwright requests
export BRIGHTDATA_API_KEY="your-api-key"    # PowerShell: $env:BRIGHTDATA_API_KEY="your-api-key"
使用 curl_cffi 获取一个商品页面,并读取 <title>、旧版教程解析的 window.runParams 对象,以及页面传递给自身 JavaScript 的引导对象。这 3 个值可以说明普通 HTTP 客户端是否足够:
import re
from curl_cffi import requests as cffi

# any product URL that still exists works
ITEM = "https://www.aliexpress.com/item/1005001398867186.html"

# no User-Agent of your own: curl_cffi sends one that matches the browser it impersonates
r = cffi.get(ITEM, impersonate="chrome", timeout=30)
html = r.text

print("status      ", r.status_code)
print("bytes       ", len(html))
print("title       ", repr(re.search(r"<title>(.*?)</title>", html, re.S).group(1)))
print("runParams   ", repr(re.search(r"window\.runParams\s*=\s*(\{.*?\});", html, re.S).group(1)))
print("isCSR       ", re.search(r"isCSR\s*=\s*(\w+)", html).group(1))
print("crawler flag", re.search(r'"crawler":(\w+)', html).group(1))
获取成功:
status       200
bytes        77226
title        ''
runParams    '{\n                    }'
isCSR        true
crawler flag false
该页面只是一个 HTML 外壳,没有价格、库存、SKU、评分或评论。在任何 JavaScript 运行之前,这个外壳中已经包含 Open Graph 标签。og:title 包含真实商品名称,而 <title> 为空;og:image、og:url 和 og:type(设置为 product)也都存在。og:description 只包含 AliExpress 的通用宣传语,而且页面中没有 JSON-LD,因此这两个来源都无法提供商品数据。
在同一小时内加载相同 URL 的浏览器会渲染价格、评分和变体:
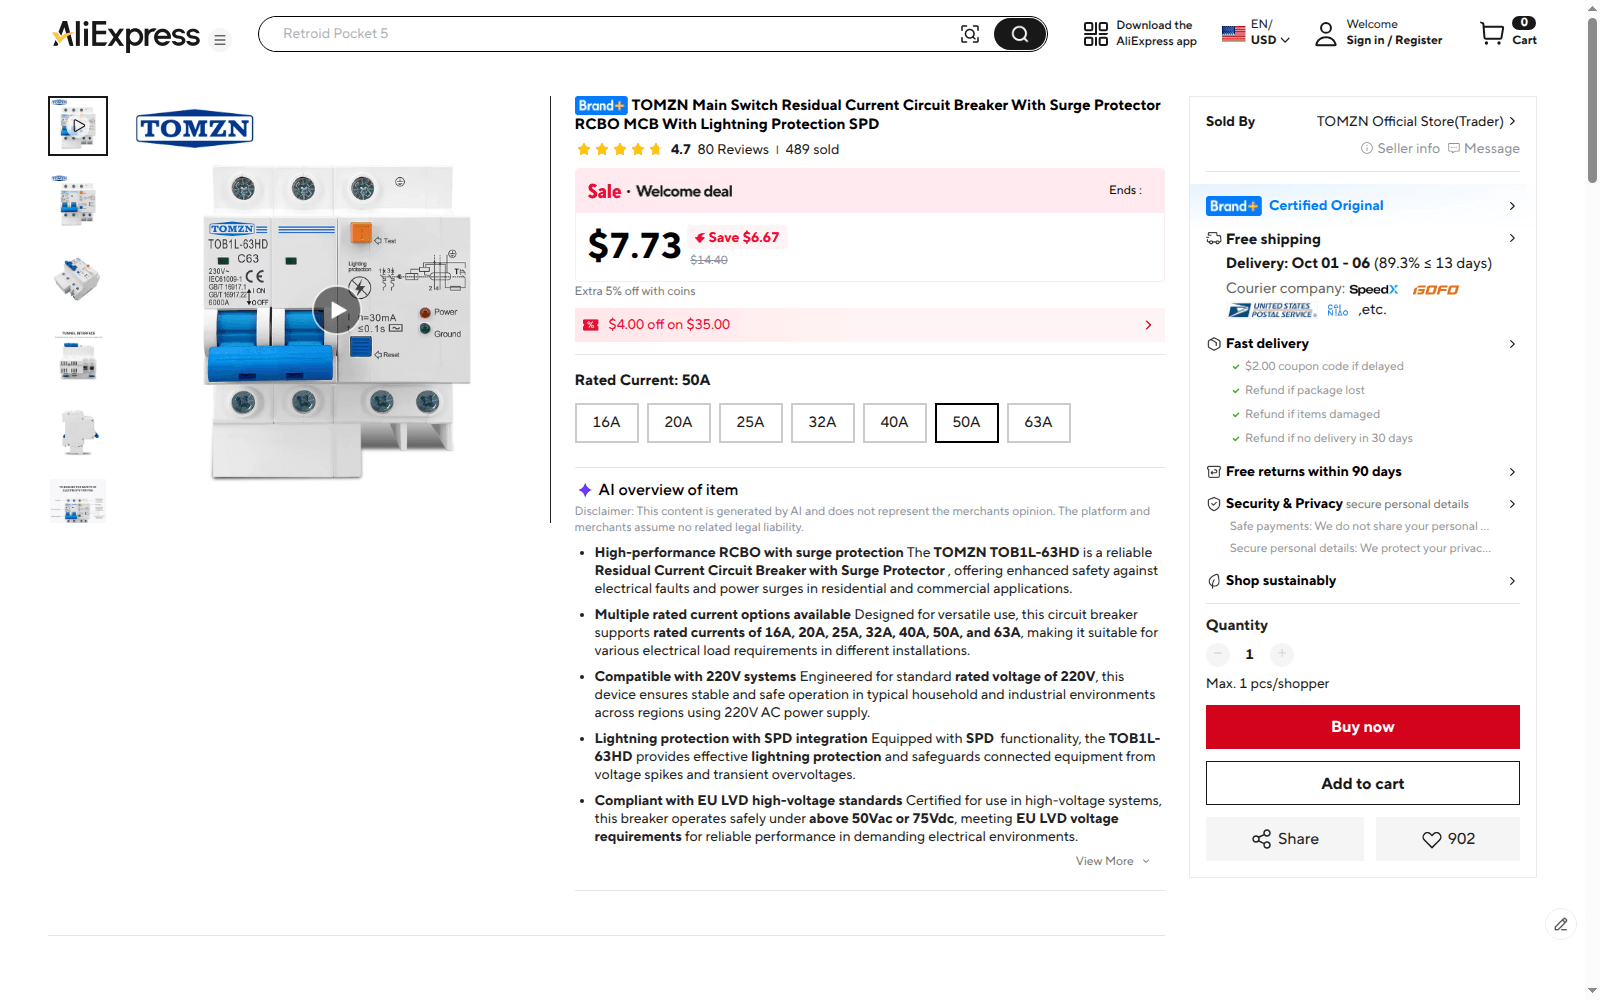
通过 Bright Data 的 Browser API 渲染,并将地理位置定向设置为美国。对于此商品,AliExpress 的内部 API 返回相同的 $14.40 标价和 4.7 评分。促销价来自临时促销,会随时间变化。
在页面源代码中搜索该标价找不到任何结果:
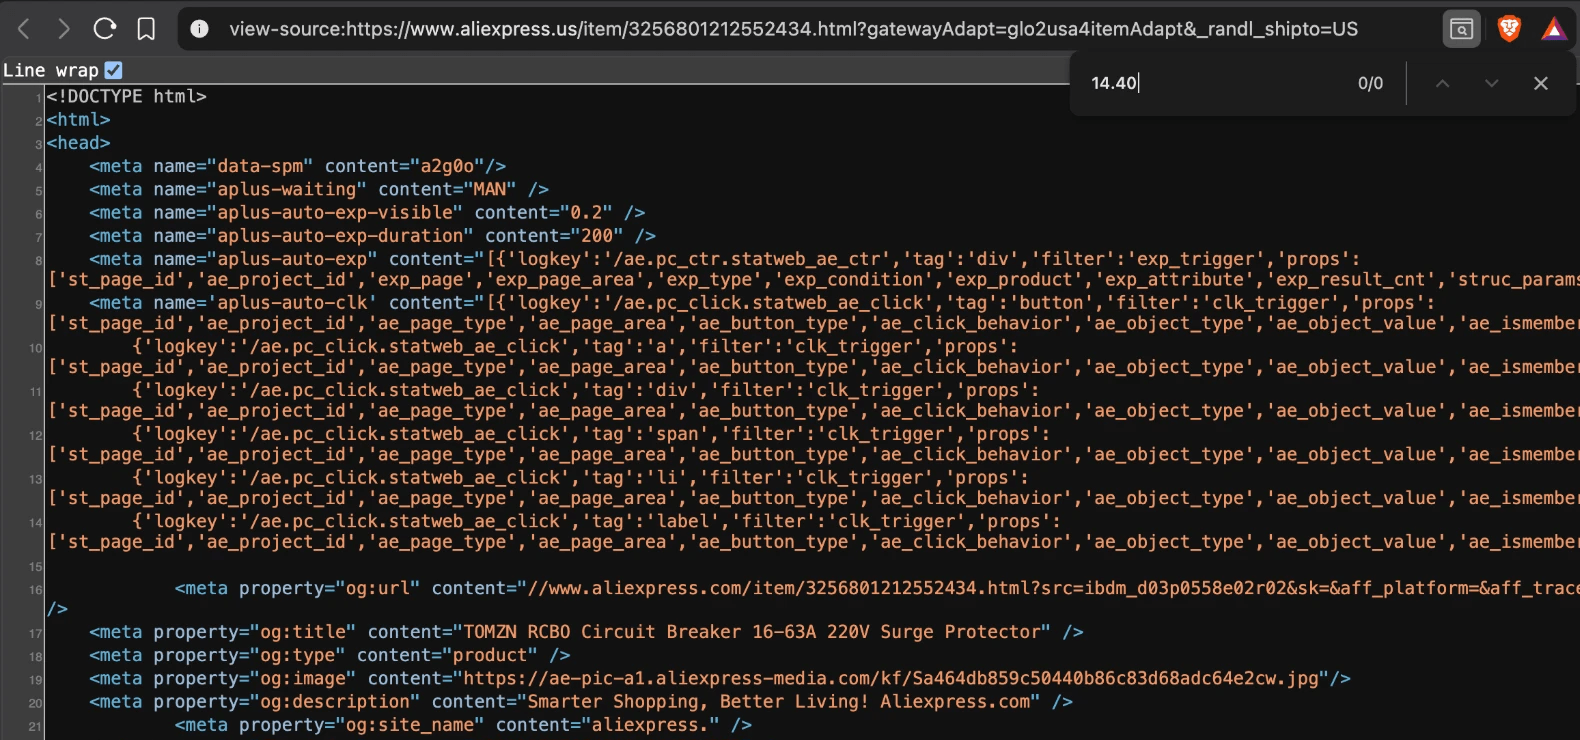
采集自美国站点,该站点提供相同的 77 KB 页面外壳。
采集目录字段的成本很低。只需一个不使用解锁功能的 GET 请求即可返回目录字段,因此你无需渲染页面,就能将商品 ID 映射到标题和主图。价格和商品组合管道需要价格、库存及变体数据,而这些数据来自 AliExpress 的内部 API 网关。应将这两项任务分开规划。
让 curl_cffi 选择 User-Agent。impersonate="chrome" 是别名,而不是版本号。在该库的源代码中,curl_cffi 0.16.1 通过 DEFAULT_CHROME 常量将此别名映射到 chrome150而该常量会在每次发布新配置文件时发生变化。如果不设置该标头,该库还会发送与之匹配的 Chrome/150 User-Agent。
如果传入自己的 User-Agent,它会替换该库的 User-Agent,因此会将硬编码的 Chrome/141 字符串与 Chrome 150 TLS 握手一起发送。这种不匹配不会引发错误,因此你可能在毫无察觉的情况下部署它。你可以省略该标头,让库自行匹配 User-Agent 与握手;也可以将配置文件固定到特定版本,并使用与之匹配的字符串。构建 TLS 客户端的工程师指出,不匹配的身份比一致的身份更容易被检测,而且 User-Agent 通常会比 TLS 握手更早过时。
isCSR 标志表明页面如何渲染。其值为 true因为 AliExpress 已将商品详情页改为客户端渲染(CSR)。window.runParams 是一个未使用的空对象,但基于正则表达式的提取器仍会匹配它。读取该对象的解析器不会报错,只会返回空结果。
我尝试的每个客户端都获得了 HTTP 200 和相同的 77 KB 页面外壳。我从一个住宅 IP 地址直接向该 URL 连续发送了 20 个请求,未使用代理,所有请求都返回 HTTP 200。这些请求在一个会话中运行,每 0.4 秒发送一次,且未轮换 User-Agent。我还分别以 python-requests/2.32.5、curl/8.7.1 和 3 种 TLS 模拟配置文件获取了相同 URL。
发送 Googlebot User-Agent 会将引导对象中的 "crawler" 从 false 切换为 true。响应仅相差 1 个字节。该标志并未添加服务器端渲染的有效负载,因此伪装成 Googlebot 只会改变一个布尔值,其他内容完全不变。
对于客户端渲染的电商平台,应先检查数据,再将获取操作记录为成功。状态码只能说明 HTTP 请求成功。在此目标上,即使数据缺失,请求本身仍会成功。
返回 HTTP 200 的拦截
AliExpress 确实会拦截请求,但 HTTP 状态行不会显示这种拦截。
该网站自己的 robots.txt 在一条 Googlebot 专用规则中提到了一个内部端点,该端点可能返回商品数据。直接调用它,并在读取正文之前检查响应标头:
from curl_cffi import requests as cffi

PID = "1005001398867186"
url = f"https://www.aliexpress.com/aeglodetailweb/api/msite/item?productId={PID}"
r = cffi.get(url, impersonate="chrome", timeout=30,
             headers={"Accept": "application/json",
                      "Referer": f"https://www.aliexpress.com/item/{PID}.html"})

print("status", r.status_code, "bytes", len(r.text))
for k in ("server", "x-rule-name", "bxpunish", "set-cookie"):
    print(f"  {k:12s} {str(r.headers.get(k))[:70]}")
print("body marker:", "rgv587_flag" in r.text, "| x5secdata:", "x5secdata" in r.text)
响应来自阿里巴巴的 Baxia 反爬系统,而且状态码显示成功:
status 200 bytes 2399
  server       Tengine/AServer-Ingress
  x-rule-name  AE_GLOBAL_UNLOGIN
  bxpunish     1
  set-cookie   x5secdata=xffEdBbOh5ArPGTjyI_40B3_06C7jiK2nBFPGlpVzkk2x66w14DH6V
body marker: True | x5secdata: True
正文是一段脚本,它通过 window.location 重定向到 _____tmd_____/punish URL,并设置 window._config_ = {"action":"captcha", ...}。脚本以阿里巴巴的拦截标记 <!--rgv587_flag:sm--> 结尾。x-rule-name 标头给出了匹配的规则 AE_GLOBAL_UNLOGIN看起来这是针对未经身份验证的全球流量所设的规则。正常、未被拦截的响应也会返回相同标头,因此该标头本身不能作为拦截标志。
仅检查状态码会接受这个被拦截的响应。raise_for_status() 不会引发异常status_code == 200 检查也会返回 true。如果控制面板将 HTTP 2xx 响应计为成功,它会报告管道运行正常,实际结果行却是空的。
因此,应通过响应标头和正文而不是状态码检测拦截。阿里巴巴的错误字符串可能随时更改,但检查专用响应标头和正文中的标记字符串成本很低,也很容易扩展:
BLOCK_MARKERS = ("rgv587_flag", "x5secdata", "_____tmd_____", "FAIL_SYS_USER_VALIDATE")

def is_blocked(resp, min_bytes=1024):
    """True when Baxia responded instead of the application."""
    if resp.headers.get("bxpunish"):
        return True
    body = resp.text
    if len(body) < min_bytes:          # treat a near-empty 200 as a block too
        return True
    return any(m in body[:4096] for m in BLOCK_MARKERS)
在我的测试中,这些检查检测出了状态码未能显示的每一次拦截。请在解析器运行前执行相同检查,并在编写任何选择器前添加这些检查。否则,在此目标上,你只能等到解析器找不到数据时才知道请求被拦截了。
记录每个失败请求的原因。对于此目标,拦截页面、空页面外壳和错误币种的价格分别需要不同的修复方法,而一个总体成功率会掩盖这 3 种问题。还应按出口国家拆分原因,因为错误币种的价格看起来仍像是成功结果。
自行签署商品 API 调用
商品字段确实以 JSON 形式存在。如果在浏览器中加载一个页面并记录其 XHR 流量,就能看到这些字段来自页面调用的 API 网关。
页面加载时会调用位于 acs.aliexpress.com/h5/<api>/<version>/ 的阿里巴巴 MTOP 网关,每次调用都包含 jsv、appKey、毫秒时间戳 t 和 32 字符的 sign。mtop.aliexpress.pdp.pc.query 返回价格、库存、SKU、店铺和评分。评论文本来自同一网关上的第二个签名调用 mtop.aliexpress.review.pc.list因此采集评论时,每件商品还需要发送第二个请求。读取内联引导脚本可发现,页面可能调用多个商品 API:
页面变体(viewName) |
预获取 API |
|---|---|
newDetail |
mtop.aliexpress.pdp.pc.query |
choiceDetail |
mtop.aliexpress.itemdetail.pc.asyncPCDetail |
h5Detail |
mtop.aliexpress.itemdetail.msite |
我抽样的全部 6 个商品页面都包含 viewName = 'newDetail'。另外两个 API,即移动端的 mtop.aliexpress.itemdetail.msite 和 mtop.aliexpress.itemdetail.pc.asyncPCDetail也并不更容易访问。两者在第一次请求时都返回了带有 bxpunish: 1 的 FAIL_SYS_USER_VALIDATE使用的是桌面 API 可接受的相同有效负载。
每次获取时读取 viewName即可发现商品详情何时开始渲染为不同的页面变体。硬编码单一 API 名称的爬虫会错过这种变化。页面的引导脚本将预获取超时设置为 15,000 毫秒,并会在 10,000 毫秒时中止自身的 XHR,因此可将 10,000 毫秒作为你自己的超时上限。
在浏览器的 Network 面板中筛选 pdp.pc.query 后,页面自身的请求包含签名代码所需的每一个值:
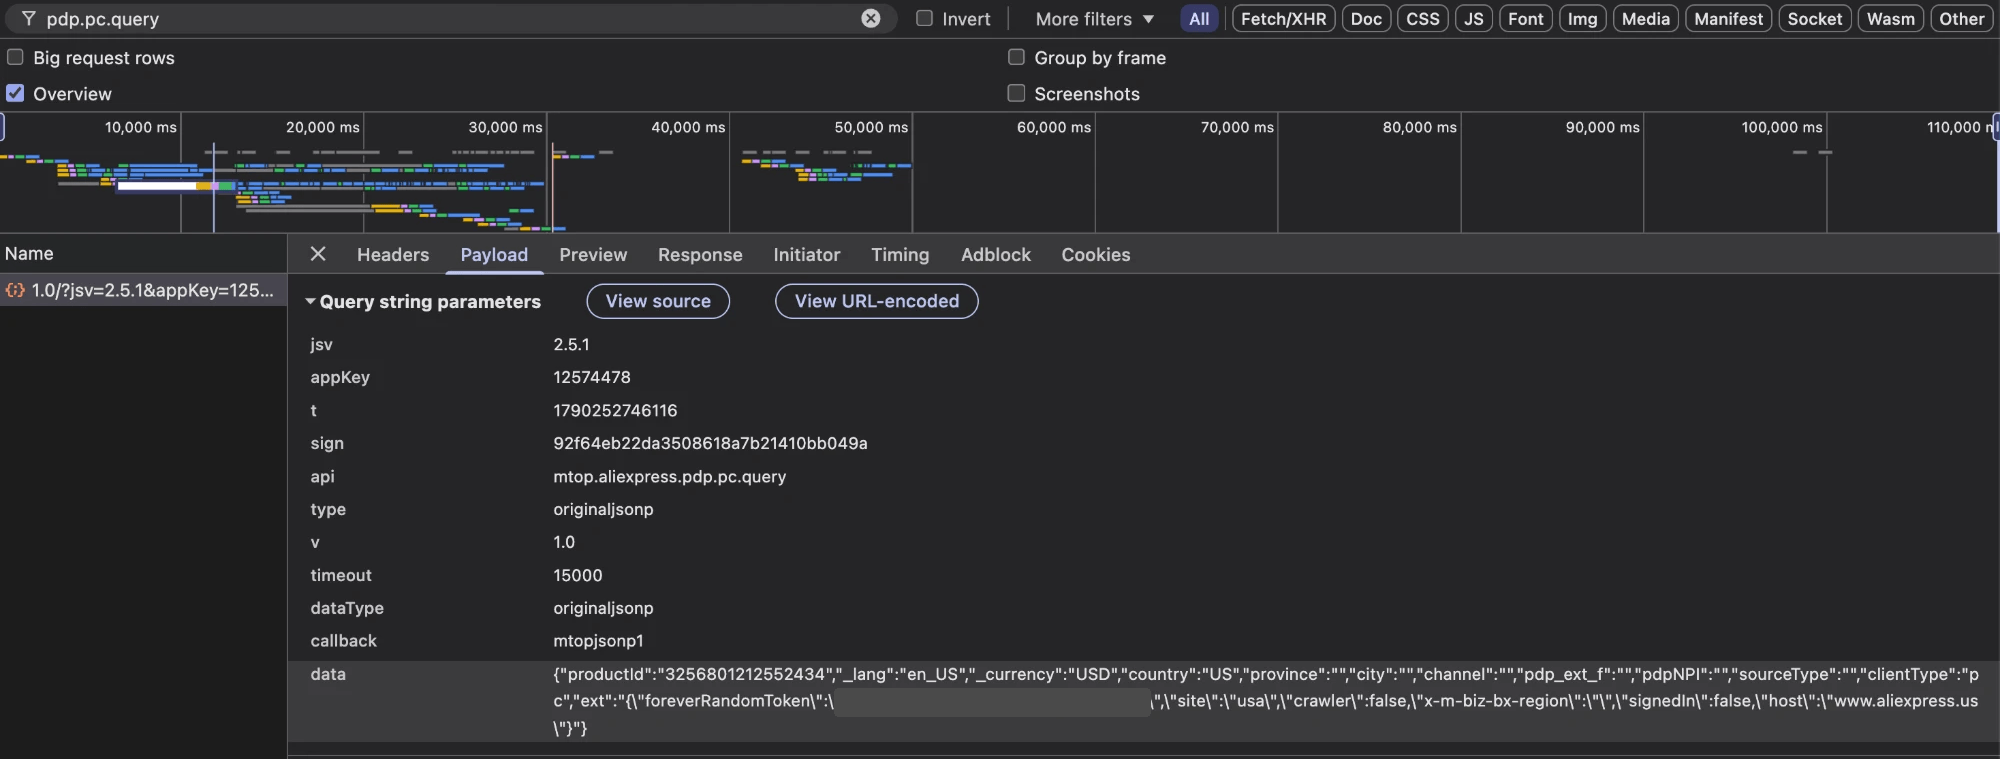
这是页面自身的调用,采集自美国站点,此商品在该站点的 ID 为 3256801212552434。页面发送 originaljsonp并添加 timeout 和 ext 块。下面的签名代码发送 jsonp 并省略这两个块,网关仍接受了这个较短的请求。其中一个令牌值已隐藏。
sign 值使用阿里巴巴 H5 签名方案,该方案很短,只需一个函数即可重新实现。它用 & 符号连接会话令牌、时间戳、应用密钥和完全一致的请求正文,然后对结果执行 MD5 哈希:
import hashlib, json, time
from curl_cffi import requests as cffi

APP_KEY, API, VER = "12574478", "mtop.aliexpress.pdp.pc.query", "1.0"
GATEWAY = f"https://acs.aliexpress.com/h5/{API}/{VER}/"

def sign(token, t, data):
    return hashlib.md5(f"{token}&{t}&{APP_KEY}&{data}".encode()).hexdigest()

def pdp(session, product_id, token=""):
    data = json.dumps({"productId": product_id, "_lang": "en_US", "_currency": "USD",
                       "country": "US", "province": "", "city": "", "channel": "",
                       "pdp_ext_f": "{}", "sourceType": "", "clientType": "pc"},
                      separators=(",", ":"))
    t = str(int(time.time() * 1000))
    params = {"jsv": "2.5.1", "appKey": APP_KEY, "t": t, "sign": sign(token, t, data),
              "api": API, "v": VER, "type": "jsonp", "dataType": "jsonp",
              "callback": "mtopjsonp1", "data": data}
    return session.get(GATEWAY, params=params, impersonate="chrome", timeout=30,
                       headers={"Referer": "https://www.aliexpress.com/"})

s = cffi.Session()
first = pdp(s, "1005001398867186")                       # unsigned, returns the token cookie
token = s.cookies.get("_m_h5_tk", "").split("_")[0]
second = pdp(s, "1005001398867186", token)               # signed with that token
print("call 1:", len(first.text), "bytes |", first.text[:60])
print("call 2:", len(second.text), "bytes")
第一次调用返回令牌,第二次调用返回商品:
call 1: 151 bytes | mtopjsonp1({"api":"mtop.aliexpress.pdp.pc.query","data":{},"ret
call 2: 103748 bytes
调用 1 返回 FAIL_SYS_TOKEN_EMPTY以及值为 _m_h5_tk 的 Set-Cookie 标头。调用 2 使用该 Cookie 值的第一部分进行签名,并返回 JSONP,即包裹一个 JSON 对象的函数调用。移除 mtopjsonp1(...) 包装后,就能获得完整商品记录,包括标题、originalPrice $14.40、salePriceString $6.84、59,924 件库存、4.7 评分、卖家 ID 200422816,以及 categoryPath 13/5/141914。
你只需要该有效负载中的一小部分。响应包含 27 个顶层模块,其中 8 个模块包含价格或商品组合管道会存储的字段。以紧凑 JSON 序列化后,这 8 个模块共 16,494 字节,占整个结果对象的 15.9%。最大的模块是 SHIPPING大小为 34,071 字节;第二大模块是 GLOBAL_DATA大小为 23,783 字节。
完成签名只需要一次 MD5 哈希、一个 Cookie 和一次重试。如果你已经为其他阿里巴巴网站重新实现过 H5 签名方案,预计需要几小时即可完成。那么,你的签名代码能持续工作多久?
一个 IP 地址能成功发起多少次签名 API 调用
循环运行签名调用可以快速回答这个问题。测试使用 10 个商品 ID、一个令牌、一个住宅 IP 地址,调用之间不设延迟。脚本会统计网关返回的每个 ret 代码:
# continues the session from the signing code: pdp(), s and token are defined there
from collections import Counter
import re

# ten product IDs, replace any that were removed
IDS = ["3256812884305776", "1005007712136541", "1005002754717958", "1005002495501001",
       "2255799968025159", "1005008121783683", "3256809736486496", "1005008175462016",
       "1005012238762416", "3256812840307416"]

outcomes, first_fail = Counter(), None
for i in range(1, 61):
    r = pdp(s, IDS[i % len(IDS)], token)
    ret = re.search(r'"ret":\["([^"]+)"', r.text).group(1).split("::")[0]
    key = ret + (" +bxpunish" if r.headers.get("bxpunish") else "")
    outcomes[key] += 1
    if key != "SUCCESS" and first_fail is None:
        first_fail = i
print(dict(outcomes), "| first non-SUCCESS at", first_fail)
循环在第 7 次调用后便无法继续获取数据:
{'SUCCESS': 7, 'FAIL_SYS_USER_VALIDATE +bxpunish': 53} | first non-SUCCESS at 8每个被拦截响应的 ret 数组还包含 RGV587_ERROR::SM。
拦截会重复出现,但成功次数有所变化。从同一 IP 地址进行的第二轮测试以每秒 6.2 个请求的速率发送请求,记录每次调用的状态码和响应长度,60 次请求中有 15 次成功,并在第 12 次请求时首次遭到拦截。全部 60 次调用均返回 HTTP 200,其中 45 个被拦截响应的大小都恰好为 543 字节。因此,容量规划应以拦截情况为依据,而不是以两轮测试中的任一成功次数为依据。
新会话无法解除拦截。连续创建的 3 个新会话都从空 Cookie 容器开始,但客户端尚未获得令牌就被拦截了。等待 60 秒后再次从空 Cookie 容器发送请求,仍然遭到拦截。因此,自动重试只会增加流量,不会增加数据;代理工程师也警告说,这种重试逻辑会消耗预算,却不会产生任何可见错误。
该测试在调用之间没有设置延迟。接下来,应测试生产级爬虫会加入的变量,例如较长的退避时间、每批次使用新令牌、刻意降低请求速率,以及页面自身请求所签署的 ext 块。该块包含 crawler 标志和 x-m-biz-bx-region 密钥。
从第 7 次到第 60 次请求,签名始终正确,因此继续进行逆向工程不太可能提高 60 次请求中分别成功 7 次和 15 次的结果。测试排除了会话作为原因的可能性。没有任何测试分别单独更改 IP 地址和指纹,因此拦截可能取决于其中任一项。反爬系统还可以跨多个 IP 地址关联同一指纹,因此从业者通常会同时更改 IP 地址、指纹和 Cookie。
三项检查表明客户端并非问题根源。在 tls.peet.ws 指纹回显服务上,curl_cffi 0.16.1 中的签名代码与该计算机上的真实 Chromium 152 一致,二者具有相同的 JA4 指纹 t13d1516h2_8daaf6152771_806a8c22fdea 和相同的 HTTP/2 指纹。curl_cffi 和 Rust 库 rnet、wreq 提供的五种指纹产生了 100 个被拦截的响应,且未获得任何令牌,尽管 wreq 提供了比 curl_cffi 0.16.1 更新的 Chrome 配置文件。Patchright、nodriver 和 Camoufox 从该 IP 地址分别尝试了 8 次,成功次数均为 0;而使用不同出口 IP 的 Bright Data Browser API 在同一分钟成功返回了商品。
当这 3 个工具运行时,该 IP 地址已经被拦截,因此它们在该 IP 上都以相同方式失败。零成功率反映的是该 IP 地址的信誉,并不能用于比较这些工具的优劣。
第一项检查是 TrackMe 位于 tls.peet.ws 的指纹回显服务,它可以通过单个请求返回所有指纹:
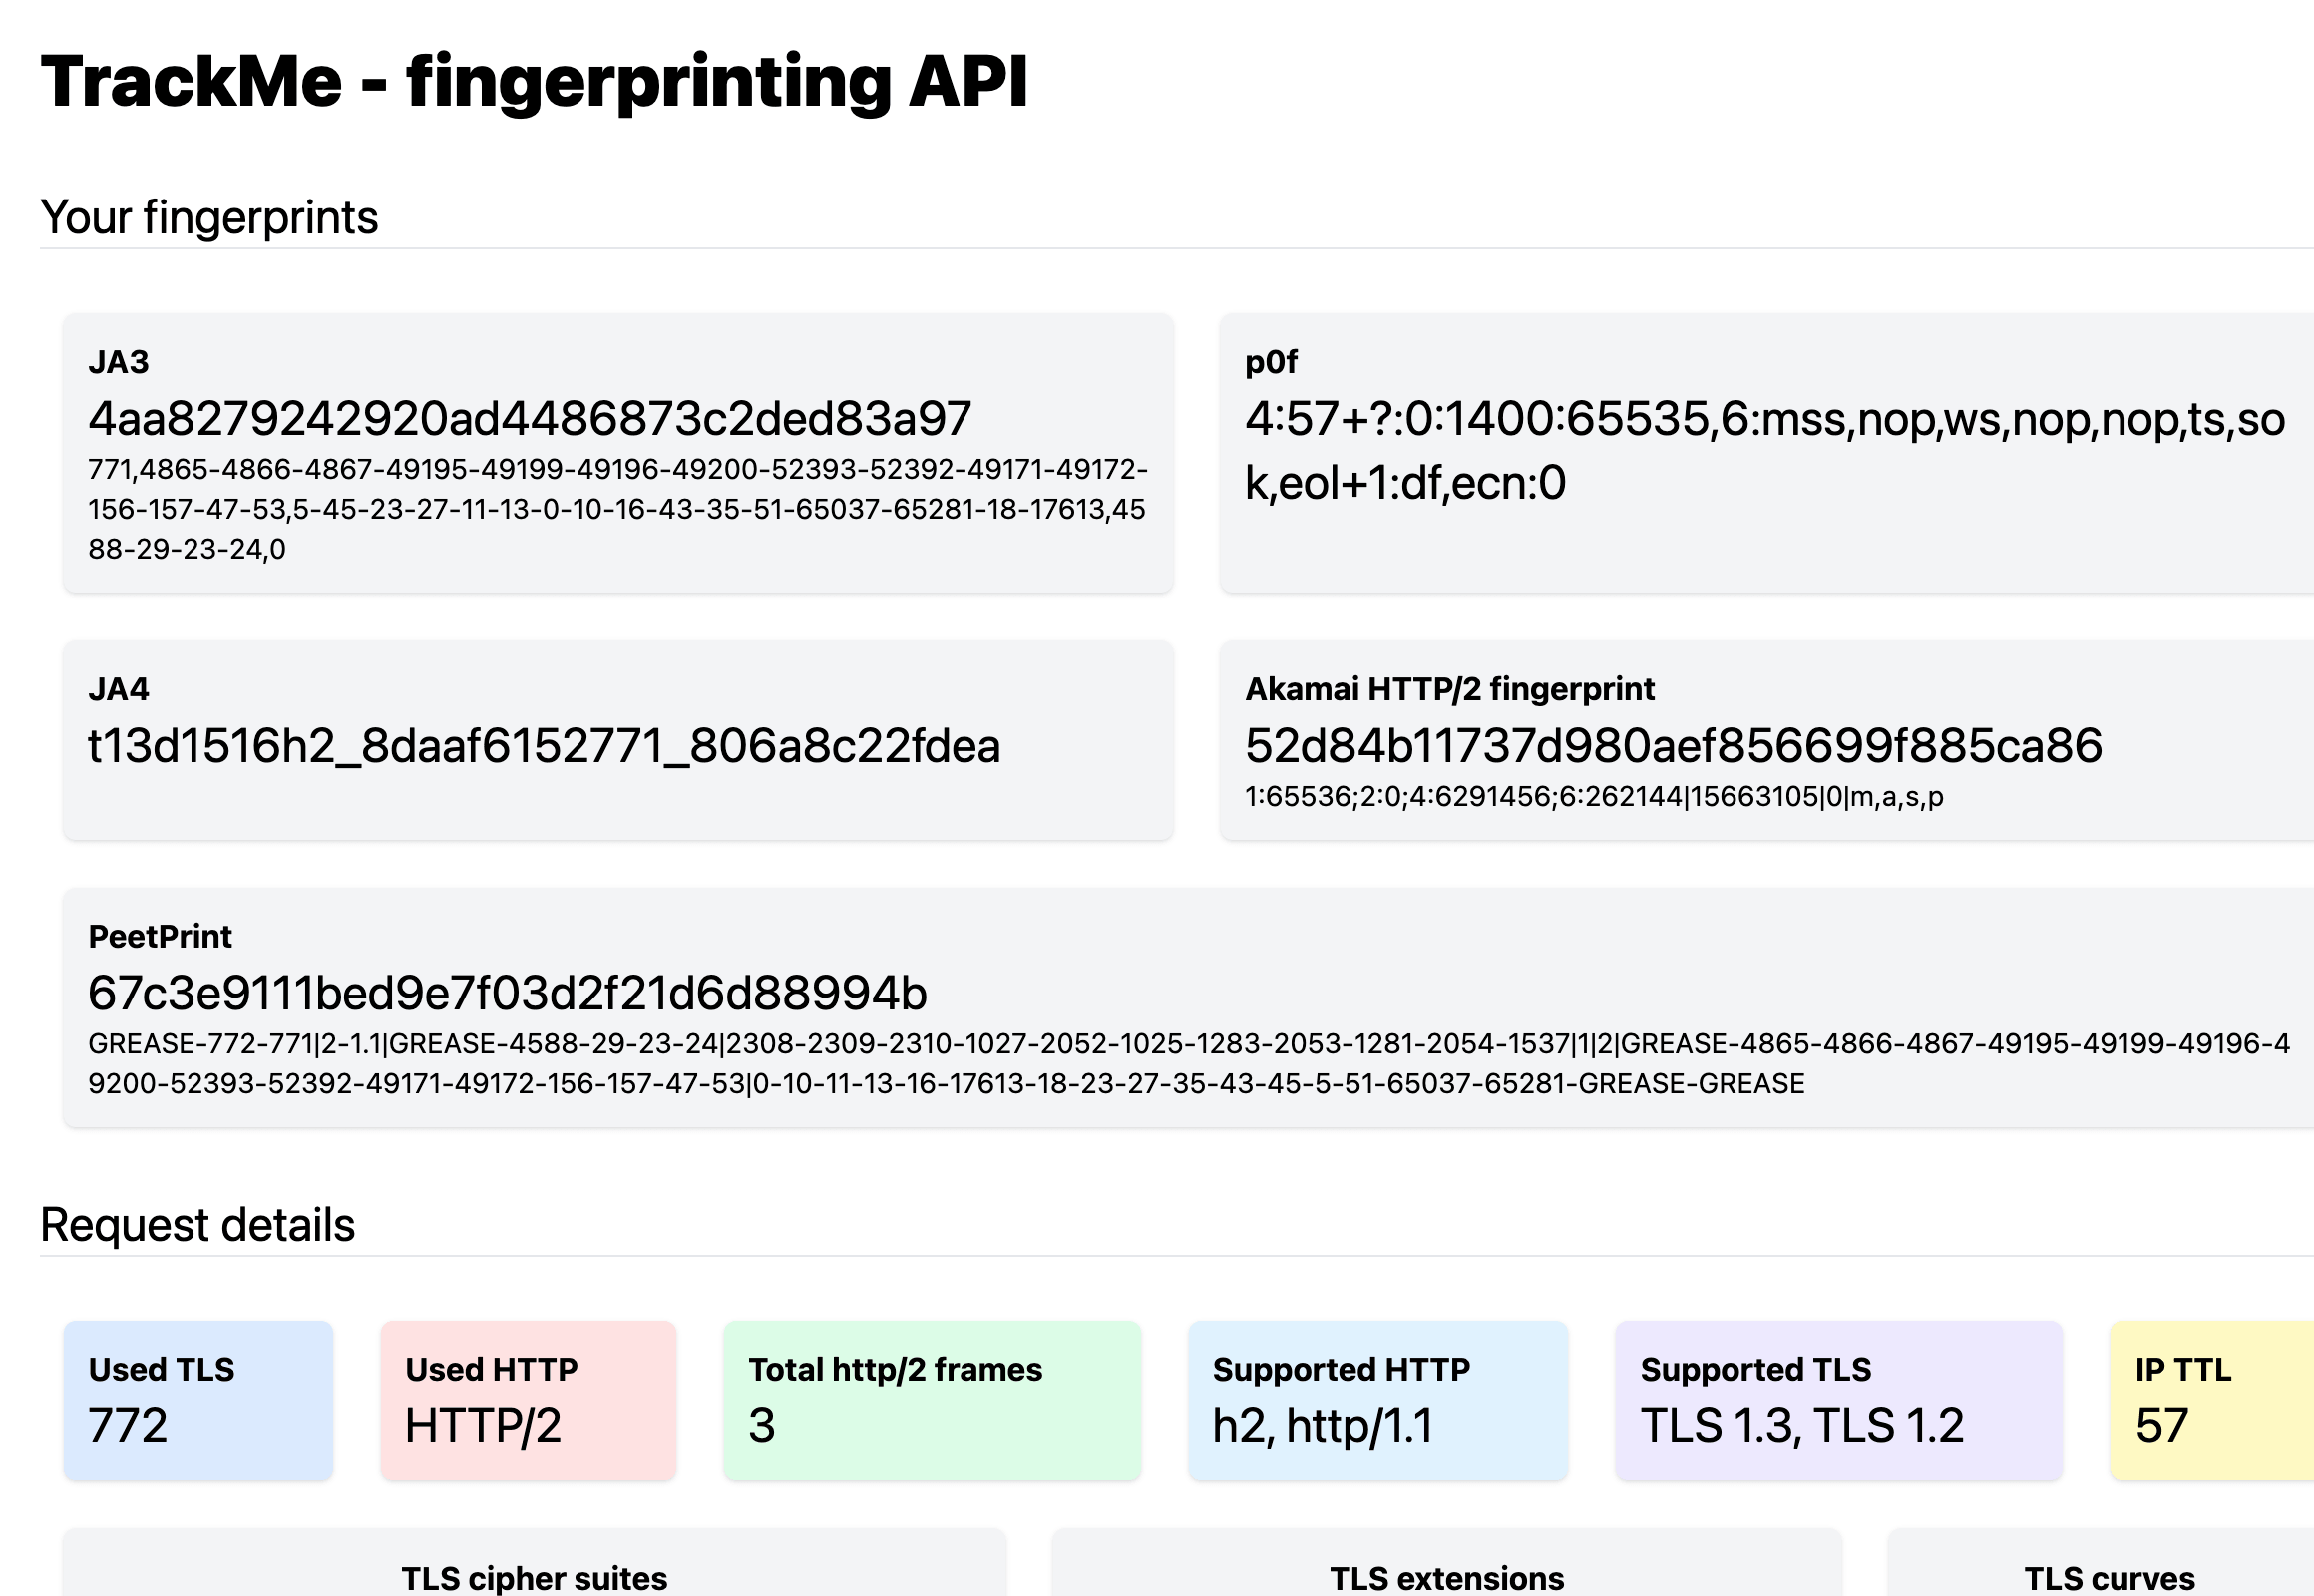
检查配置文件是否同时复现其对应浏览器的 JA4 指纹和 HTTP/2 指纹。
在这里,更新的配置文件并没有带来更好的匹配效果。wreq Chrome 152 配置文件发送的 ClientHello 包含 17 个扩展,而 Chrome 152 本身发送 16 个。配置文件名称中的版本号并不能保证它实际发送的指纹,因此在信任配置文件之前,应使用指纹回显服务检查每个配置文件。在这里,curl_cffi 的默认配置文件与真实浏览器完全匹配。
逆向工程签名端点可以告诉你数据的结构,但无法告诉你能够采集多少数据。在这些测试中,更好的签名和更好的浏览器都没有提高数据采集量。
让页面代你签署商品 API 调用
获取商品有效负载的第二种方式是使用浏览器自动化,而不是从自己的代码发起 API 调用。页面本身已经会发起签名调用。你只需附加响应处理程序,并读取页面收到的响应。通过 Browser API,页面请求还会经由 Bright Data 的代理网络发送。
读取页面自身的响应后,你的代码中就不再需要处理令牌、时间戳、MD5 签名和 Cookie 容器:
import json, re
from playwright.sync_api import sync_playwright

WSS = "wss://brd-customer-<id>-zone-<zone>:<password>@brd.superproxy.io:9222"

def capture_pdp(product_id):
    """Read the response to the call the page already makes."""
    bodies = []

    def keep(response):
        if "mtop.aliexpress.pdp.pc.query" not in response.url:
            return
        try:
            bodies.append(response.text())
        except Exception:
            pass                      # redirects and closed pages have no readable body

    with sync_playwright() as pw:
        browser = pw.chromium.connect_over_cdp(WSS, timeout=150_000)
        ctx = browser.contexts[0] if browser.contexts else browser.new_context()
        page = ctx.new_page()
        page.on("response", keep)
        try:
            page.goto(f"https://www.aliexpress.com/item/{product_id}.html",
                      wait_until="domcontentloaded", timeout=150_000)
            page.wait_for_timeout(13_000)
        except Exception:
            pass                      # keep whatever keep() collected before navigation ended
        browser.close()

    for body in sorted((b for b in bodies if isinstance(b, str)), key=len, reverse=True):
        m = re.match(r"\s*mtopjsonp\d*\((.*)\)\s*$", body, re.S)
        try:
            result = json.loads(m.group(1) if m else body).get("data", {}).get("result")
        except (ValueError, AttributeError):
            continue                  # skip a body that is not JSON, such as an HTML page
        if isinstance(result, dict) and len(result) > 10:
            return result
    return None

result = capture_pdp("1005001398867186")
if result:
    print(len(result["PRICE"]["skuIdStrPriceInfoMap"]), "SKUs priced")
WSS 连接到一个 Browser API 区域其 3 个占位符来自该区域的访问详情:
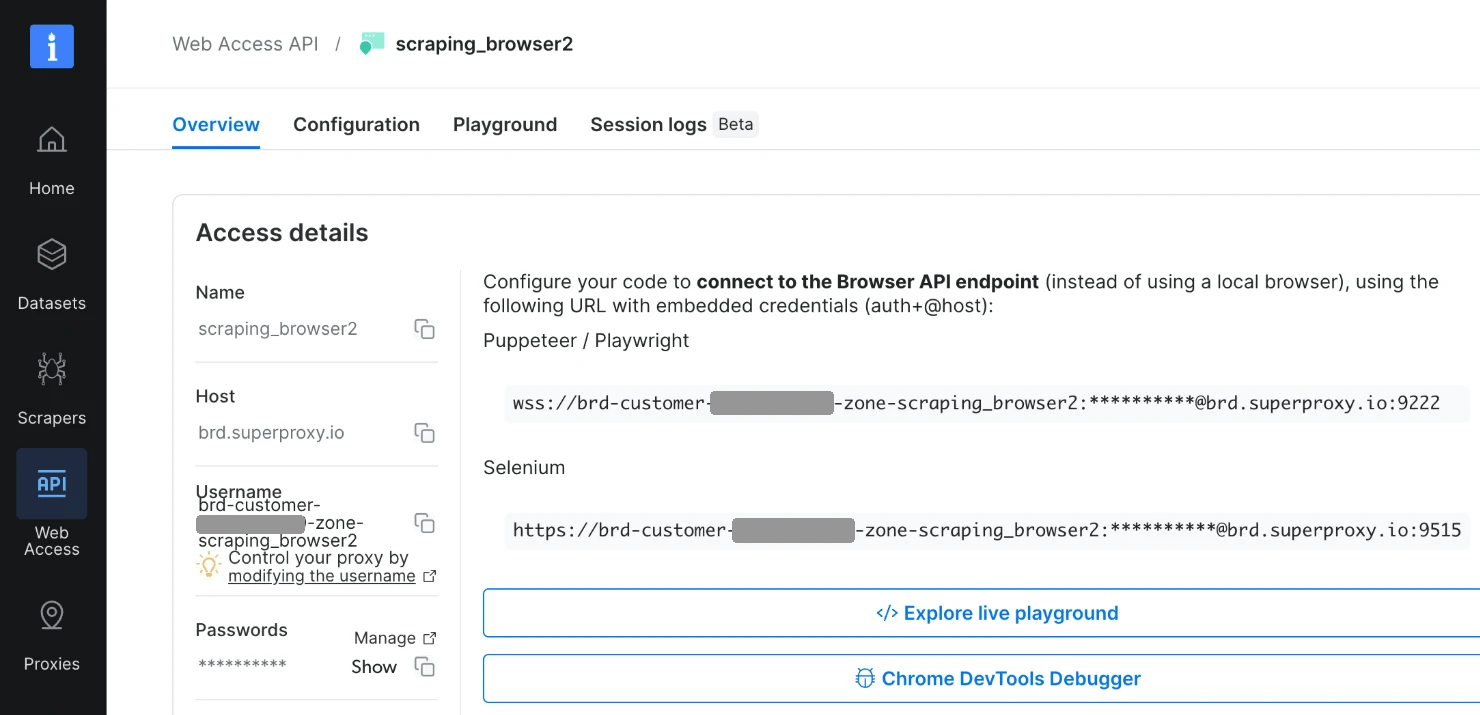
Puppeteer / Playwright 行是 WSS 所需的值,你的账户 ID、区域名称和密码用于填充其中 3 个占位符。此处已隐藏账户 ID,控制面板也会遮盖密码。
保留每个响应,而不只是第一个。页面每次加载都会多次调用该端点。记录 keep() 所采集的每个响应正文的大小,即可判断哪个响应包含商品:
3256812884305776  sizes=[151, 170539]          141 SKUs priced
1005007712136541  sizes=[151, 244023]           75 SKUs priced
1005002754717958  sizes=[151, 105852, 106046]   20 SKUs priced
1005002495501001  sizes=[151,  96065]           18 SKUs priced
2255799968025159  sizes=[151,  93982]           15 SKUs priced
1005008121783683  sizes=[151,  63780]            6 SKUs priced
151 字节的响应用于设置令牌 Cookie。其后的大型响应正文包含商品记录,包括 SKU 价格映射。如果一次加载中出现多个大型响应capture_pdp 会返回最大的一个。
AliExpress robots.txt 文件允许什么
选择方法前应先阅读 robots.txt 文件。如果其中某条指令你不熟悉,我们的网页抓取 robots.txt 指南提供了相关说明。API 主机与主站主机上的文件规则不同:
$ curl -s https://acs.aliexpress.com/robots.txt
User-agent: *
Disallow: /

$ curl -s https://www.aliexpress.com/robots.txt | grep -E '/item'
Disallow: */aeglodetailweb/api/msite/item?productId*
Disallow: /items/*
Disallow: /item-img/*
Disallow: /item-img/*
MTOP 网关被完全禁止抓取。在主站主机上,所有提到 item 的规则都适用于其他对象(/items/*、/item-img/*以及针对 aeglodetailweb 端点的 Googlebot 规则)。没有任何规则适用于 /item/1005001398867186.html而整个 /search/* 都被禁止。对于 robots.txt 允许的路径,请使用 Bright Data 的住宅代理或下文介绍的方法之一。
还应检查主站主机的站点地图和智能体清单文件。.com robots.txt 列出了商品站点地图,第一个站点地图文件包含 31,999 个 /item/ URL,因此站点地图是商品 ID 的直接来源。测试中,6 个智能体清单路径(/llms.txt 和 /ai.txt以及 /.well-known/ 下的 agent.json、ai-plugin.json、mcp.json 和 acp.json)都通过 302 重定向到 /p/error/404.html。
www.aliexpress.us/robots.txt 与 .com 文件包含相同规则,但没有站点地图行。由于网站会根据地区在这两个主机之间重定向访问者,因此这些规则适用于两个主机。m.aliexpress.com 发布了一个更长的文件,其中包含自己的 AdsBot 规则,因此应检查你实际调用的主机。
有一个 AliExpress 主机公布了一条例外规则,这是所有这些文件中唯一允许的签名 API 路径。recom-acs.aliexpress.com 提供 Disallow: /后跟 Allow: /h5/mtop.relationrecommend.aliexpressseorecommend.recommend/*。使用刻意不完整的有效负载调用该端点时,它返回了不含 bxpunish 标头的 FAIL_SYS_BIZPARAM_MISSED;被禁止的端点则返回带有该标头的 FAIL_SYS_USER_VALIDATE。因此,robots.txt 和反爬系统都允许访问同一端点。
商品页面与网关正好相反。AliExpress 会公开提供商品页面,robots.txt 并未禁止访问它,而且测试中 3 种 Bright Data 产品都成功访问了该页面。在美国区域设置测试中,网络解锁器渲染结果、网关响应和爬虫 API 记录都包含相同的 $6.84 促销价。
爬虫网站公开的页面,并让你的基础设施处理 IP 地址和指纹。这种方法不太可能因网站改版或签名变化而失效;而从网站 JavaScript 软件包复制的签名程序会在任一变化发生后都需要重写。
大规模爬虫 AliExpress 的 3 种方法
Bright Data 的 Browser API、网络解锁器和爬虫 API 分别以不同形式提供商品数据。我们的网络解锁器与 Browser API 对比介绍了它们的一般区别。在控制面板的爬虫工具库中搜索 AliExpress,即可查看该域名可用的爬虫工具:
一次搜索即可返回该域名的爬虫工具和一个可直接使用的 AliExpress 数据集。
Browser API 可在内置解锁功能的托管云浏览器中运行你的脚本,并让脚本读取页面收到的网络响应。当我通过 CDP 连接 Playwright 并加载商品页面时,页面显示了标题和包含价格的购买框,而我的脚本能够读取这次加载产生的全部 171 个响应。Browser API 还支持地理位置定向,因此购买框会使用你所选出口国家的货币显示价格。若要获取美国价格,请将 -country-us 附加到区域用户名。
Browser API 定价按流量 GB 计费,因此可根据页面大小在运行前估算成本。在 3 次加载中,CDP 的 Network.loadingFinished 事件所传输的字节数平均为每个商品页面 3.03 MB,范围为 2.68 MB 至 3.47 MB。Playwright 的 networkidle 会等待连续 500 毫秒没有请求,但该页面会持续在后台发送请求。因此capture_pdp 会先等待 domcontentloaded再等待一段固定时间。
网络解锁器负责处理解锁、渲染页面并返回一个文档。它为商品页面生成的原始输出为 344,355 字节,而页面外壳只有 77,226 字节,说明 JavaScript 已运行。该页面的 markdown 输出包含 21 KB 至 24 KB 文本,可由 LLM 或正则表达式直接读取。Bright Data CLI 中的 brightdata scrape 命令默认使用 markdown 输出。
网络解锁器定价按请求计费,而且只为成功的请求付费。在每个请求中设置 country 即可选择站点区域。
AliExpress 爬虫工具 API 返回结构化数据。你发送商品 URL,然后接收已经提取好字段的记录,例如标题、标价和促销价、可用性、规格、卖家、评分、评论和图片 URL。AliExpress 图片爬虫工具 API专门用于图片数据。爬虫 API 定价按交付记录计费,因此你只需为结果付费。
| 产品 | 计价单位 | 你会获得什么 | 适用场景 |
|---|---|---|---|
| Browser API | 流量 GB | 浏览器会话和页面的网络响应 | 你需要页面自身的 API 响应,例如每个变体的价格 |
| 网络解锁器 | 成功请求 | 由你解析的渲染后 HTML 或 markdown | 你已经在维护解析器,或需要将页面发送给 LLM |
| 爬虫 API | 交付记录 | 结构化商品记录 | 你需要的是记录,而不是页面 |
运行自己的浏览器是第四种选择,因此我也进行了测量。3 种隐身浏览器(Patchright、nodriver 和 Camoufox)均为开源工具,每次加载平均耗时 14.1 至 15.9 秒。这个时间只是最低值,因为 24 次加载都没有获取到商品数据,而成功加载还需要额外时间解析数据。
在一个已被拦截的 IP 地址上,3 种隐身浏览器都返回了页面的页眉和页脚,但没有商品数据。每种 Bright Data 产品都内置代理,而你自己运行的浏览器也可以使用 Bright Data 的 AliExpress 代理。
大规模运行爬虫 API
爬虫 API 在一个端点接收 URL,并在另一个端点返回记录。其控制面板页面会在一个可直接运行的请求旁显示两种抓取模式:
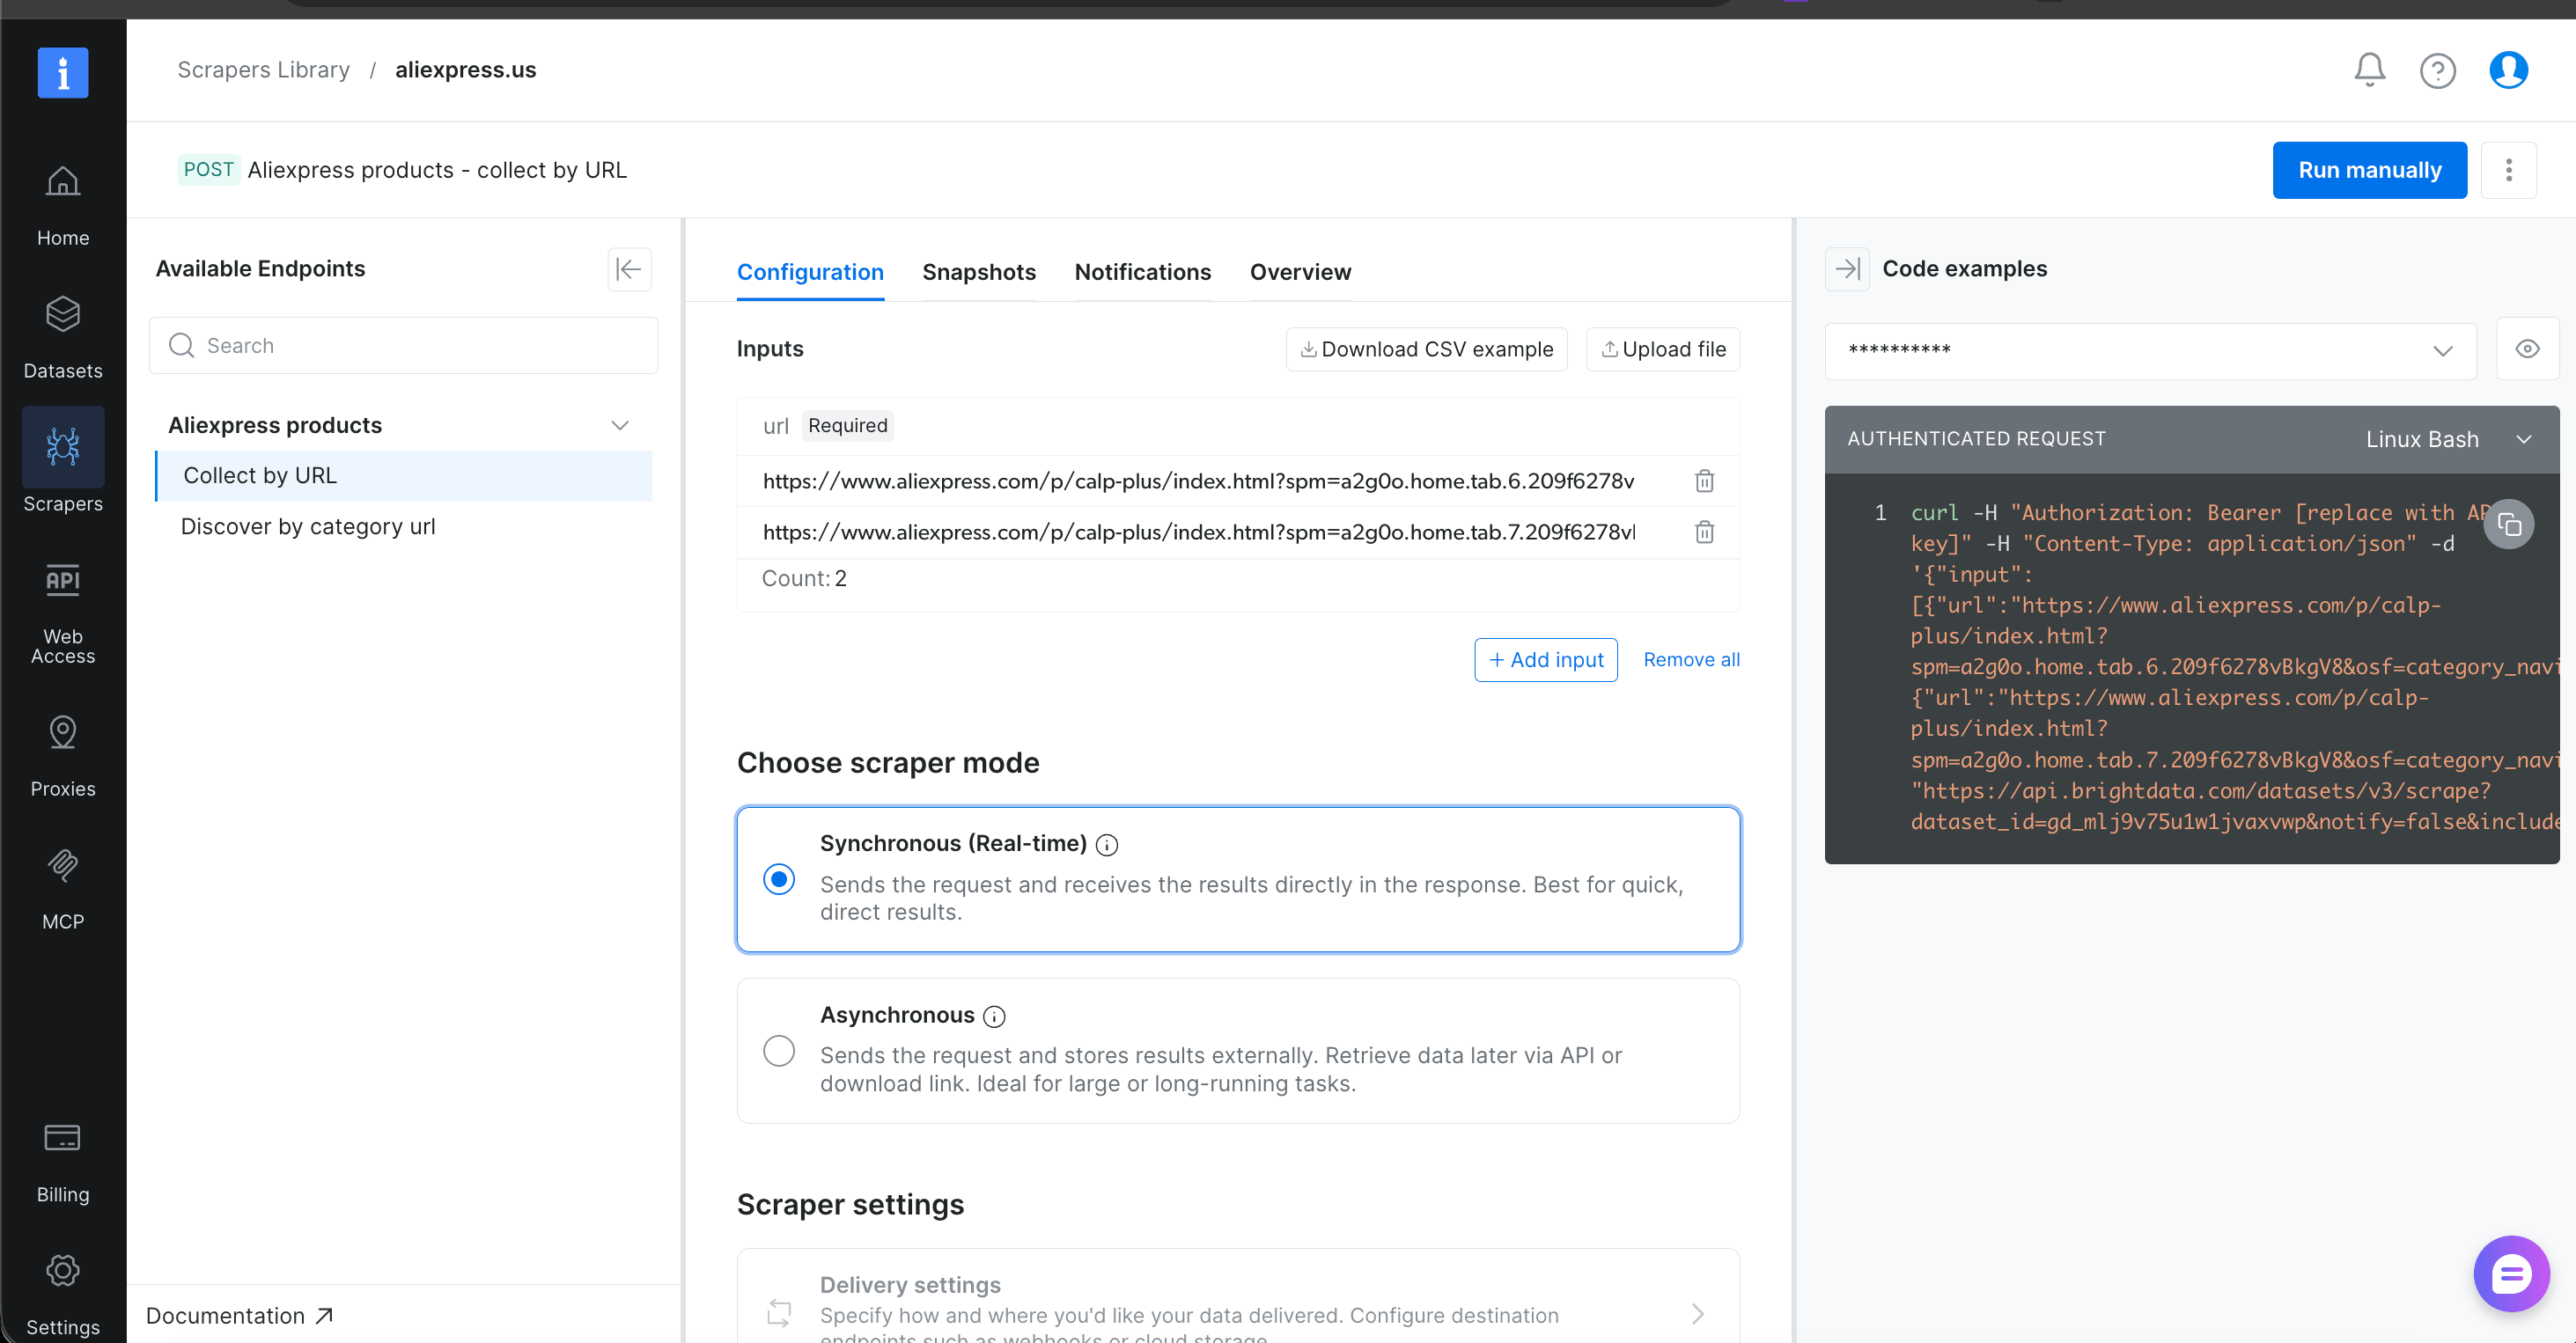
左侧面板列出该域名的两个端点:按 URL 采集和按分类 URL 发现。右侧代码示例中的 dataset_id 与下方脚本使用的值相同。
当采集耗时较长时同步模式会返回 snapshot_id而采集会继续在后台运行。对于完整目录,应分块触发异步采集并在每个分块完成后保存进度。这样,即使进程崩溃,任务也能继续运行,你也无需为相同 URL 重复付费:
import json, os, time, requests

API = "https://api.brightdata.com/datasets/v3"
DATASET = "gd_mlj9v75u1w1jvaxvwp"          # AliExpress products
TOKEN = os.environ["BRIGHTDATA_API_KEY"]   # API key from your account settings
CHUNK = 40                                 # larger triggers ran faster per input
H = {"Authorization": f"Bearer {TOKEN}", "Content-Type": "application/json"}

def _await(snapshot, timeout=3600, poll=20):
    deadline = time.time() + timeout
    while time.time() < deadline:
        p = requests.get(f"{API}/progress/{snapshot}", headers=H, timeout=60).json()
        if p.get("status") in ("ready", "failed"):
            return p
        time.sleep(poll)
    raise TimeoutError(snapshot)

def _save(state, state_path):
    with open(state_path, "w") as fh:
        json.dump(state, fh)

def run(urls, state_path="run_state.json", out_path="rows.jsonl"):
    state = {"done": {}, "dead": []}
    if os.path.exists(state_path):
        with open(state_path) as fh:
            state = json.load(fh)

    for n in range(0, len(urls), CHUNK):
        key = str(n // CHUNK)
        done = state["done"].get(key, {})
        if done.get("records") is not None:     # finished means downloaded, not triggered
            continue
        batch, t0 = urls[n:n + CHUNK], time.time()
        snapshot = done.get("snapshot")         # triggered before a crash: reuse that snapshot
        if not snapshot:
            r = requests.post(f"{API}/trigger?dataset_id={DATASET}&include_errors=true",
                              headers=H, json={"input": [{"url": u} for u in batch]},
                              timeout=120)
            r.raise_for_status()
            snapshot = r.json()["snapshot_id"]
            state["done"][key] = {"snapshot": snapshot}
            _save(state, state_path)            # record the trigger BEFORE the wait

        print(f"chunk {key}: collecting {len(batch)} URLs")
        progress = _await(snapshot)
        rows = requests.get(f"{API}/snapshot/{snapshot}?format=json",
                            headers=H, timeout=600).json()
        with open(out_path, "a") as fh:
            for row in rows:
                if row.get("error_code") == "dead_page":   # listing removed on AliExpress
                    state["dead"].append(row["input"]["url"])
                elif not row.get("error"):
                    fh.write(json.dumps(row) + "\n")
        state["done"][key].update(records=progress.get("records"), errors=progress.get("errors"))
        _save(state, state_path)
        print(f"chunk {key}: collected at {(time.time() - t0) / len(batch):.1f}s per input")

    return state

run(["https://www.aliexpress.com/item/1005001398867186.html"])   # pass your full URL list
include_errors=true 会将错误报告添加到结果中,因此列表中的每个 URL 都有对应状态。
rows.jsonl 中的每一行都是一条商品记录。此脚本会输出第一条记录中的几个字段:
import json

with open("rows.jsonl") as fh:
    row = json.loads(fh.readline())
for key in ("item_id", "title", "brand", "price", "sale_price",
            "availability", "star_rating", "review_count"):
    print(f"{key:13s}", row[key])
print("variants     ", [o["option_name"] for o in row["variants"][0]["variant_options"]])
输出显示了第一节中的断路器:
item_id       1005001398867186
title         TOMZN Main Switch Residual Current Circuit Breaker With Surge Protector RCBO MCB With Lightning Protection SPD
brand         TOMZN
price         $14.40
sale_price    $8.40
availability  in_stock
star_rating   4.7
review_count  80
variants      ['16A', '20A', '25A', '32A', '40A', '50A', '63A']
标价、来自 80 条评论的 4.7 评分,以及 7 个 rated-current 变体都与第一节中渲染后的页面一致。促销价来自临时促销,因此不同采集时间的结果有所不同。
让每个分块都保持满载。在这些测试中,包含 40 个 URL 的触发任务按每个 URL 计算,比包含 20 个 URL 的任务快 2.8 倍。可以用下一轮运行中的 URL 填满最后一个分块,使其以完整规模运行。对于数十万个 URL,可让 Bright Data 将每个快照交付到你的云存储或 webhook,这样无需轮询即可接收结果。
使用同一个状态文件再次运行 run() 时,任务在 0.08 秒内完成,没有发送任何触发请求,也没有写入重复记录。该脚本还可以处理进程在等待期间崩溃前已触发的分块。只有在记录已下载时,它才会跳过分块;否则,它会复用已保存的快照,因此等待期间发生崩溃也不会丢失已采集的快照。
测量价格变化频率,然后让采集计划与该频率匹配。在一次检查中,我对 12 件商品进行了两次采集,间隔 25 分钟,其价格均未变化。该样本无法反映价格变化率,因此应参考方法,而不是这一结果。按照你正在考虑的时间间隔,对自己的商品采集两次快照,即可获得适用于你目录的答案。
发现功能,即抓取工具的按分类发现端点,可从种子 URL 中列出商品。使用批发搜索页面 /w/wholesale-ergonomic-chair.html 作为种子时type=discover_new&discover_by=category_url 请求在第一次运行中就返回了商品 URL。使用 /w/wholesale-<keyword>.html 作为种子 URL 模式,在校准期间通过 limit_per_input 限制每次发现运行的规模,并将返回的 URL 直接传递给采集任务。
如果你从其他位置采集商品 ID,例如商品站点地图或商品页面的 SEO 链接,只需一个无需渲染的 GET 请求,就能检查每个 ID 是否仍有对应商品页面。商品页面返回 77.2 至 77.4 KB 的响应,并包含已填充的 og:title;而从这些 SEO 链接采集的 3 个 ID 返回 75.26 KB 响应,其中每个 og: 字段均为空。在原始响应中可以明显看到这 2 KB 的差异,因此应在将 ID 加入采集队列前,删除 og: 字段为空的 ID。
确保价格数据可比的 2 项检查
这些数据需要接受与 HTTP 响应相同的验证。以下两项检查都很容易添加,并能帮助你在不可比价格进入控制面板前发现问题。
折扣会随出口国家变化,而不只是货币不同。我通过网络解锁器以 markdown 格式从 6 个出口国家获取了同一个商品 ID,每个国家都返回了不同的促销:
| 出口国家 | 货币 | 促销价 | 标价 | 折扣 |
|---|---|---|---|---|
| 美国 | USD | $6.84 | $14.40 | 52.5% |
| 英国 | GBP | £9.83 | £11.16 | 11.9% |
| 德国 | EUR | 11,69€ | 13,29€ | 12.0% |
| 巴西 | BRL | R$62,25 | R$68,30 | 8.9% |
| 澳大利亚 | AUD | AU$18.59 | AU$19.42 | 4.3% |
| 加拿大 | CAD | C$19.86 | C$20.70 | 4.1% |
即使折扣百分比也无法直接比较,而每个页面都说明了原因。美国购买框将其价格标记为 Ends :因此美国这一行是特定时刻采集的限时优惠。英国页面显示 Price includes VAT而美国页面显示 Tax excluded。德国页面标明 30-day lowest price before the discount这是欧盟参考价格规则,通常会让德国的折扣看起来更小。
由于这 3 项差异,应为每个价格序列设置一个固定出口国家,将其存储在记录行中,并且只将同一序列与自身比较。网络解锁器通过 country 参数设置出口国家,Browser API 则通过区域用户名上的 -country-<code> 后缀设置。如果你需要的是促销本身,而不是价格管道AliExpress 促销跟踪器可以为你监控竞品促销。
英国英镑符号使用的是全角字符。英国站点使用 £即 U+FFE1 FULLWIDTH POUND SIGN,因此使用 £(U+00A3)编写的货币正则表达式不会匹配任何内容。德国和巴西站点的价格字段使用逗号作为小数分隔符。应根据你请求的站点设置解析货币,并将数值解析与符号解析分开处理。
每个变体的价格和完整分类路径
Bright Data 的 Browser API 可以从 AliExpress 商品页面采集 SKU 价格映射,而网络解锁器会从页脚返回分类面包屑。评论也有专用抓取工具,即 AliExpress 评论爬虫工具其记录包含商品 ID 和 URL。
页面自身的响应包含 SKU 价格映射。使用 capture_pdp 记录的采集结果分别包含 141、75、20、18、15 和 6 个 SKU 的价格。对于其中一件商品,价格映射包含 6 个不同价格,范围从 2.56 到 10.96。该映射位于 PRICE 模块中,与预选 SKU 和 region 字段相邻:
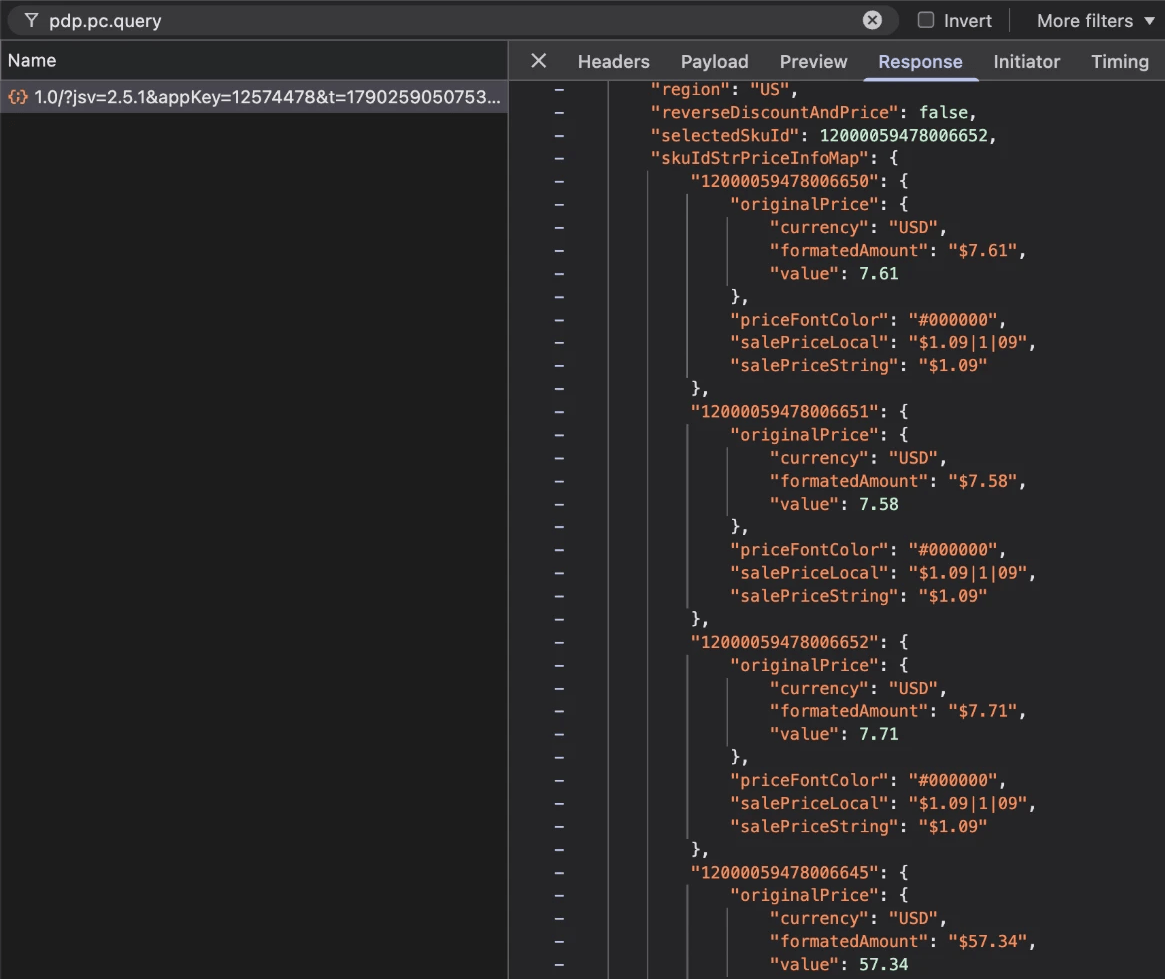
此采集结果来自一个多件装商品。页面预选的是价格为 $1.09 的 1 件装,第四项是标价 $57.34 的 10 件装,因此该映射包含每个变体各自的价格。
要获取每个变体的价格,请通过 Browser API 运行 capture_pdp、读取 PRICE.skuIdStrPriceInfoMap并使用 item_id 作为键进行存储。应从你所需价格对应的地区读取映射,因为它也可能因地区而异。对于第一节中的断路器,该映射在美国会话中包含不同的变体价格,而在另一个地区中,全部 7 个变体只有一个统一价格。
网络解锁器 markdown 包含分类路径。渲染后的页面在页脚中以面包屑形式列出商品分类,网关的 GLOBAL_DATA.globalData 也在其 categoryPath 字段 13/5/141914 中包含相同路径。以下解析器将商品页面读取为网络解锁器 markdown,这也是 brightdata scrape 默认返回的格式:
import re

CRUMB   = re.compile(r"^This product belongs to\s.*$", re.M)
CAT_URL = re.compile(r"/category/(\d+)/([a-z0-9-]+)\.html")

def categories_from_markdown(md):
    """Category IDs and URLs from the product page footer."""
    line = CRUMB.search(md)
    if not line:
        return []
    return [{"category_id": cid,
             "url": f"https://www.aliexpress.com/category/{cid}/{slug}.html"}
            for cid, slug in CAT_URL.findall(line.group(0))]

with open("page.md", encoding="utf-8") as fh:    # brightdata scrape <product URL> -o page.md
    print(categories_from_markdown(fh.read()))
第一个模式末尾的 \s 必不可少,因为页脚会在 to 后立即放置 U+00A0,即不换行空格。使用普通字面空格编写相同模式将无法找到匹配项。使用 \s 后,解析器会返回分类路径:
[{'category_id': '13',     'url': '.../category/13/home-improvement.html'},
 {'category_id': '5',      'url': '.../category/5/electrical-equipments-supplies.html'},
 {'category_id': '141914', 'url': '.../category/141914/circuit-breakers.html'}]
获取分类路径需要为每件商品发送一个网络解锁器请求。对需要分类体系的商品运行解析器,并使用 item_id 作为键存储结果。页脚文案可能随时变化,因此如果解析器返回空列表,请先检查 CRUMB 模式。
爬虫工具 Studio 可处理自定义字段列表。当你描述所需数据时,其 AI 会生成一个内置代理和解锁功能、可直接运行的爬虫工具,而且你之后还可以添加或更改输出字段。对于价格监控AliExpress 价格爬虫工具 API会采集 AliExpress 定价数据,帮助你跟踪价格变化。
检测页面和架构变化
在此目标上观察到的所有故障都是静默发生的,因此应监控页面本身。页面的引导脚本包含构建版本 cosmos_prefetch_mtop version 20240605.195626.856当该版本发生变化时,预获取配置也可能随之变化。指纹可直接检测这种变化。若没有指纹,你自己的爬虫只会将其表现为空值。
以下两个指纹会检查 3 个阶段(HTML 外壳、渲染后页面和交付的记录行),且都不依赖于解析商品字段:
import hashlib, re

def shell_fingerprint(html):
    """From an unrendered GET. Detects a bootstrap or prefetch-config change."""
    view = re.search(r"viewName\s*=\s*'([^']+)'", html)
    api  = re.search(r"api:\s*'(mtop\.[^']+)'", html)
    ver  = re.search(r"cosmos_prefetch_mtop version ([\d.]+)", html)
    return {"viewName": view.group(1) if view else None,
            "prefetch_api": api.group(1) if api else None,
            "gop_version": ver.group(1) if ver else None}

def row_fingerprint(row):
    """From a delivered row. Confirms the field set your pipeline expects."""
    keys = sorted(k for k in row if k not in ("input", "timestamp"))
    return {"fields_sha1": hashlib.sha1(",".join(keys).encode()).hexdigest()[:12]}
在真实采集结果中,这两个指纹都返回了稳定值:
shell   unrendered GET : viewName=newDetail  api=mtop.aliexpress.pdp.pc.query  gop=20240605.195626.856
shell   rendered DOM   : viewName=newDetail  api=mtop.aliexpress.pdp.pc.query  gop=20240605.195626.856
row     1005012408061151 : fields_sha1=154f2f84da5f
row     1005001398867186 : fields_sha1=154f2f84da5f
row 1005011666876666 : fields_sha1=154f2f84da5f对采集的有效负载生成第三个指纹看似有用,但可能导致误报。对模块集合进行哈希看起来采用了同样的思路,但模块数量不仅会随新部署变化,还会因商品和采集时间而异。采集的有效负载分别包含 28、27 和 28 个模块,而且其中两个负载的 PRICE 键集合不同。
同一件商品的模块数量也会变化。同一个商品 ID 在相隔几分钟的两次采集中分别返回 27 个和 26 个模块,因此即使是单件商品的历史记录,也需要设置阈值,而不能执行相等性检查。应根据页面外壳和记录行指纹设置警报,因为它们的值在每次采集中都保持不变。
何时应改为获取 AliExpress 数据集
上述 3 种方法都从你已有的 URL 开始。如果你的问题涉及整个市场,应从可直接使用的数据集开始:
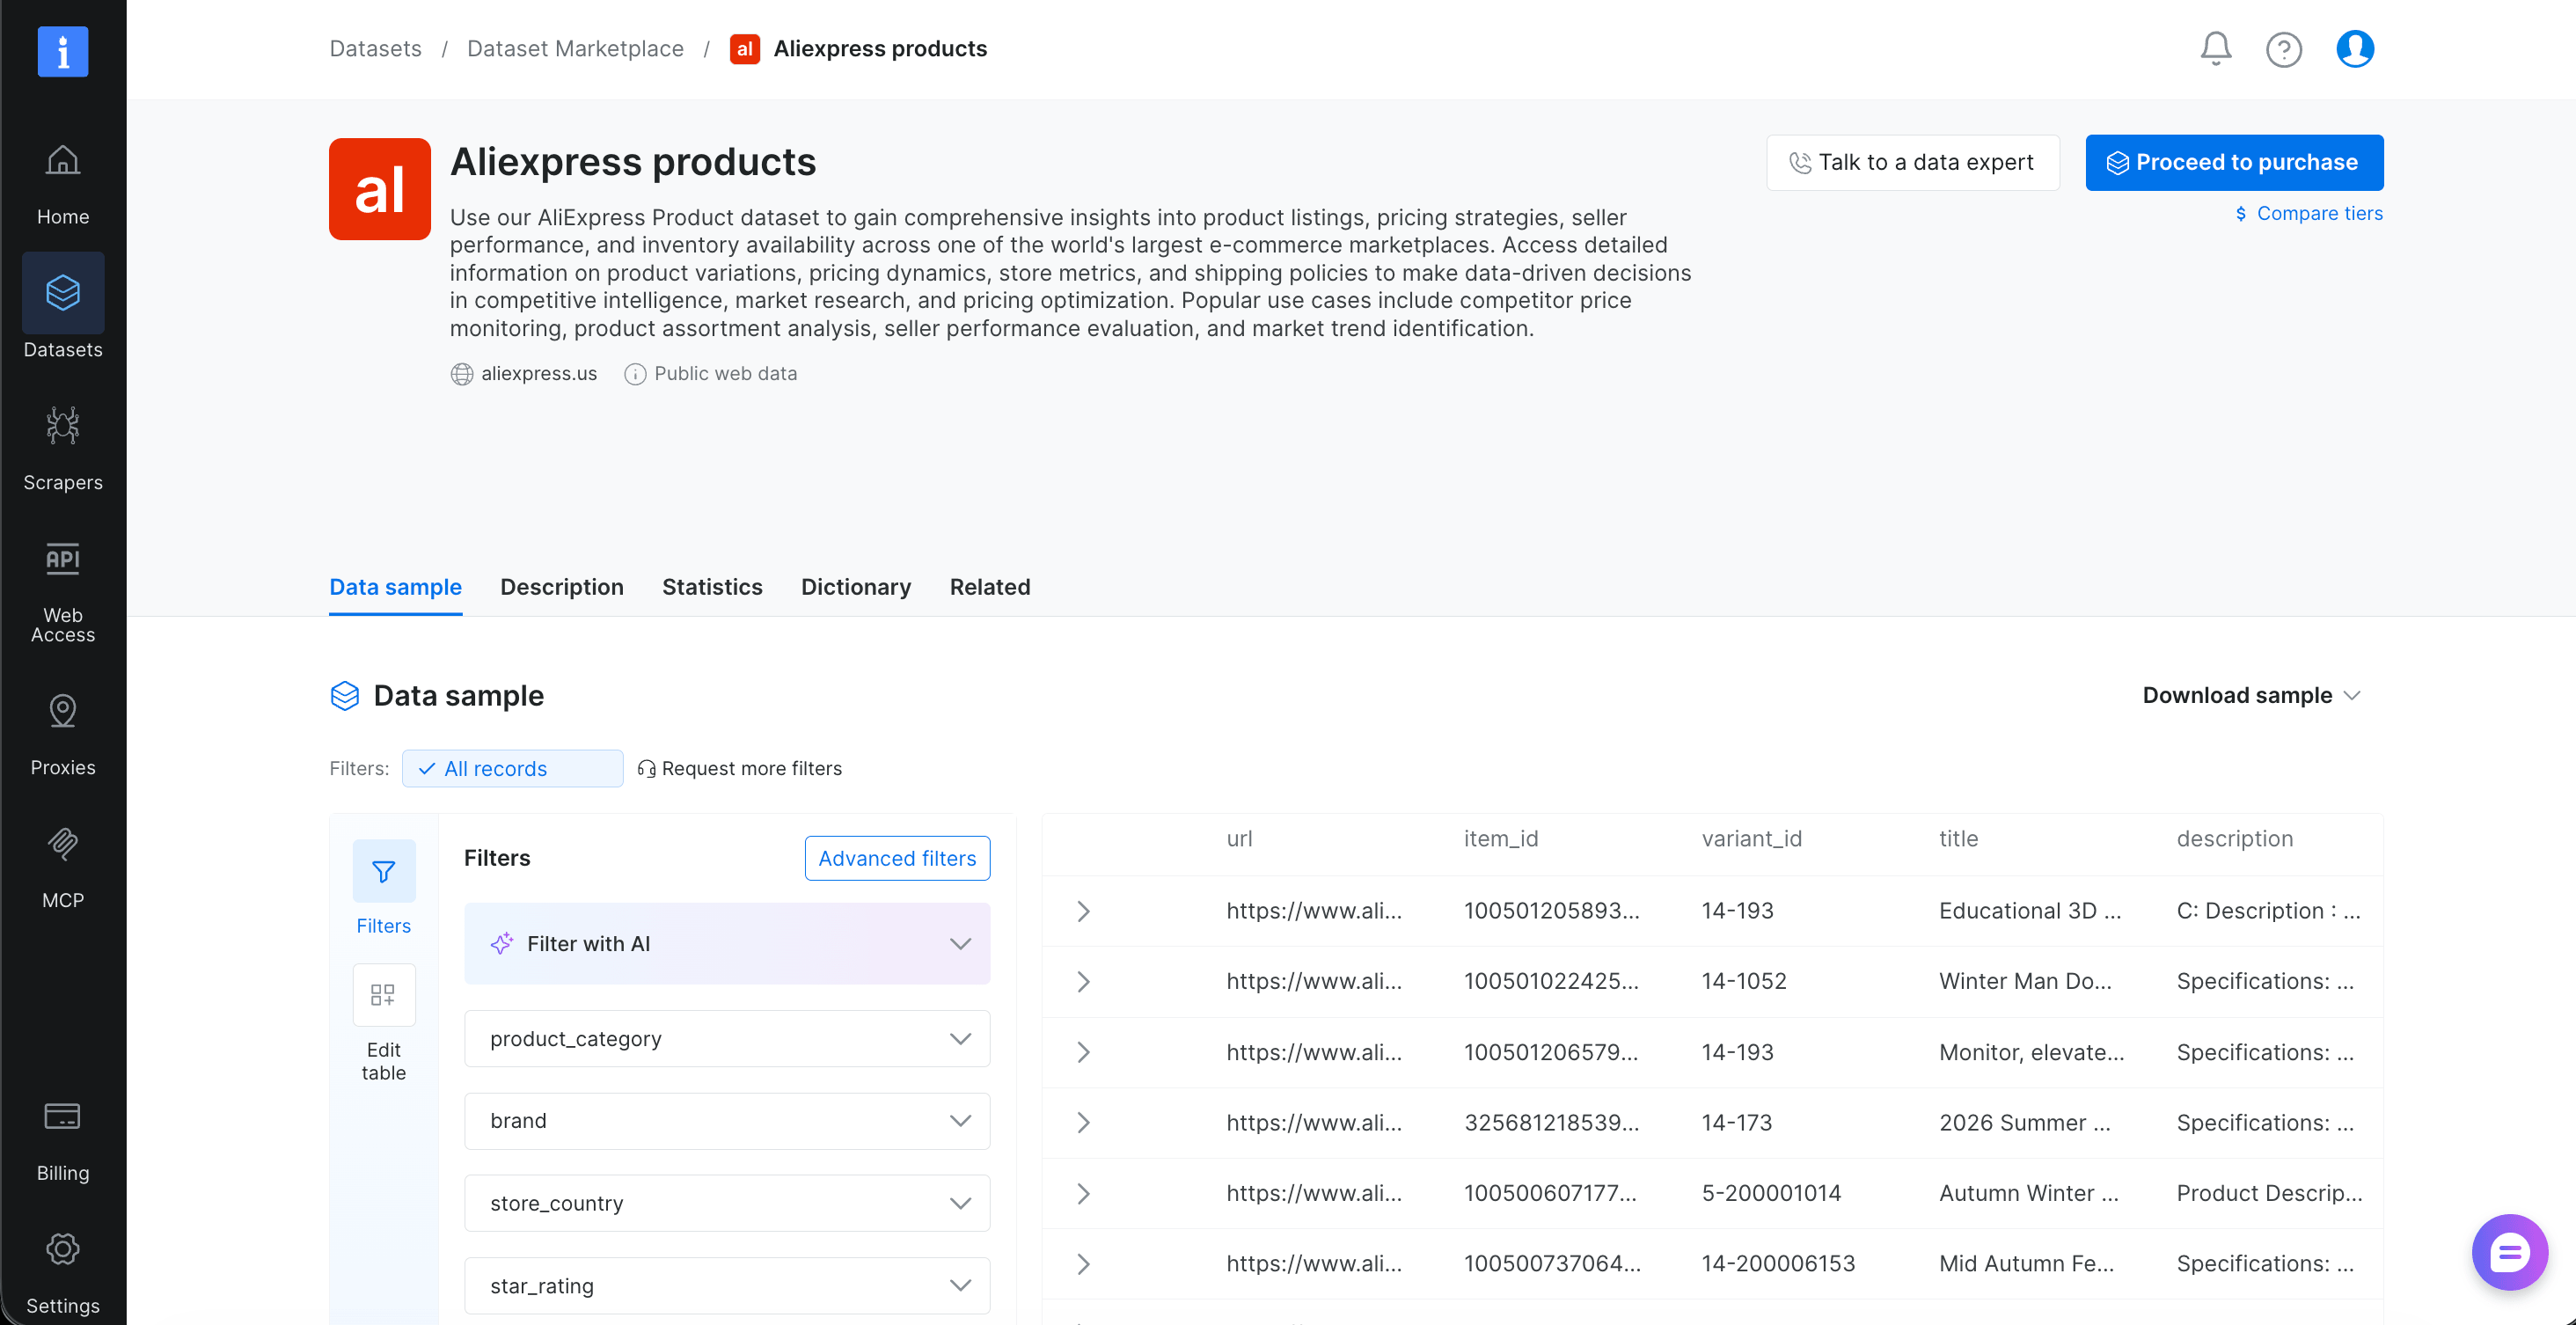
筛选面板可让你在付费前选择记录。
AliExpress 数据集可以减少筛选工作和采集时间。你可以在数据集市场中或通过 Filter 数据集 API 筛选所需记录,并且只为筛选后的快照付费。这些记录已经存在,因此无需等待采集任务完成。你可以一次性获取,也可以按自己选择的刷新计划获取;当前价格请参阅数据集定价页面。
下单前应估算交付大小。数据集样本中的记录以 JSON 交付时平均为 12.75 KB,因此每 100,000 条记录应预留约 1.3 GB 空间。数据集也支持 Parquet 格式,同一样本转换为 Parquet 后体积缩小了近 8 倍。这种大小差异可能决定你是就地查询文件,还是先将其暂存。
对于全市场商品组合和覆盖范围问题,请使用数据集;对于你跟踪的特定商品,请使用爬虫 API。数据集会按你选择的计划刷新,而爬虫 API 采集会在运行时返回每件商品的即时数据。
总结
AliExpress 的签名方案只需一个函数即可实现,但在测试中,即使签名正确,网关也会在前十几次请求内拦截来自同一个 IP 地址的调用。由于拦截可能返回成功状态码,因此每项检查都应以 bxpunish 标头和每件商品都应具备的字段(例如价格)为依据。该网站的 robots.txt 并未禁止公开的 /item/ 路径,因此大规模爬虫时应使用该路径。
Bright Data 的 AliExpress 爬虫工具 API 会为这些商品页面返回结构化记录,Browser API 可采集每个变体的价格,而 AliExpress 数据集适用于全市场问题。你可以从免费套餐开始,该套餐每月包含 5,000 次请求,且无需信用卡。使用目录中的 40 个 URL 进行测试,并对照管道所需字段检查记录。
常见问题
AliExpress 是否提供商品数据 API?
提供,但仅面向卖家、联盟营销者和获批的代发货商。在 AliExpress Open Platform 上,卖家可通过 OAuth 2.0 为自己的店铺授权应用,而联盟 API 则覆盖推广目录。这些 API 都无法覆盖整个市场,因此市场级定价数据需要电商数据采集。
如何获取 AliExpress 商品 URL 或 ID?
商品 URL 遵循 /item/<item_id>.html 模式,发现流程从 /w/wholesale-<keyword>.html 开始。ID 取决于主机。同一件商品在 .com 上的 ID 为 1005001398867186在 .us 上则为 3256801212552434。应以地区重定向后的最终 URL 作为每件商品的键,避免它以两个 ID 重复出现。
爬虫 AliExpress 商品数据是否免费?
小规模使用时可以免费。Bright Data 的免费套餐每月包含 5,000 次请求,无需信用卡,并覆盖爬虫 API、网络解锁器和 Browser API,因此你可以先使用自己的 URL 测试它们。Playwright 和 curl_cffi 均为开源工具。在生产规模下,成本主要来自 IP 地址,因为从一个 IP 地址进行的两轮各 60 次签名 API 调用分别只获得了 7 次和 15 次数据。
AliExpress 爬虫工具 API 的费用是多少?
Bright Data 的 AliExpress 爬虫工具 API 按交付记录计费,网络解锁器按成功请求计费,因此你只需为结果付费。Browser API 按流量计费,因此可根据页面大小预测成本。测试中,一个商品页面约为 3 MB。当前价格请参阅 Bright Data 的定价页面。
为什么我的 AliExpress 爬虫返回空字段?
因为初始 HTML 中没有价格或库存。window.runParams 是空对象<title> 为空,因此基于选择器的提取器匹配不到任何内容,也不会报错。页面的 JavaScript 随后会从 mtop.aliexpress.pdp.pc.query 加载这些字段。你可以执行 JavaScript也可以直接调用该 API。
如何避免在爬虫 AliExpress 时被拦截?
通过 Bright Data 的爬虫 API 或网络解锁器发送请求,它们内置代理和 AliExpress 验证码破解功能。测试中,无论创建新的 Cookie 容器还是等待 60 秒,都无法解除对同一个 IP 地址的拦截。被拦截的请求也会返回 HTTP 200,因此应检查 bxpunish 标头,而不是状态码。
为什么 AliExpress 价格会变化?
因为促销是临时的,并且因国家而异。在一项覆盖 6 个出口国家的测试中,同一件商品的折扣从标价的 52.5% 到 4.1% 不等,而且各国在价格是否含税方面也存在差异。应为每个价格序列设置固定出口国家,并将其存储在记录行中。
是否有 AliExpress MCP 服务器?
有。Bright Data 的 MCP 服务器可让 AI 智能体通过 scrape_as_markdown 和 scrape_batch 工具获取 AliExpress 商品页面,这些工具会处理解锁并返回 markdown。在一次测试调用中scrape_as_markdown 返回了商品的价格、评分、变体和分类路径。AliExpress MCP 页面介绍了设置方法。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。