本指南将介绍:
- 什么是容器即服务以及它会为你管理哪些内容。
- CaaS 的工作原理,以及容器编排在该模型中的重要性。
- 这种云服务方式的主要优势和缺点。
- 为什么 CaaS 非常适合网页数据获取工作负载。
- 如何使用 CaaS 和 Bright Data 构建可扩展的网页数据管道。
让我们开始吧!
CaaS(容器即服务)详解
在了解 CaaS 如何支持网页数据管道和 AI 智能体之前,你需要先理解它是什么,以及它实际负责处理哪些内容。
什么是 CaaS?
CaaS 是容器即服务(Containers as a Service)的缩写,是一种云服务模型,可为容器化应用程序的部署、运行和扩展提供托管环境。它介于基础设施服务和应用程序级服务之间。
要了解 CaaS 的定位,可以先看看构建容器时会发生什么。容器镜像是应用程序的一个可移植单元,能够在不同环境中以一致的方式运行。
然后,该镜像会用于创建正在运行的容器。要在生产环境中可靠地运行这些容器,则需要用于部署、网络连接、扩展、监控和生命周期管理的基础设施。
CaaS 弥合了已完成的容器镜像与生产就绪型运行环境之间的差距。你无需手动配置服务器和管理单个容器,只需将容器镜像部署到 CaaS 平台,由平台定义它们的运行方式并进行编排。
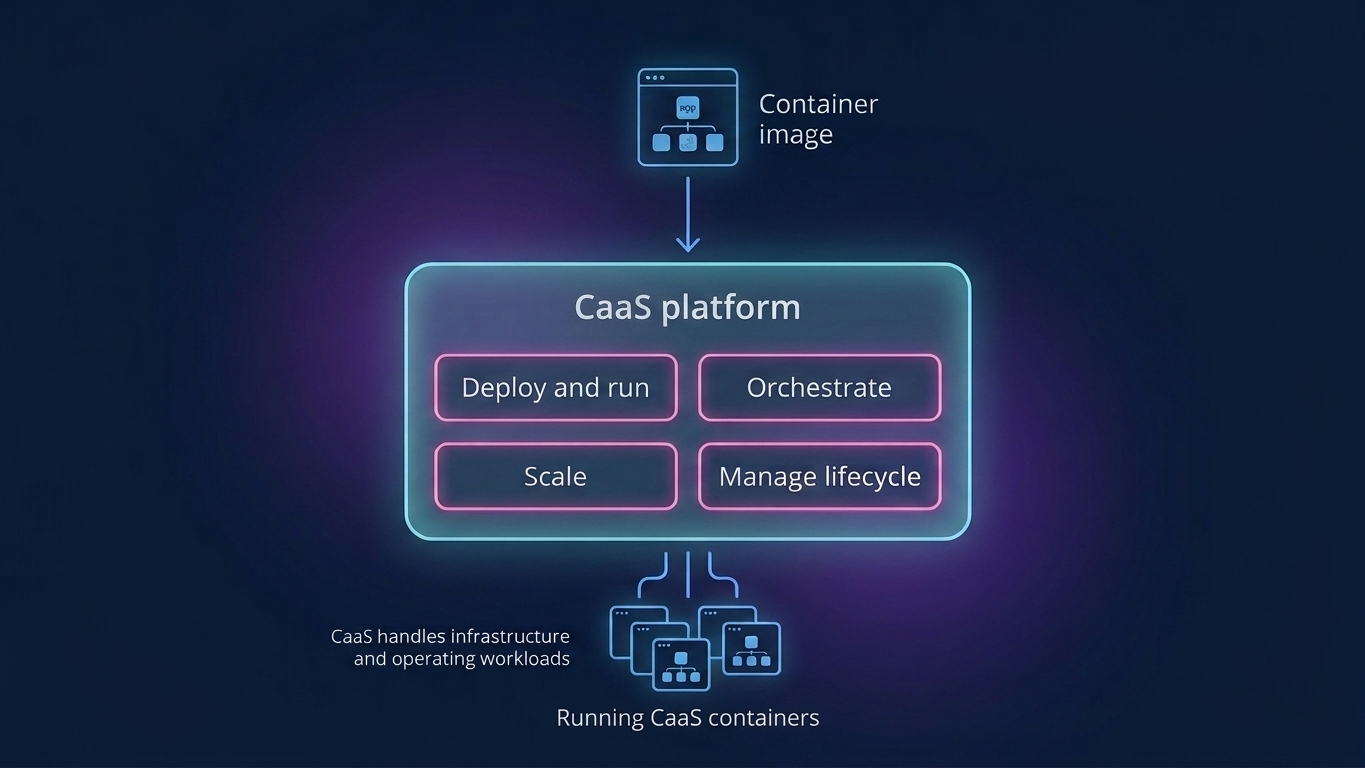
换句话说,这种模型不只是简单地在虚拟机上运行 Docker。如果只使用 Docker,你仍需自行管理底层基础设施并协调容器。CaaS 解决方案则提供大规模运行容器化工作负载所需的其他功能。
CaaS 管理哪些内容?
CaaS 平台通常会处理容器部署、编排、扩展、网络连接、服务发现、运行状况检查和生命周期操作。
在实际应用中,你只需定义所需的工作负载,例如要运行多少个容器实例,以及它们需要哪些资源。然后,平台会替你处理大部分执行工作。
这种方式可以降低运维开销,让分布式应用程序更容易可靠运行,尤其适合需要频繁扩缩容或变化的工作负载。
CaaS 如何运作?
了解 CaaS 是什么之后,接下来该看看它如何运作。
从容器镜像到生产工作负载
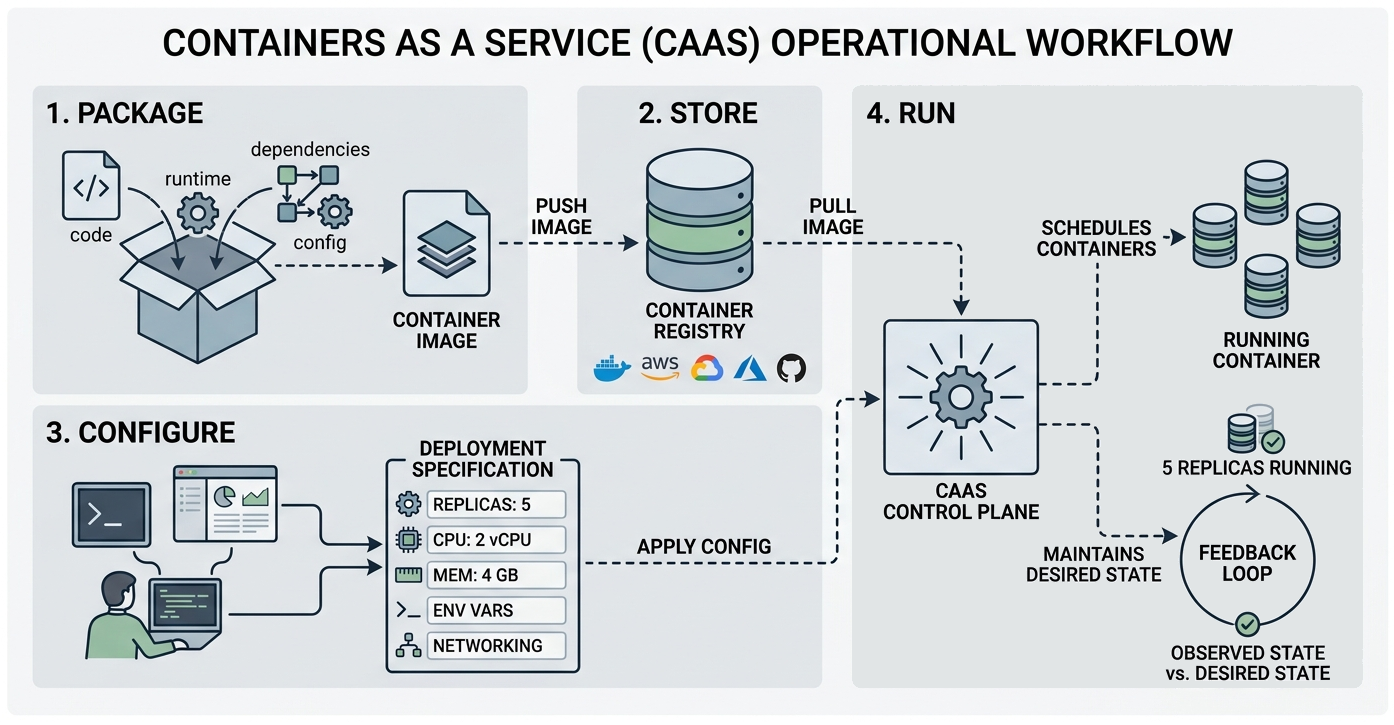
使用 CaaS 部署应用程序的第一步,是将应用程序及其运行所需的一切打包成容器镜像。其中包括应用程序代码、依赖项、运行时、配置和其他必要组件。
镜像通常存储在容器注册表中,例如 Docker Hub、Amazon ECR、Google Artifact Registry、Azure Container Registry 或 GitHub Container Registry。注册表是一个用于存储、管理和分发容器镜像的集中式系统。部署应用程序时,系统会从注册表获取所需镜像,并使用它启动容器。
然后,你需要指定应用程序的运行方式。具体取决于 CaaS 解决方案,其中可能包括容器实例数量、CPU 和内存要求、网络规则、环境变量及其他配置设置。通常可以通过网页界面、命令行工具、配置文件或 API 提供这些参数。
CaaS 服务会将这些配置转换为正在运行的工作负载。它会在可用的底层基础设施上调度容器,并持续维持所需状态。
容器编排的作用
运行单个容器相对简单。然而,随着应用程序不断扩展,你可能需要运行数十个甚至数百个容器。在大多数情况下,这些容器需要彼此通信、根据需求扩缩容,或在发生问题时自动恢复。手动管理这一切很快就会变得极具挑战性。
这正是容器编排发挥作用的地方。编排可以自动执行运行和协调多个容器所需的任务。它能随着需求变化自动添加或移除容器、检查容器是否健康、替换故障实例,并让服务能够相互发现和通信。
Kubernetes 是最广为人知的容器编排技术,通常用作现代 CaaS 解决方案的基础。它提供在机器集群中部署、调度、扩展和维护容器化工作负载所需的机制。
不过,请注意 CaaS 与 Kubernetes 并不相同。Kubernetes 是容器编排的首选技术,而 CaaS 则提供一种托管方式,让你无需自行运维所有组件即可使用容器基础设施。
CaaS 的优势与挑战
容器即服务模型可以简化容器化应用程序的部署和运行,但也会带来一些新的考量因素。
主要优势:
- 应用程序能够在开发、测试和多云环境中以相同方式运行,避免因配置不匹配而导致部署错误。
- 自动横向扩展可即时调整容器数量以应对流量高峰,优化服务器资源使用。
- 将集群管理和主机操作系统配置交给服务商处理,可免除内部工程团队维护基础设施的负担。
- 细粒度的组件隔离允许基于模块化微服务的架构独立部署、扩展和恢复故障。
- 与持续部署管道的原生集成可通过自动执行测试和创建容器来加快发布周期。
主要挑战:
- 共享操作系统内核架构会带来容器逃逸漏洞,与虚拟机相比扩大了整体攻击面。
- 复杂的网络、存储和编排配置会形成陡峭的学习曲线,并且需要专业的运维知识。
- 特定于供应商的 API 和专有编排工具增加了在不同云服务提供商之间迁移工作负载的难度。
用于网页数据和 AI 工作流的 CaaS
了解为什么容器即服务特别适合网页数据采集,以及为 AI 应用程序准备新鲜数据的工作流。
常见应用
CaaS 最常见的使用场景之一是运行微服务。每项服务都可以在自己的容器中运行,让你能够分别部署、更新和扩展各个组件。
该模型也适用于应用程序现代化、持续部署、混合基础设施,以及资源需求不固定的工作负载。容器提供一致的执行环境,而 CaaS 层则提供运行和扩展容器所需的基础设施。
任何涉及重复或并行任务的工作负载同样非常适合这种模型。你无需逐个处理所有任务,而是可以将各个作业分配给多个容器化工作进程。这种方式特别适合数据管道,因为各工作进程可以独立获取、转换、验证、丰富或处理数据。
用于网页数据采集的 CaaS
网页抓取是可以受益于容器化执行的典型工作负载。例如,假设你需要从数千个 URL 获取数据。与其在单个应用程序中按顺序处理,不如将 URL 分配给多个容器化工作进程。
每个工作进程都可以自主处理分配到的任务,因此只需运行更多容器即可提高采集能力。任务队列还可以在工作进程空闲时动态分发作业,从而进一步改进这种架构。
用于 AI 数据处理工作流的 CaaS
上述架构还可以扩展到数据采集之外。容器化工作进程可以获取新鲜的网页数据、进行处理和丰富,再将生成的信息发送至分析系统、数据库、RAG 管道或 AI 应用程序。
具体来说,队列可以将数千项数据采集任务分配给不同工作进程。采集完成后,另一组工作进程可以清理并构建结果结构,再将其传递给 AI 智能体或 LLM。
使用 CaaS 和 Bright Data 扩展网页数据采集
CaaS 为容器化抓取工作进程提供执行基础设施,但无法解决大规模访问网站面临的挑战。浏览器自动化、代理管理、IP 轮换、网站封锁和反机器人机制都需要额外的基础设施。
这正是 Bright Data 在该架构中发挥作用的地方。其网页数据基础设施提供大型代理网络,以及用于网页访问、搜索、浏览器自动化和结构化数据提取的托管 API。
Bright Data 以超过 4 亿个 IP 的代理网络为支撑,支持无限并发,正常运行时间达 99.99%,全网络成功率达 99.95%。
其核心思路是将两个层分开:
- CaaS 为你的应用程序提供可扩展的计算能力。
- Bright Data 提供访问和采集网页数据所需的基础设施。
进一步了解如何结合 CaaS 与 Bright Data,构建生产就绪型数据管道和 AI 工作流!
第 1 步:选择合适的 Bright Data API
第一步是根据所需采集的数据类型选择合适的 Bright Data 产品。其中包括:
- 网页爬虫工具 API:使用 1,500 多个预构建抓取工具,从 800 多个受支持的域名中提取结构化数据。
- 网络解锁器 API:获取网页内容,同时处理代理、封锁和 CAPTCHA 等多种访问挑战。
- 搜索引擎 API:从 Google、Bing、Yandex 等搜索引擎获取结构化搜索结果。
- 浏览器 API:针对需要执行 JavaScript、点击、滚动或进行其他浏览器自动化操作的网站运行托管浏览器会话。
注意:所有这些产品都包含在 Bright Data 每月循环免费套餐中,因此你可以免费使用。
第 2 步:构建容器化抓取工作进程
选择合适的网页数据 API 后,你可以将应用程序打包为容器。它只需向所选 Bright Data API 发送请求,并可选择处理返回的数据。
例如,Python 工作进程可以使用网络解锁器 API,从网页中获取适用于 LLM 的 Markdown 内容:
# worker.py

import os
import requests

def fetch_page(url):
    response = requests.post(
        "https://api.brightdata.com/request",
        headers={
            "Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "zone": os.environ["BRIGHTDATA_WEB_UNLOCKER_API"], # Replace with your Bright Data Web Unlocker API name
            "url": url,
            "format": "raw",
            "data_format": "markdown",
        },
    )

    response.raise_for_status()

    return response.text
有关集成的更多指导,请参阅 Bright Data 网络解锁器文档。
请注意,该请求没有任何 Docker 特有的内容。应用程序通过 Python requests 库发出标准 HTTP 请求。因此,同一代码既可以在本地或虚拟机上运行,也可以在由 CaaS 服务管理的容器内运行。
然后,你可以在 requirements.txt 文件中列出所需的依赖项。该文件将包含:
requests==2.34.2要将工作进程容器化,你可以编写一个简单的 Dockerfile:
FROM python:3.14-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

CMD ["python", "worker.py"]
你还需要将 Bright Data API 密钥和网络解锁器 API 名称与应用程序代码分开提供。在本地开发期间,你可以使用 .env 文件:
BRIGHTDATA_API_KEY=<BRIGHTDATA_API_KEY>
BRIGHTDATA_WEB_UNLOCKER_ZONE=<BRIGHTDATA_WEB_UNLOCKER_API>
对于生产部署,你应使用 CaaS 提供商的密钥管理功能将 API 密钥注入容器。
做得好!同样,你也可以将调用其他 Bright Data API 产品的应用程序容器化。
第 3 步:将工作分配到多个容器
抓取工作进程正确运行后,该架构便可以根据工作负载扩展工作进程实例的数量。
现在,假设一个抓取队列中包含 100,000 个 URL。CaaS 服务可以运行多个工作进程实例,并在它们之间分配任务。随着工作负载增长,系统将添加更多工作进程来并发处理请求。这远优于在单个应用程序中按顺序处理任务。
请记住,与其他 Bright Data 产品一样,网络解锁器 API 专为大规模数据采集而设计。这意味着你可以扩展容器化工作进程的数量,而无需担心并发问题。
第 4 步:处理和使用返回的数据
最终架构如下所示:
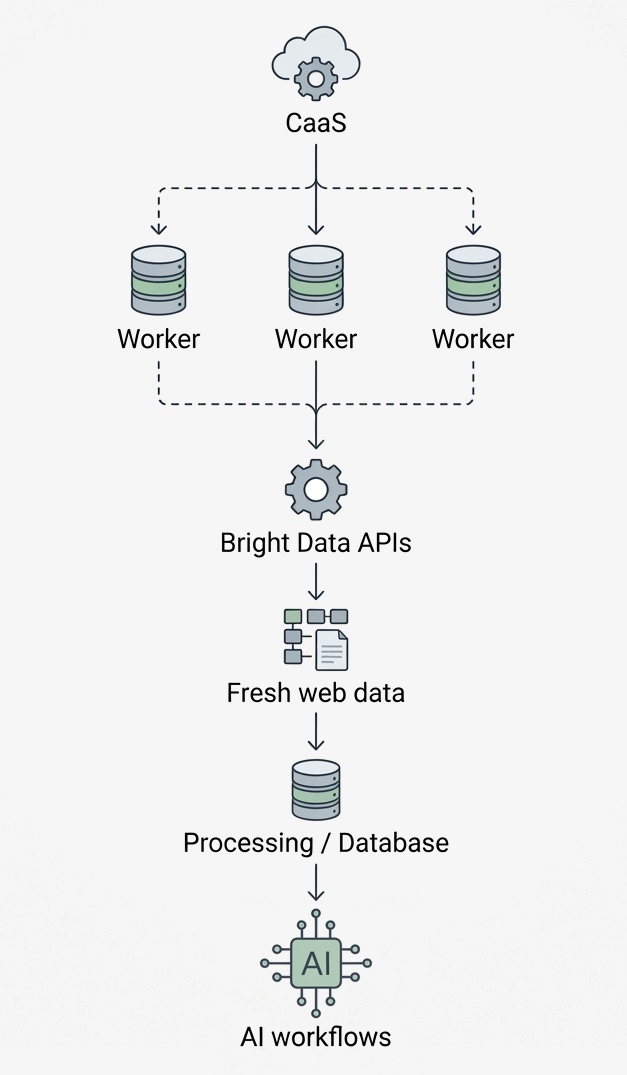
任务队列可以位于应用程序与工作进程之间,在容器空闲时动态分发作业。如果工作负载增加,你可以运行更多工作进程。当需求下降时,则可以减少这些进程。
这实现了清晰的职责分离:
- CaaS:提供计算环境并扩展容器化工作进程。
- Docker:将应用程序及其依赖项打包到可移植的运行环境中。
- Bright Data:提供大规模访问和采集网页数据所需的专业基础设施。
- 你的应用程序:处理返回的数据,并将其发送至数据库、基于 ML 的系统或 AI 智能体。
请注意,CaaS 本身不会降低网页内容获取的难度。它能让网页抓取应用程序更容易部署和扩展。与 Bright Data 等托管网页数据基础设施结合使用后,你无需自行管理网页访问技术栈的每一层,就能为分析和 AI 构建可扩展的网页数据管道。太棒了!
总结
本文介绍了如何使用容器即服务(CaaS)构建可扩展的网页数据管道和 AI 工作流。如上所示,将 CaaS 与 Bright Data 相结合,可以同时扩展架构中的计算层和网页数据层。
通过这种集成,你可以将数据采集任务分配给容器化工作进程,通过 Bright Data API 获取新鲜的网页数据,并将结果发送至下游组件。
创建新的 Bright Data 账号,开始使用我们的 API 构建可扩展的数据和 AI 处理管道!
常见问题
CaaS 与自建容器基础设施有何区别?
使用 CaaS 时,云服务提供商会管理大部分底层基础设施和容器操作。采用自建方式时,你需要负责设置、维护、扩展和保护容器环境。
| CaaS | 自建 | |
|---|---|---|
| 基础设施 | 由提供商管理 | 由你的团队管理 |
| 编排 | 托管或集成 | 由你的团队设置和维护 |
| 扩展 | 内置自动化 | 由你自行配置和维护 |
| 维护 | 较低 | 较高 |
| 控制能力 | 基础设施层面的控制较少 | 控制能力更强 |
| 专业知识 | 要求较低 | 要求较高 |
简而言之,CaaS 可减少运维开销,而自建方式则能提供更强的控制能力和定制性。进一步了解托管与自建之争。
CaaS、IaaS、PaaS、FaaS 和 SaaS 有何区别?
不同云服务模型之间的主要区别,在于它们将多少基础设施和应用程序管理工作留给用户:
| 模型 | 提供的内容 | 由你管理 | 由提供商管理 | 典型用途 |
|---|---|---|---|---|
| IaaS(基础设施即服务) | 虚拟化计算、存储和网络 | 操作系统、中间件、运行时、应用程序和数据 | 物理基础设施和虚拟化 | 自定义基础设施和应用程序 |
| CaaS(容器即服务) | 容器化应用程序的托管环境 | 容器镜像、应用程序和配置 | 基础设施、容器编排和扩展 | 容器化应用程序和微服务 |
| PaaS(平台即服务) | 托管应用程序平台和运行时 | 应用程序代码和数据 | 基础设施、操作系统、运行时和平台 | 应用程序开发和部署 |
| FaaS(函数即服务) | 无服务器、事件驱动的函数执行 | 各个函数及其代码 | 服务器、运行时、扩展和基础设施 | 短时运行的事件驱动型任务 |
| SaaS(软件即服务) | 完整且开箱即用的软件 | 配置和数据 | 整个应用程序技术栈和基础设施 | 面向最终用户的应用程序 |
CaaS 介于 IaaS 与 PaaS 之间,让你能够控制容器化应用程序,同时由提供商管理大部分底层基础设施和编排工作。
Bright Data 是否支持 CaaS 云服务模型?
Bright Data 为 CaaS 提供补充,为大规模数据采集提供所需的网页数据基础设施,而 CaaS 则提供用于运行和扩展容器化工作进程的计算基础设施。


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。