在这篇博文中,你将了解:
- 什么是音频抓取,以及如何执行音频抓取。
- 从网络抓取音频并为后续处理做好准备时面临的主要挑战。
- 如何大规模抓取音频。
- 如何将抓取的音频转换为 WAV 格式,以便进行基于 AI 的处理。
- 如何使用 AI 语音转文本模型,根据音频生成带时间戳的转录文本。
- 抓取的音频数据有哪些相关用例。
让我们开始吧!
音频网页抓取的工作原理
音频网页抓取是指自动从网站下载音频内容。音频可能来自独立文件,也可能嵌入在视频中。
下载音频通常只是第一步。在实际应用中,目标是利用抓取的音频进行自动分析、文本检测或AI 模型训练。要执行此类任务,你通常还需要音频中包含的文本。
这正是音频转录发挥重要作用的地方。将抓取的音频转换为文本后,你可以让语音内容变得可搜索。为每个转录片段添加时间戳,还可以将特定文本与原始音频波形中的对应位置关联起来。
换句话说,抓取可以让你获取原始音频。随后,转录会将这些音频转换为结构化、机器可读的文本,可用于各种 AI 和数据处理任务。
本教程将带你完成整个流程。你将学习如何从网络抓取和下载音频、将其转换为合适的格式,并使用 AI 模型进行处理以生成转录文本。
音频抓取面临的挑战及解决方案
从网络抓取音频看似简单,但构建可靠的音频处理管道会遇到许多障碍。
你首先需要找到可访问的音频源,然后克服获取音频时可能遇到的限制,最后将音频转换为可用文本。幸运的是,只要使用合适的工具和工作流程,这些挑战都可以解决!
在网络上寻找音频源
第一个挑战是找到适合抓取的音频源。与网页不同,音频并不总是通过显而易见的直接下载 URL 提供。
例如,你感兴趣的音频可能来自托管在 YouTube、Vimeo 或哔哩哔哩等平台上的视频。一种解决方案是抓取这些视频并提取其音轨,从而获得更丰富的音频内容。
如果你想完全跳过音频网页抓取,可以考虑使用 Bright Data 的 AI 就绪音频数据集。其中的数据已经完成采集和准备,可直接用于 AI 和机器学习工作流程。
克服网络访问和反机器人挑战
找到音频源只是问题的一部分。确定要采集的内容后,目标网站可能会采用反抓取技术。这些技术包括 IP 信誉检查、速率限制、CAPTCHA、JavaScript 质询以及其他反机器人机制。
这正是 Bright Data 可以提供帮助的地方。Bright Data 提供专为企业级公开网络数据采集而设计的网络访问基础设施。其产品组合包括网络解锁器 API、浏览器 API 和代理服务等解决方案。
Bright Data 的网络覆盖 195 个国家/地区的 4 亿多个 IP。该基础设施支持无限并发,成功率达 99.95%,正常运行时间达 99.99%。
接下来,你将看到如何使用网络解锁器 API访问任何网站上的音频资源。这样一来,我们就可以专注于音频处理工作流程,而不必自行构建网络访问层。
将音频转换为可用文本
最后一个问题是将抓取的音频转换为文本。这并不总是很简单,尤其是当录音中包含背景噪声、多位说话者或语音不清晰时。不过,现代 AI 转录模型可以处理其中大多数情况。添加时间戳还可以将每段文本与其在录音中的位置关联起来,使转录文本更加实用。
第 1 步:从网络抓取音频资源
音频网页抓取首先需要构建一个自动化系统,从网络采集音频内容。这可能包括直接获取 MP3 等音频文件,或者更常见的做法:下载视频并从中提取音轨。
为了帮助克服网站可能针对爬虫机器人实施的限制,你需要通过 Bright Data 的网络解锁器 API 路由自动请求。这样,你就不必再担心 CAPTCHA、速率限制及其他访问限制。
请按照以下说明操作!
前提条件
开始之前,请确保你具备以下条件:
- 已在本地安装 Python 3.11+。
- 一个 Python 开发环境,包括 Python 项目和 Python IDE。
- 一个 Bright Data 账户并满足以下条件:
– 已配置 API 密钥。
– 已设置网络解锁器 API。
如需更多指导,请参阅以下链接:
我们假设你的网络解锁器 API 名为“web_unlocker”:
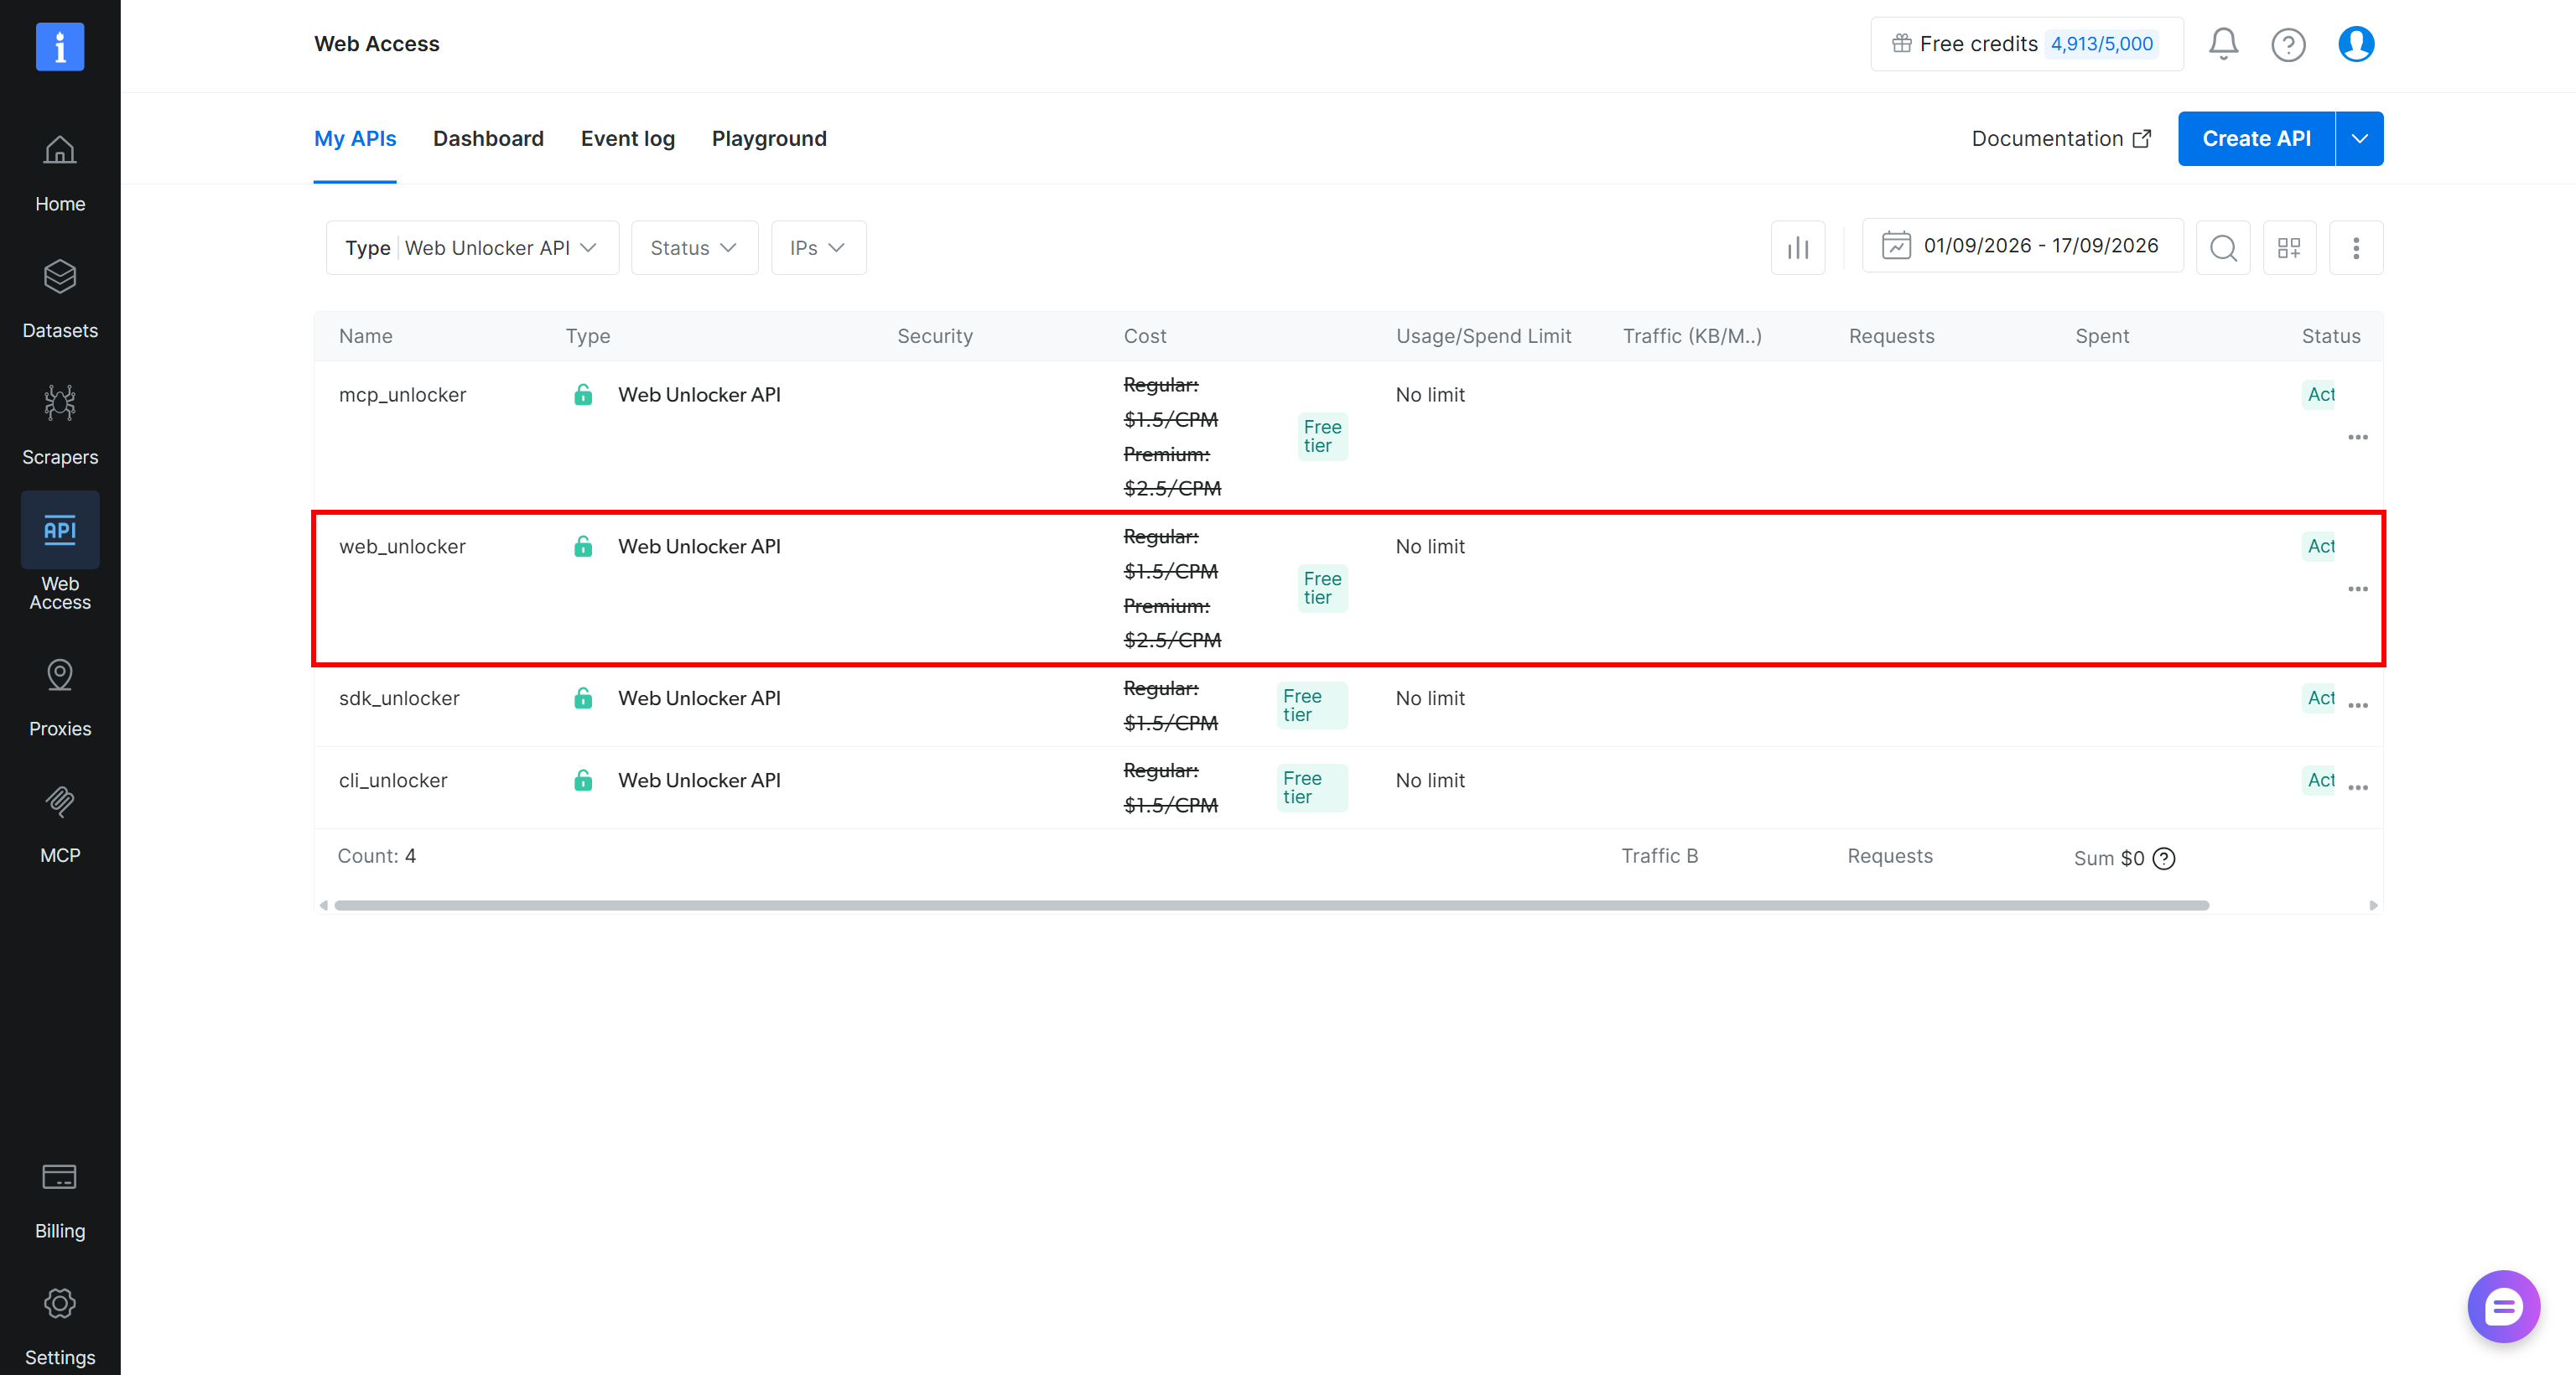
重要提示:请务必调整此步骤中的代码示例,使其与你实际使用的网络解锁器 API 名称一致。
此外,你可以直接在网络解锁器 API 页面上找到代理模式的凭据:
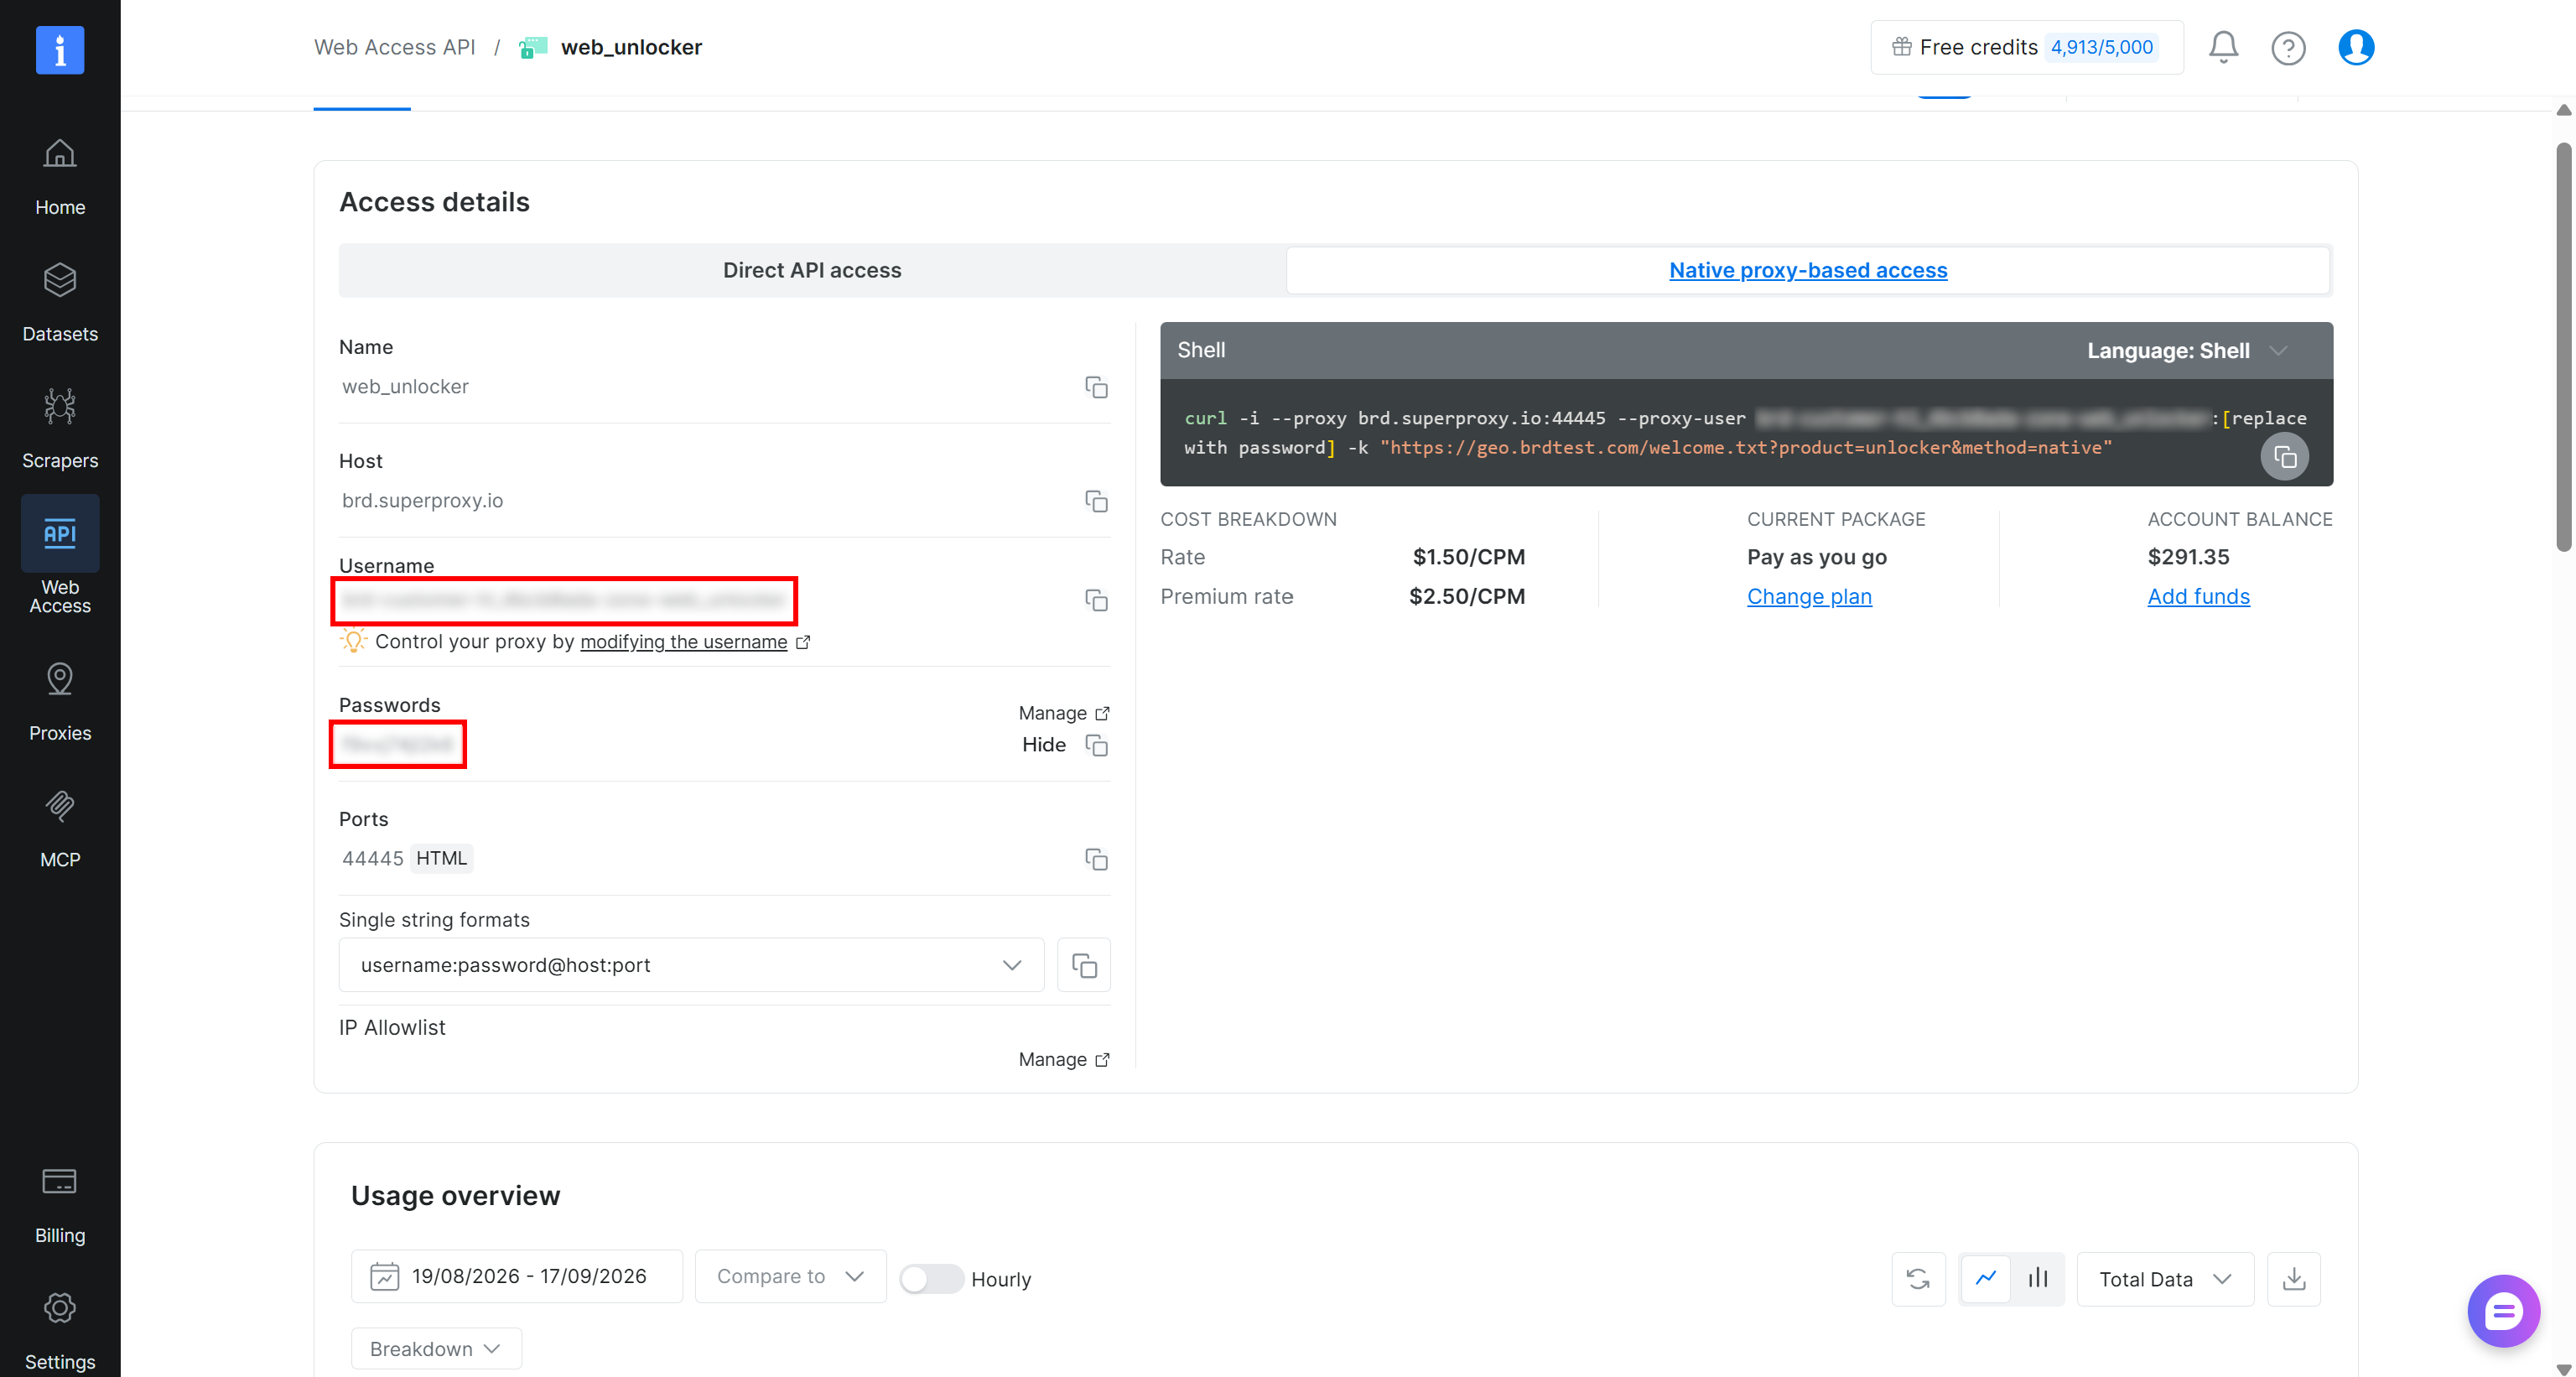
转到“原生代理访问”选项卡,然后点击密码旁边的“显示”。输入发送到你电子邮箱的验证码。
获得网络解锁器 API 的用户名、密码和端口后,你可以使用以下格式构建代理 URL:
http://<WEB_UNLOCKER_API_USERNAME>:<WEB_UNLOCKER_API_PASSWORD>@brd.superproxy.io:<WEB_UNLOCKER_API_PORT>在你的 Python HTTP 客户端中配置此代理后,其 HTTP 请求将通过网络解锁器 API 进行路由,以绕过反机器人措施。
注意:为避免以代理模式使用网络解锁器 API 时出现 SSL 证书验证问题,请下载 Bright Data SSL 证书并将其安装在你的本地计算机上。
下载在线视频
假设你的音频源是一个没有转录文本的 YouTube 视频,例如这个视频:
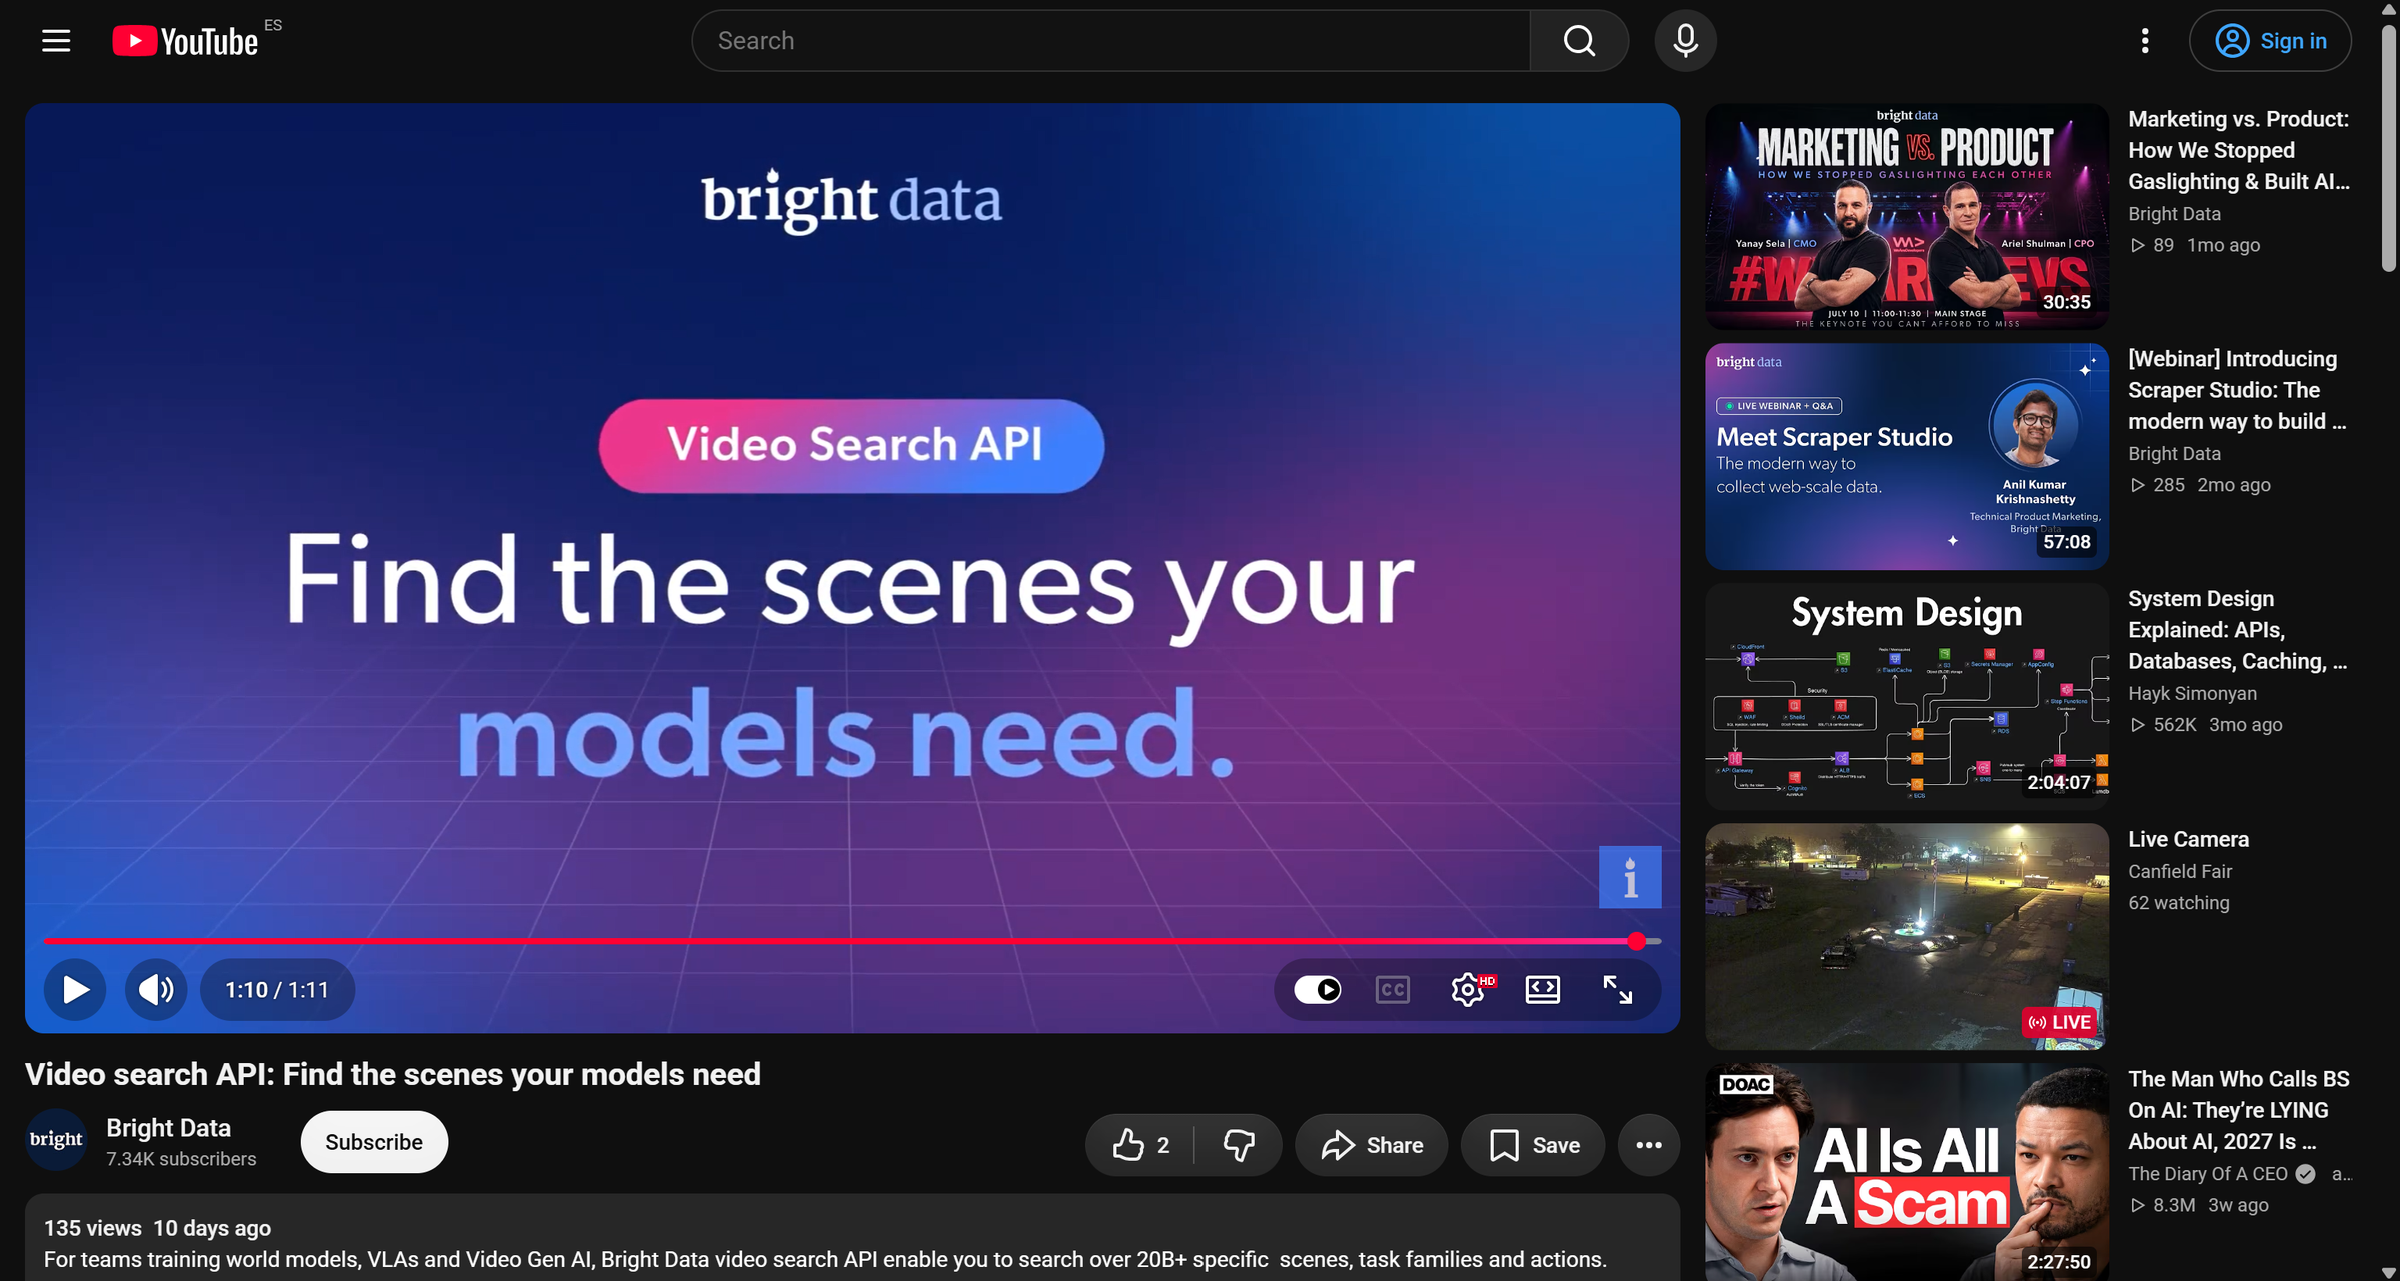
如你所见,“字幕”选项已被禁用。
在这种情况下,音频包含在视频中,而不是作为独立音频文件提供。要下载该视频,你可以使用 yt-dlp这是最受欢迎的视频和音频内容下载命令行工具及库之一。
请注意,从 YouTube 和类似平台抓取视频很容易导致请求被屏蔽,尤其是在大规模操作时。为避免这些问题,你需要可靠的 IP 轮换以及应对反机器人防护的机制。
Bright Data 支持 yt-dlp因此你可以通过网络解锁器 API 路由其请求,从而无限访问视频数据。
首先使用 pip 安装 yt-dlp:
python -m pip install -U "yt-dlp[default]"接下来,运行:
yt-dlp --proxy 'http://<WEB_UNLOCKER_API_USERNAME>:<WEB_UNLOCKER_API_PASSWORD>@brd.superproxy.io:<WEB_UNLOCKER_API_PORT>' '<YOUTUBE_VIDEO_URL>' --output output.mp4请记得将占位符替换为你的网络解锁器 API 凭据和目标 YouTube 视频的 URL。
上述命令会下载指定的 YouTube 视频,同时通过 Bright Data 网络解锁器 API 路由请求以避免被屏蔽。下载的视频随后会以 output.mp4 的名称保存到你的项目目录中:
太棒了!你现在已成功抓取包含目标音频的视频。
如果你想从其他来源抓取视频,请参阅以下指南:
直接下载音频文件
设想这样一种场景:你感兴趣的音频资源已作为独立文件发布在网上。
例如,你可能想获取托管在互联网档案馆中的特定录音或获取其他网站上的录音。在这里,页面已经提供了音频文件的直接下载链接:
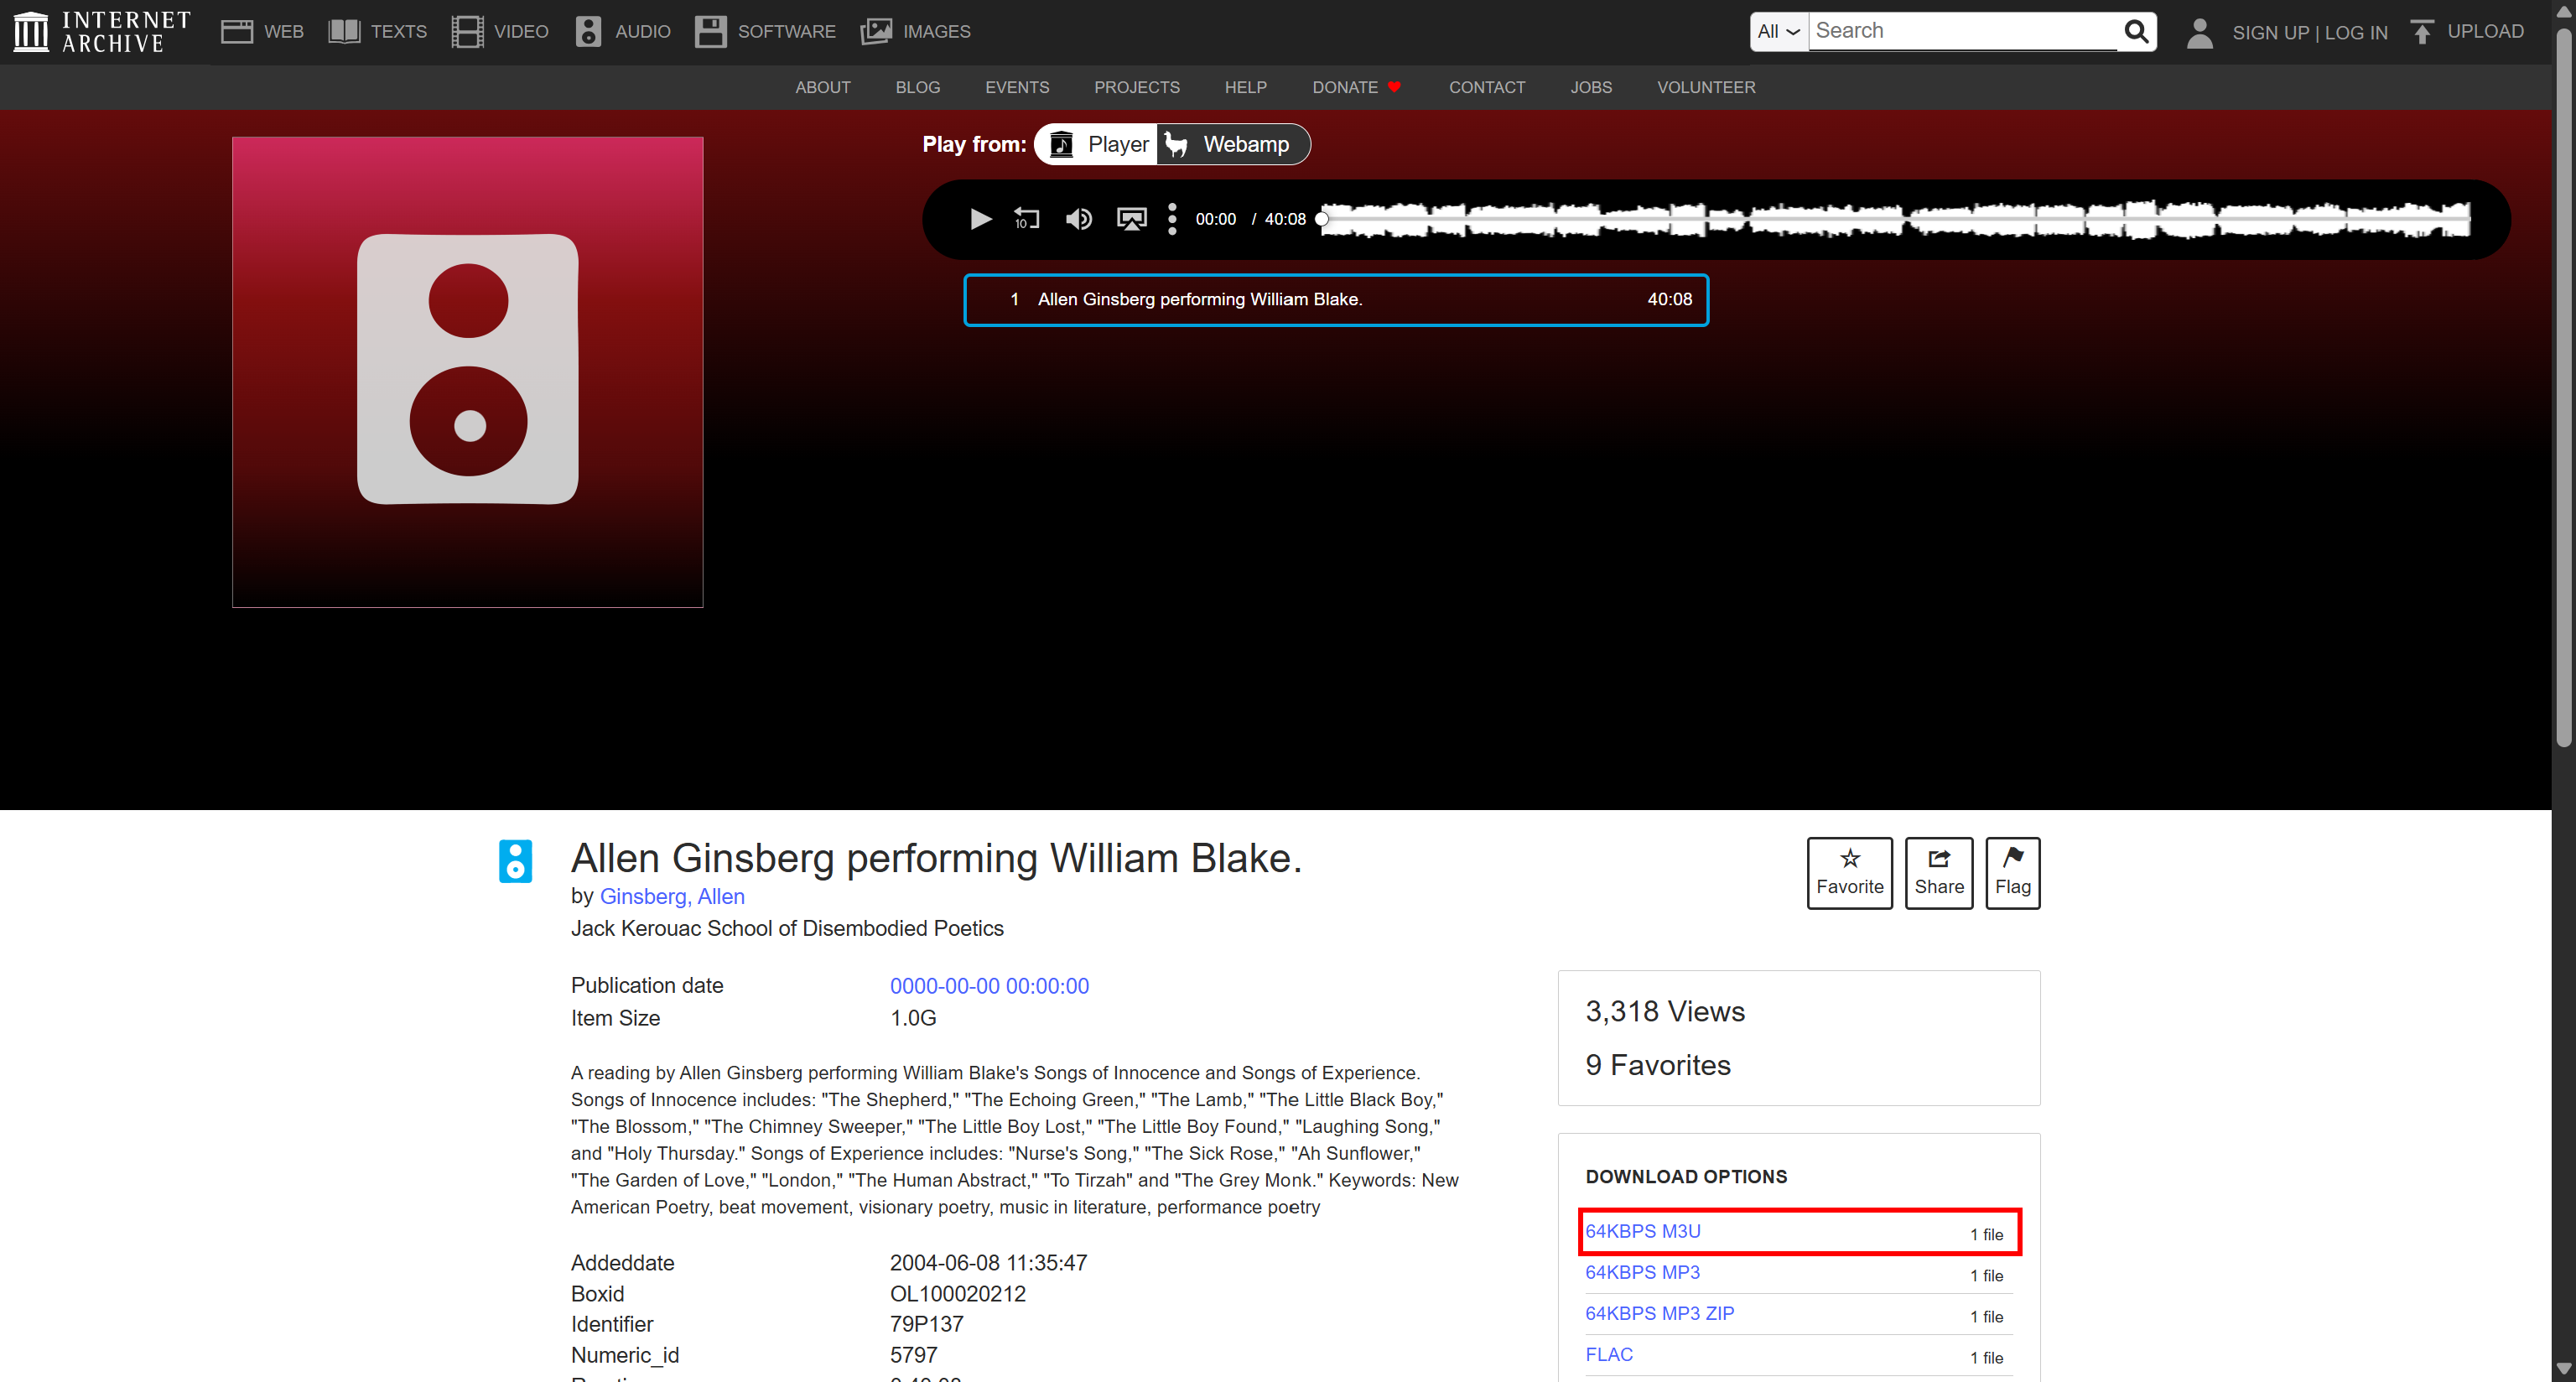
为了自动执行此过程并帮助应对潜在的访问限制,你可以构建浏览器自动化逻辑,导航至目标页面并发现底层音频资源的 URL。为此,你可以使用 Bright Data 的浏览器 API。
具体来说,这次 MP3 文件的直接 URL 是:
https://archive.org/download/79P137/79P137_64kb.mp3获得目标 URL 后,你可以通过 POST 请求将其发送到 Bright Data 的网络解锁器 API。随后,网络解锁器会为你获取该资源,同时绕过反机器人措施或其他访问限制。
首先安装 Requests HTTP 库:
pip install requests然后,使用以下代码创建一个 Python 脚本:
import requests

# Replace with your Bright Data API key
BRIGHT_DATA_API_KEY = "<YOUR_BRIGHT_DATA_API_KEY>"

target_audio_source = "https://archive.org/download/79P137/79P137_64kb.mp3"

# Access the audio resource through Bright Data's Web Unlocker API
response = requests.post(
    "https://api.brightdata.com/request",
    headers={
        "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}",
        "Content-Type": "application/json",
    },
    json={
        "zone": "web_unlocker", # Replace with your actual Web Unlocker API name
        "url": target_audio_source,
        "format": "raw",
        "country": "us"
    },
)
response.raise_for_status()

# Export the audio content to an MP3 file
with open("output.mp3", "wb") as f:
    f.write(response.content)
此脚本会将音频文件 URL 发送到网络解锁器 API,获取该资源,并将返回的内容以 output.mp3 的名称保存到本地计算机。
注意:在生产脚本中,请将 Bright Data API 密钥和网络解锁器 API 名称存储在环境变量中,而不是将它们硬编码到源代码中。
运行 Python 脚本后,获取的音频文件将以 output.mp3 的名称出现在你的项目目录中:
第 2 步:将抓取的音频文件转换为 WAV
在音频处理方面,许多多模态 AI 模型支持将 WAV 文件作为输入。即使模型支持多种格式,将抓取的音频数据统一转换为单一格式也很有帮助。
在本章中,你将学习如何将源音频和视频文件转换为 WAV。这样一来,就可以在后续 AI 处理步骤中统一使用这些文件。
前提条件
继续之前,请确保已在本地安装 FFmpeg。FFmpeg 是一种用于转换和处理音频及视频文件的命令行工具。
从官方网站下载 FFmpeg并按照适用于你的操作系统的安装说明进行操作。
将输入视频/音频文件转换为 WAV
使用以下命令,将抓取的 YouTube 视频文件转换为 WAV 音频文件:
ffmpeg -i output.mp4 -vn -acodec pcm_s16le -ar 16000 -ac 1 video_output.wav以下是每个参数的作用:
-i output.mp4:将output.mp4指定为输入文件。-vn:禁用视频处理,因此仅提取音频流。-acodec pcm_s16le:使用有符号 16 位小端编码将音频转换为未压缩的 PCM 音频,这是 WAV 文件的常用格式。-ar 16000:将音频采样率设置为 16,000 Hz(16 kHz)。-ac 1:将音频转换为单声道。video_output.wav:指定输出 WAV 文件的名称。
同样的方法也可用于将其他受支持格式的独立音频文件转换为 WAV:
ffmpeg -i output.mp3 -vn -acodec pcm_s16le -ar 16000 -ac 1 audio_output.wav请注意,该命令基本相同,主要区别在于输入文件和输出文件。
太棒了!现在你已准备好使用 AI 模型转录抓取的音频。
第 3 步:使用 AI 转录 WAV 文件
最后一步是将 WAV 格式的音频输入 AI 转录模型,可以使用基于云的 LLM,也可以使用在本地运行的模型。
对于此任务,你可以使用专为语音转文本转录设计的 AI 模型,也可以使用其他支持音频输入的多模态 AI 模型。具体选择取决于你的要求,例如转录准确率、时间戳、说话者识别、处理速度和成本。
使用基于云的多模态 AI 模型获取转录文本
OpenAI 提供了多种用于语音转文本转录的模型和 API。使用 OpenAI SDK 将你的 WAV 音频文件发送到转录模型,并获取生成的带时间戳转录文本。
首先安装 OpenAI Python SDK:
pip install openai接下来,使用以下代码实现目标:
from openai import OpenAI

# Replace with your actual OpenAI API key
OPENAI_KEY = "<YOUR_OPENAI_API_KEY>"

client = OpenAI(api_key=OPENAI_KEY)

# Open the audio file and send it to OpenAI Whisper for transcription
with open("video_output.wav", "rb") as f:
    transcription = client.audio.transcriptions.create(
        model="whisper-1",
        file=f,
        response_format="verbose_json",
        timestamp_granularities=["segment"],
    )

# Write the complete timestamped transcript to a text file
with open("video_transcript.txt", "w", encoding="utf-8") as f:
    for segment in transcription.segments:
        # Get the start and end time of the segment
        start = segment.start
        end = segment.end

        # Get the transcribed text
        text = segment.text.strip()

        # Format the timestamp as HH:MM:SS
        start_time = f"{int(start // 3600):02d}:{int((start % 3600) // 60):02d}:{int(start % 60):02d}"
        end_time = f"{int(end // 3600):02d}:{int((end % 3600) // 60):02d}:{int(end % 60):02d}"

        # Create one timestamped transcript line
        line = f"[{start_time} - {end_time}] {text}"

        # Print the line and save it to the transcript file
        print(line)
        f.write(line + "\n")
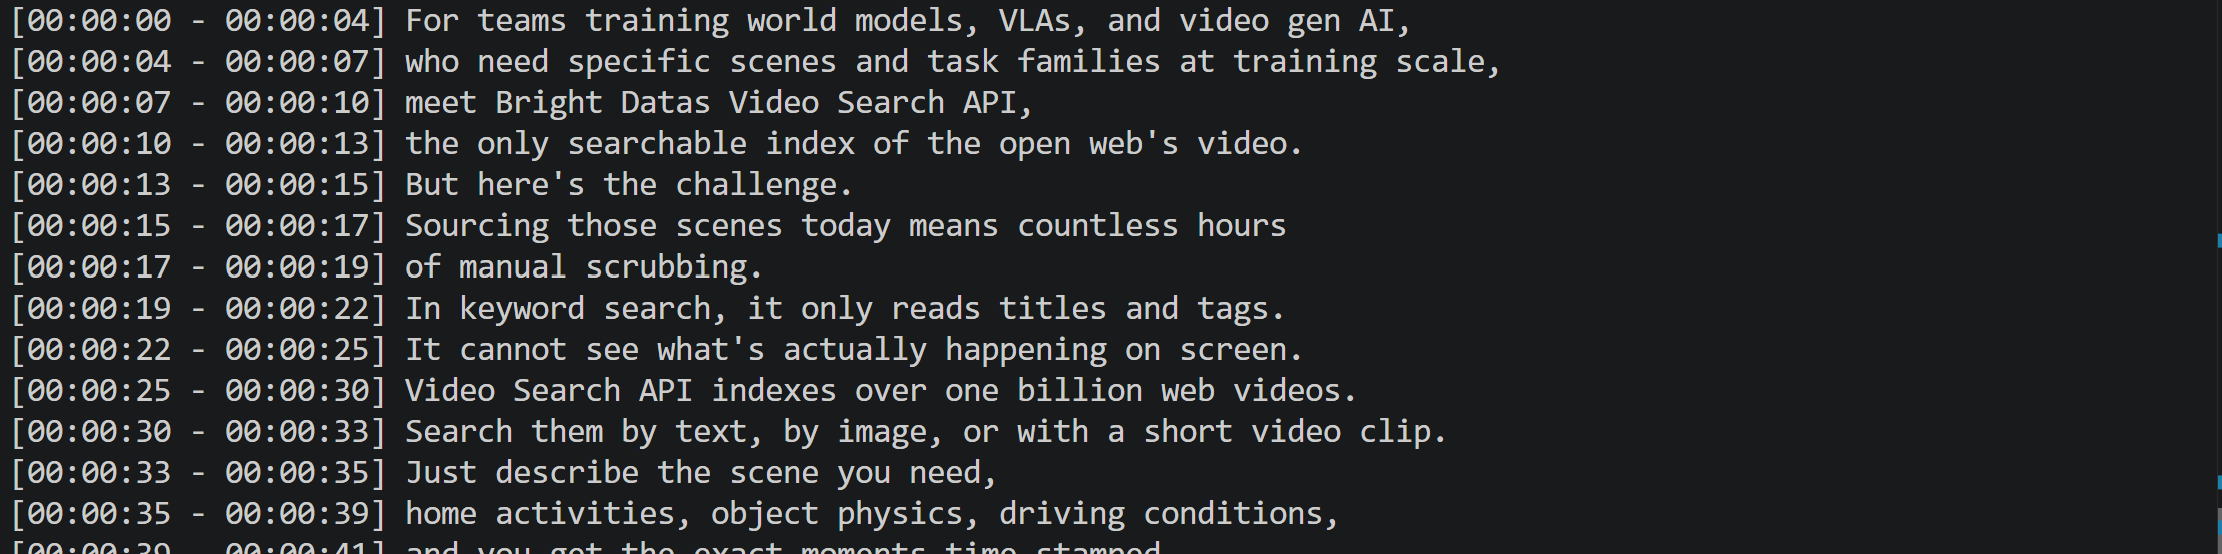
此脚本首先使用你的 API 密钥初始化 OpenAI 客户端,并以二进制模式打开 WAV 文件。然后,它将音频发送到 whisper-1 模型,并请求包含片段级时间戳的详细 JSON 响应。
随后,它会遍历返回的片段,提取每个片段的开始时间、结束时间和转录文本,并将其格式化为易读的带时间戳文本行。每一行都会打印到终端并写入 video_transcript.txt。
执行 Python 脚本后,你将在终端中看到转录输出:
处理完成后video_transcript.txt 文件将包含带时间戳的转录文本:
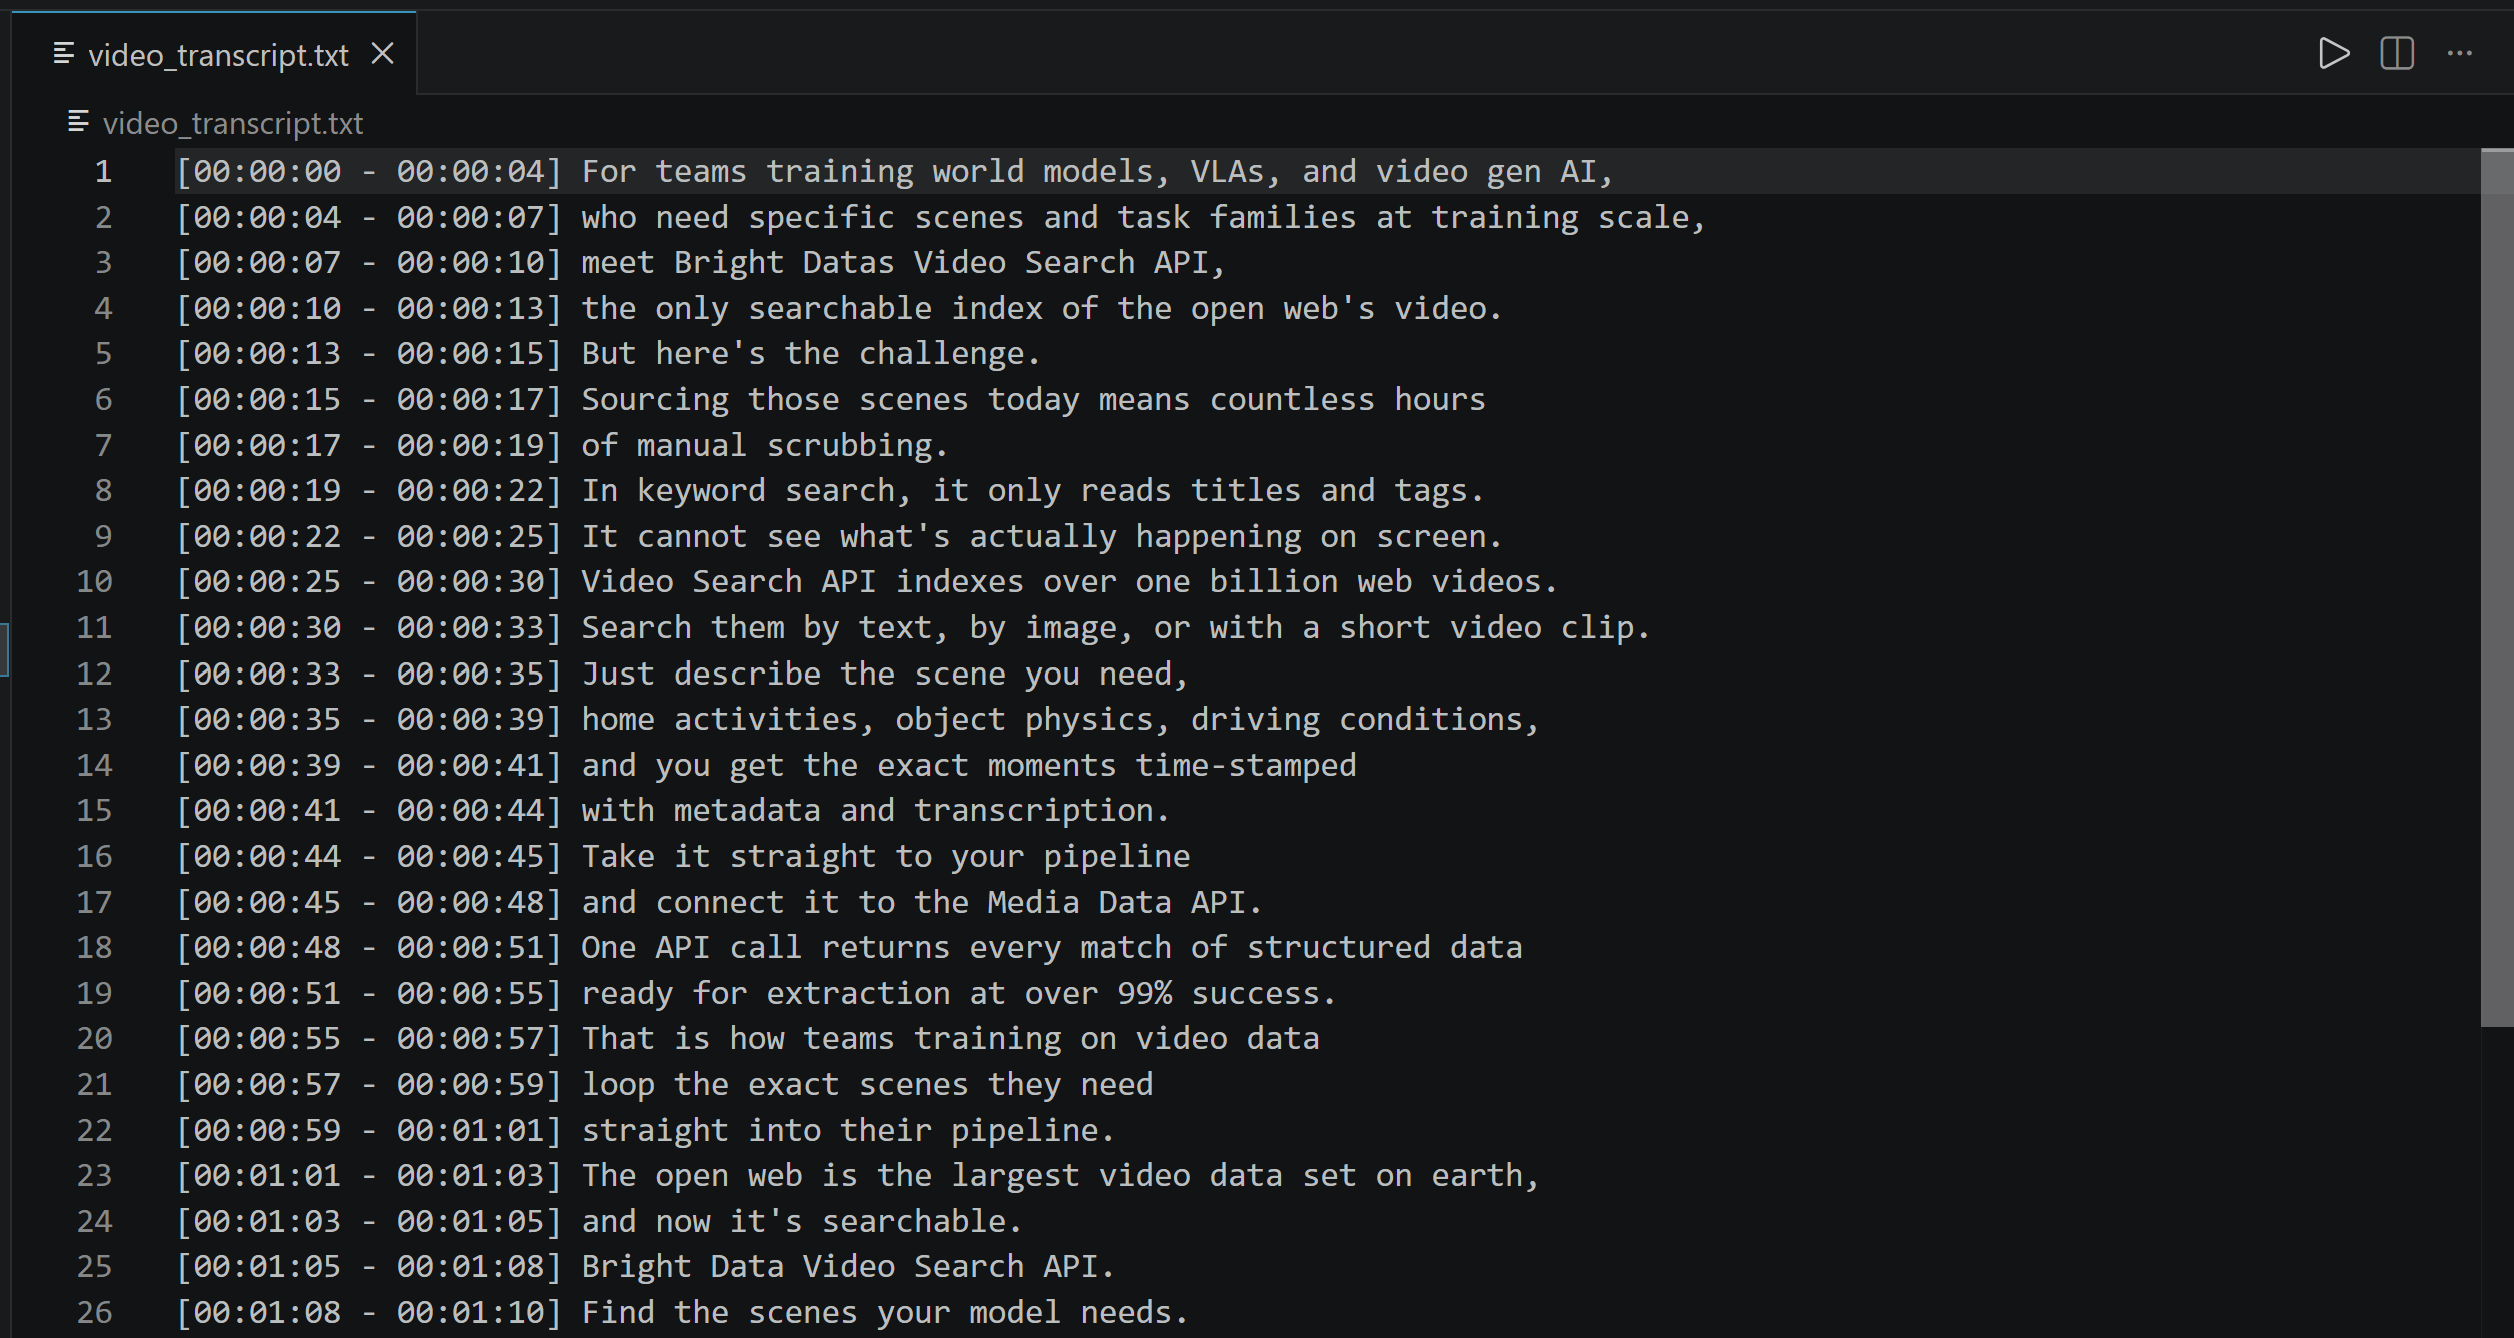
任务完成!你从一个 YouTube 视频开始,对其进行抓取,将其音频转换为 WAV 格式,最后将其转录为文本。现在,你已经获得了一份可供进一步分析的清晰转录文本。
这种方法的主要限制包括:
- 输入文件大小:通过转录 API 提交的音频文件大小上限为 25 MB。对于较大的录音,你需要压缩音频以减小文件大小,或在转录前将其拆分成更小的片段。
- 成本:较长的音频录音可能会产生大量 API 用量。音频越长,所需的输入 token 和生成的输出 token 就越多。
或者,你也可以在本地运行语音转文本模型,如下一节所示。
使用本地 AI 模型获取转录文本
你可以使用多种本地语音转文本模型和库来生成转录文本。faster-whisper 是一个热门选择。它是 OpenAI Whisper 模型的重新实现,使用了 CTranslate2后者是一款适用于 Transformer 模型的高性能推理引擎。
使用以下命令安装 faster-whisper:
pip install faster-whisper然后,使用它根据本地音频文件生成转录文本:
from faster_whisper import WhisperModel

# Load the local Whisper model
model = WhisperModel(
    "small",
    device="cpu", # Run the task on the CPU
    compute_type="int8"
)

# Transcribe the input audio file and return timestamped transcript segments
segments, info = model.transcribe(
    "audio_output.wav",
    beam_size=5
)

# Print the language detected by Whisper
print(f"Detected language: {info.language}")

# Convert seconds into a readable HH:MM:SS timestamp
def format_timestamp(seconds):
    hours = int(seconds // 3600)
    minutes = int((seconds % 3600) // 60)
    seconds = int(seconds % 60)

    return f"{hours:02d}:{minutes:02d}:{seconds:02d}"

# Write each timestamped transcript segment to an output file
with open("audio_transcript.txt", "w", encoding="utf-8") as f:
    for segment in segments:
        # Get the start and end timestamps for this segment
        start = format_timestamp(segment.start)
        end = format_timestamp(segment.end)

        # Remove unnecessary whitespace from the transcribed text
        text = segment.text.strip()

        # Combine the timestamps and transcript into a single line
        line = f"[{start} - {end}] {text}"

        # Print the segment to the console and save it to the file
        print(line)
        f.write(line + "\n")
此脚本会在本地加载 small Whisper 模型,并使用 int8 量化在 CPU 上运行。它会将 audio_output.wav 转录为带时间戳的片段,检测音频语言,并使用开始和结束时间格式化每个片段。生成的转录文本会打印到控制台并保存到 video_transcript.txt。
运行脚本后,你将看到类似以下内容的输出:
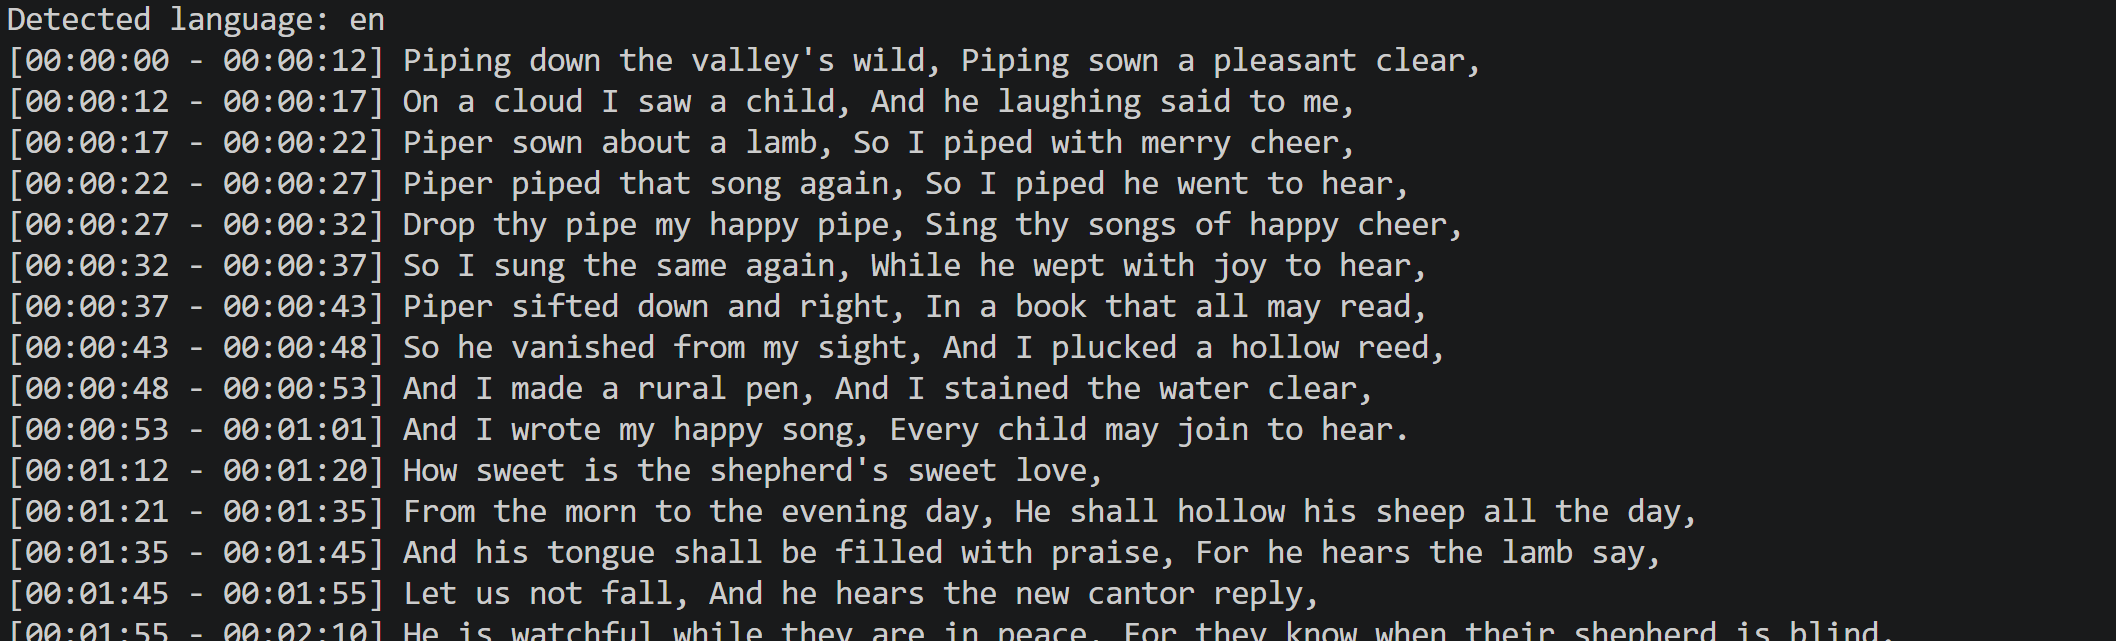
现在faster-whisper 模型已成功检测到音频语言为英语,并生成了准确的转录文本。
生成的 video_transcript.txt 文件将包含带时间戳的转录文本:
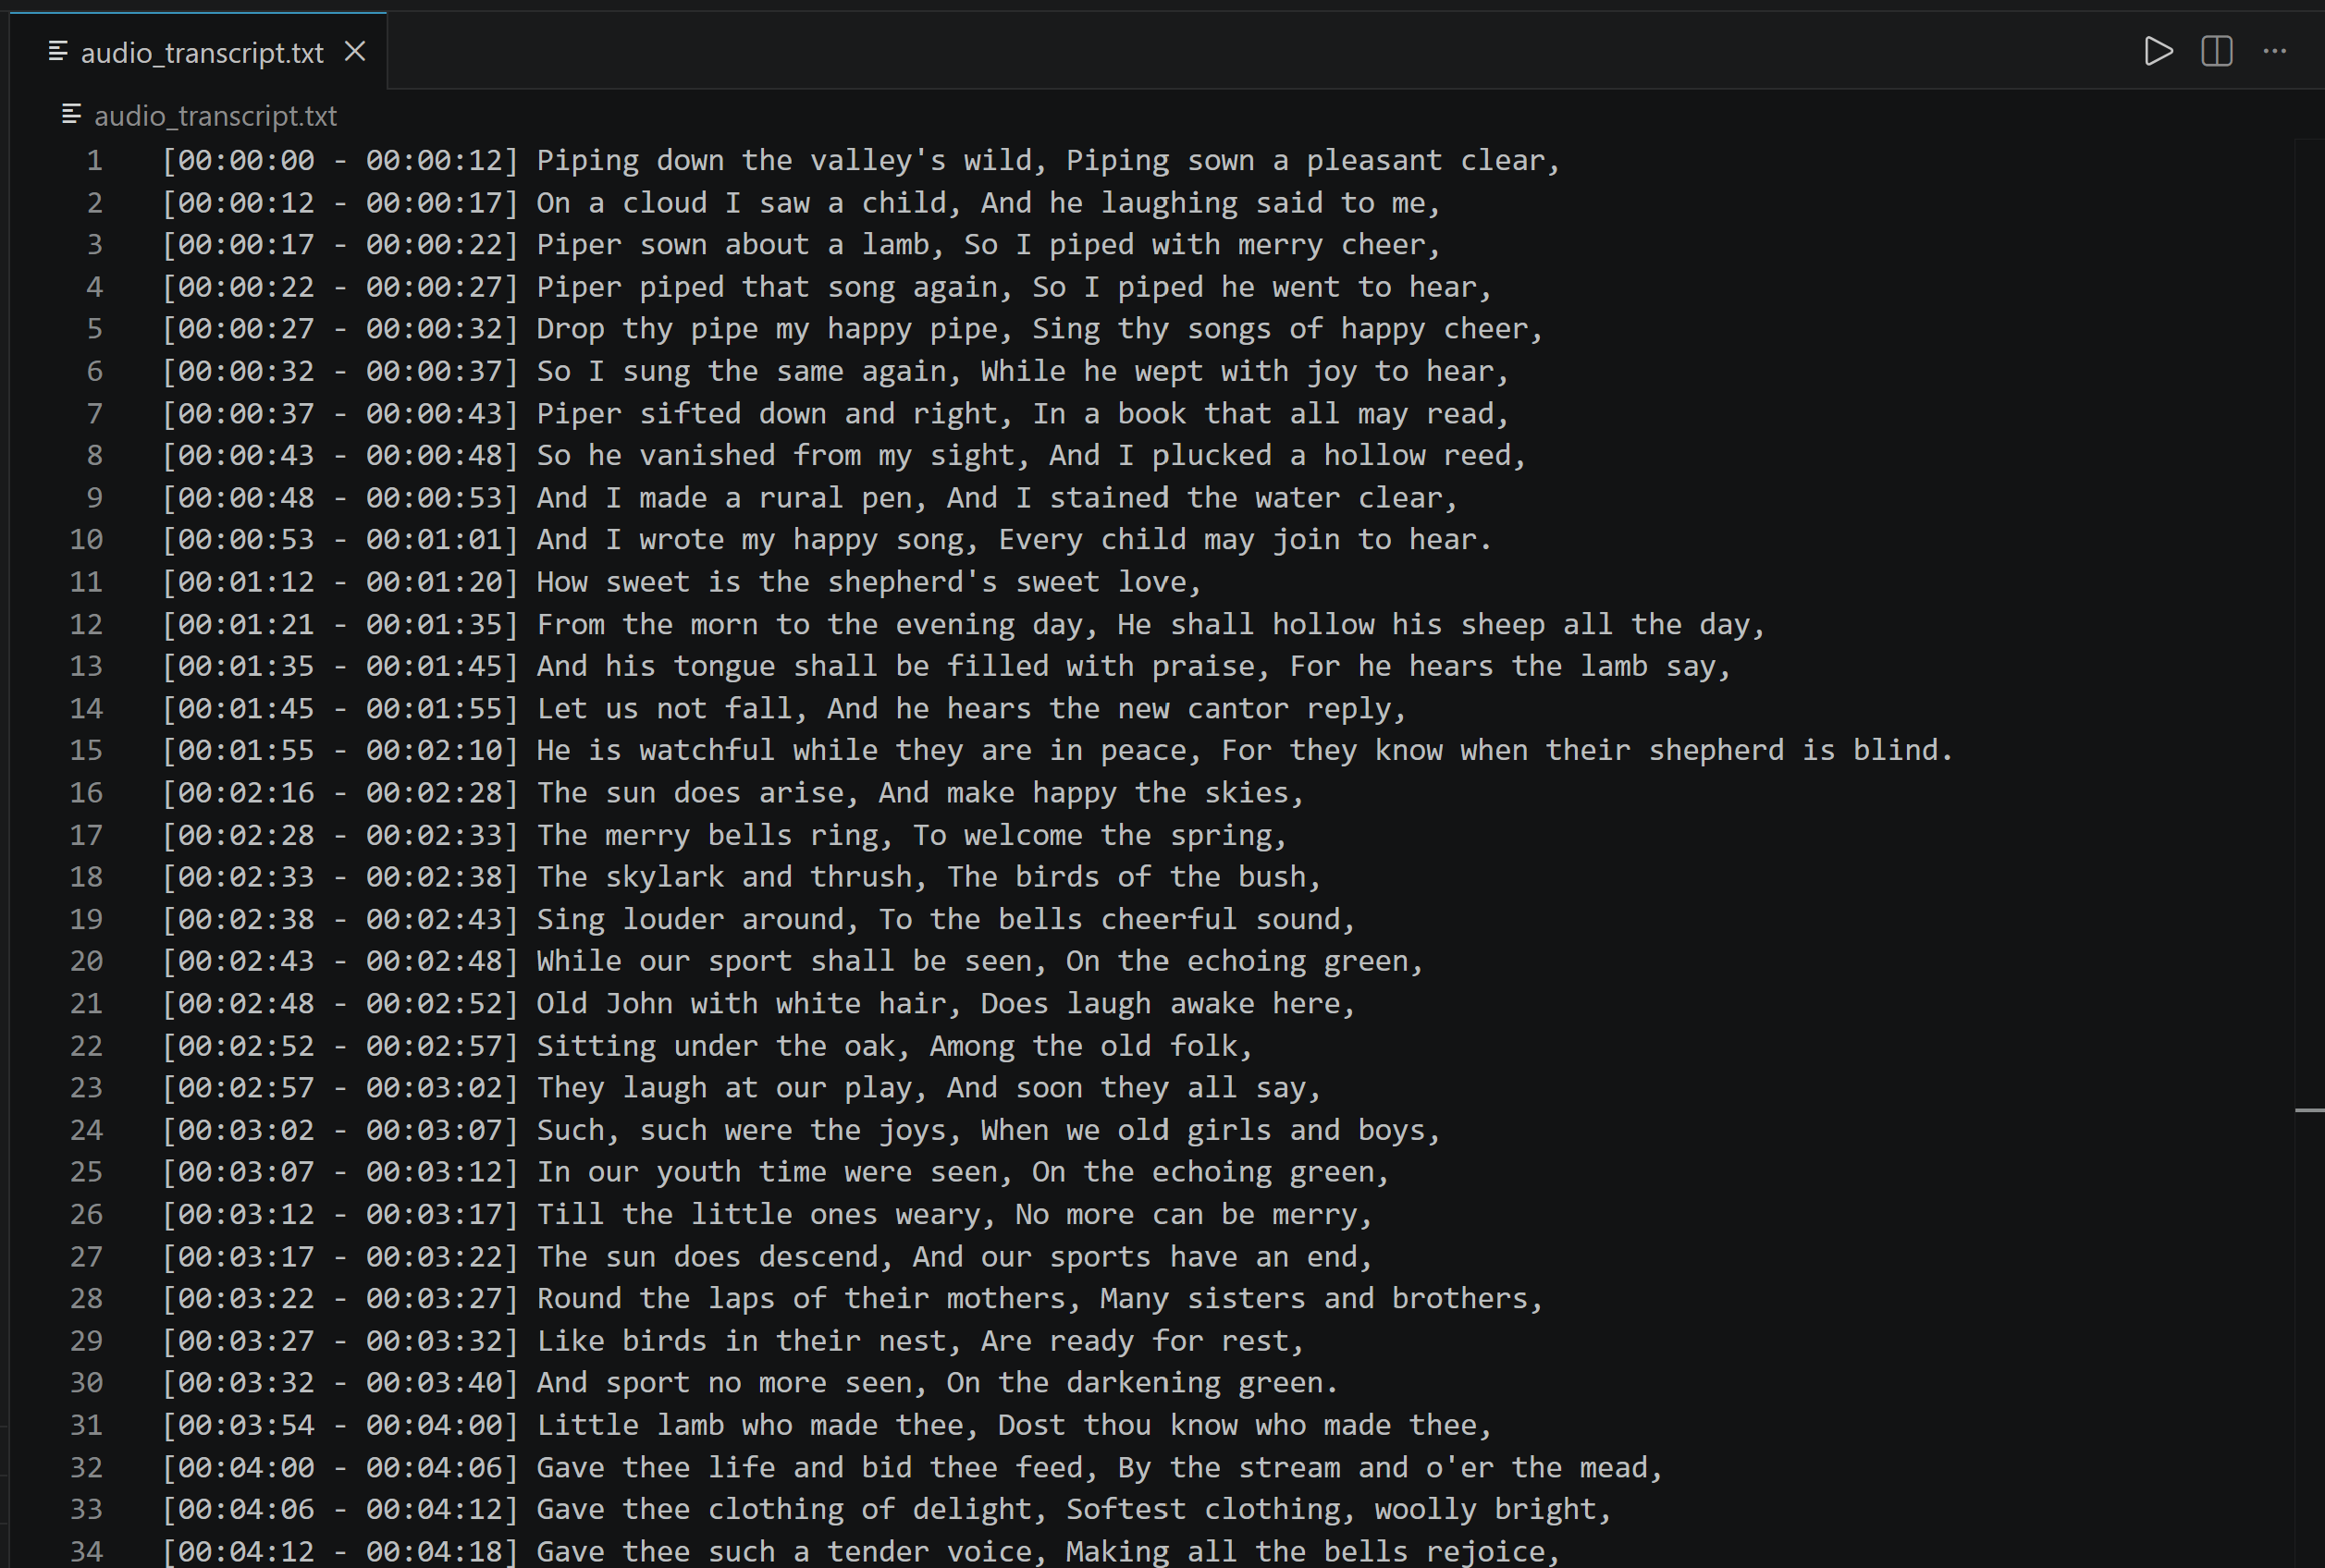
大功告成!你已经完成整个音频网页抓取管道,包括:
- 从网络获取音频录音。
- 将其转换为标准化的 WAV 文件。
- 使用本地 AI 模型将音频转换为带时间戳的文本转录。
音频网页抓取:用例和场景
从网络抓取音频并将其转换为文本后,你可以将生成的结果用于各种 AI 和数据处理应用。
音频、转录文本和时间戳的组合既支持内容级分析,也支持音频与文本相关的应用。可能的用例包括:
- 媒体监测:跟踪播客、访谈和广播,识别其中提及的内容、主题、品牌或事件。
- 内容分析:分析大量语音内容,发现反复出现的主题、趋势、观点和核心议题。
- AI 模型训练:构建音频文本数据集,用于训练或微调语音识别模型及其他 AI 模型。
- 可搜索档案:将大型在线音频集合转换为可搜索文本,让用户能够快速找到特定信息。
- 信息提取:自动从语音内容中提取姓名、组织、地点、事实或其他结构化信息。
- 内容摘要:为播客、访谈、讲座、会议及其他长篇录音生成简洁摘要。
- 音频文本对齐:使用时间戳将转录片段与其在原始音频中的准确位置关联起来,实现精确的内容检索和分析。
总结
在本文中,你学习了如何从网络抓取音频,并将其转换为带时间戳的文本以供 AI 处理。具体来说,你了解了如何从视频或独立文件中采集音频、将其转换为 WAV,以及如何使用基于云或本地的 AI 模型进行转录。
最终得到的是一个完整的音频处理管道,可支持内容分析、信息提取、可搜索档案和 AI 模型训练等应用。
如果你想跳过抓取步骤,可以探索 Bright Data 的 AI 就绪音频数据集和视频数据包。如果需要自定义音频采集,请使用 Bright Data 的网络解锁器,以可靠且可扩展的方式访问所需网络资源,同时避免遭到屏蔽。
立即创建 Bright Data 账户,开始构建你的音频数据管道!


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。