在这篇博客文章中,你将学习:
- Grok Build 是什么,以及它作为基于终端的 AI 编码代理所提供的能力。
- 为什么添加实时 Web 访问可以帮助 Grok Build 生成更及时的结果。
- Bright Data 如何通过网页搜索、抓取、发现和浏览器自动化能力扩展 Grok Build。
- 如何将 Bright Data Web MCP 连接到 Grok Build。
- 如何使用 Agent skills 通过 Bright Data 产品知识增强 Grok Build。
- Grok Build 和 Bright Data 如何在真实工作流中协同工作。
让我们开始吧!
什么是 Grok Build?
Grok Build 是一个由 SpaceXAI 开发的开源、基于终端的 AI 编码代理。它将全屏终端 UI (TUI) 与可扩展的代理运行时结合在一起,能够理解你的代码库、编辑文件、执行 shell 命令并自动化开发任务。
它可以从终端以交互方式使用,也可以在无头模式下用于脚本和 CI/CD 流水线,或通过 ACP(Agent Client Protocol)嵌入到编辑器中。
主要功能
Grok Build 提供的关键能力包括:
- AI 驱动的编码和自动化:理解代码库,编写和重构代码,审查变更,编辑多个文件,执行 shell 命令,运行构建和测试,并直接从 CLI 自动化开发工作流。
- 规划和推理:为复杂任务生成执行计划,让你审查和批准它们,并将每项变更显示为清晰的 diff。
- 并行子代理:启动专门的 AI 子代理,并发处理研究、实现和测试等独立任务。
- 可扩展性:支持 MCP 服务器、Agent 技能、插件、hooks 和
AGENTS.md文件,以自定义能力并集成外部工具。 - 开源架构:在 Apache 2.0 许可下发布在 GitHub 上,使你能够检查源代码,了解代理如何工作,并扩展其功能。
- 无头执行:以非交互方式运行,用于脚本、自动化和 CI/CD 工作流,同时支持 ACP。
- 持久上下文:维护配置、项目约定和会话记忆,以便在开发会话之间提供更一致的协助。
在官方文档中了解更多信息。
为什么用网页搜索、抓取和导航能力扩展 Grok Build CLI
毫无疑问,Grok Build 是一个强大的基于终端的 AI 编码代理。然而,像任何由 LLM 驱动的系统一样,其内置知识受限于训练期间可用的数据。
无论 AI 模型有多新,它都没有其训练截止时间之后发布的信息。在快速变化的 IT 领域,这可能意味着错过有关安全漏洞、软件发布、文档变更和不断演变的最佳实践的关键更新。
对于开发者而言,仅依赖静态 LLM 知识可能会降低研究、故障排查和自动化工作流的有效性。一个有能力的 AI 编码代理必须能够查阅最新文档、检查实时网站、发现新来源,并从未包含在其原始训练数据中的平台检索数据。
Grok Build 通过内置网页搜索能力解决了这一挑战的一部分。然而,由于速率限制和 CAPTCHA 等反机器人机制,此类 Web 访问方法在规模化使用或与受保护网站交互时会遇到困难。
这正是 Bright Data 集成发挥作用的地方。通过将 Grok Build 与 Bright Data 的基础设施连接,CLI 代理可以访问面向企业的工具,用于实时网页搜索、数据提取、来源发现、浏览器自动化和数据集检索。
Bright Data 集成脱颖而出的原因在于其全球基础设施,包括 4 亿多个住宅 IP。这种架构提供了苛刻 Web 数据工作流所需的可扩展性、可靠性和性能。它支持无限并发,拥有 99.99% SLA 支持的正常运行时间,并实现 99.95% 的成功率。
Bright Data 如何支持与 Grok Build 的集成
Bright Data 通过两个互补的集成扩展 Grok Build:
- Bright Data Web MCP:一个 MCP 服务器,公开 70+ 个用于网页搜索、抓取、结构化提取和浏览器自动化的工具。
- Bright Data 技能:为 Grok Build 提供有关 Bright Data 产品、推荐工作流和最佳实践的专业知识的 Agent skills。
Bright Data 技能 帮助代理了解何时以及如何有效使用 Web MCP 工具,并结合 Bright Data CLI 暴露的命令。
Bright Data Web MCP 和 技能 共同将 Grok Build 转变为一个更有能力的 CLI 代理,能够将本地开发工作流与实时 Web 情报、自动化和结构化数据提取相结合。
Bright Data Web MCP
Bright Data Web MCP 为 Grok Build 配备了一套由 Bright Data API 驱动的广泛 Web 交互能力。
在 Rapid mode(每月 5K 请求的免费层)中,你可以访问用于 Web 研究和数据提取的基本工具。这些包括:
| 工具 | 描述 |
|---|---|
search_engine 和 search_engine_batch |
以结构化格式检索 Google、Bing 和 Yandex 搜索结果,并支持并行查询。 |
scrape_as_markdown 和 scrape_batch |
从网页中提取干净的 Markdown 内容,同时处理机器人防护和访问限制。 |
discover |
执行 AI 驱动的 Web 发现,包含相关性排名、意图过滤和丰富结果。 |
通过启用 Pro mode,Grok Build 将获得用于从 Amazon、LinkedIn、YouTube、Zillow、Google Maps 以及其他 40+ 个域名等平台检索结构化数据的工具。此外,它还可以访问生产就绪的浏览器自动化工具。
Bright Data 的 技能
Bright Data skills 使用可复用的知识和工作流扩展 Grok Build,以便使用 Bright Data 产品。它们帮助代理选择合适的工具,遵循推荐方法,并自动化常见的 Web 数据任务。
一些可用的 技能包括:
| Skill | 描述 |
|---|---|
agent-onboarding |
引导新代理完成 Bright Data 设置,并将工作流路由到 MCP、CLI、API 或身份验证选项。 |
search |
通过从 Google 检索包含标题、链接和描述的结构化结果来启用实时搜索工作流。 |
scrape |
教代理如何将网页内容提取为干净的 Markdown,并自动处理反机器人绕过。 |
bright-data-mcp |
为在搜索、爬虫、提取和浏览器自动化中编排 70+ 个 Web MCP 工具提供指导。 |
scraper-builder |
通过分析网站、选择 API 和生成提取逻辑,帮助创建生产就绪的爬虫工具。 |
scraper-studio |
通过自然语言指令中的 Bright Data CLI 命令,启用 AI 驱动的抓取工具创建和执行。 |
bright-data-best-practices |
提供使用 Bright Data API 的推荐模式,包括网络解锁器、搜索引擎 API、Browser API 和网页爬虫工具 API。 |
brightdata-cli |
允许代理使用 Bright Data CLI 进行抓取、搜索、数据集、代理管理和账户操作。 |
competitive-intel |
支持实时竞争对手研究、定价分析、评论监控和市场情报工作流。 |
brand-listening |
帮助分析社交平台、论坛和评论网站上的品牌提及、情绪和讨论。 |
price-comparison |
通过收集主要零售商的定价和可用性数据,启用产品比较工作流。 |
seo-audit |
使用实时网站数据、技术信号和搜索可见性洞察执行 SEO 分析。 |
live-research |
通过结合发现、提取、排名和 AI 生成的摘要来构建多来源研究报告。 |
rag-pipeline |
帮助使用实时 Web 数据作为检索来源创建检索增强生成工作流。 |
brightdata-proxy |
为不同环境生成代理集成代码,包括 Python、Node.js、Playwright、Puppeteer 和 Selenium。 |
Grok Build 设置:通用步骤
在接下来的两章中,你将分别学习如何使用 MCP 和 Agent 技能 将 Bright Data 集成到 Grok Build 中。在探索这些集成之前,让我们先完成准备本地 Grok Build 环境所需的通用设置步骤。
前提条件
要跟随本教程,请确保你拥有:
- 一个有效的 SuperGrok/X Premium+ 订阅或一个 SpaceXAI API key。
- 一个配置了 API key 的 Bright Data 账户。按照官方指南生成你的 Bright Data API token。
安装 Grok Build
要在 macOS、Linux 或 WSL 上安装 Grok Build,请运行:
curl -fsSL https://x.ai/cli/install.sh | bash此命令会下载并执行 Grok Build 安装脚本。输出应类似如下:
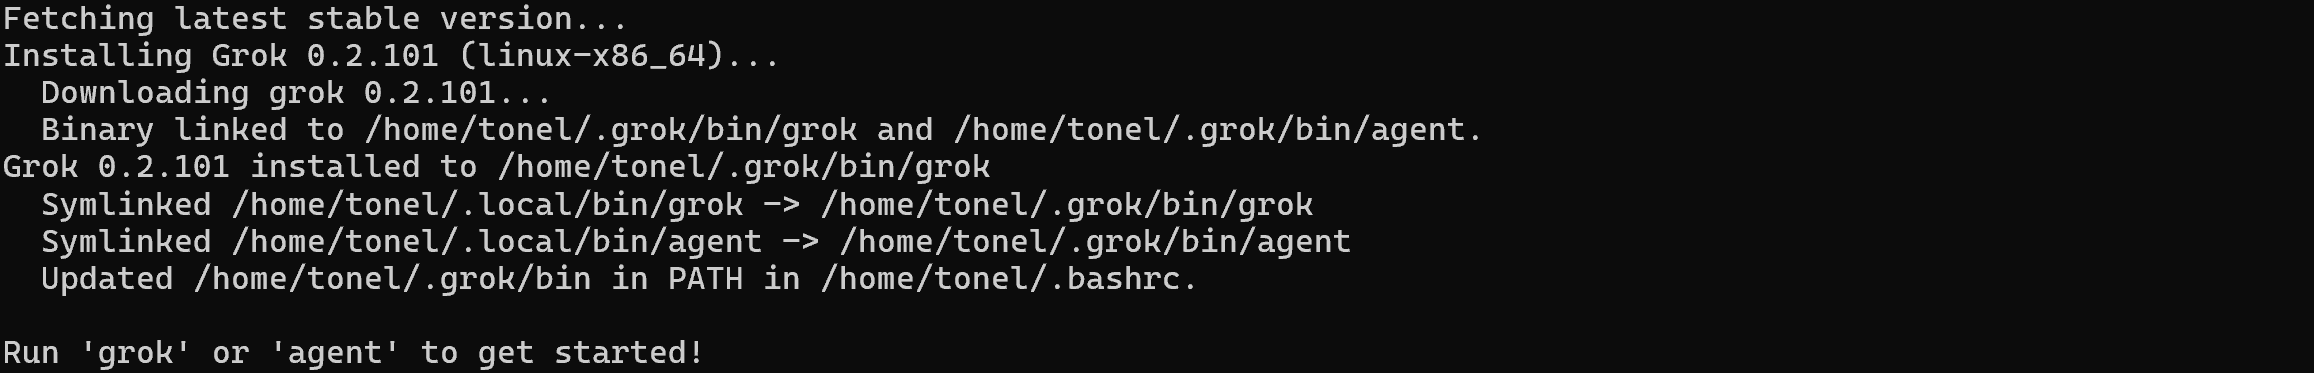
要在 Windows 上安装 Grok Build,请打开 PowerShell 并运行:
irm https://x.ai/cli/install.ps1 | iexgrok 命令现在应该已在你的系统上全局可用。做得好!
对 Grok Build 进行身份验证和配置
通过运行以下命令首次启动 Grok Build:
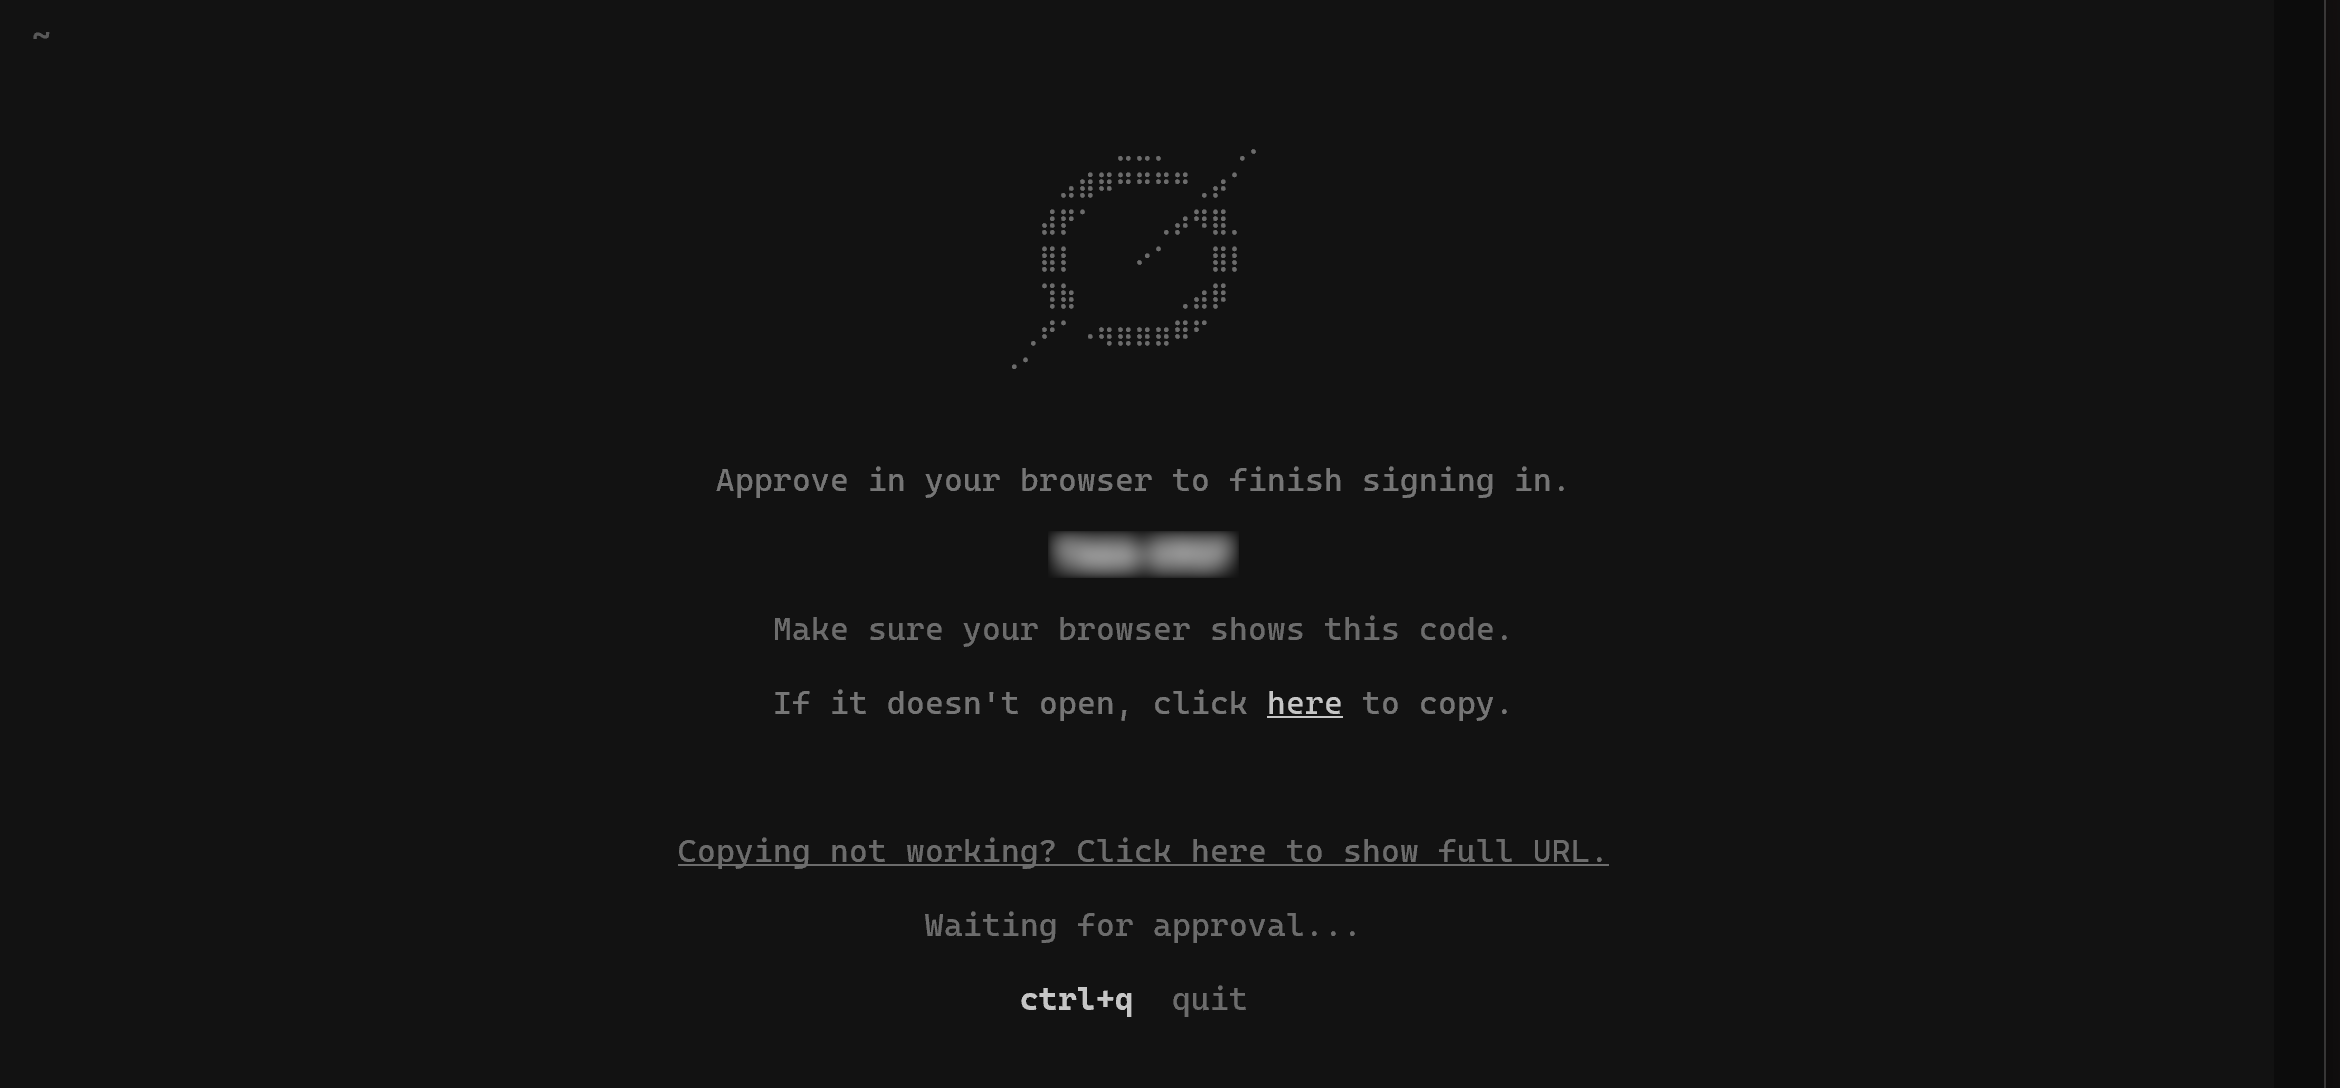
grok你将收到将 Grok Build 连接到具有有效订阅的 Grok 账户的说明:
或者,你可以通过设置 XAI_API_KEY 环境变量,使用 SpaceXAI API key 进行身份验证:
export XAI_API_KEY="<YOUR_SPACEXAI_API_KEY>"在 Windows 上,使用等效的 PowerShell 命令设置该变量:
$Env:XAI_API_KEY="<YOUR_SPACEXAI_API_KEY>"将 <YOUR_SPACEXAI_API_KEY> 占位符替换为你的实际 SpaceXAI API key。
然后,启动 Grok Build:
grok成功通过身份验证后,你将看到 Grok Build TUI:
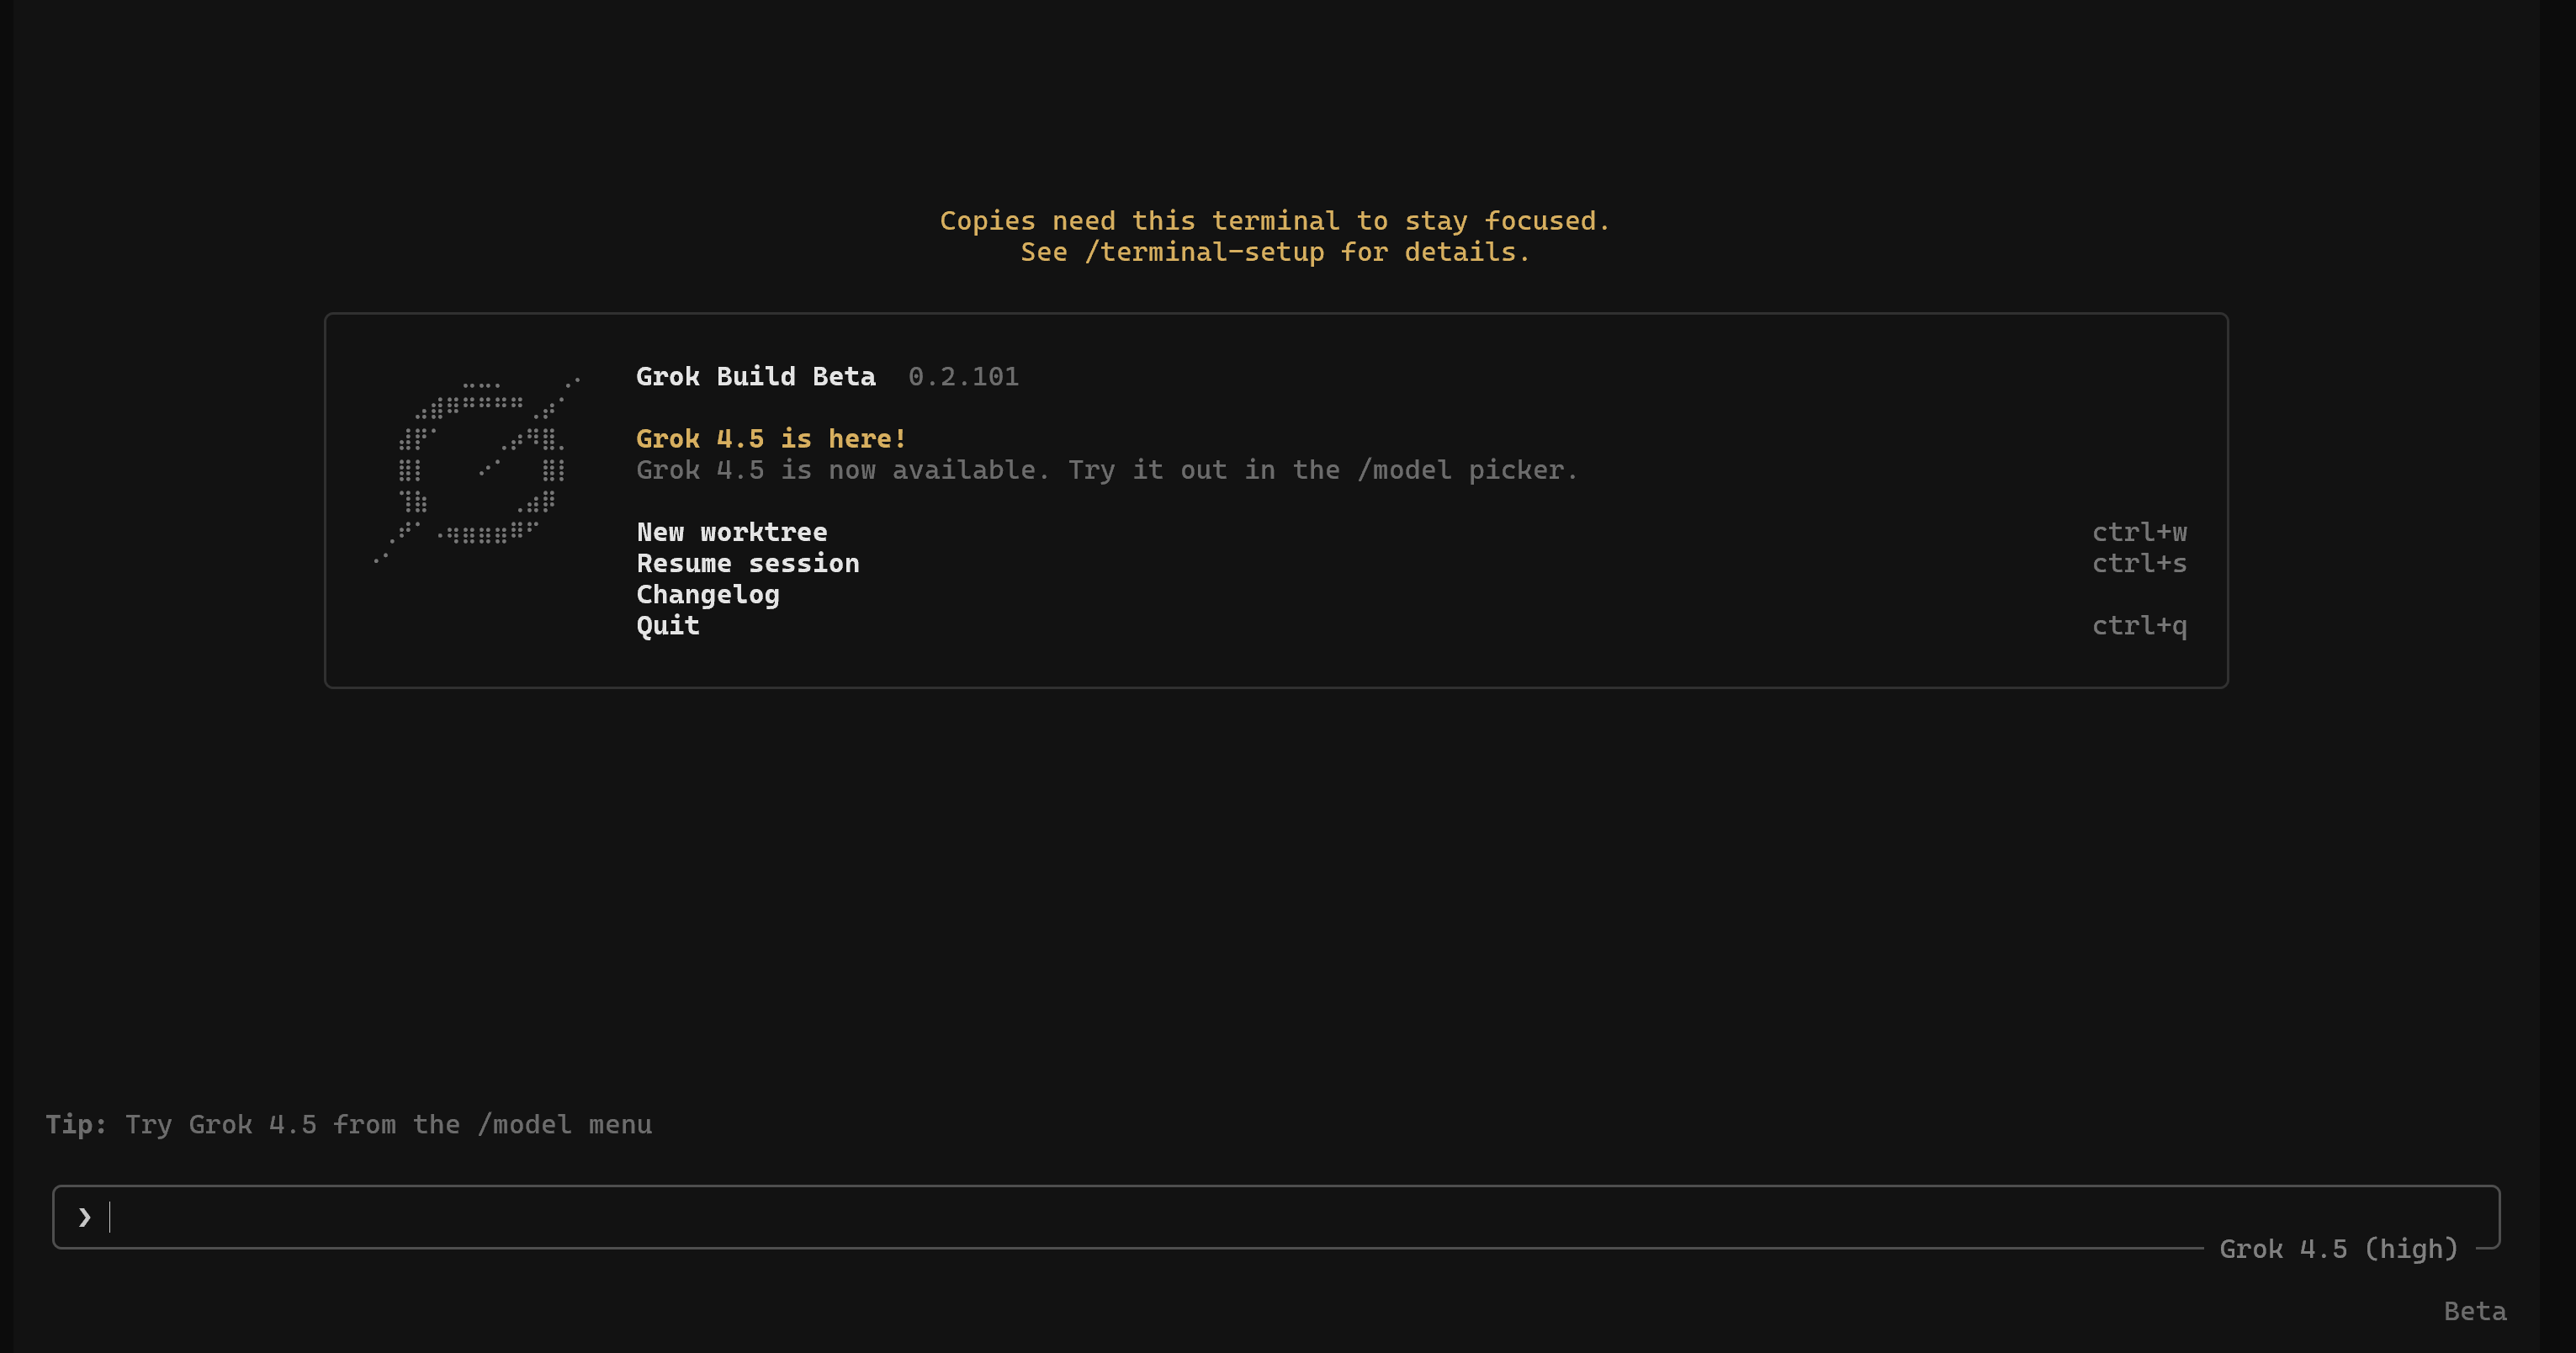
最后,根据你的偏好配置 Grok Build。例如,你可以使用 /model 命令选择要使用的 LLM 模型(默认是 Grok 4.5)。
Grok Build 现在已在本地安装并配置完成。你已准备好使用 MCP 和 Agent 技能 集成 Bright Data。太棒了!
将 Grok Build 连接到 Bright Data 的 Web MCP
在这里,你将学习如何在 Grok Build 中配置 Bright Data Web MCP 服务器。
前提条件
为了更轻松地跟随操作,你应该具备:
- 关于 MCP 如何工作的基本知识。
- 熟悉 Bright Data Web MCP 提供的工具。
注意:“通用步骤”章节中描述的前提条件也适用于此处。
第 #1 步:开始使用 Bright Data 的 Web MCP
在将 Bright Data Web MCP 连接到 Grok Build 之前,请确保 MCP 服务器可以在你的机器上正确运行。有关更多详细信息,请参阅官方 Web MCP 文档。
首先,通过以下命令全局安装 Web MCP 包:
npm install -g @brightdata/mcp在 Linux、macOS 或 WSL 上,通过运行以下命令验证 MCP 服务器是否正确启动:
API_TOKEN="<YOUR_BRIGHT_DATA_API>" npx -y @brightdata/mcp而在 PowerShell 上,执行:
$Env:API_TOKEN="<YOUR_BRIGHT_DATA_API>"; npx -y @brightdata/mcp将 <YOUR_BRIGHT_DATA_API> 替换为你的实际 Bright Data API key。此命令设置所需的 API_TOKEN 环境变量,并通过 @brightdata/mcp 包在本地启动 Web MCP 服务器。
如果一切正常,你应该会看到类似这些的日志:
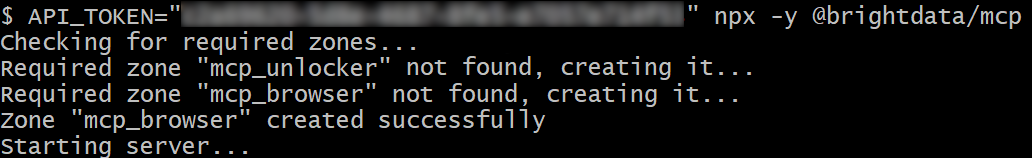
首次运行期间,@brightdata/mcp 包会在你的 Bright Data 账户中创建两个 API:
这些 API 为 Web MCP 暴露的 70+ 个工具提供支持。你也可以配置自定义 API 名称,如官方仓库中所述。
要验证这些 API 是否已创建,请打开 Bright Data 控制面板中的“Web Access > Web Access API”部分。两个 API 将出现在“My APIs”表中:
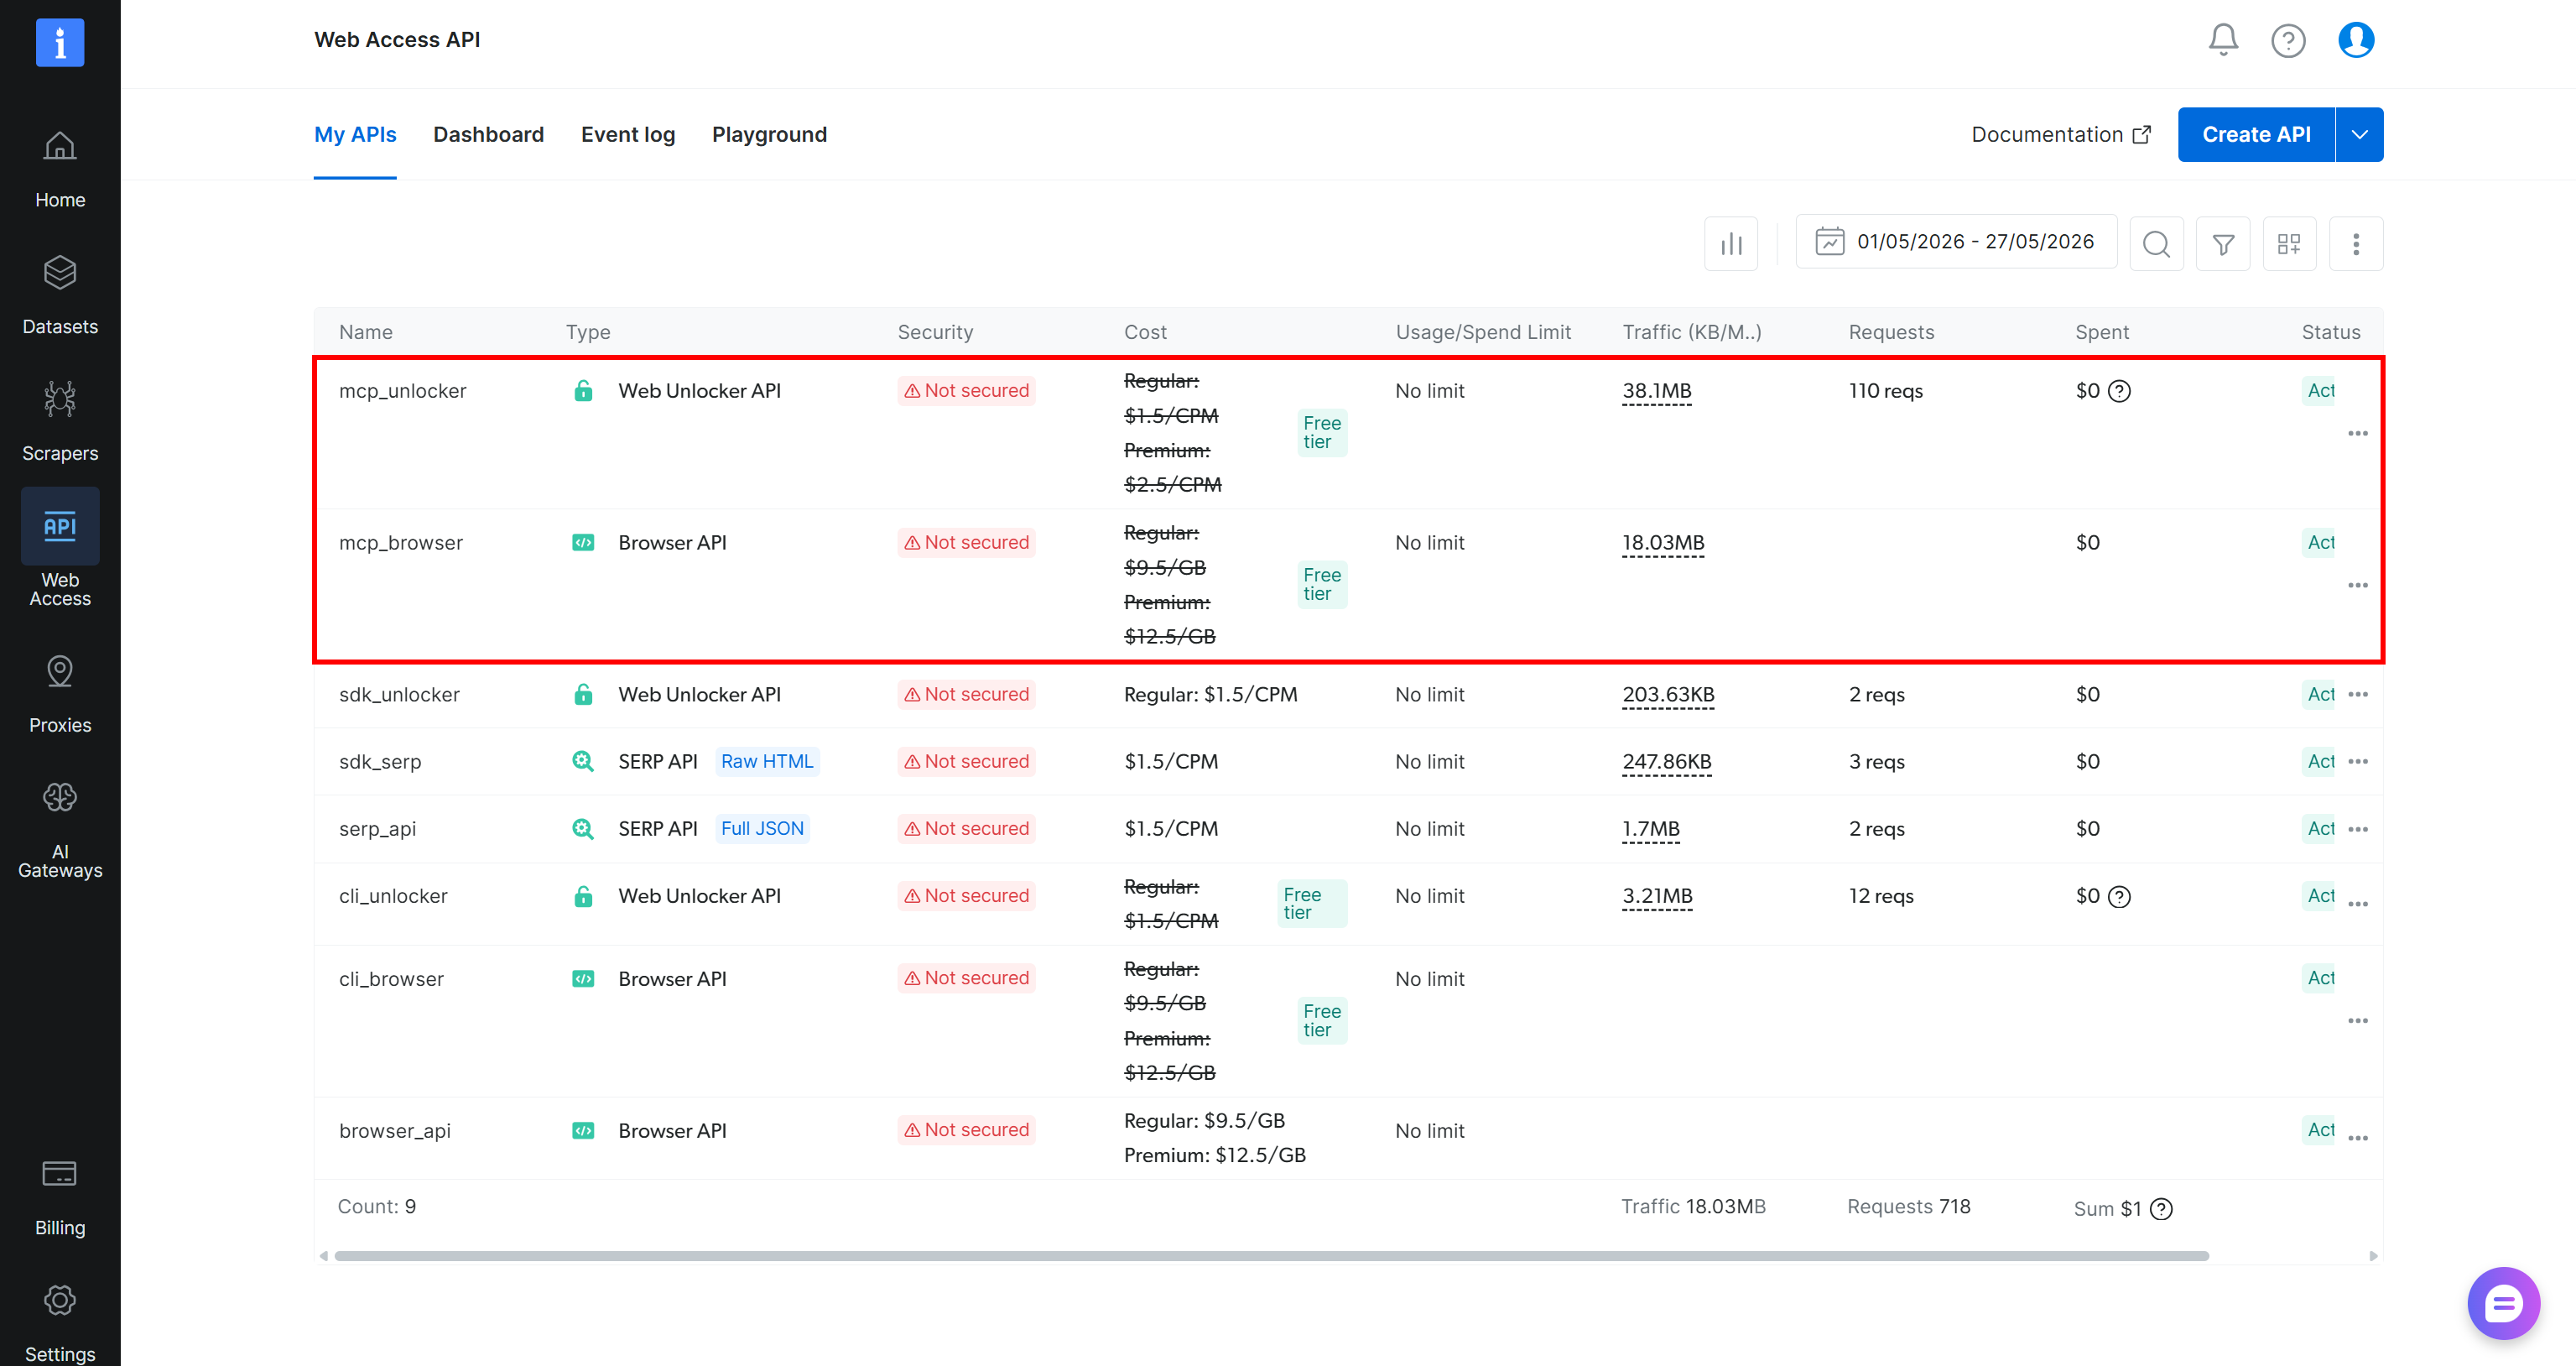
默认情况下,Web MCP 以 Rapid mode(免费层)运行,该模式提供对有限工具集的访问。
要解锁全部 70+ 个工具,请通过设置 PRO_MODE=true 环境变量启用 Pro mode:
API_TOKEN="<YOUR_BRIGHT_DATA_API>" PRO_MODE="true" npx -y @brightdata/mcp或者,在 Windows 上:
$Env:API_TOKEN="<YOUR_BRIGHT_DATA_API>"; $Env:PRO_MODE="true"; npx -y @brightdata/mcp注意: Pro mode 不包含在免费层中,并且[会产生额外费用](https://github.com/bright-cn/brightdata-mcp?tab=readme-ov-file#-pricing, modes)。
完美!你已经验证 Bright Data Web MCP 在你的机器上正确运行。接下来,在 Grok Build 中配置它。
第 #2 步:在 Grok Build 中配置 Web MCP
Grok Build 支持通过专用的 grok mcp CLI 命令进行 MCP 配置。
要将 Bright Data Web MCP 添加到 Grok Build,请运行:
grok mcp add brightdata -e API_TOKEN=<YOUR_BRIGHT_DATA_API_KEY> -e PRO_MODE=true, npx -y @brightdata/mcp将 <YOUR_BRIGHT_DATA_API_KEY> 占位符替换为你的实际 Bright Data API key。
注意:如果你只想为当前项目存储配置,请添加 --scope project 选项。
命令输出应类似如下:

默认情况下,此命令会将此 MCP 配置全局存储在 ~/.grok/config.toml 中(或 Windows 中的 %USERPROFILE%\.grok\config.toml):
[mcp_servers.brightdata]
command = "npx"
args = [
    "-y",
    "@brightdata/mcp",
]
enabled = true
[mcp_servers.brightdata.env]
API_TOKEN = “<YOUR_BRIGHT_DATA_API_KEY>” PRO_MODE = “true”
你也可以通过手动编辑 Grok Build 配置文件并添加上述内容来实现相同结果。
上述配置指定 brightdata 服务器通过 npx -y @brightdata/mcp 运行,并设置这些环境变量:
API_TOKEN(必需):你的 Bright Data API key。PRO_MODE(可选):设置为true以启用 Pro 功能。从grok mcp add命令中移除-e PRO_MODE=true,即可在 Rapid(免费)模式下配置 Web MCP。
Grok Build 现在会自动启动本地 Bright Data Web MCP 服务器并连接到它。太好了!
第 #3 步:检查 Web MCP 连接
通过关闭 CLI 重新启动 Grok Build。然后再次启动它:
grok在 Grok Build 内,运行:
/mcps这会打开“MCP Servers”视图。你应该会看到列出的 brightdata MCP 服务器。展开它以检查可用工具:
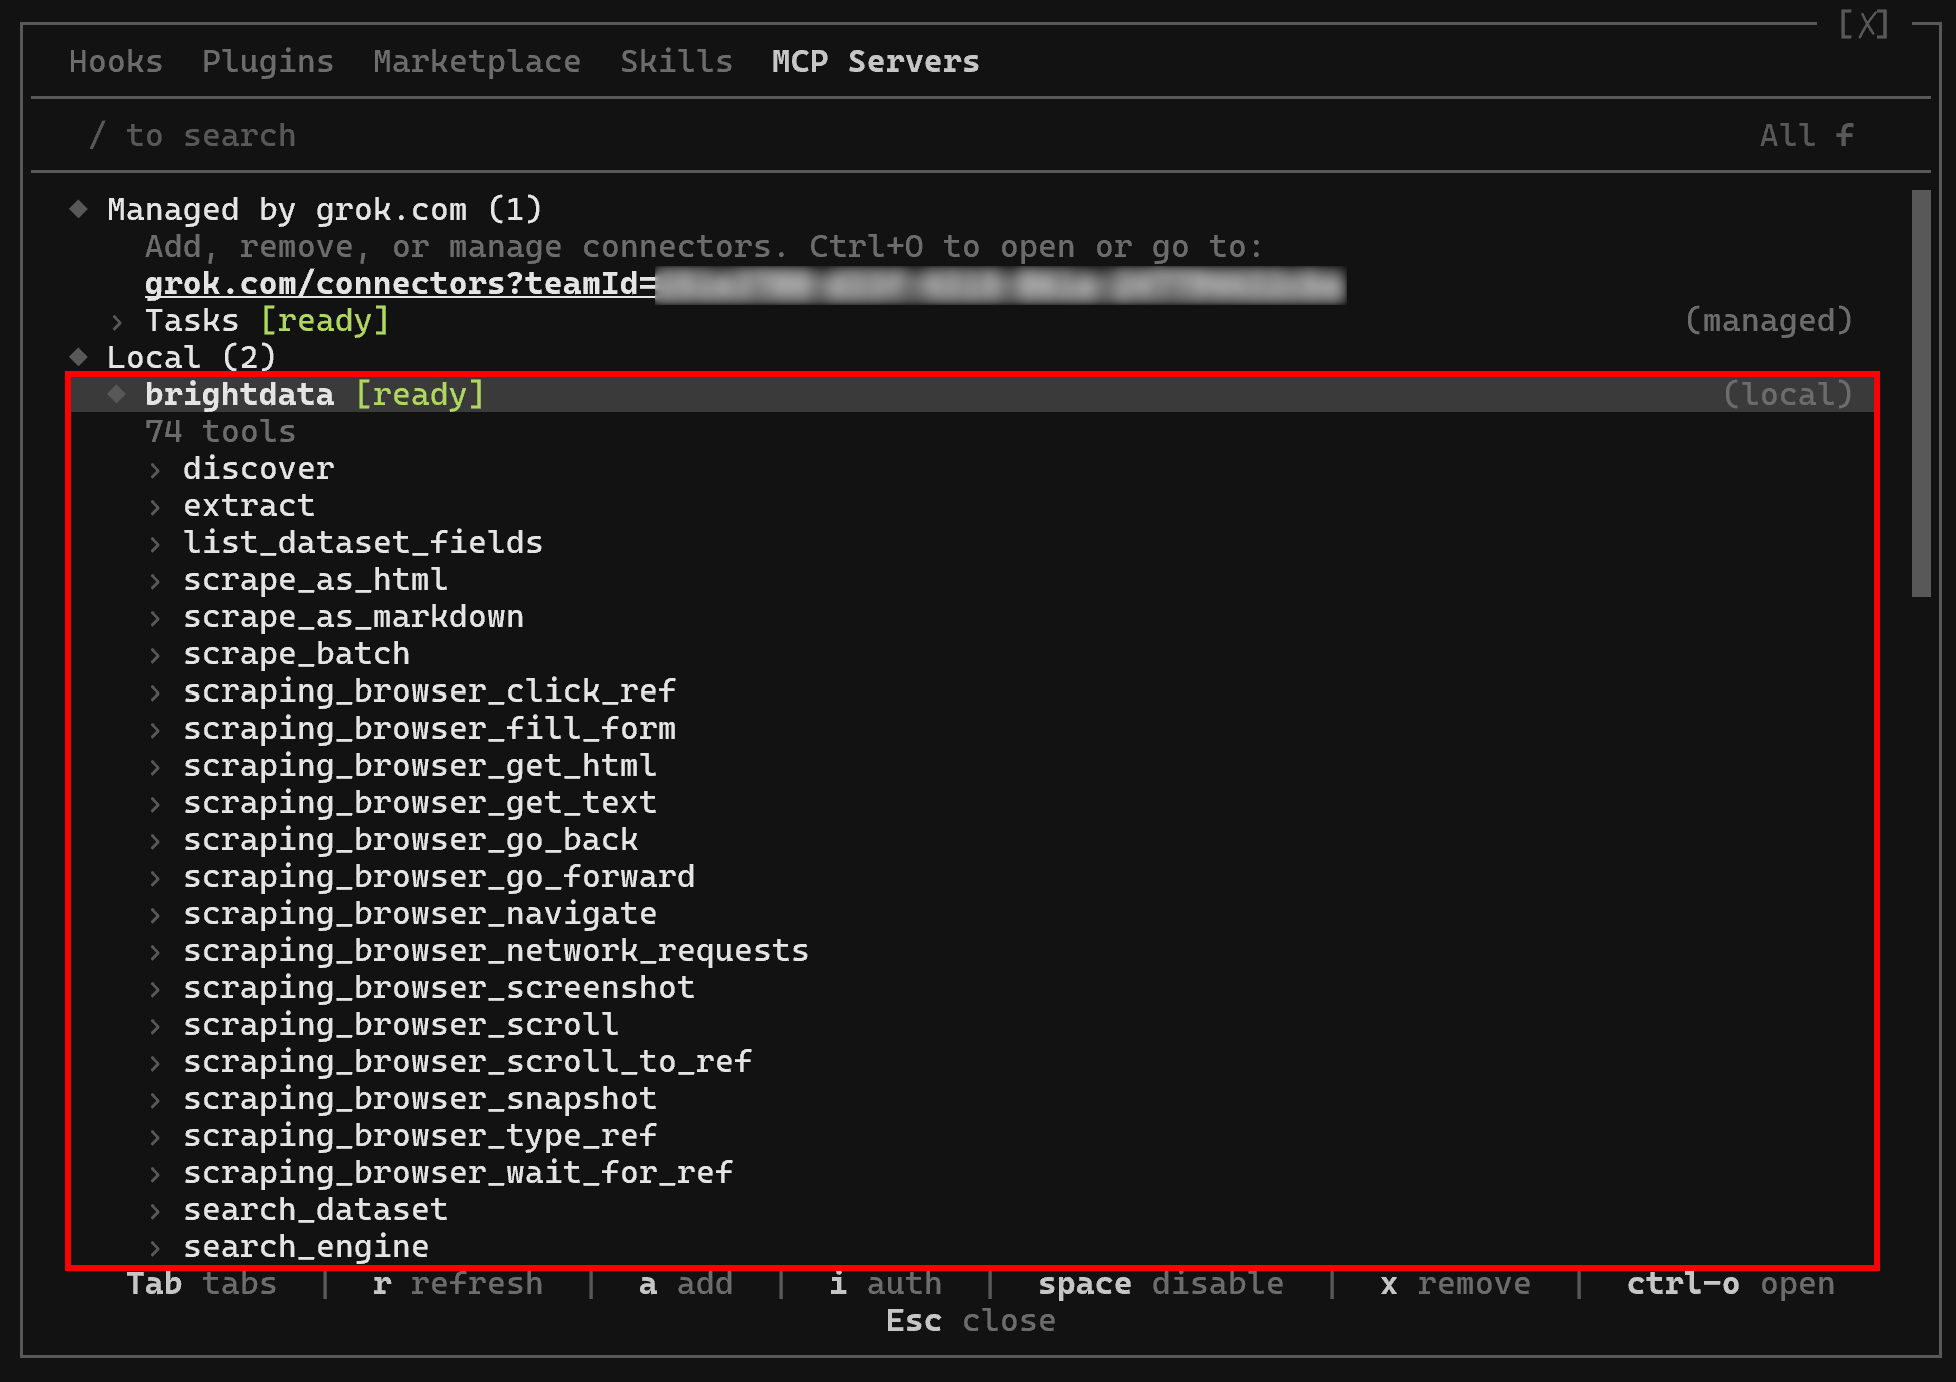
在 Pro mode 下运行时,Grok Build 将可以访问 70+ 个 Web MCP 工具。在 Rapid mode 下,只有免费工具可用。
这确认 Bright Data Web MCP 已正确连接,并向 Grok Build 暴露工具。在下一章中,你将学习如何通过添加 Bright Data 技能 进一步扩展 Grok Build。然后,你将看到 Grok Build + Bright Data Web MCP + skills 设置的实际运行!
使用官方 技能 通过 Bright Data 知识扩展 Grok Build
下面,你将被引导完成将 Bright Data skills 添加到 Grok Build 的过程。
前提条件
在跟随本节之前,请确保:
- 你正在基于 UNIX 的系统(Linux、macOS 或 WSL)上操作。
- Bright Data CLI 已在本地安装并配置。这是使用 Bright Data 技能 的主要前提条件。若要快速设置,请参阅“Bright Data CLI:安装与设置”指南或专门的博客文章。
- 你对 Bright Data 技能 提供什么有基本了解。更多信息,请阅读我们博客上的 Bright Data skills 文章。
熟悉 Agent 技能 标准也会有所帮助,但不是必需的。
第 #1 步:将 Bright Data skills 添加到 Grok Build
Grok Build 会自动发现 Agent 技能,这些 skills 存储在全局 ~/.grok/skills/ 目录(或当前项目内的本地 .grok/skills/ 目录)中。
首先,克隆官方 Bright Data 技能 仓库:
git clone https://github.com/bright-cn/skills.git接下来,如果目标目录尚不存在,请创建它:
mkdir -p ~/.grok/skills最后,将 Bright Data 技能 复制到 Grok Build 的 skills 目录中:
cp -r skills/skills/* ~/.grok/skills/~/.grok/skills/ 目录现在应包含此文件结构:
~/.grok/skills/
├── agent-onboarding/
├── brand-listening/
├── brd-browser-debug/
├── bright-data-best-practices/
├── bright-data-mcp/
├── brightdata-cli/
├── competitive-intel/
├── create-skill/
├── data-feeds/
├── design-mirror/
├── discover-api/
├── js-sdk-best-practices/
├── live-research/
├── price-comparison/
├── proxy/
├── python-sdk-best-practices/
├── rag-pipeline/
├── scrape/
├── scraper-builder/
├── scraper-studio/
├── search/
├── seo-audit/
└── other built-in skills...
每个文件夹代表一个 Agent Skill,它使用有关 Bright Data 产品、API 和推荐工作流的知识扩展 Grok Build。酷!
第 #2 步:验证 技能 是否可用
启动 Grok Build,并运行:
/skills此命令列出所有可用的 Agent 技能。你应该会看到刚刚安装的 Bright Data skills:
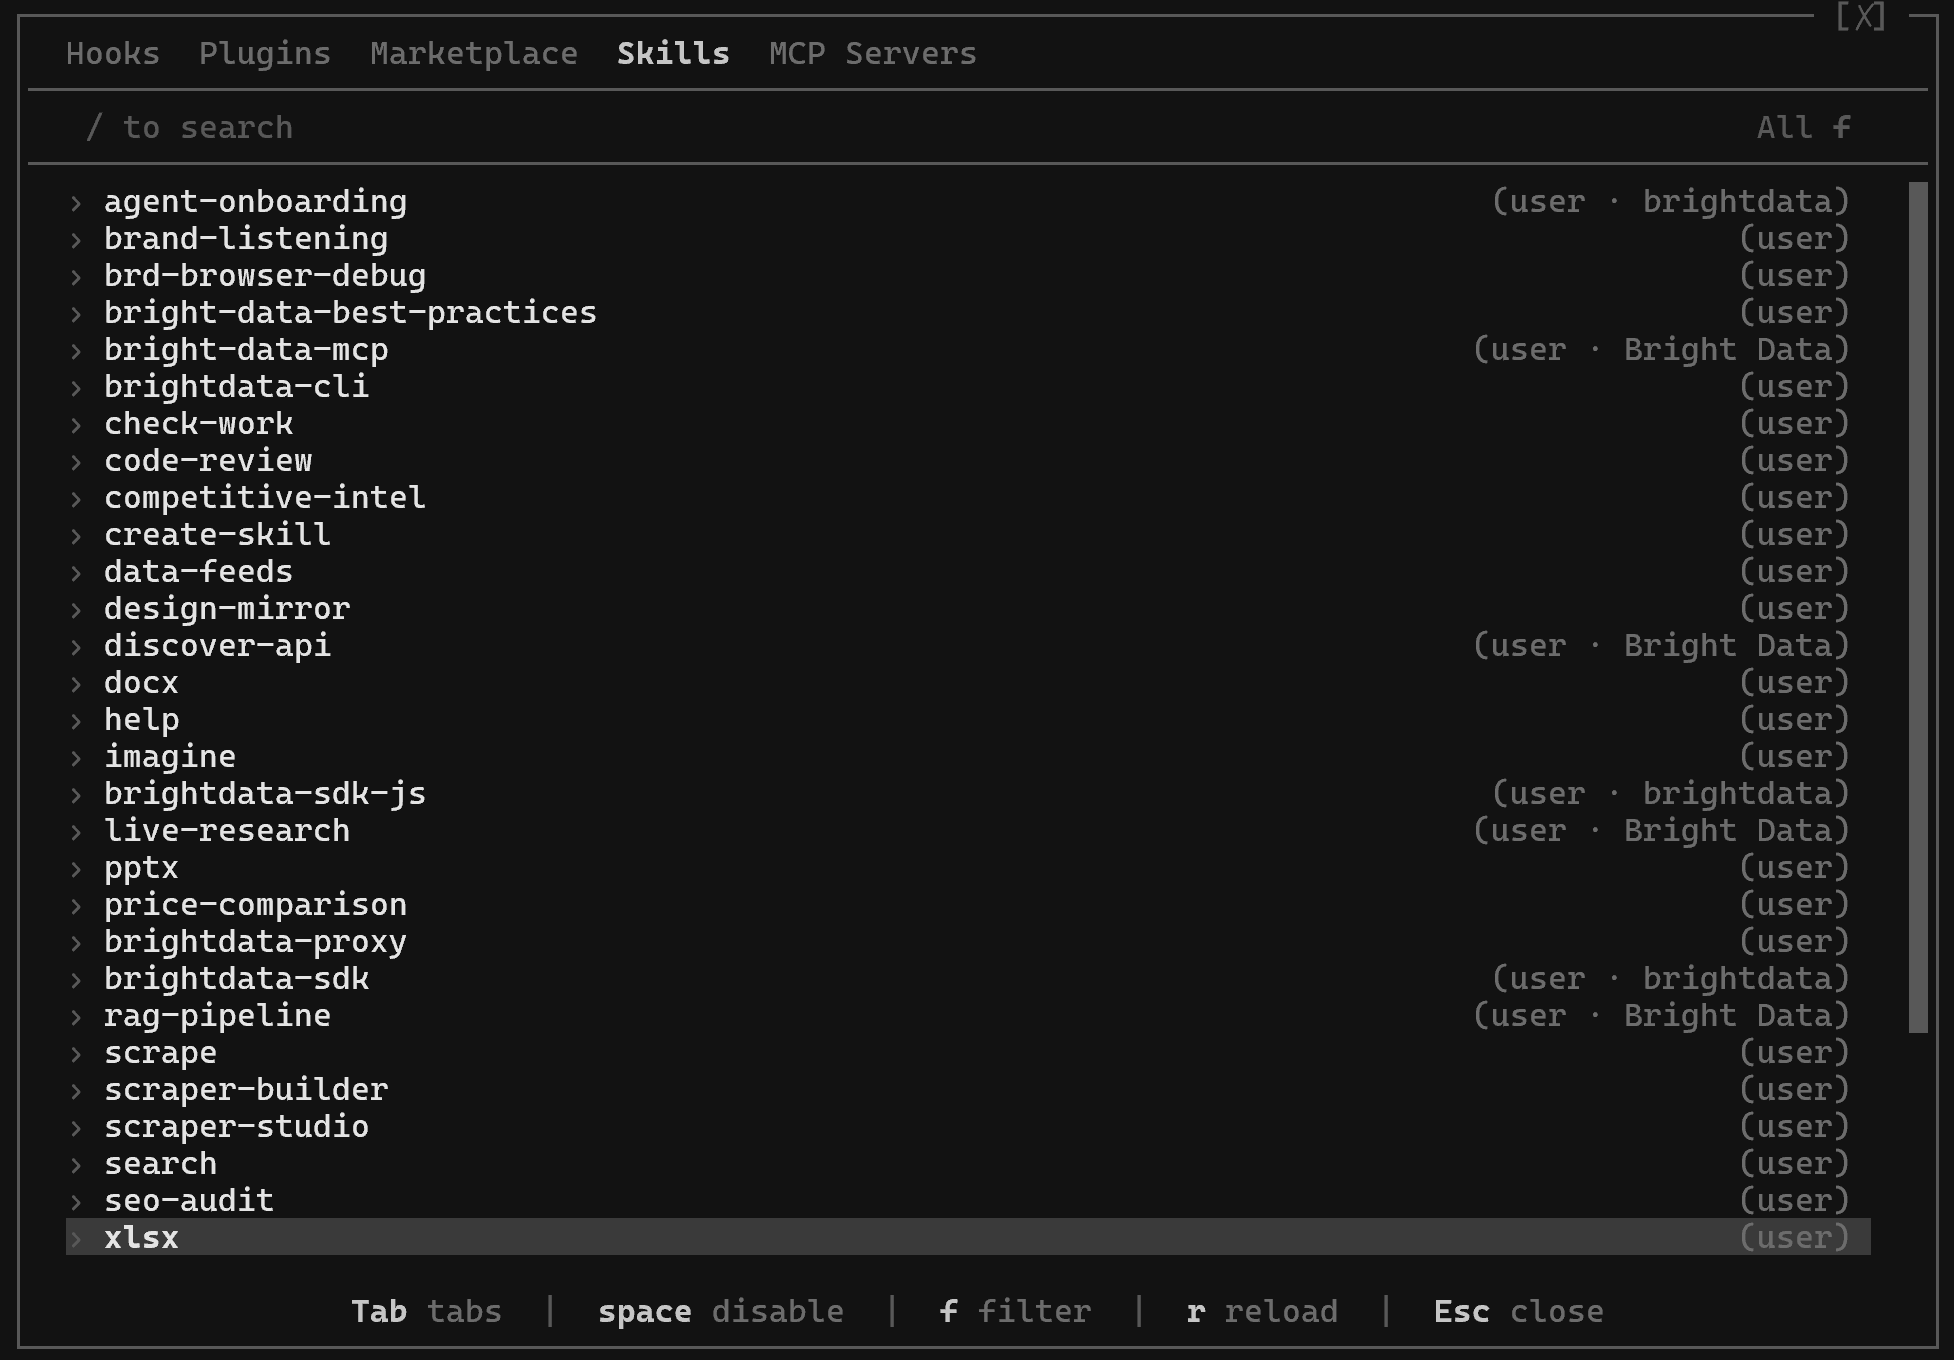
可选:如果你尚未配置 Bright Data CLI,请直接在 Grok Build 内运行 onboarding skill:
/agent-onboarding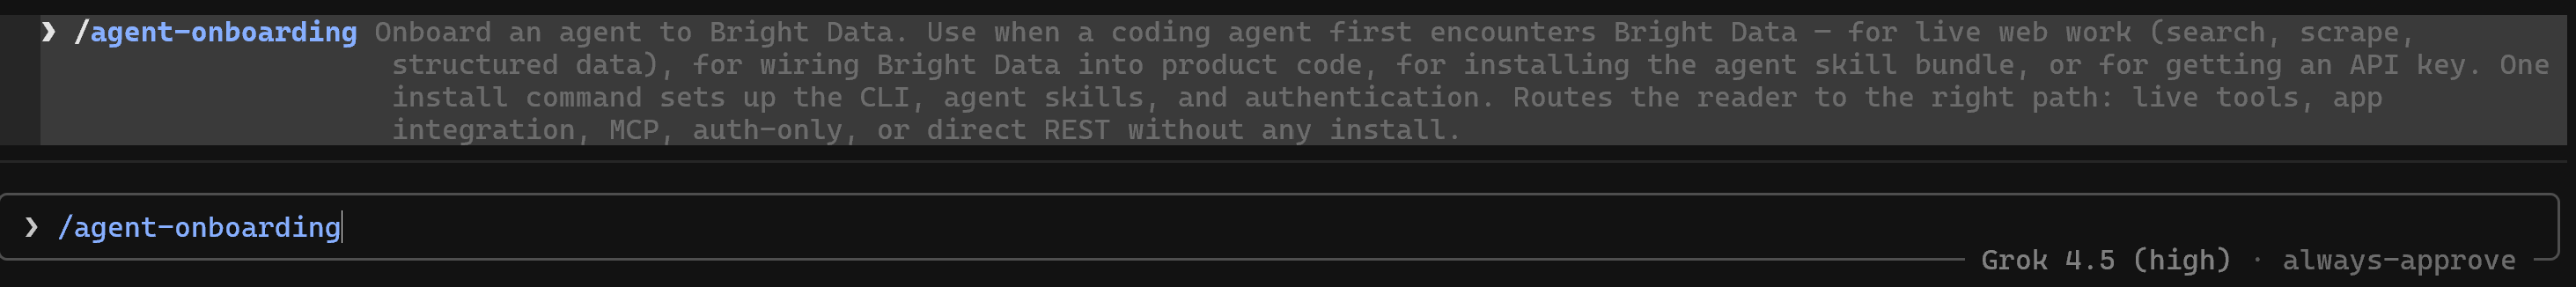
该 skill 将引导你完成所需设置,以便其他 Bright Data 技能 能够正确工作。
就是这样!你已成功将 Bright Data skills 添加到 Grok Build。在下一节中,你将看到如何将它们与 Bright Data Web MCP 结合,获得具备 Web 感知能力的 CLI 助手体验。
Grok Build + Bright Data Web MCP 和 技能:完整示例
要验证 Grok Build 现在可以访问并与 Web 交互,请尝试如下提示:
Using the Bright Data MCP, search online for the latest information about CVE-2026-6357. Scrape the Markdown content from the three most relevant articles, then combine it with the versioning information extracted from the official PyPI pip page. Finally, check whether my system is affected and, if so, recommend how to remediate the issue.这是一个 Grok Build 靠自身会难以完成的现实任务。由于该漏洞最近才披露,配置的 AI 模型甚至可能不知道所引用的 CVE。完成该任务需要 Bright Data 的工具从权威来源检索最新信息,并使用这些信息生成准确响应。
重要:请记住,这只是一个示例。Grok Build + Bright Data 设置支持许多其他用例。
在 Grok Build 中启动该提示:
为了实现目标,该代理执行以下步骤:
- 加载
bright-data-mcpskill,以了解与 Bright Data Web MCP 交互的推荐实践。 - 验证本地 Web MCP 服务器是否可用,并检查其暴露的工具。
- 检查本地系统上安装的
pip版本。 - 使用 Web MCP
search_engine工具(由 Bright Data 的搜索引擎 API提供支持)在 Google 中搜索“CVE-2026-6357 pip vulnerability”。 - 从返回的 SERP 中选择三个最相关的来源(一个 NIST 漏洞数据库页面、一个 Red Hat 公告页面和一个 GitHub Security Advisory 页面)。
- 使用 Web MCP
scrape_batch工具(由 Bright Data 的网络解锁器 API支持)并行检索所有三个页面。 - 抓取官方 PyPI
pip页面以检索最新版本信息。 - 由于 Red Hat 公告没有提供更多技术细节,它从检索到的 SERP 中识别出另一个相关来源(一个 ichard26.github.io 页面),并使用 Web MCP 的
scrape_as_markdown工具检索它。 - 将所有收集到的信息与本地安装的
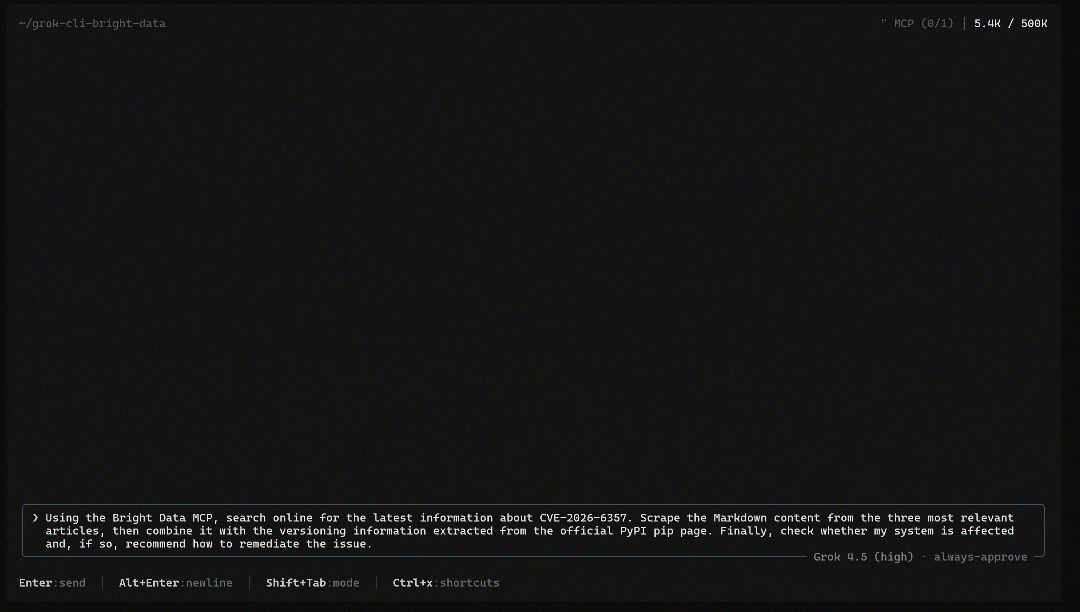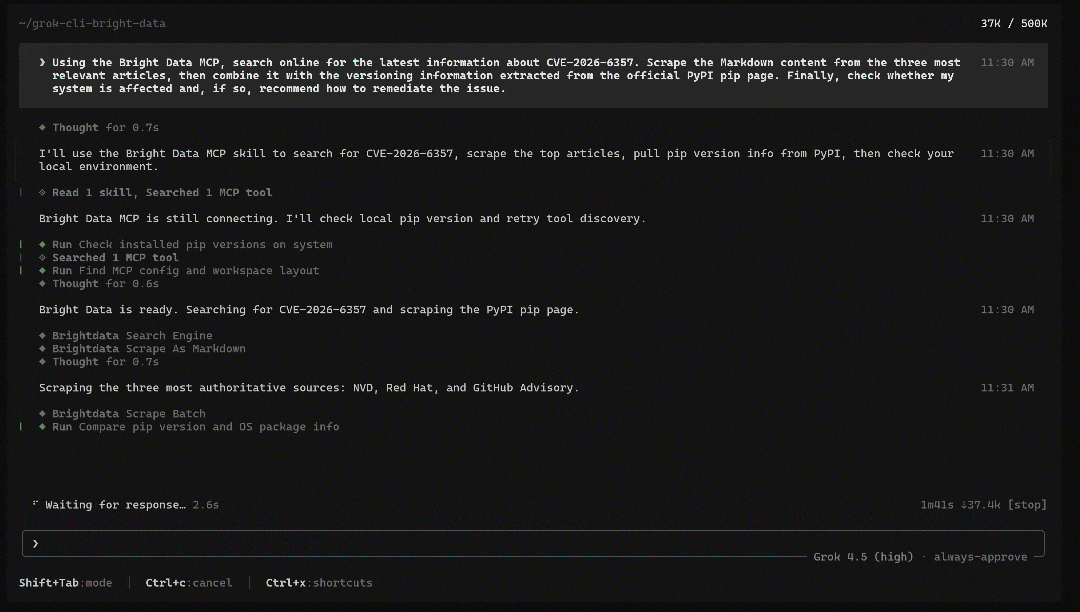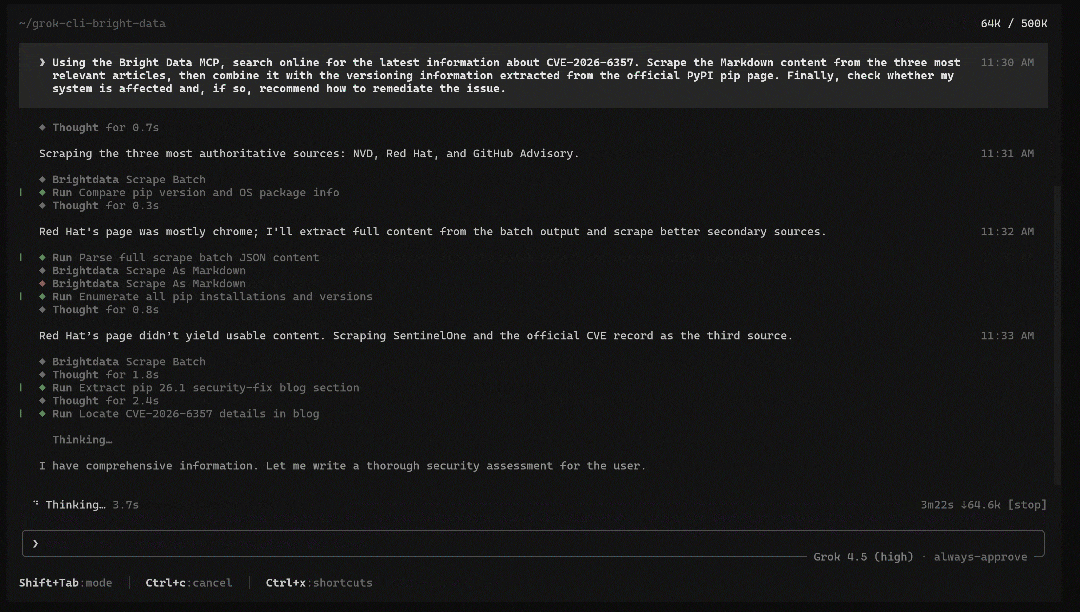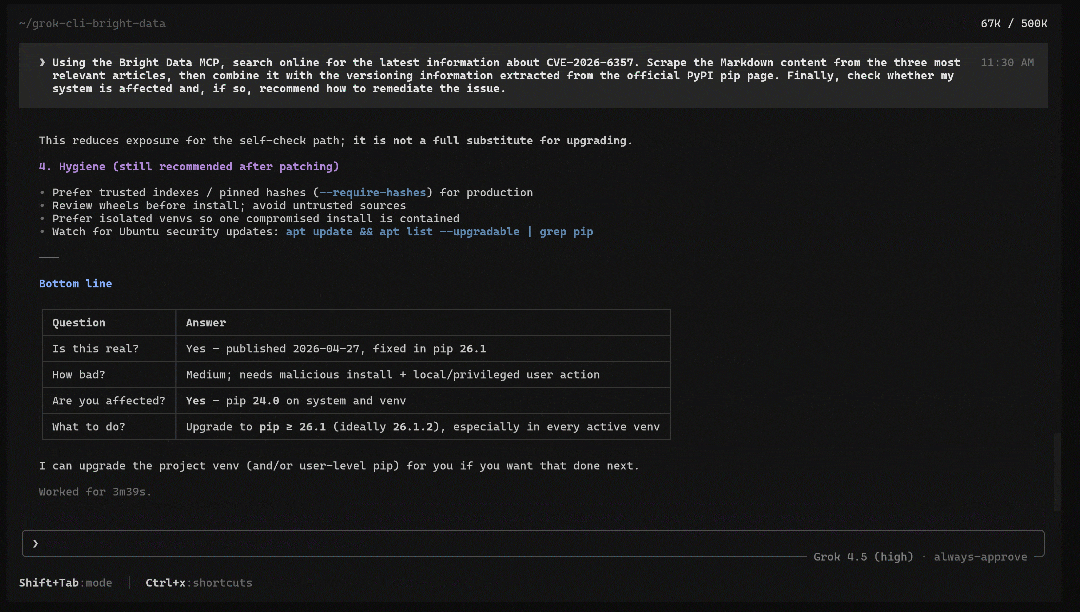
pip版本结合起来,以确定系统是否存在漏洞,并在必要时建议适当的修复步骤。
最终报告将本地系统信息与最新公开可用的安全指南结合起来。具体来说,它包含关于如何解决该问题的建议:
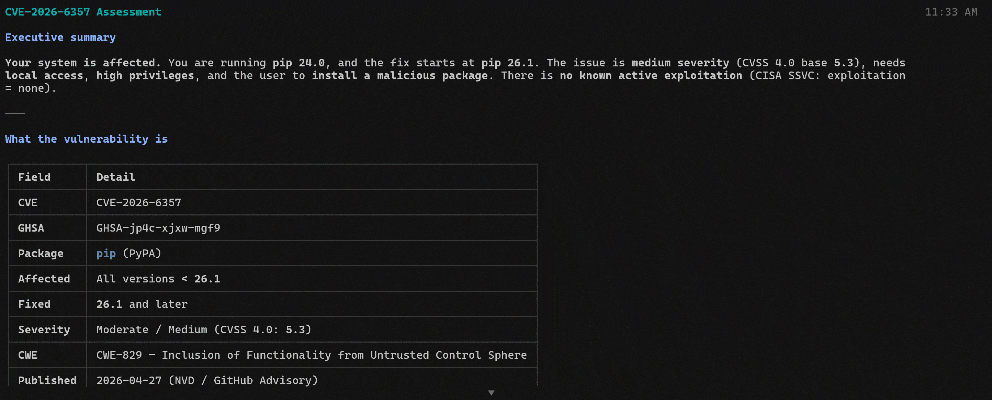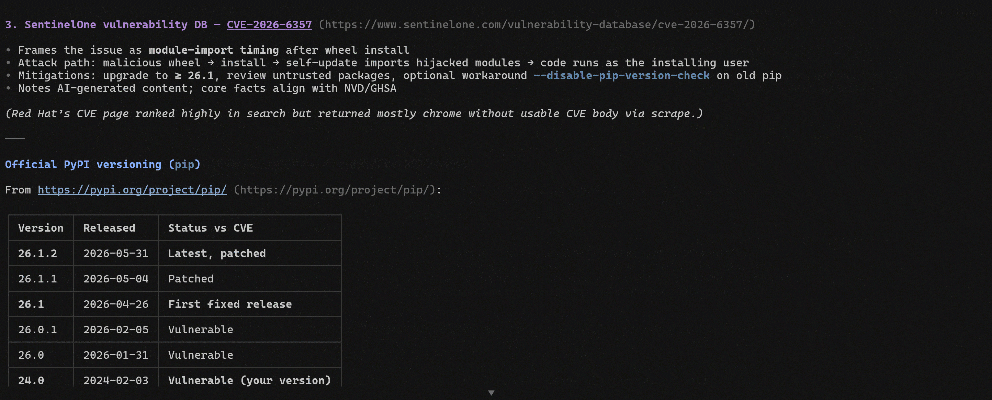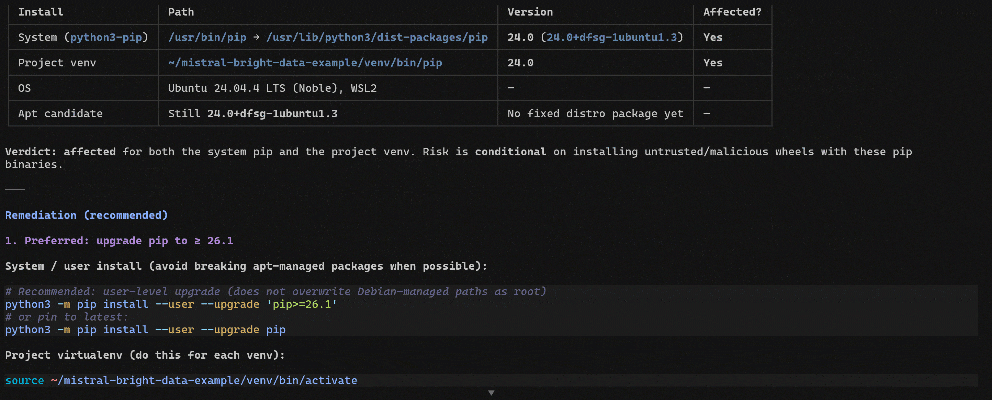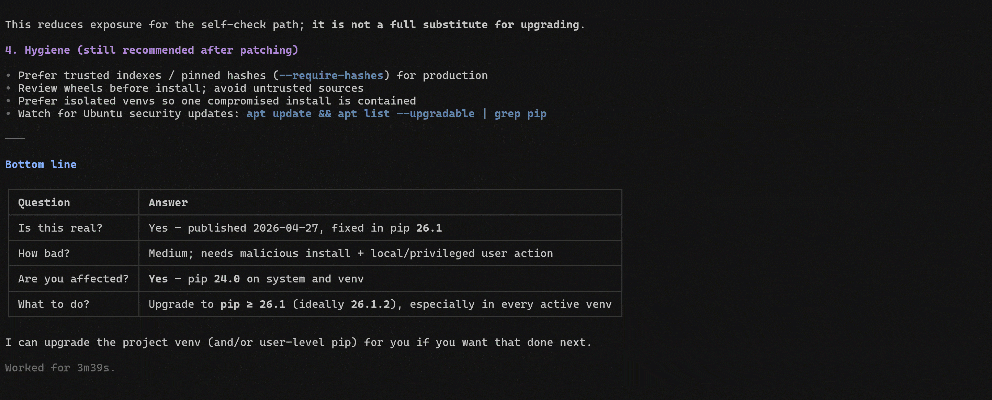
瞧!通过将 Bright Data Web MCP 和 技能 与 Grok Build 集成,你的 CLI 代理获得了生成更可信结果、采取更明智操作以及生成更不易出现幻觉的输出所需的工具和领域知识。
结论
在本文中,你了解了 Grok Build 是什么以及它提供什么。尤其是,你看到了如何通过 Web MCP 和其官方 agent 技能 集成 Bright Data 来扩展其能力。
借助 Bright Data,Grok Build 可以访问用于研究的实时 Web 数据,从而实现更准确、更及时的响应。同时,它直接从你的 CLI 解锁强大的浏览器和 Web 自动化工作流。对于更高级的用例,请探索 Bright Data 生态系统中可用的完整 AI 就绪 Web 数据解决方案。
立即免费创建 Bright Data 账户,开始探索我们的 AI 就绪 Web 数据工具!


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。