在本文中,你将了解:
- 为什么 AI 智能体能从企业级网络访问工具中受益,以及为什么通过 CLI 提供这些工具是一种有效的方法。
- 如何在本地安装和配置 Bright Data CLI。
- 如何让具有 shell 访问权限的 AI 智能体(如 Claude Code、Codex CLI 和 Gemini CLI)使用 Bright Data CLI,以及相关最佳实践。
- 在为 AI 解决方案提供网络功能时,CLI、MCP 和智能体技能之间的主要区别。
让我们开始吧!
AI 智能体需要可靠的网络访问能力
人们越来越期望 AI 智能体能够执行现实世界中的任务,而其中许多任务都需要访问网络。为了克服静态训练数据造成的 LLM 知识局限,它们还需要能够自由探索在线信息源。
因此,大多数主流 LLM 提供商都提供内置的网络搜索功能。然而,这些工具在可靠性和扩展能力方面往往表现不佳。当目标网站受到验证码、速率限制和指纹检查等反机器人系统保护时,它们通常会失败。
对于生产用例AI 智能体需要企业级工具才能可靠地检索网络数据并与网页交互。
为什么 CLI 是 AI 智能体的天然接口
通过 CLI 向 AI 智能体提供网络工具,是最有效的方法之一。这是因为大多数 LLM 都接受过大量 shell 使用方面的训练,因此它们已经熟悉常见的 CLI 工作流程。
它们可以使用 --help 发现命令、串联多个命令、解读输出、从错误中恢复,并自动执行复杂的工作流程。这使得基于 CLI 的集成灵活、轻量,并且与现代 AI 高度兼容。
Bright Data CLI:面向 AI 智能体的企业级网络访问工具
Bright Data CLI 将 Bright Data 的网络数据基础设施直接引入终端。具体来说,它提供了用于搜索、抓取、发现、提取结构化数据以及自动执行浏览器交互的命令。
注意:在 GitHub 上查看 Bright Data CLI 的代码。
它的一些热门命令包括:
| 命令 | 说明 | 技术支持 |
|---|---|---|
bdata search |
搜索网络并返回结构化的搜索引擎结果。 | 网络解锁器 API |
bdata scrape |
绕过反机器人保护抓取网页,并返回经过清理的内容。 | 搜索引擎 API |
bdata pipelines |
从 40 多个受支持的平台提取结构化数据。 | 爬虫 API |
bdata browser |
控制远程浏览器,执行导航、交互和自动化任务。 | 浏览器 API |
bdata scraper |
创建、运行和管理由 AI 驱动的自定义爬虫工具。 | 抓取工具工作室 |
这款 CLI 工具的独特之处在于,它由 Bright Data 的基础设施提供支持,并构建在拥有超过 4 亿个住宅 IP 的网络之上。这一全球基础设施专为大规模、生产级工作负载而设计,可提供 99.99% 的正常运行时间、99.95% 的成功率,并包含集成式反机器人绕过功能甚至能够访问最具挑战性的网站。
得益于此,使用 Bright Data CLI 的 AI 智能体能够大规模探索网络并与之交互。即使处理复杂网站也是如此。
如何开始使用 Bright Data CLI
以下部分将指导你在计算机上设置 Bright Data CLI。
你也可以参阅官方安装与设置指南或阅读我们的 Bright Data CLI 专题文章。
前提条件
要在本地运行 Bright Data CLI,你需要:
- 在本地安装 Node.js 20 或更高版本(建议使用最新的 LTS 版本)。
- 一个 Bright Data 账户(你可以免费创建新账户)。
重要提示:Bright Data CLI 每月包含 5,000 次免费请求因此无需订阅 Bright Data 即可开始使用。
第 1 步:安装 Bright Data CLI
要在任何平台上安装 Bright Data CLI,请运行:
npm install -g @brightdata/cli此命令会在你的系统上全局安装 @brightdata/cli npm 软件包。
或者,在 Linux 或 macOS 上,你可以[使用官方 shell 脚本](https://github.com/bright-cn/cli?tab=readme-ov-file#macos, linux)进行安装:
curl -fsSL https://cli.brightdata.com/install.sh | sh安装完成后brightdata 命令(或其较短的别名 bdata)将在全局范围内可用。
要验证 CLI 是否安装成功,请使用 --version(或 -v)标志检查其版本:
brightdata, version或者使用简写命令:
bdata, version你应该会看到类似以下内容的输出:
0.3.2
做得好!Bright Data CLI 现已安装。接下来,将其连接到你的 Bright Data 账户。
第 2 步:关联你的 Bright Data 账户
现在需要使用你的 Bright Data 账户对 Bright Data CLI 进行身份验证。为此,请运行:
bdata login此命令会自动打开默认浏览器,并将你重定向到 Bright Data 登录页面。如果浏览器没有打开,请复制终端中显示的 URL,并将其粘贴到浏览器中。然后,按照提示通过 OAuth 使用你的 Bright Data 账户完成身份验证。
注意:如果你的计算机无法使用图形界面浏览器,请改为运行以下命令:
bdata login, device此命令会显示一个验证 URL 和一次性代码。使用任何带浏览器的设备打开该 URL,输入代码并完成身份验证流程。完成后,你计算机上的 CLI 会话将通过身份验证。
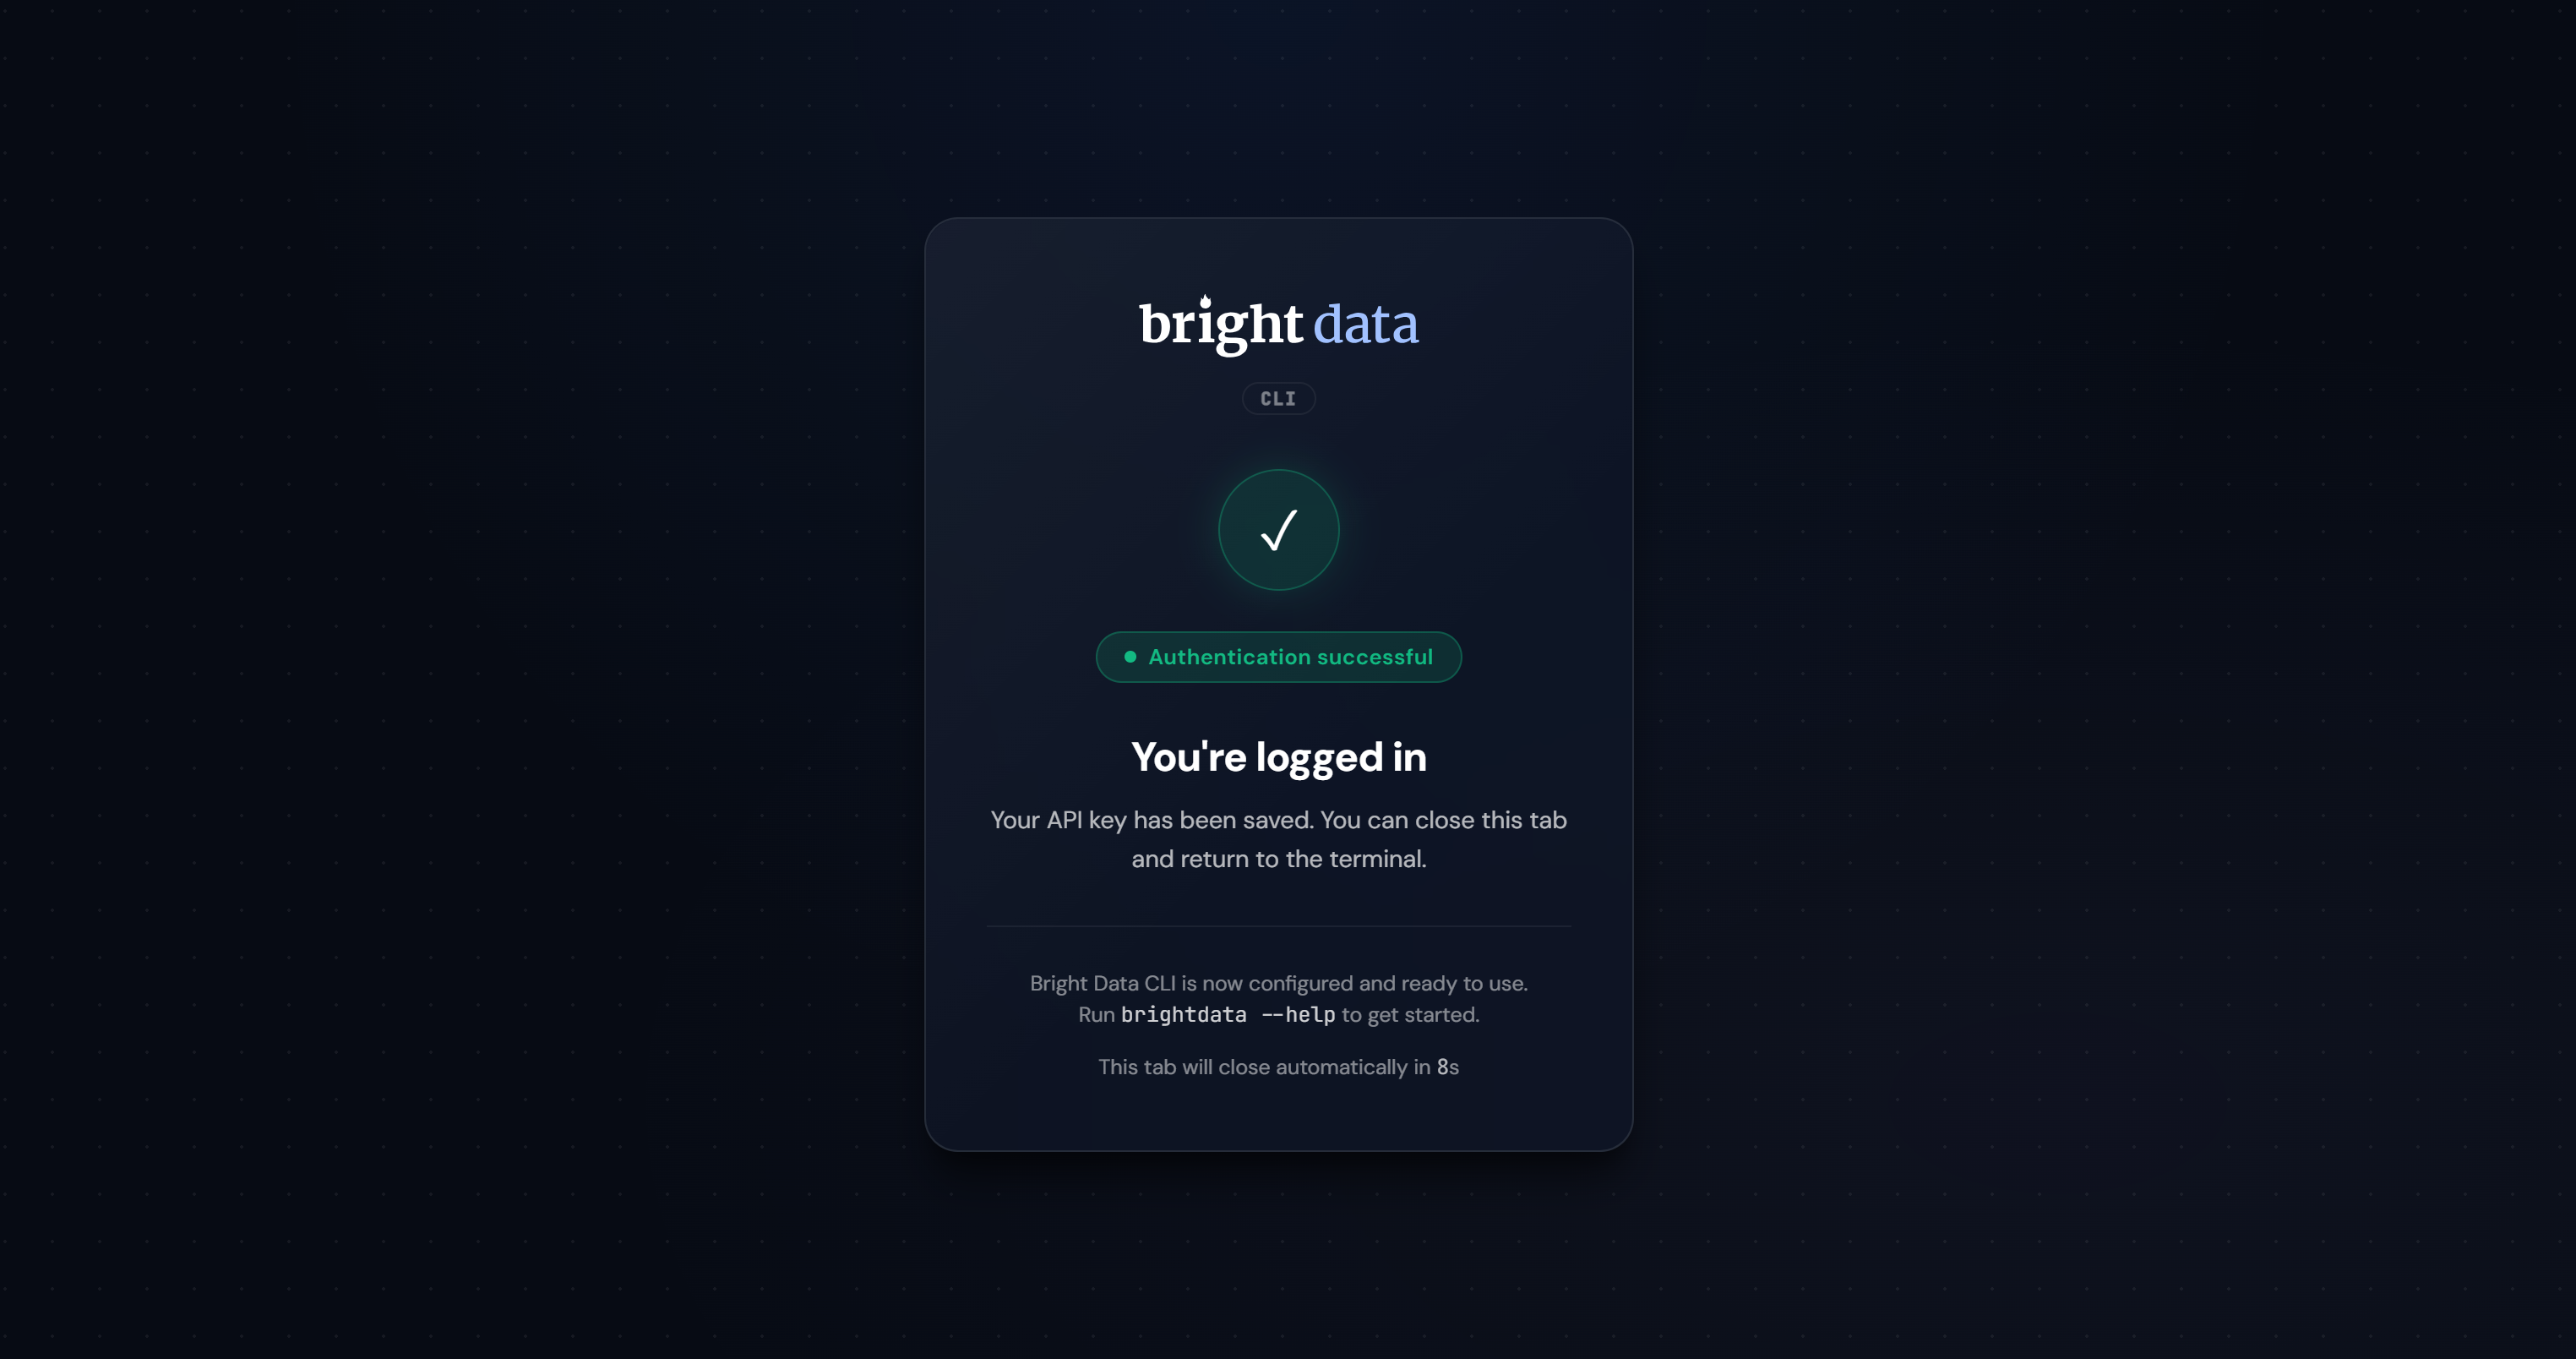
登录后,你应该会看到类似这样的确认页面:
身份验证完成后,CLI 会生成一个 Bright Data 智能体 API 密钥:
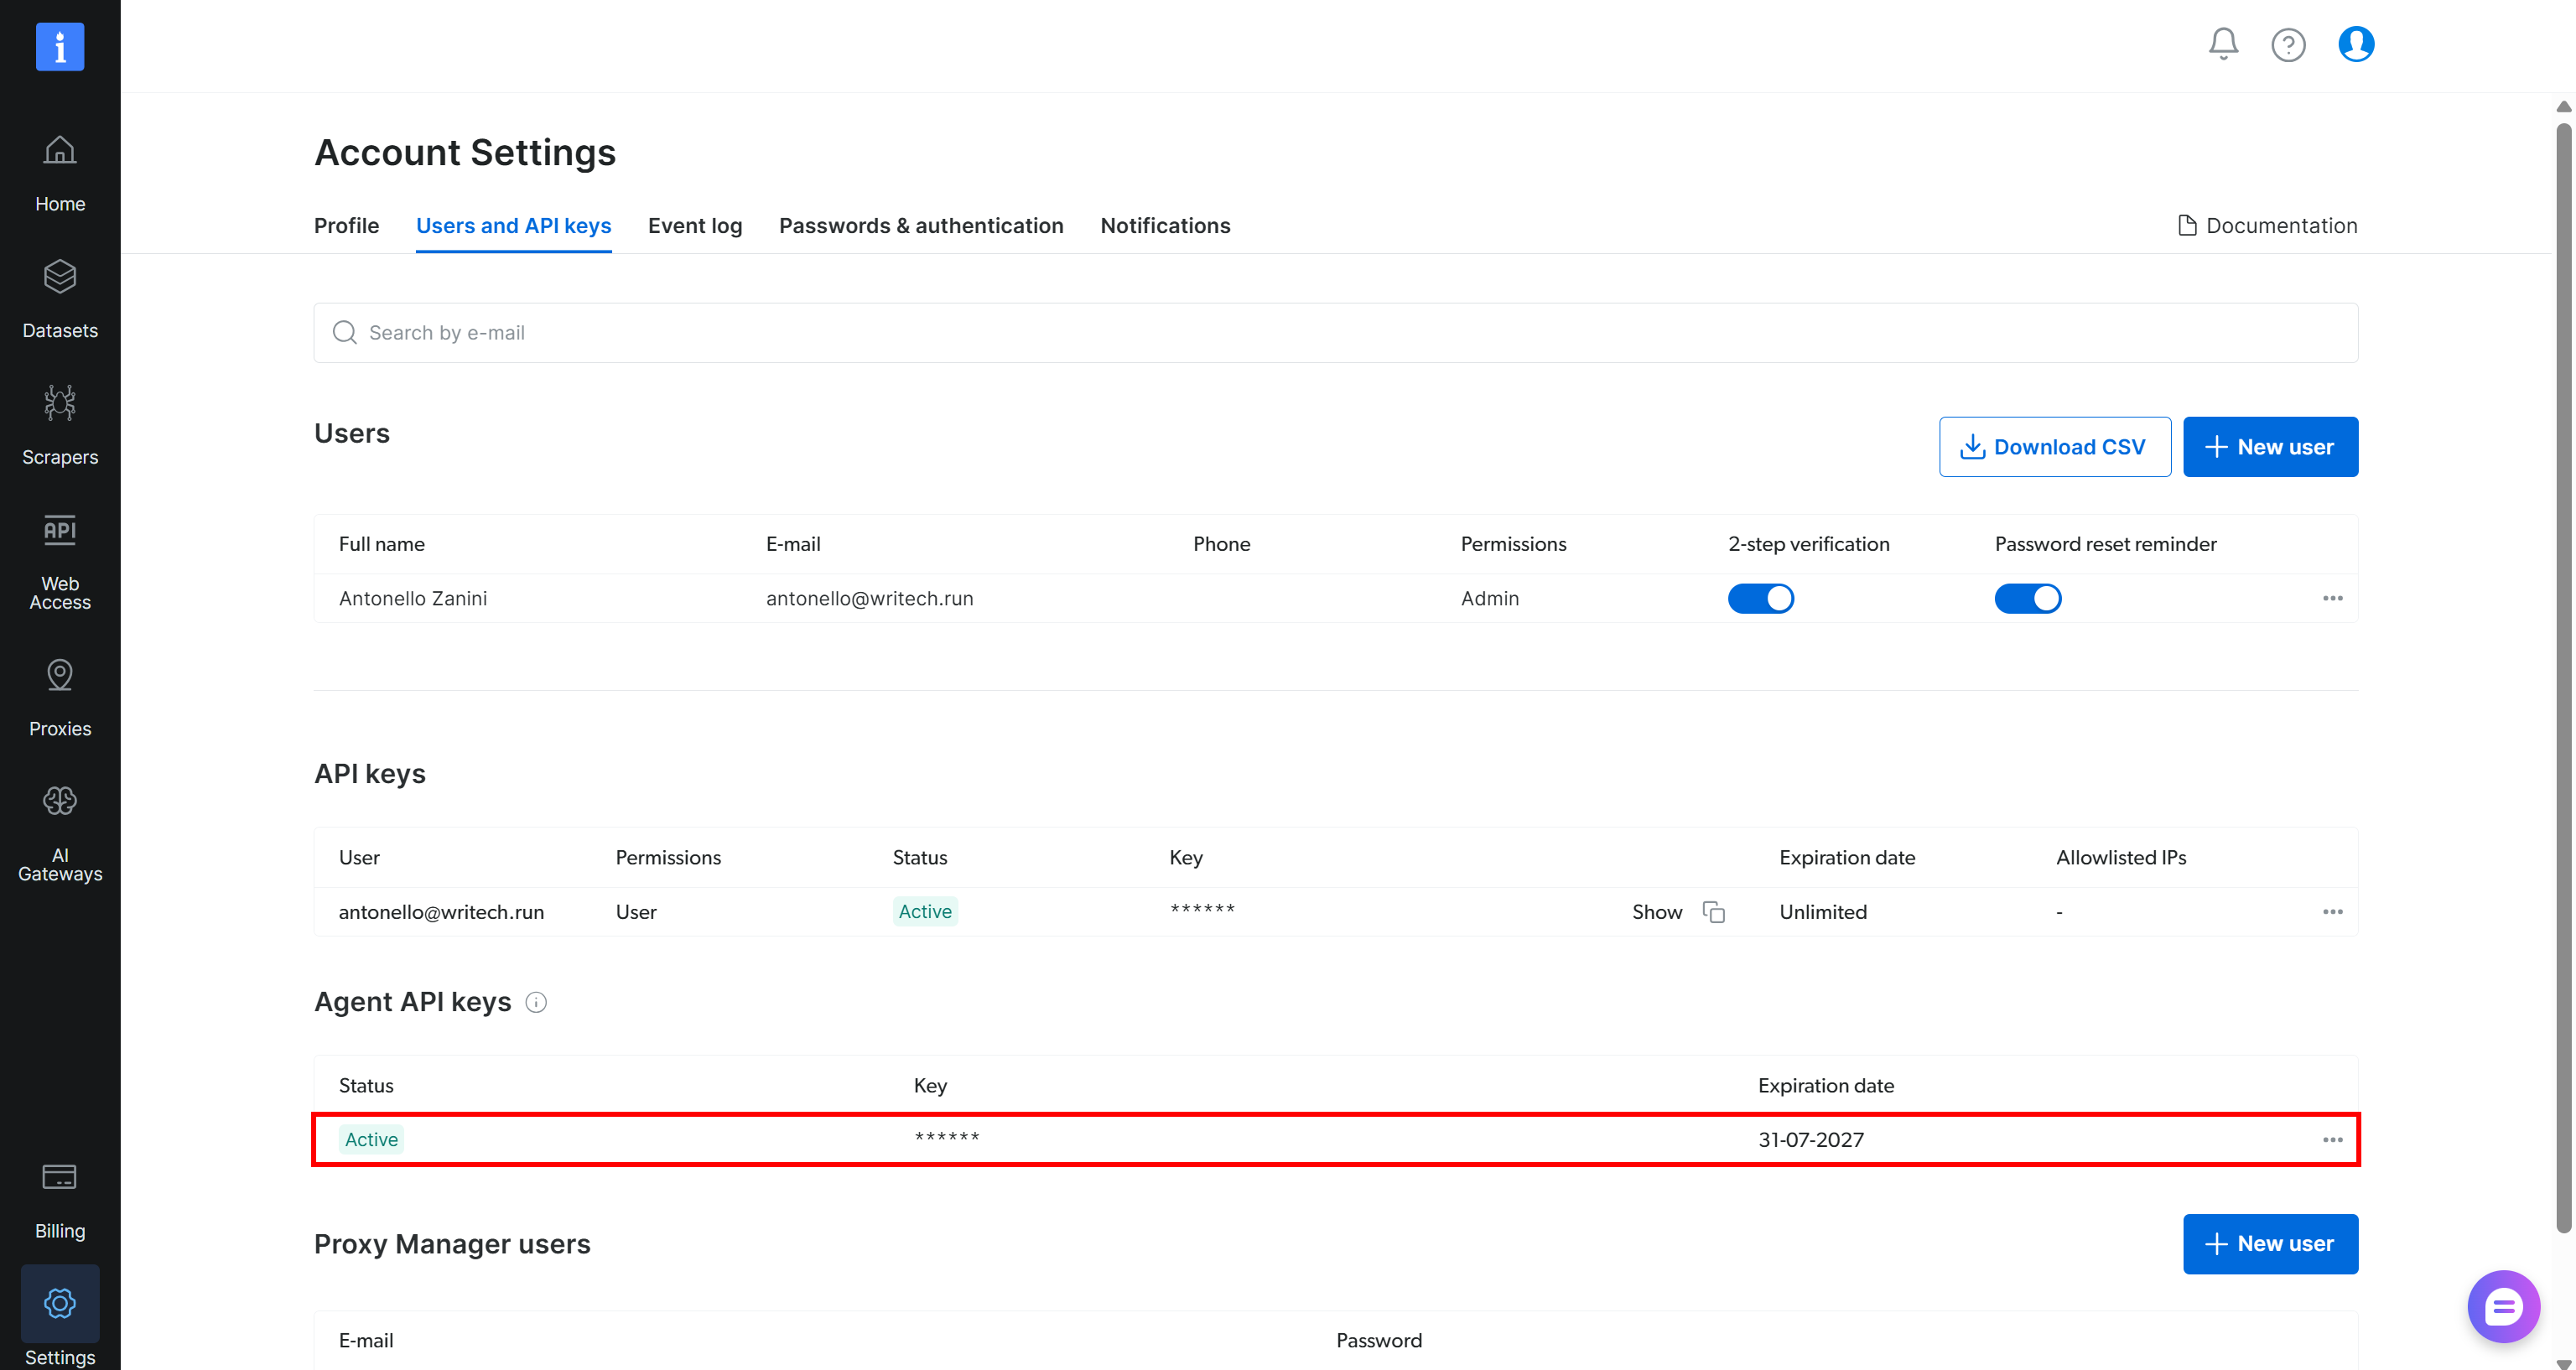
这个特殊的 API 密钥存储在本地,CLI 会使用它安全地向 Bright Data 服务验证请求。
如果你想要退出登录并删除已存储的凭据,请运行:
bdata logout很好!现在你可以直接从终端开始访问网络了。
第 3 步:测试 Bright Data CLI 设置
要验证 Bright Data CLI 是否正常工作,请运行以下命令:
bdata scrape "https://example.com/"此命令会调用 CLI 的 scrape 命令,以检索 https://example.com/ 的内容。在后台,它会:
- 通过 Bright Data 网络解锁器 API发送请求。
- 获取页面。
- 返回以 Markdown 格式提取的内容(默认输出格式)。
注意:Markdown 是一种非常适合 LLM 摄取的格式这表明 Bright Data CLI 是为 AI 工作流程而构建的。
你应该会看到以下输出:
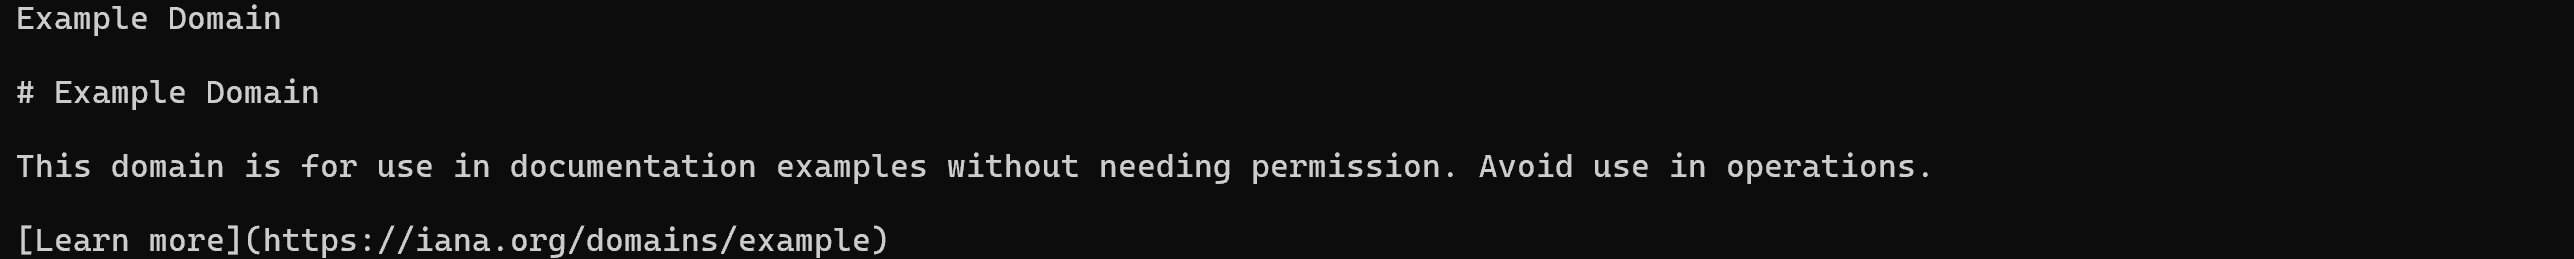
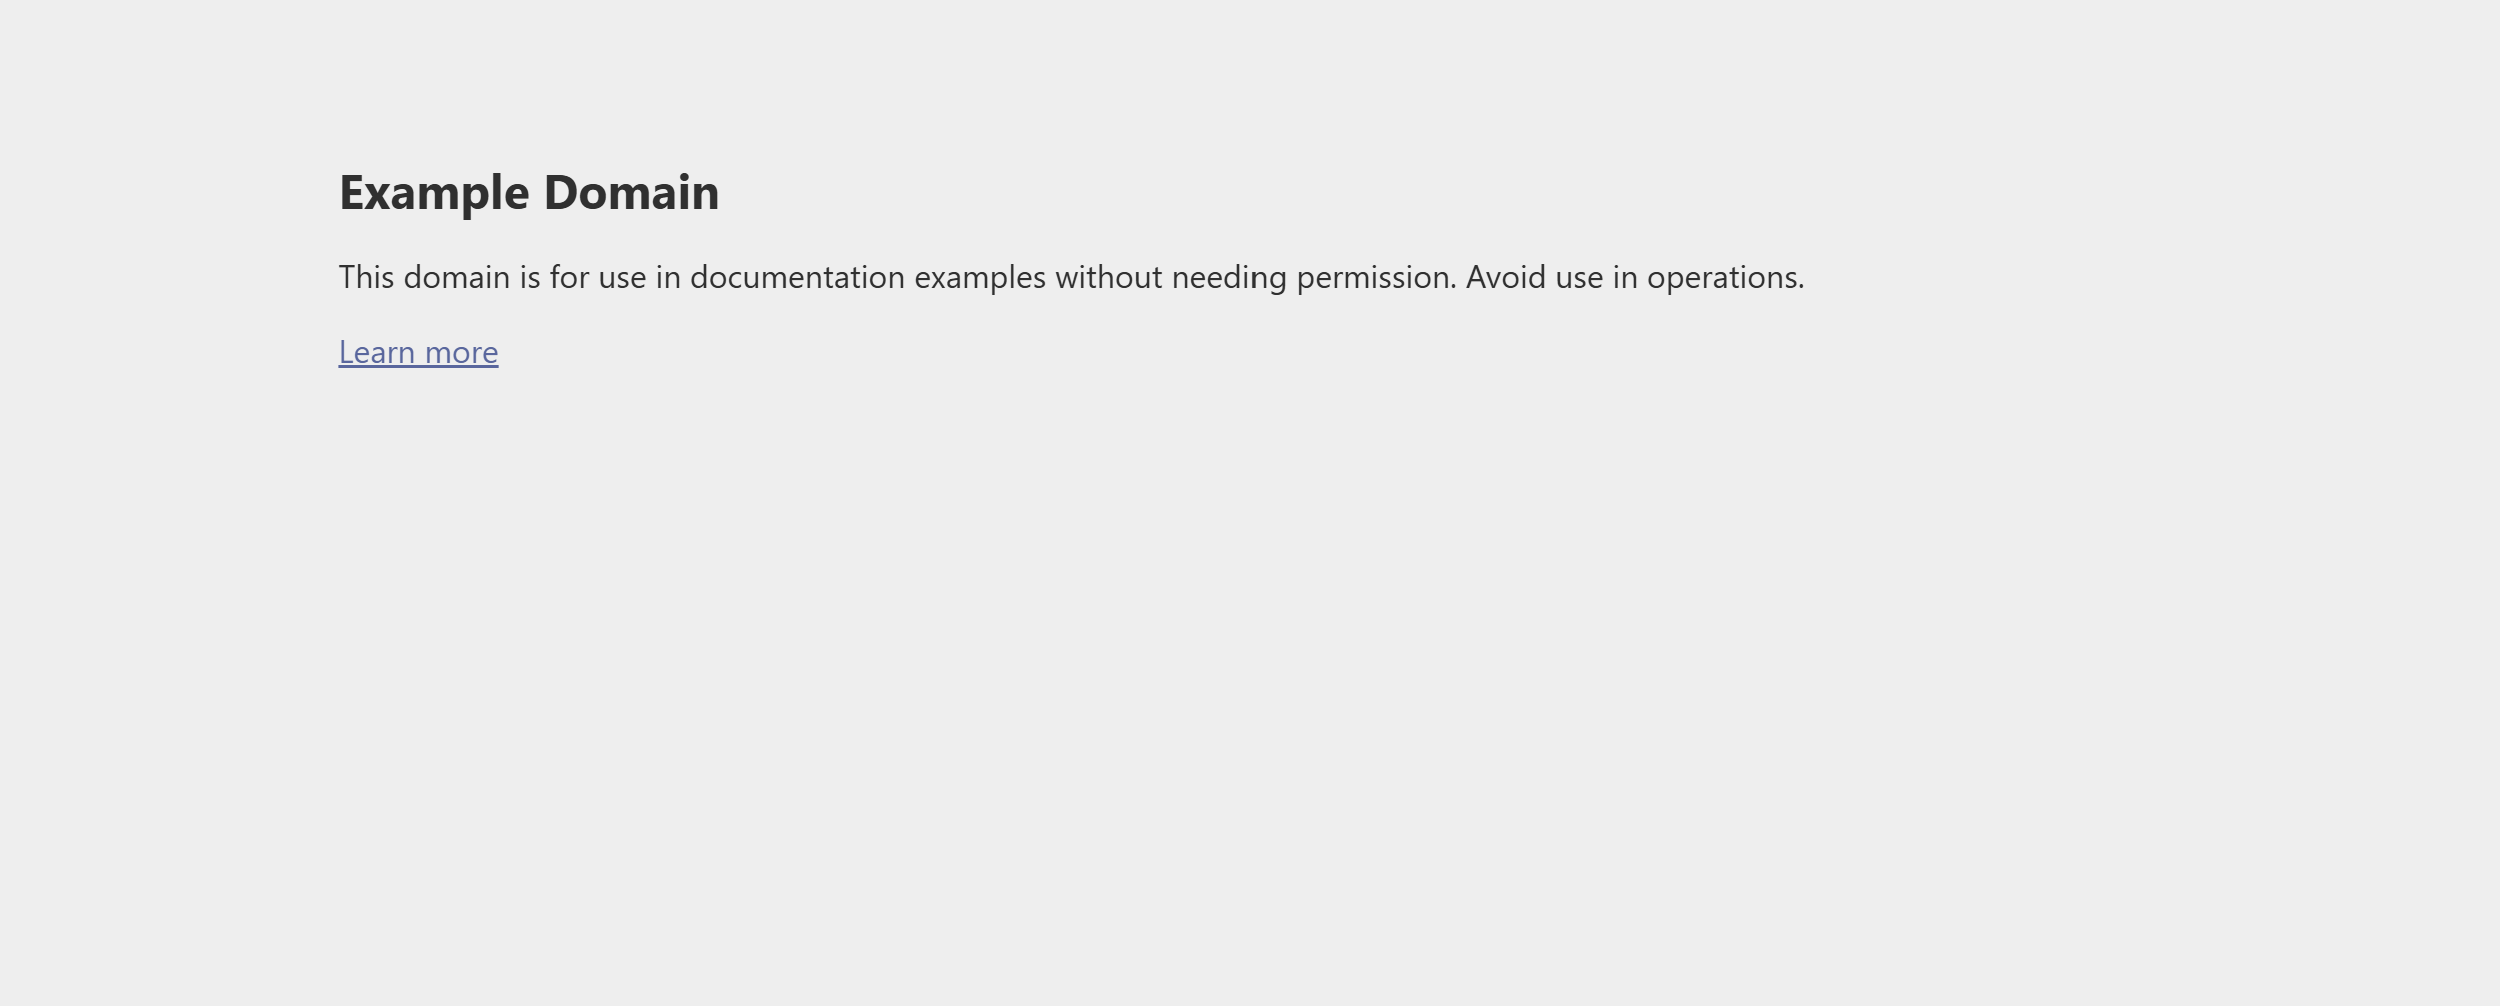
这对应于目标页面针对 LLM 优化的 Markdown 表示形式:
要探索所有可用的 Bright Data CLI 命令和选项,请参阅官方文档。
任务完成!Bright Data CLI 现已安装、通过身份验证并可供使用。
指导本地 AI 智能体使用 Bright Data CLI 执行网络任务
现在 Bright Data CLI 已可在你的计算机上使用,你可以指导自己喜欢的 AI 智能体使用它执行网络任务。
以下部分适用于任何具有 shell 访问权限的 AI 智能体解决方案。其中包括 Claude Code、Codex CLI、Gemini CLI、OpenCode、Aider、Pi 等基于 CLI 的智能体,也包括 Claude Desktop 和 goose 等桌面 AI 助手,以及 OpenClaw、ZeroClaw 等其他 AI 智能体框架和类似解决方案。
目标是为这些 AI 智能体提供必要的上下文,使它们能够自主使用 Bright Data CLI 执行网络数据检索、抓取、搜索和浏览器自动化任务。
请按照以下说明操作!
前提条件
开始之前,请确保你已经:
- 在本地安装并配置了 Bright Data CLI。
- 在计算机上设置了一个 AI 智能体(例如 Claude Code、Claude Desktop、Gemini CLI、Codex、OpenCode 等)。
注意:以下章节使用 Claude Code 作为示例,但任何其他具有 shell 访问权限的 AI 智能体解决方案都可以使用,无需更改整体方法。
第 1 步:启用 Shell 访问权限
首先,你的 AI 智能体需要访问系统 shell。如果 AI 智能体无法与底层终端环境交互并执行命令,它就无法调用 Bright Data CLI。
大多数现代 AI 智能体解决方案已经内置 shell 访问权限,通常还会配有权限系统,在执行命令前要求确认。不过,某些智能体会禁用命令执行权限。
如果 shell 访问权限被禁用,请参阅该智能体的文档并在继续之前将其启用。出于安全考虑,建议将智能体配置为执行终端命令前需要获得批准的模式。
第 2 步:提供有关 Bright Data CLI 的上下文
你的 AI 智能体可能不了解 Bright Data CLI,或者在你通过提示词提到它时错误推断其用途。为了降低产生幻觉的风险,请向智能体提供一些关于该工具的初始上下文。
请从以下提示词开始:
From now on, assume the Bright Data CLI is installed and available through the `bdata` command.

You can use it to:
- Scrape websites.
- Search the web.
- Extract structured data from 40+ supported platforms.
- Control remote browsers for browser automation.
- Perform other web data retrieval tasks.

Whenever a task requires web data or browser automation, consider whether the Bright Data CLI is the most appropriate tool before using other approaches.
这会向 AI 智能体提供理解 Bright Data CLI 是什么以及何时应使用它所需的信息。
请注意,该提示词只提到 bdata 命令,而不是更长的 brightdata 命令。这可以让指令更简单,并避免与 CLI 交互时可能出现的混淆。
在你的 AI 智能体中运行该提示词,输出将类似于:

太棒了!你的本地 AI 智能体现在已经了解 Bright Data CLI。
第 3 步:指导 AI 智能体如何有效使用 CLI
大多数 LLM 已经知道如何与 CLI 工具交互。不过,明确指导 AI 智能体如何正确使用 Bright Data CLI 仍然是一项良好实践。
因此,请运行以下提示词:
When using the Bright Data CLI, do not assume command names, arguments, or options.

Always use `bdata, help` and `<command> --help` (or `-h`) to discover the available commands, understand their syntax, and determine the correct flags before executing them.
这应该足以引导 AI 智能体正确使用 Bright Data CLI。
无需向智能体提供完整的 CLI 文档,也无需手动描述每个可用命令。内置的 --help(-h)标志提供了智能体发现和使用 CLI 所需的全部信息。
提示:你也可以根据具体任务要求,提供有关何时应使用不同命令的额外指导。
AI 智能体应该会给出类似以下内容的响应:

要了解为什么提示词中的说明已经足够,请在终端中尝试以下命令:
bdata, help请注意,此命令会列出所有可用的 Bright Data CLI 命令:
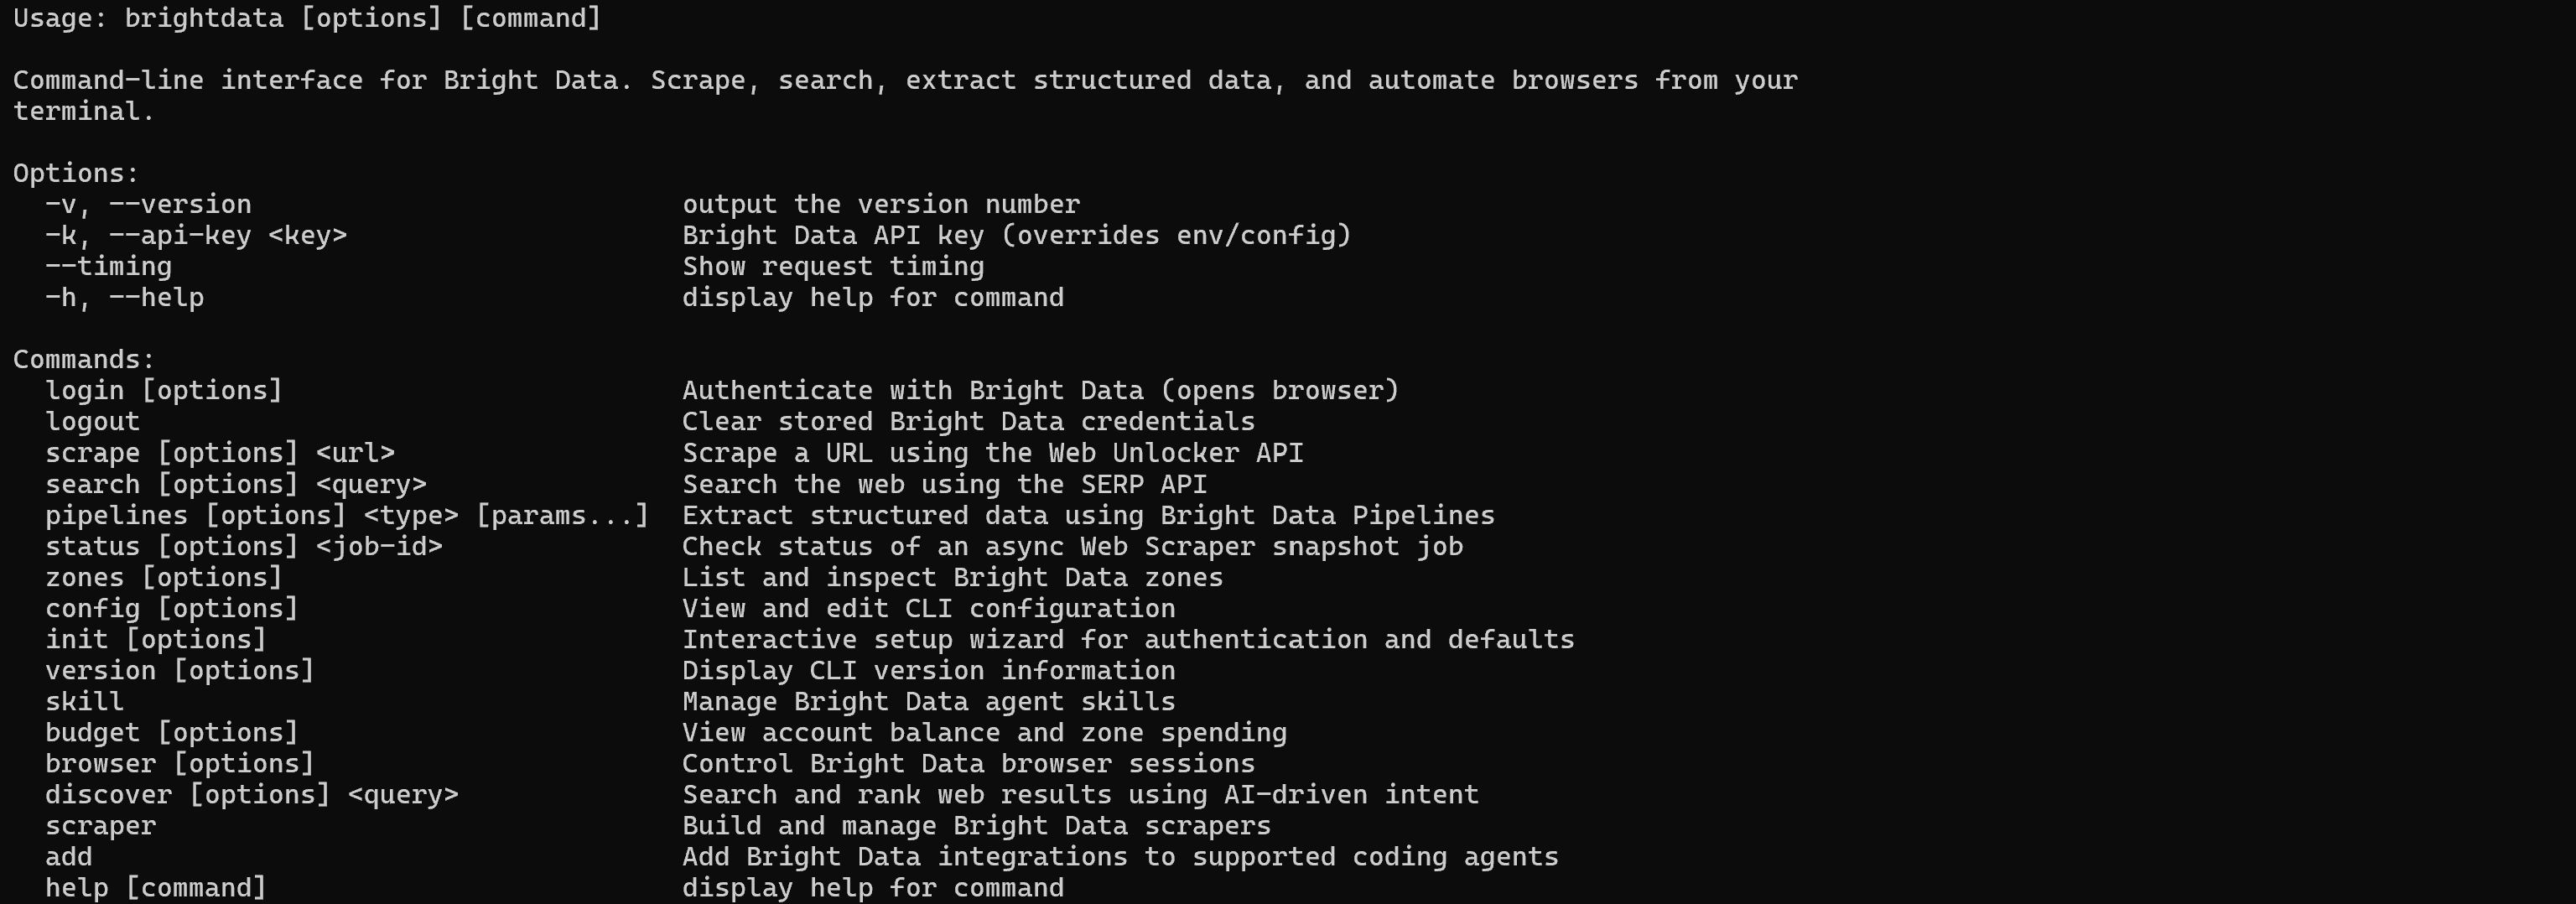
然后,查看特定命令的 --help 输出:
bdata search, help同样,请注意其中提供的信息详细程度:
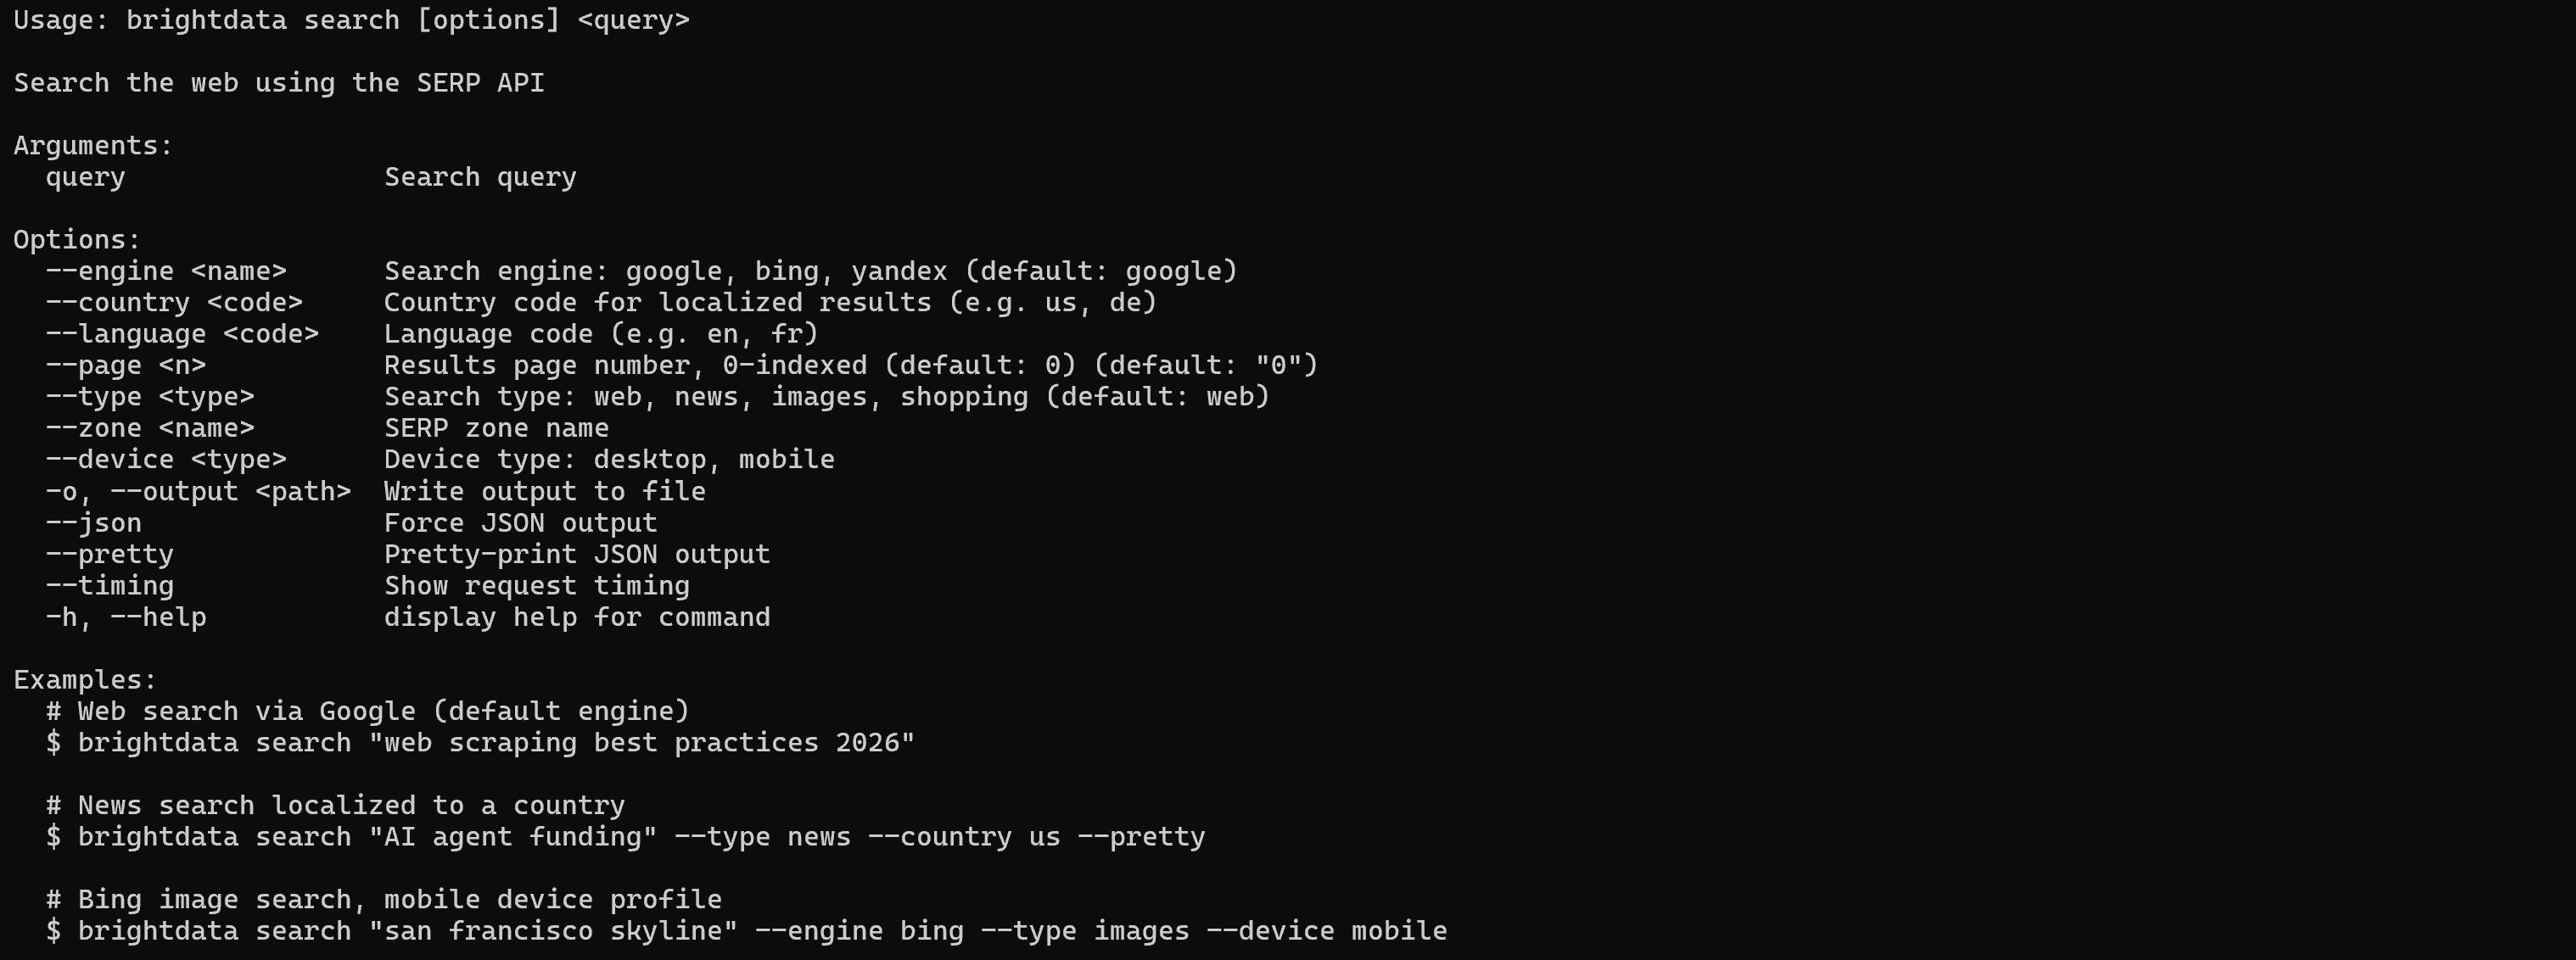
输出中甚至包含 AI 智能体可以针对不同用例进行调整的示例。
因此,通过使用 --help(或 -h)调用命令,智能体可以获得成功使用 Bright Data CLI 命令所需的全部信息。
太好了!你的 AI 智能体现在已经具备充分利用 Bright Data CLI 所需的上下文和指令。
第 4 步:使用 Bright Data CLI 执行网络任务
现在,你可以让 AI 智能体处理 Bright Data CLI 所支持的众多网络相关任务之一。
例如,运行以下任务:
Use the Bright Data CLI to research the best AI startups in Europe. Select 2,3 relevant sources and scrape their content. Based on these sources, identify the top 3 AI startups in Europe. Then, search for each startup's Crunchbase company profile and extract structured information from it. Finally, create a report describing what each company does and include the relevant Crunchbase data.此任务涉及网络搜索、网页抓取和结构化数据提取。因此,它非常适合用来展示 AI 智能体能够借助 Bright Data CLI 完成哪些工作。
在 Claude Code 中执行该任务,你应该会看到类似以下内容的工作流程:
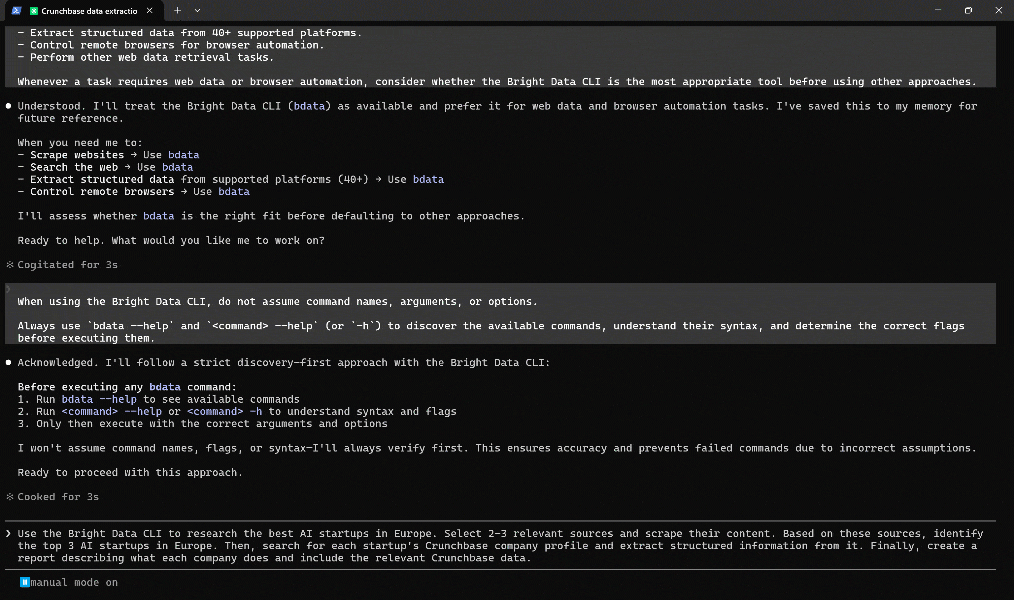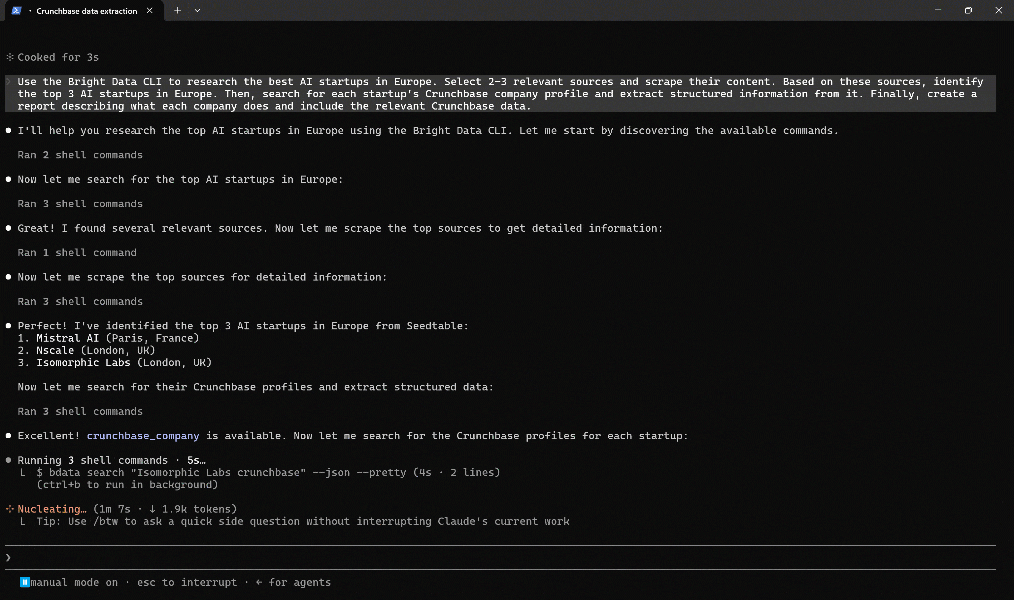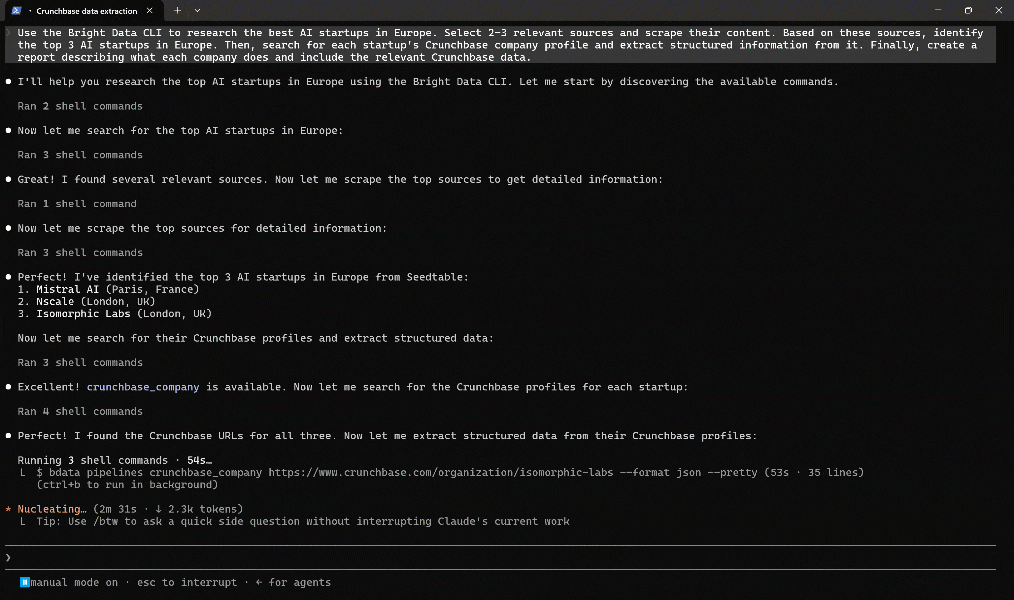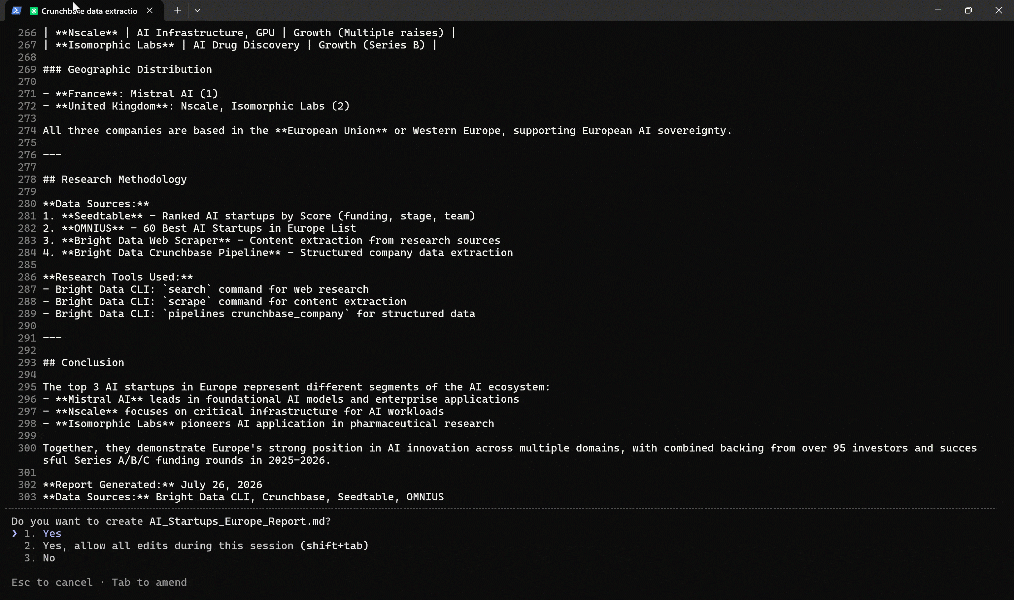
具体来说,AI 智能体:
- 调用
bdata, help以发现 Bright Data CLI 中可用的命令。 - 确定
bdata search是适合进行网络搜索的命令。 - 使用
bdata search在 Google 上执行“2026 年欧洲最佳 AI 初创公司”搜索查询,并检索 JSON 格式的 SERP。 - 分析搜索结果,以找出最相关文章。
- 确定
bdata scrape是适合提取网页内容的命令。 - 调用
bdata scrape, help以了解命令语法和可用选项。 - 对选定文章的 URL 使用
bdata scrape以 Markdown 格式检索其内容。 - 分析 Markdown 内容,并找出多个来源中提到的排名前 3 的 AI 初创公司。
- 确定
bdata pipelines是适合从 Crunchbase 资料页提取结构化数据的命令。 - 调用
bdata pipelines, help以了解命令语法。 - 使用
bdata search查找每家初创公司的 Crunchbase 资料页。 - 对每个 Crunchbase 资料页使用
bdata pipelines以 JSON 格式提取结构化公司数据。在后台,此操作依赖 Bright Data 的 Crunchbase 抓取工具。 - 将所有提取的信息合并为最终的 Markdown 报告。
最终生成的报告应类似于:
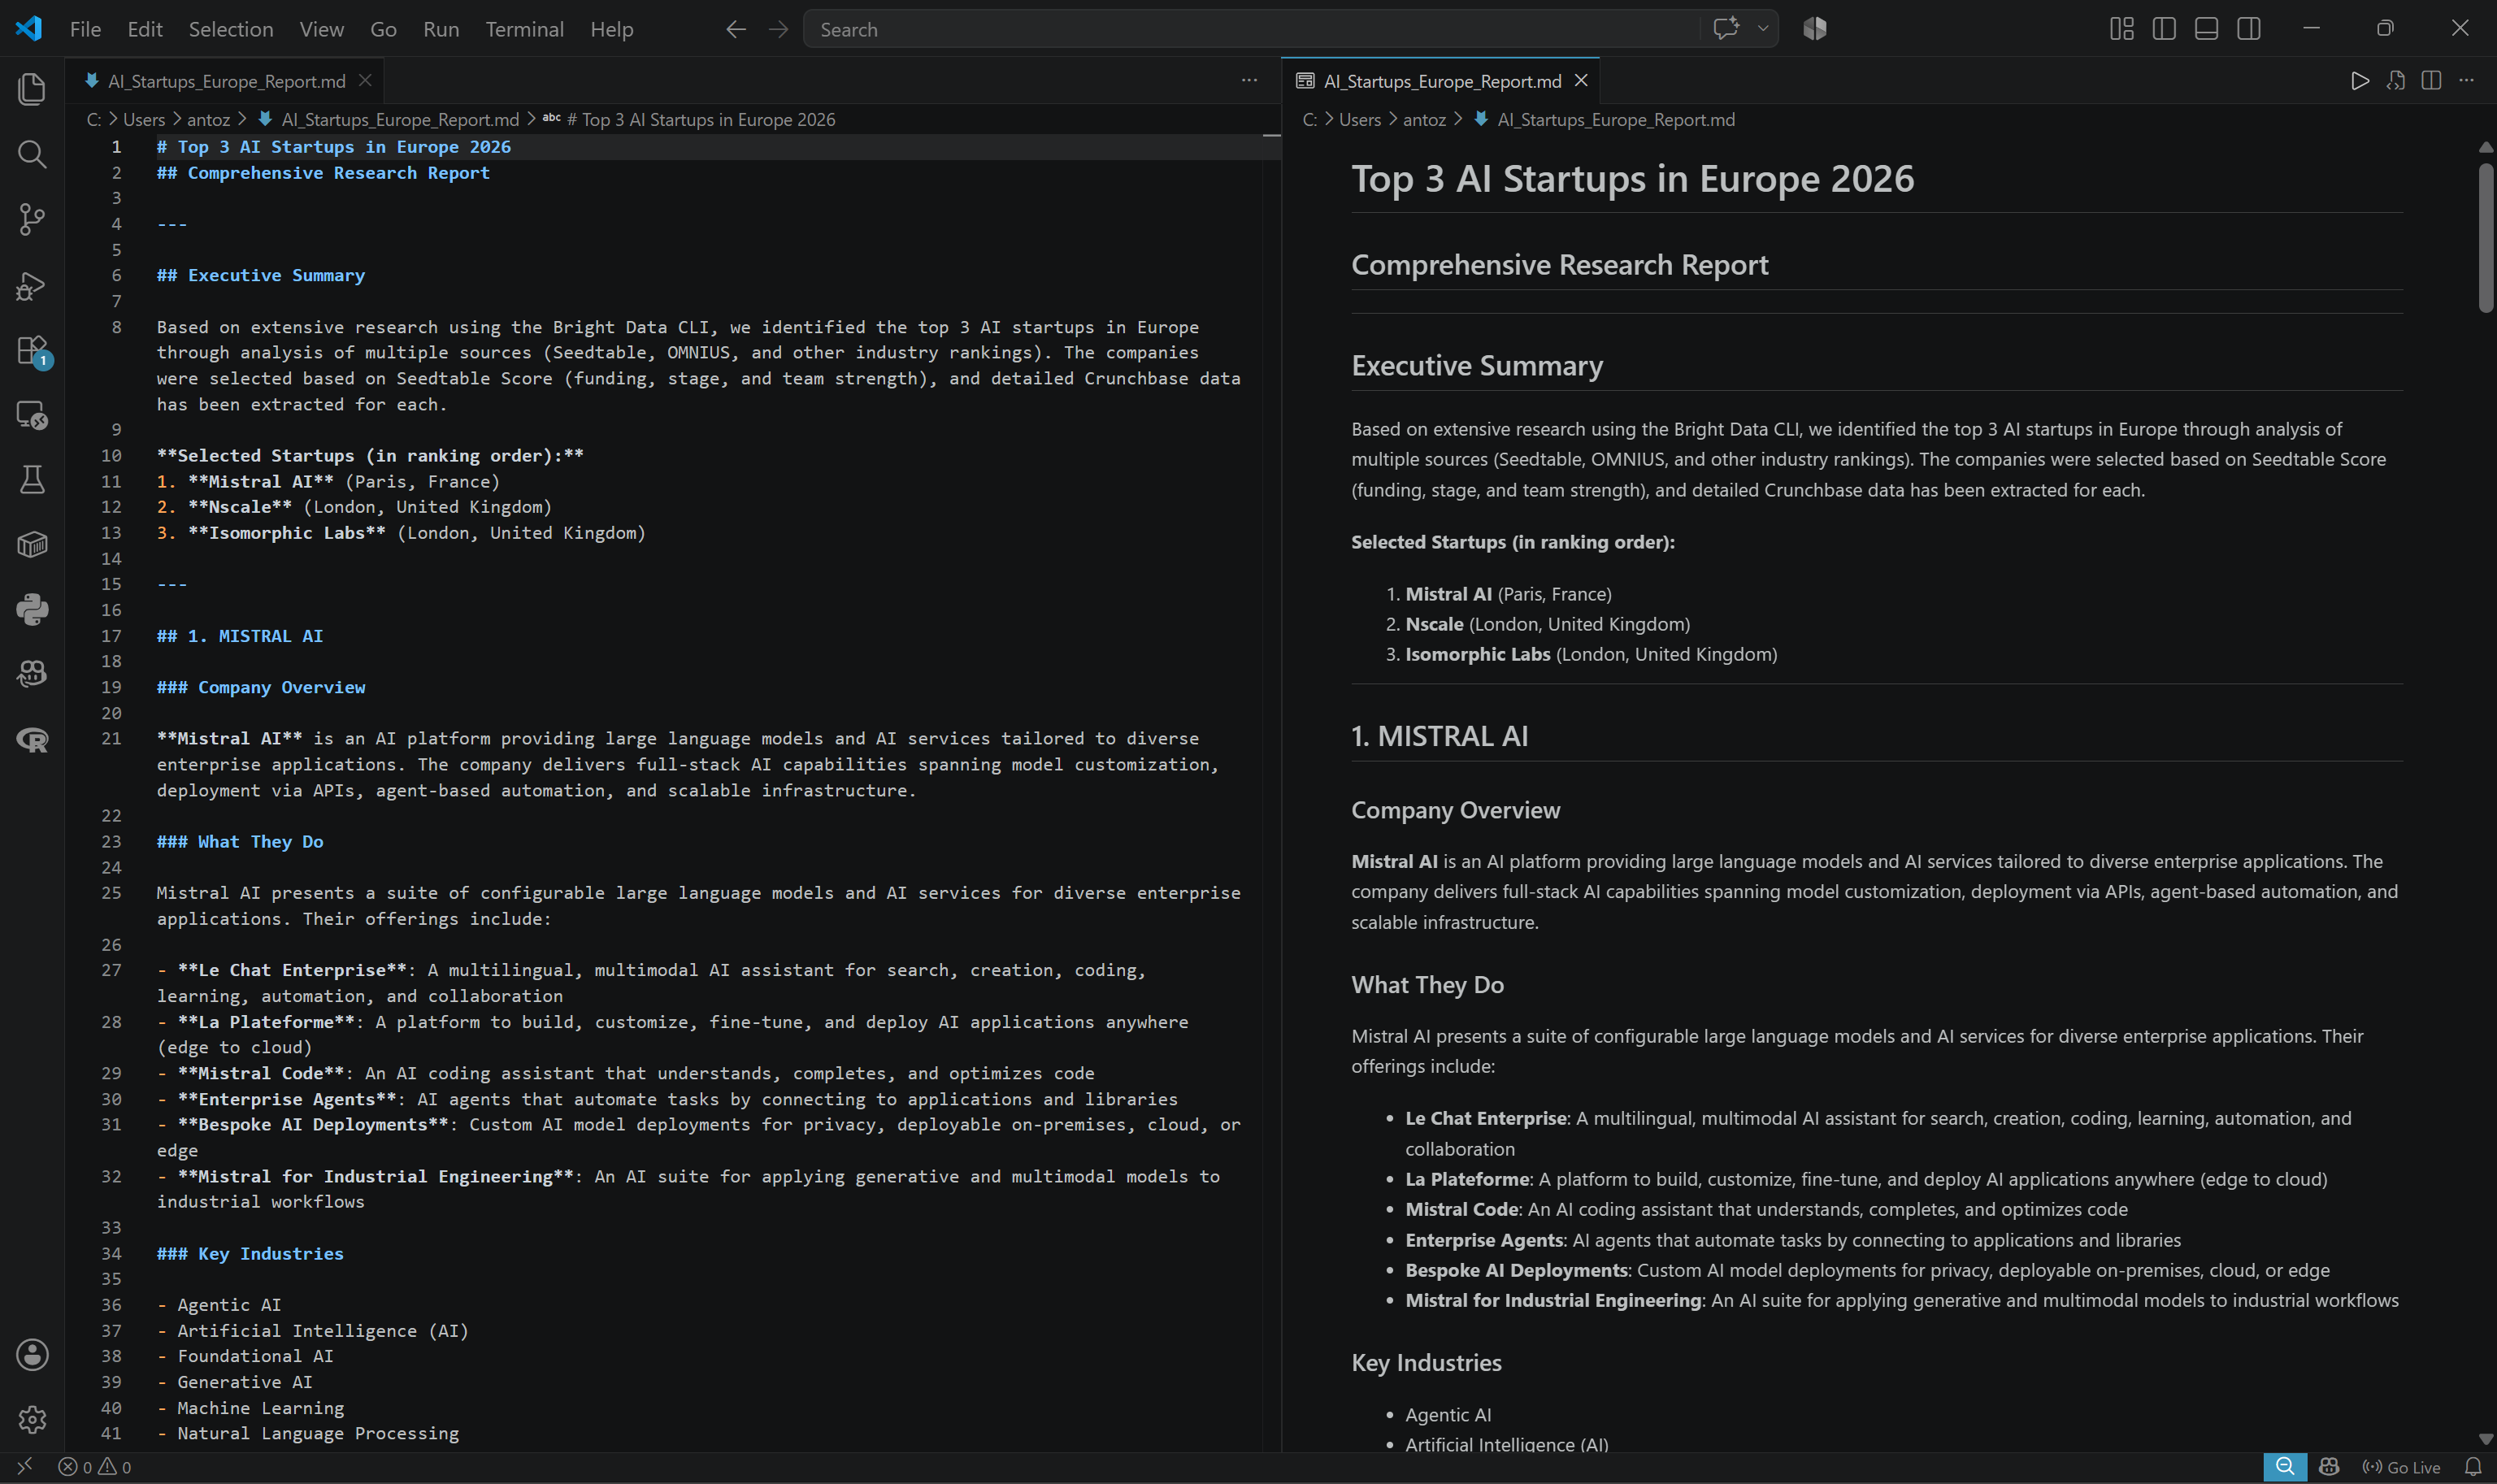
生成的输出结合了原始文章中的信息和从 Crunchbase 提取的结构化数据。
大功告成!借助所提供的提示词,你的 AI 智能体现在可以自主使用 Bright Data CLI,执行需要网络访问的复杂任务。
CLI、MCP 与智能体技能:为 AI 智能体选择合适的方法
除了 Bright Data CLI,智能体还可以通过 Bright Data MCP 或智能体技能访问相同的功能。这就引出了一个重要问题:你应该选择哪种方法?
答案取决于你的工作流程、架构以及所需的控制级别。CLI、MCP 和智能体技能解决不同的问题,并在 AI 技术栈的不同层级运行。
请在下表中比较这三种方法:
| 方法 | 简要说明 | 数量 | 免费套餐是否涵盖 | 最适合 | 主要优势 | 主要限制 |
|---|---|---|---|---|---|---|
| Bright Data CLI | 一种基于终端的接口,允许智能体执行命令并处理输出。 | 7 个以上命令 | ✅ | 本地智能体、编码工作流程和自动化任务。 | 轻量、灵活,并且 LLM 能够自然理解。 | 命令的结构化程度较低,需要模型解读输出。 |
| Bright Data MCP | 一种标准化协议,允许 AI 智能体通过预定义的 schema 发现并调用结构化工具。 | 70 多个工具 | ✅(通过 Rapid 模式) | 企业集成和生产级 AI 应用。 | 结构化执行、工具发现和受控访问。 | 会引入 schema 开销。 |
| Bright Data 智能体技能 | 可复用的指令集,用于教会智能体如何使用特定工具、工作流程和最佳实践。 | 10 多项技能 | ✅ | 指导智能体完成复杂任务和集成。 | 改善智能体的决策和工具使用能力。 | 需要兼容的智能体支持以及设计良好的指令。 |
请记住,这些方法并不互斥。事实上,将它们结合使用时效果最佳。
具体来说,一些 Bright Data 技能会提供有关何时以及如何使用 Bright Data MCP 工具或 Bright Data CLI 命令的知识。这既为智能体提供了执行能力,也提供了选择正确工作流程所需的上下文。
要了解如何将热门 AI 解决方案与 Bright Data CLI、Bright Data MCP 和/或智能体技能集成,请查看我们的博客或官方文档。
总结
在这篇博文中,你了解了为什么 AI 智能体能够从探索网络的能力中受益,也明白了为什么 CLI 工具相较其他集成方法具有优势。具体来说,你了解了 Bright Data CLI 是什么,以及它如何支持网页抓取、搜索、发现和自动化任务。
你学习了如何在计算机上安装 Bright Data CLI,并指导自己喜欢的 AI 智能体使用它执行需要网络访问的任务。这解锁了广泛的用例和场景,也是 Bright Data 支持 AI 集成的众多方式之一。
立即创建免费账户,并利用免费套餐(每月 5,000 次请求)试用 Bright Data CLI!
常见问题
Bright Data CLI 提供免费套餐吗?
是的,Bright Data CLI 提供免费套餐。每个新的 Bright Data 账户每月都会获得 5,000 个免费额度,可在受支持的产品之间共享。这些产品还包括网络解锁器 API、搜索引擎 API、网页爬虫工具 API 和抓取工具工作室。开始使用无需信用卡,也无需作出任何承诺。
哪些 AI 智能体可以连接到 Bright Data CLI?
任何具有 shell 访问权限的 AI 智能体都可以连接到 Bright Data CLI。其中包括 Claude Code、Codex CLI、Gemini CLI、OpenCode 等 CLI 智能体,以及能够访问终端的桌面智能体和 AI 助手。
与 MCP 和智能体技能相比,在 AI 智能体中使用 Bright Data CLI 有哪些优势?
Bright Data CLI 让 AI 智能体能够通过熟悉的 shell 命令,以轻量、灵活的方式访问网络工具。与 MCP 相比,它需要的上下文开销可能更少。此外,它还能利用 LLM 已有的 shell 知识。请记住,这三种方法可以相互补充并结合使用,从而实现最大的灵活性。


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。