Naver 已于 2026 年 7 月 31 日终止其 Shopping 搜索 API,且没有官方替代方案。团队仍然需要从 Naver Shopping 和 SmartStore 获取价格、排名和卖家名称,因此主要选择是爬虫 Naver 页面。
在我们的测试中,普通 HTTP 客户端可以从 Naver 搜索页面获得完整结果。然而,Naver 的购物页面会返回拦截页面、CAPTCHA 或登录重定向。数据仍然存在,并以 JSON 形式嵌入这些页面。
本指南介绍如何使用 Python 读取这些 JSON、由哪种 Bright Data 工具获取各类页面,以及每种工具的计费方式。
简要总结
- 使用 Bright Data 的搜索引擎 API 爬虫 Naver 搜索页面。从
discountedSalePrice读取价格,因为在 아이폰 17 的 8 个比价卡片中,有 6 个的salePrice为 0。 - 使用网络解锁器获取 Plus Store 结果,并使用 Browser API 处理分页。标记广告:코카콜라 제로 的前 6 个商品均非自然排名。
- 通过比价搜索重建 Shopping API 的大多数字段。对于 10 次查询中的全部 10 次,网络解锁器都返回了页面 JSON,其中包括
lowPrice、brand和分类。 - 将 SmartStore 商品 URL 发送到 Naver Shopping 爬虫工具 API。一批 10 个 URL 返回了所有公开商品,且价格与各自页面一致。
Naver Shopping 搜索 API 的终结
Naver Open API 曾是价格和数字货架监测的官方数据源。其 Shopping 搜索端点每次调用最多返回 100 件商品,使用免费密钥每天可调用 2.5 万次。
Naver 的开发者中心公告宣布,Shopping、Book 和研究文档搜索 API 将于 2026 年 7 月 31 日终止。公告称,现有密钥将停止工作,且没有宽限期。公告还表示,Naver 不会提供任何替代 API,NAVER API HUB 上也不会提供:
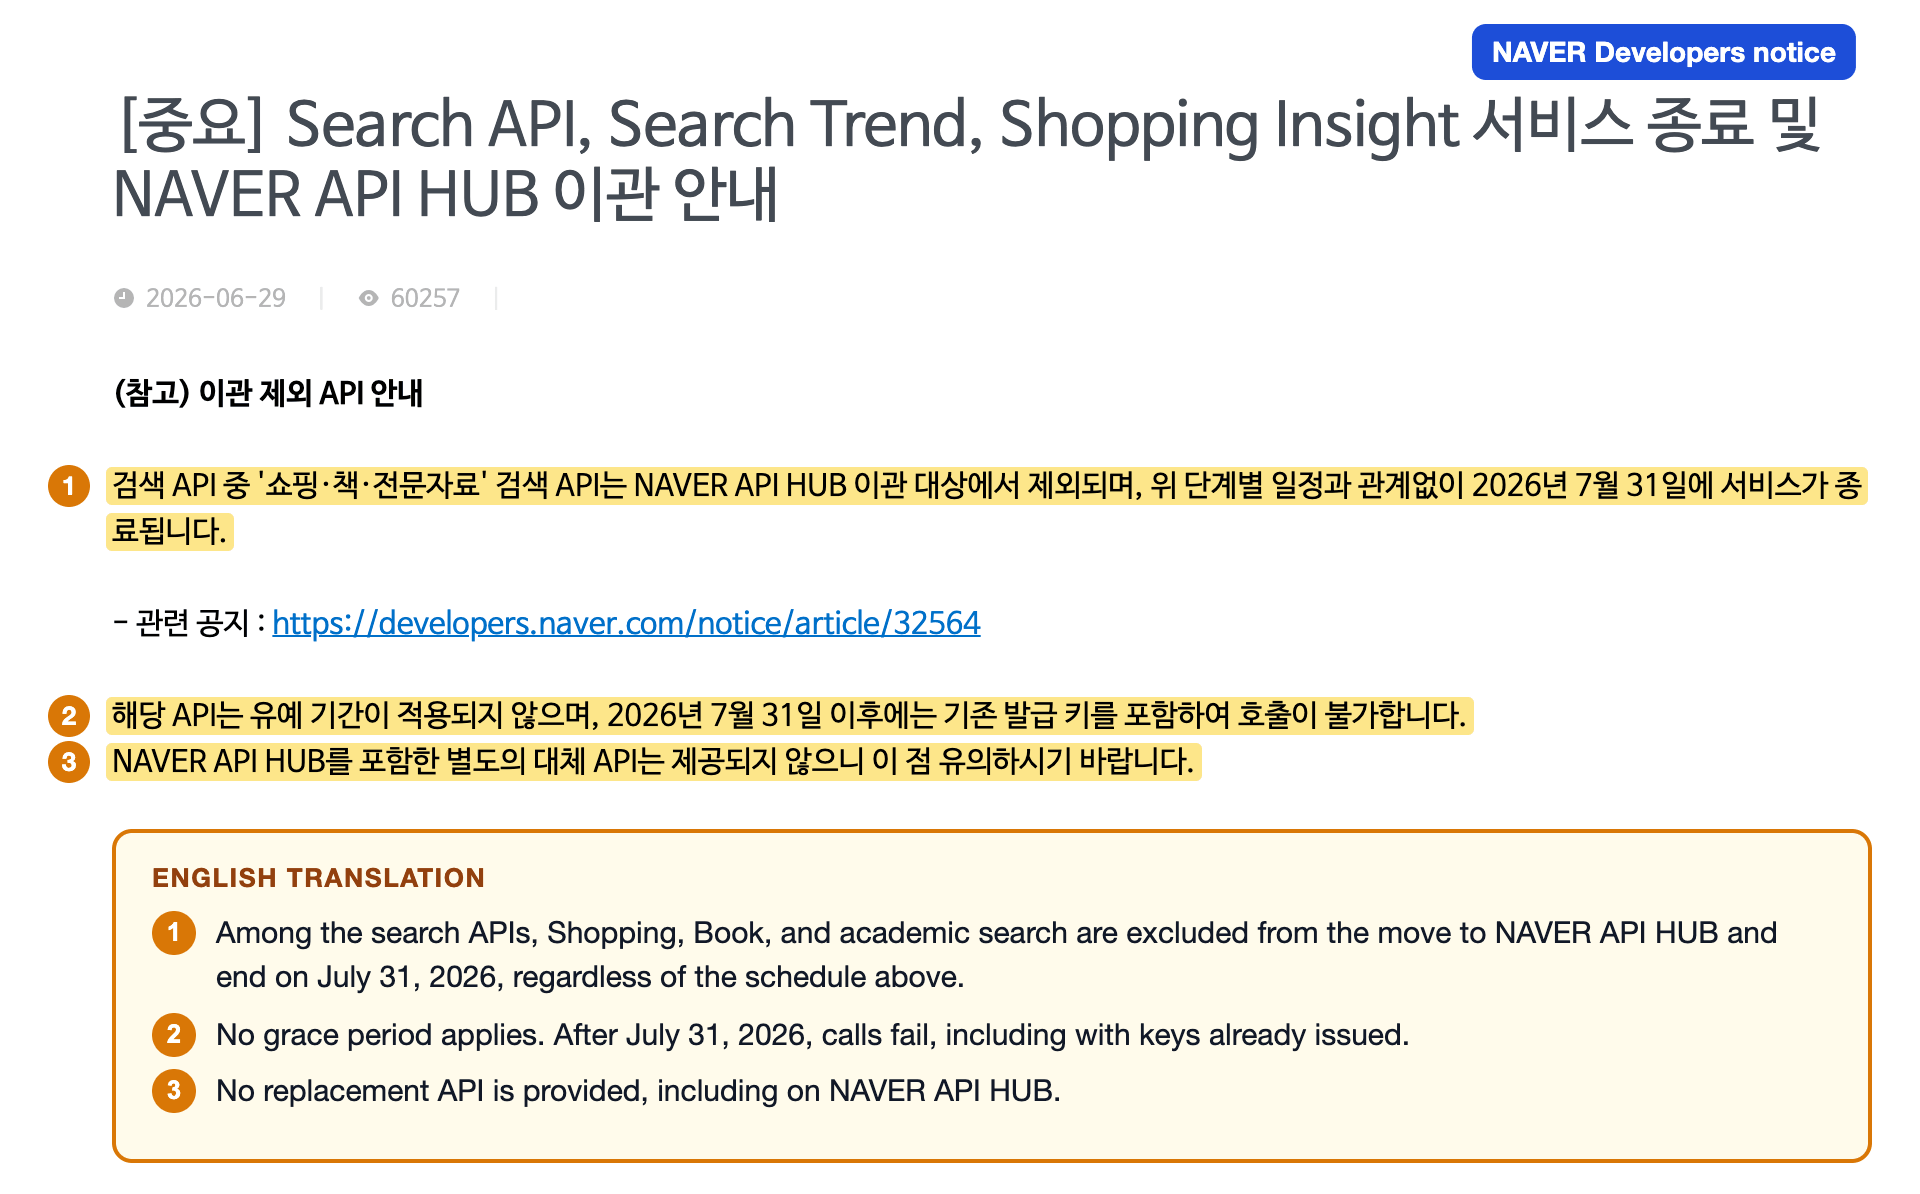
由于终止日期已确定且没有宽限期,调用此 API 的数据流必须在 2026 年 7 月 31 日前改用新的数据源。
同一公告表示,其他搜索 API(包括博客、新闻和网页文档搜索)将迁移至 NAVER Cloud Platform 上的 NAVER API HUB。2026 年 7 月 31 日之前签发的开发者中心密钥可继续用于这些 API,直至 2027 年 6 月 30 日。
根据 Naver 的 Open API 条款这些 API 也不能用作监测数据流。条款禁止复制、存储或缓存结果,但为保证服务连续性而进行的临时缓存除外。条款还禁止向第三方提供或出售结果,以及将结果用作 AI 输入或训练数据。
Naver 的 DataLab Shopping Insight API 按分类和关键词返回点击趋势。它会缩放每条趋势,使其最高点为 100。这些趋势可以显示关注度是上升还是下降,但不包含价格。Naver 的公开页面会显示价格、排名和卖家名称,因此应从这些页面采集。
Naver 各项服务如何响应爬虫工具
我们从印度的一条住宅网络连接,使用 4 个普通 HTTP 客户端测试了 Naver 的 4 项服务。搜索和酒店页面返回完整 HTML,但购物和商品页面会拦截这些客户端。对于被拦截的页面,下表还列出了浏览器和解锁工具的结果:
| Naver 服务 | 普通 HTTP 客户端获得的结果 | 浏览器和解锁工具获得的结果 |
|---|---|---|
搜索(search.naver.com) |
返回完整结果页面,约 1.5 MB,即使使用默认的 python-requests User-Agent 也是如此 | 加载页面时不需要这些工具 |
购物搜索(search.shopping.naver.com) |
HTTP 418 拦截页面、HTTP 405 CAPTCHA 页面,或重定向至 Naver 登录页面的 307 响应 | 无头 Chrome 收到 418,有头 Chrome 收到 CAPTCHA,网络解锁器则获得结果 |
SmartStore 商品(smartstore.naver.com) |
第一次请求即返回标题为“시스템오류”(“系统错误”)的 HTTP 429 页面 | 网络解锁器和 Browser API 获得商品页面 |
酒店(hotels.naver.com) |
返回包含 Next.js 数据的完整页面 | 加载页面时不需要这些工具 |
Naver 搜索在全部 500 次测试请求中都返回了结果,没有出现 CAPTCHA 或拦截。前 200 次请求按顺序发送,每次间隔约 2 秒。另外 300 次则由 8 个并发工作进程以每秒 4.9 次请求的速度突发发送,并且每次突发请求都使用新会话。
购物搜索上的 418 页面称访问暂时受限。该页面列出了 4 个触发因素:来自与购物无关的外部推广活动的访问、来自单个 IP 的突发请求、VPN IP,以及某些浏览器扩展程序。405 页面从 ncpt.naver.com 加载了 Naver 自己的 CAPTCHA 脚本。
在有头 Chrome 中,405 页面从 wtm.pstatic.net 加载了 WebAssembly 模块,并将加密载荷发布至 ncpt.naver.com/v2/tokens。随后,页面显示了一道收据 CAPTCHA:一张生成的商店收据,以及一道关于该收据的填空题。
使用 Chrome User-Agent 的普通 HTTP 客户端收到的是 405 CAPTCHA,而非 418。即使 curl_cffi 与 Chrome 的 TLS 和 HTTP/2 指纹相匹配,405 CAPTCHA 仍然会出现。无头 Chrome 在第一次文档请求时就收到 418,耗时 0.5 秒,且此时尚未运行任何页面脚本。从 python-requests 到有头 Chrome,6 个客户端都未能获得购物结果。
SmartStore 的 429 会在每个新客户端的第一次请求时出现,因此其行为更像拦截,而不是典型的速率限制。错误文本称,原因是流量过大或网络不稳定。
只采集无需登录即可加载的页面。登录重定向后的数据并非公开数据,因为访问这些数据需要自动操作 Naver 账户。Bright Data 的可接受使用政策也不允许采集登录后的数据。
将每项服务视为独立目标。
嵌入每个 Naver 页面中的 JSON
我们测试的每个 Naver 页面都在 HTML 中以 JSON 或 JavaScript 对象的形式包含数据,因此解析器不需要 CSS 选择器。在搜索结果页面上,每个购物区块的数据都被赋给了各自的 JavaScript 变量:
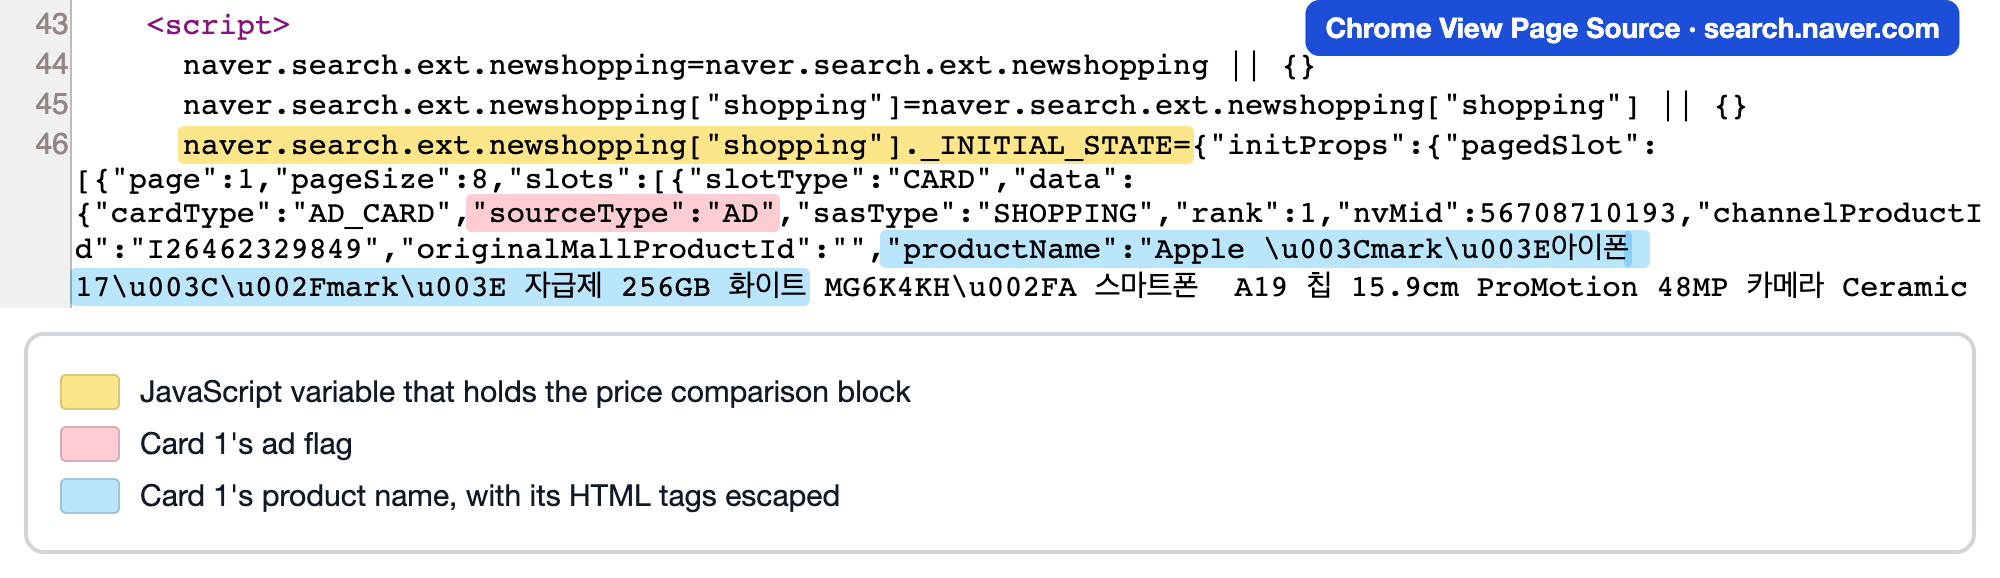
比价区块的数据是一个 JSON 对象,因此只需调用一次解码器即可读取其中的所有卡片。在“查看网页源代码”中,这项赋值位于单独一行,共有 32,182 个字符。
每个页面都将 JSON 存储在不同位置,而且每个页面都有各自的解析问题:
| 页面 | JSON 位置 | 解析问题 |
|---|---|---|
| 搜索结果 | naver.search.ext.newshopping["shopping"] 上的 _INITIAL_STATE 对象,以及 ["nstore"] 上的另一个对象 |
아이폰 17 的 8 个比价卡片中,有 6 个的 salePrice 为 0。页面显示的价格位于 discountedSalePrice。 |
Plus Store 搜索(/ns/search) |
通过 self.__next_f.push 推送的 React Server Component 数据块位于键 initPagedCompositeCards 下 |
JSON 的引号在 HTML 内被转义,因此需要先拼接并解码这些数据块,然后再搜索。 |
比价搜索(/search/all) |
props.pageProps.compositeList.list[].item 处的 __NEXT_DATA__ |
price 是字符串,而 lowPrice 是整数,因此使用 price 前要先将其转换为数字。 |
| SmartStore 商品 | simpleProductForDetailPage 处的 window.__PRELOADED_STATE__ |
该对象并非严格的 JSON,并且顶层 product 键中的值均为 0。 |
当解析器开始无法返回任何内容时,请优先检查这些路径。
即使渲染后的页面看起来更容易读取,也应解析 JSON。Naver 页面将某个 Apple 商品的显示评论数限制为“9,999+”,而同一商品的嵌入式 JSON 中则包含准确数量 13,971。
SmartStore 的状态数据还需要进行 3 项额外检查。在一个商品页面上,状态是包含 34 个裸 undefined 值的 JavaScript 对象字面量,因此 json.loads 会引发错误。商品的 id 与 URL 中的数字相同,但内部 productNo 是另一个数字,因此应将 id 用作商品 ID。该页面还包含 2 个评论数,一个属于单件商品,另一个更大的数值属于其商品组。
下面的函数会规范化该对象,并区分有效商品和失效商品:
import json
import re

MARKER = "window.__PRELOADED_STATE__="


def smartstore_product(html: str) -> dict | None:
    start = html.index(MARKER) + len(MARKER)
    # The state is a JavaScript object literal, and bare undefined values break json
    text = re.sub(r"(?<=[:\[,])undefined(?=[,\]}])", "null", html[start:])
    state, _ = json.JSONDecoder().raw_decode(text)
    product = state["simpleProductForDetailPage"]
    # None for a deleted listing, an empty id for one behind an authorization check
    return product if product and product.get("id") else None
已删除商品的 URL 仍会返回正常页面,其标题为“상품이 존재하지 않습니다”(“商品不存在”)。因此,仅检查状态码会将该页面视为有效商品。对于此类页面以及需要授权检查的商品,该函数会返回 None。应将 None 结果视为从监测列表中移除该 URL 的信号。
为 Naver 设置 Bright Data
有 4 个脚本会使用 requests 调用 Bright Data 的 REST API,分页脚本则使用 Playwright 驱动云浏览器。你需要:
- 一个 Bright Data 账户,以及从账户设置中获取的 API 密钥。
- 一个搜索引擎 API 区域、一个网络解锁器区域和一个 Browser API 区域。区域是控制面板中某项产品的配置,脚本会使用其名称。Naver Shopping 抓取工具 API 只需要 API 密钥。
- Python 3.10 或更高版本,以及
requests和playwright。分页脚本会将 Playwright 连接到远程浏览器,因此无需下载本地浏览器。
为确保安全,区域只能接受来自其 IP 允许列表中地址的请求。如果发送到区域的请求返回 ip_forbidden请将你的计算机 IP 添加到该列表。
安装软件包并导出凭据:
pip install requests playwright
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_SERP_ZONE="your_serp_zone"
export BRIGHTDATA_UNLOCKER_ZONE="your_unlocker_zone"
export BRIGHTDATA_BROWSER_WSS="wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222"
BRIGHTDATA_BROWSER_WSS 值是在区域的访问详情中Puppeteer / Playwright 下显示的 WebSocket URL:
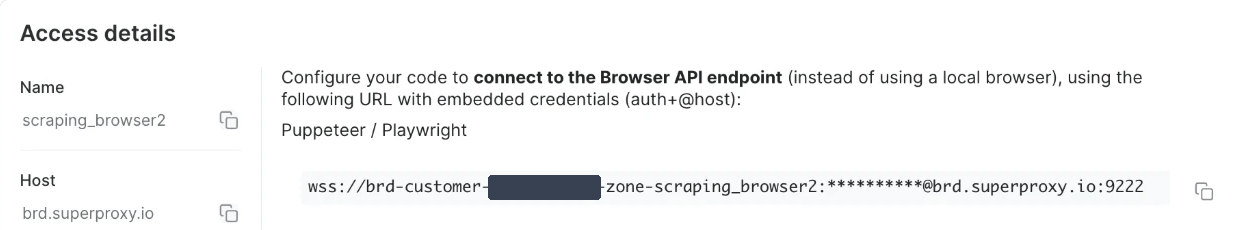
该 URL 已嵌入区域的用户名和密码。
在区域名称后添加 -country-kr以通过韩国 IP 路由请求。如果你更倾向于使用 SDK 而不是原始 HTTP,请安装 Bright Data Python SDK:brightdata-sdk。
如果想在编写代码前检查单个 URL,可以使用 Bright Data CLI它会通过网络解锁器获取该 URL:
bdata scrape "https://smartstore.naver.com/acnope/products/10444371682" --country kr -f html -o product.html该命令保存了完整的 SmartStore 商品页面,因此 smartstore_product(open("product.html", encoding="utf-8").read()) 会返回其商品数据。
使用搜索引擎 API 从 Naver 搜索中爬虫购物结果
对于 아이폰 17(iPhone 17),Naver 桌面端结果页面显示了 2 个购物区块,一个包含比价卡片,另一个包含 Naver Plus Store 商品:
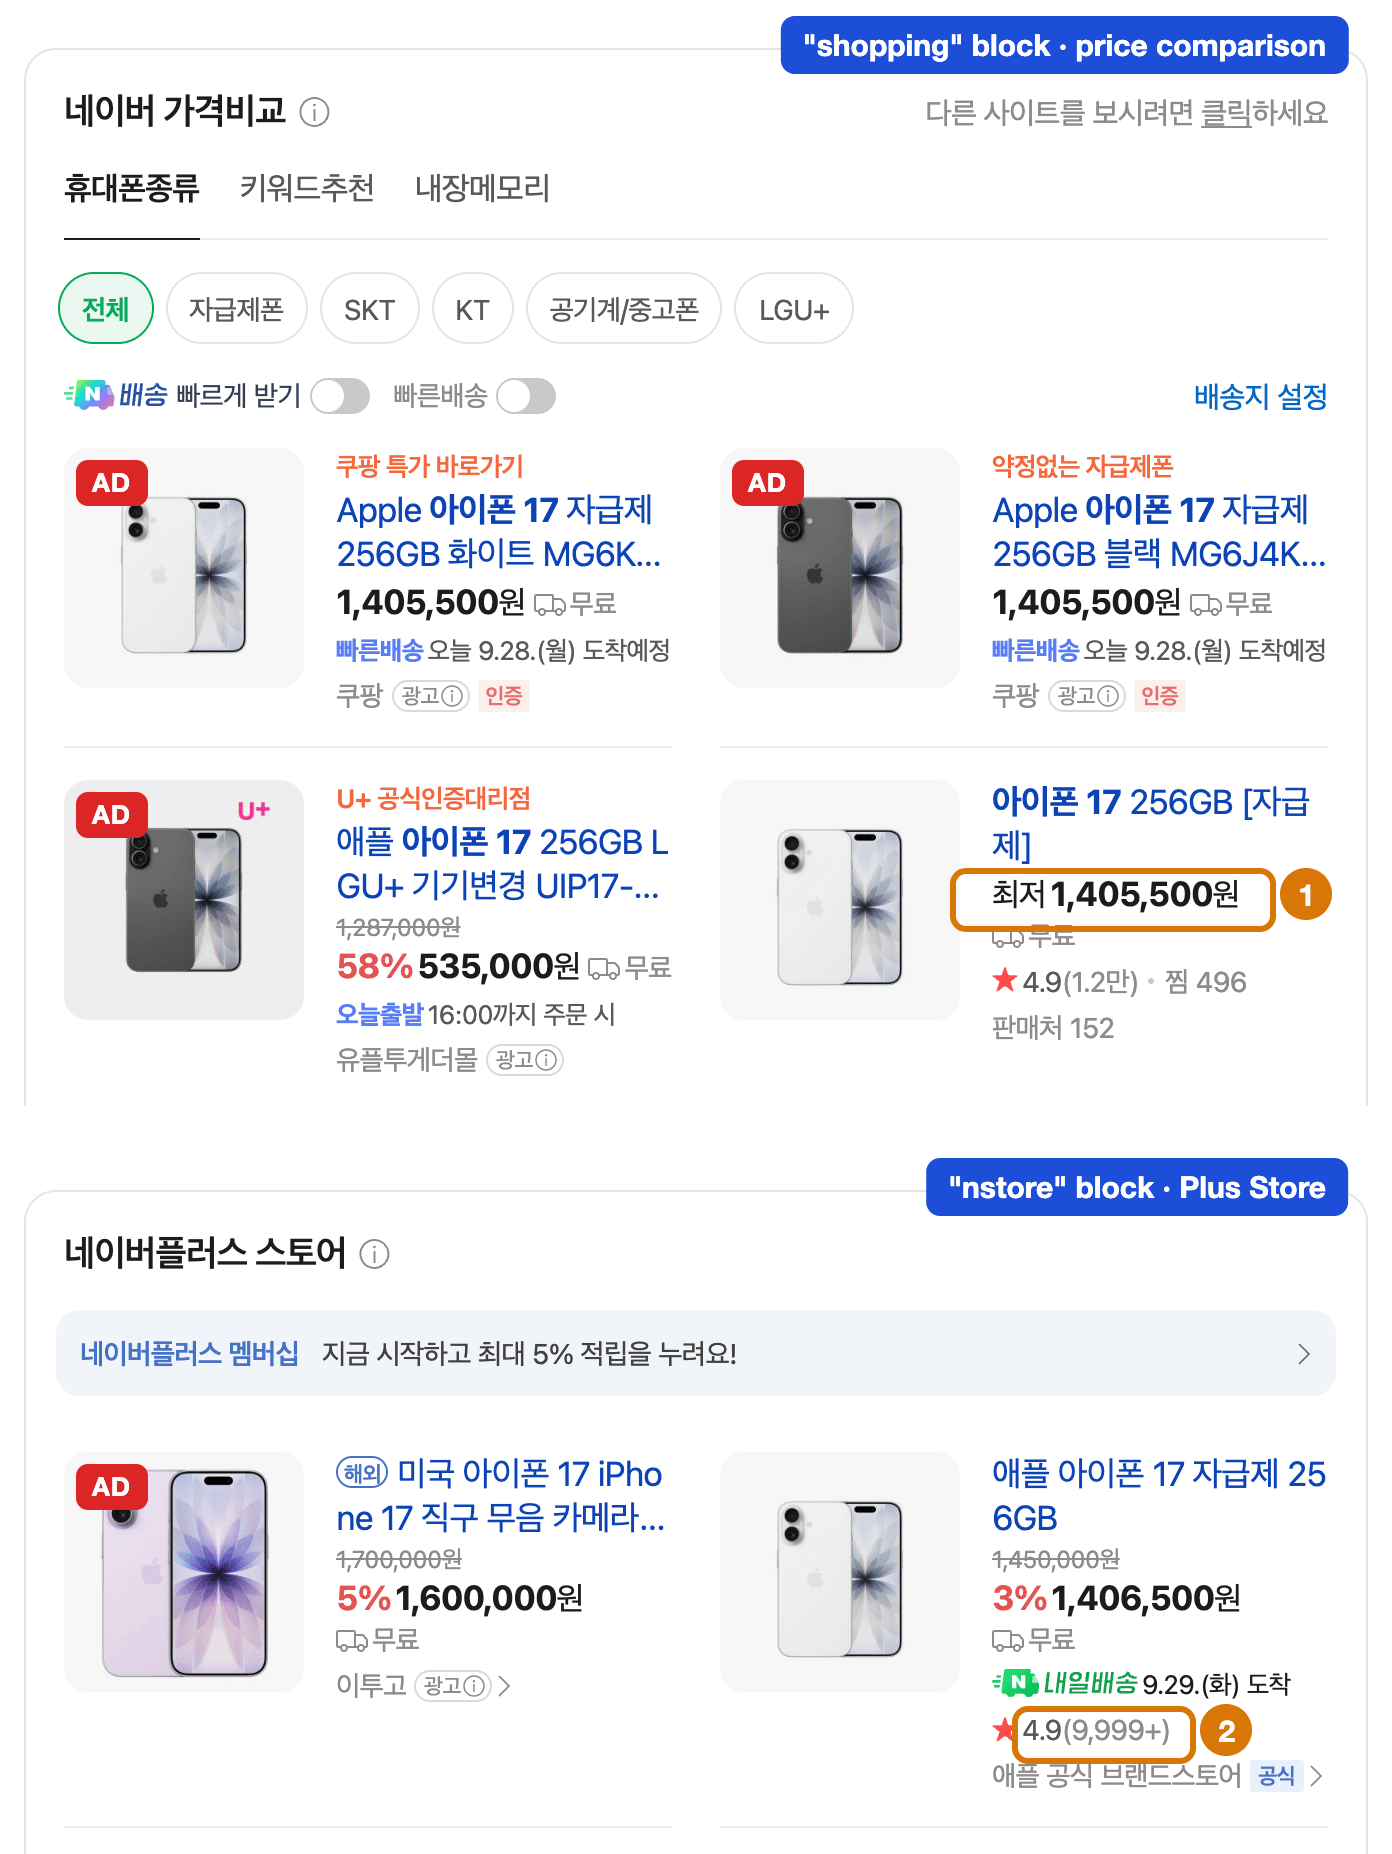
红色标签标记了 Naver 标注为 광고(广告)的卡片,解析器会将其标记为 is_ad。在标记 1 处,卡片显示 1,405,500 韩元,而其 salePrice 字段为 0。在标记 2 处,评论数显示为 9,999+,而 JSON 中的值为 13,971。
将搜索引擎 API用于搜索引擎结果页面(SERP),包括 Naver;将网络解锁器用于其他网站。搜索引擎 API 按成功请求计费。
Naver 将搜索引擎 API 请求的地理位置定位到韩国。其嵌入式 JSON 为这些请求记录了 KR而从印度直接发出的请求则记录了 IN 和一座印度城市。
对于 Naver,请将区域的数据格式设置为原始 HTML或在每次请求中传递 "data_format": "html":
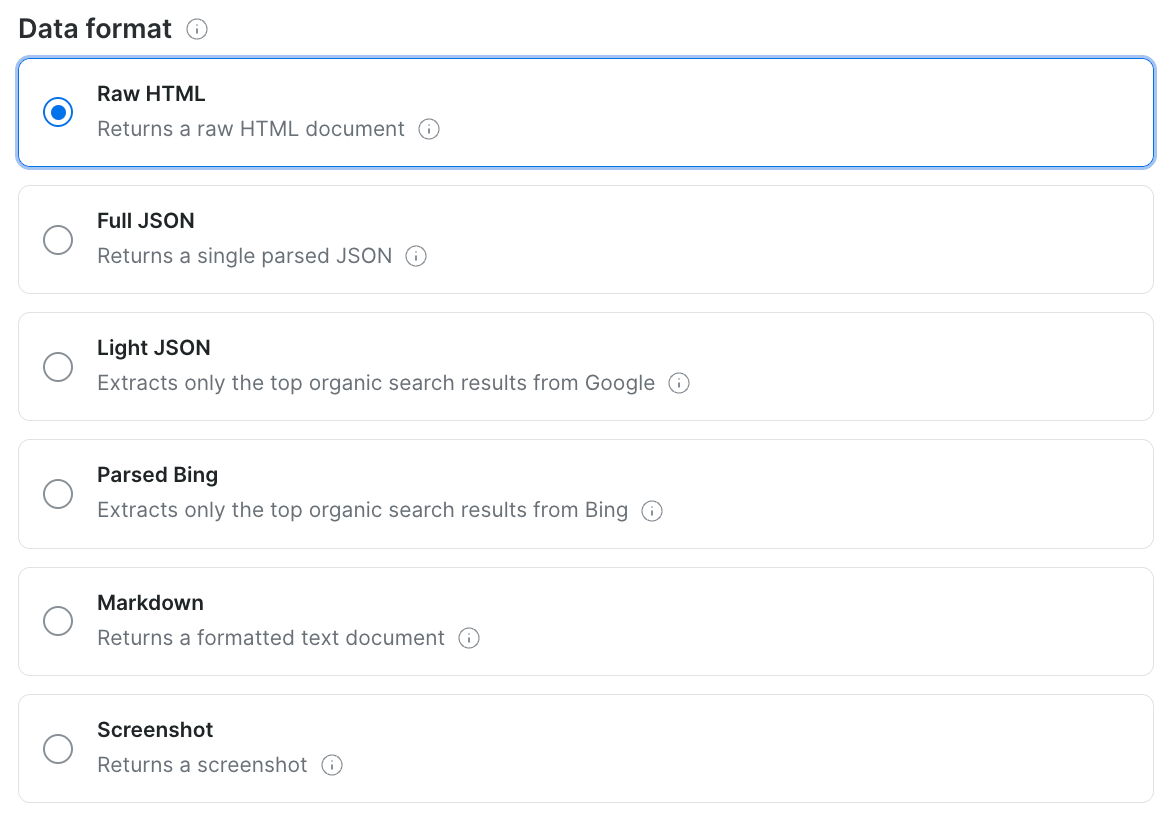
原始 HTML 会返回完整结果页面,包括 Naver 嵌入的购物 JSON。
下面的脚本会获取结果页面,并返回两个购物区块中的所有卡片,同时标记广告:
import json
import os
import re
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
SERP_ZONE = os.environ["BRIGHTDATA_SERP_ZONE"]

# Each shopping block on the results page assigns its data to a JS global
STATE = re.compile(r'naver\.search\.ext\.newshopping\["(\w+)"\]\._INITIAL_STATE\s*=\s*')


def fetch_naver_serp(query: str) -> str:
    url = f"https://search.naver.com/search.naver?where=nexearch&query={quote(query)}"
    resp = requests.post(
        API_URL,
        headers=HEADERS,
        # Request the raw page, which contains Naver's embedded shopping JSON
        json={"zone": SERP_ZONE, "url": url, "format": "raw", "data_format": "html"},
        timeout=120,
    )
    resp.raise_for_status()
    if resp.headers.get("x-brd-error") or "_INITIAL_STATE" not in resp.text:
        raise RuntimeError(f"No shopping state for {query!r}: {resp.headers.get('x-brd-error')}")
    return resp.text


def parse_shopping_blocks(html: str) -> list[dict]:
    decoder = json.JSONDecoder()
    rows = []
    for match in STATE.finditer(html):
        block = match.group(1)  # "shopping" = price comparison, "nstore" = Plus Store
        state, _ = decoder.raw_decode(html, match.end())
        props = state["initProps"]
        if block == "shopping":
            items = [slot["data"] for page in props["pagedSlot"] for slot in page["slots"]]
        else:
            items = props["products"]
        for position, item in enumerate(items, start=1):
            rows.append({
                "block": block,
                "position": position,
                "is_ad": item.get("sourceType") == "AD",
                "name": re.sub(r"<[^>]+>", "", item.get("productName", "")),
                # discountedSalePrice holds the displayed price, and salePrice can be 0
                "price": item.get("discountedSalePrice") or item.get("salePrice"),
                "mall": item.get("mallName") or None,
                "reviews": item.get("totalReviewCount"),
                "nv_mid": item.get("nvMid"),
                "channel_product_id": item.get("channelProductId"),
            })
    return rows


if __name__ == "__main__":
    for row in parse_shopping_blocks(fetch_naver_serp("아이폰 17")):
        label = "ad" if row["is_ad"] else "  "
        print(f'{row["block"]:<8} {row["position"]} {label} {row["price"]:>9,} KRW  '
              f'{row["mall"] or "(catalog)":<12} {row["name"][:24]}')
对于 아이폰 17,该脚本输出了 8 个比价卡片和 4 个 Plus Store 商品:
shopping 1 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 화
shopping 2 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 블
shopping 3 ad   535,000 KRW  유플투게더몰       애플 아이폰 17 256GB LGU+ 기기변
shopping 4    1,405,500 KRW  (catalog)    아이폰 17 256GB [자급제]
shopping 5    1,713,000 KRW  (catalog)    아이폰 17 프로 256GB [자급제]
shopping 6    2,006,400 KRW  (catalog)    아이폰 17 프로 512GB [자급제]
shopping 7       29,600 KRW  로트박스         [대여] 애플 아이폰 17 프로 대여 렌탈
shopping 8    2,294,400 KRW  (catalog)    아이폰 17 프로 1TB [자급제]
nstore   1 ad 1,600,000 KRW  이투고          미국 아이폰 17 iPhone 17 직구 무
nstore   2    1,406,500 KRW  애플 공식 브랜드스토어 애플 아이폰 17 자급제
nstore   3    1,790,000 KRW  애플 공식 브랜드스토어 애플 아이폰 17 프로 자급제
nstore   4    1,697,500 KRW  애플 공식 브랜드스토어 애플 아이폰 17 자급제
前 3 个卡片是广告,第三个显示的价格要求签订运营商合约,并非无锁版手机的价格。目录商品卡片没有 mall 值channel_product_id 为空,因为它们指向 Naver 的比价页面,而不是单一商店。在 10 次查询中,搜索引擎 API 在全部 10 次中都返回了包含购物 JSON 的页面。
同一天的 2 次运行之间,有 2 个 Plus Store 位置发生了互换。请为每一行存储时间戳和广告标记,并在排名跟踪报告变化前多次采样同一个关键词。
使用网络解锁器爬虫 Naver Plus Store 搜索结果
Naver 于 2024 年推出了购物平台 Plus Store。在其搜索页面上,普通 HTTP 客户端会收到 418 拦截页面、405 CAPTCHA 或登录重定向。
网络解锁器是 Bright Data 的自动化网页解锁工具,可获取 URL 并按成功请求计费。使用韩国 IP 时,它会返回嵌入前 50 个卡片的搜索页面。在 10 次查询中,网络解锁器在全部 10 次中都返回了包含结果数据的 Plus Store 页面。
下面的获取函数会请求韩国 IP,确认响应中包含结果数据,并使用退避策略重试:
import json
import os
import re
import time
from collections import Counter
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]

FLIGHT = re.compile(r"self\.__next_f\.push\((\[.*?\])\)</script>", re.S)
KEY = '"initPagedCompositeCards":'
MARKER = "initPagedCompositeCards"  # quotes are escaped inside the raw HTML


def fetch_plus_store_search(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/ns/search?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # Naver can redirect to a login page, so check for the result data, not the status
        if resp.ok and MARKER in resp.text:
            return resp.text
        reason = resp.headers.get("x-brd-error") or ("login wall" if "nidlogin" in resp.text else "no data")
        print(f"attempt {attempt} failed: {reason}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Plus Store search failed for {query!r}")


def parse_search(html: str) -> dict:
    # The page streams React Server Component data in string chunks
    chunks = [json.loads(m.group(1)) for m in FLIGHT.finditer(html)]
    flight = "".join(c[1] for c in chunks if len(c) == 2 and isinstance(c[1], str))
    start = flight.index(KEY) + len(KEY)
    result, _ = json.JSONDecoder().raw_decode(flight, start)
    products = []
    for card in result["data"]:
        item = card.get("card", {}).get("product")
        if not item:
            continue  # banners and promotion slots have no product
        products.append({
            "rank": len(products) + 1,
            "type": item.get("cardType") or "ORGANIC",
            "name": item.get("productName"),
            "price": item.get("discountedSalePrice"),
            "list_price": item.get("salePrice"),
            "mall": item.get("mallName"),
            "reviews": item.get("totalReviewCount"),
            "url": (item.get("productUrl") or {}).get("pcUrl"),
        })
    return {"total": result["total"], "next_cursor": result["cursor"], "products": products}


if __name__ == "__main__":
    page = parse_search(fetch_plus_store_search("코카콜라 제로"))
    mix = Counter(p["type"] for p in page["products"])
    print("total results:", page["total"], "| next cursor:", page["next_cursor"], "| page 1 mix:", dict(mix))
    for p in page["products"][:3] + [p for p in page["products"] if p["type"] == "ORGANIC"][:2]:
        print(json.dumps(p, ensure_ascii=False))
对于 코카콜라 제로(Coke Zero),第 1 页的 50 个卡片中有 47 件商品,第一个自然排名商品位于第 7 名:
total results: 7746 | next cursor: 33 | page 1 mix: {'AD': 12, 'SUPER_POINT': 2, 'ORGANIC': 31, 'SME_SLOT': 2}
{"rank": 1, "type": "AD", "name": "코카-콜라 제로 CAN 350ml 24개", "price": 21600, "list_price": 35290, "mall": "코카콜라직영몰", "reviews": 96956, "url": "https://smartstore.naver.com/main/products/4660954096"}
{"rank": 2, "type": "AD", "name": "코카-콜라 제로 CAN 190ml 30개", "price": 18000, "list_price": 24790, "mall": "코카콜라직영몰", "reviews": 46451, "url": "https://smartstore.naver.com/main/products/4609271837"}
{"rank": 3, "type": "AD", "name": "코카-콜라 제로 레몬라임 CAN 350ml 48개(2x24입) + 코크 큐브 블럭캘린더 (옵션선택)", "price": 38720, "list_price": 70580, "mall": "코카콜라직영몰", "reviews": 440, "url": "https://smartstore.naver.com/main/products/13689352448"}
{"rank": 7, "type": "ORGANIC", "name": "코카-콜라 제로 라벨프리 PET 370ml 24개", "price": 22880, "list_price": 35300, "mall": "코카콜라직영몰", "reviews": 25197, "url": "https://smartstore.naver.com/main/products/6006925665"}
{"rank": 8, "type": "ORGANIC", "name": "코카-콜라 제로 제로 라벨프리 PET 370ml 18개", "price": 16720, "list_price": 20900, "mall": "코카콜라직영몰", "reviews": 3676, "url": "https://smartstore.naver.com/main/products/11574172085"}
在页面本身,前 6 个排名中没有自然排名商品:
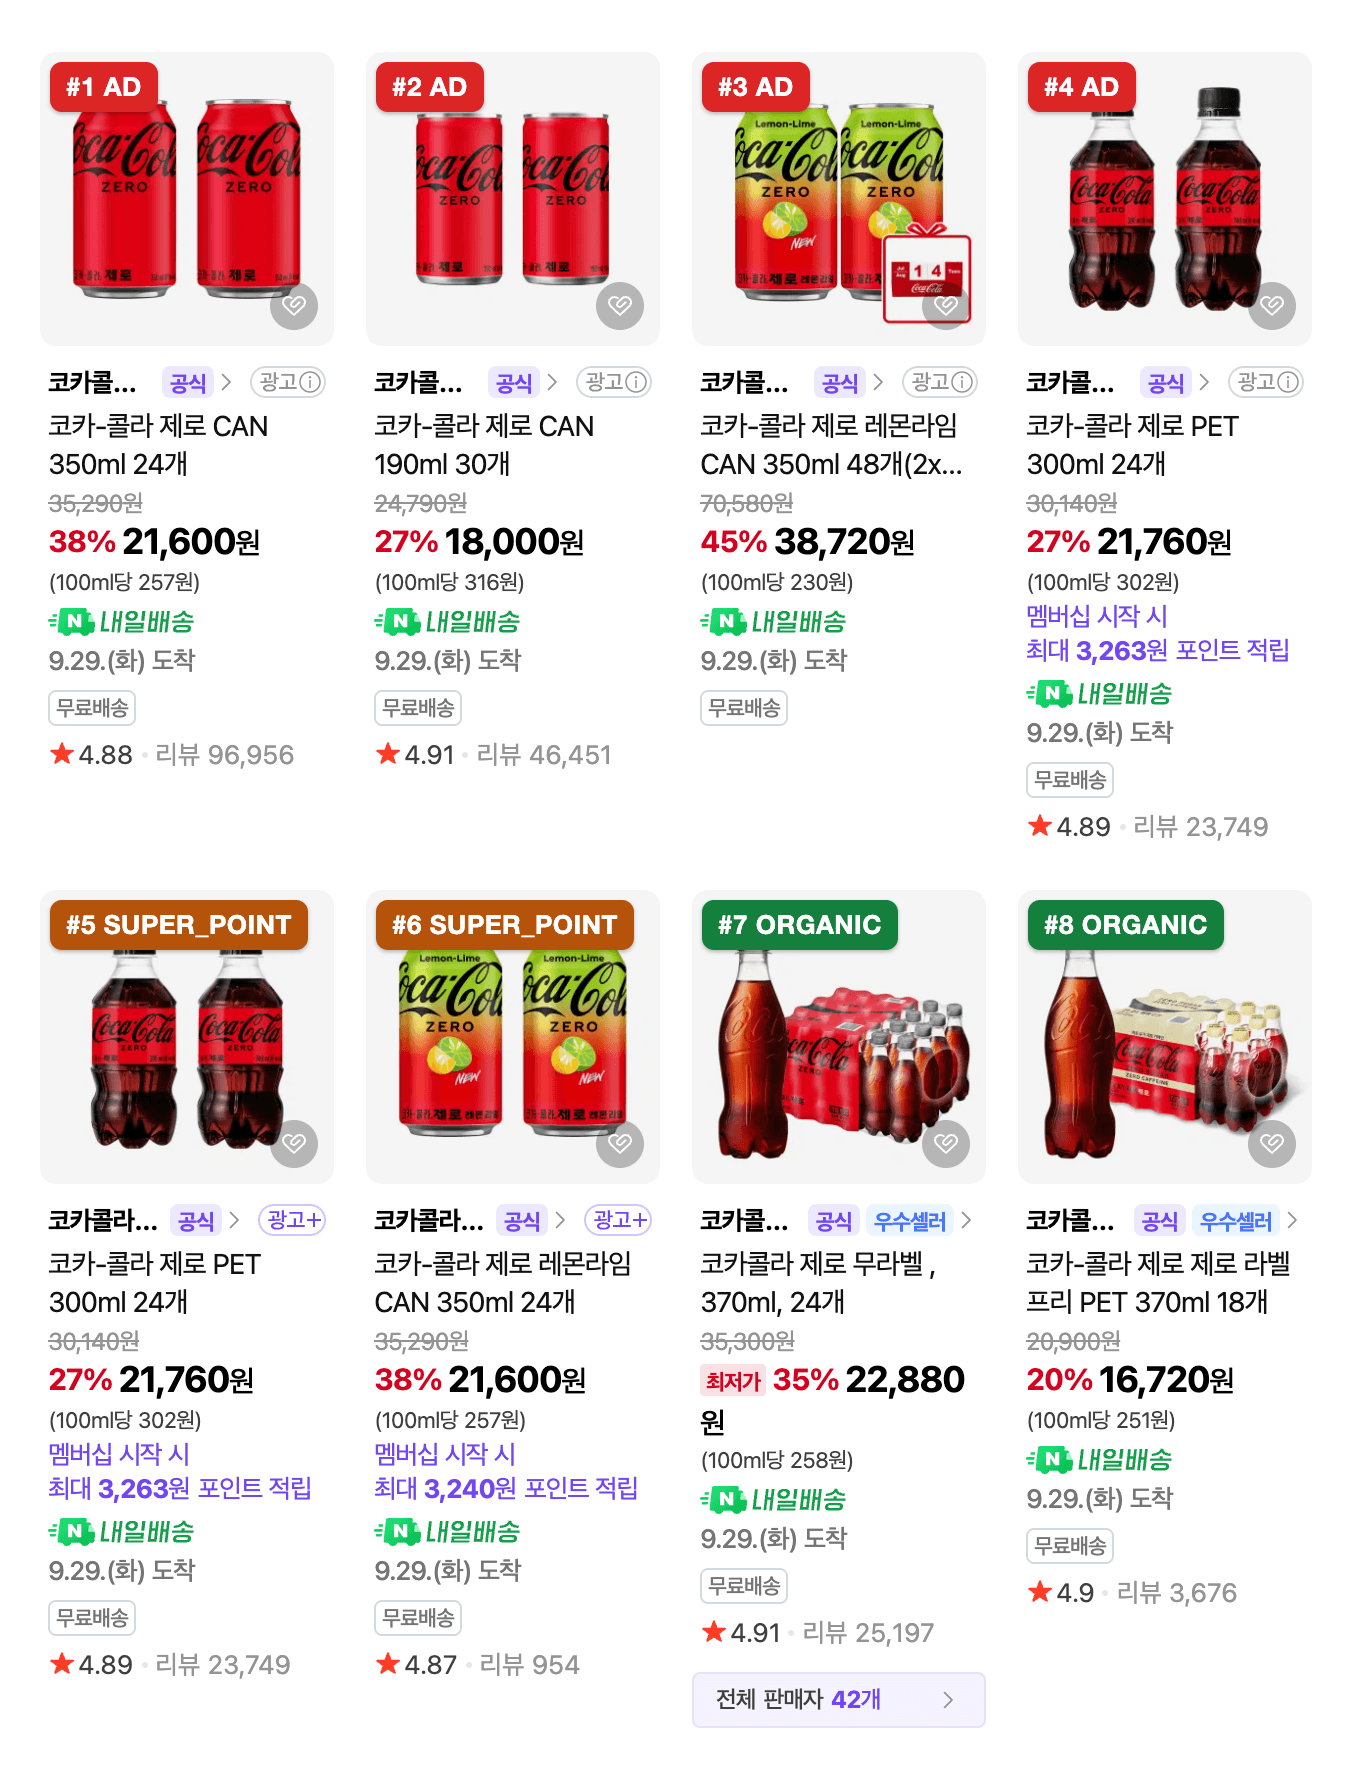
Naver 将第 1 至第 6 名标注为 광고(广告),解析器则将其 type 设置为 AD 或 SUPER_POINT。
为每一行保留 type以便货架份额报告区分广告和促销商品与自然排名商品。将每个商品 URL 中的商品编号用作商品 ID。名称并不是可靠的 ID,因为在该页面上,链接到 Naver 目录的全部 8 个卡片都显示 catalogName而不是存储的 productName。
使用 Browser API 对 Plus Store 搜索结果进行分页
Plus Store 结果第 1 页嵌入在 HTML 中,网站则通过无限滚动加载第 2 页及后续页面。这正是网络解锁器与 Browser API 的区别:网络解锁器返回一个页面,而 Browser API 可以滚动该页面。当购物者滚动时,页面会使用游标请求 /ns/v1/search/paged-composite-cards每次请求都携带 x-wtm-ncaptcha-token 标头。页面会为每次调用生成一个新令牌:
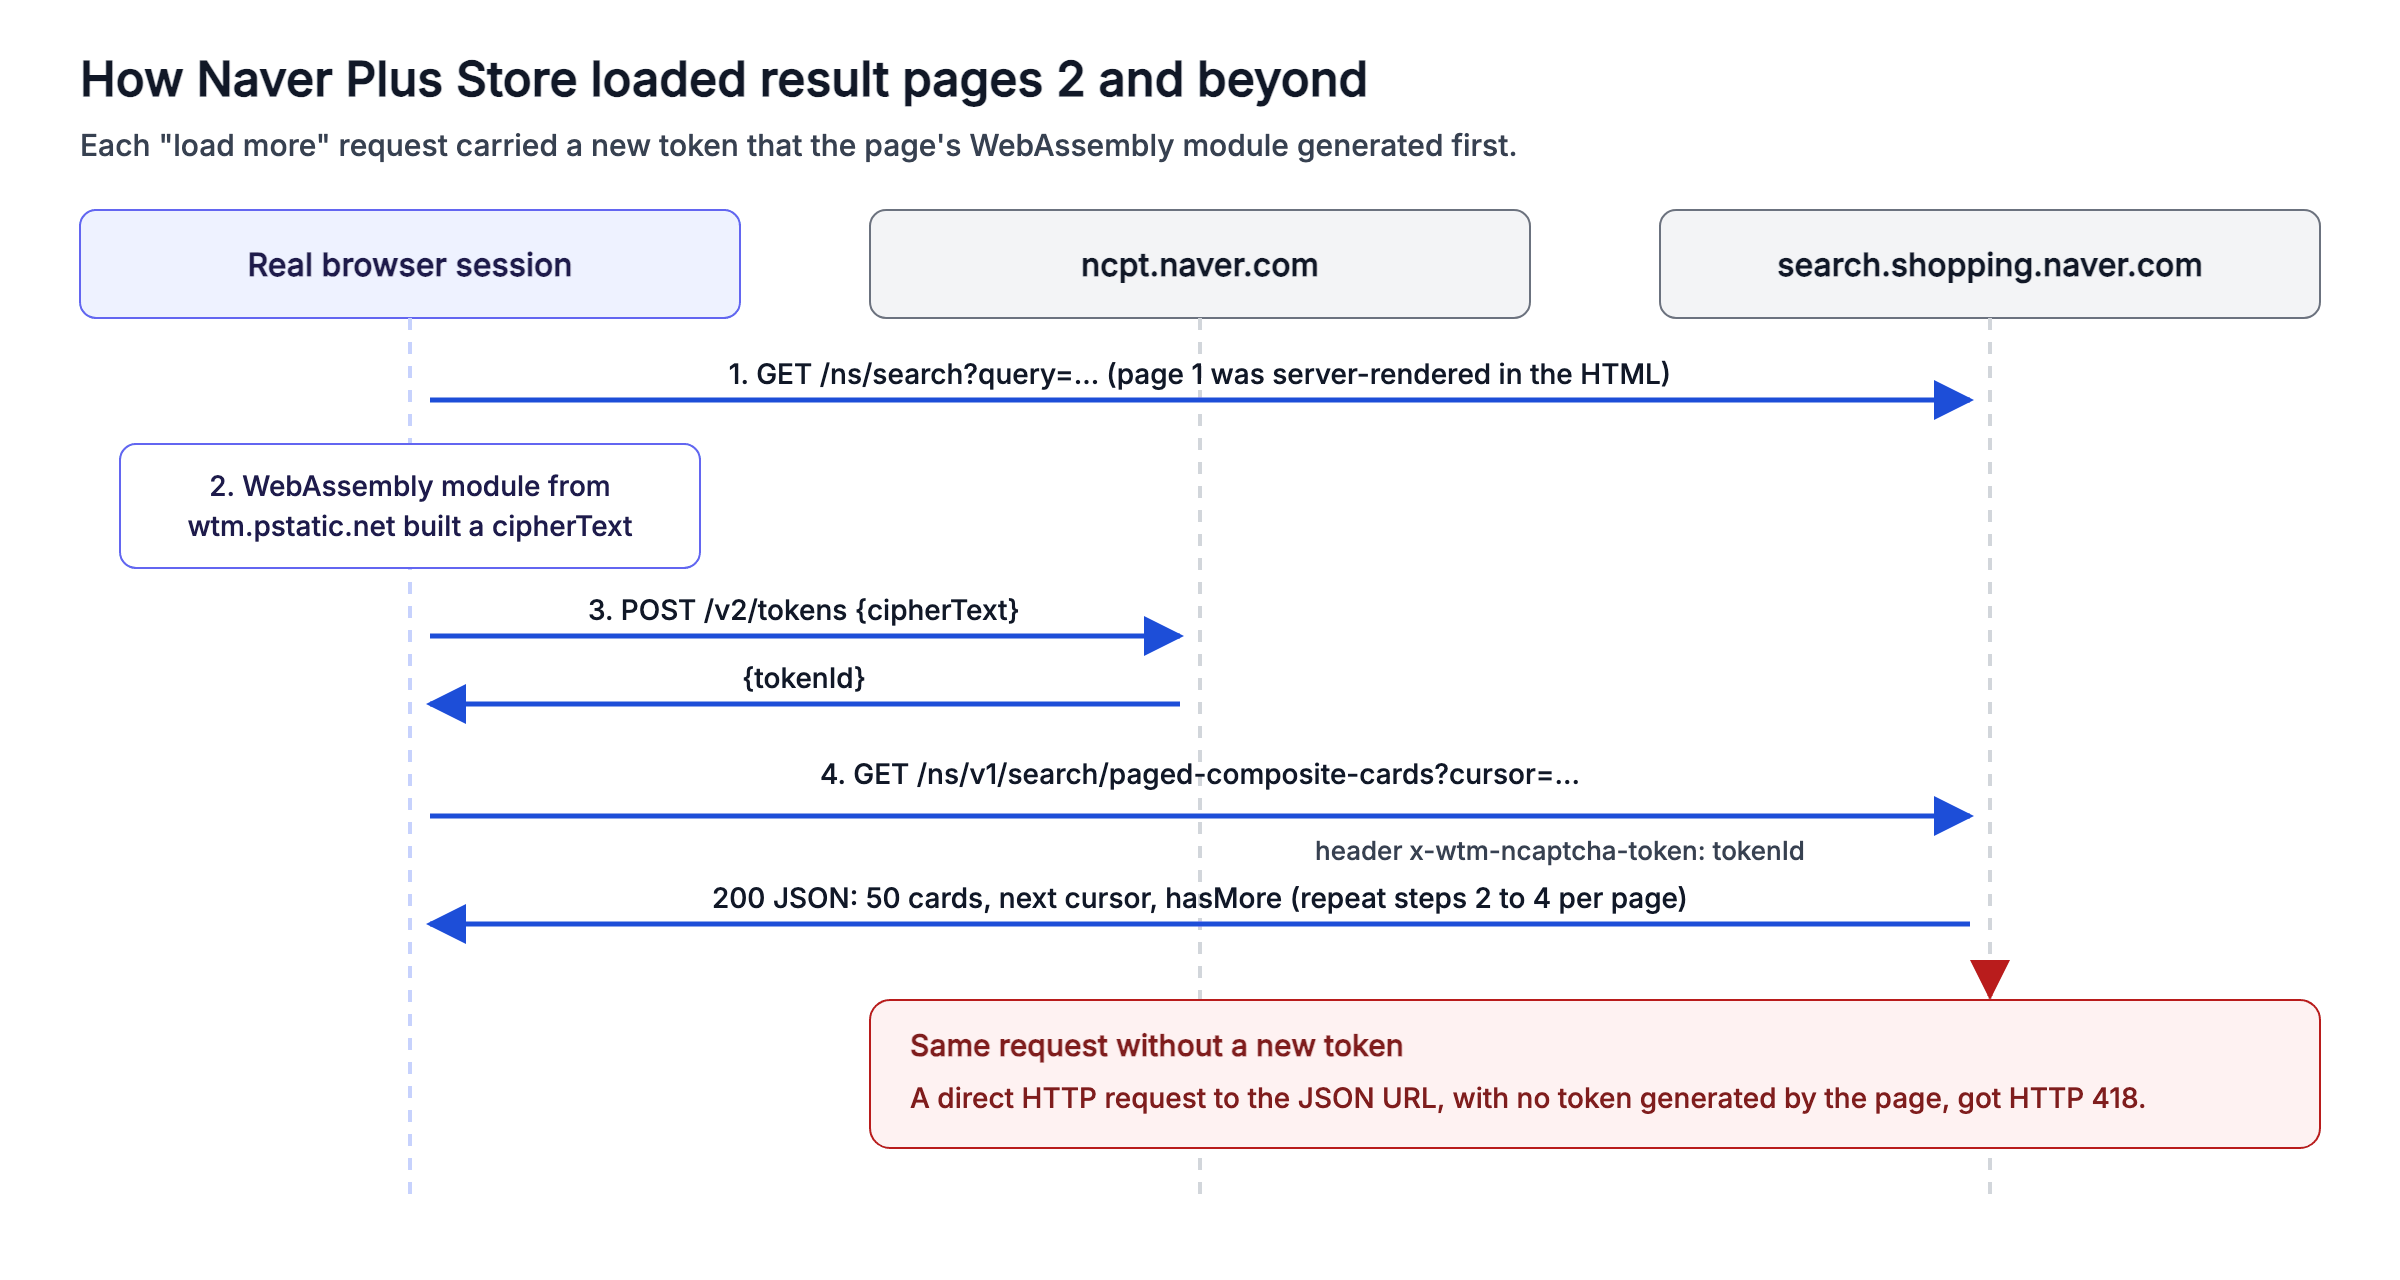
如果不带新令牌直接请求该端点,会收到 HTTP 418。在真实浏览器中运行页面,可让页面自己的脚本生成每个令牌。
Browser API 在 Bright Data 的云端运行 Chrome,并按带宽计费。在该浏览器中,页面自己的 WebAssembly 会生成每个令牌,代码只需读取 JSON 响应。下面的脚本通过 Chrome DevTools Protocol(CDP)连接,以不均匀的步长和停顿进行滚动,并捕获每页结果:
import asyncio
import os
import random
import time
from urllib.parse import quote

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
PAGED_API = "/ns/v1/search/paged-composite-cards"


async def plus_store_pages(query: str, extra_pages: int = 5, budget_s: int = 120) -> list[dict]:
    """Return result pages 2..N as JSON. The page generates each request's token itself."""
    pages = []
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()

        async def on_response(response):
            # The page fetches each new set of cards as JSON while it scrolls
            if PAGED_API in response.url and response.ok:
                pages.append((await response.json())["data"])

        page.on("response", on_response)
        first = await page.goto(f"https://search.shopping.naver.com/ns/search?query={quote(query)}",
                                wait_until="domcontentloaded", timeout=120_000)
        if first.status != 200:
            raise RuntimeError(f"landing page returned {first.status}")
        deadline = time.time() + budget_s
        while len(pages) < extra_pages and time.time() < deadline:
            if pages and not pages[-1]["hasMore"]:
                break
            # Scroll in uneven steps with pauses
            await page.mouse.wheel(0, random.randint(900, 1500))
            await page.wait_for_timeout(random.randint(2500, 4500))
        await browser.close()
    return pages


if __name__ == "__main__":
    result = asyncio.run(plus_store_pages("캠핑의자"))
    for data in result:
        products = [c["card"]["product"] for c in data["data"] if c.get("card", {}).get("product")]
        print(f"page {data['data'][0]['page']}: {len(products)} products, next cursor {data['cursor']}")
对于 캠핑의자(露营椅),该会话采集了第 2 至第 6 页:
page 2: 50 products, next cursor 74
page 3: 50 products, next cursor 112
page 4: 50 products, next cursor 151
page 5: 50 products, next cursor 189
page 6: 50 products, next cursor 239
使用这种滚动模式又运行了 3 个会话,每个会话都采集到了全部 5 个额外页面。调整脚本时请保留不均匀的步长和停顿,使会话符合已测试的模式。
通过比价搜索重建 Shopping API 的字段
在我们测试的页面中,位于 /search/all 的 Naver 比价搜索与已停用的 API 最为相似。其 __NEXT_DATA__ 包含 Shopping 搜索 API 返回的 14 个字段中的 12 个,因此中断的数据流可以保留大部分现有架构:
| Shopping 搜索 API 字段 | 比价搜索字段 |
|---|---|
productId |
id |
title |
productTitle |
link |
对于单一商店商品使用 mallProductUrl;对于目录商品,则使用 Naver 的跟踪链接 crUrl |
image |
imageUrl |
lprice |
lowPrice即目录商品在各商店中的最低价格 |
hprice |
不映射:在检查的每条结果中highPrice 均为空或“0” |
mallName |
mallName目录商品为空,因为由多个商店销售 |
productType |
部分来自 mallCount:大于 0 表示目录商品 |
brand 和 maker |
brand 和 maker |
category1 至 category4 |
category1Name 至 category4Name |
网络解锁器在 10 次测试查询的全部 10 次中都返回了包含结果列表的页面。下面的脚本通过网络解锁器获取页面,最多尝试 3 次,并将每条结果的字段重命名为 API 的字段名:
import json
import os
import re
import time
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S)


def fetch_price_comparison(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/search/all?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # A login page also returns 200, so check for the result list
        if resp.ok and "compositeList" in resp.text:
            return resp.text
        print(f"attempt {attempt} failed: {resp.headers.get('x-brd-error') or 'no result list'}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Price comparison search failed for {query!r}")


def as_api_items(html: str) -> list[dict]:
    """Rename each result's fields to the ones the Shopping search API returned."""
    data = json.loads(NEXT_DATA.search(html).group(1))
    rows = []
    for entry in data["props"]["pageProps"]["compositeList"]["list"]:
        item = entry["item"]
        rows.append({
            "productId": item.get("id"),
            "title": item.get("productTitle"),
            "link": item.get("mallProductUrl") or item.get("crUrl"),  # catalog products have no store URL
            "lprice": item.get("lowPrice"),  # the lowest price across stores for a catalog product
            "mallName": item.get("mallName") or None,
            "mallCount": item.get("mallCount"),  # above 0 marks a price comparison catalog product
            "brand": item.get("brand"),
            "maker": item.get("maker"),
            **{f"category{i}": item.get(f"category{i}Name") for i in range(1, 5)},
            # adId marks an ad, and entry types other than "product" are promoted slots
            "is_ad": bool(item.get("adId")) or entry["type"] != "product",
        })
    return rows


if __name__ == "__main__":
    rows = as_api_items(fetch_price_comparison("코카콜라 제로"))
    first = next(i for i, row in enumerate(rows) if not row["is_ad"])
    print(f"{len(rows)} results, {sum(r['is_ad'] for r in rows)} ads or promoted slots, first organic at rank {first + 1}")
    print(json.dumps({k: v for k, v in rows[first].items() if k != "link"}, ensure_ascii=False))
对于 코카콜라 제로,前 8 条结果都是广告或推广位,第一个自然排名结果是目录商品:
56 results, 16 ads or promoted slots, first organic at rank 9
{"productId": "54166199731", "title": "코카콜라 콜라 , 190ml, 30개", "lprice": 13400, "mallName": null, "mallCount": 8702, "brand": "코카콜라", "maker": "코카콜라", "category1": "식품", "category2": "음료", "category3": "청량/탄산음료", "category4": "콜라", "is_ad": false}
页面 JSON 还会标记广告,而已停用的 API 不返回这一信号,因此在比较新旧排名前,应先根据 is_ad 进行筛选。
使用 Naver Shopping 爬虫工具 API 获取 SmartStore 商品记录
对于商品详情,应请求结构化记录,而不是 HTML。Naver Shopping 抓取工具 API 是 Bright Data 网页爬虫工具 API 的一部分,会针对你发送的每个 URL 运行 SmartStore 爬虫工具。在控制面板中,其按 URL 采集端点接受商品 URL 列表:
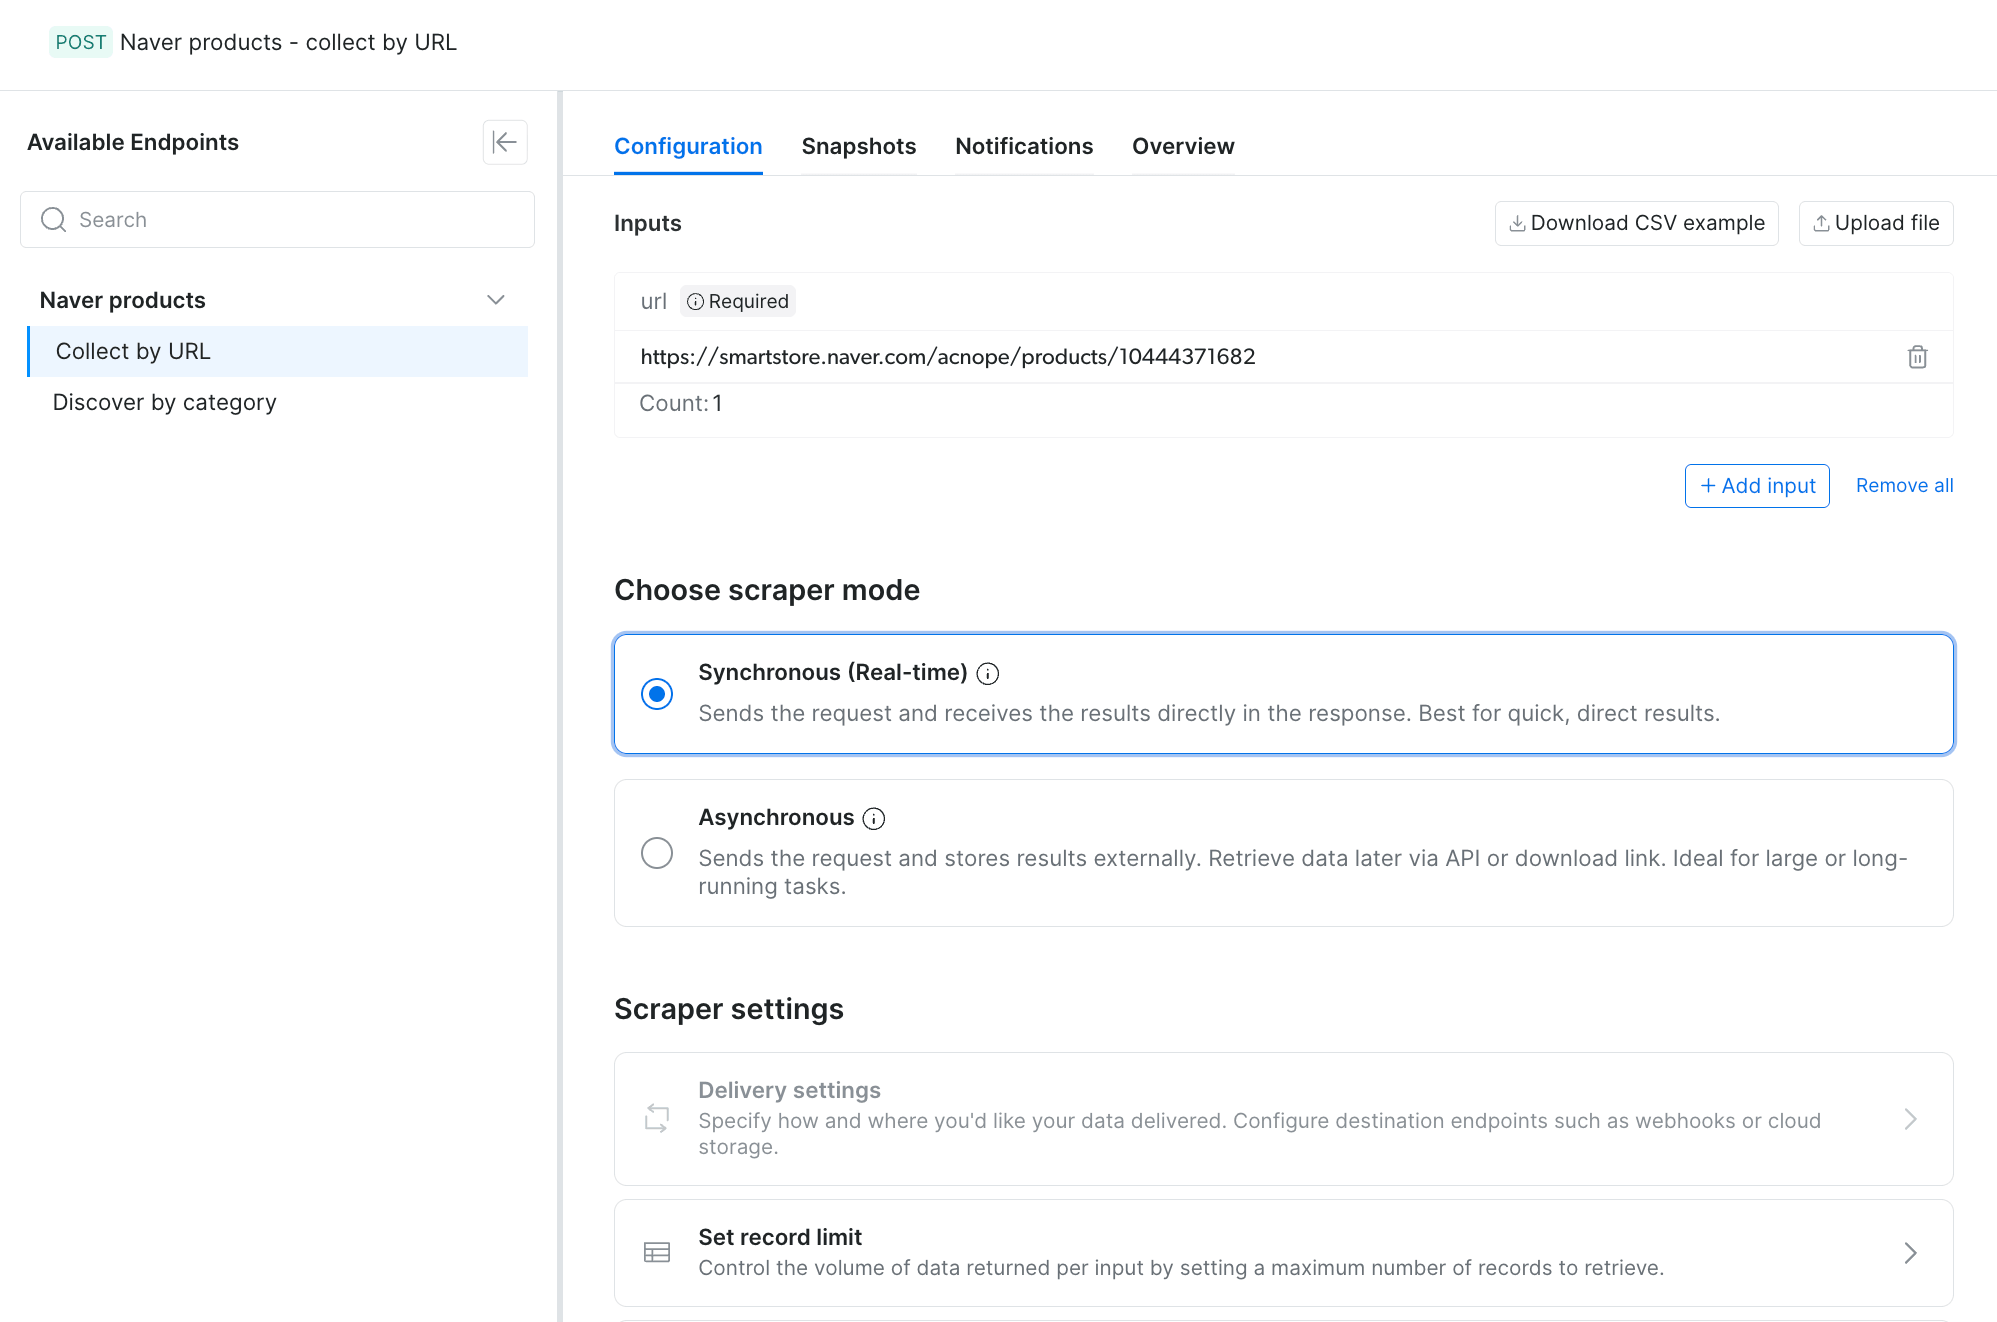
同一端点也可通过 REST API 使用,数据集 ID 为 gd_m9qqjxxr1hab7okefj。
该脚本依赖 API 的 3 项细节。如果任务耗时超过同步超时限制/scrape 端点会返回 HTTP 202 和一个可供轮询的快照 ID。小批量任务使用 /scrape较大的任务则发送至异步 /trigger 端点其文档会给出当前的批量大小限制。此外custom_output_fields 只返回你列出的字段,因此请添加 input、error 和 error_code以了解某个 URL 为何未返回商品。
下面的脚本会发送批次,必要时切换到快照轮询,并验证每条记录:
import json
import os
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
NAVER_PRODUCTS = "gd_m9qqjxxr1hab7okefj"
# custom_output_fields returns only what you list, so include input and the error fields
FIELDS = ("input|error|error_code|url|product_id|title|original_price|final_price"
          "|discount_rate|total_reviews|sold_out|breadcrumbs|timestamp")


def collect_products(urls: list[str]) -> list[dict]:
    params = {"dataset_id": NAVER_PRODUCTS, "format": "json",  # a JSON array instead of the default NDJSON
              "include_errors": "true", "custom_output_fields": FIELDS}
    body = {"input": [{"url": u} for u in urls]}
    resp = requests.post(f"{API}/scrape", params=params, json=body, headers=HEADERS, timeout=180)
    if resp.status_code == 202:  # the job took longer than the synchronous timeout limit
        snapshot_id = resp.json()["snapshot_id"]
        while True:
            status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60).json()["status"]
            if status == "ready":
                break
            if status == "failed":
                raise RuntimeError(f"snapshot {snapshot_id} failed")
            time.sleep(10)
        while True:  # the snapshot endpoint returns 202 until the file is built
            resp = requests.get(f"{API}/snapshot/{snapshot_id}", params={"format": "json"},
                                headers=HEADERS, timeout=120)
            if resp.status_code != 202:
                break
            time.sleep(10)
    resp.raise_for_status()
    records = resp.json()
    # Keep a list shape even if the API returns a single object
    return records if isinstance(records, list) else [records]


def validate(record: dict) -> dict:
    if record.get("error_code"):
        # dead_page means the listing is gone: drop it from the watch list, don't retry
        return {"url": record["input"]["url"], "ok": False, "reason": record["error_code"]}
    list_price = int(record["original_price"]) if record.get("original_price") else None  # int() also accepts the string form
    price = record.get("final_price")
    ok = isinstance(price, int) and price > 0 and (list_price is None or price <= list_price)
    return {"product_id": record.get("product_id"), "ok": ok, "price": price, "list_price": list_price,
            "reviews": record.get("total_reviews"), "title": (record.get("title") or "")[:40]}


if __name__ == "__main__":
    urls = json.load(open(sys.argv[1])) if len(sys.argv) > 1 else [
        "https://smartstore.naver.com/acnope/products/10444371682"]
    records = collect_products(urls)
    print(f"{len(records)} records")
    for row in map(validate, records):
        print(json.dumps(row, ensure_ascii=False))
一批 10 个 SmartStore URL 返回了全部 7 个公开商品的记录,并使用错误代码标记了另外 3 个:
10 records
{"url": "https://smartstore.naver.com/bestymall/products/9824862314", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/wonliveshopm/products/12177447319", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/dajunemall/products/12725077707", "ok": false, "reason": "wait_element_timeout"}
{"product_id": "11219337734", "ok": true, "price": 16890, "list_price": null, "reviews": null, "title": "TROLLI 트롤리 올인원 젤리 1kg  사우어 구미캔디"}
{"product_id": "11499596414", "ok": true, "price": 615340, "list_price": null, "reviews": null, "title": "LG전자 2도어 344L 몽블랑 네이처 (M344MB14) 2도어 냉장고"}
{"product_id": "12465433420", "ok": true, "price": 17900, "list_price": 35000, "reviews": 41, "title": "[국산 100%] 꿈에그린X알파플러스 KF94 새부리형 마스크 100매("}
{"product_id": "12332341407", "ok": true, "price": 299000, "list_price": 608000, "reviews": 12, "title": "마이크로소프트  MS office 2024 Home & Business "}
{"product_id": "12385071329", "ok": true, "price": 277000, "list_price": null, "reviews": null, "title": "-ku- 일렉트로룩스 WELL Q8 무선스틱청소기 WQ81-3OMBF"}
{"product_id": "5494837526", "ok": true, "price": 31490, "list_price": null, "reviews": 1, "title": "로슈 아큐첵 인스턴트 혈당계+시험지50매"}
{"product_id": "9280411528", "ok": true, "price": 32200, "list_price": 32250, "reviews": 33, "title": "오딧세이 남성2종 로맨틱 레드 스페셜세트+아이오페 포케터블 토트백 증 정"}
每个价格、评论数和标记都与通过网络解锁器获取的同一商品页面一致。3 个被标记的 URL 中,2 个是已删除商品,1 个是需要 Naver 授权检查的商品。每次运行后,从监测列表中移除 dead_page URL。通过网络解锁器获取其他任何被标记的 URL,并使用 smartstore_product 解析各页面。
批次中的每个 URL 都以商店 URL 开头,例如脚本中的默认 smartstore.naver.com/acnope/products/10444371682。如需从 Plus Store 卡片构建 URL,请从 mallUrl.pcUrl 的 url 参数中读取商店 URL,并附加 /products/<channelProductId>。
将记录加载到数据仓库之前,请检查数据契约:
- 在 Naver 商品数据集的 930 条记录样本和实时记录中
original_price均为字符串,而final_price均为整数。比较它们之前,应像validate那样将二者都转换为整数。 - 在这一批次中,空的
original_price表示没有折扣,空的total_reviews表示尚无评论。 total_reviews与商品页面上的评论数一致,脚本默认 URL 的值为 19,581。该数量属于整个商品组,页面状态中还包含单件商品的评论数 15,422。- 在这一批次中
product_id与每个输入 URL 中的商品编号一致,因此可以用它将记录与 Plus Store 结果关联。 custom_output_fields控制你存储哪些字段,因此只保留要监测的字段,不要存储卖家的个人详细信息。
如果需要历史数据或批量覆盖,而不是实时采集,可以获取按记录计费的 Naver 商品数据集。需要价格和促销洞察而不是原始记录的团队,可以使用 Naver Shopping Price Tracker。
Bright Data 还提供专用于 SmartStore 评论、Naver Shopping 评论和 Naver Hotels 的抓取工具。
比较不同 Naver 页面类型所用的工具和成本
Naver 价格和数字货架监测中的每项任务都对应一种 Bright Data 产品:
| 任务 | Bright Data 产品 | 测试结果 | 计费方式 |
|---|---|---|---|
| 获取某个关键词在 Naver 搜索中的购物结果 | 使用原始 HTML 的搜索引擎 API | 10 次查询中成功 10 次 | 按成功请求计费(搜索引擎 API 定价) |
| Plus Store 结果第 1 页,50 个卡片 | 网络解锁器 | 10 次查询中成功 10 次 | 按成功请求计费(网络解锁器定价) |
| Plus Store 第 2 页及后续页面 | Browser API | 4 个会话均通过滚动停顿获取了 5 个额外页面中的全部 5 个 | 按 GB 带宽计费(Browser API 定价) |
| 从比价搜索获取某个关键词的 Shopping API 字段 | 网络解锁器 | 10 次查询中成功 10 次 | 按成功请求计费 |
| 获取已知商品 URL 的完整记录 | Naver Shopping 爬虫工具 API | 7 个公开商品中的全部 7 个,价格和评论均与各页面一致 | 按记录计费(网页爬虫工具 API 定价) |
| 历史或批量商品数据 | Naver 商品数据集 | 930 条记录样本中的价格字段类型与实时记录一致 | 按记录计费(数据集定价) |
通过网络解锁器获取一个 Plus Store 结果页面按 1 次请求计费。Naver Shopping 抓取工具 API 按记录计费,因此成本会随发送的商品 URL 数量增加。在我们的测试中,一个加载了 5 个额外页面、每页 50 件商品的 Browser API 会话使用了约 18 MB。将这些用量乘以各定价页面上的当前费率,即可估算预算。
使用搜索页面发现商品并跟踪其搜索排名。然后将要监测的 URL 发送到 Naver Shopping 爬虫工具 API,这样你只需为实际跟踪的商品记录付费。
总结
Naver 的购物和商品页面会拦截普通 HTTP 客户端,但其比价搜索仍包含已停用 API 的大多数字段。应读取嵌入式 JSON 并检查其内容,而不是只检查状态码,因为 Naver 的登录重定向和已删除商品都会以普通页面形式返回。
使用搜索引擎 API 和网络解锁器发现商品,使用 Browser API 处理分页,并使用 Naver Shopping 抓取工具 API 获取结构化商品记录。实时采集可显示当前价格和排名,而 Naver 商品数据集则提供历史或批量商品数据。首先对你最常监测的 5 个关键词运行比价脚本,并将结果行加载到现有的数据流表中。
常见问题
Naver 现在还有购物 API 吗?
Naver 已于 2026 年 7 月 31 日终止其 Shopping 搜索 API,NAVER API HUB 上也没有替代方案。一个类似的替代选项是比价搜索,其嵌入数据包含该 API 的大多数字段,包括最低价格、品牌和分类。Bright Data 的网络解锁器在 10 次查询中的全部 10 次都成功返回了这些数据。
为什么 Naver Shopping 会返回 418 错误?
HTTP 418 是 Naver Shopping 在访问暂时受限时显示的拦截页面。它列出了 4 个触发因素:来自与购物无关的外部推广活动的访问、来自单个 IP 的突发请求、VPN IP,以及某些浏览器扩展程序。Python 的 requests 和无头 Chrome 都会收到该错误,而 Bright Data 的网络解锁器可以获得结果。
可以从韩国以外地区爬虫 Naver 吗?
可以,但购物页面需要使用解锁工具。从印度访问时,普通 HTTP 客户端可以从 Naver 搜索获得完整页面,但 Naver Shopping 会返回拦截页面、CAPTCHA 或登录重定向。Bright Data 的网络解锁器在当地成功返回了 10 个 Plus Store 页面中的全部 10 个。请使用韩国 IP,因为 Naver 会记录每个请求者所在的国家/地区。
如何使用 Python 爬虫 Naver?
获取页面,然后解析嵌入 HTML 中的 JSON,而不是使用 CSS 选择器。搜索页面将购物数据存储在 _INITIAL_STATE 对象中,SmartStore 则使用 window.__PRELOADED_STATE__。Naver Shopping 会拦截 Python HTTP 客户端,因此应通过 Bright Data 的网络解锁器路由这些请求。
爬虫 Naver 需要多少成本?
Bright Data 的搜索引擎 API 和网络解锁器按成功请求计费,Naver Shopping 抓取工具 API 按记录计费,Browser API 按 GB 计费。在我们的测试中,一个结果页面计为 1 次请求,通过 Browser API 获取 5 个额外页面使用了约 18 MB。当前费率请参阅定价页面。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。