在这篇博客文章中,你将了解:
- Workato 是什么,以及它作为低代码自动化平台提供哪些功能。
- 为什么访问高质量的结构化网页数据有助于提升自动化工作流。
- 如何构建 Workato 配方,以处理通过 Bright Data API 以编程方式检索的网页数据。
让我们开始吧!
什么是 Workato?
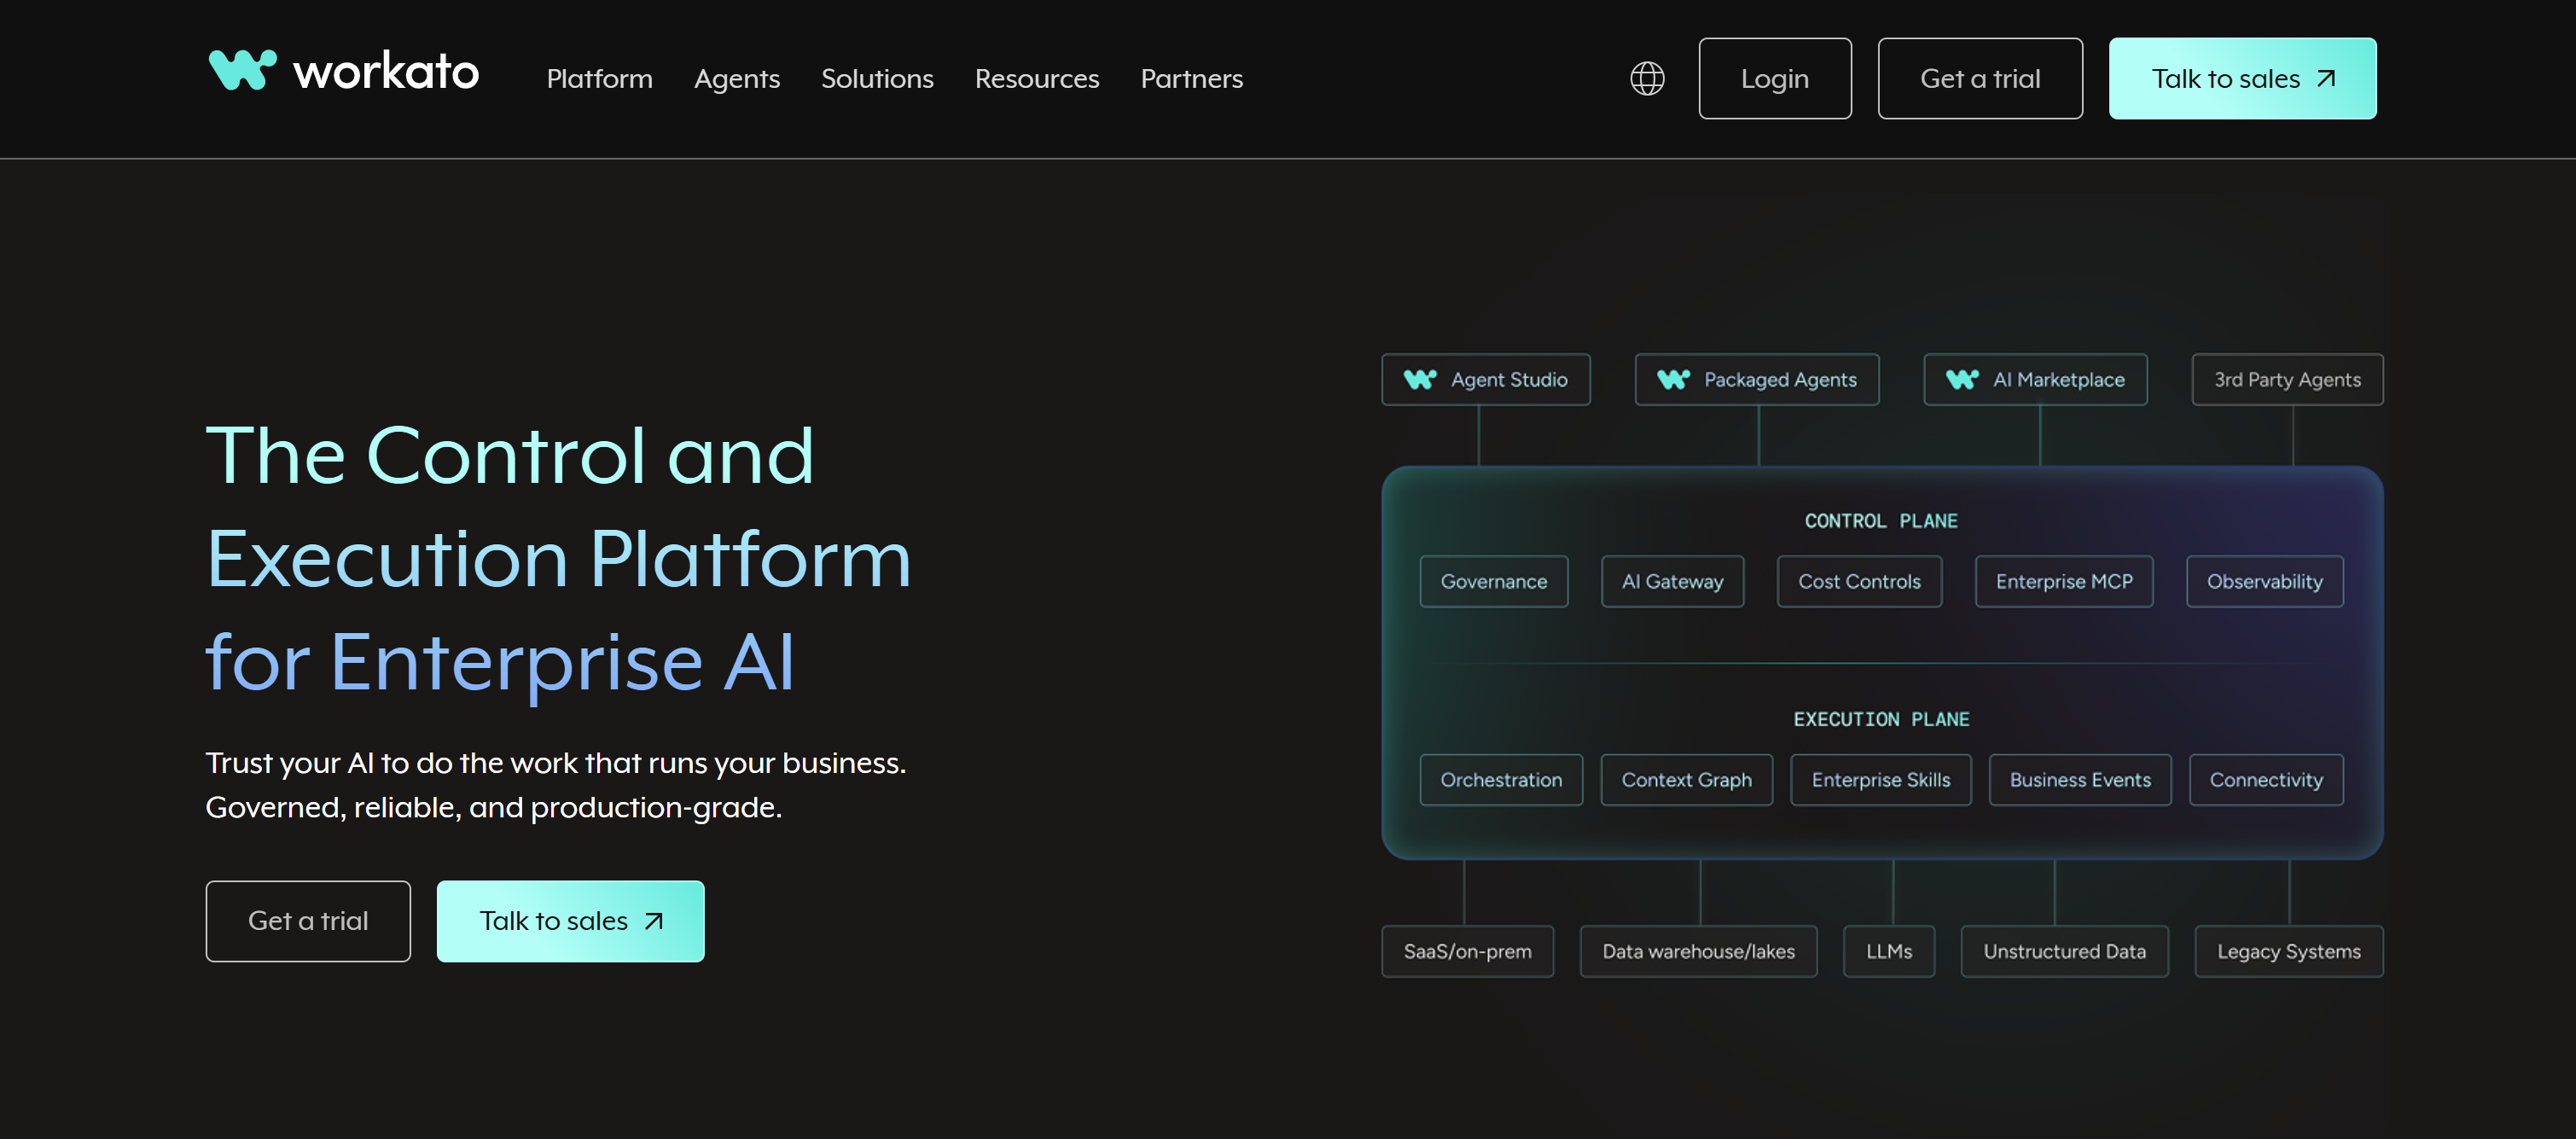
Workato 是一个基于云的低代码自动化与集成平台。它可以连接应用程序、同步数据,并使用低代码工具编排业务工作流。它能帮助你实现流程自动化,并在数千个应用程序和系统中集成 AI 智能体。
Workato 支持的主要功能包括:
- 配方:通过触发器和操作定义自动化流程的可视化工作流。它们可以连接应用程序、转换数据并执行业务逻辑,无需进行大量定制开发。
- 连接器:预构建的集成,可将 Workato 与热门 SaaS 应用程序、企业系统、数据库、API 及其他业务工具连接起来,从而简化数据交换。
- 低代码/无代码自动化:通过拖放式界面,团队无需编写传统代码即可构建和修改工作流,从而缩短开发时间并减少对工程资源的依赖。
- AI 智能体编排:用于设计、部署和治理 AI 智能体的工具,这些智能体可以与企业系统交互、遵循业务规则并执行自动化流程。
- 企业治理与安全:提供访问管理、审计日志、数据保护、监控和策略执行等控制措施,确保大规模自动化可靠运行。
为什么要在 Workato 配方中集成网页数据
Workato 支持与你的企业技术栈中的第三方 SaaS 应用程序和服务进行集成。然而,仅依靠内部数据通常不足以生成完整、准确的洞察。
网页数据可以提供有关当前市场动态的外部背景信息。这类具有上下文的实时信息对于改善决策至关重要,尤其是在业务场景中。
构建 AI 驱动的自动化时,在线数据更加重要。LLM 基于静态数据集进行训练无法获取最新事件、动态或业务信号。如果缺少实时数据,其输出可能涉及过时知识,并可能导致不准确的洞察。
问题在于,由于存在速率限制、反机器人系统、CAPTCHA 和指纹分析大规模采集网页数据颇具挑战。这正是 Bright Data 的用武之地!
Bright Data API:解决方案
Bright Data 是领先的网页数据提供商,通过 API 支持大规模采集、提取和处理公共网页数据。所有这些 API 均可集成到 Workato 配方中,利用结构化、可验证且及时更新的网页数据为自动化工作流提供支持。
Bright Data 的主要 API 包括:
- 网页爬虫工具 API:从 Amazon、LinkedIn 以及其他 40 多个受支持的网站域名中提取结构化数据集。
- 网络解锁器 API:以 HTML 或 Markdown 格式检索网页内容,同时自动处理反机器人系统和访问挑战。
- 搜索引擎 API:从 Google、Bing、Yandex 和其他搜索平台采集结构化搜索引擎结果,用于研究和自动化工作流。
- 浏览器 API:运行自动化浏览器会话,与动态网站和基于 JavaScript 的应用程序进行交互。
注意:每个新的 Bright Data 账户每月都可以在网络解锁器 API、搜索引擎 API 和网页爬虫工具 API 中享受5,000 次免费请求。
Bright Data 的独特优势在于其企业级基础设施,该基础设施由覆盖 195 个国家/地区、拥有超过 4 亿个 IP 的代理网络提供支持。它支持无限扩展和并发,同时实现 99.99% 的正常运行时间和 99.95% 的成功率。
与 Workato 结合后Bright Data 可帮助企业构建稳健的工作流。继续了解具体方法!
如何在 Workato 配方中使用 Bright Data 爬虫 API
在这个分步章节中,你将学习如何设置一个真实场景下由 AI 驱动的 Workato 配方。具体而言,该工作流将自动:
- 使用 Bright Data 检索近期的 Glassdoor 评价。
- 使用 OpenAI 对其进行分析。
- 将结构化 HTML 报告直接发送到你的收件箱。
此配方适用于竞争对手监控、市场研究和员工反馈分析。
注意:这只是一个构建示例。Bright Data API 支持许多其他用例让你可以为网页搜索、潜在客户开发、评价监控、数据扩充等场景创建工作流。
请按照以下说明操作!
前提条件
请确保你拥有:
- 一个 Workato 账户(免费试用账户即可)。
- 一个已配置 API 密钥的 Bright Data 账户。请参阅有关设置 Bright Data API 密钥的官方指南。
- 一个 OpenAI API 密钥。
虽然并非硬性要求,但基本了解 Bright Data 爬虫 API 的工作方式也会有所帮助。
第 1 步:初始化 Workato 配方
登录你的 Workato 账户并创建一个新项目(例如“网页数据工作流”)。打开该项目,然后选择“创建 > 配方”来创建新的 Workato 配方:
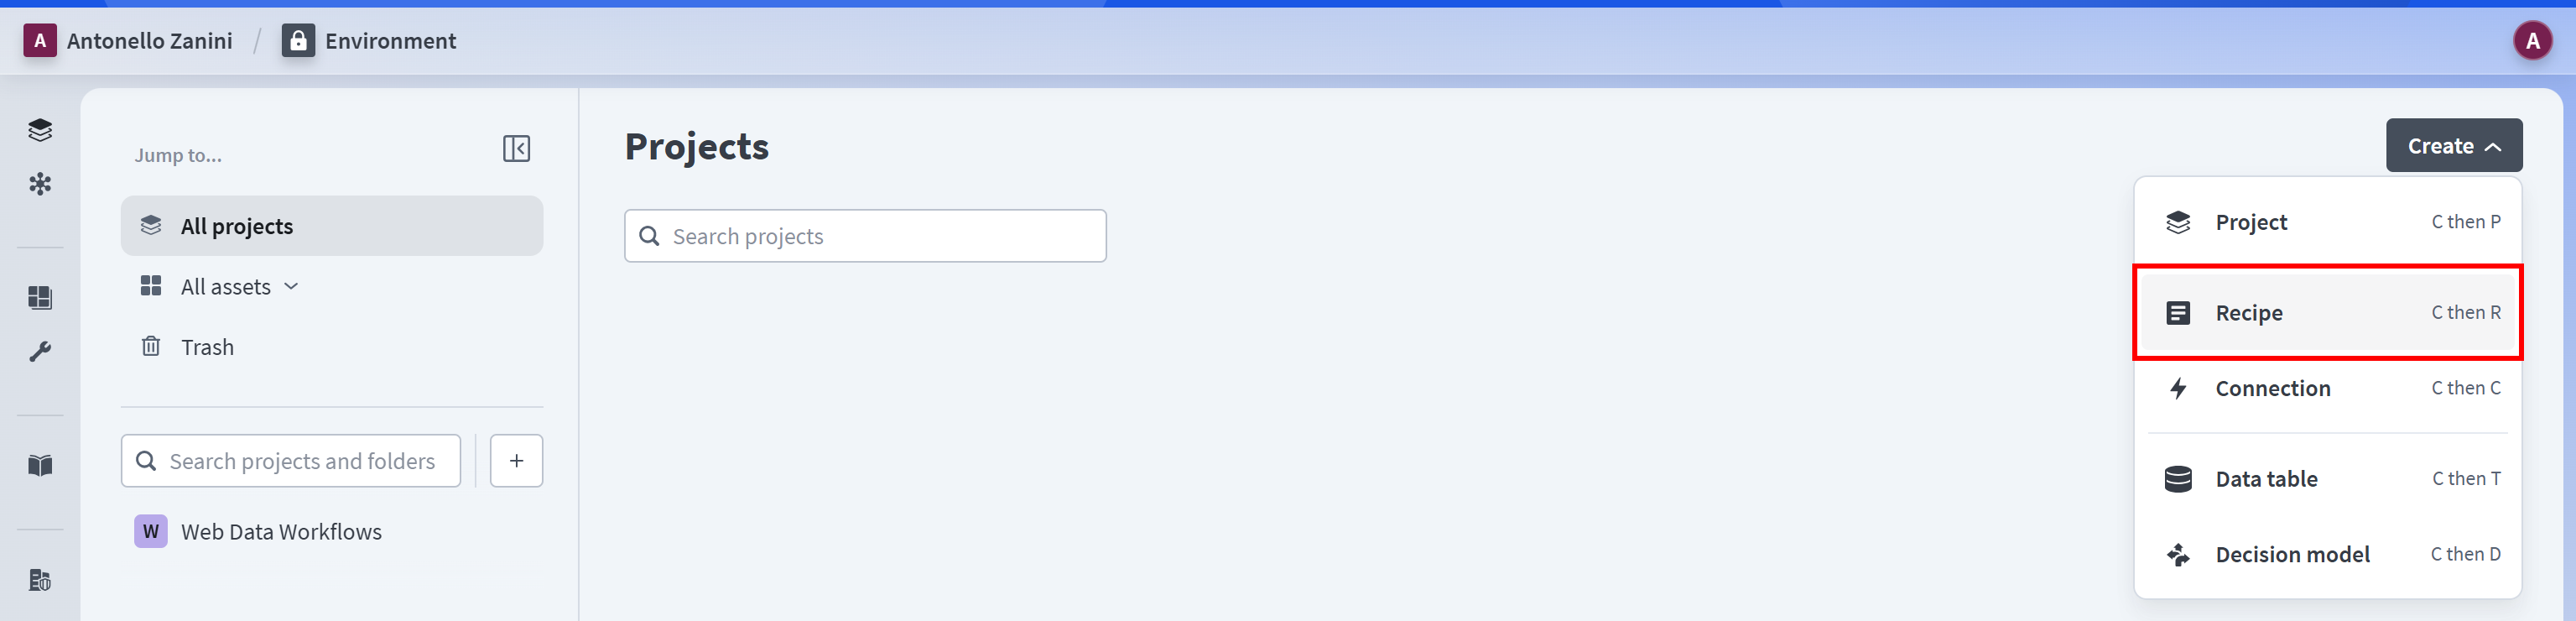 如果你是 Workato 新用户配方是一种自动化工作流,通过一个触发器和一系列操作连接不同应用程序。触发器决定工作流何时启动,而操作则定义之后执行的任务。
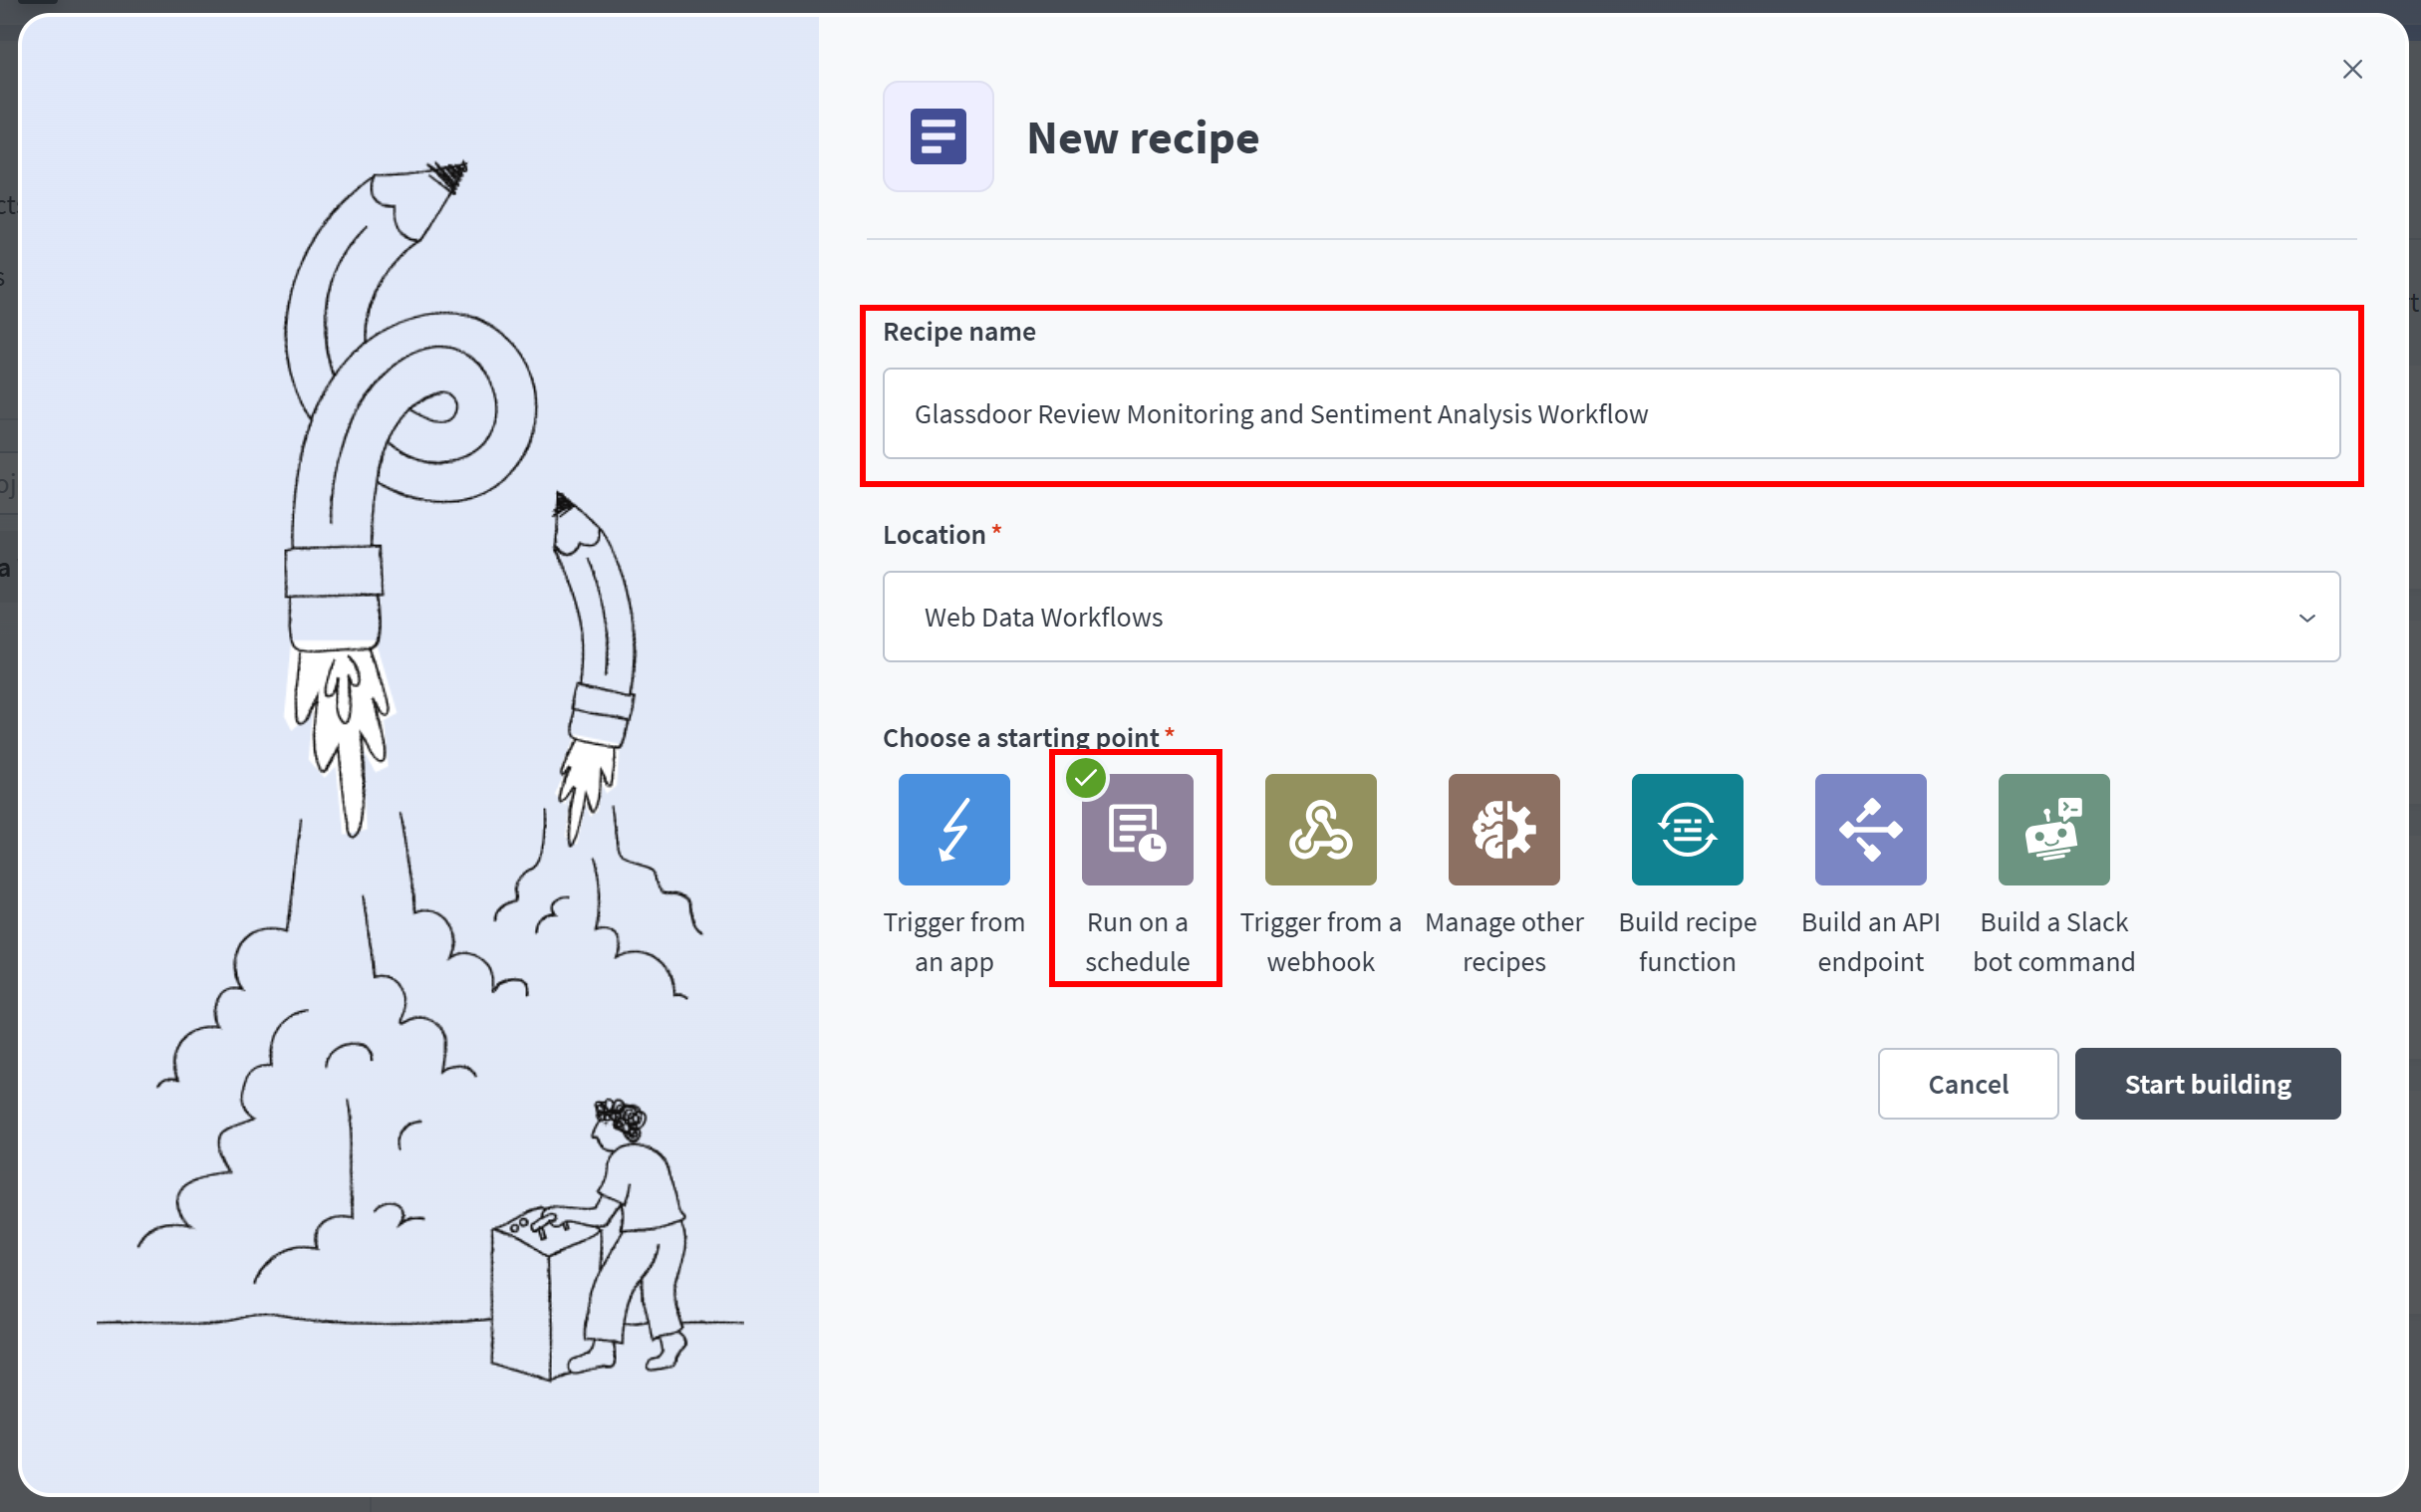
为配方命名(例如“Glassdoor 评价监控和情感分析工作流”),然后选择“按计划运行”作为起点:
你将被重定向到可视化配方编辑器:
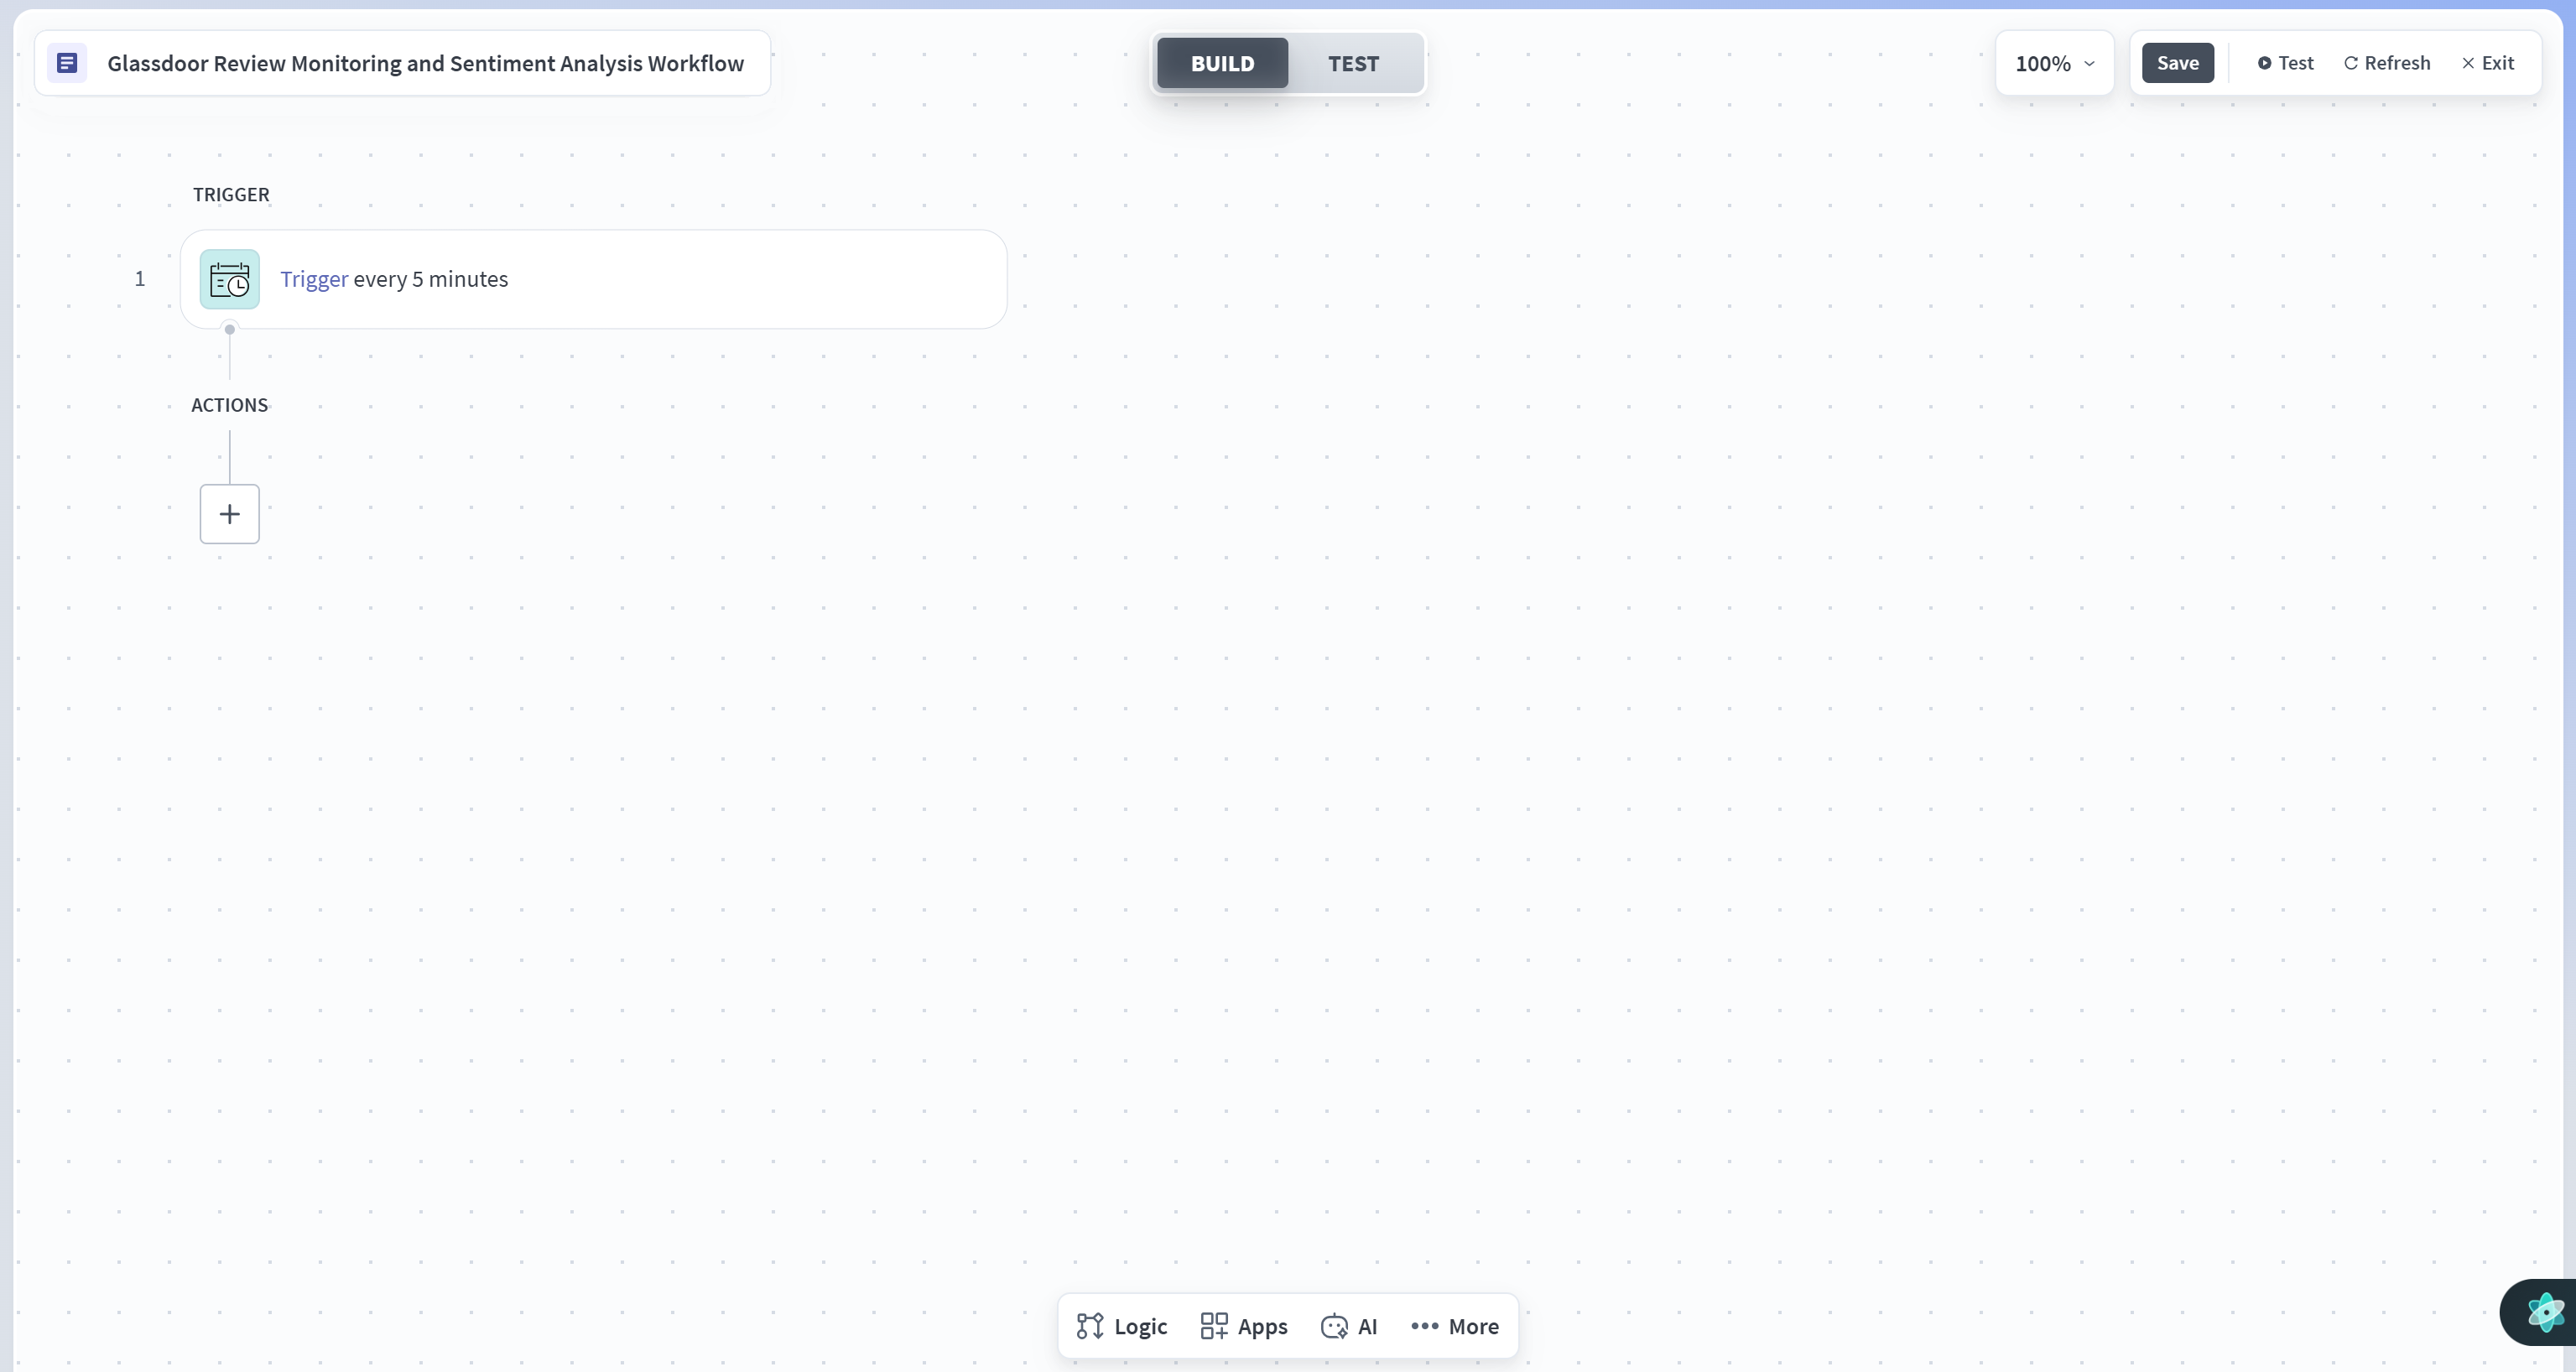
请注意,该配方已经包含一个定时触发器。这意味着工作流将按固定时间间隔定期运行,无需人工干预。
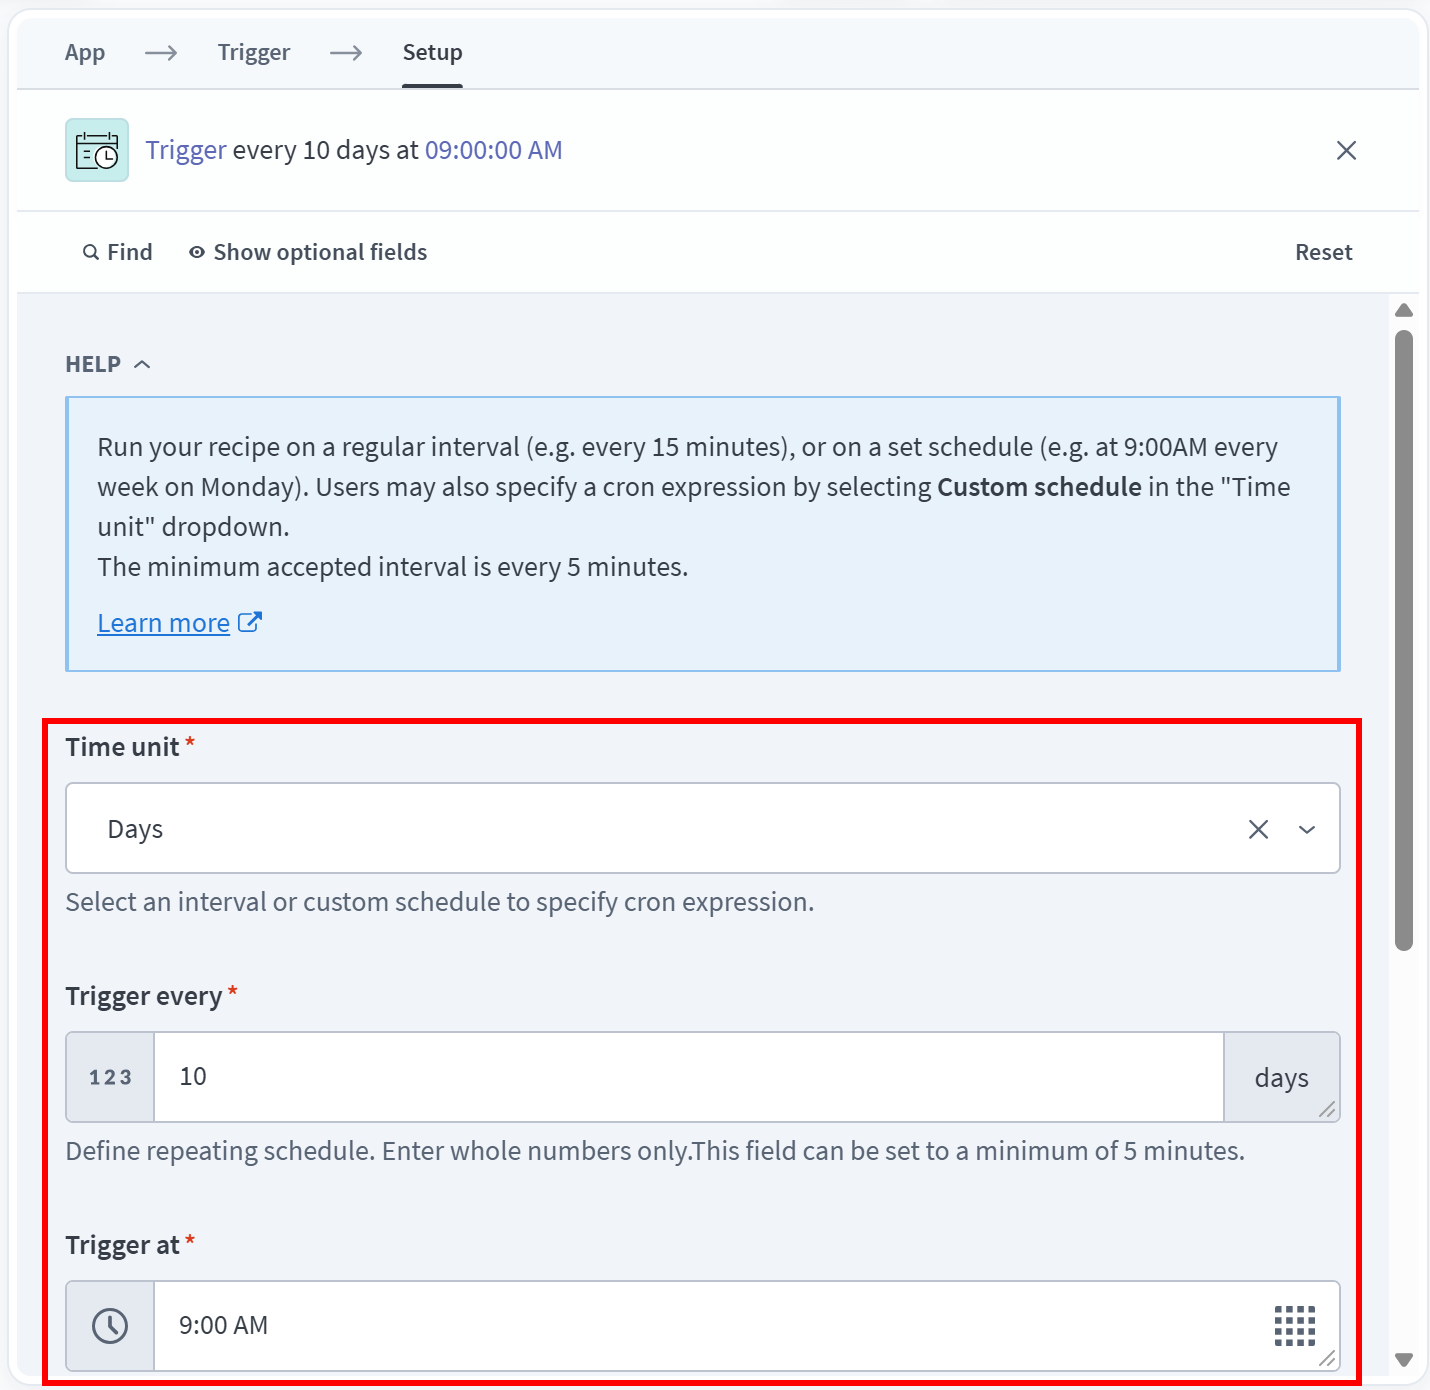
要配置工作流的触发时间,请单击“触发器”步骤并调整计划设置。例如,你可以将其设置为每 10 天上午 9:00 运行一次:
做得好!你的新 Workato 配方已完成初始化。
第 2 步:熟悉 Bright Data Glassdoor 评价抓取工具 API
Bright Data Glassdoor 评价抓取工具是检索 Glassdoor 评价数据的理想网页爬虫工具 API 端点。将其集成到 Workato 配方之前,有必要先了解该 API 的工作方式,包括其端点、输入和输出。
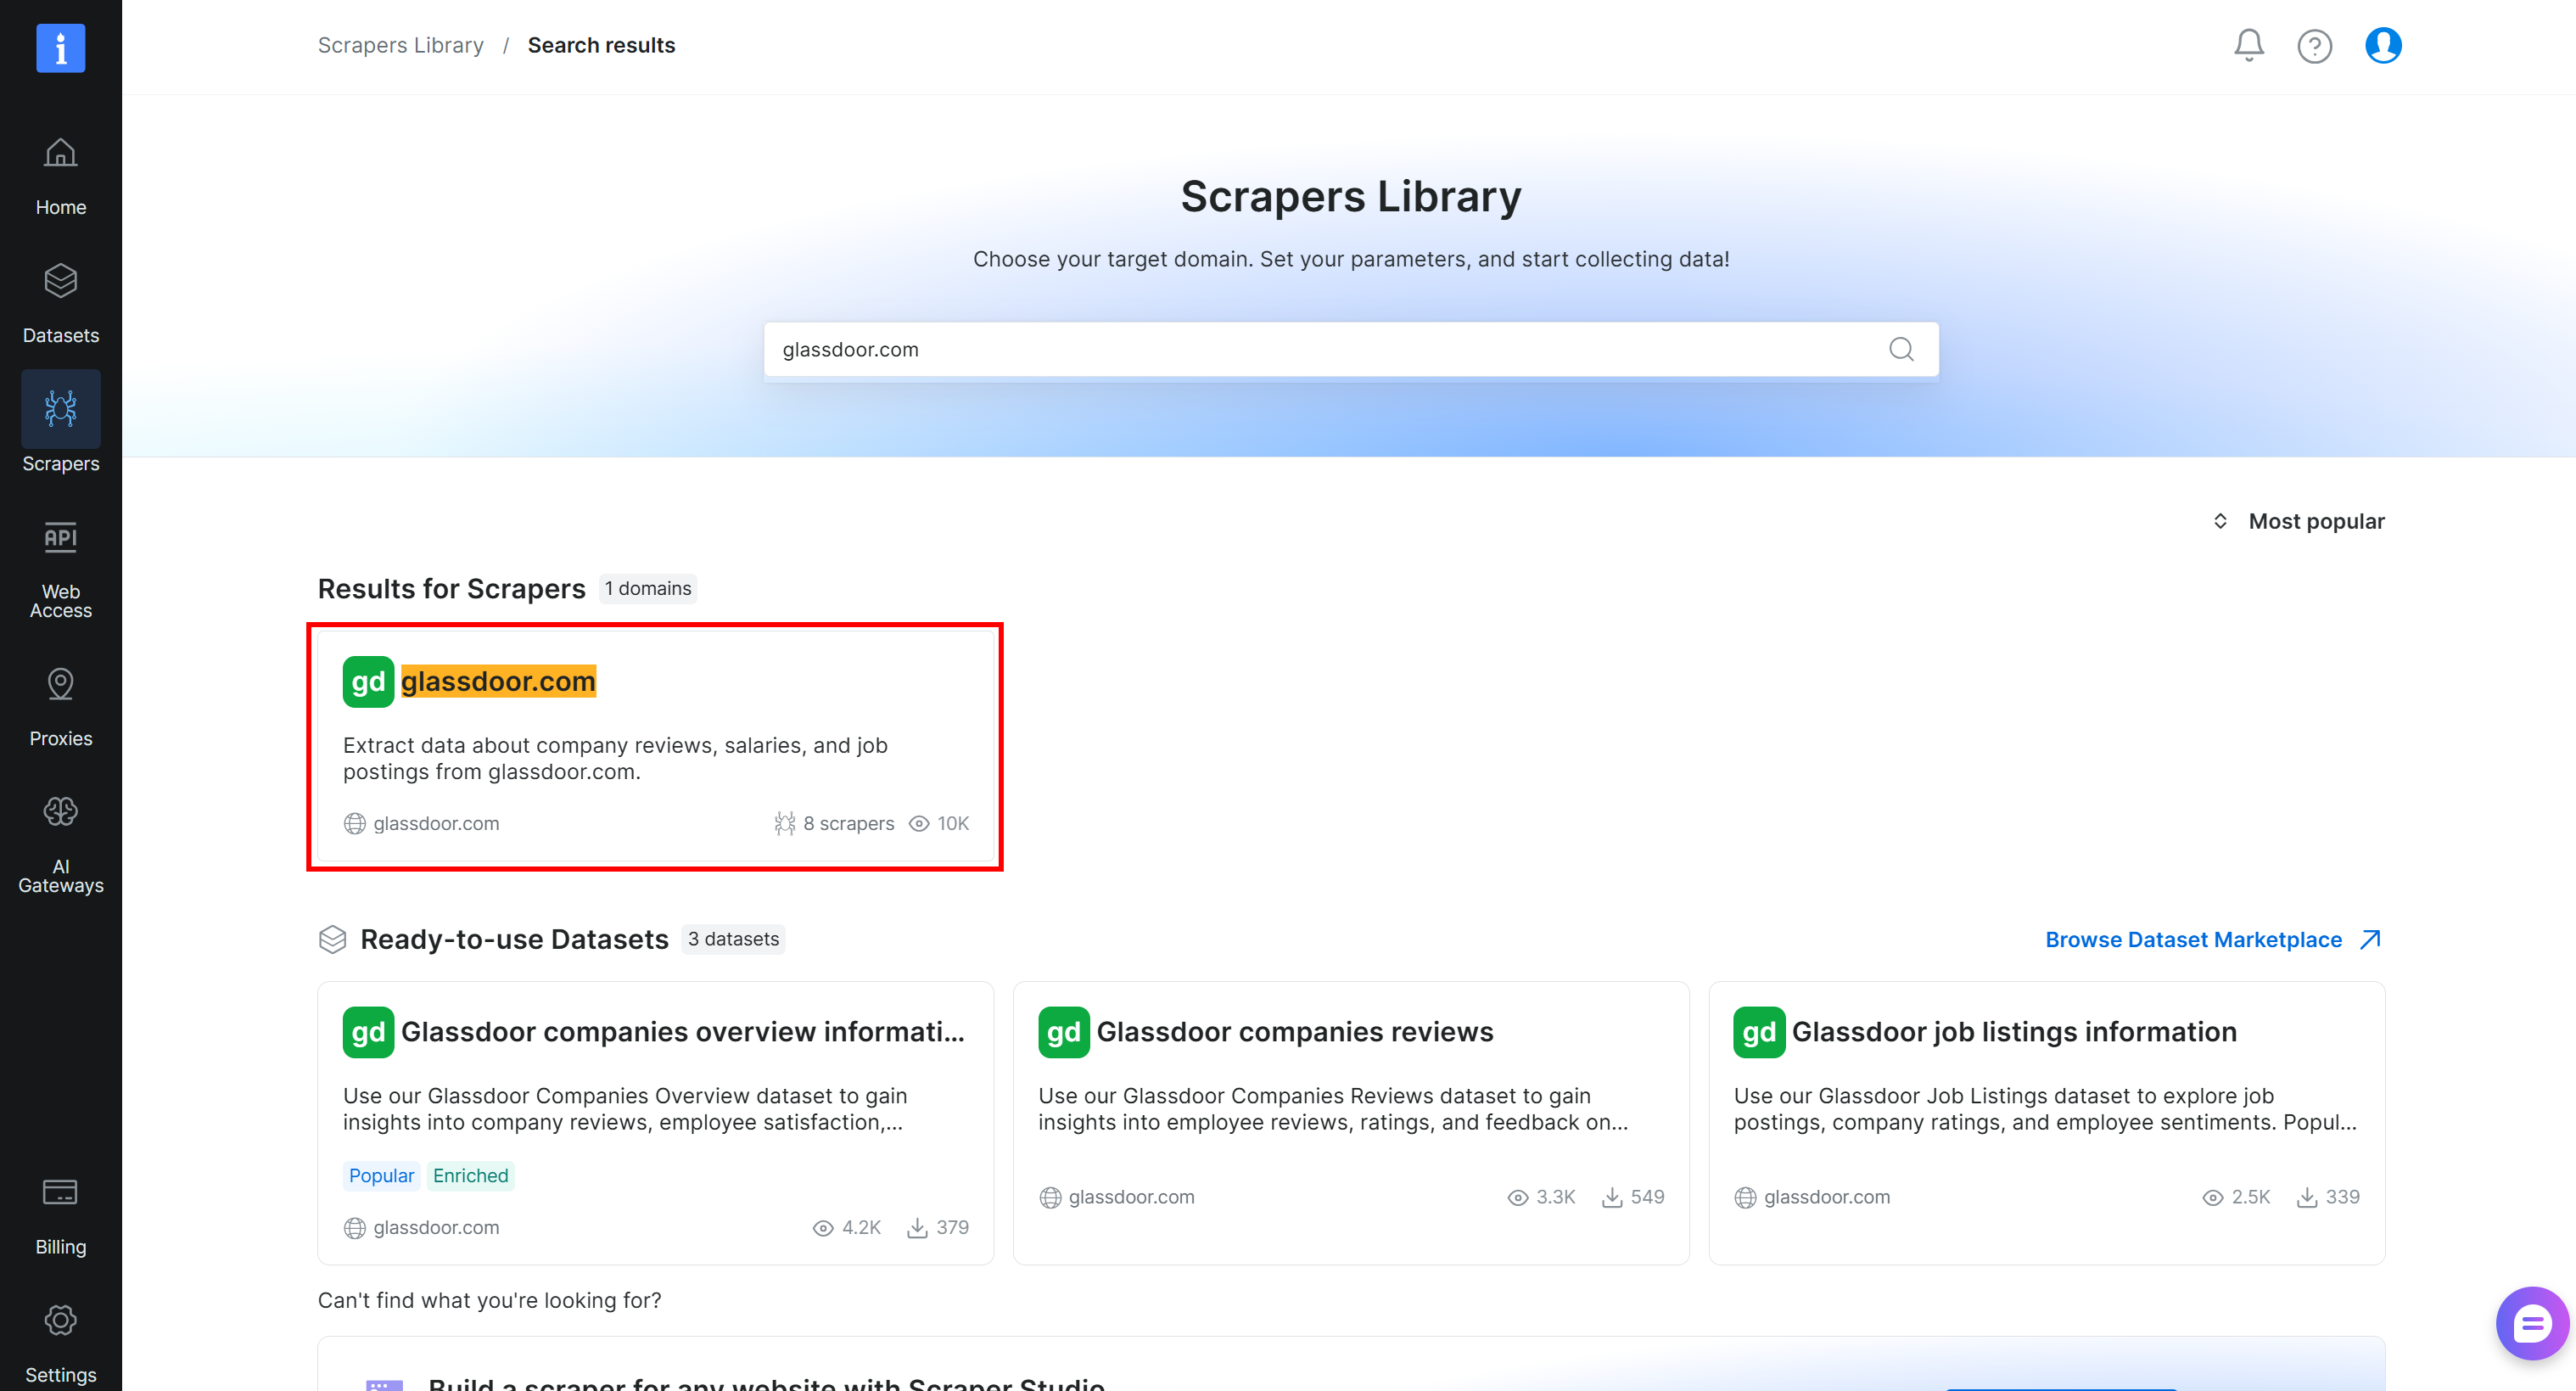
登录你的 Bright Data 账户并进入控制面板。导航至“爬虫工具 > 爬虫工具库”,搜索“glassdoor”,然后选择“glassdoor.com”卡片:
你将被重定向到 Glassdoor 抓取工具页面。在这里,从左侧菜单中选择“Glassdoor 公司评价 > 按 URL 采集”选项。这是用于抓取 Glassdoor 评价的端点:
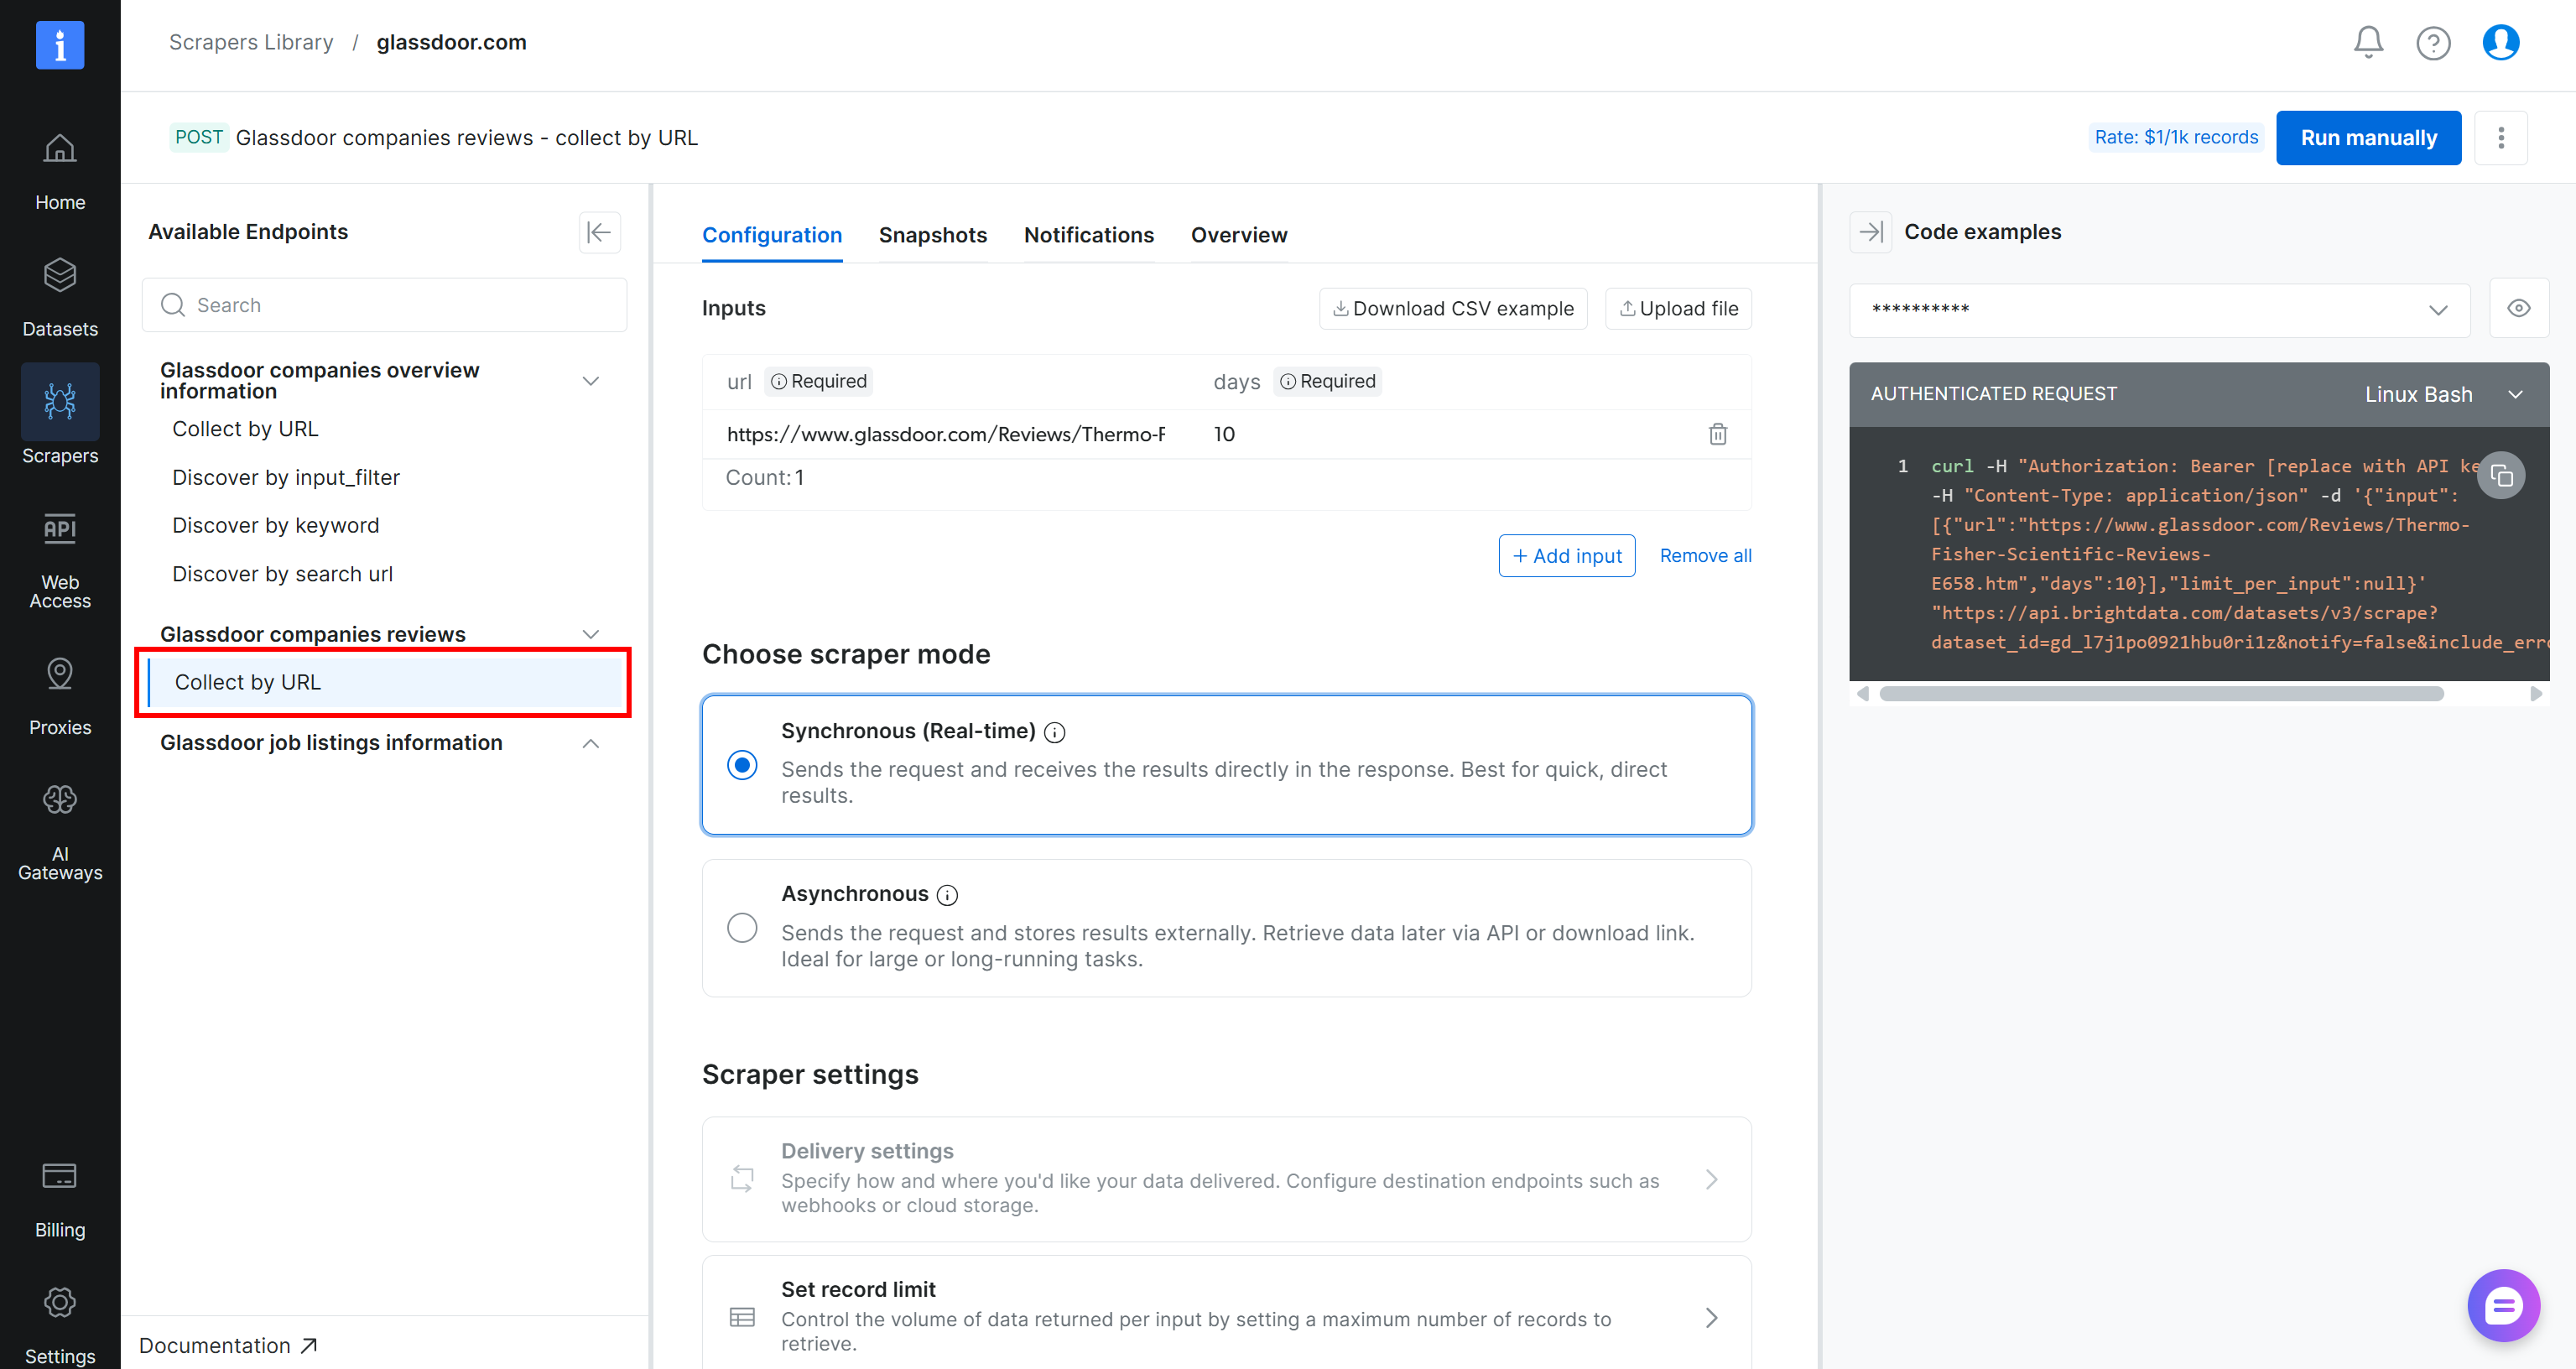 右侧的代码示例显示,同步抓取请求会发送至以下端点:
https://api.brightdata.com/datasets/v3/scrape?dataset_id=gd_l7j1po0921hbu0ri1z其中gd_l7j1po0921hbu0ri1z 是 Glassdoor 评价爬虫 API 的数据集 ID。请求会发送至 datasets/v3/scrape 端点,该端点会执行抓取任务并等待其完成,然后在响应中返回提取的数据。
如你所见,请求正文具有以下结构:
{
  "input": [
    {
      "url": "<GLASSDOOR_REVIEW_PAGE_URL>",
      "days": <NUM_DAYS>
    },
    // other URL objects...
  ],
  "limit_per_input": null
}
url 字段指定要抓取的 Glassdoor 公司评价页面,而 days 则将结果限制为指定天数内发布的评价。
你还可以单击右上角的“手动运行”,直接从 Bright Data 控制面板测试该端点。如果分析一次 API 调用的 JSON 输出,你会看到:
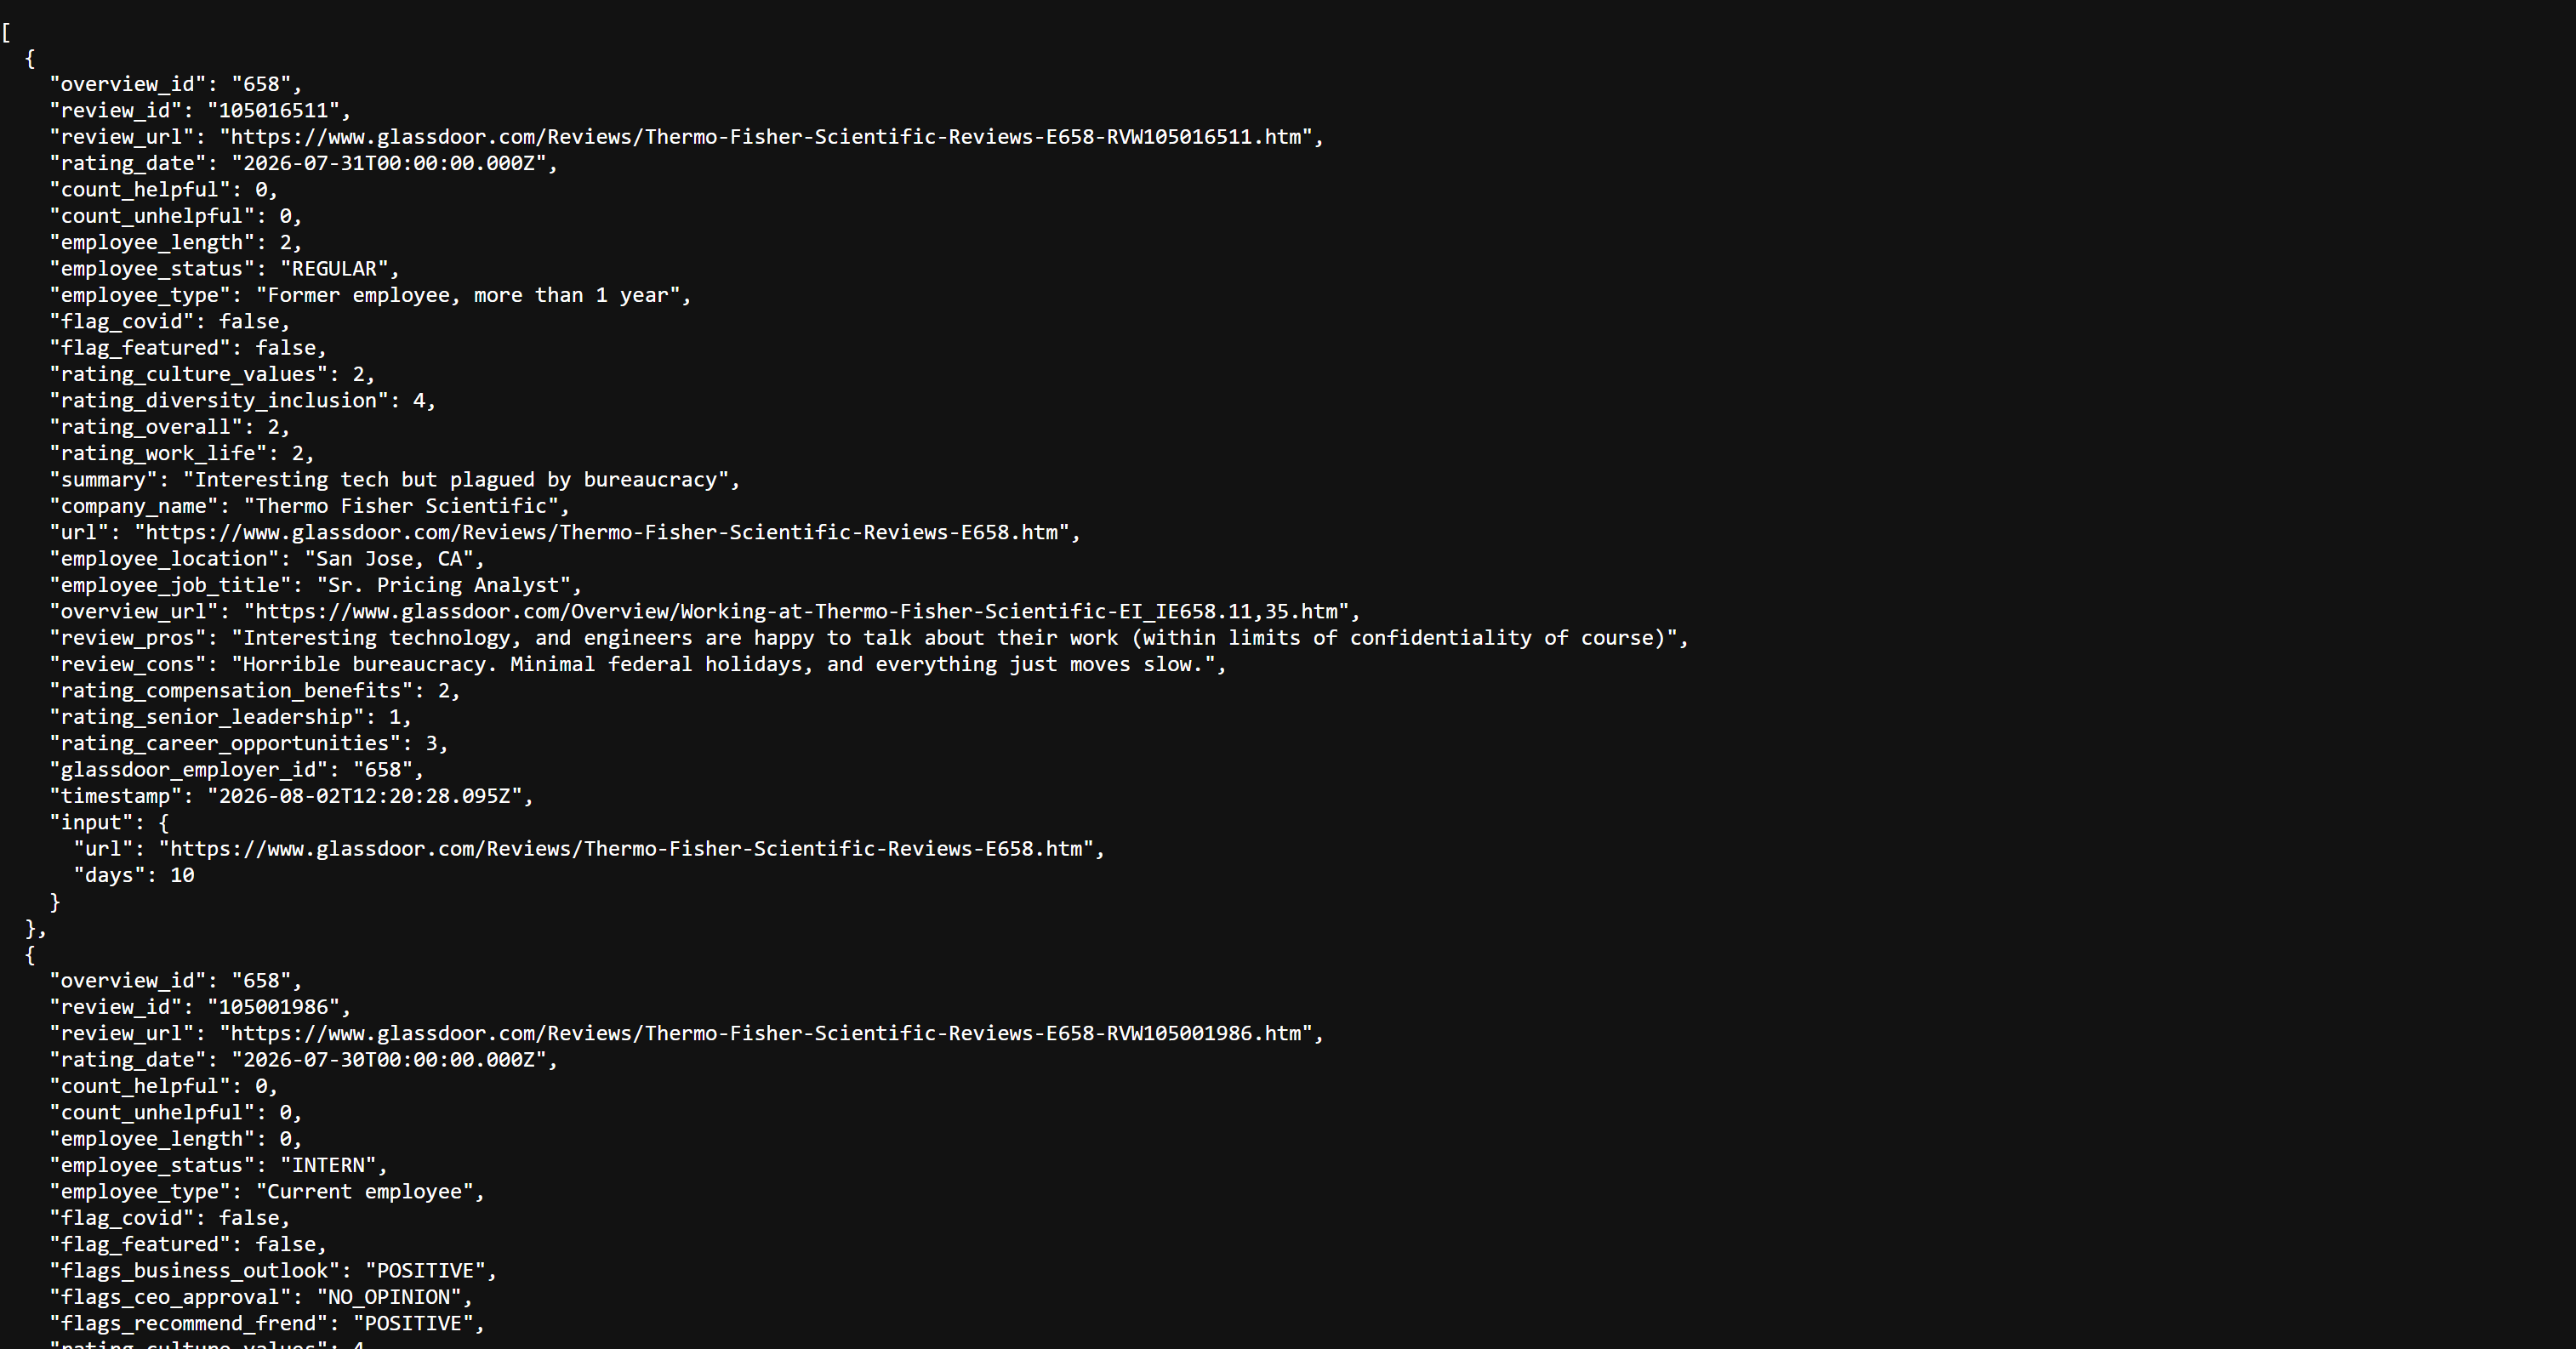
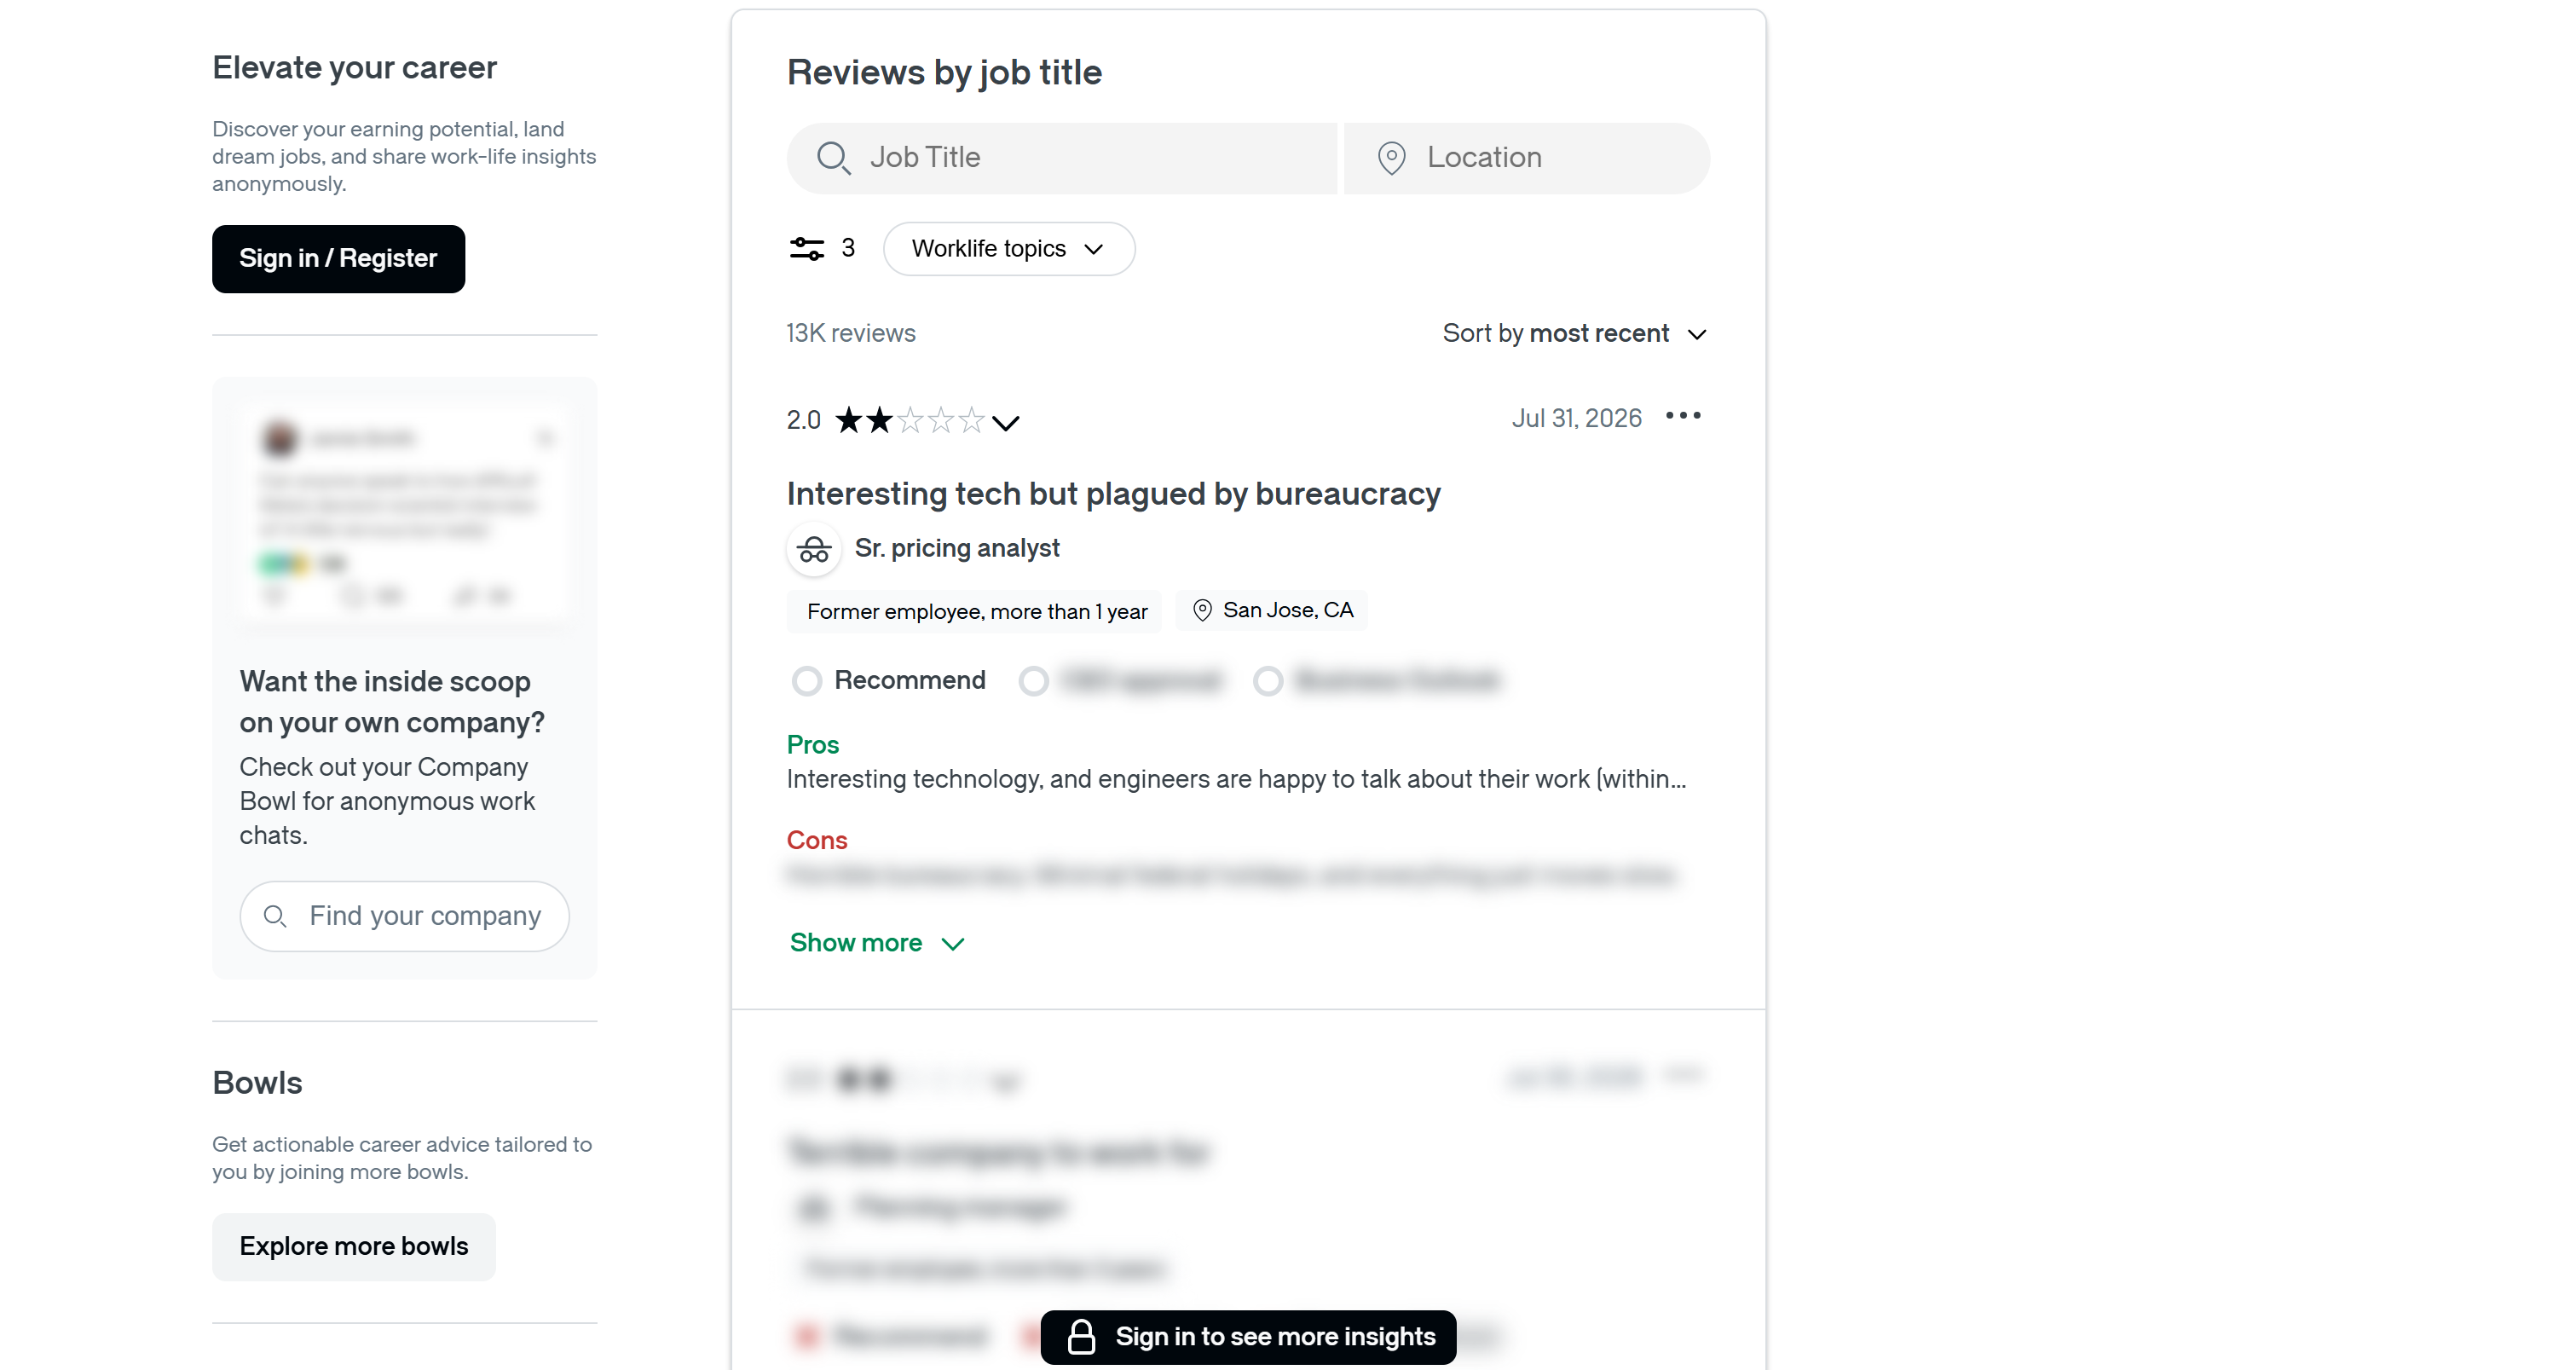
请注意,每条评价都包含 Glassdoor 原始页面上提供的相同信息,包括评价标题、评分、优点、缺点、推荐情况和评价日期:
太棒了!现在可以将 Bright Data 爬虫 API 调用集成到你的 Workato 配方中了。
第 3 步:设置 HTTP 步骤以调用爬虫 API
返回 Workato 配方编辑器页面。单击“+”按钮并选择“应用中的操作”以添加新步骤。在右侧面板中搜索“http”,然后选择“HTTP”应用:
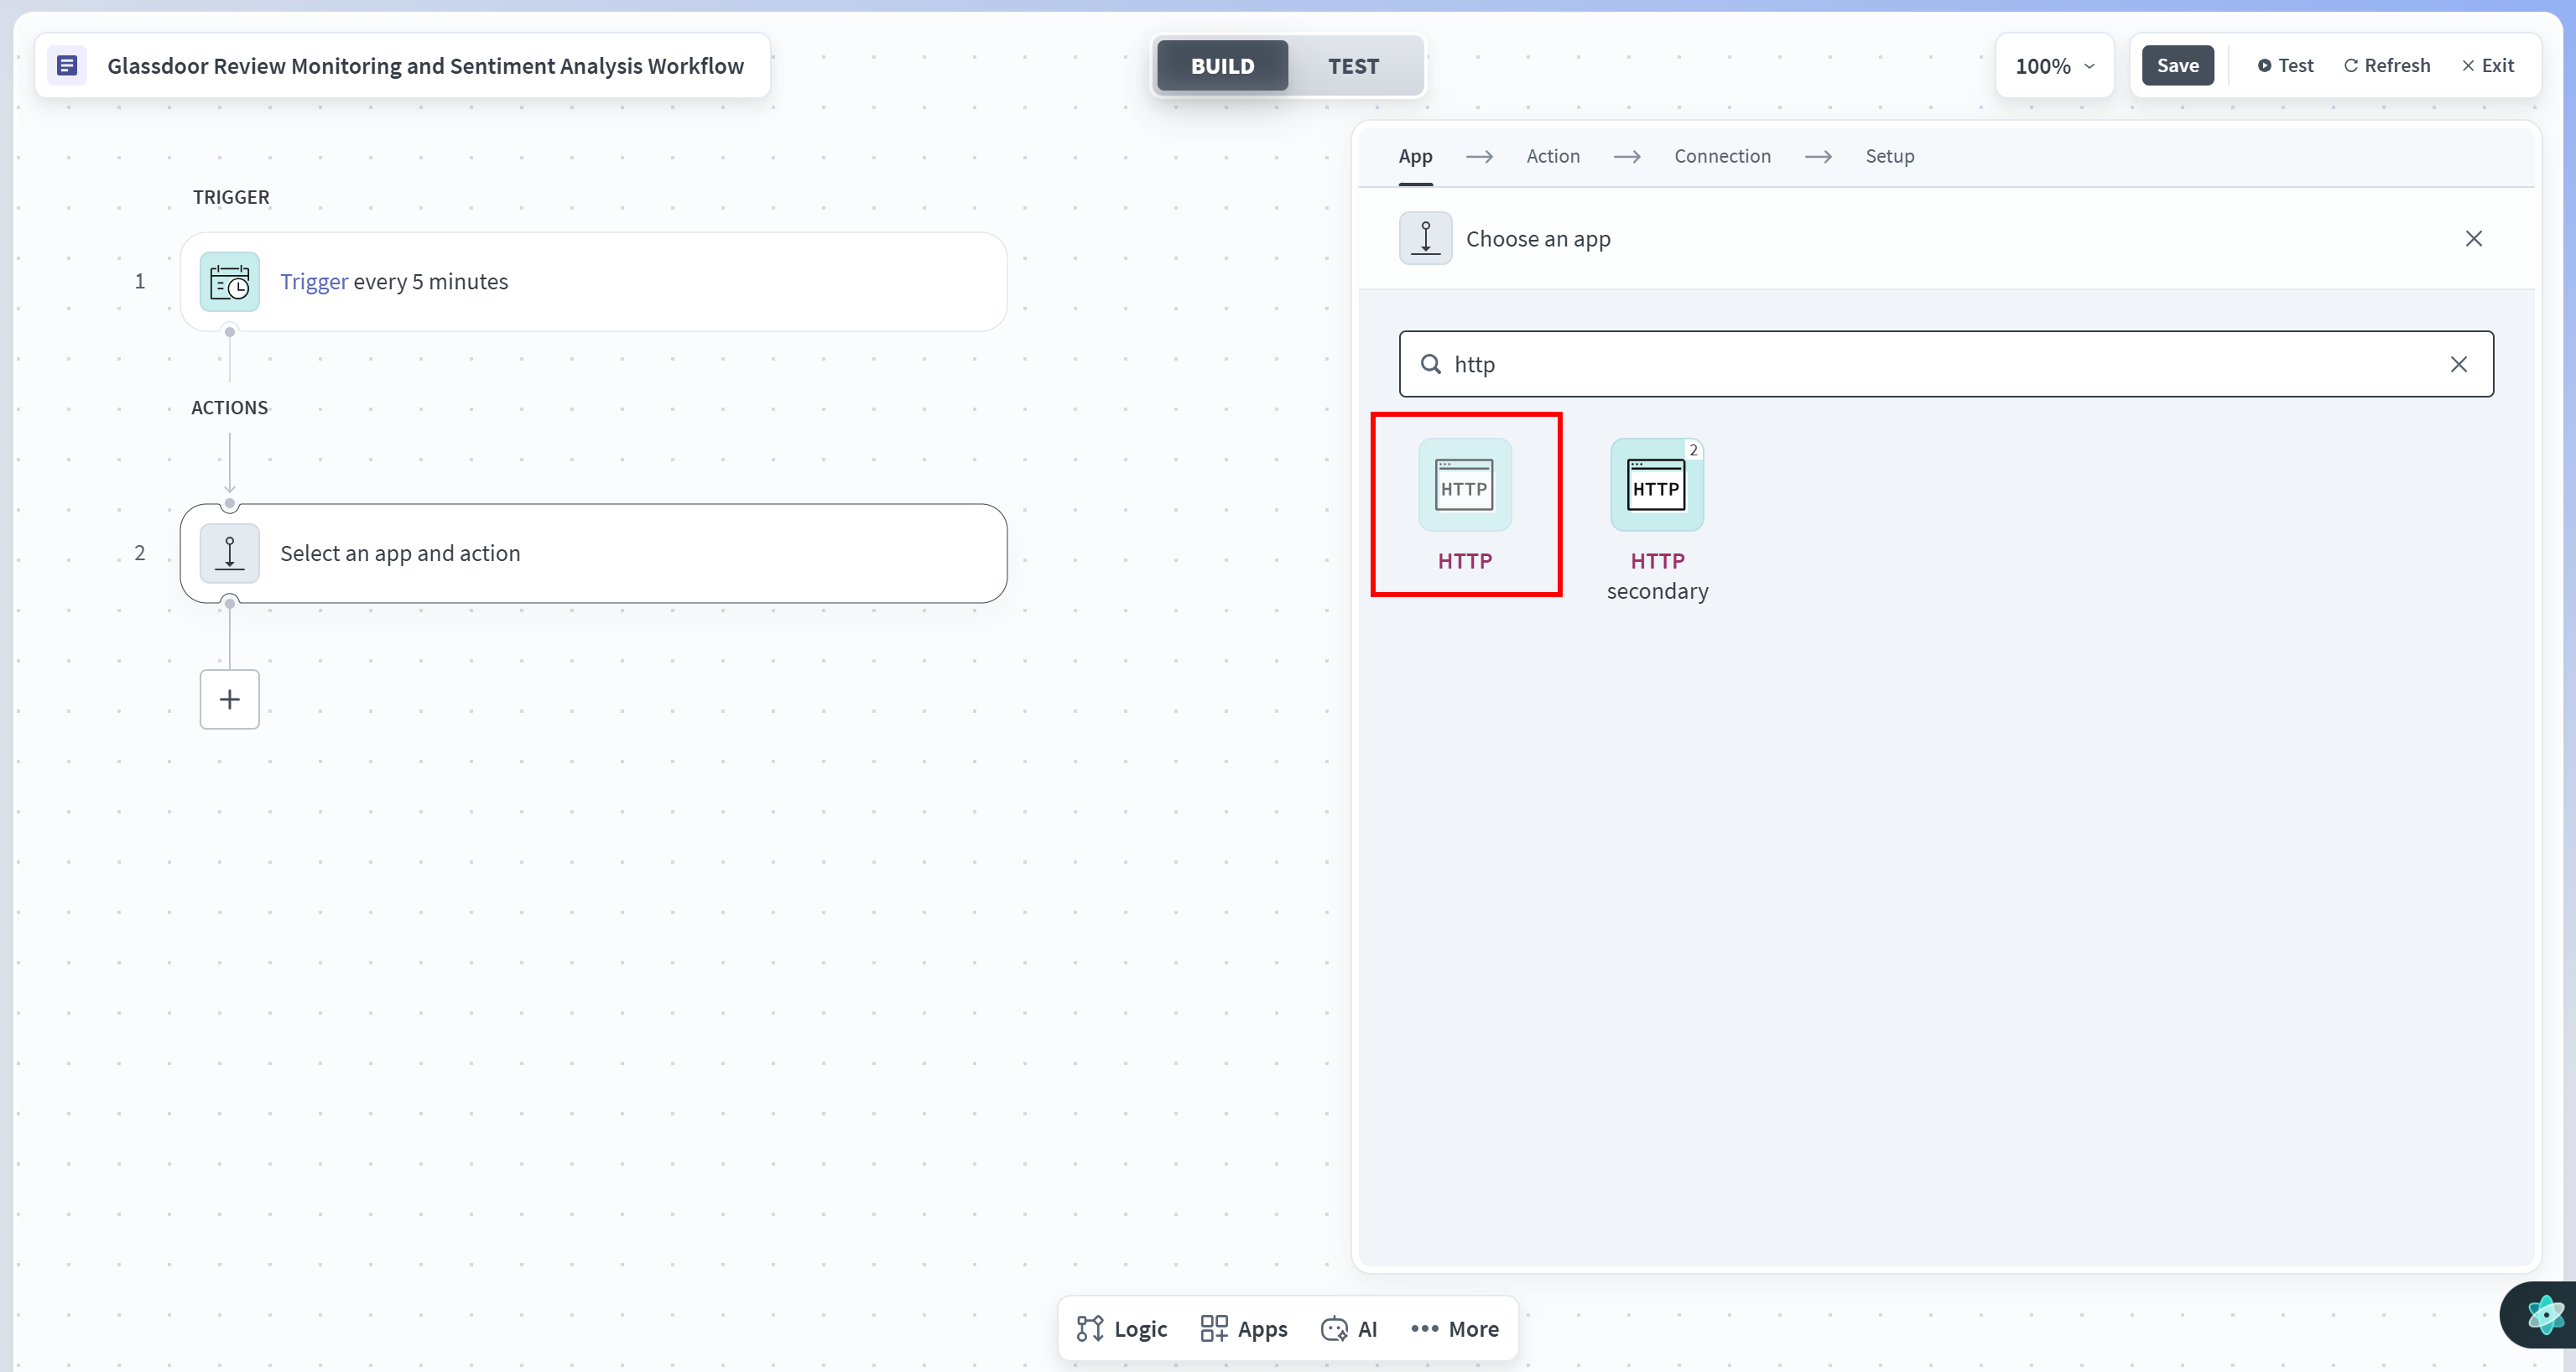
Workato“HTTP”应用允许你向外部服务发送 HTTP 请求,因此非常适合调用 Bright Data 爬虫 API。
使用以下设置配置连接:
- 连接名称:
Bright Data Scraper API - 位置:
Your Workato project - 连接类型:
Cloud - 身份验证类型:
Header auth(因为 Bright Data 爬虫 API 通过Authorization标头进行身份验证)
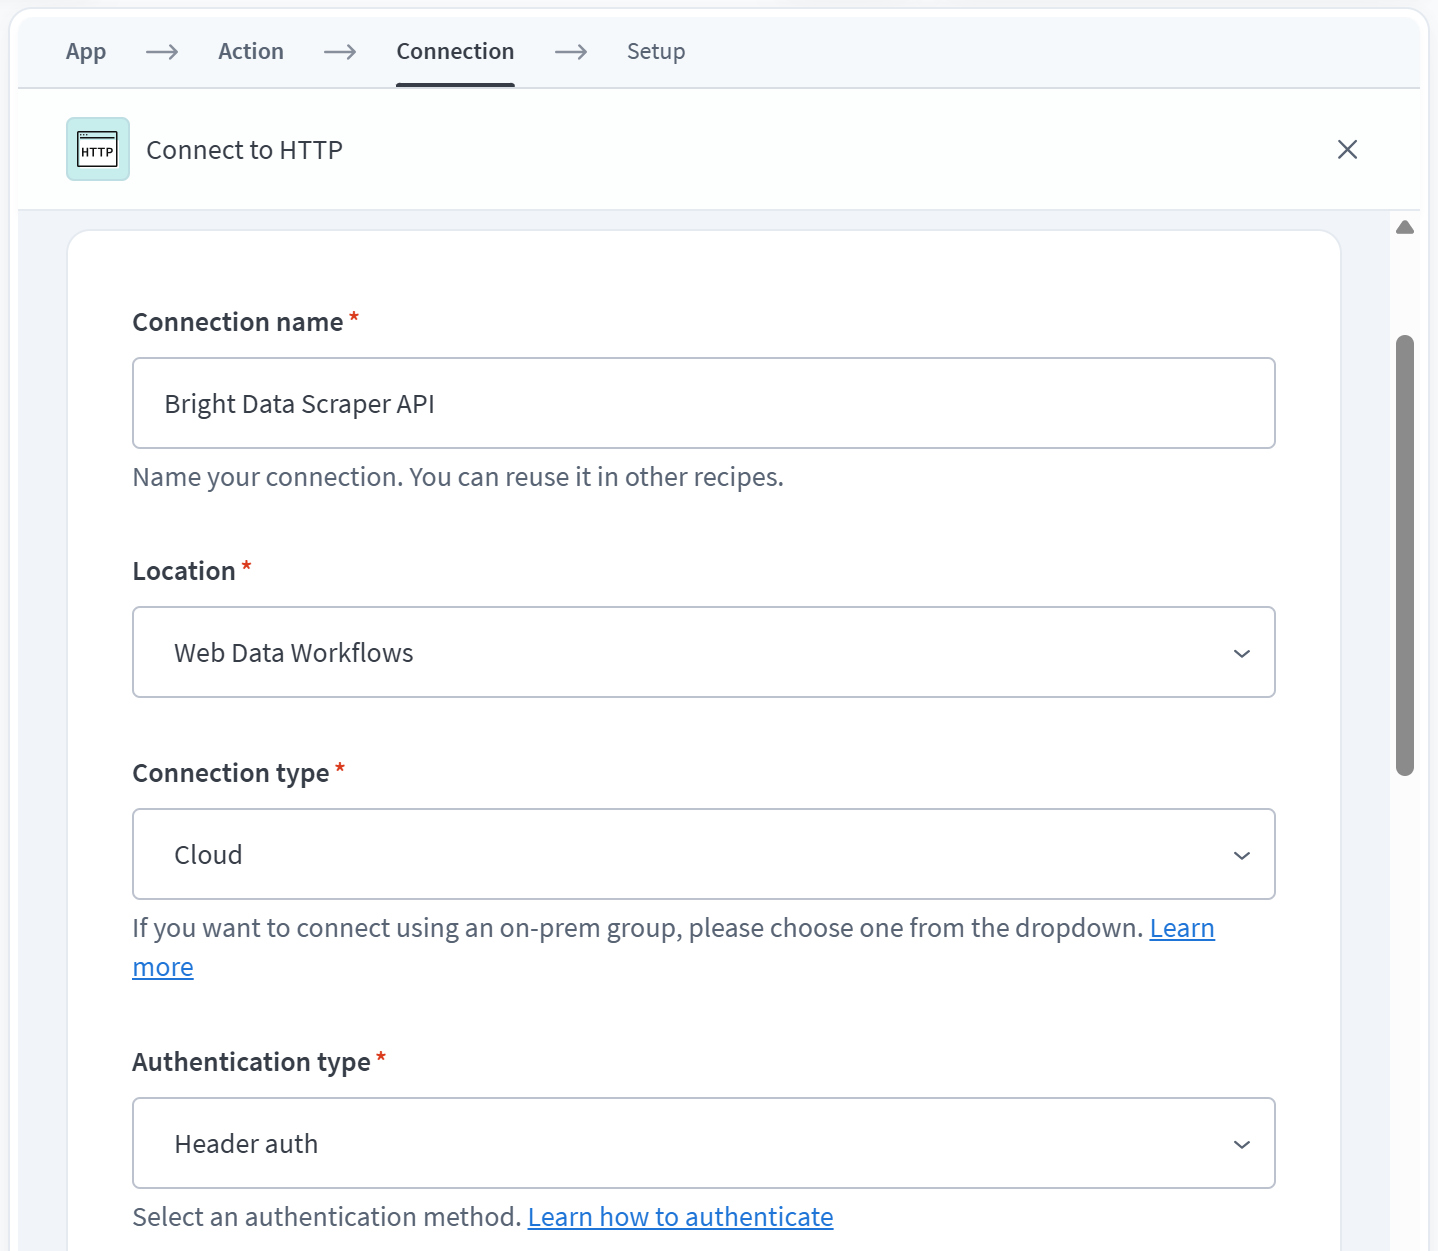
然后,在“基础 URL”中粘贴 Bright Data 爬虫 API 的基础 URL:
https://api.brightdata.com/datasets/v3/scrape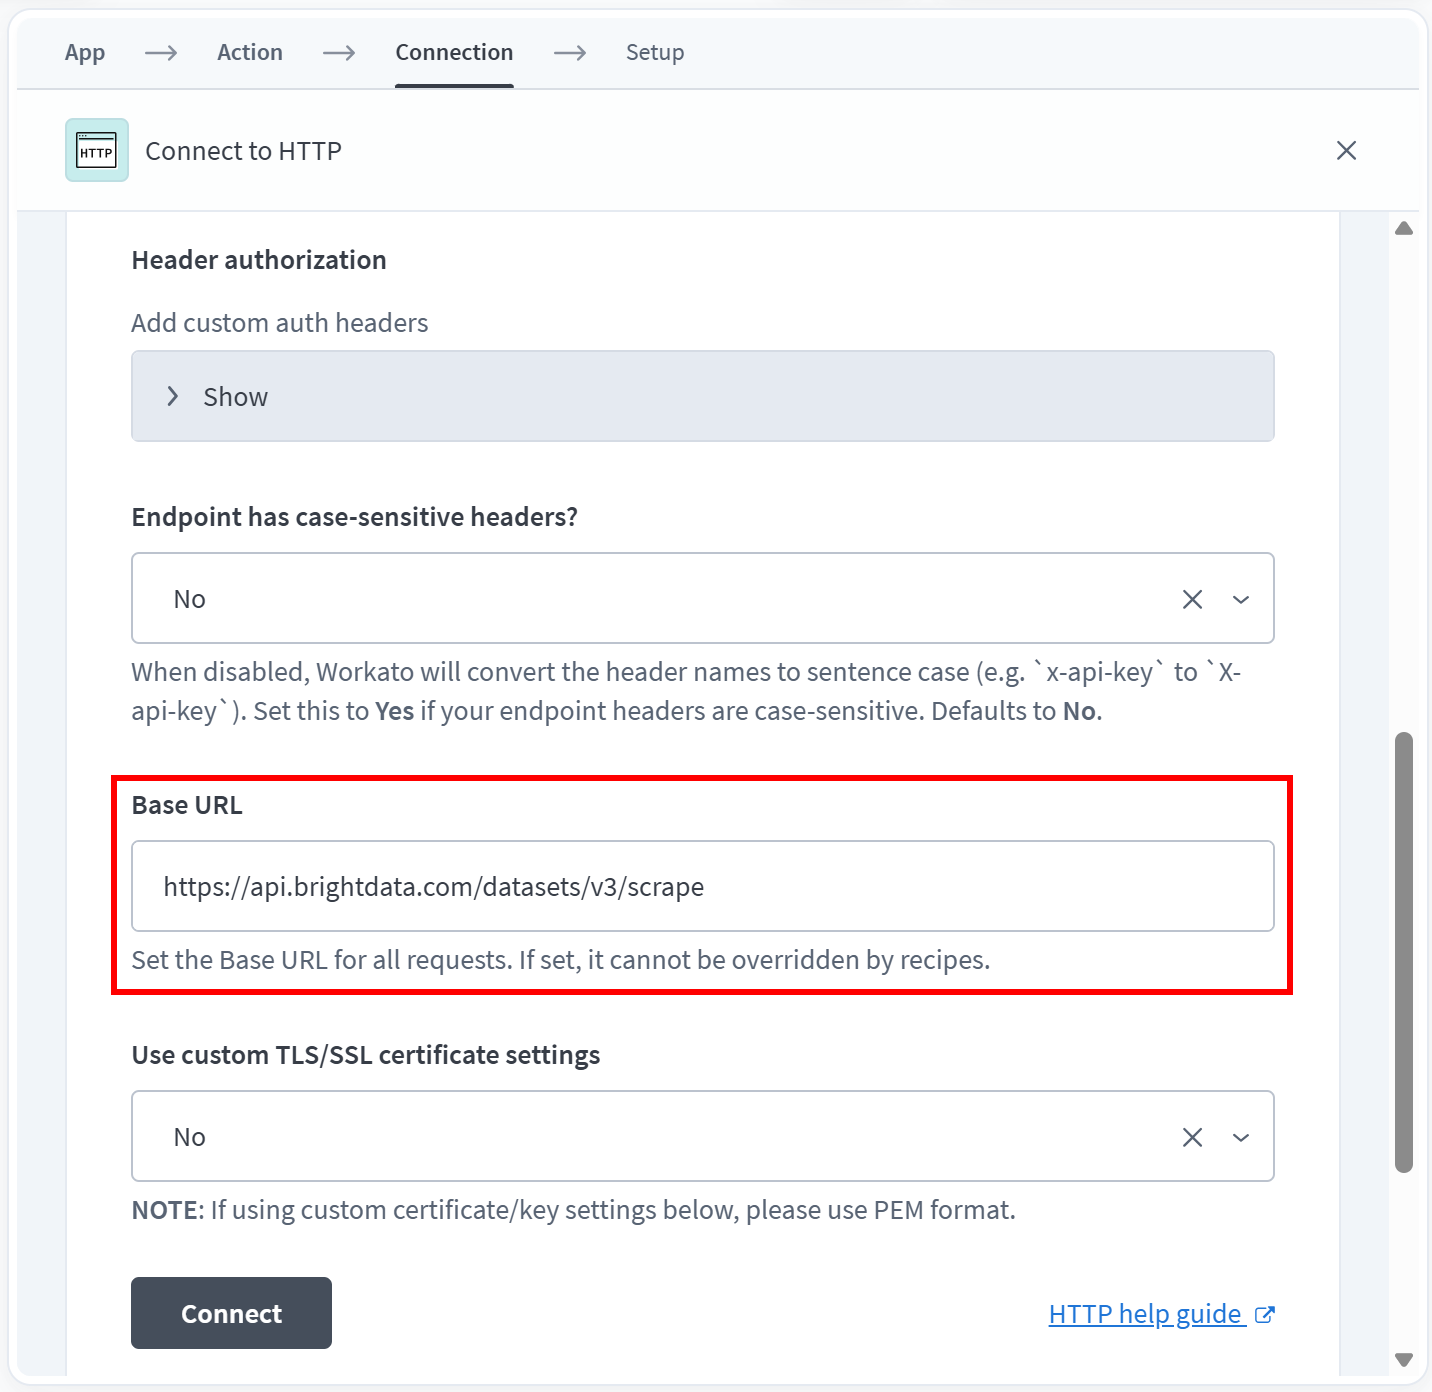
保持其余选项不变,然后单击“连接”。接下来,在步骤配置中单击“开始引导式设置”按钮:
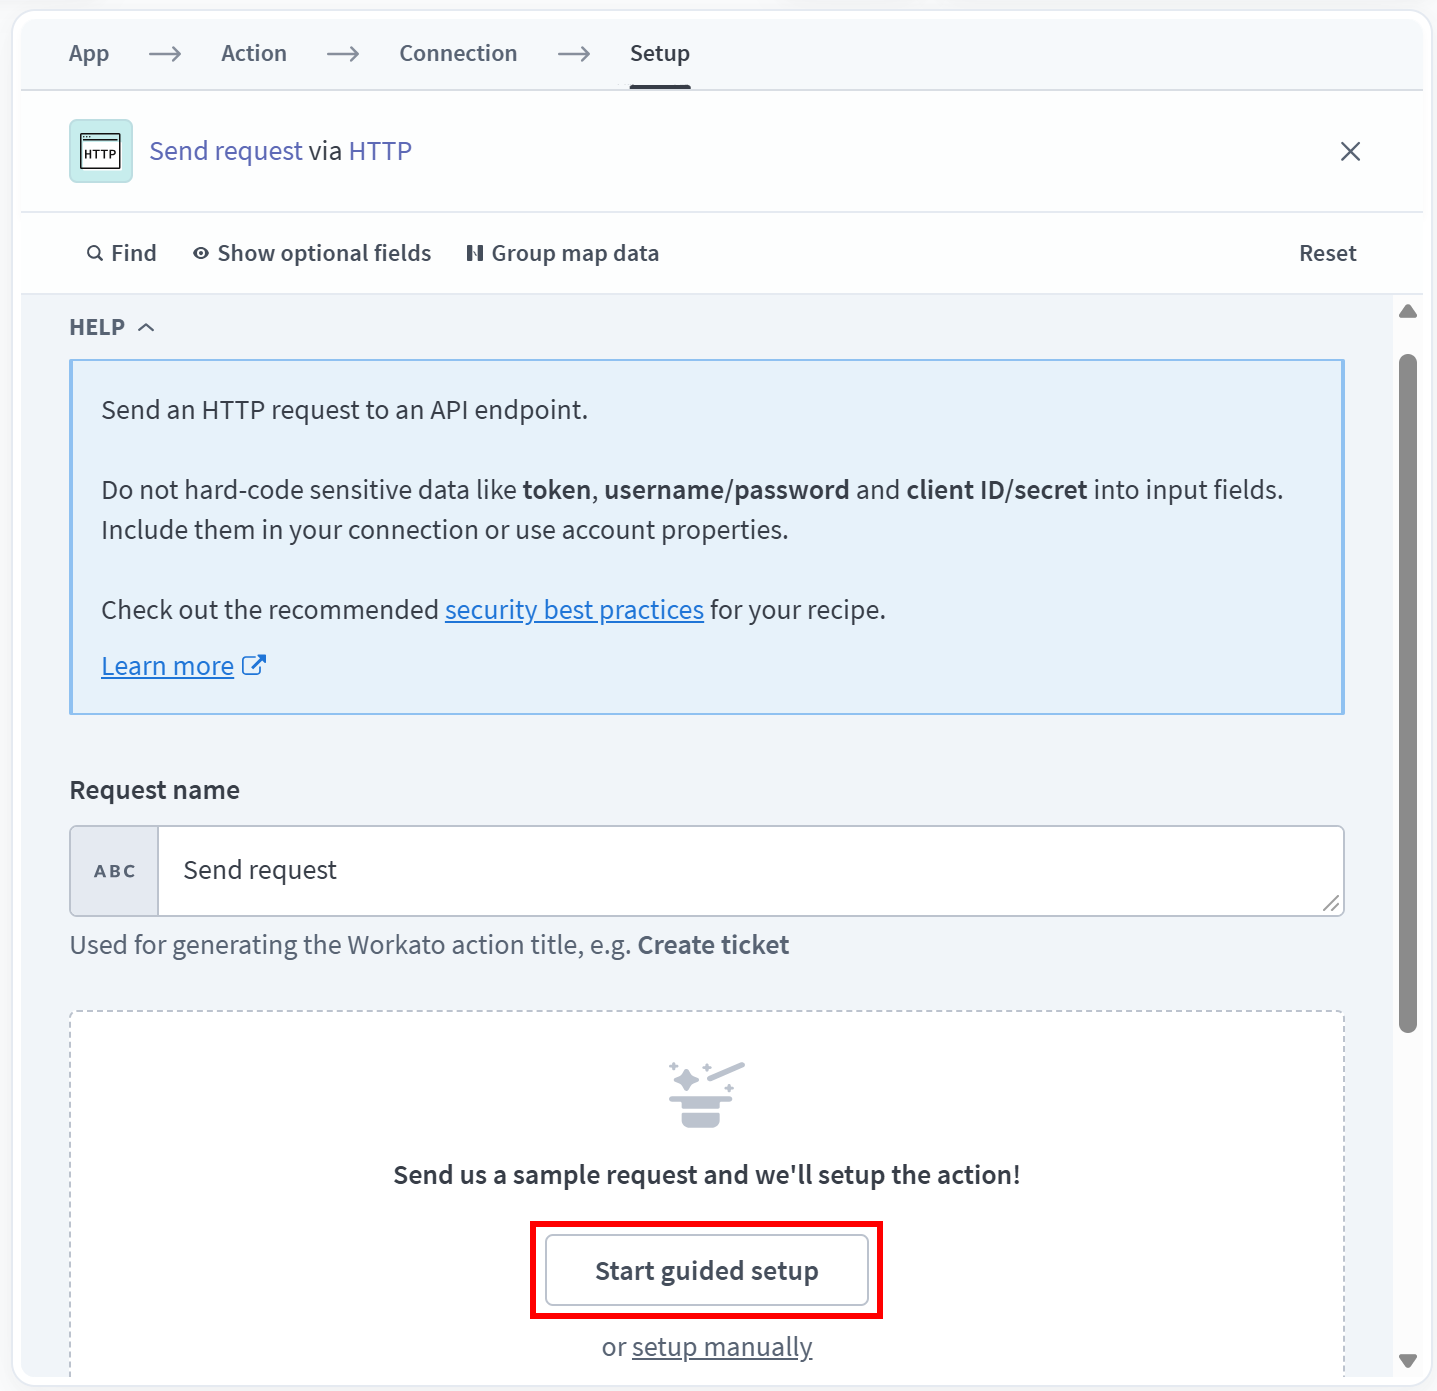
这将打开一个向导模式,引导你完成 HTTP 请求的配置。
选择“POST”作为 HTTP 方法,并为 Glassdoor 抓取工具 API 端点使用以下请求 URL:
https://api.brightdata.com/datasets/v3/scrape?dataset_id=gd_l7j1po0921hbu0ri1z&format=jsonformat=json 查询参数指示 API 以 JSON 格式返回结果。此外还支持CSV 和 JSONL 等格式。
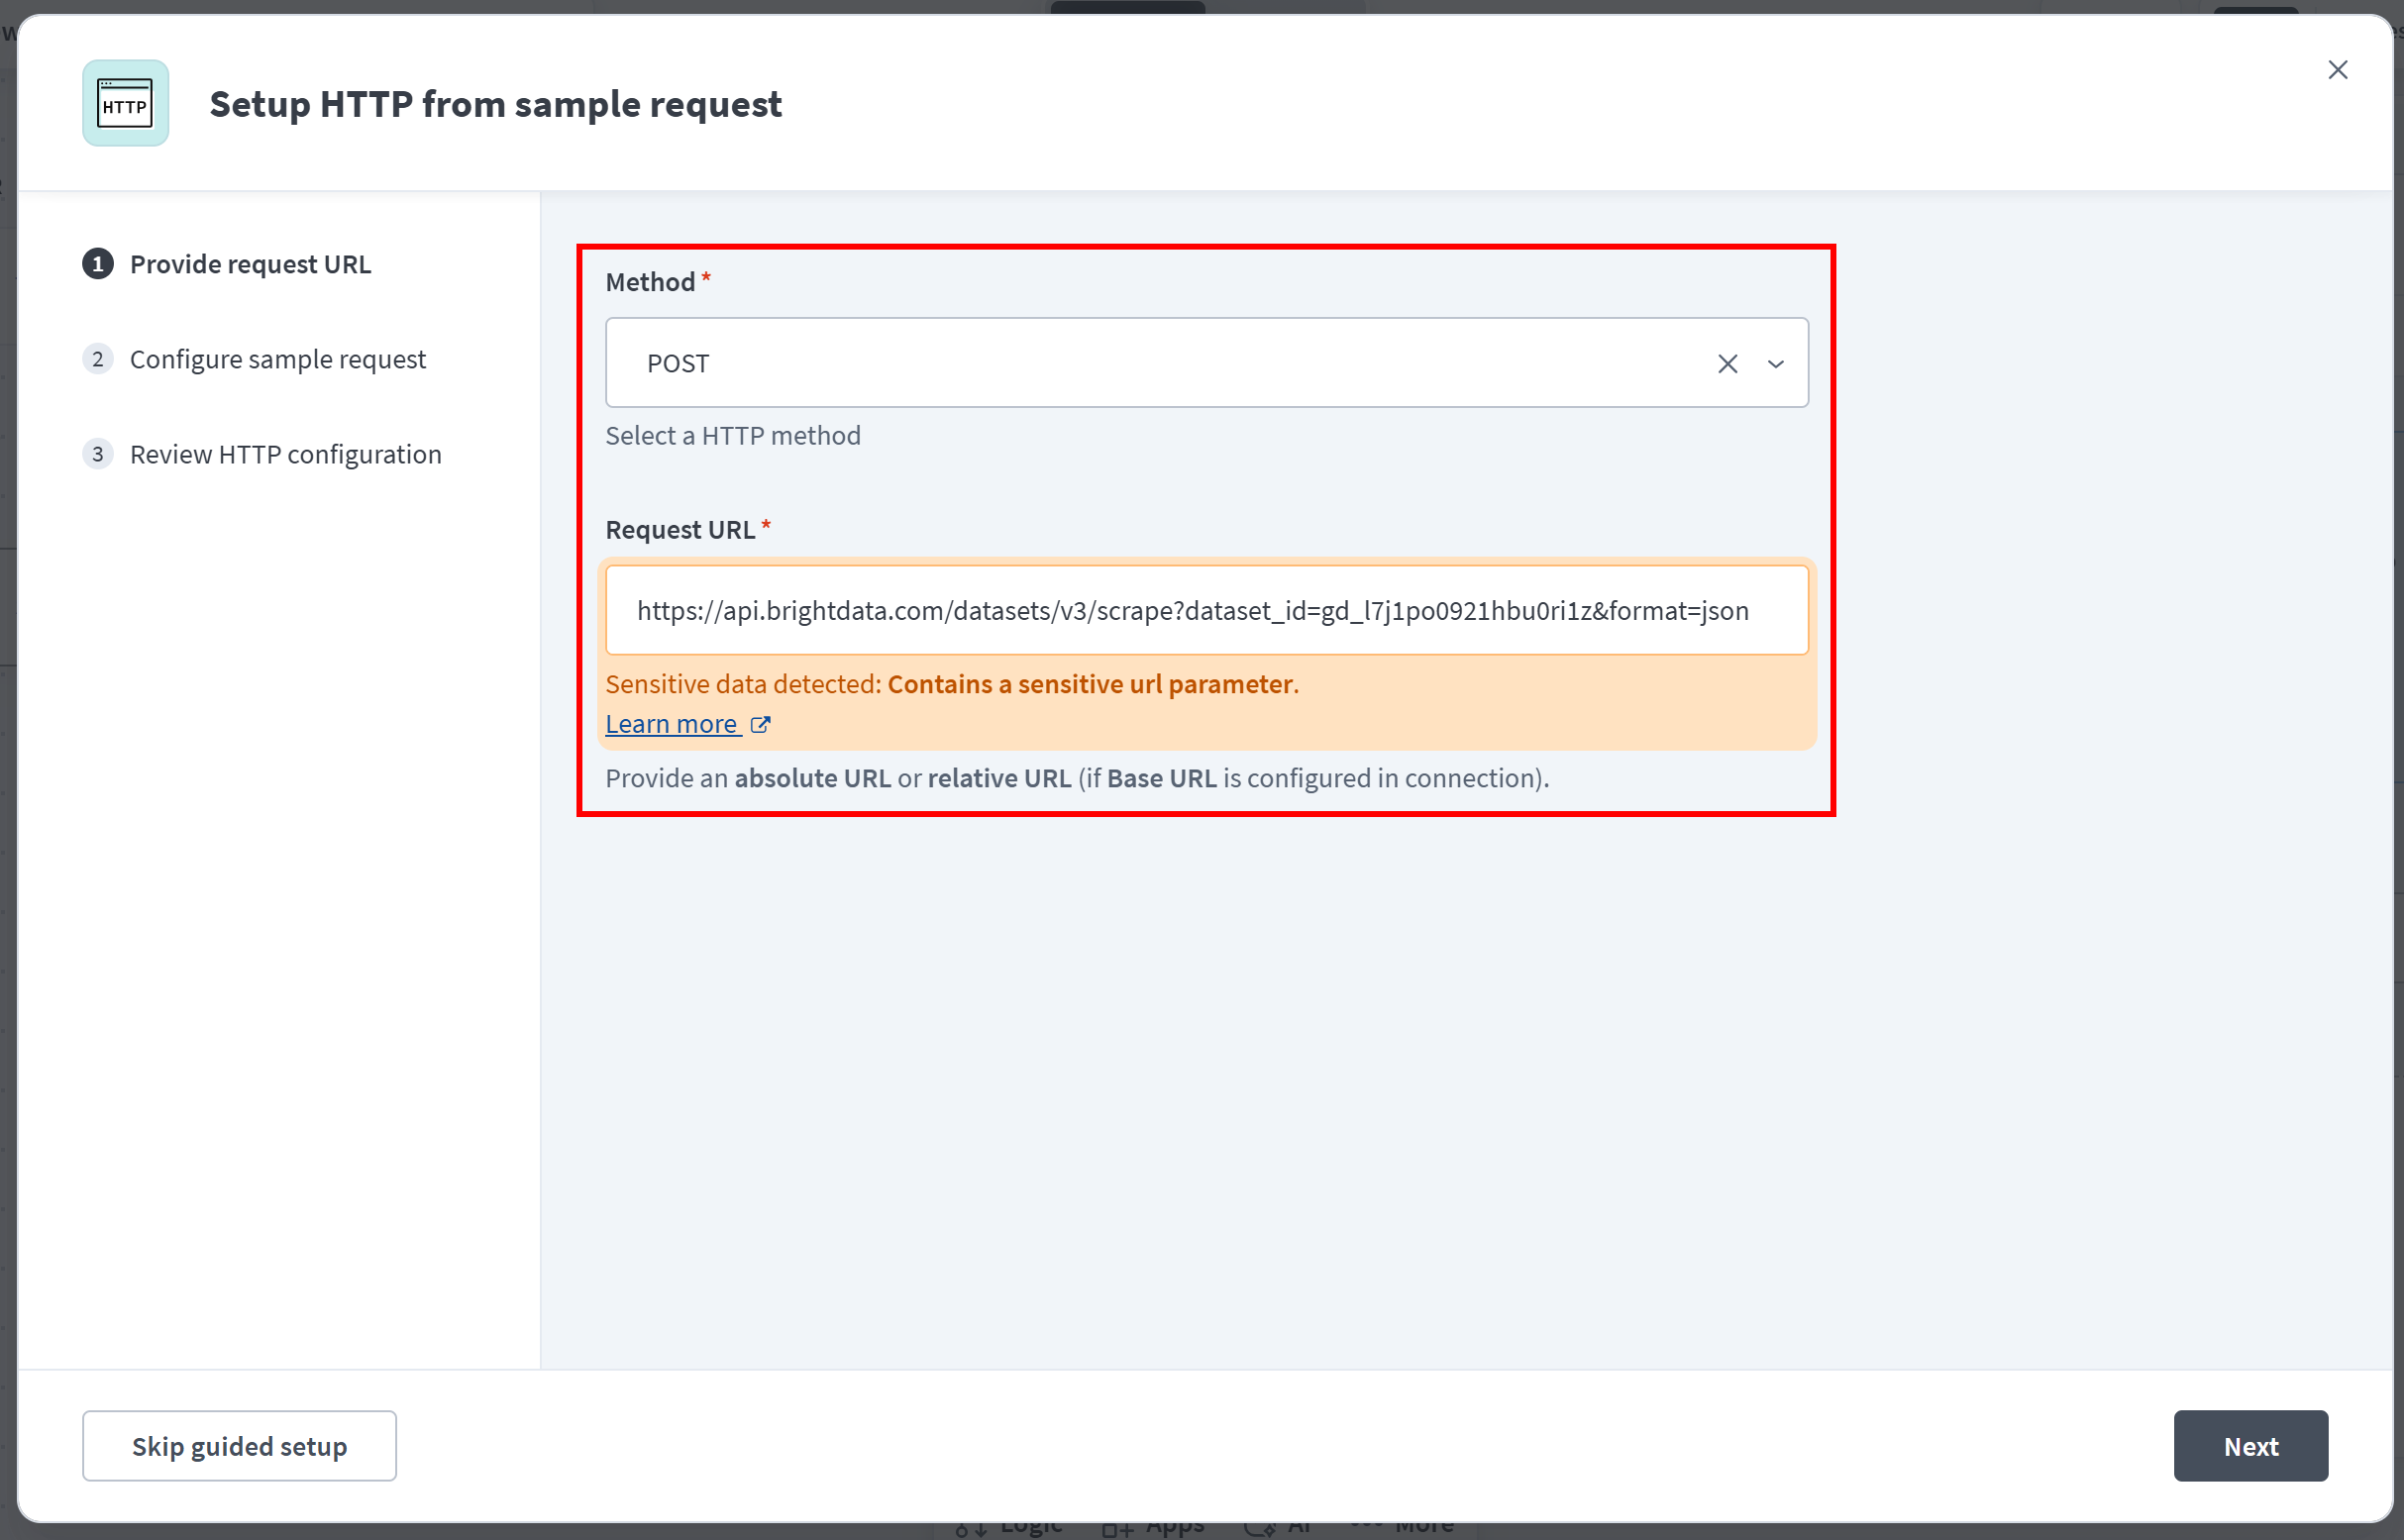
现在,假设你想监控 Nike 在 Glassdoor 上的评价。添加以下请求正文:
{"input":[{"url":"https://www.glassdoor.com/Reviews/NIKE-Reviews-E1699.htm","days":10}],"limit_per_input":null}请注意days 设置为 10因为 Workato 配方被配置为每 10 天运行一次。这可确保每次执行时都能检索上次运行以来发布的所有新评价。
要通过你的 Bright Data 账户验证请求,请设置包含以下内容的 Authorization 标头:
Bearer <YOUR_BRIGHT_DATA_API_KEY>将 <YOUR_BRIGHT_DATA_API_KEY> 替换为你自己的 Bright Data API 密钥。这是 Bright Data API 用于身份验证的必要格式。
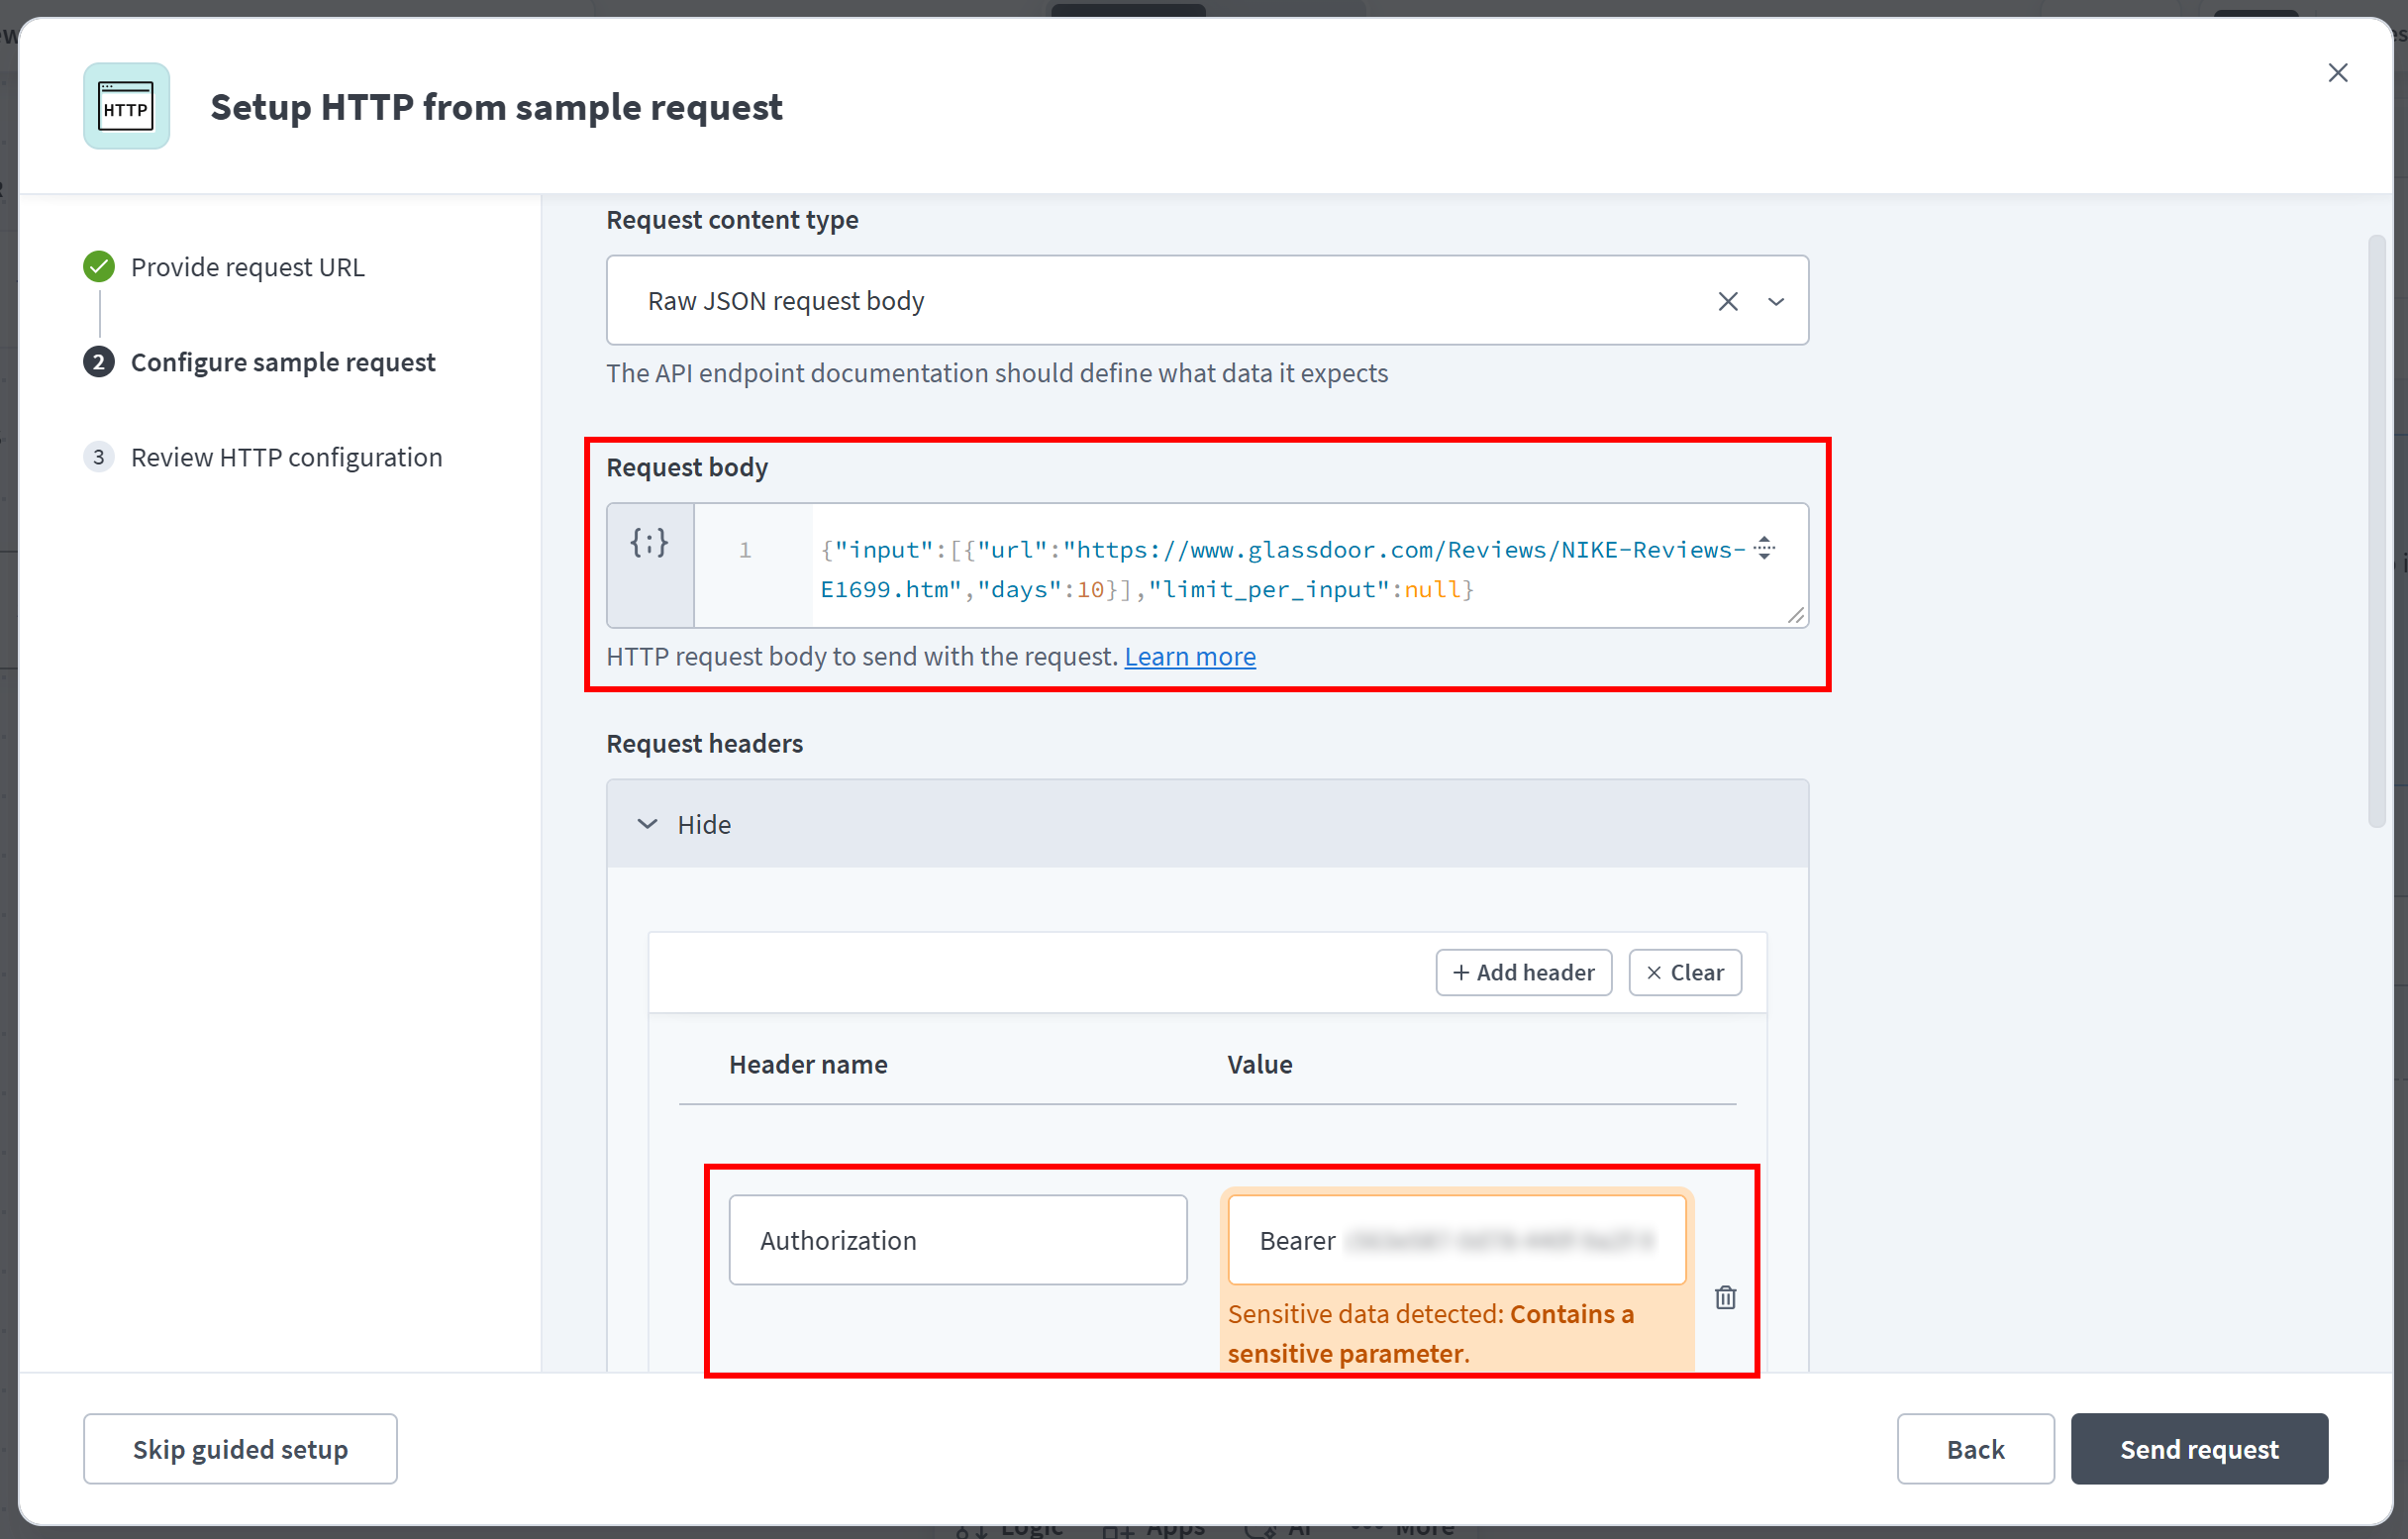
单击“发送请求”以测试配置。如果一切配置正确,Workato 将返回包含以 JSON 格式抓取的 Glassdoor 评价的 200 OK 响应:
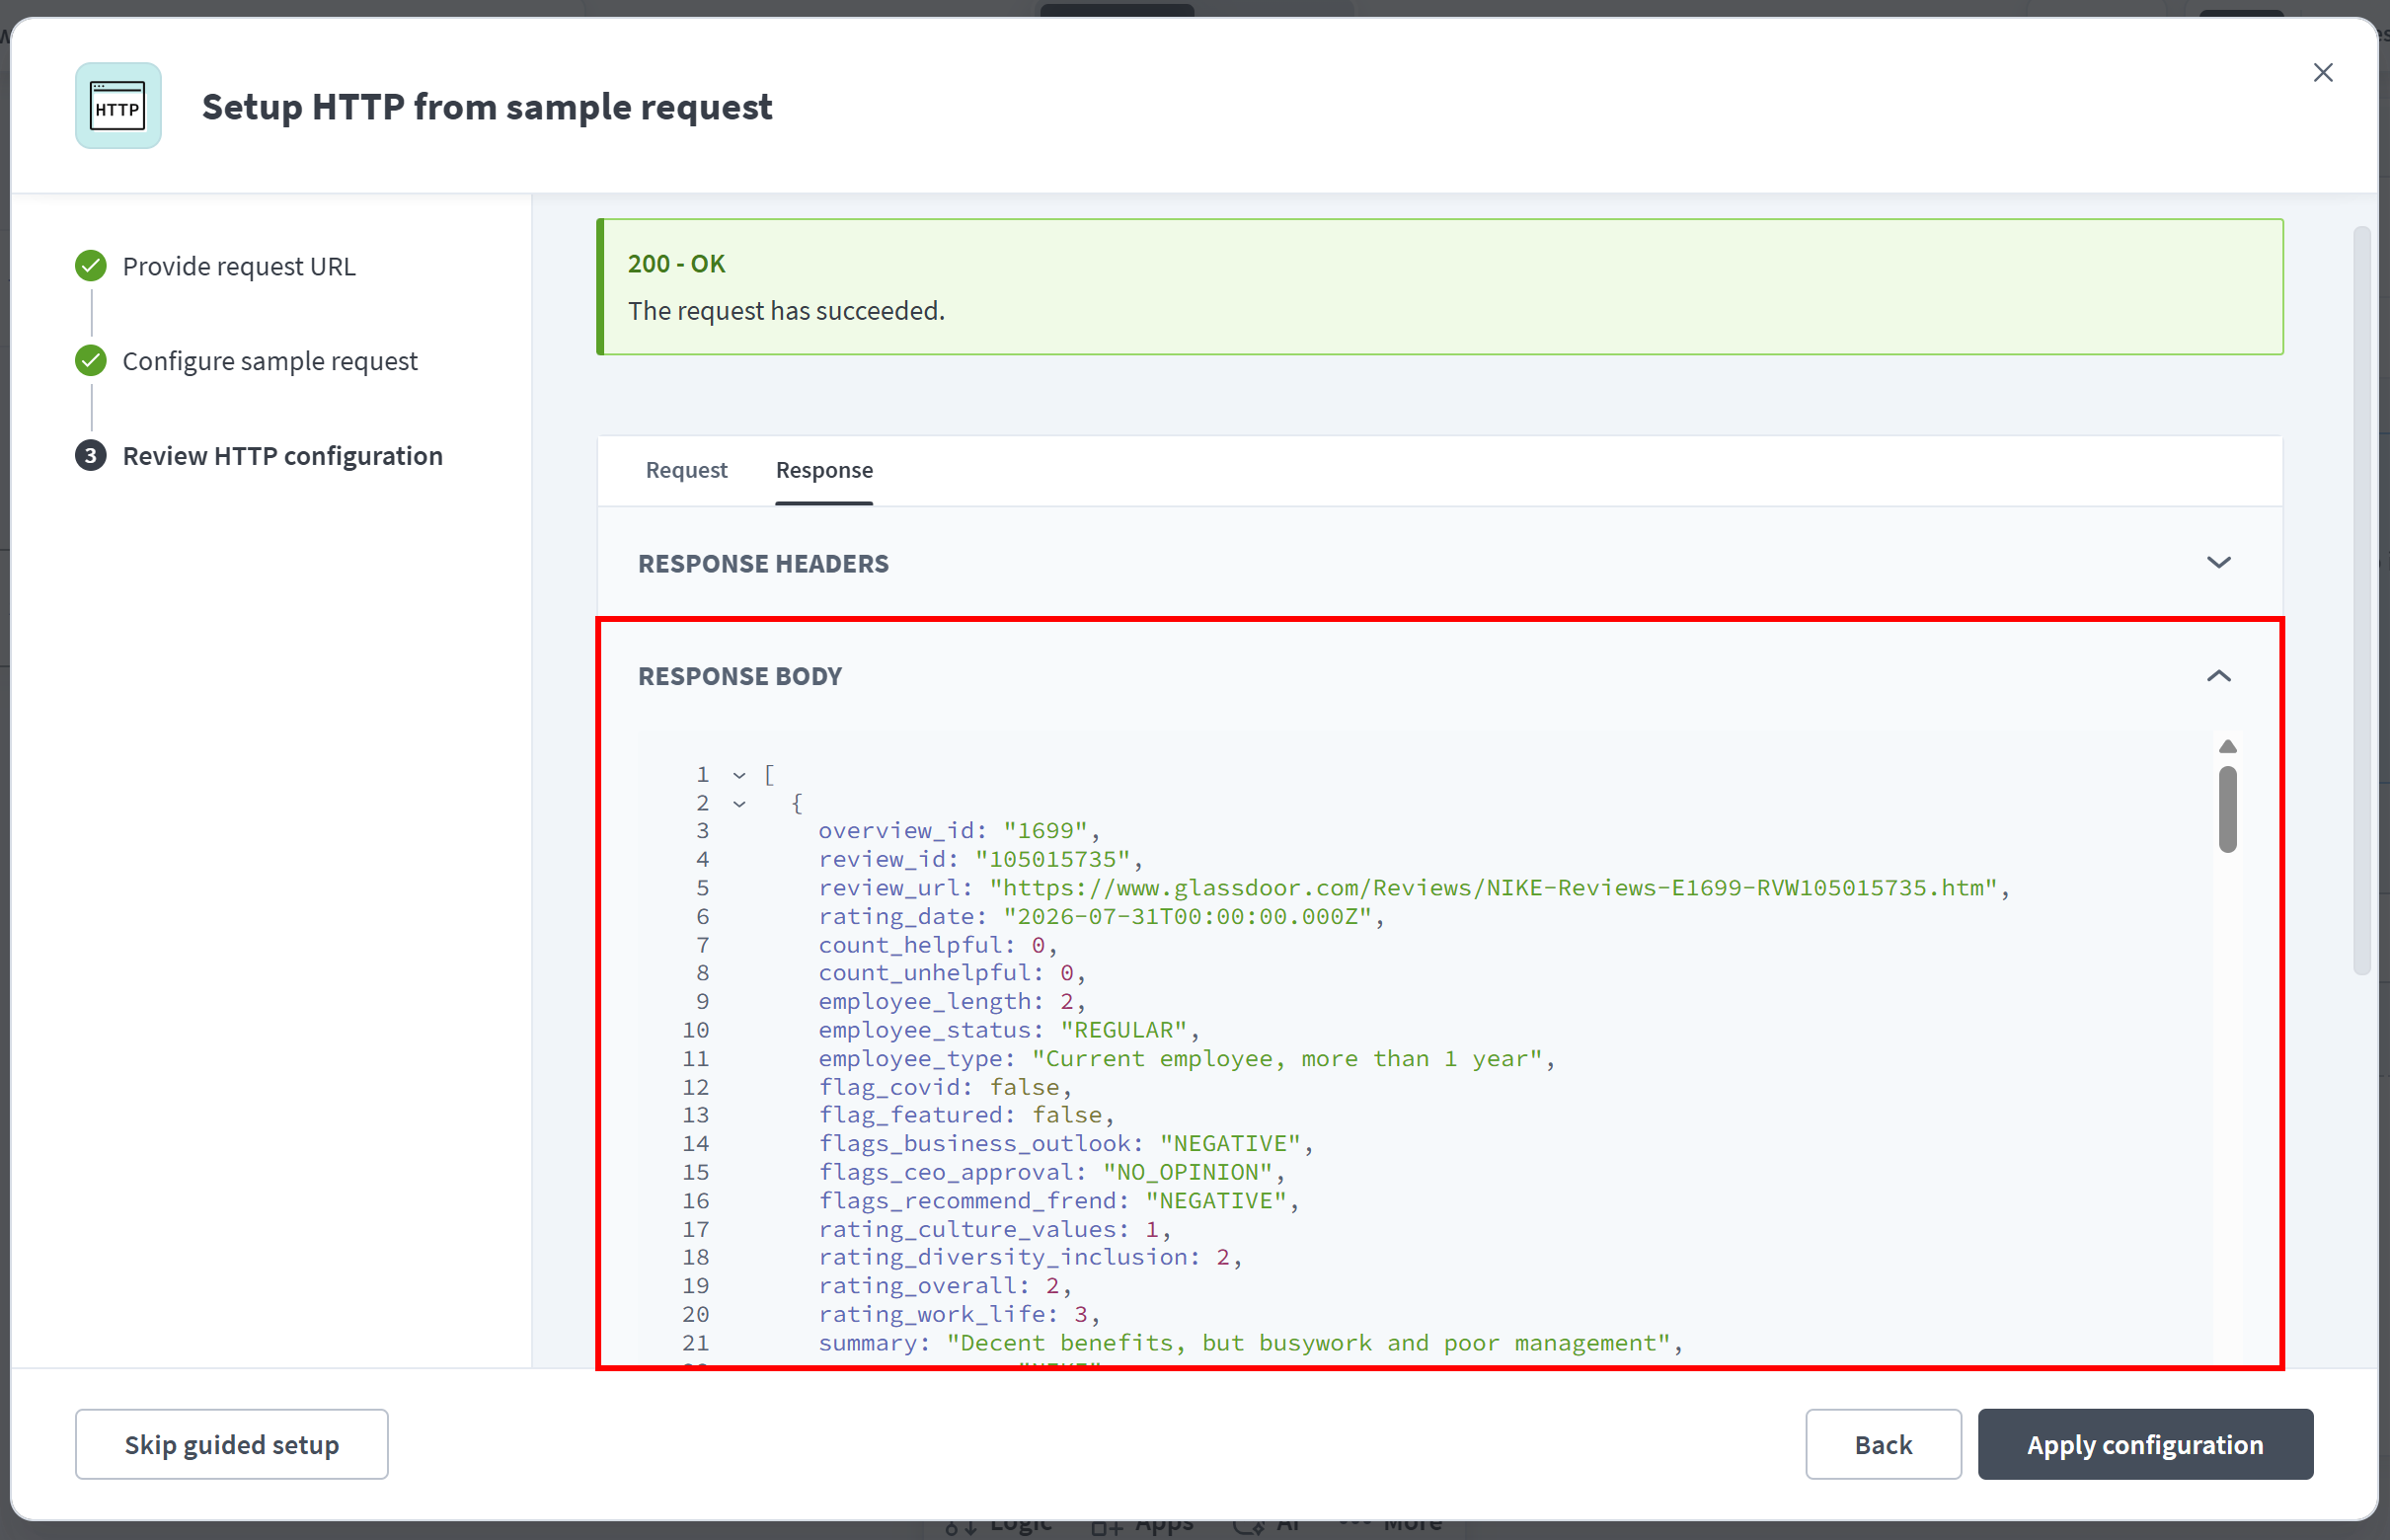
单击“应用配置”以完成引导式设置。
返回“HTTP”步骤配置后,你将能够查看 API 调用测试后自动生成的响应架构。在“设置”选项中,确保将“等待响应”选项设置为“是”:
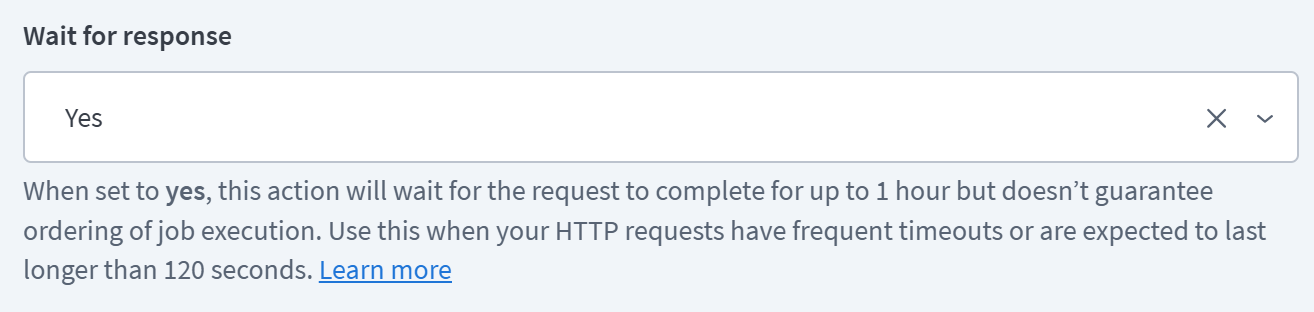
这样,Workato 会等待 Bright Data API 返回抓取的数据,然后再执行配方中的下一步。
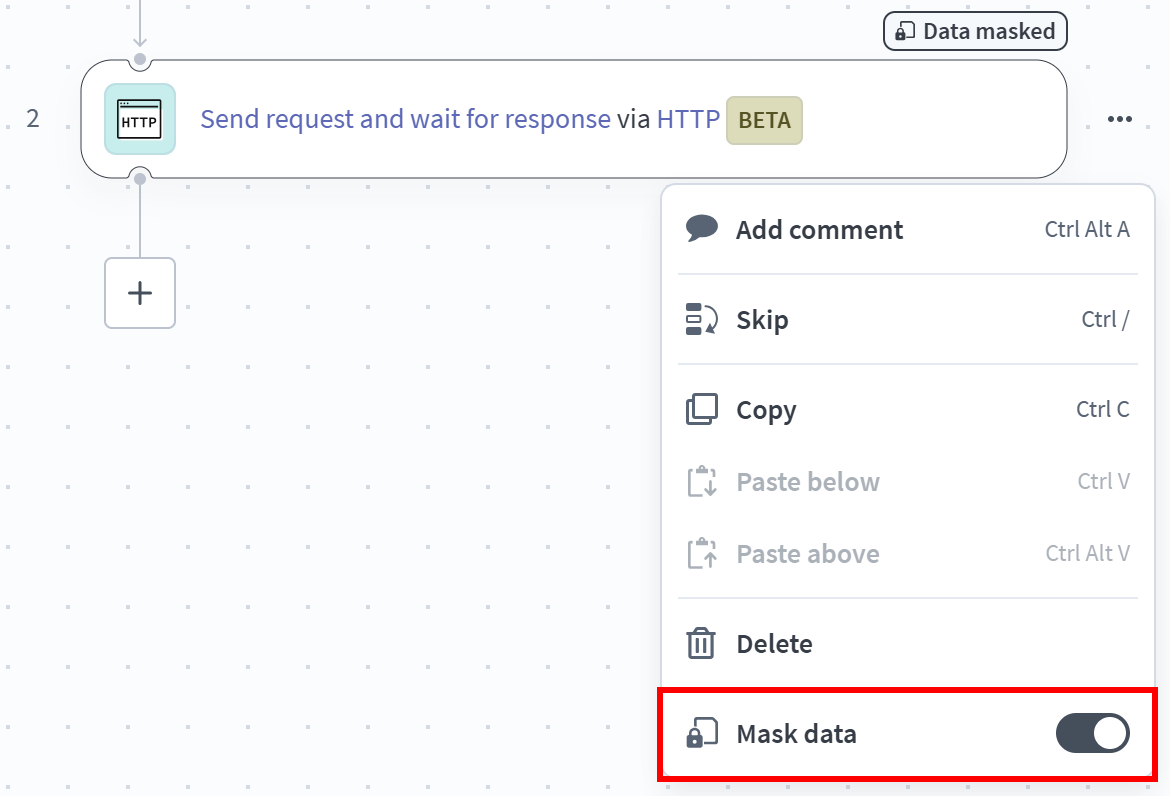
最后,请记住,此“HTTP”步骤包含你的 Bright Data API 密钥。为避免其暴露在配方日志或任务报告中,请将其存储为密钥或者单击 HTTP 步骤上的“…”菜单并开启“屏蔽数据”:
非常好!你的 Workato 配方现已成功连接到 Bright Data Glassdoor 评价爬虫 API。
第 4 步:配置 OpenAI 步骤
Workato 配方现在可以通过 Bright Data API 检索抓取的网页数据。接下来,你可以将这些数据发送给 OpenAI 模型进行分析。
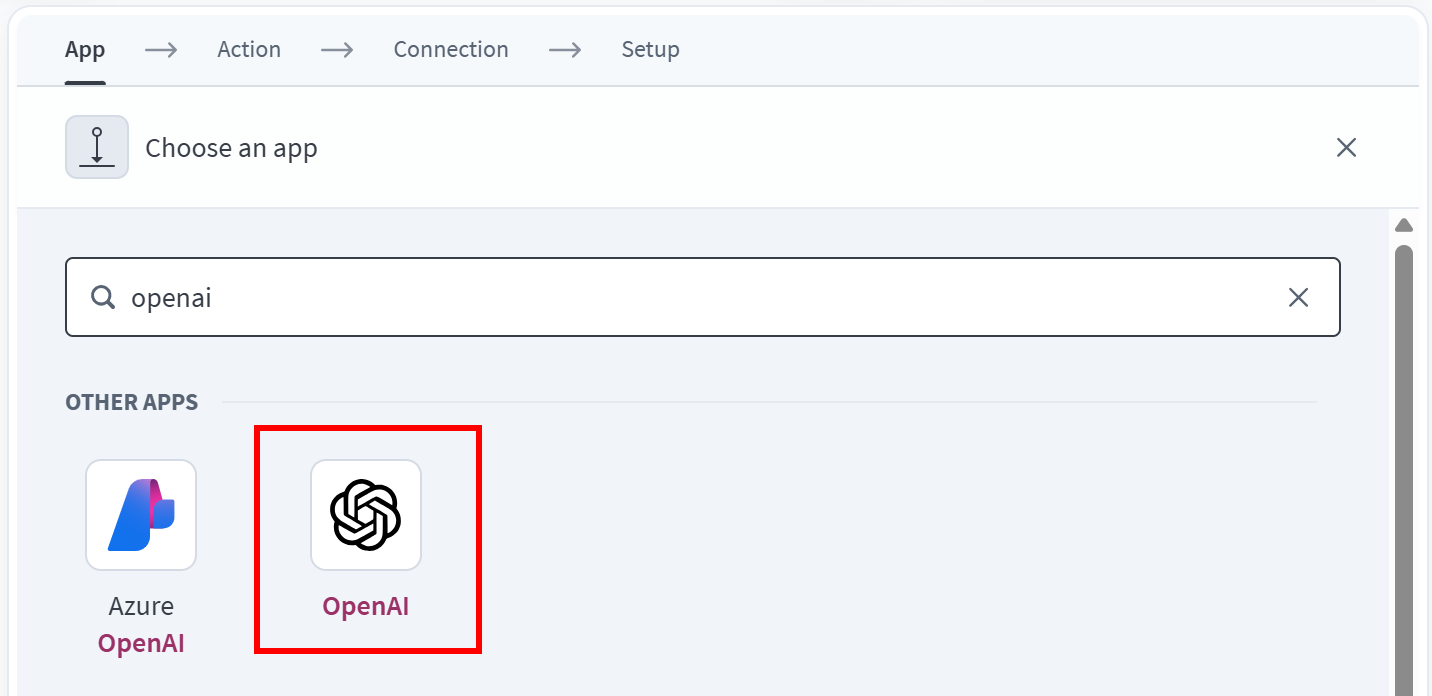
再次单击“+”,添加一个新应用,搜索“openai”,然后选择“OpenAI”应用:
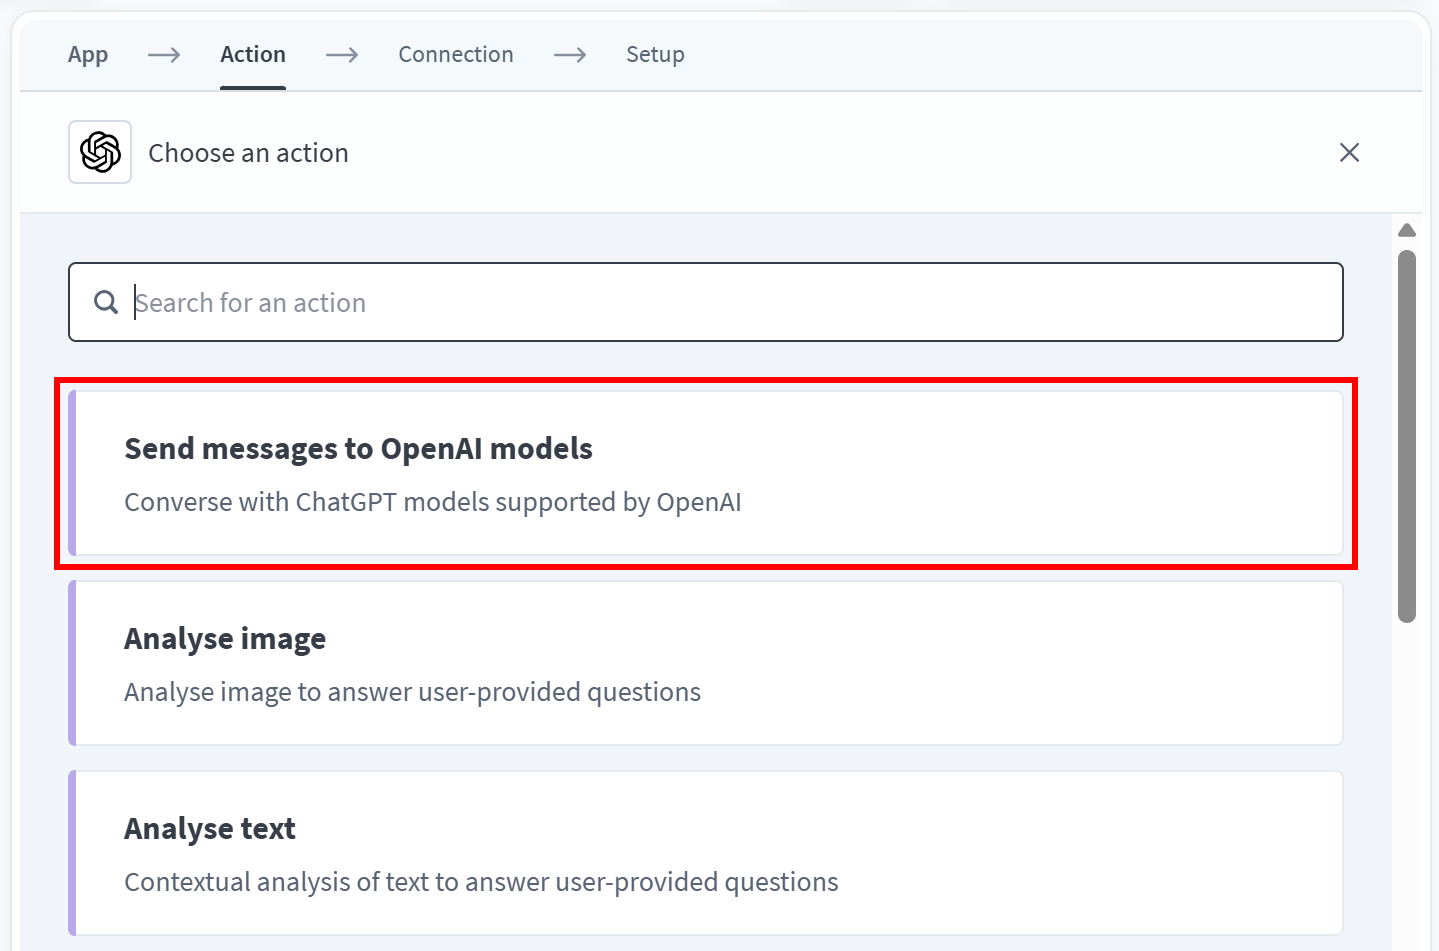
选择“向 OpenAI 模型发送消息”操作,以便你的配方向 OpenAI 模型发送提示词并接收响应:
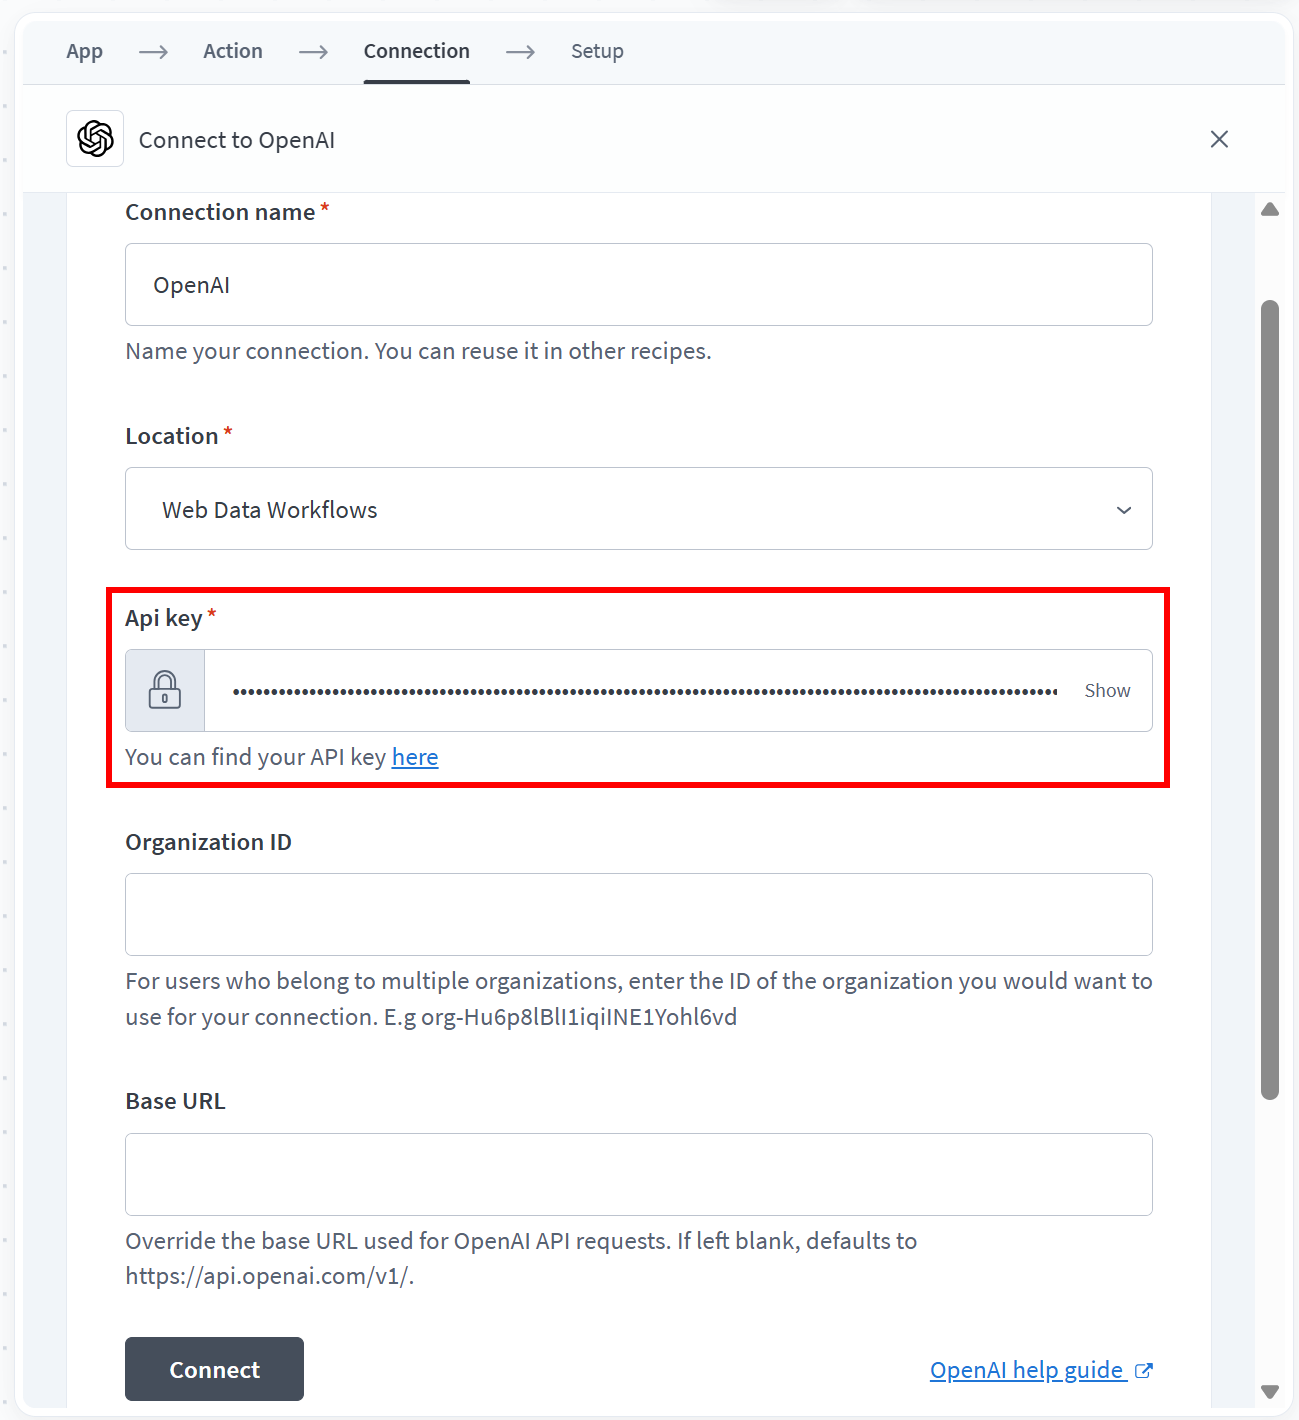
创建连接时,将你的 OpenAI API 密钥粘贴到相应字段中,然后单击“连接”:
接下来,选择“单条消息”模式(因为你要向 LLM 发送一个提示词)。在“要发送的文本”中切换到“公式”模式,然后粘贴以下提示词:
"Given the following Glassdoor reviews, generate a concise yet comprehensive HTML email report summarizing recent user reviews, highlighting key trends, recurring themes, sentiment, and notable feedback.

GLASSDOOR REVIEWS:" + <response_array_text_data>
将 <response_array_text_data> 占位符替换为上一个“HTTP”步骤中的“发送请求 > 响应 > 数组”输出,以便模型接收抓取的评价数据。由于响应是一个数组,请调用 join(";") 方法,将所有评价对象连接成一个字符串,然后再发送给 LLM。
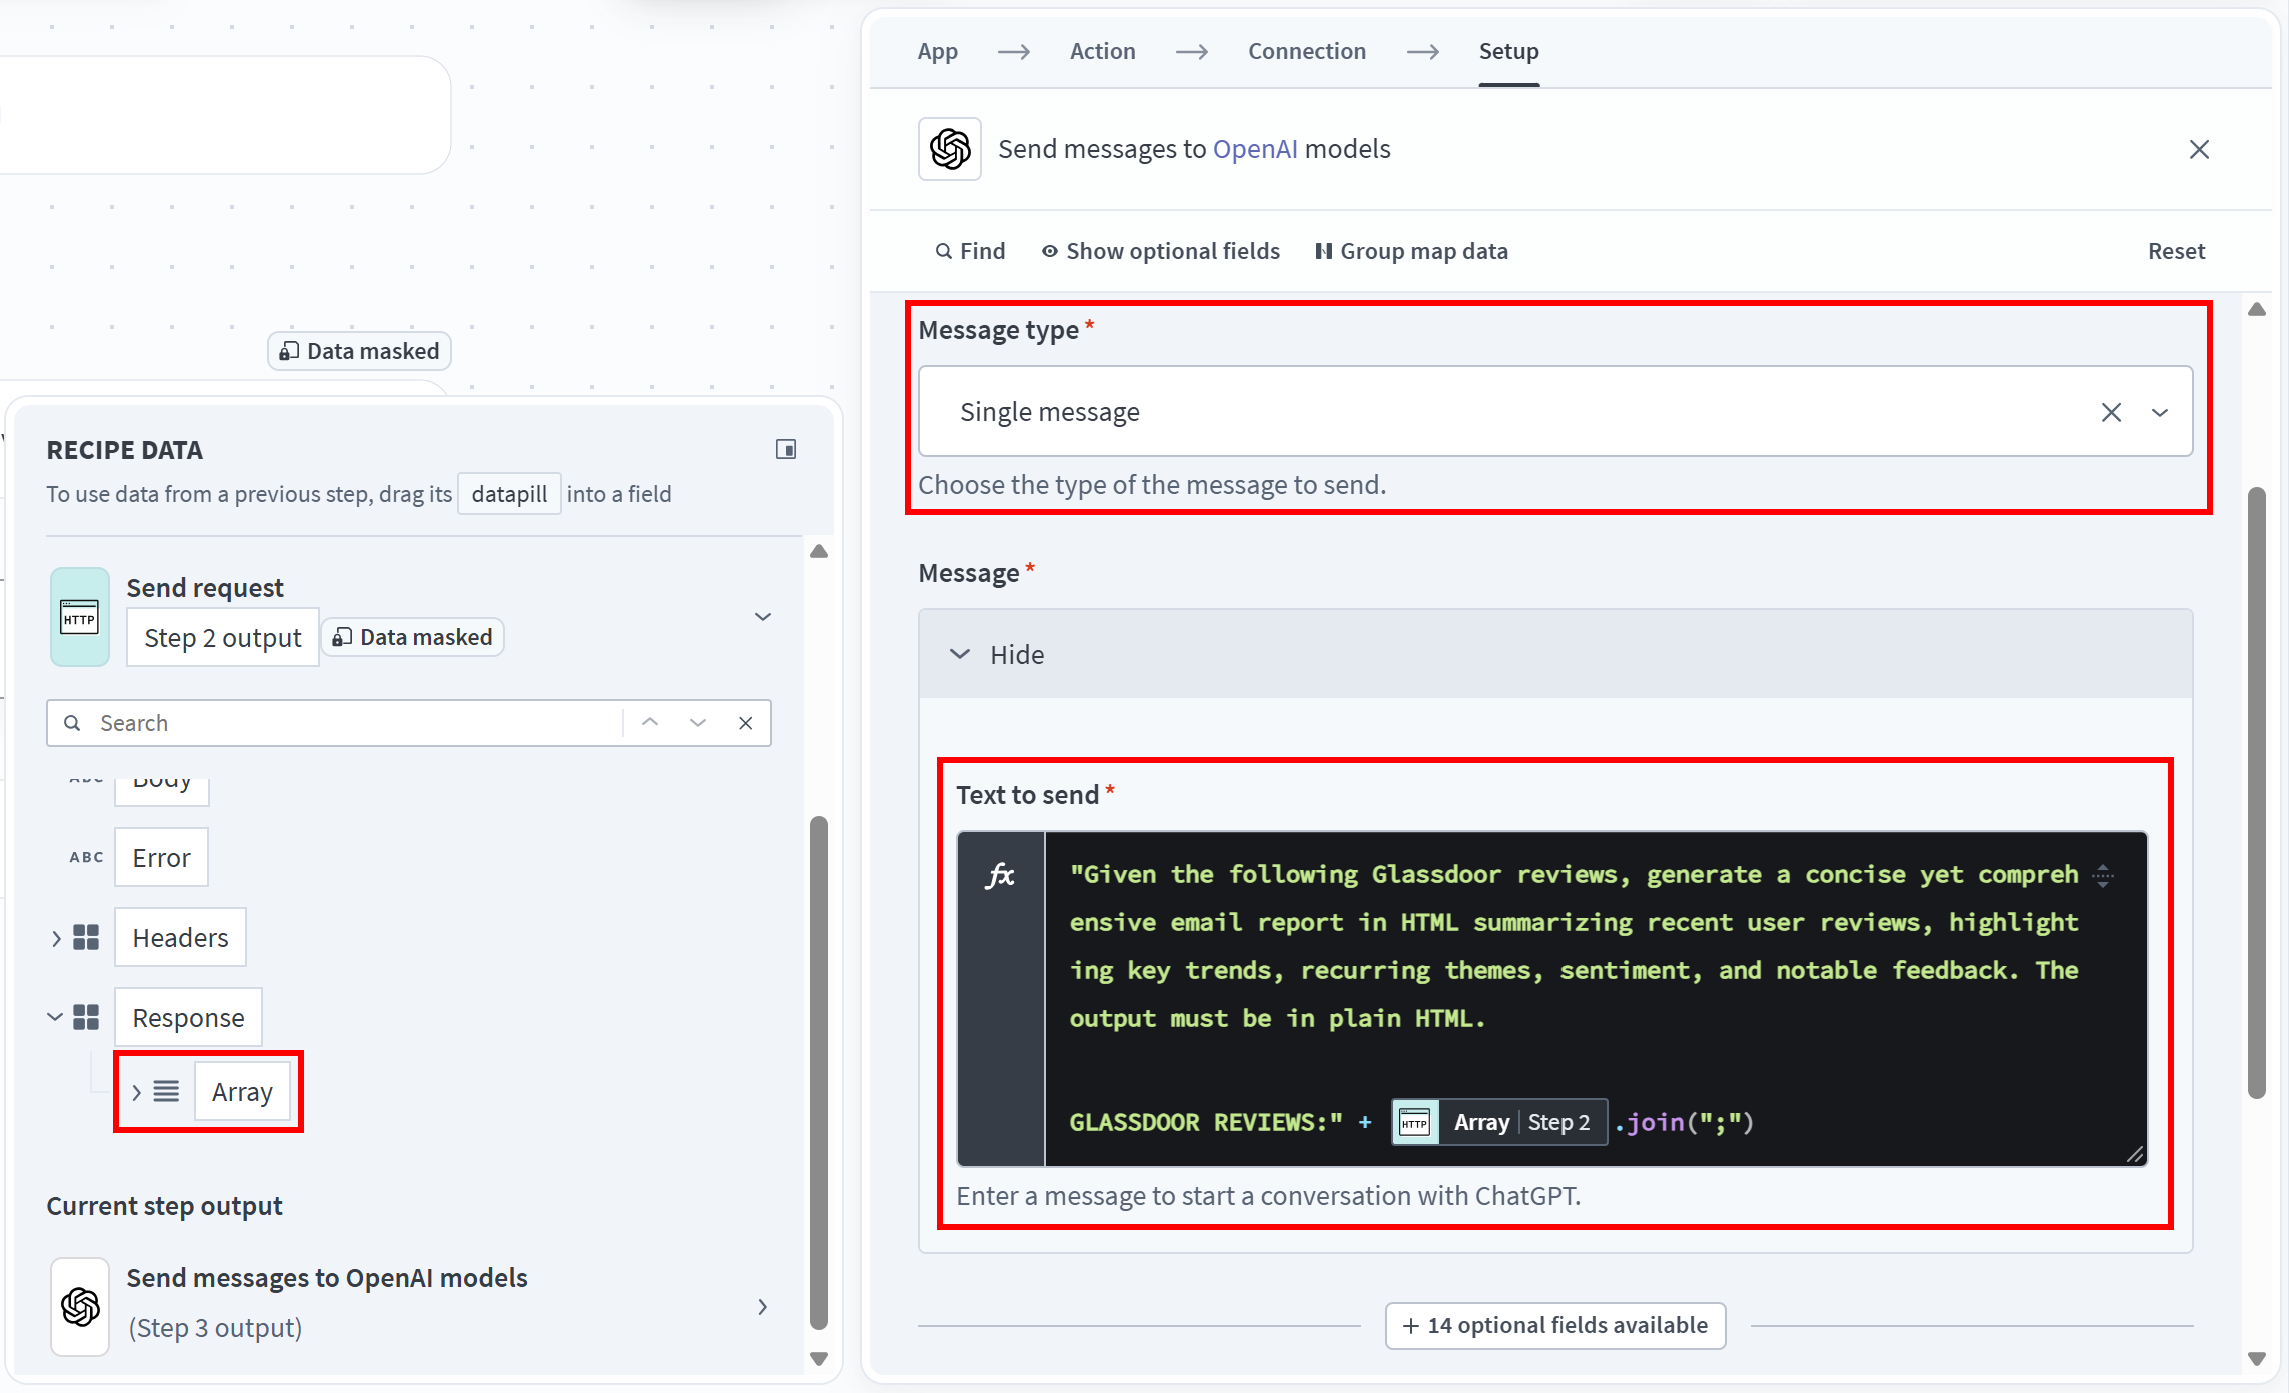
请注意,该提示词明确要求返回 HTML 响应。这是有意为之,因为生成的内容稍后将通过电子邮件发送,而电子邮件协议支持 HTML 格式的内容。
注意:在撰写本文时,Workato 的“OpenAI”步骤默认使用 GPT-4o。
很好!你的 Workato 配方现在可以通过 OpenAI 模型处理及时更新的网页数据,并生成由 AI 驱动的 HTML 报告。
第 5 步:添加 Gmail 集成
最后一步是通过电子邮件发送 AI 生成的报告。单击“+”,添加“Gmail”应用,然后选择“发送电子邮件”操作:
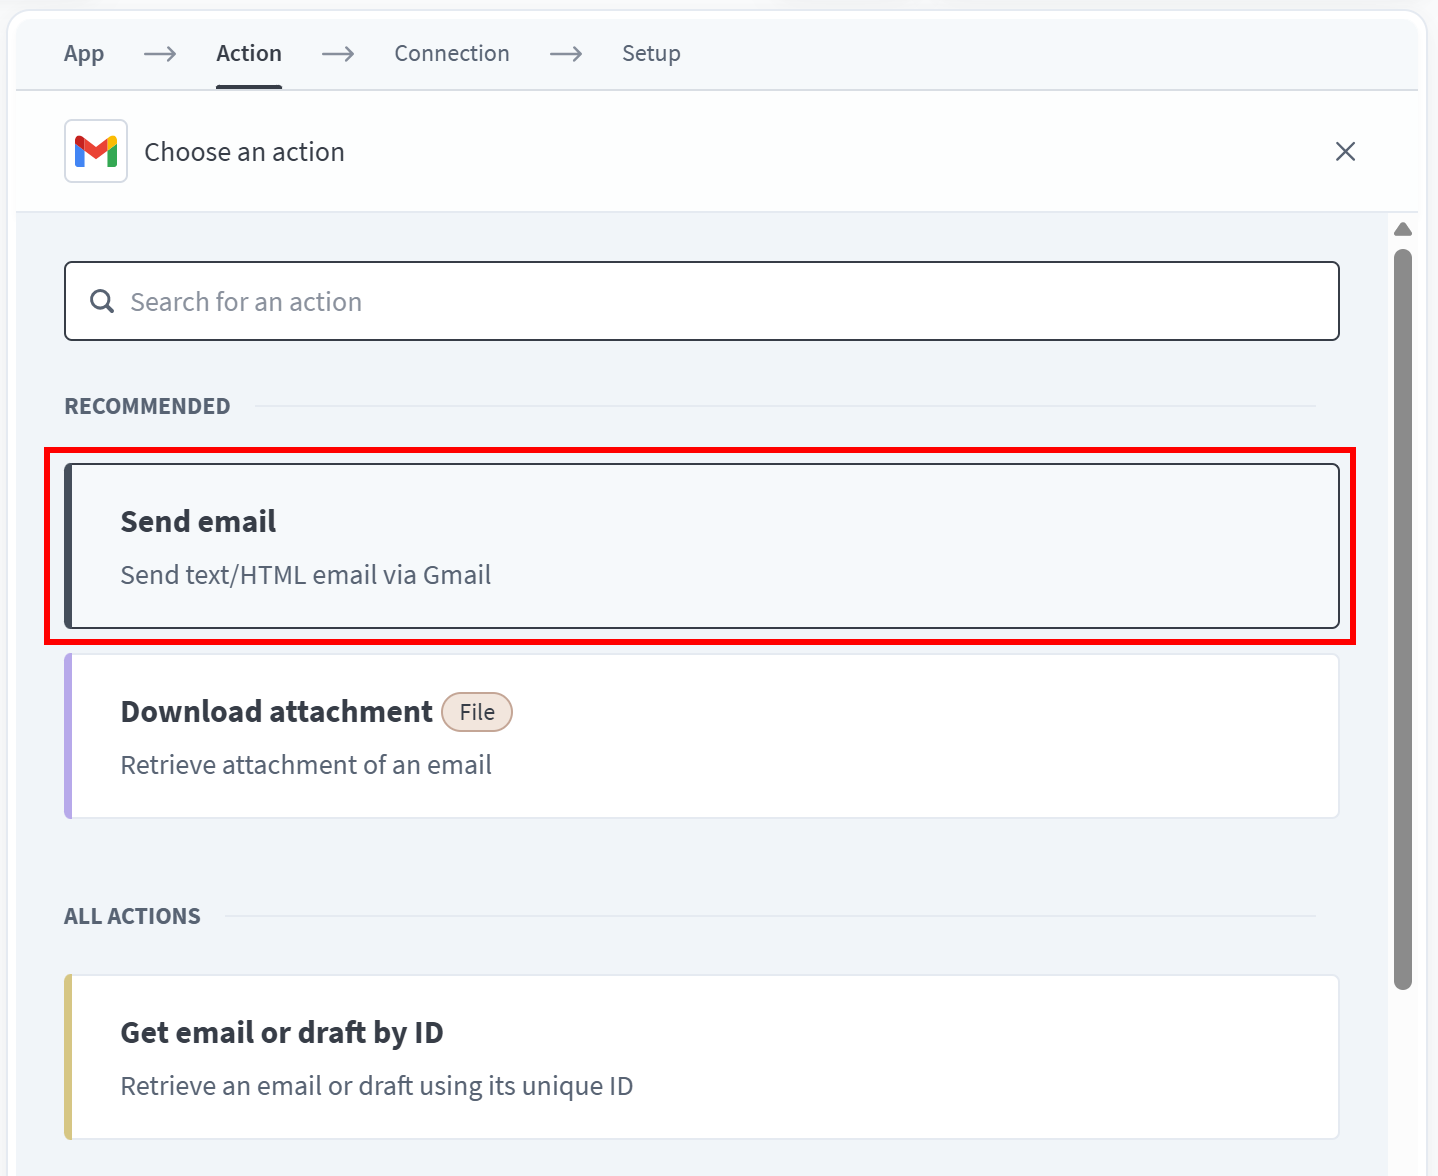
单击“登录 Google”,将你的 Google 账户连接到 Workato。授予所请求的权限以授权该集成。
然后,按如下方式配置“通过 Gmail 发送电子邮件”步骤:
- 收件人:收件人的电子邮件地址
- 主题:
Glassdoor review analysis report(或类似标题) - 电子邮件类型:
HTML - 消息:从“向 OpenAI 模型发送消息”步骤中选择“最佳选择”配方数据输出。
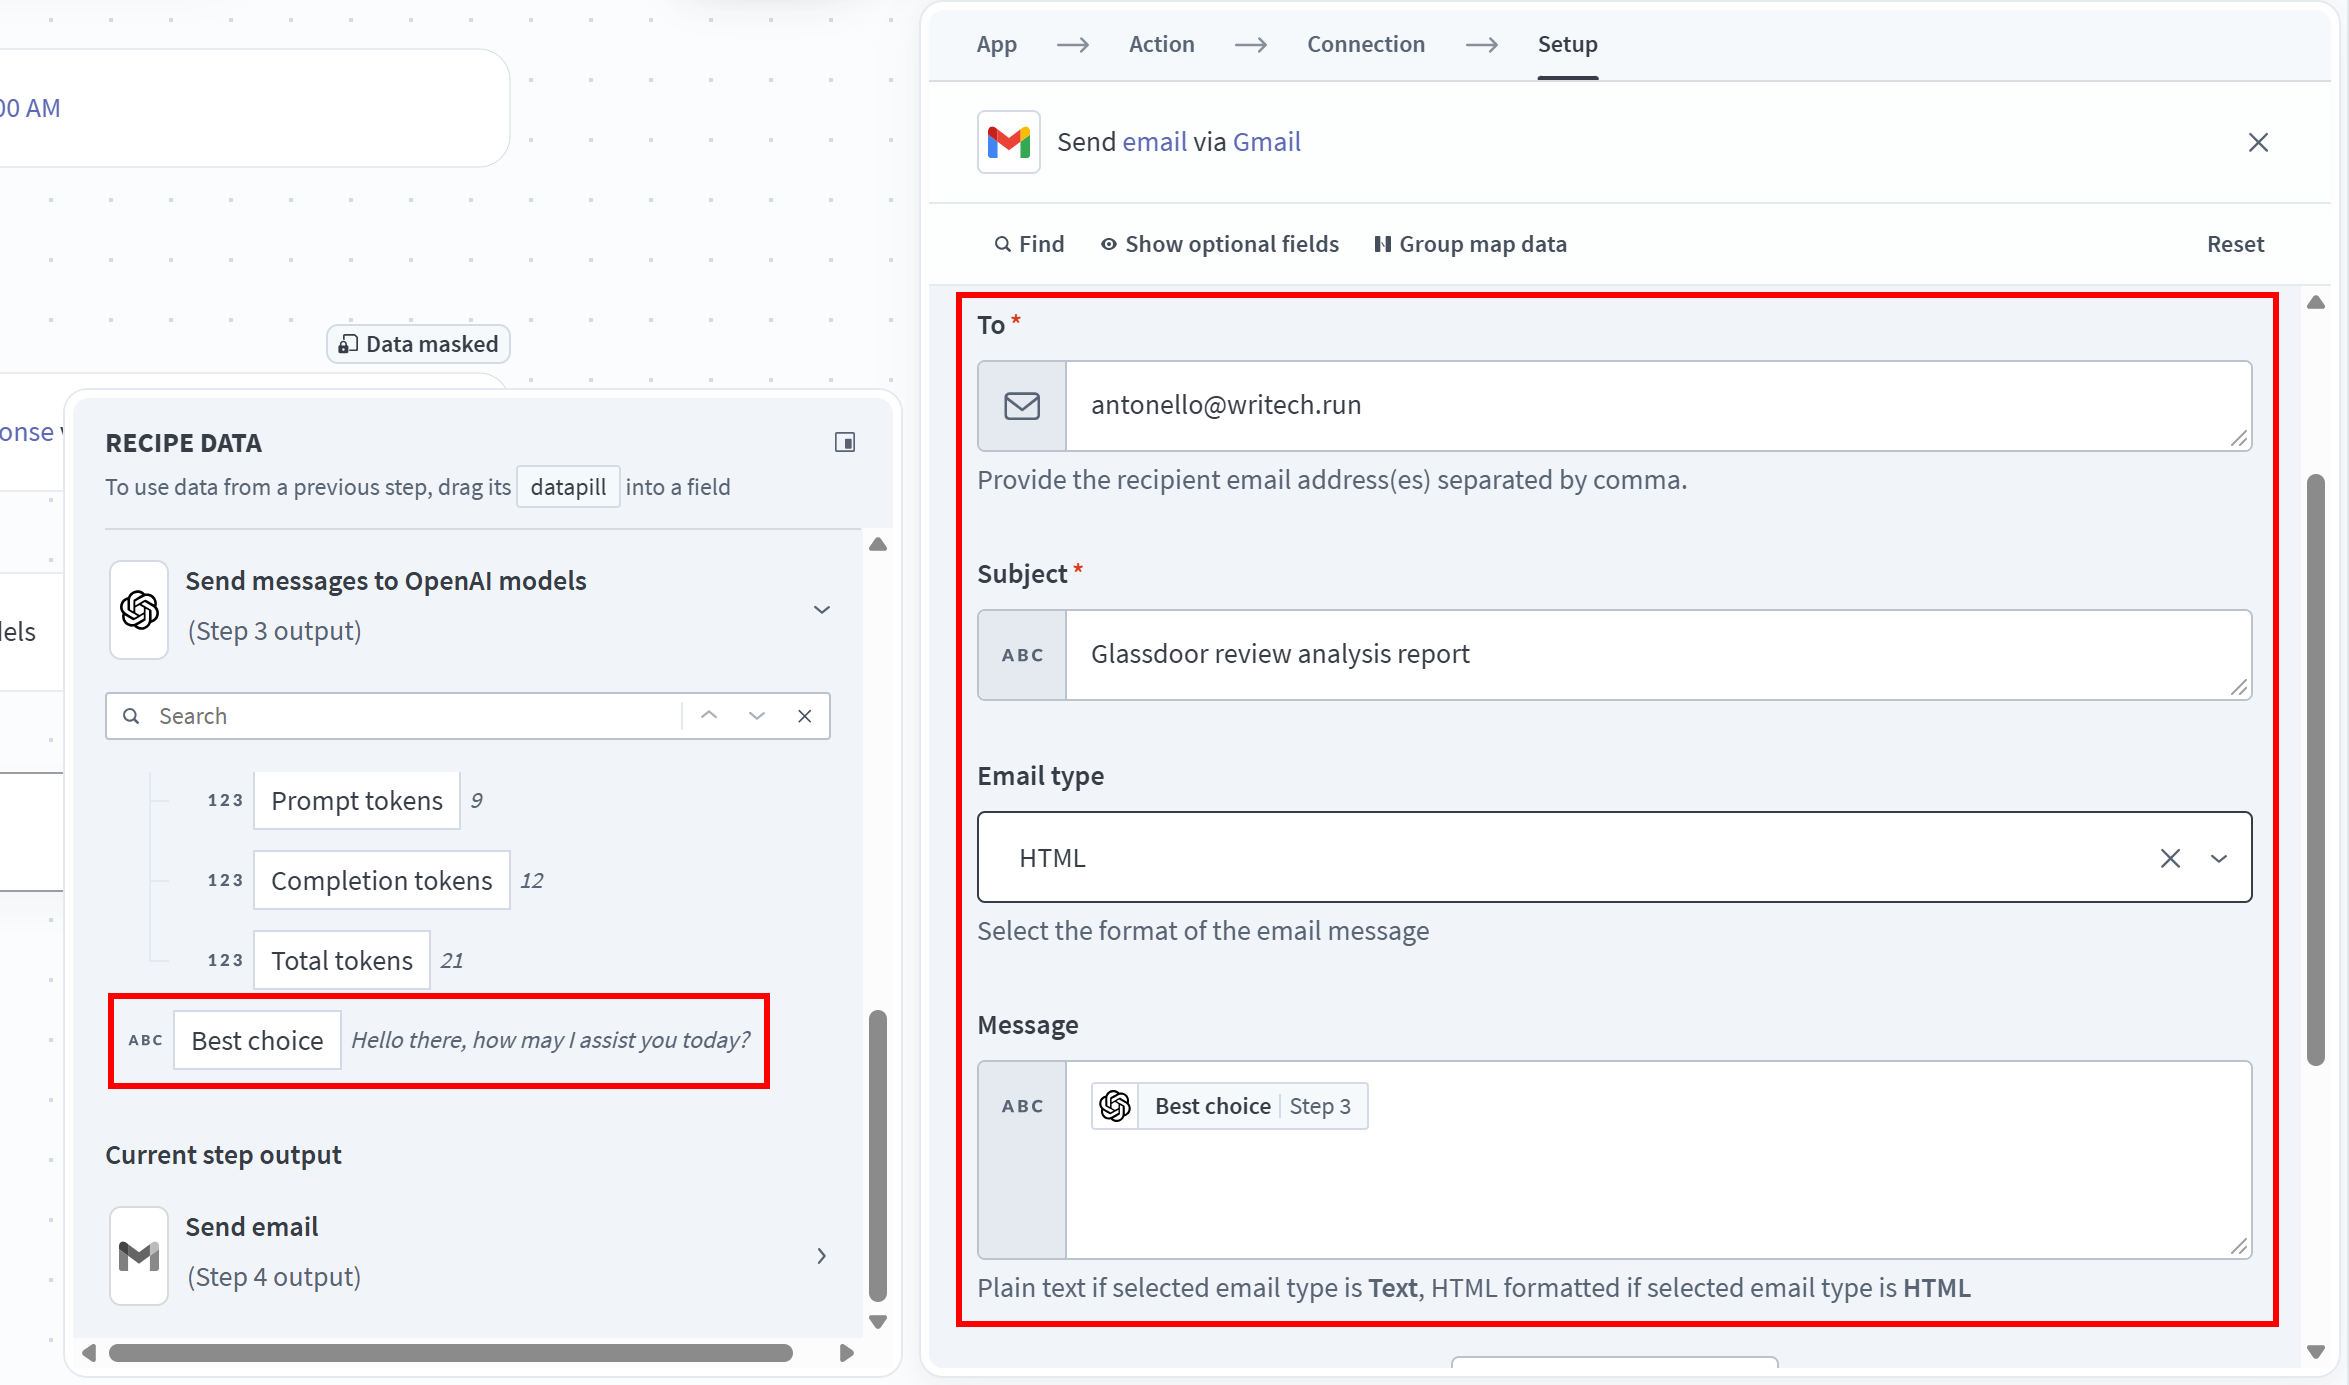
注意:“最佳选择”配方数据包含 OpenAI 模型在上一步中生成的 HTML 报告。
很好!Workato 配方已完成。
第 6 步:运行配方
最终的 Workato 配方应类似如下:
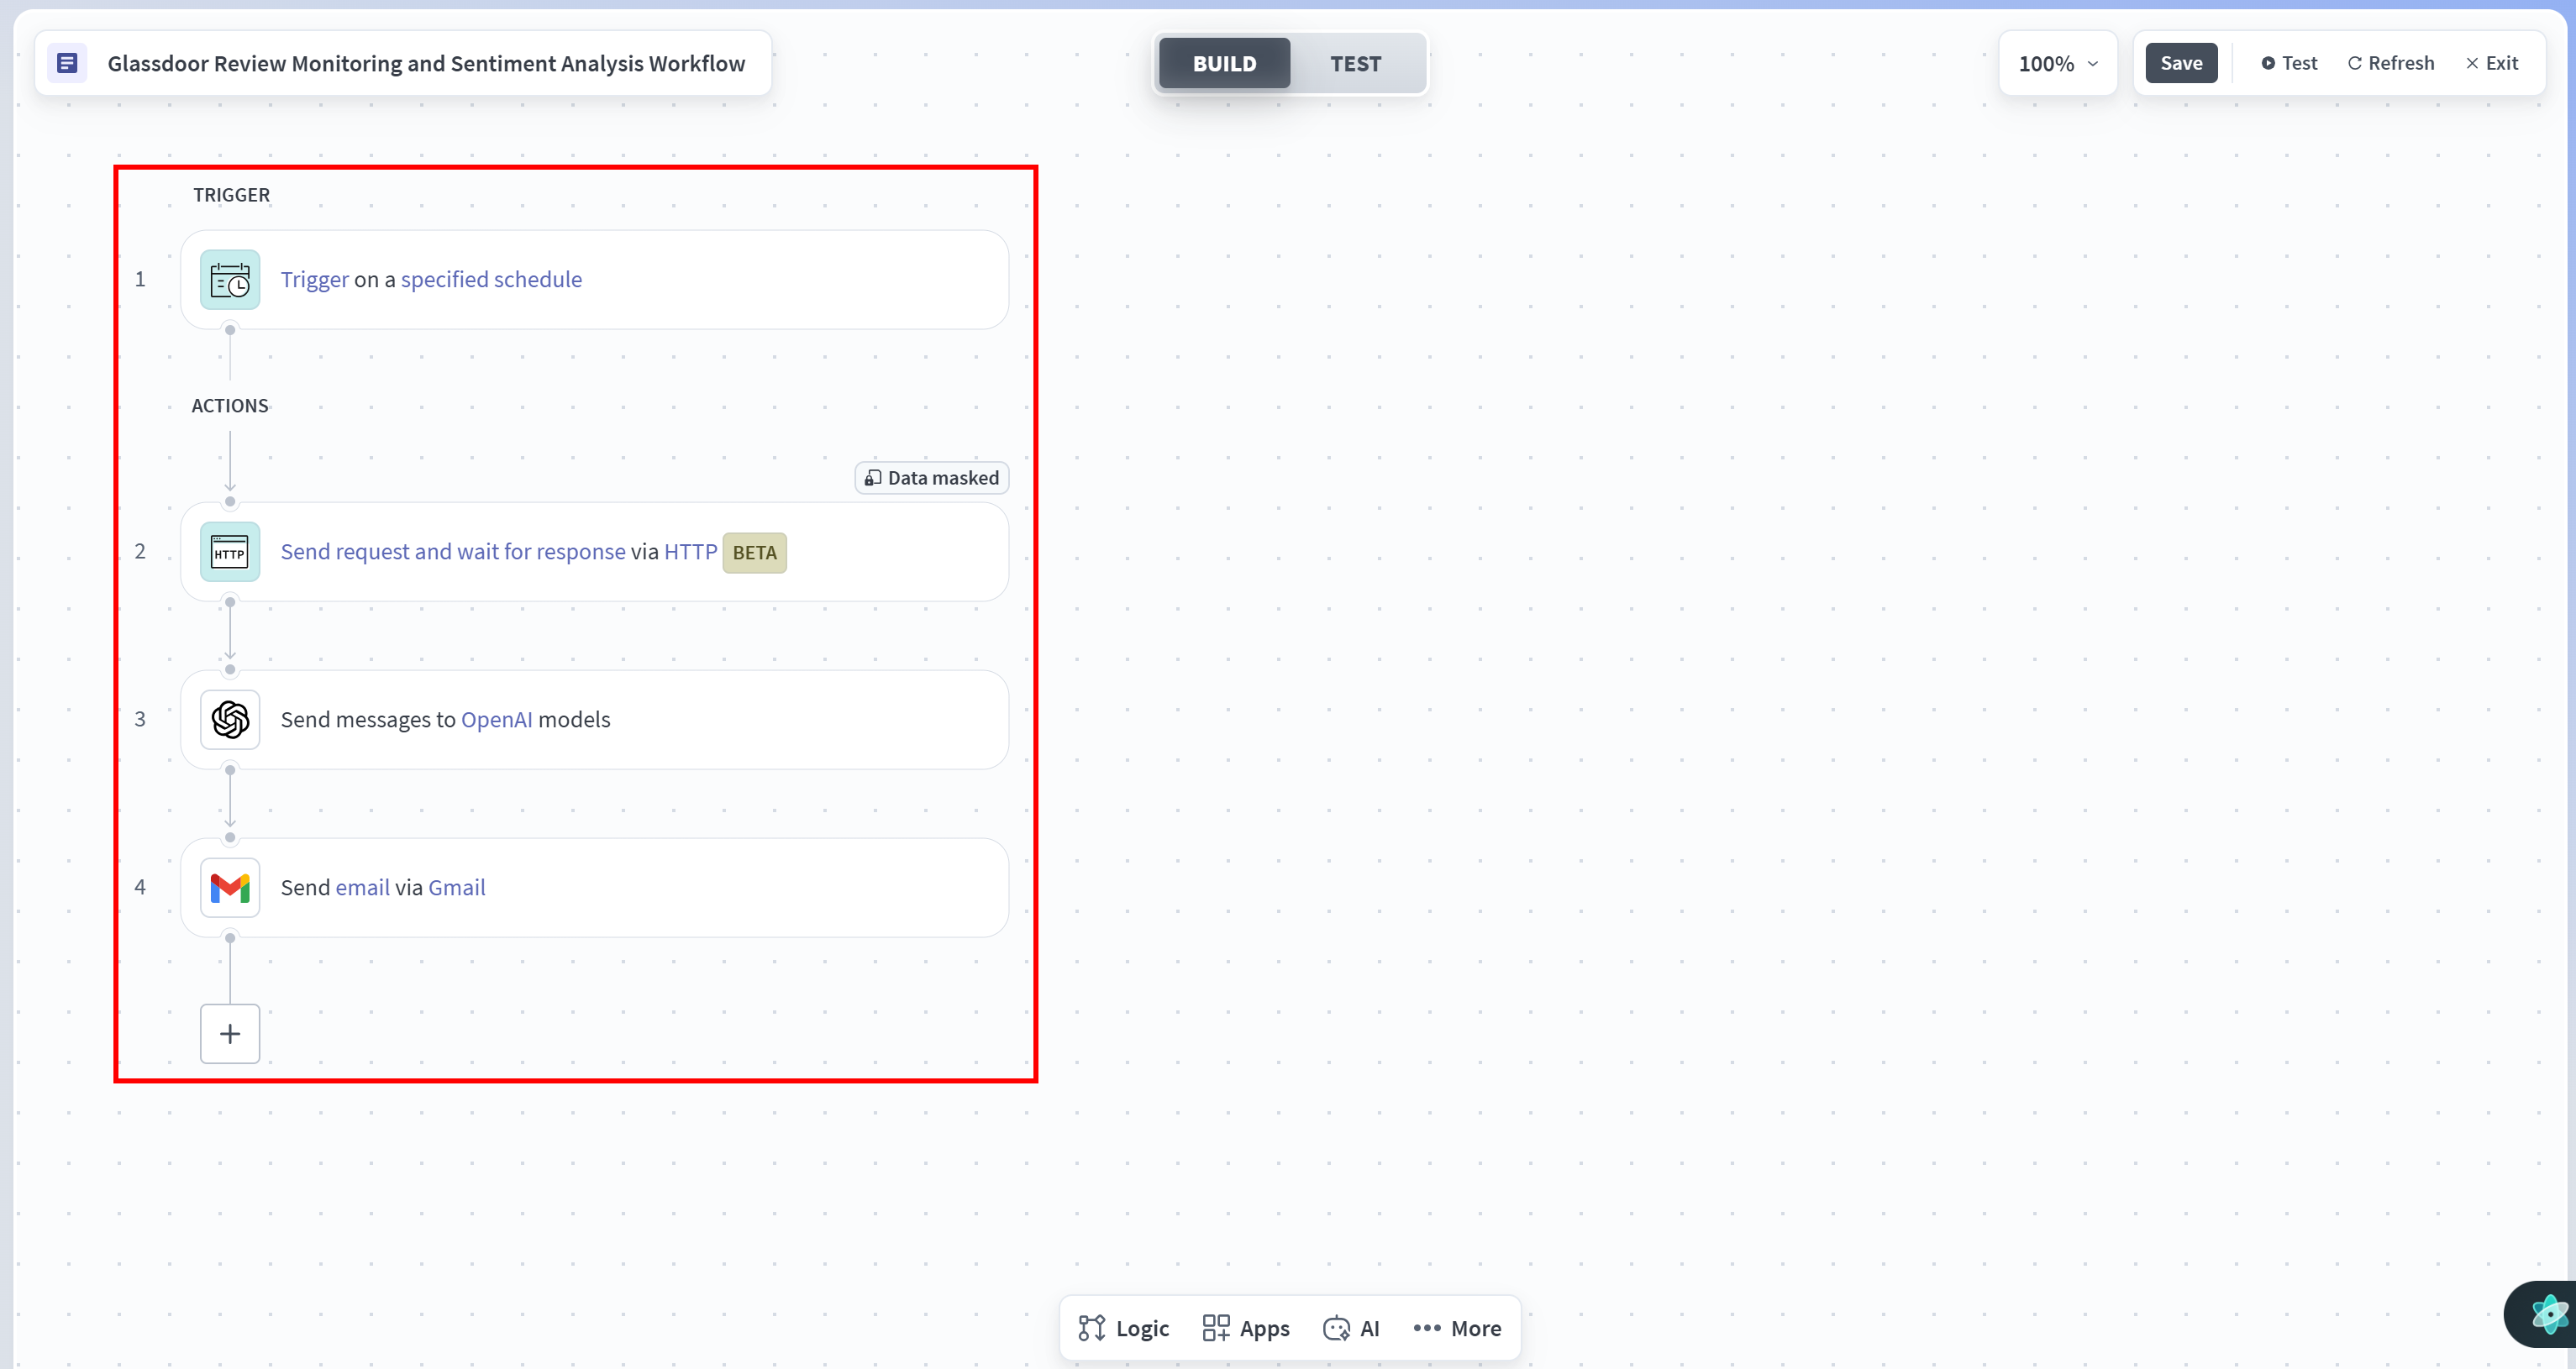
打开“测试”选项卡,然后单击“测试配方”以执行工作流。你将看到以下结果:
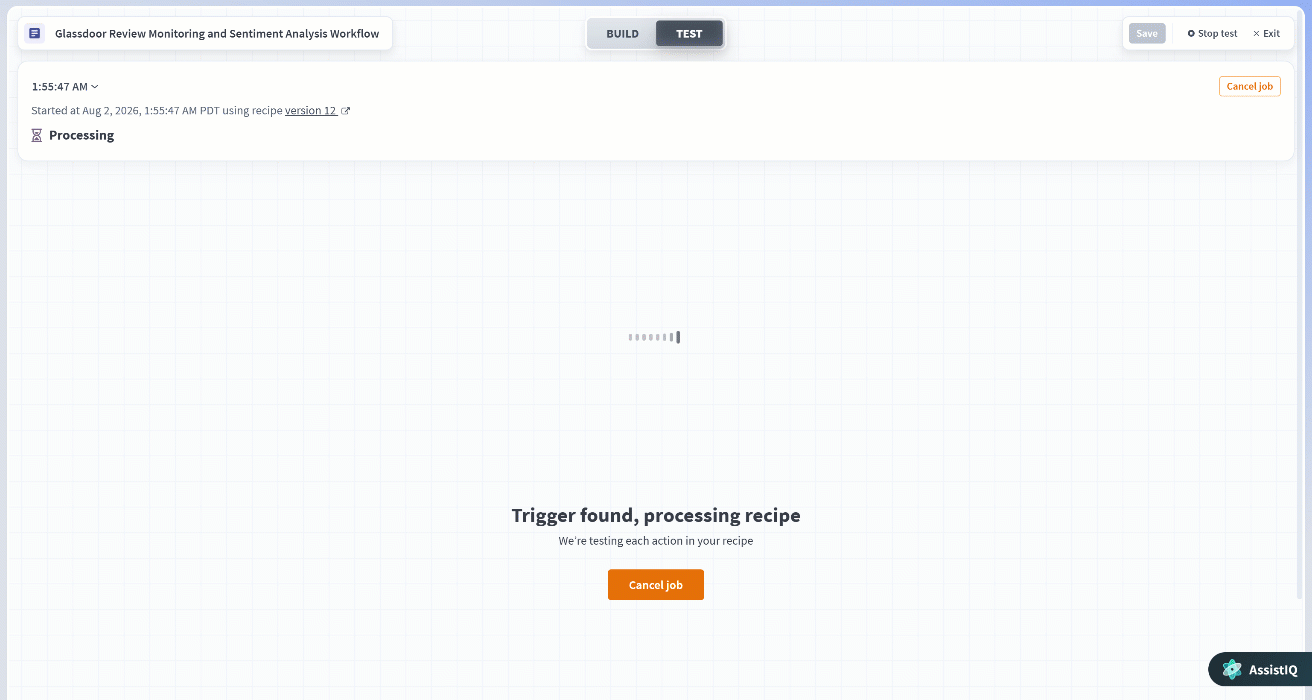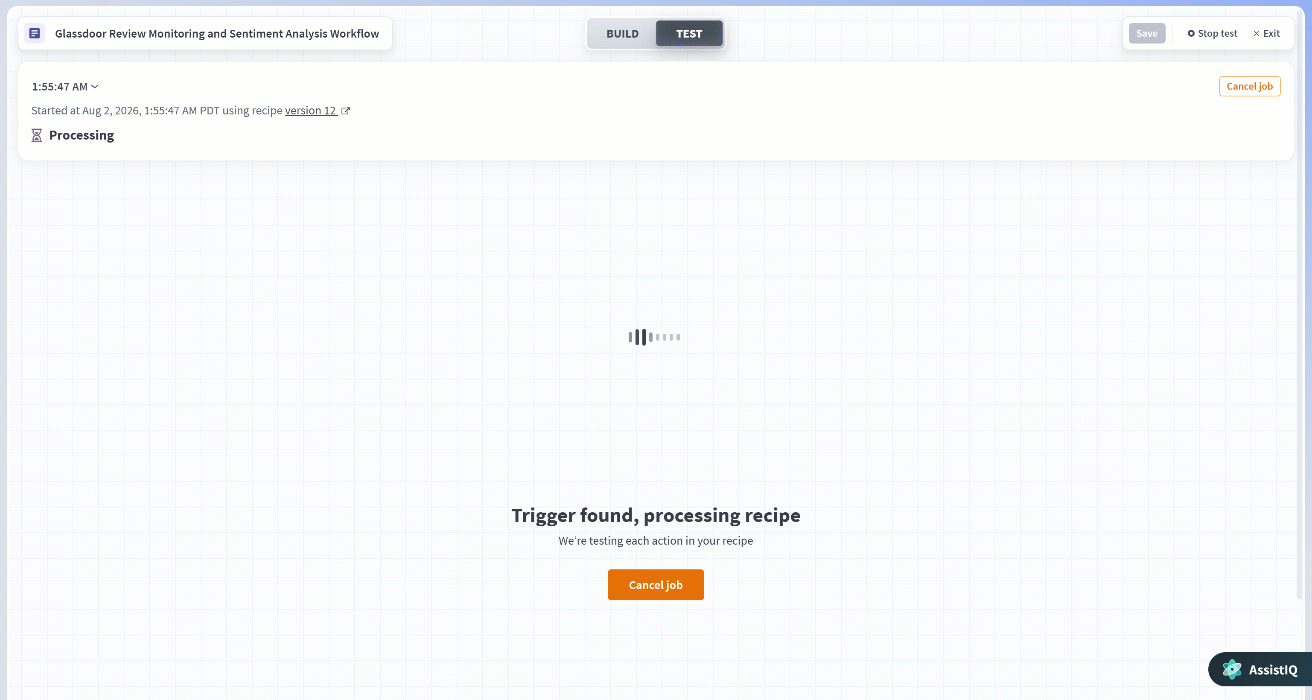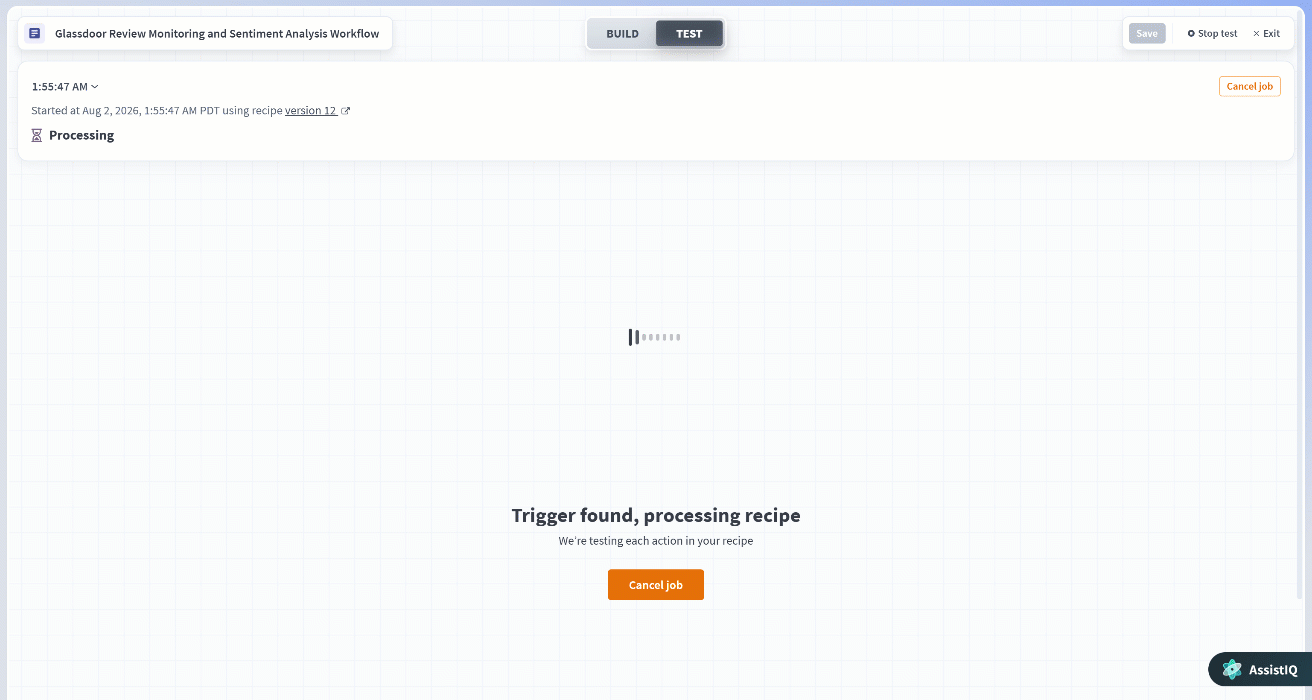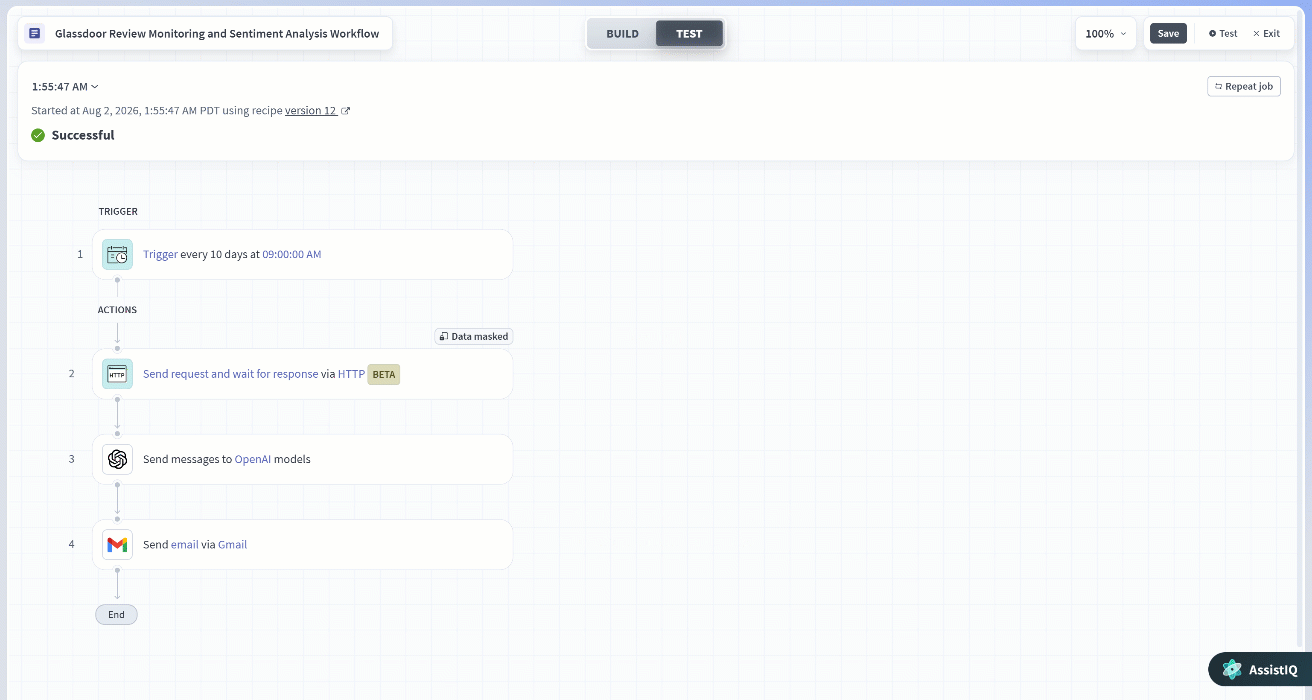
执行期间,Workato 将:
- 触发定时工作流。
- 调用 Bright Data Glassdoor 评价爬虫 API。
- 将检索到的评价传递给 OpenAI 进行分析并生成 HTML 报告。
- 通过 Gmail 发送报告。
要验证工作流使用的是来自 Glassdoor 的评价数据,请检查“OpenAI”步骤的“输入”:
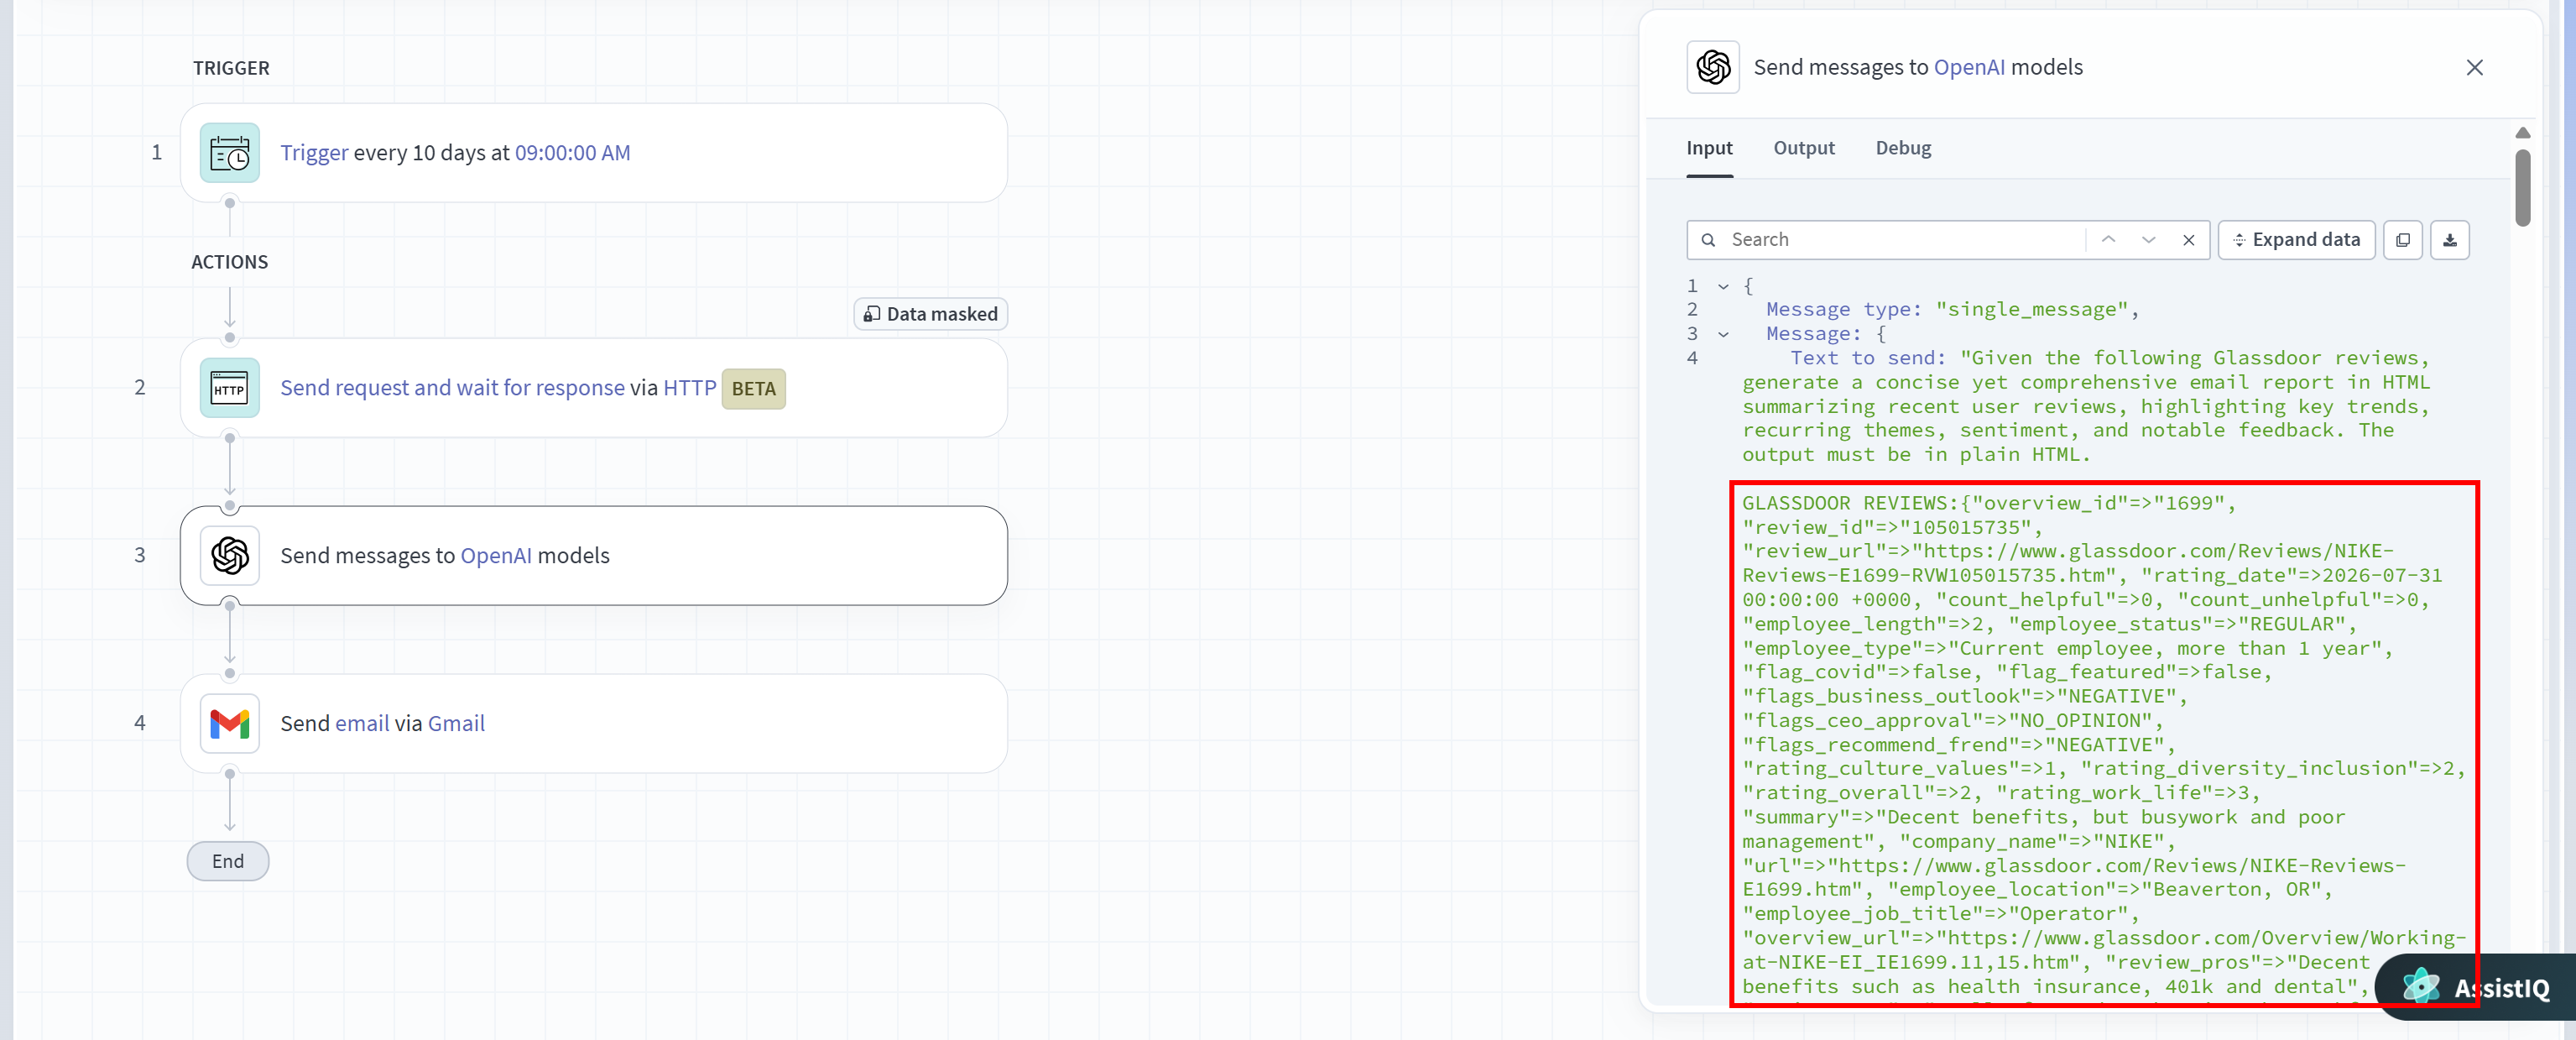
请注意,该提示词包含 Bright Data 抓取工具 API 按需检索的 Glassdoor 评价。这些具有上下文的网页数据可为 LLM 提供事实依据,而不是依赖来自训练数据的陈旧知识。
注意:你可以采用类似方法集成任何其他 Bright Data API。例如,你可以向 Workato 配方添加网页搜索、网页爬取或通用网页抓取功能。
任务完成!你已成功将 Bright Data 与 Workato 集成。通过结合 Workato 的 API 支持和 Bright Data 的网页数据基础设施,你可以构建强大的自动化工作流,从几乎任何网站采集和分析新鲜网页数据,并据此采取行动。
探索 Bright Data API 支持的众多用例,构建更多由 AI 驱动的自动化工作流。
第 7 步:查看生成的输出
最后,查看你的收件箱:
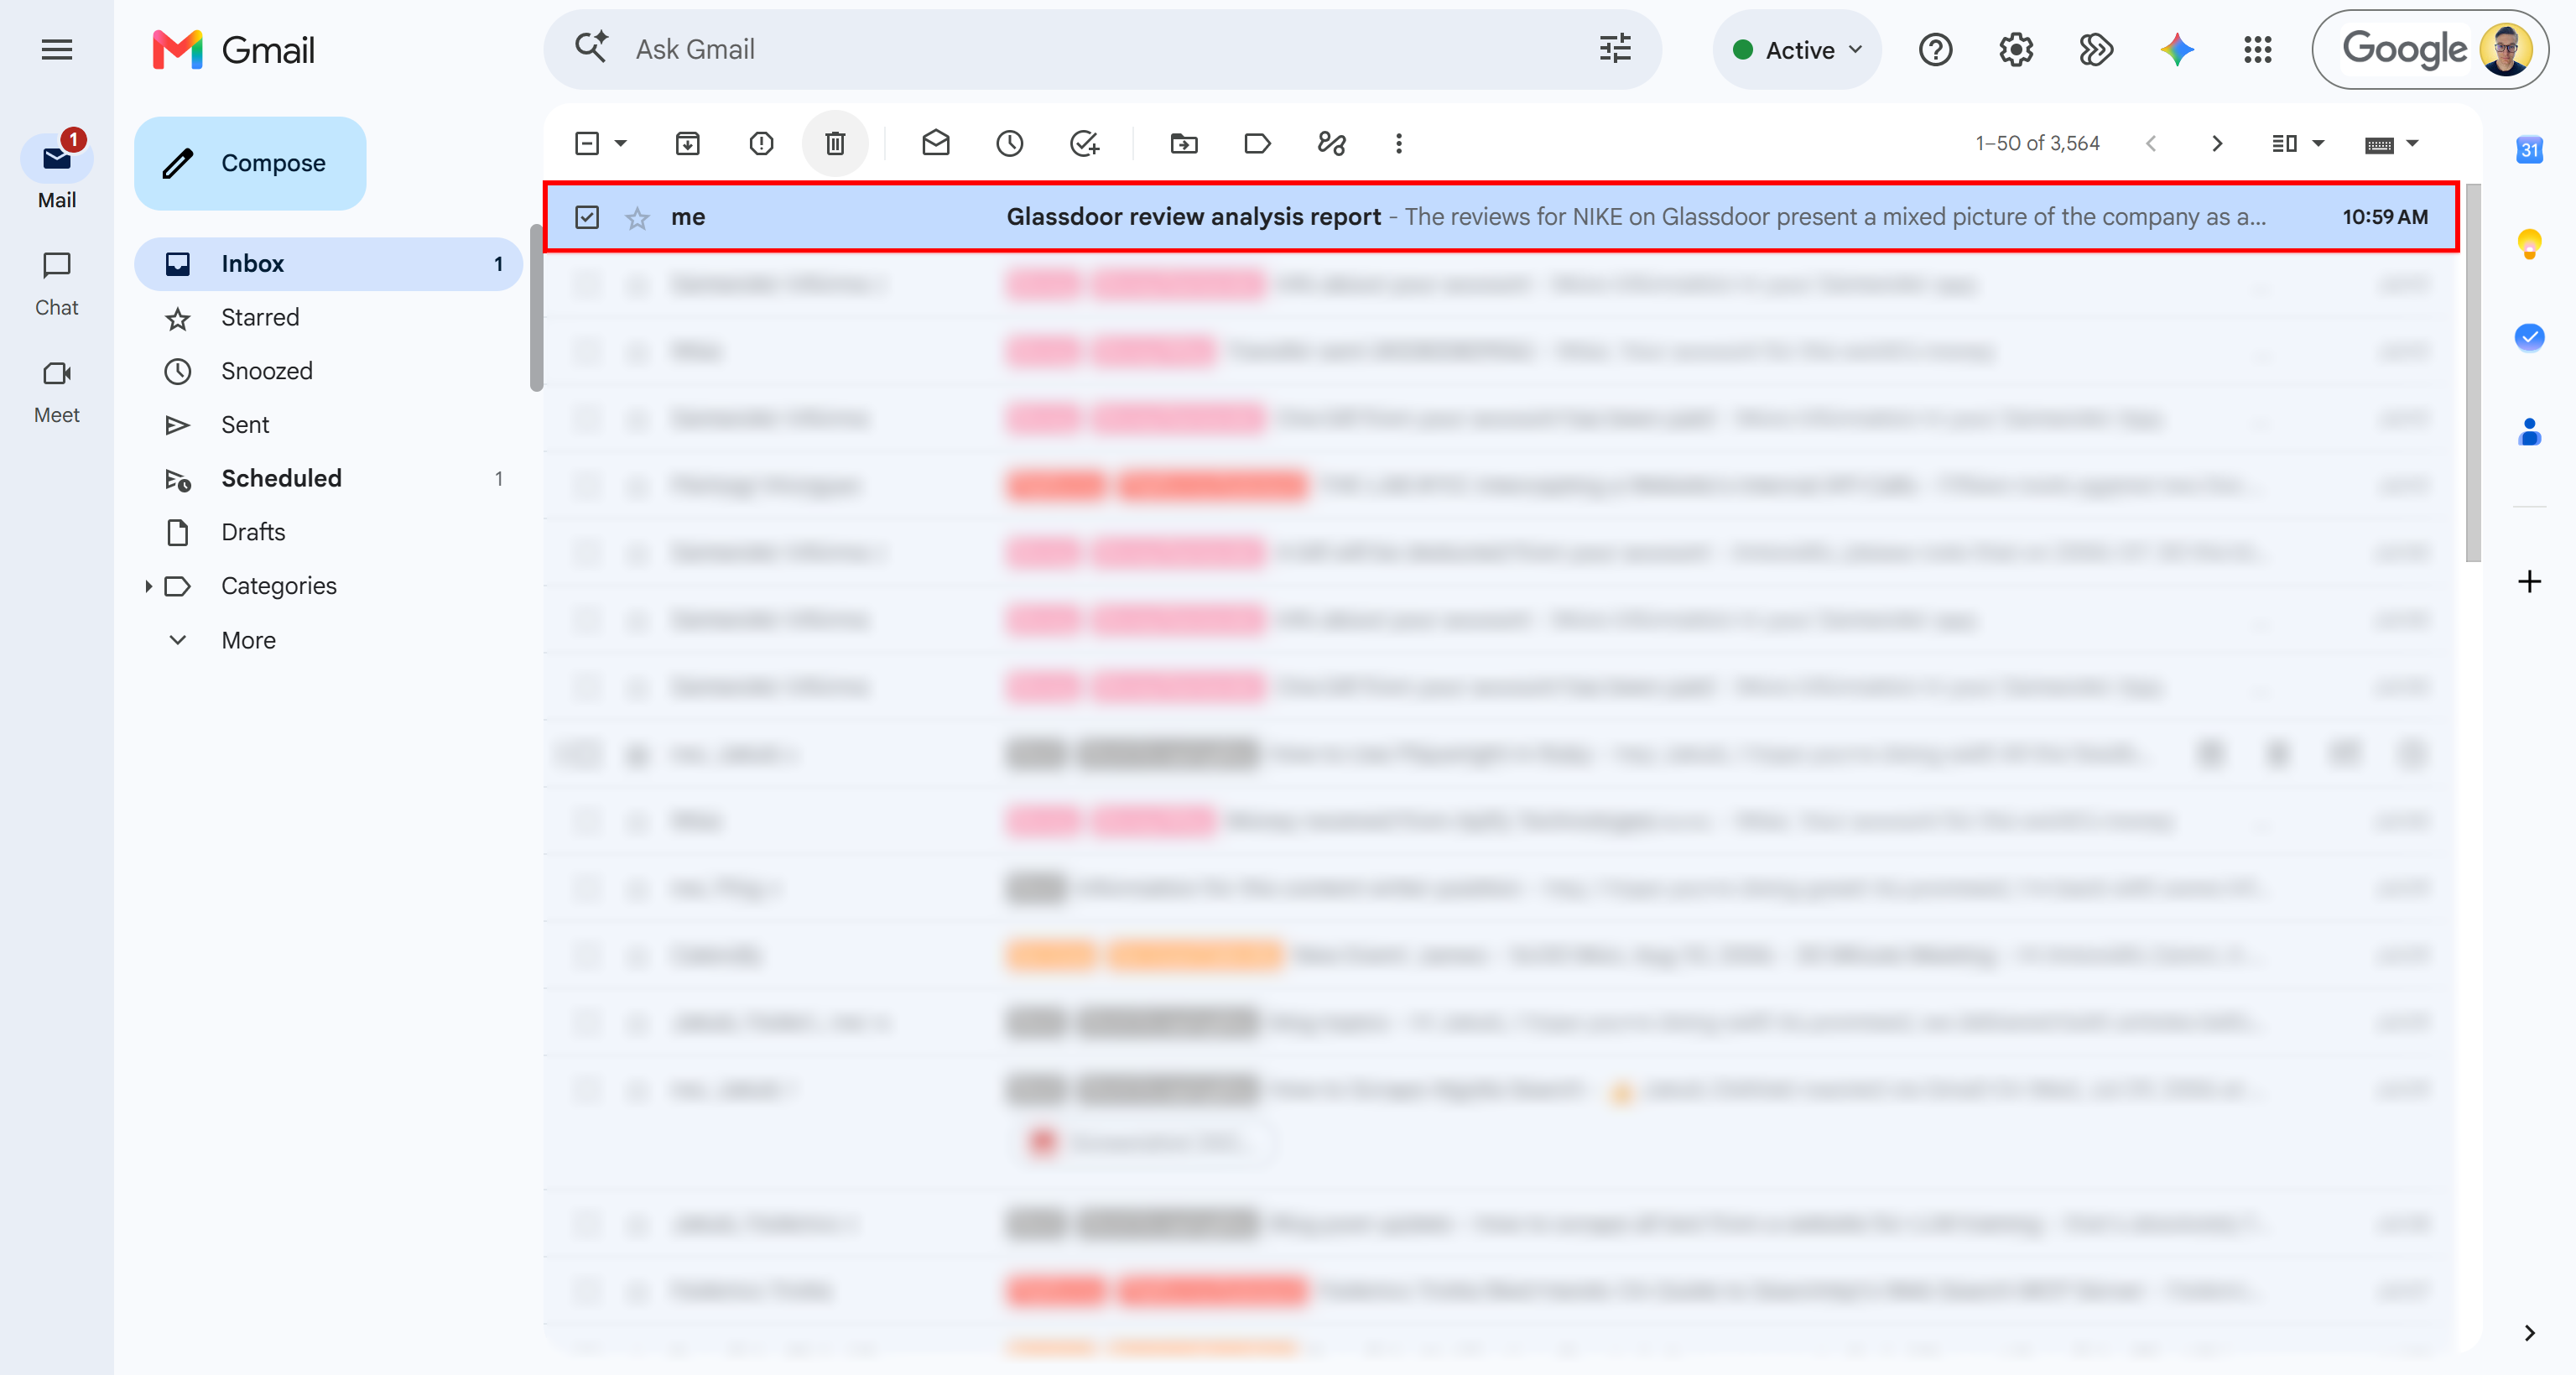
你应该会看到一封新的“Glassdoor 评价分析报告”电子邮件。打开它即可查看结构化 HTML 报告,其中汇总了过去 10 天内发布的评价,并突出显示反复出现的正面和负面主题。
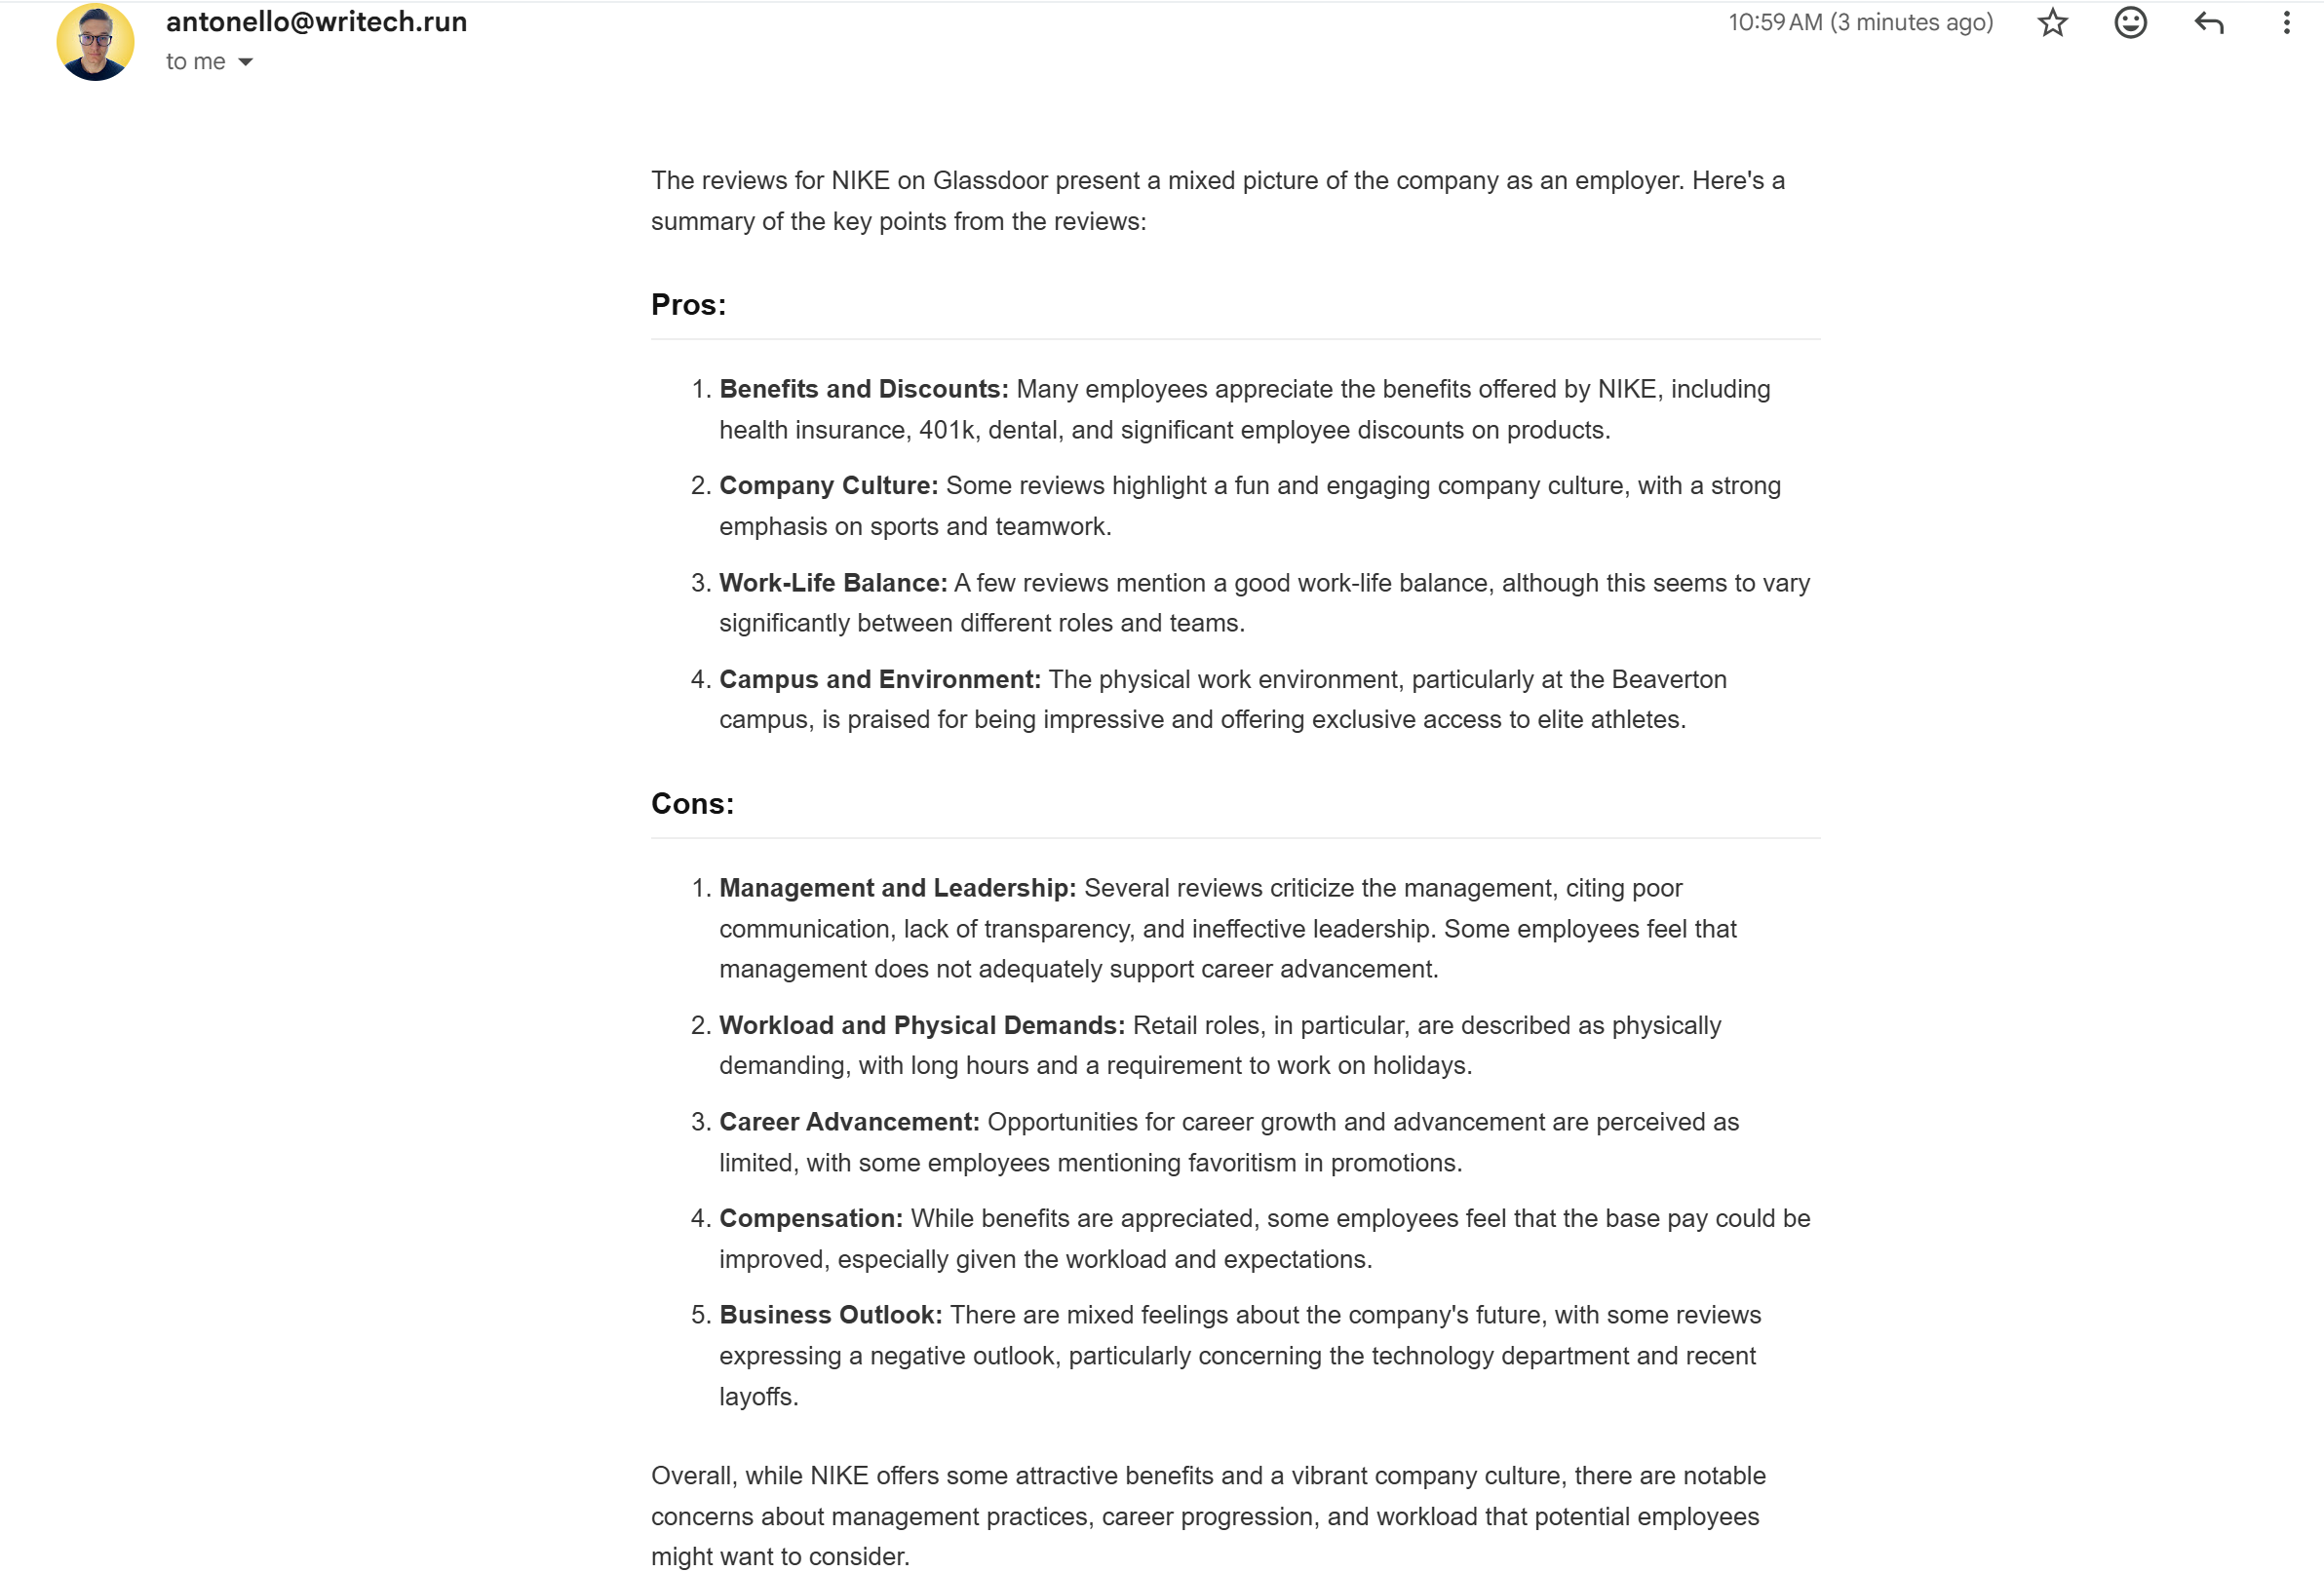
大功告成!Workato 配方运行得非常顺畅。
结论
在本文中,你学习了如何使用 Bright Data 的爬虫 API 从网站获取实时结构化数据,并在自动化 Workato 配方中使用 OpenAI 处理这些数据。
此处演示的 AI 工作流可以轻松扩展至其他 Bright Data API,以实现编程式网页抓取、搜索、数据源检索等功能。要构建更高级的管道,请探索 Bright Data 全套适用于 AI 的 API。
立即免费创建 Bright Data 账户,开始将企业级网页数据 API 集成到你的 AI 工作流中!


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。