在本文中,你将了解:
- OpenHuman 是什么,以及它作为 AI 智能体运行框架能带来什么。
- 为什么使用企业级网页访问工具扩展 OpenHuman 至关重要。
- Bright Data 如何通过 Bright Data CLI 支持这些能力。
- 如何通过
brightdata-cli技能将 Bright Data 集成到 OpenHuman 中,并在真实工作流中使用它。
开始吧!
OpenHuman 简介
了解 OpenHuman 是什么以及它提供什么。
什么是 OpenHuman?
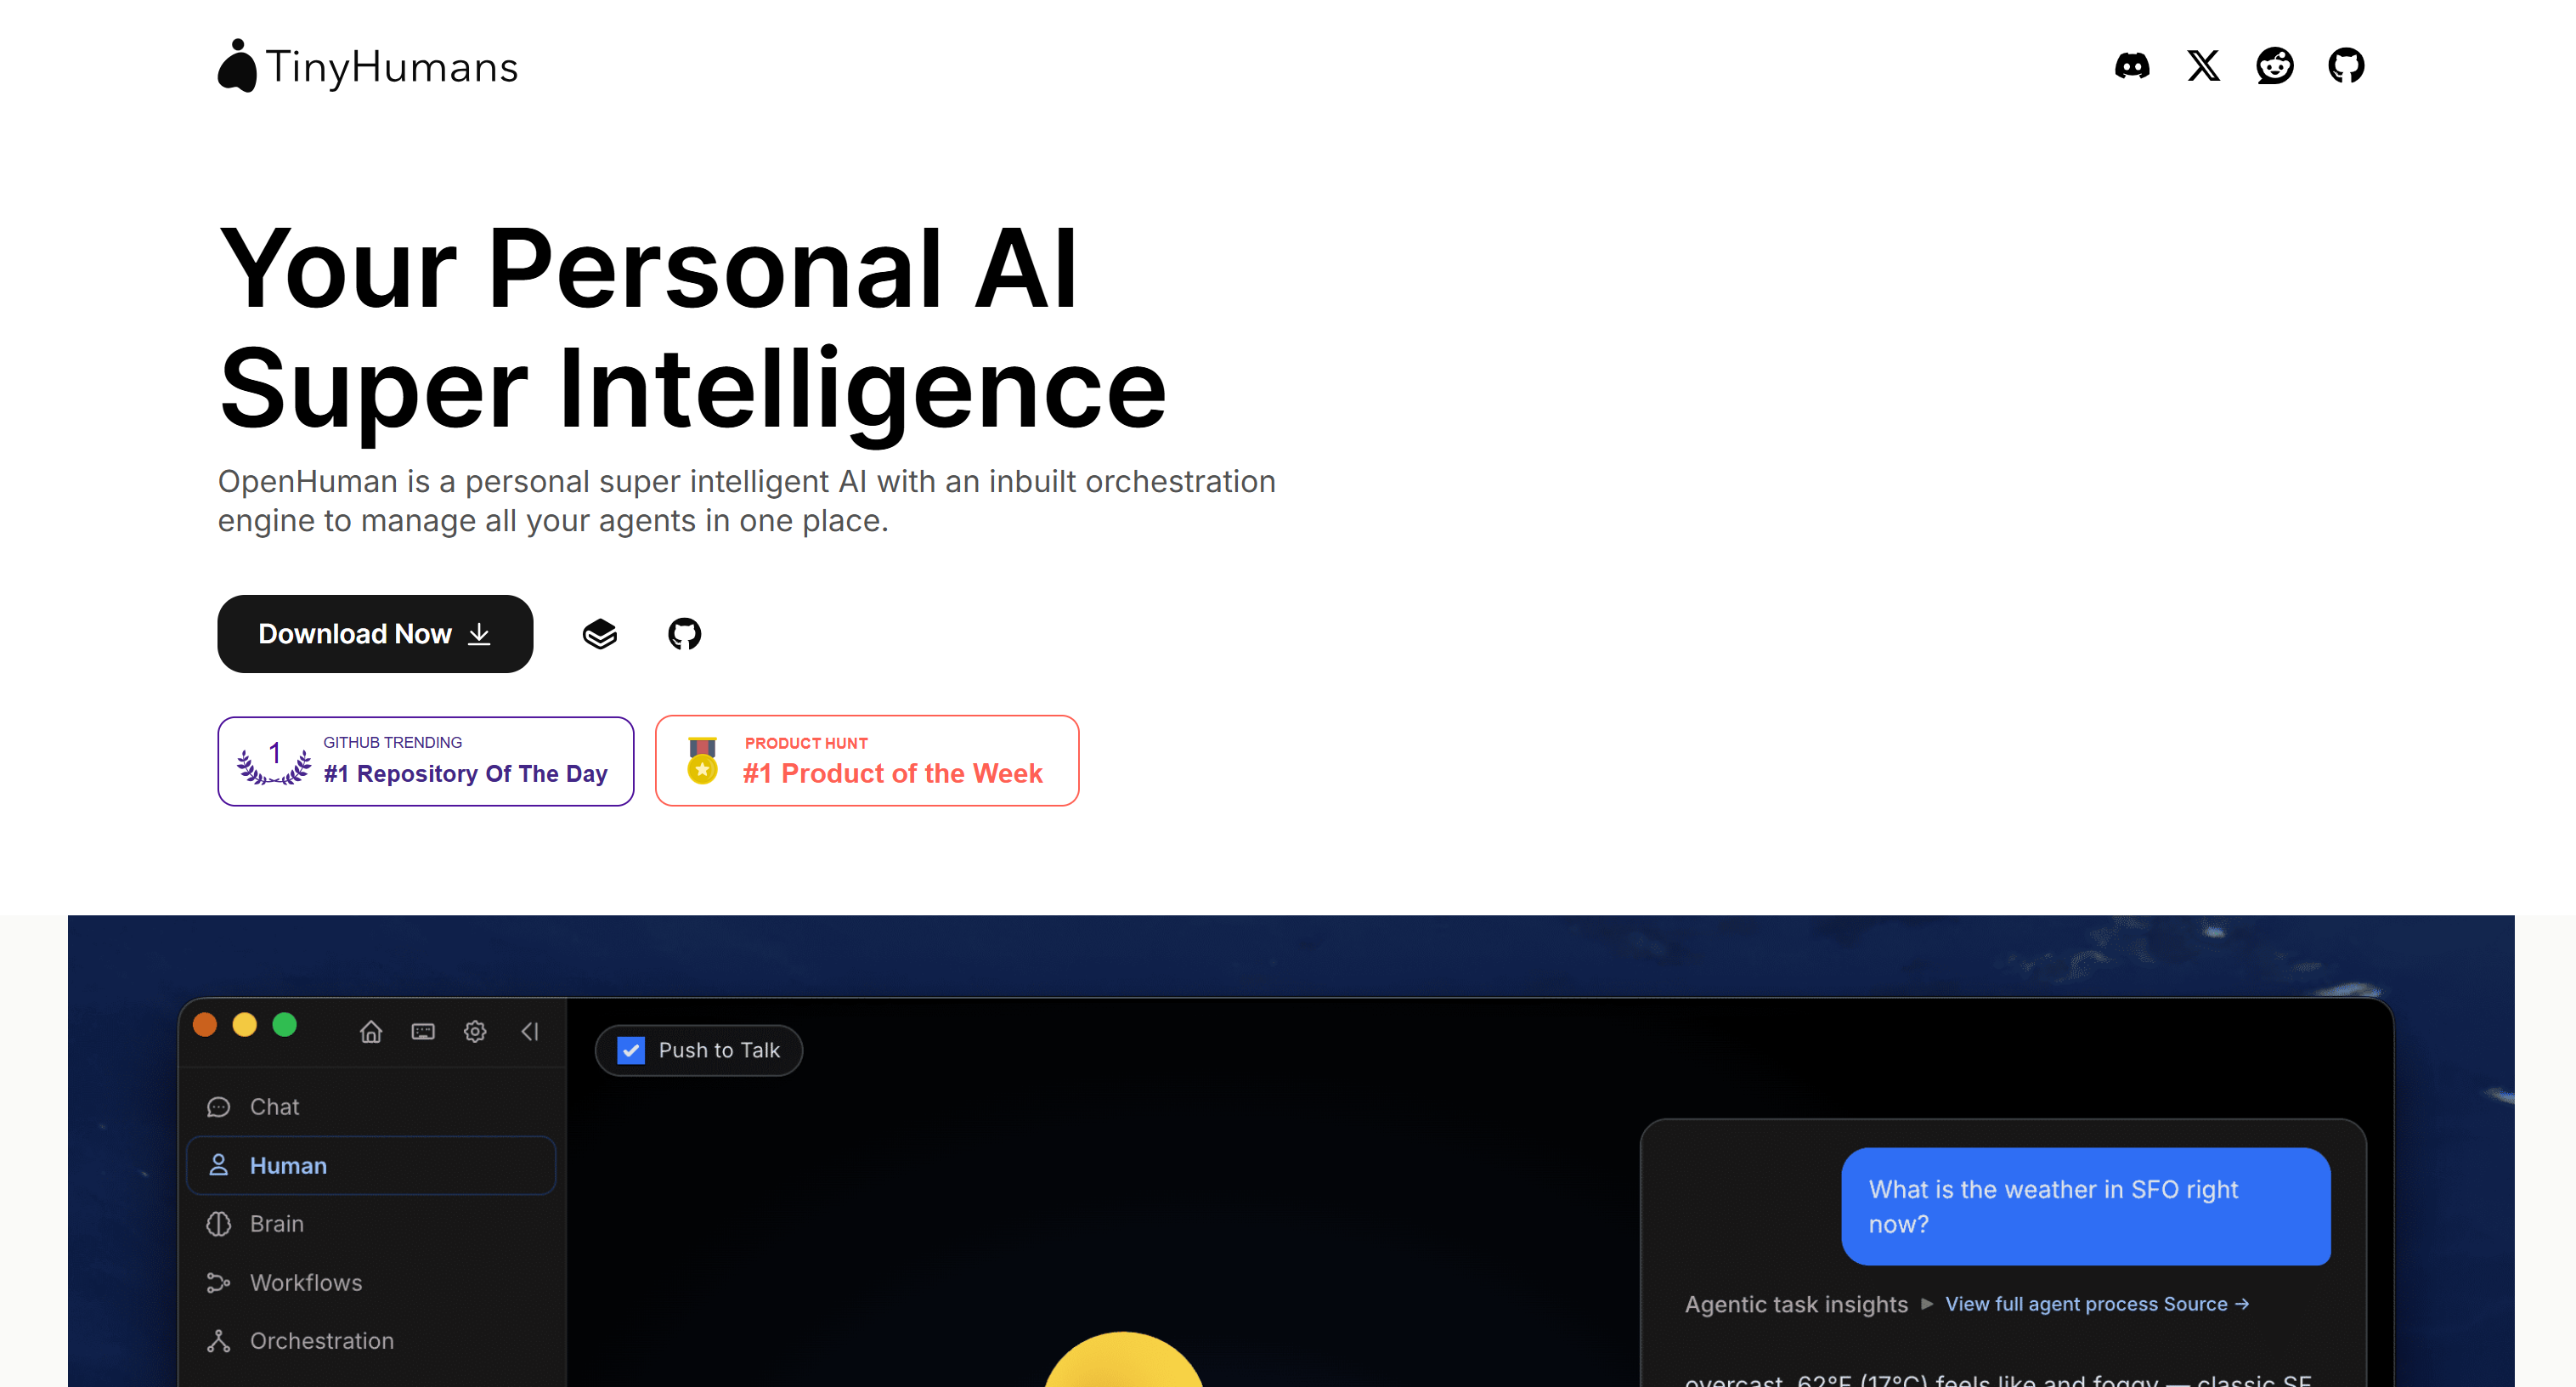
OpenHuman 是一个开源、本地优先的 AI 智能体运行框架旨在充当个人 AI 助手。它结合了持久化记忆、智能体编排、工作流、网页研究和集成能力。
它的主要用例包括研究信息,以及管理个人数据和任务。它还可以自动化工作流、协调多个智能体,并与外部服务交互。该项目的 GitHub 仓库拥有 39k+ stars体现了社区的强烈兴趣和支持。
主要功能
以下是 OpenHuman 提供的主要能力:
- 持久化记忆:使用 Memory Trees 和兼容 Obsidian 的 wiki,为你的电子邮件、文档、聊天和其他数据构建本地记忆。
- 智能体编排:通过可持久化、带检查点的图来协调多个智能体,这些图可以暂停、恢复,并将任务委派给专门的 worker。
- 可视化工作流:让智能体提出由触发器驱动的工作流,你可以在保存前进行查看、修改和批准。
- 集成:连接 100+ OAuth 服务、5K+ MCP 服务器和 90K+ 技能,将外部数据和能力引入智能体。
- 多渠道通信:支持 17 个消息渠道,包括 Telegram、Discord、Slack、WhatsApp、Signal、iMessage 和原生电子邮件。
- 隐私和本地控制:通过加密将数据存储在本地,并支持让推理保留在你设备上的 Privacy Mode。
- 模型灵活性:提供内置模型路由,同时允许你使用自己的提供商 API 密钥或本地 Ollama 模型。
- 原生媒体工具:支持图像和视频生成,以及通过进程内 Whisper 提供语音能力。
- 可观测性:提供可重放的运行日志和按调用计费的成本核算,让智能体活动更容易检查和理解。
如需更多信息,请查看官方文档。
为什么 OpenHuman 需要网页搜索、爬虫和交互能力
OpenHuman 内置了网页研究集成。这使它的 AI 智能体能够发现在线来源,并将其知识建立在新鲜内容之上。
该功能对于克服 LLM 的知识截止限制尤其有用。OpenHuman 默认提供托管式网页搜索,也支持与其他热门网页搜索 API 集成,例如 Parallel、Exa 等。
不过,内置网页工具不一定总能提供企业级工作流所需的可靠性和可扩展性。智能体可能会遇到被封锁的网站、反机器人系统、CAPTCHA 或地理限制。
此外,网页搜索只是开始。结构化的智能体网页工作流还涉及浏览器自动化和网页爬虫。对于生产场景,拥有一套稳健的网页数据基础设施和更丰富的工具会带来巨大差异。这正是 Bright Data 可以提供帮助的地方!
Bright Data 提供企业级基础设施,用于可靠的网页访问,基于一个覆盖 195 个国家/地区、拥有 400M+ IP 的网络构建。该基础设施为搜索、发现、爬虫和浏览器自动化提供多种网页数据解决方案。
Bright Data 如何支持 OpenHuman
将 Bright Data 与 OpenHuman 集成的最简单方式,是通过 brightdata-cli 技能。该技能是更广泛的 Bright Data 智能体技能的一部分,为 AI 智能体提供有效使用 Bright Data CLI 所需的知识。
如果你还不熟悉它Bright Data CLI 可让你通过简单的终端命令访问 Bright Data 的网页数据产品套件。具体来说CLI 命令包括:
| 命令 | 描述 | Bright Data 产品 |
|---|---|---|
brightdata scrape <url> |
抓取 URL,同时处理 JavaScript、CAPTCHA 和反机器人保护。 | 网络解锁器 API |
brightdata search <query> |
搜索 Google、Bing 或 Yandex,并返回结构化搜索结果。 | 搜索引擎 API |
brightdata pipelines <type> |
从 Amazon、LinkedIn、Instagram、YouTube 等受支持的平台提取结构化数据。 | 网页爬虫工具 API |
brightdata browser open <url> |
在持久化的真实浏览器会话中打开 URL。 | 浏览器 API |
brightdata browser snapshot |
将当前页面捕获为可访问性树,供 AI 智能体读取并与之交互。 | 浏览器 API |
brightdata browser click / type / fill / scroll / etc. |
通过在页面上执行特定操作来与网页交互 | 浏览器 API |
brightdata browser screenshot |
捕获当前浏览器视口或完整页面的屏幕截图。 | 浏览器 API |
注意:每个新的 Bright Data 账户都包含一个每月重复的免费额度最高可调用 5K 次 CLI 命令。开始使用不需要信用卡,也不需要作出承诺。完整详情请参阅免费额度文档。
这些 CLI 命令让 OpenHuman 能够可靠地搜索、发现、抓取并与在线内容交互,即使在处理反机器人保护时也一样!
将 Bright Data CLI 集成到 OpenHuman 中:分步教程
在这个引导式部分中,你将学习如何通过 brightdata-cli 技能将 OpenHuman 与 Bright Data 集成。这会为底层智能体提供使用 Bright Data CLI 所需的知识。
请按照下面的说明操作!
先决条件
开始之前,请确保你具备:
- 一台 macOS、Windows 或 Linux 机器至少配备 4 GB RAM。如果你计划摄取非常大的邮箱或仓库,或者在同一台机器上运行本地模型,建议使用 16GB+。
- 一个已充值的 OpenHuman 账户,或来自受支持 LLM 提供商之一的 API 密钥。在本教程中,我们将使用一个 OpenAI API 密钥。
- 本地已安装 Node.js这是运行 Bright Data CLI 所必需的。
- 一个 Bright Data 账户。
如果你对 智能体 技能 标准有一定了解,也会有所帮助。
第 #1 步:安装 OpenHuman
首先从官方网站下载 OpenHuman 安装程序选择适用于你操作系统的版本,或从 GitHub Releases 页面下载。
或者,如果你更愿意从终端安装 OpenHuman请按照官方指南操作。
启动安装程序并按照向导进行操作。启动 OpenHuman,它会检查你的系统是否具备所需依赖,并安装任何缺失的依赖。
安装完成后,你将看到以下屏幕:
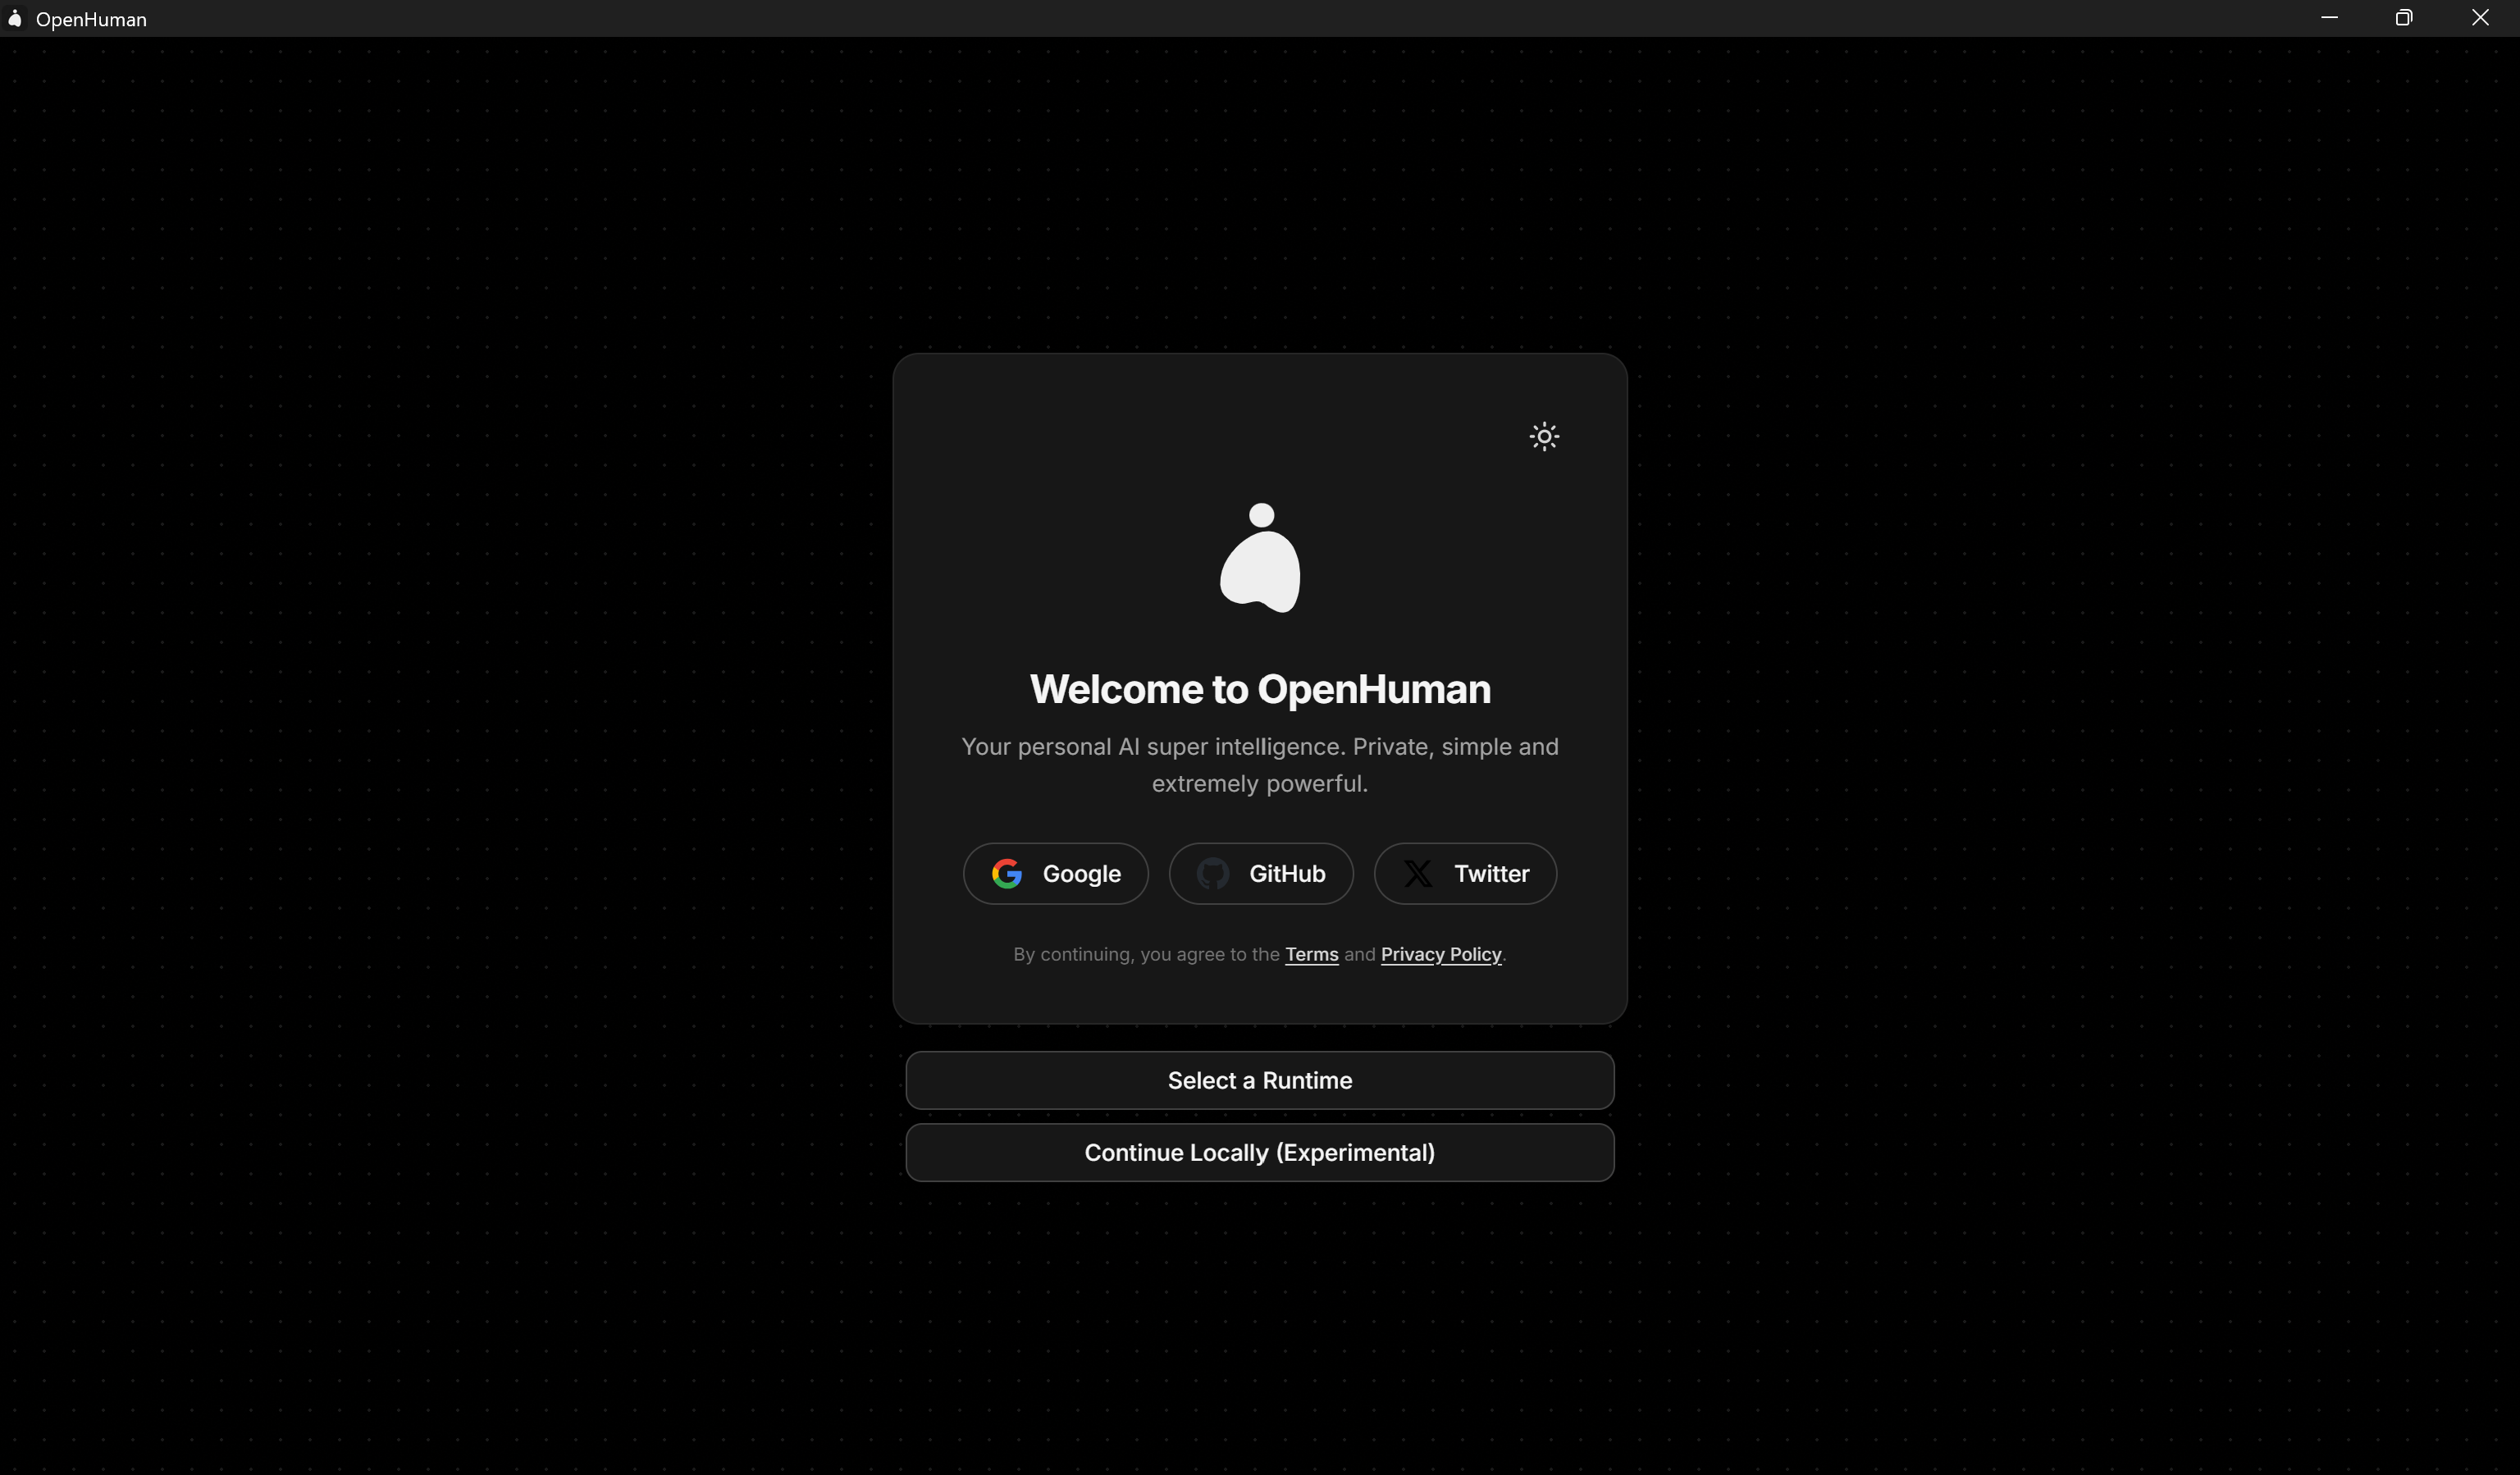
登录你的 OpenHuman 账户以访问基于 OpenHuman 的功能,或继续使用“继续本地使用(实验性)”选项。
做得好!OpenHuman 已准备好进行配置。
第 #2 步:配置 OpenHuman
登录 OpenHuman 后,系统会要求你在“简单”设置和“运行自定义”设置之间进行选择。
为了更好地控制配置,请选择“运行自定义”,然后选择“继续使用自定义”:
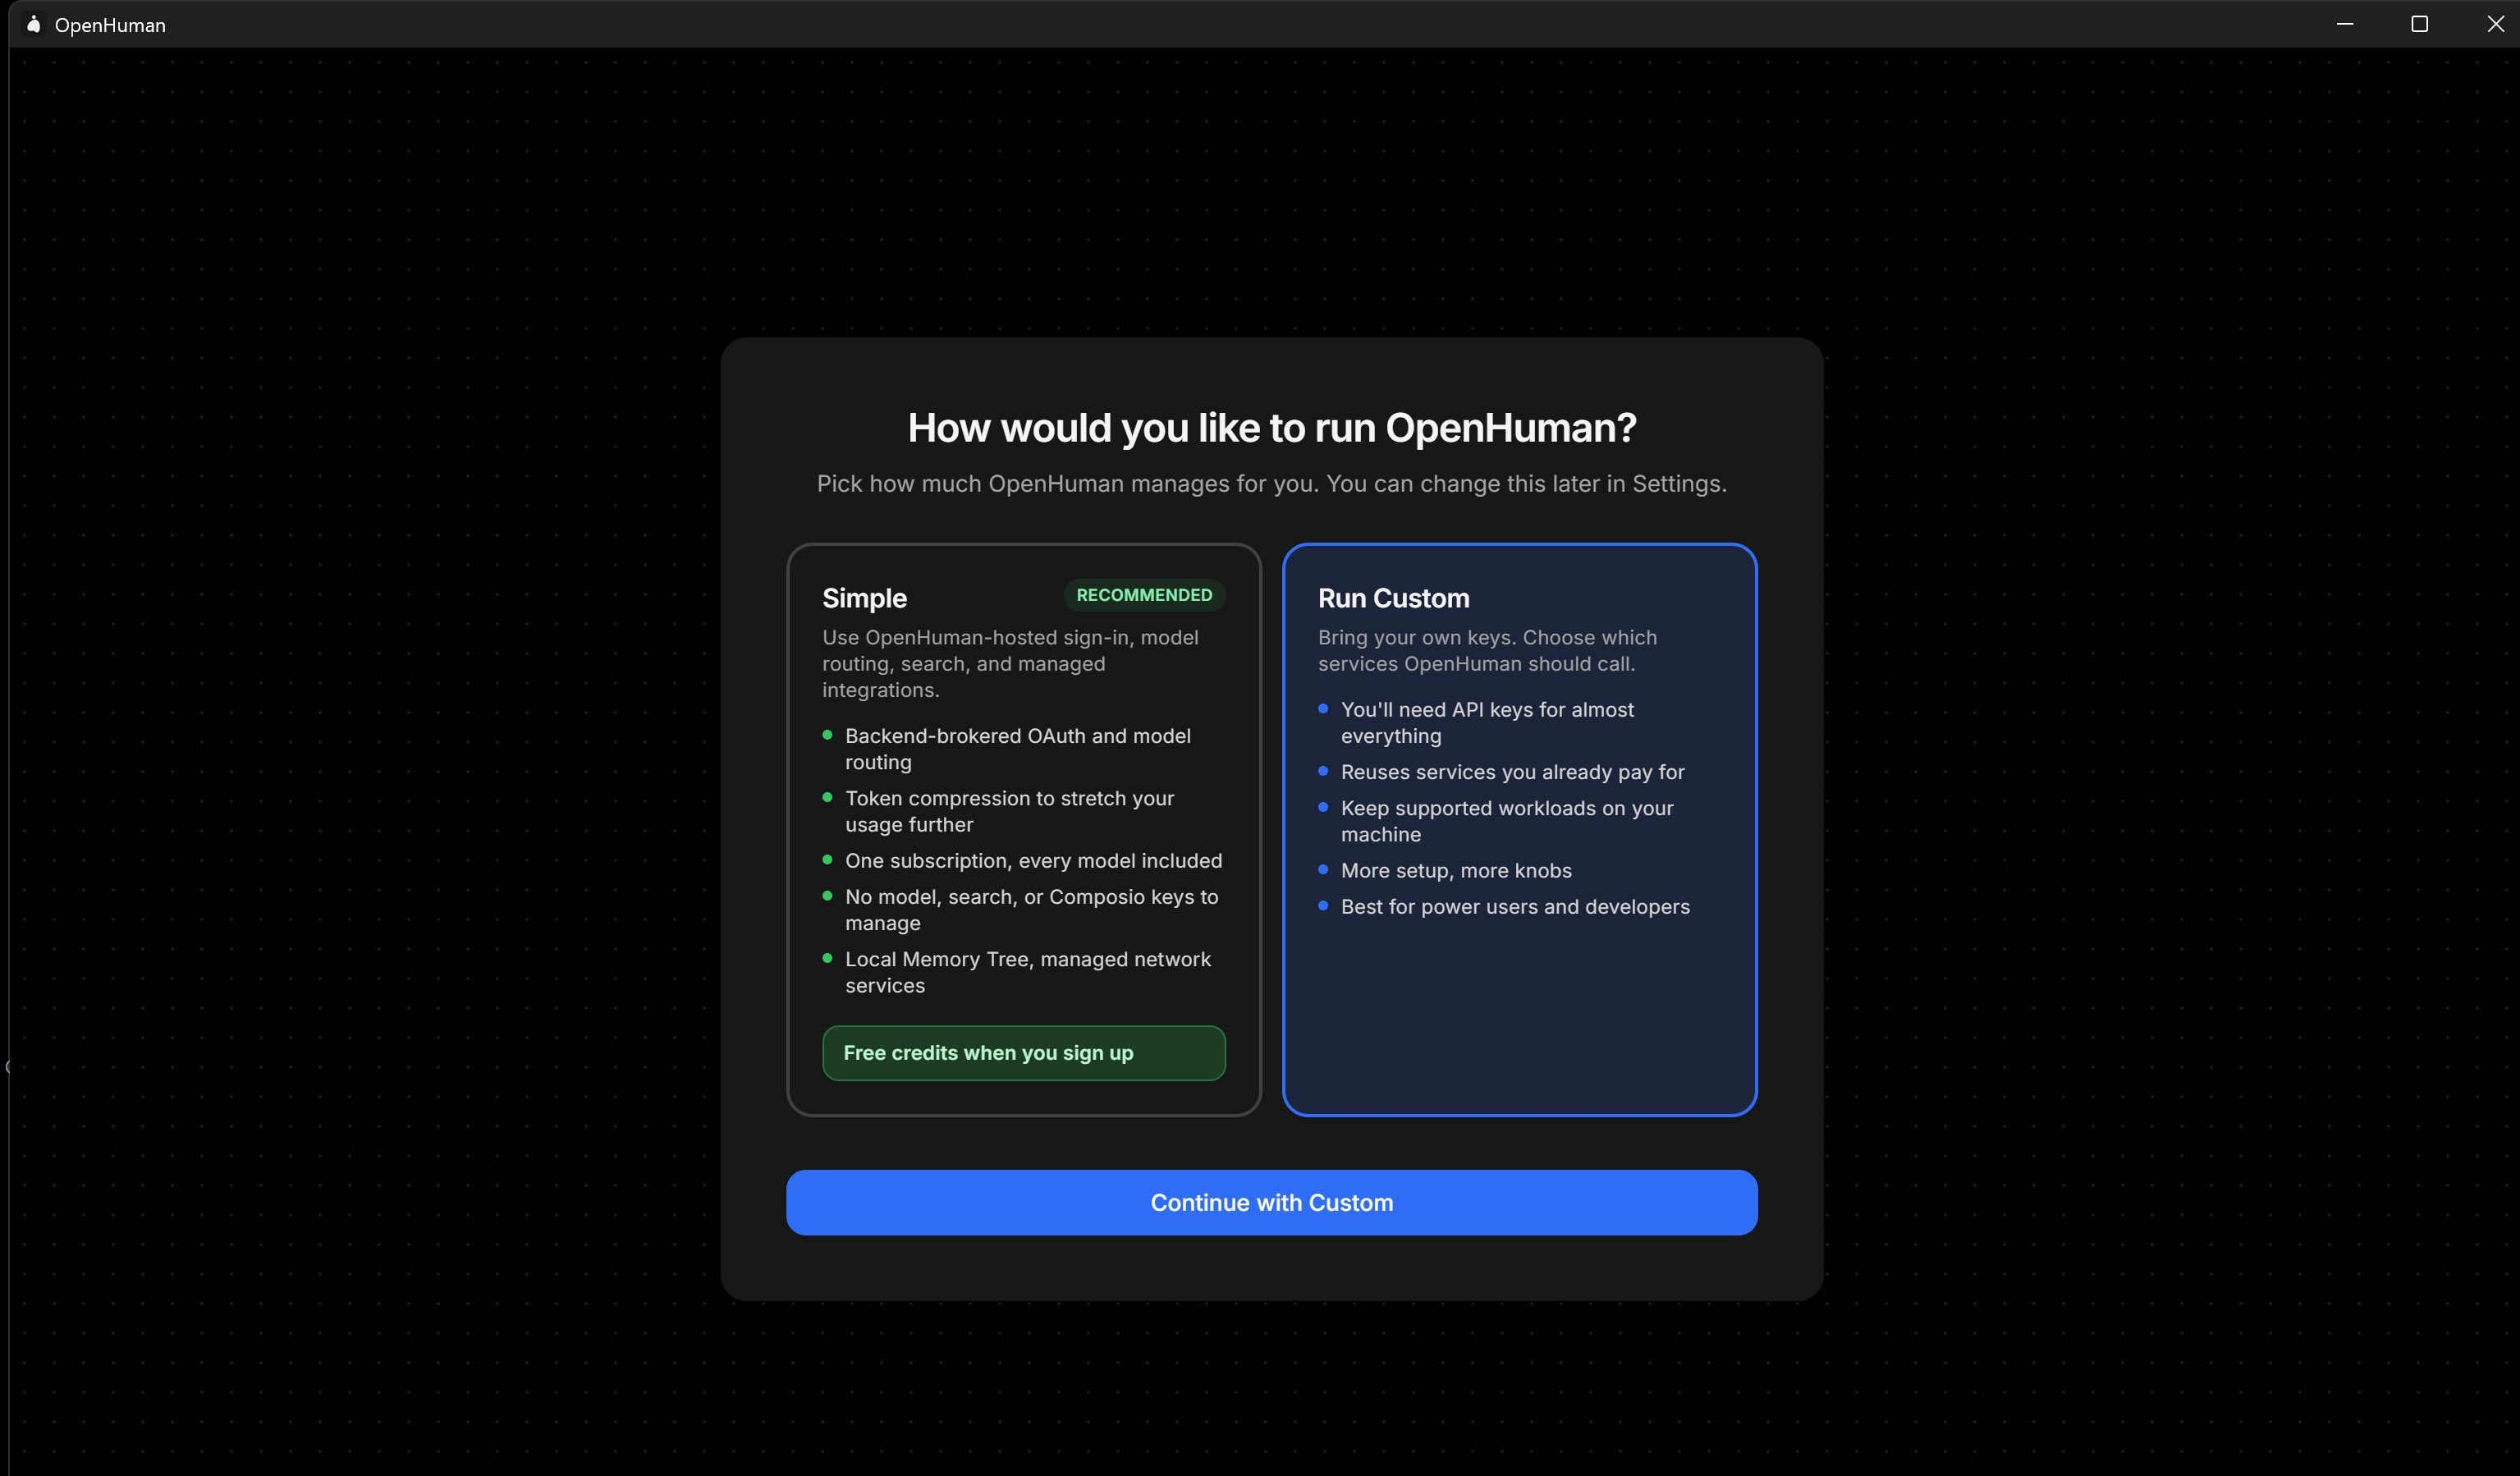
随后,引导流程会带你完成以下配置步骤:
- 推理
- 语音
- OAuth
- 搜索
- 嵌入
- 活动
- 保管库
在“Inference”步骤中,选择“Configure”来设置你自己的 AI 提供商 API 密钥。在本例中,打开“OpenAI”开关,粘贴你的 OpenAI API 密钥,然后点击“Save”:
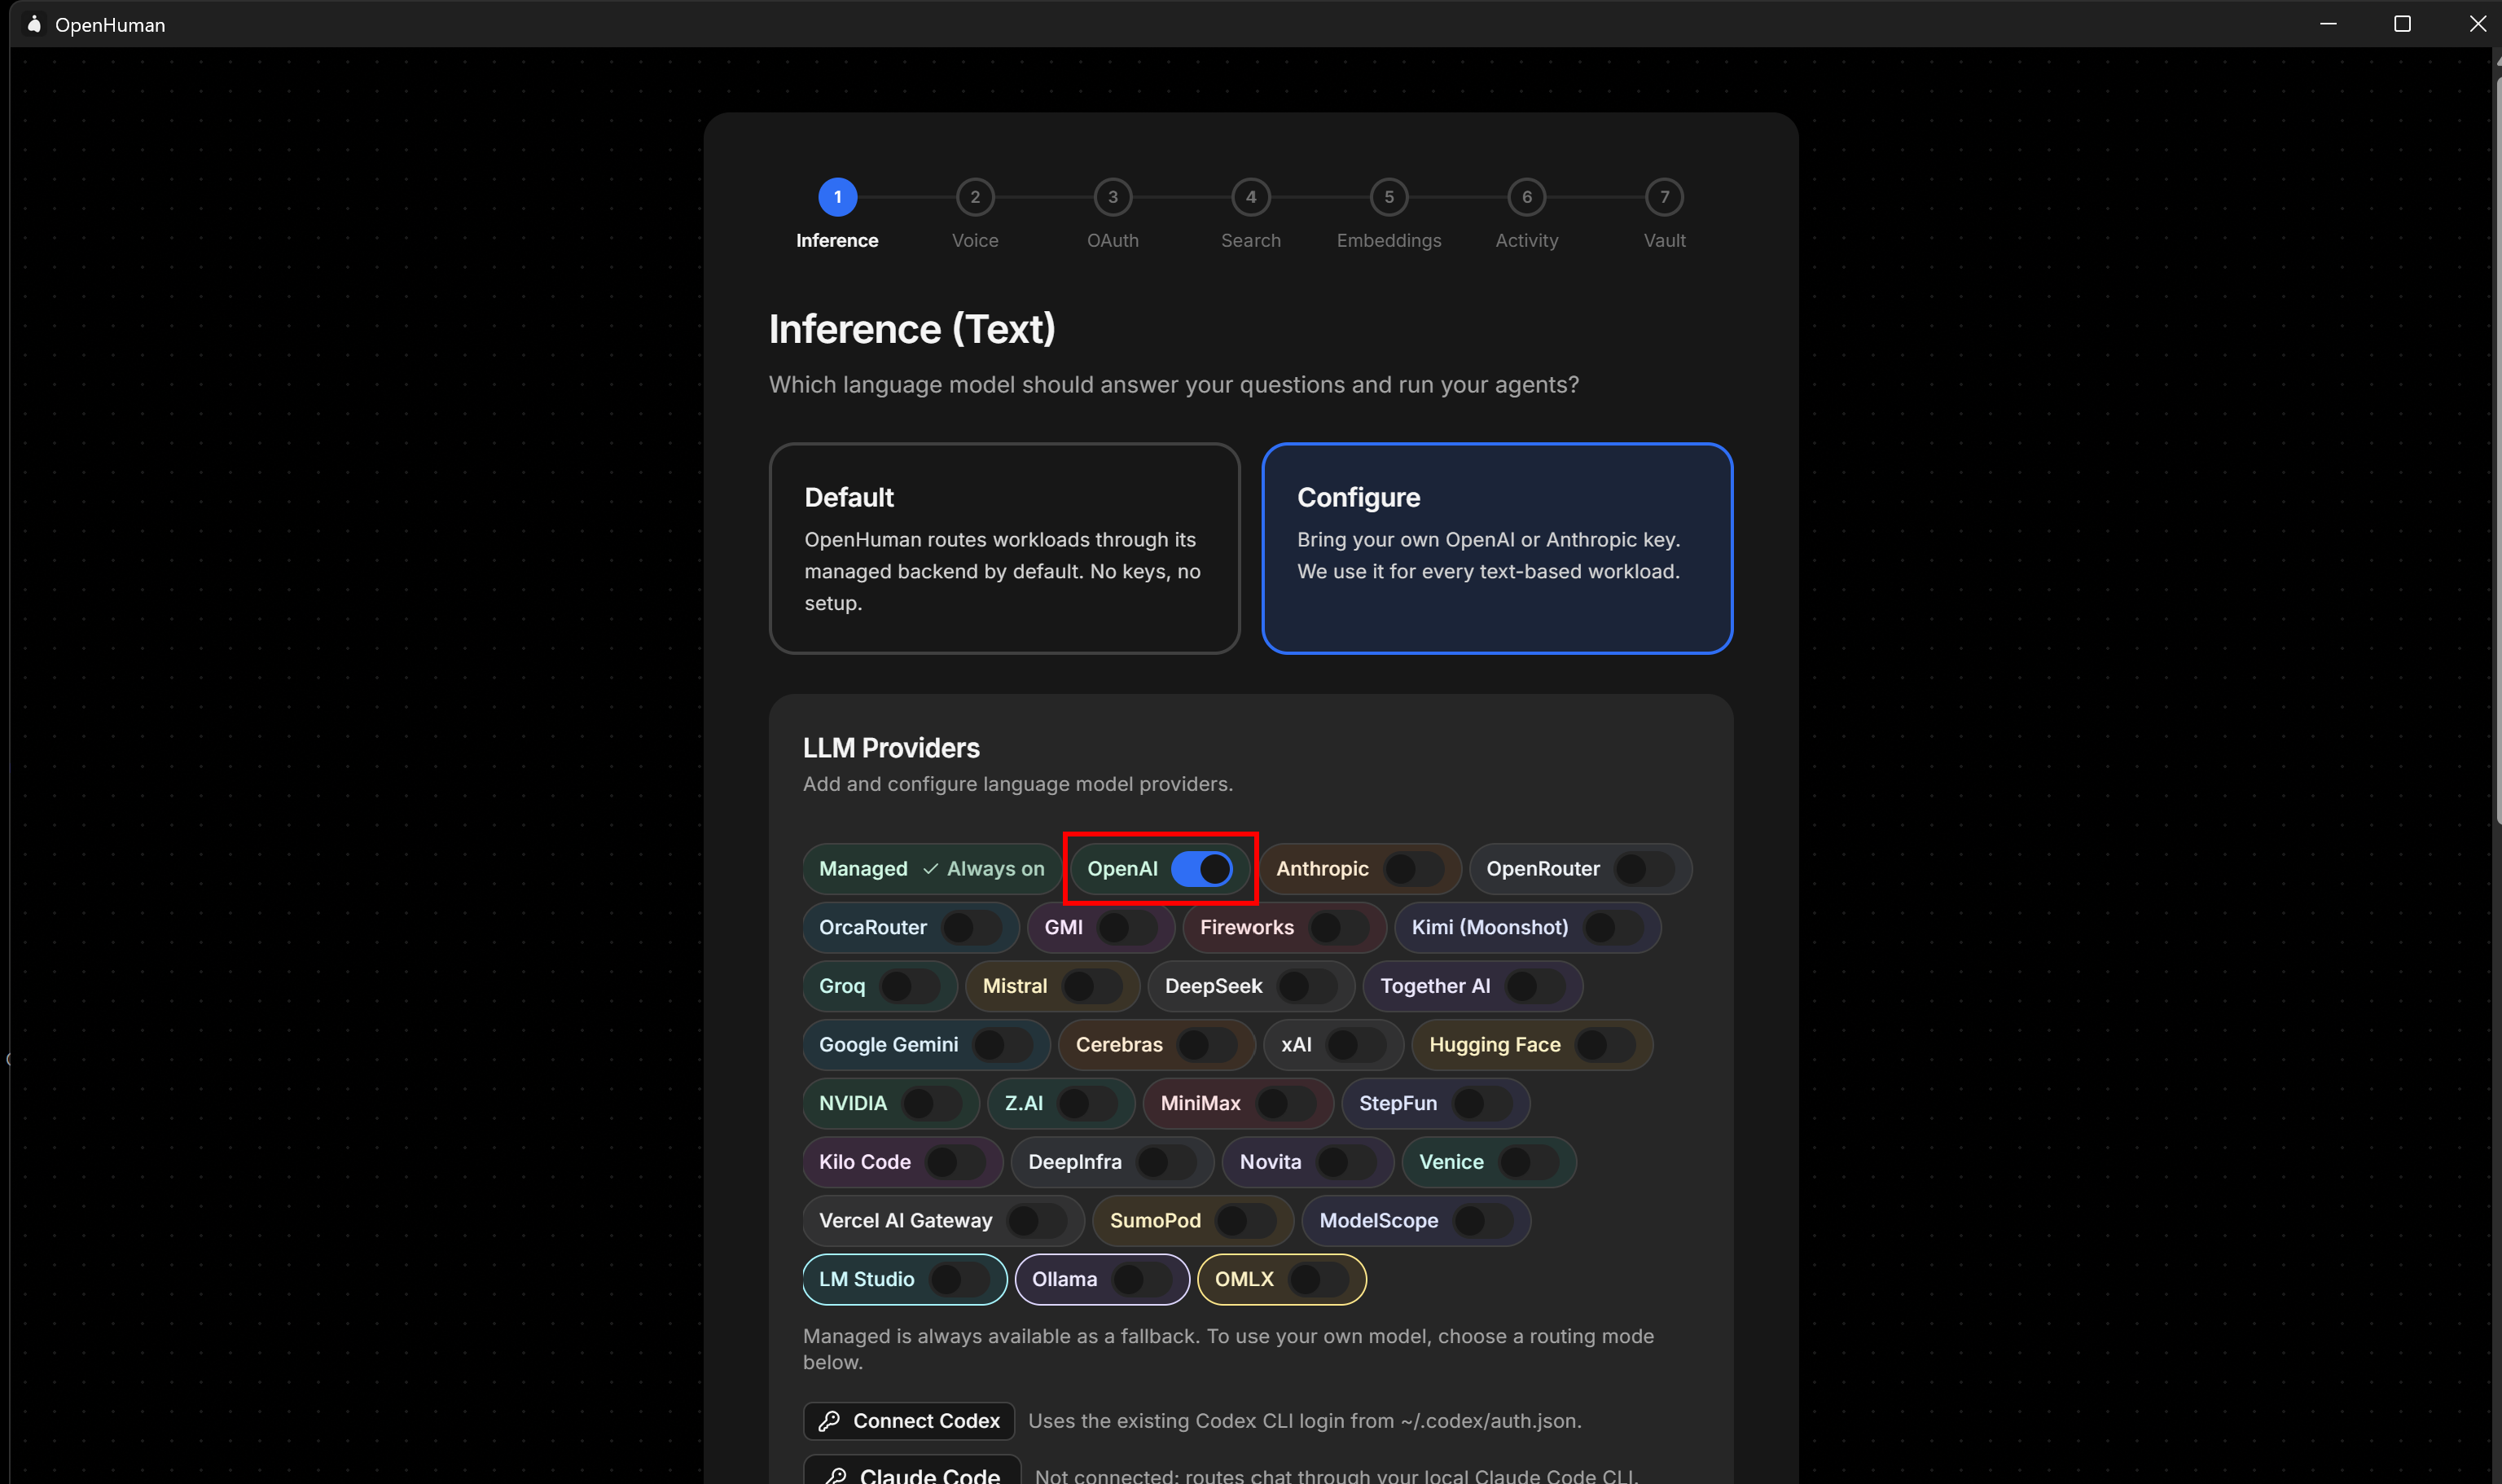
接下来,向下滚动,并考虑启用“Set Your Own Models”选项,以便更好地控制所使用的 LLM。选择“OpenAI”作为提供商,并选择一个模型,例如 gpt-4o-mini。
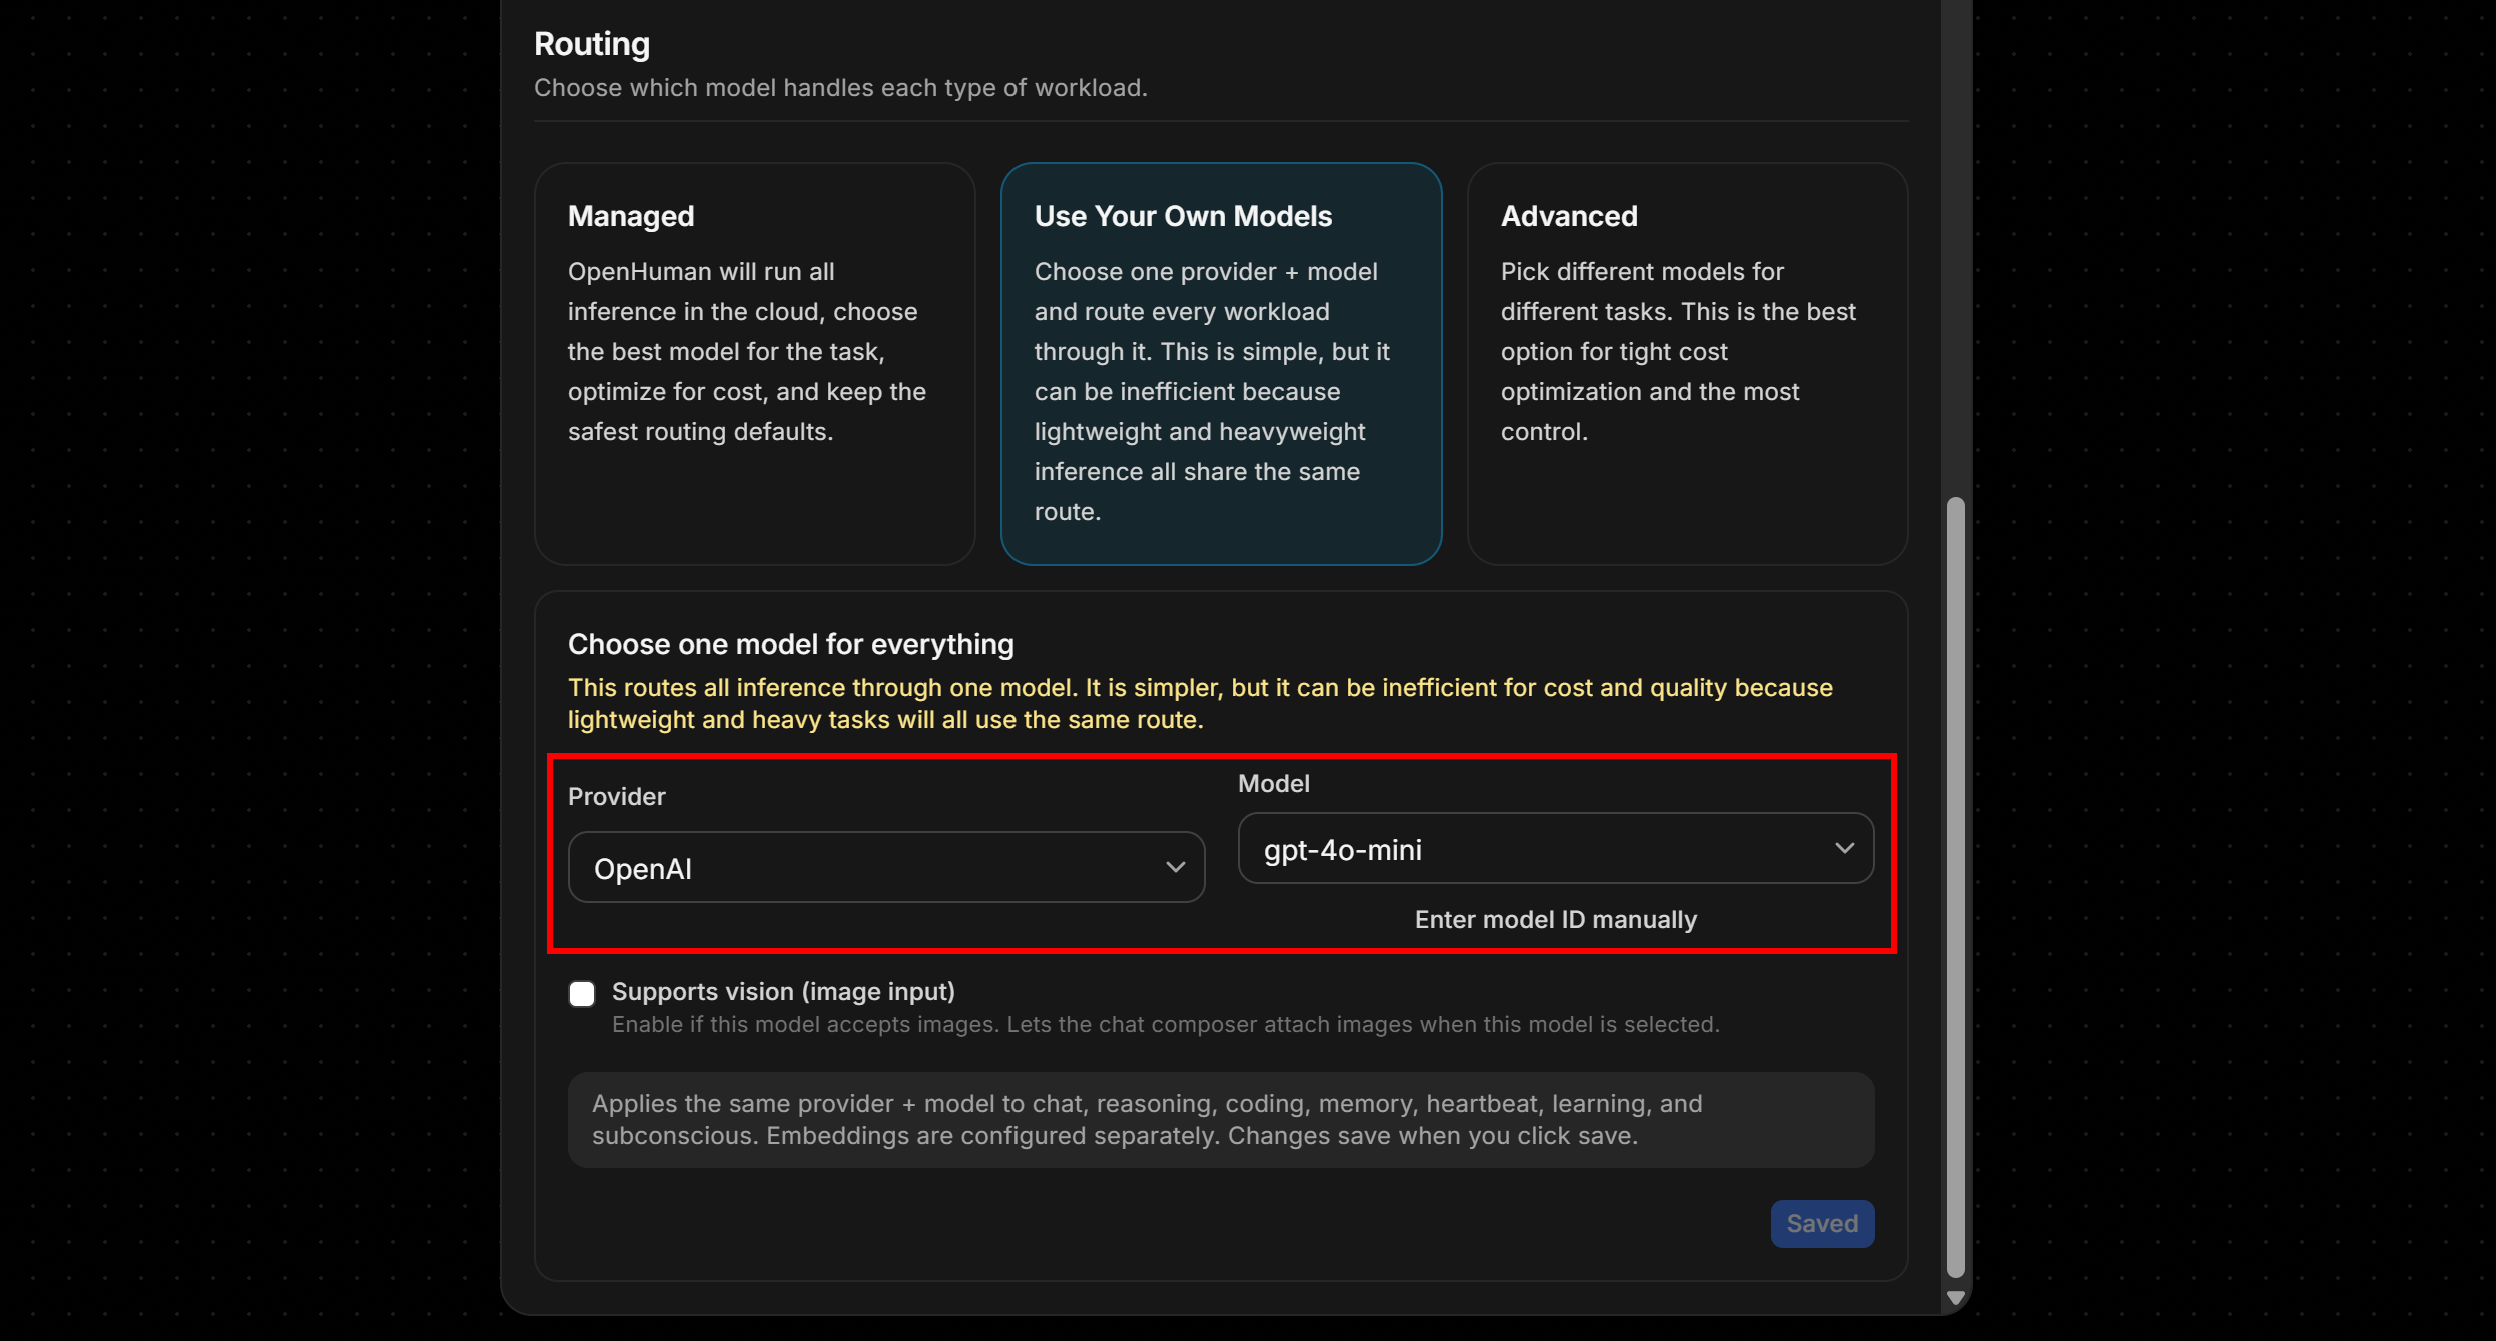
注意:撰写本文时,OpenHuman 不支持 GPT-5 系列的模型。你可以配置它们,但无法与它们聊天。
对于剩余的引导步骤,你可以保留默认选项,或根据需要进行配置。
在“Search”步骤中,选择“Configure”,然后选择“Disabled”选项:
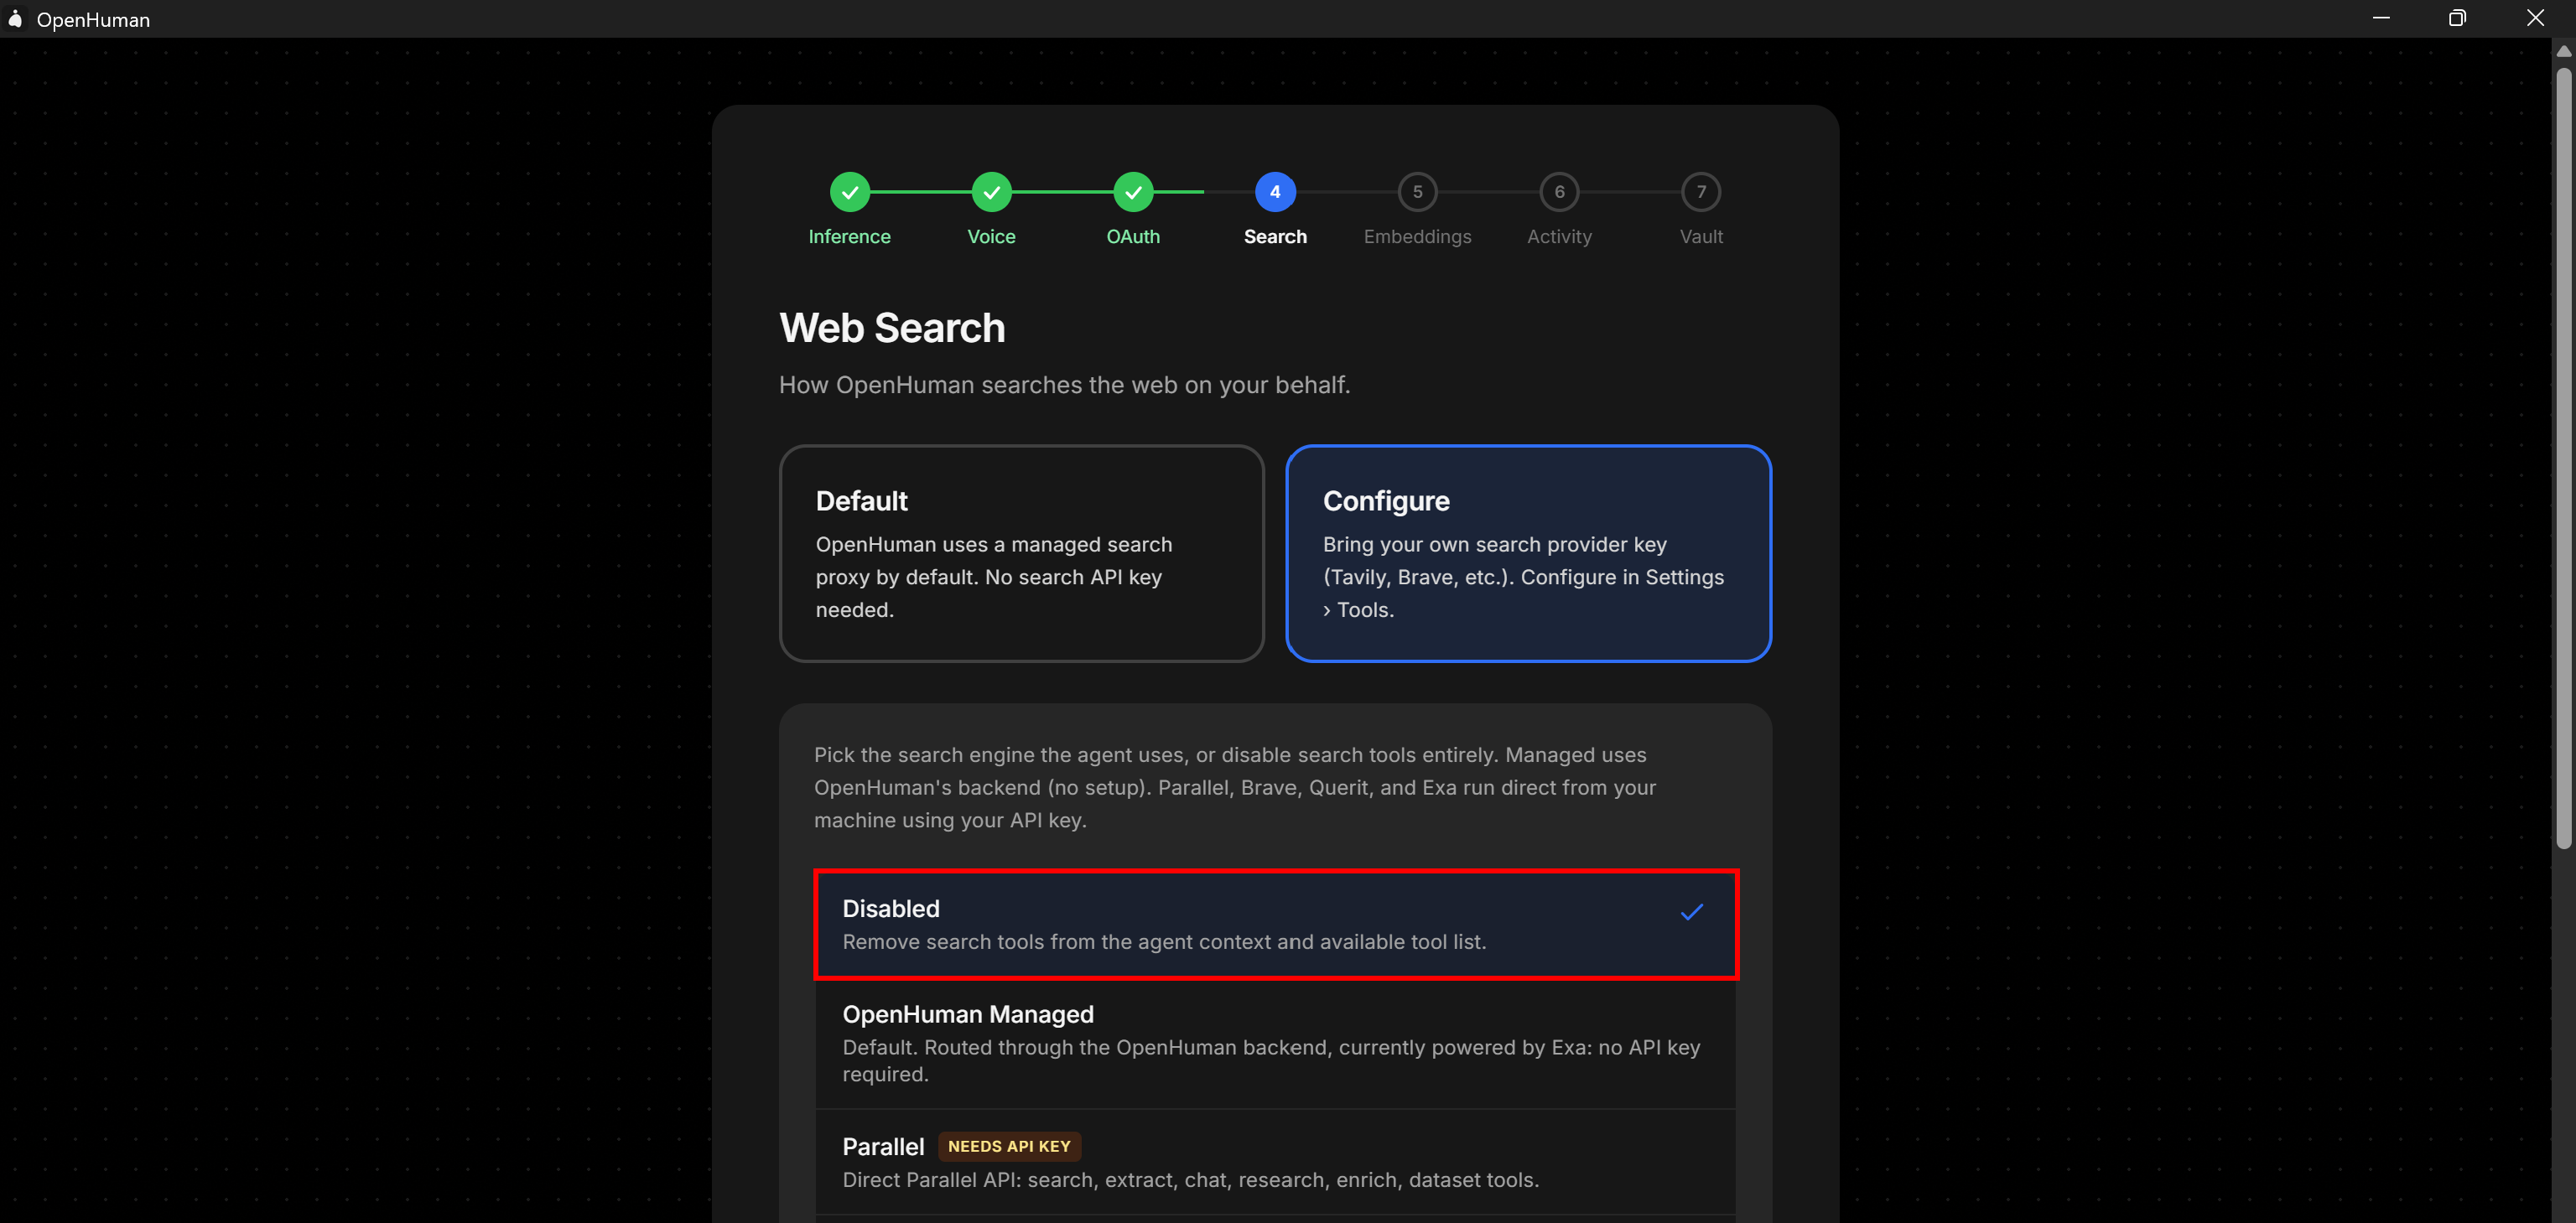
建议这样做,因为网页搜索将改由 Bright Data CLI 提供支持。Bright Data 提供企业级、可用于生产环境的网页访问能力,使 OpenHuman 获得更稳定的搜索能力。
继续完成剩余的引导步骤。默认选项通常就可以。
完成设置后,你会进入 OpenHuman 的“Chat”界面:
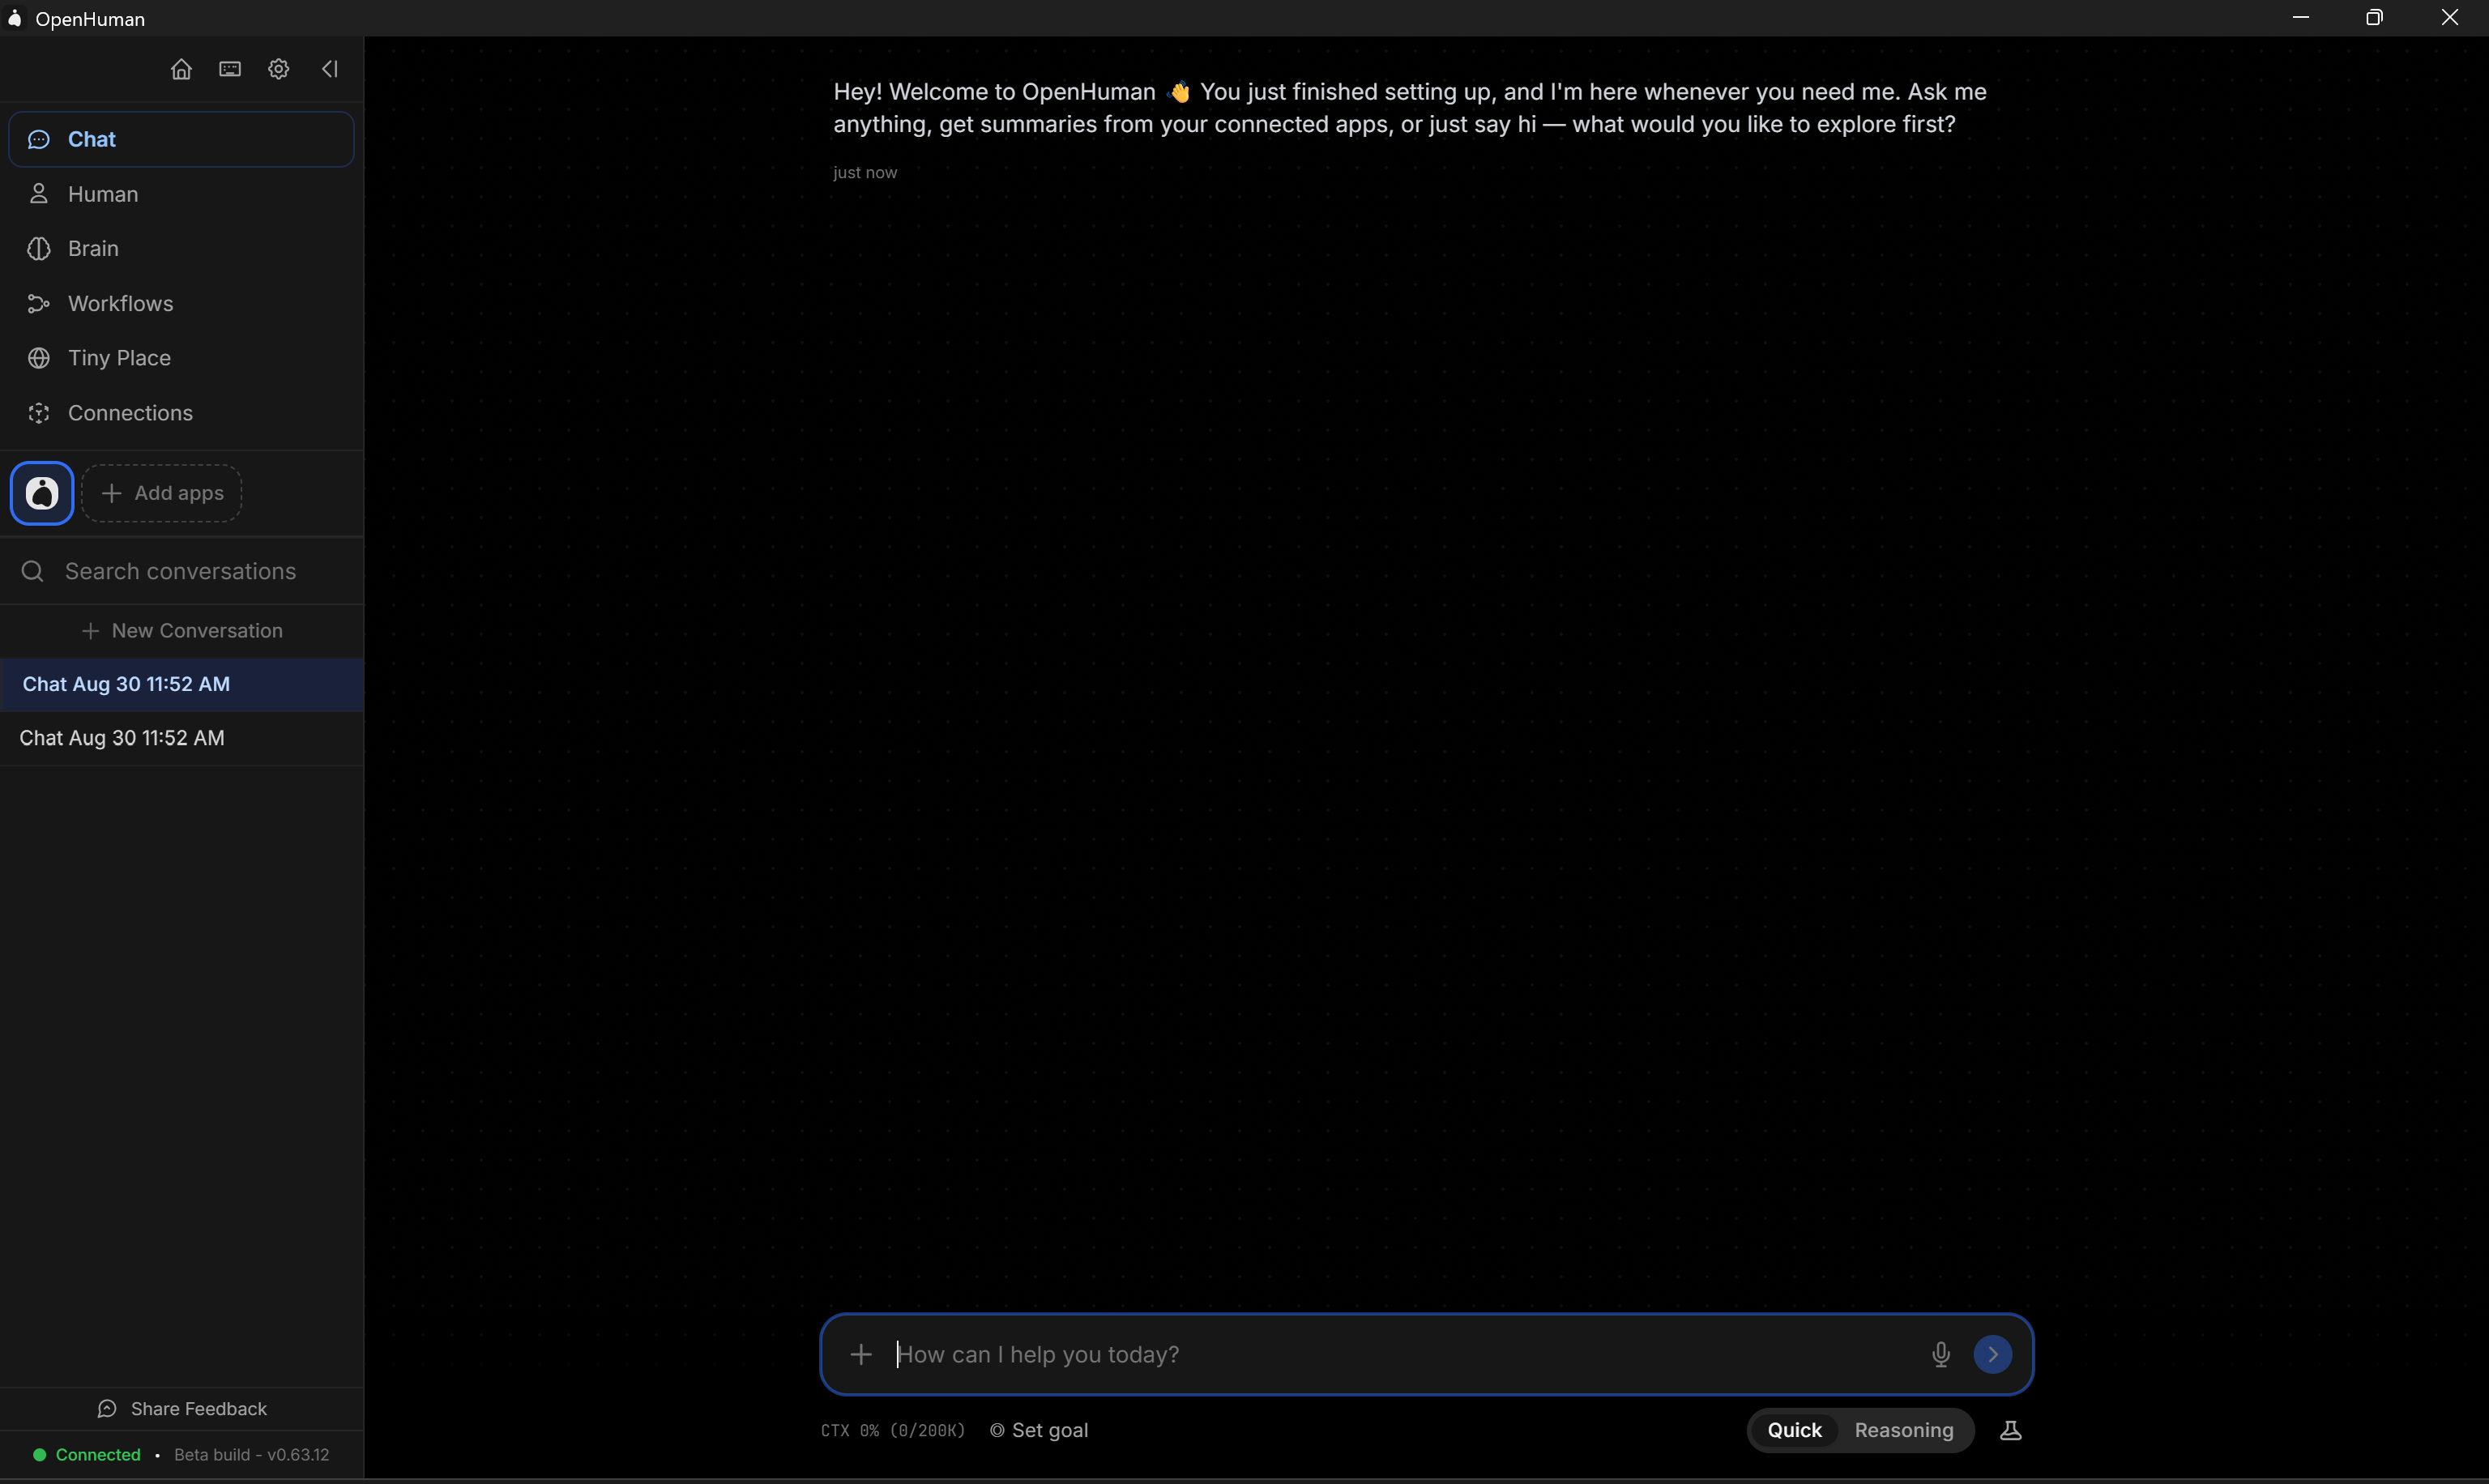
你会被重定向到“Chat”页面,在那里可以开始与 OpenHuman 智能体聊天。很好!
第 3 步:开始使用 Bright Data CLI
如需引导式设置流程,请参考关于安装和配置 Bright Data CLI的官方文档。你也可以阅读我们的博客文章“认识 Bright Data CLI:从终端提取数据并与网页交互”,获取更详细的介绍。
或者,也可以按照下面的步骤操作。
首先使用 @brightdata/cli npm 包全局安装 Bright Data CLI:
npm install -g @brightdata/cli这会将 brightdata 命令,以及 bdata 别名,添加到你的系统中。
通过检查版本来确认 CLI 已成功安装:
bdata --version截至本文撰写时,最新版本是 0.3.5:

接下来,运行以下命令,将 Bright Data CLI 连接到你的 Bright Data 账户:
bdata login这会打开你的浏览器,并启动安全的 OAuth 身份验证流程。随后,CLI 会配置所需的 API 并设置必要的默认值。
很好!现在可以指示 OpenHuman 通过 brightdata-cli 技能使用 Bright Data CLI 了。
第 4 步:在 OpenHuman 中安装 Bright Data CLI 技能
要安装 brightdata-cli 技能,请先在 OpenHuman 左侧菜单中点击“skills”。在“技能”页面上,点击“Install from URL”:
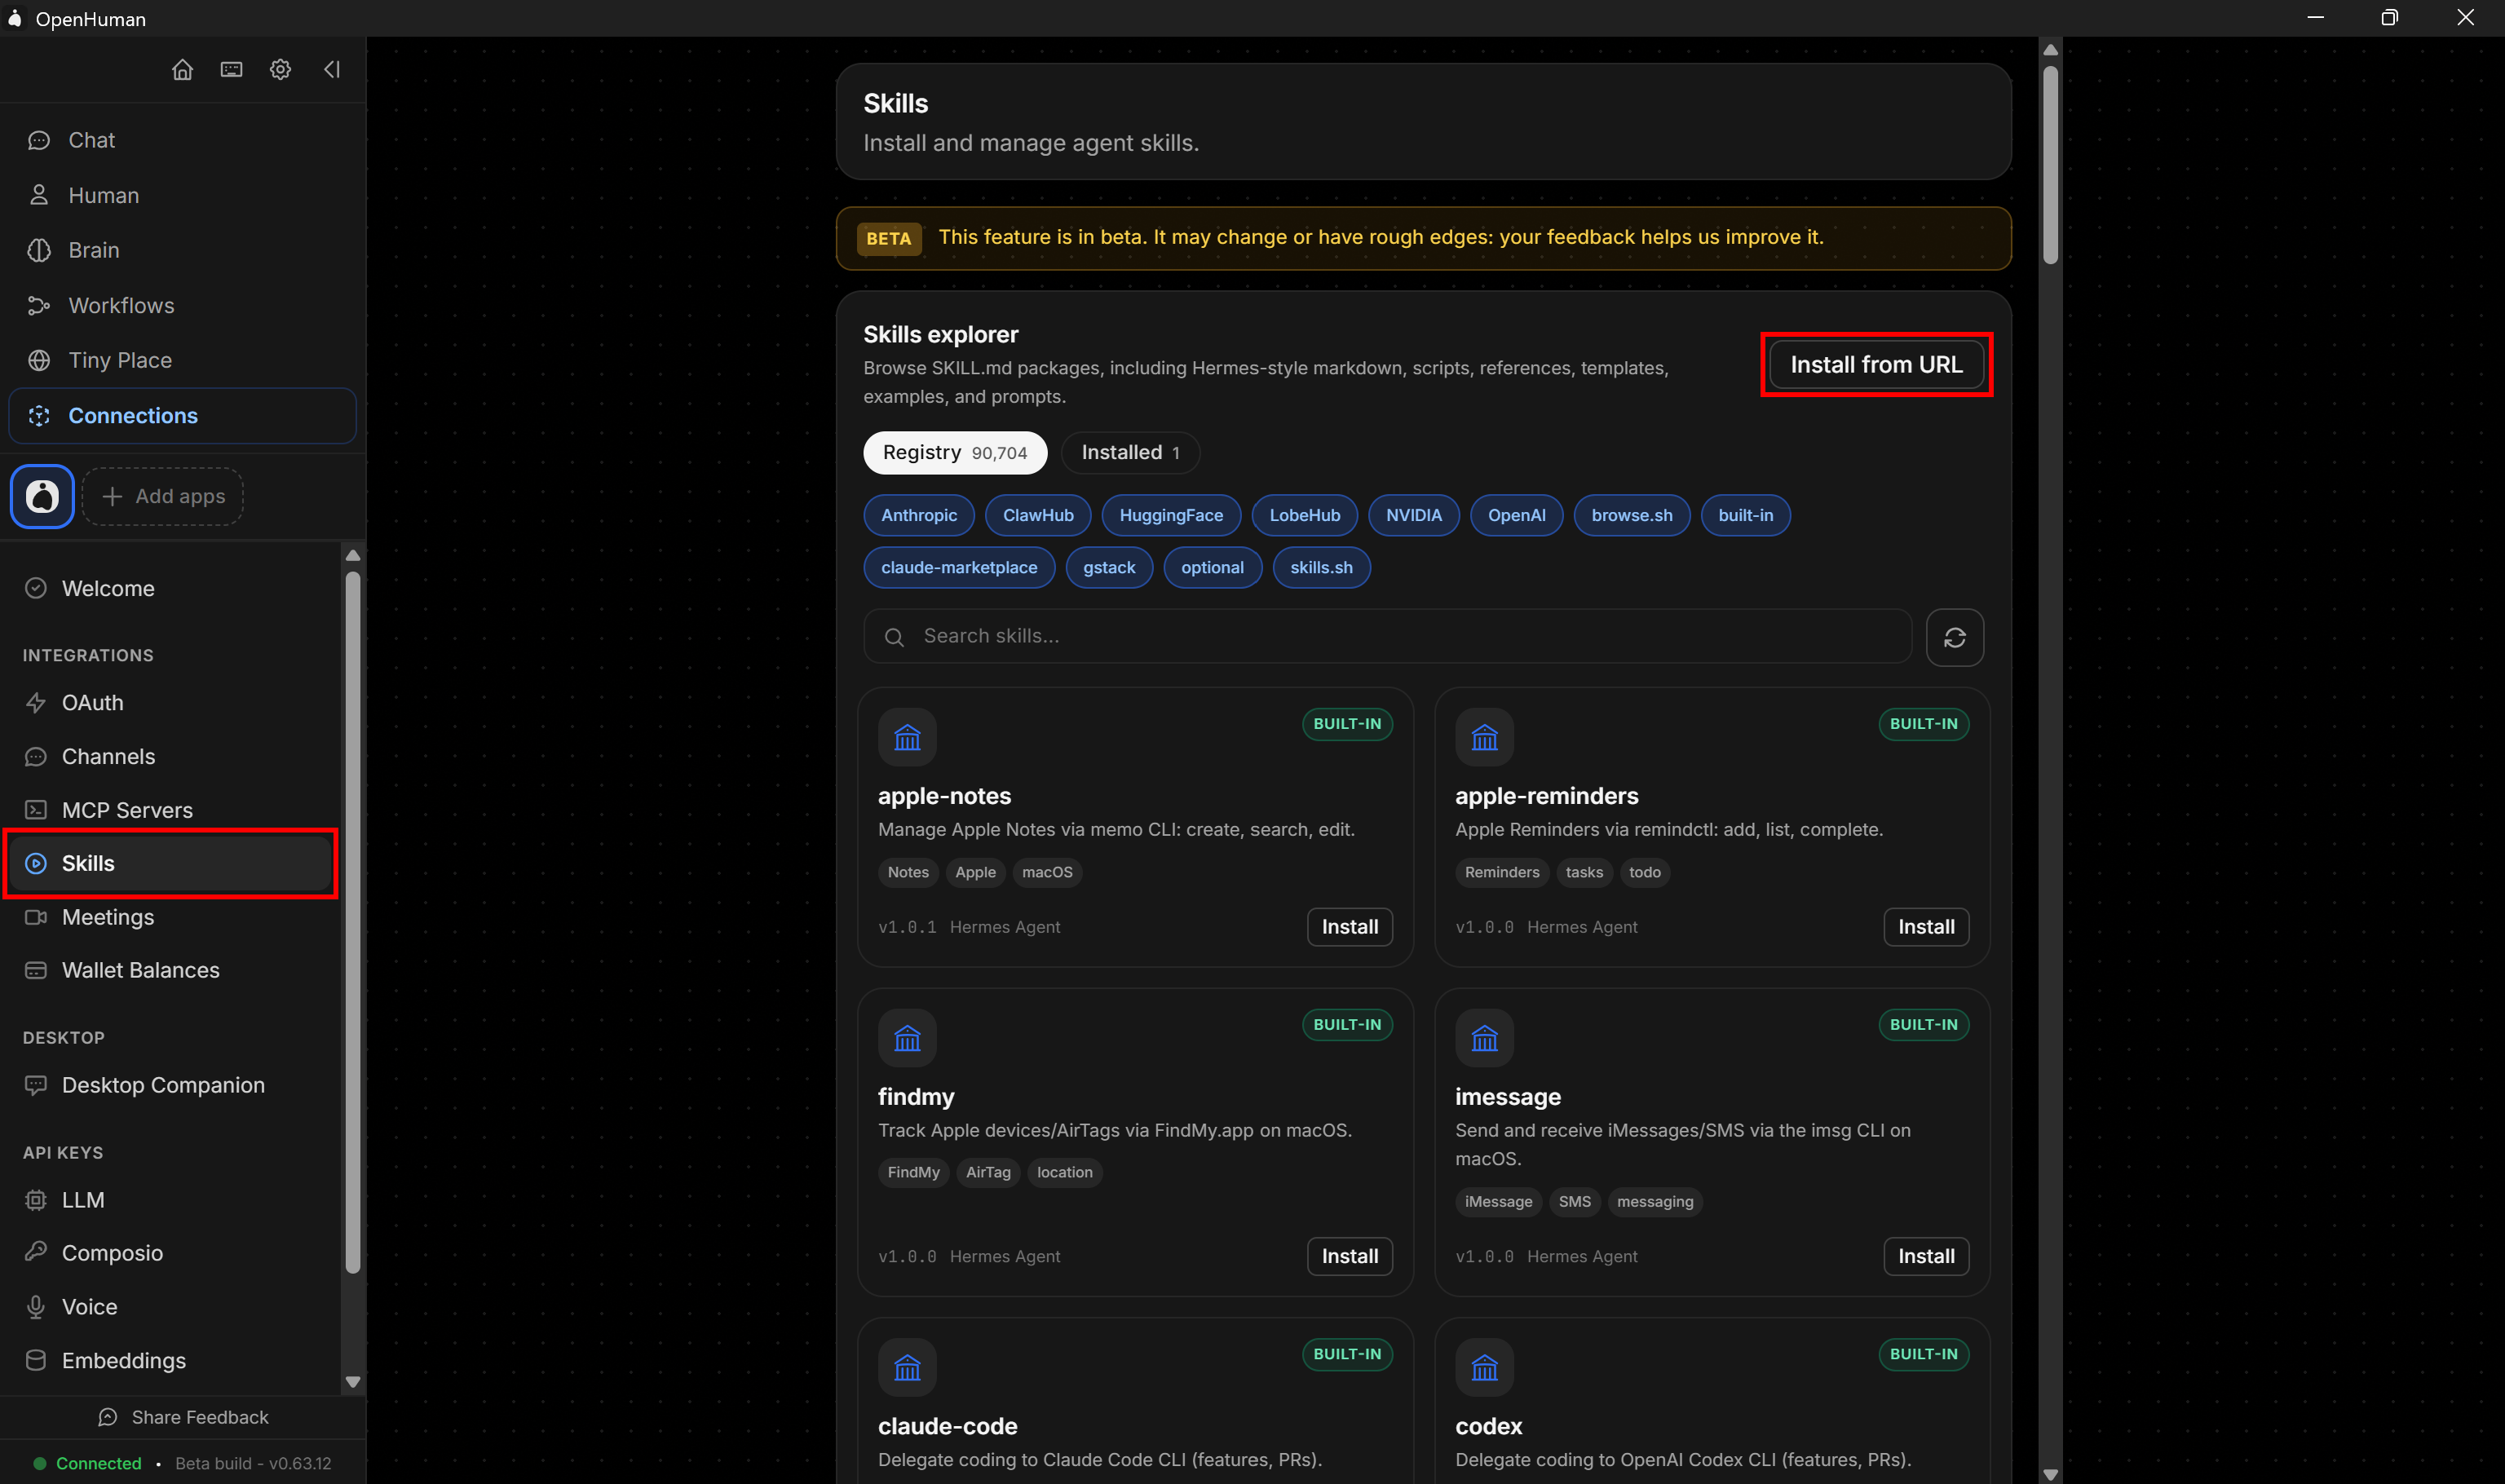
随后会打开一个对话框,要求你输入指向 SKILL.md 文件的 raw.githubusercontent.com URL。
Bright Data skills 托管在 GitHub 上。要找到 brightdata-cli 技能,请访问 brightdata/skills 仓库并导航到 /skills 目录。然后,打开 /brightdata-cli 文件夹并选择 SKILL.md 文件。
在 brightdata/skills/skills/brightdata-cli/SKILL.md 文件页面上,点击“Raw”查看其原始 GitHub 内容:
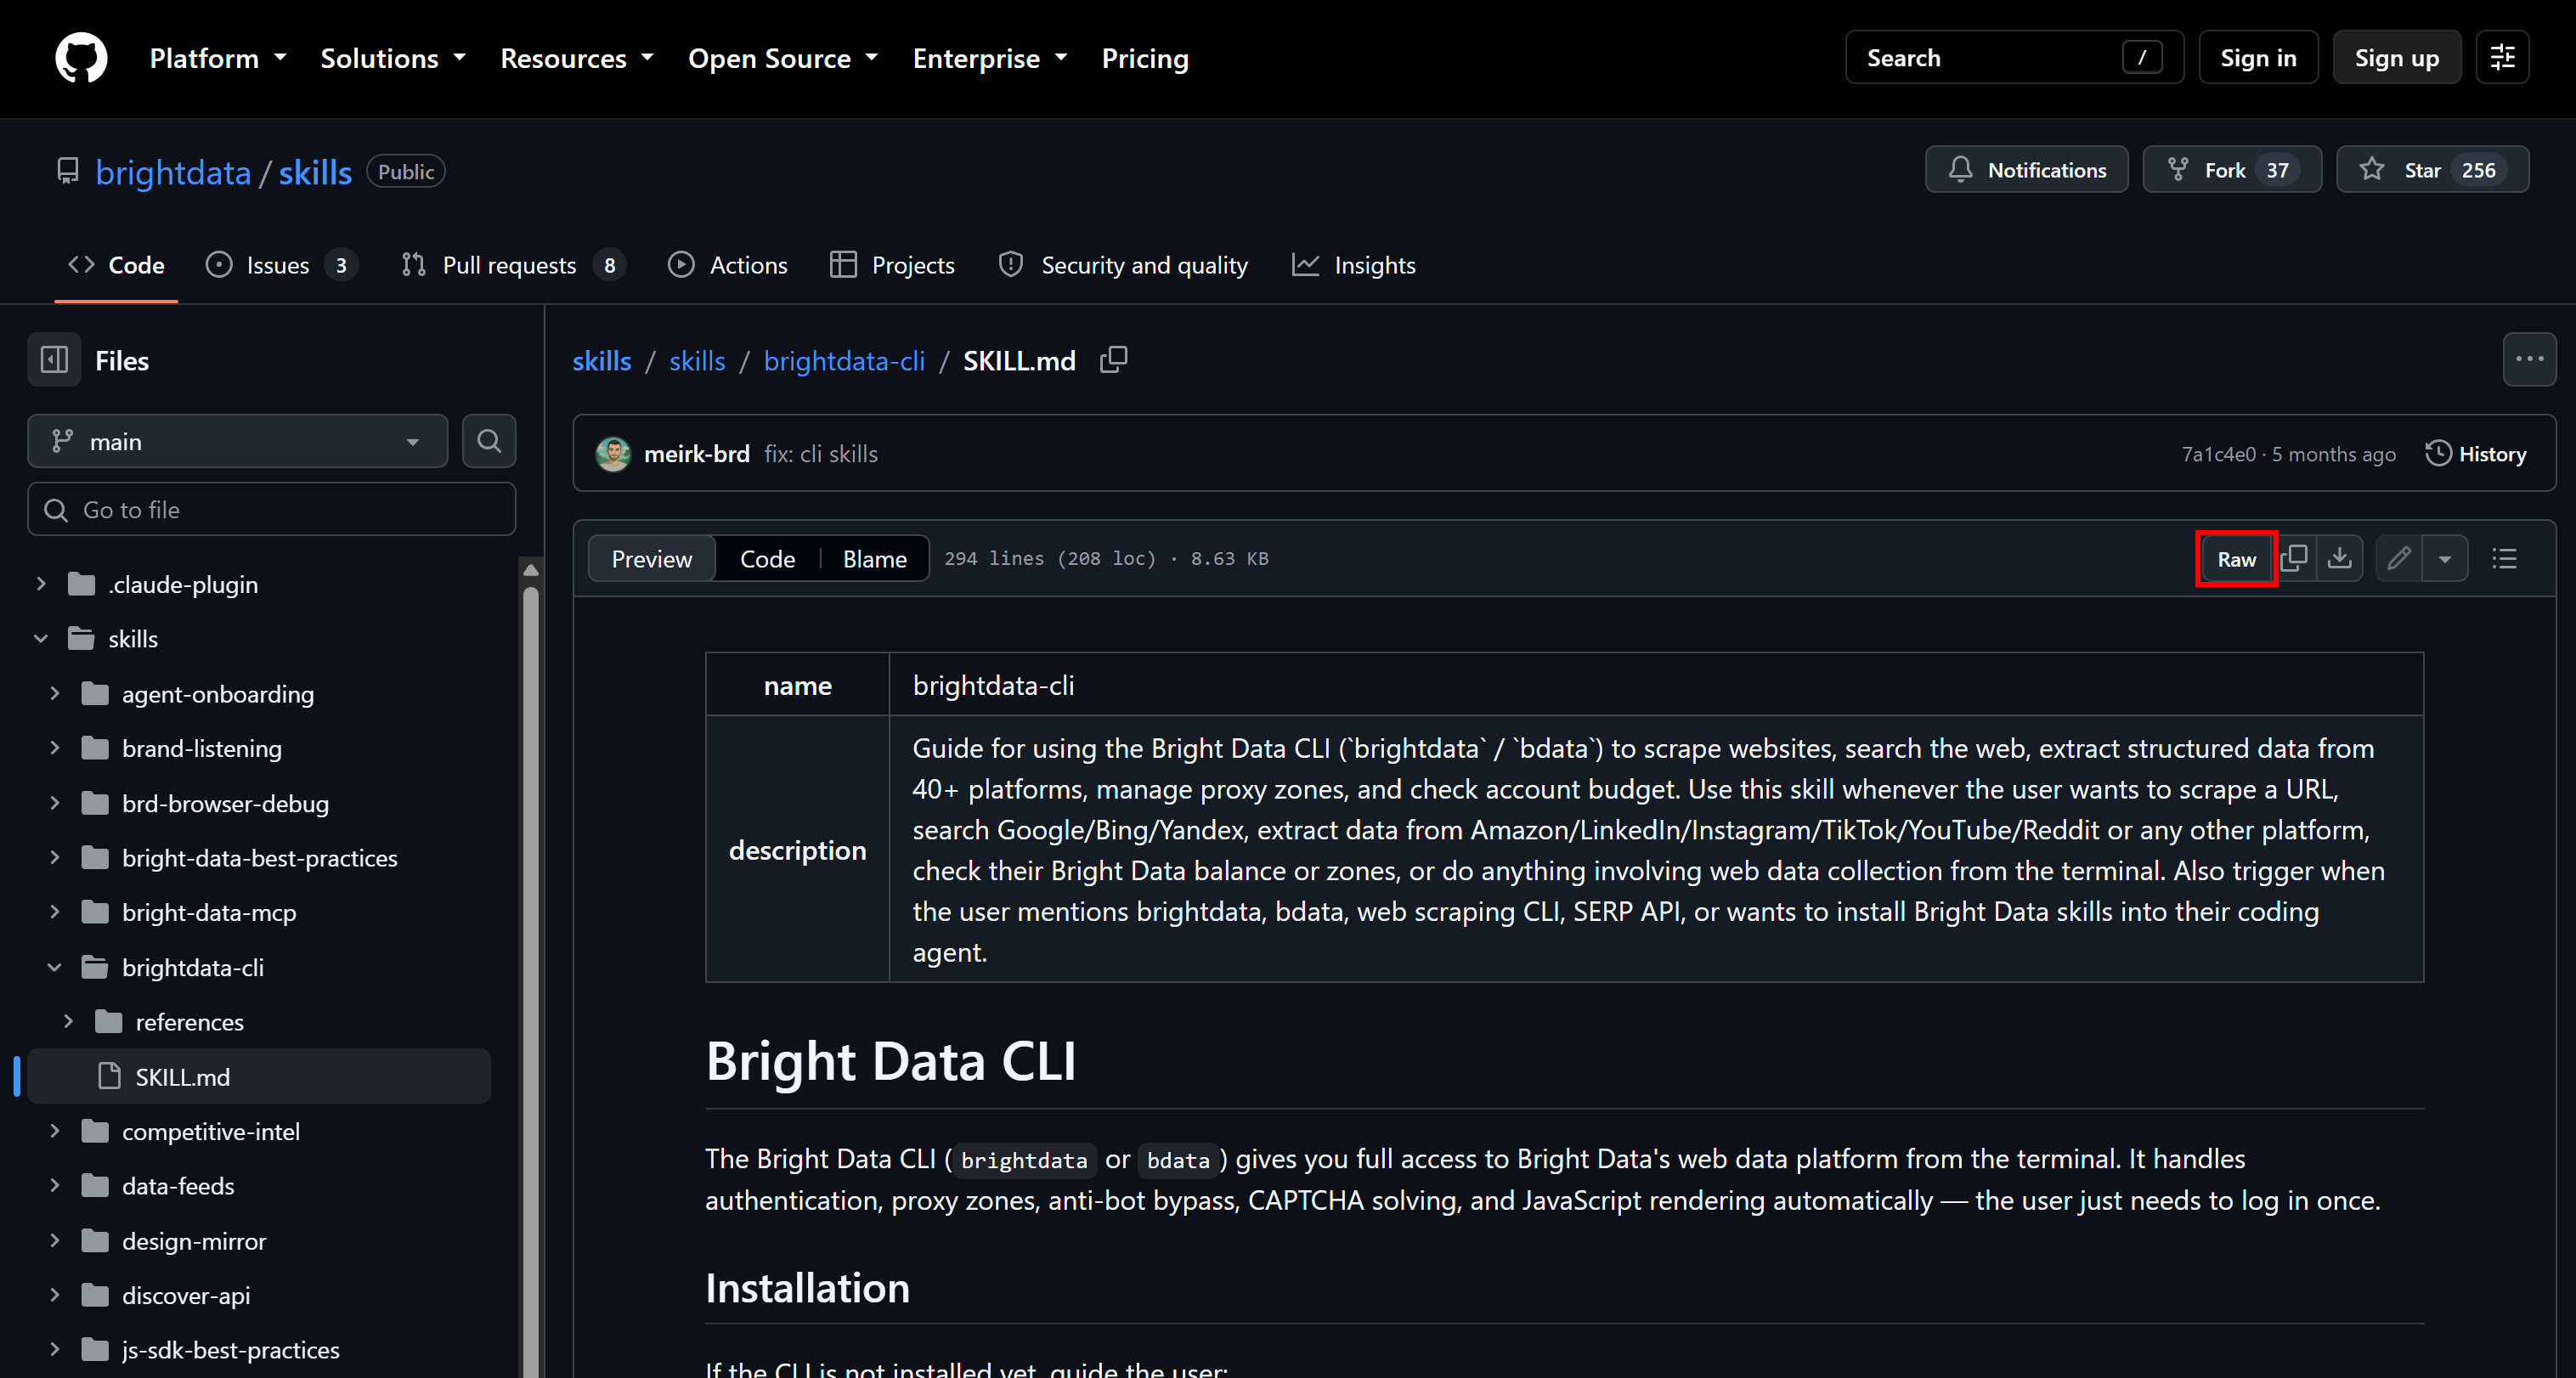
新页面的 URL 将是:
https://raw.githubusercontent.com/brightdata/skills/refs/heads/main/skills/brightdata-cli/SKILL.md将该 URL 粘贴到“Skill URL”字段中,然后点击“Install skill”:
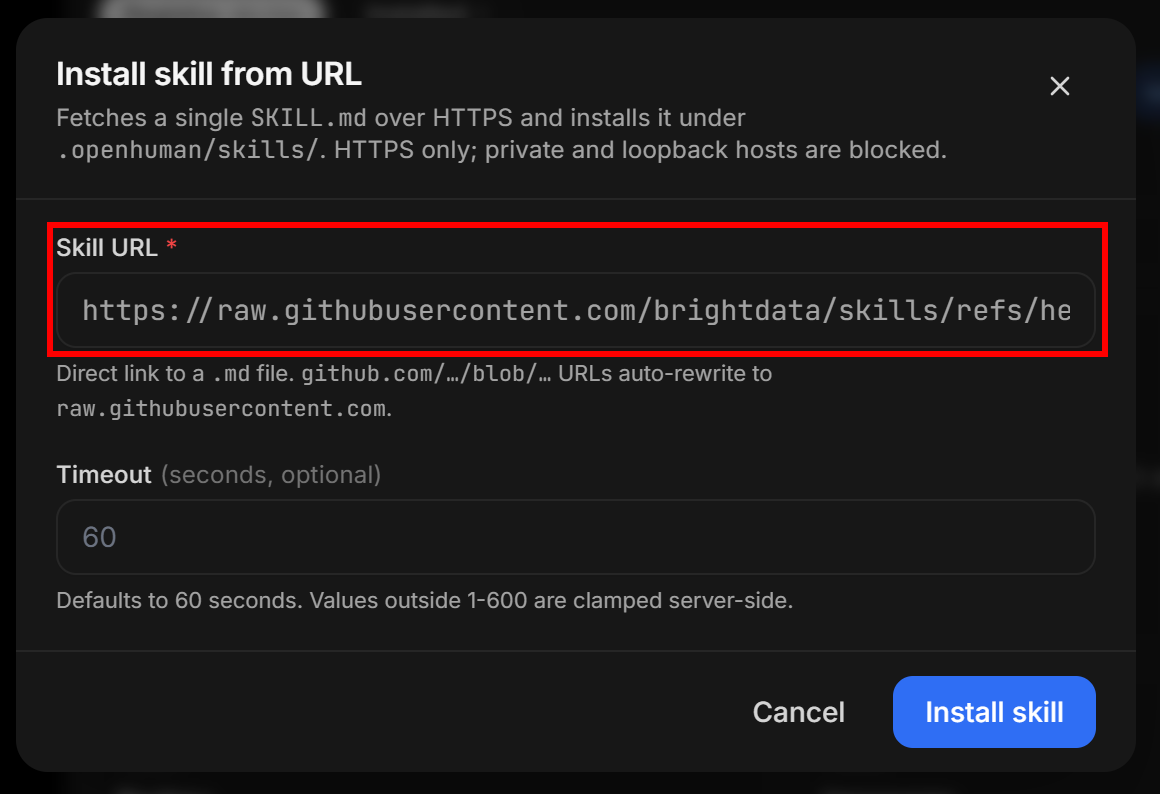
注意:通过同样的流程,你可以安装任何其他 Bright Data 技能。
太好了!brightdata-cli 技能现在已安装,它为 OpenHuman 提供了使用 Bright Data CLI 所需的知识。
第 5 步:验证技能安装
点击“Install skill”后,你应该会看到一个显示“Install complete”的成功提示 UI 元素:
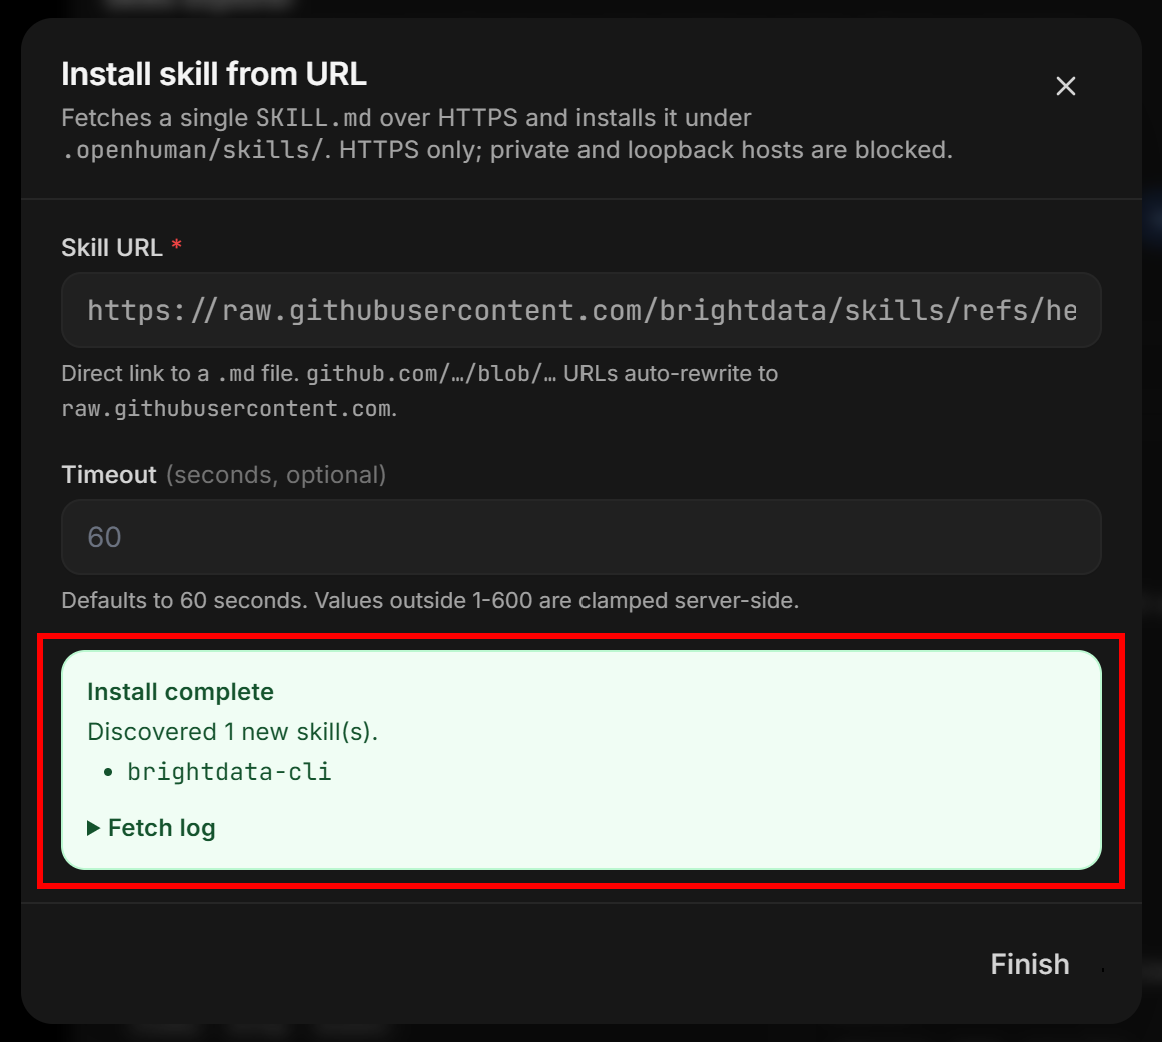
点击“Finish”。“技能”页面的“Installed”部分现在应该会列出 brightdata-cli 技能:
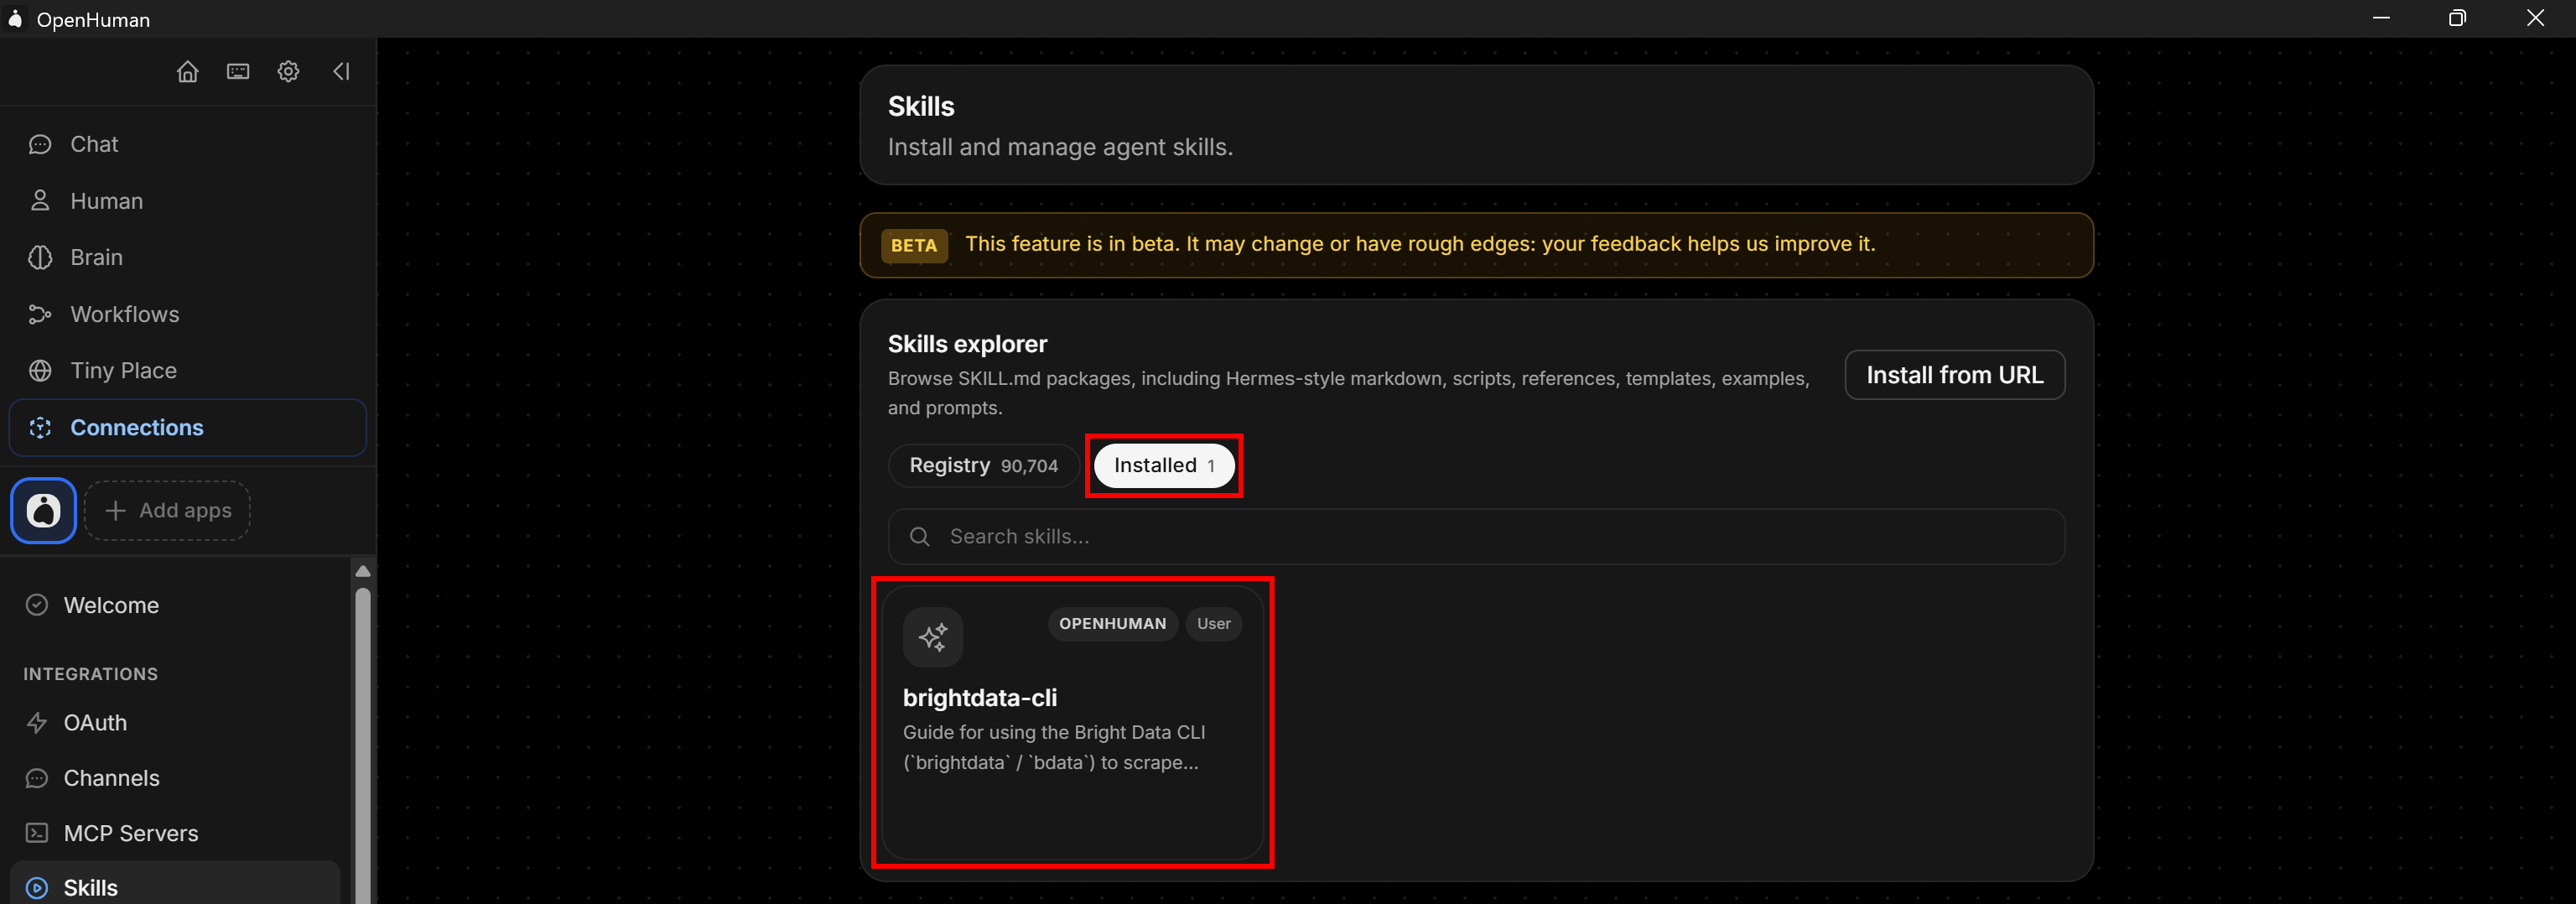
无需激活该技能,也无需将其分配给特定智能体。OpenHuman 可以在需要时自动发现并使用已安装的技能。
任务完成!剩下的就是把所有内容组合起来,测试 OpenHuman + Bright Data 设置。
第 6 步:测试集成
要验证 OpenHuman 能否通过 brightdata-cli 技能调用 Bright Data CLI,请给它一个涉及网页任务的任务。
例如,写入以下提示词:
Using the installed brightdata-cli skill, learn how to use the Bright Data CLI. Then, use the CLI to search for the latest NVIDIA news. Select the three most relevant articles and produce a simple report with all the main information.这应足以验证 OpenHuman 能够:
- 加载
brightdata-cli技能。 - 从该技能中学习如何使用 Bright Data CLI。
- 使用 CLI 的
search命令搜索最新的 NVIDIA 新闻。 - 解析搜索命令返回的结构化 JSON 结果。
- 选择三篇最有意思的新闻文章。
- 使用 CLI 的
scrape命令爬虫所选页面,以检索其 Markdown 内容。 - 分析爬虫到的内容,并生成一份最终报告,其中包含所选 NVIDIA 新闻的主要信息。
前往“Chat”标签页,粘贴提示词并运行。你应该会看到类似这样的内容:
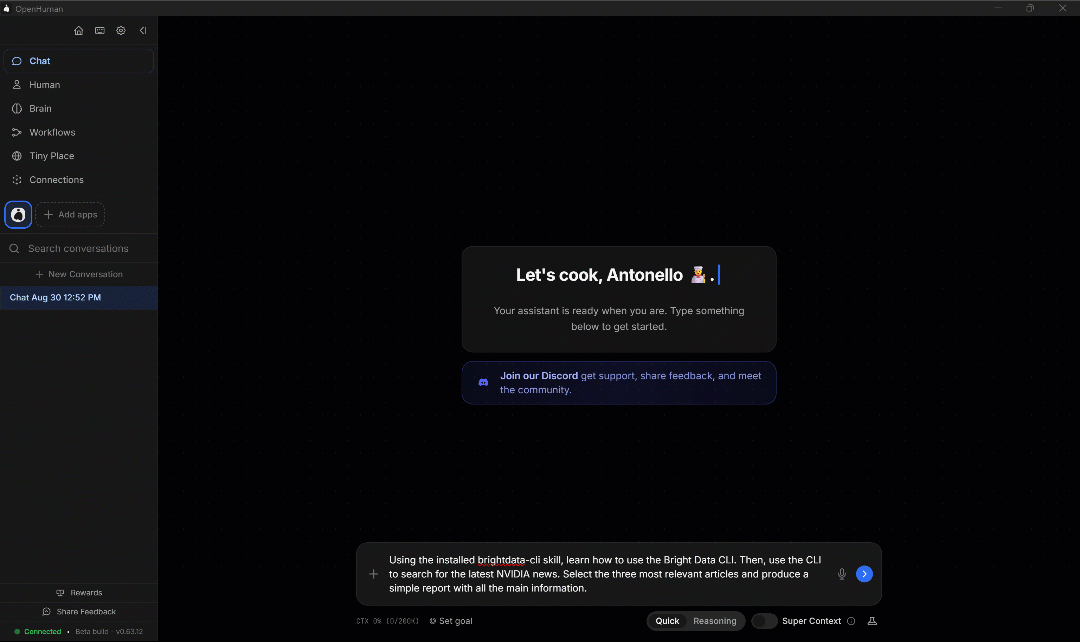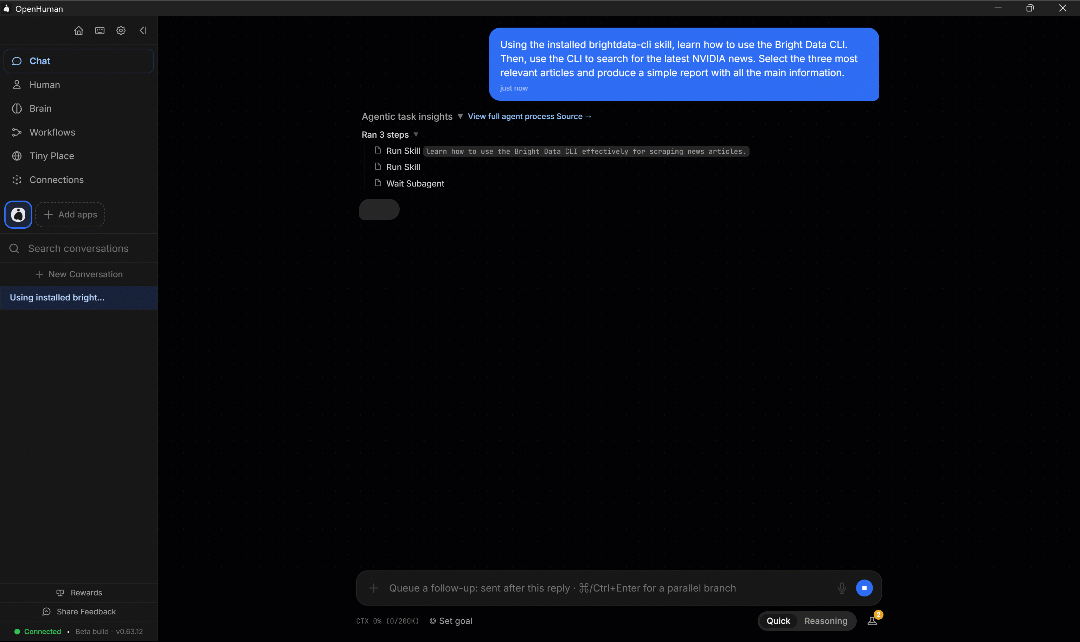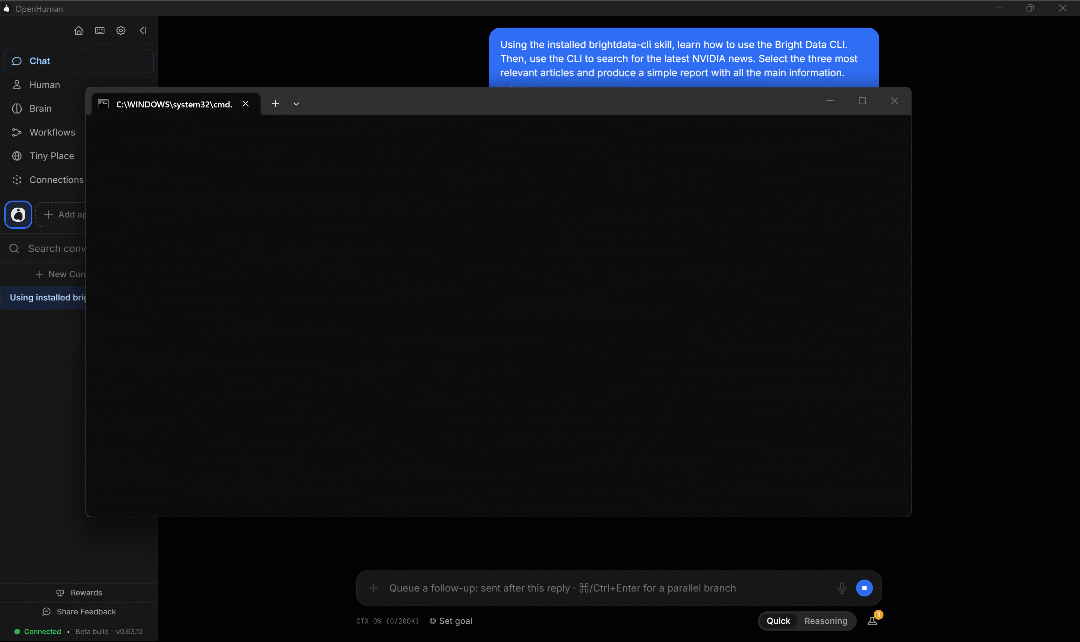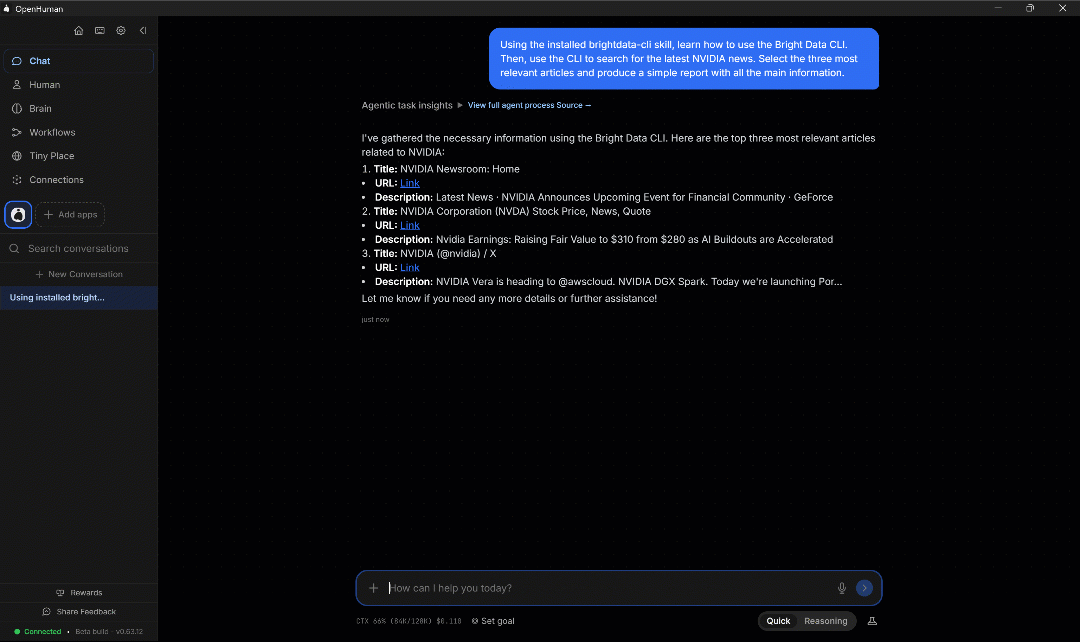
注意 OpenHuman 如何自动执行所有步骤。特别是在运行过程中,你可能会看到终端窗口打开。这些就是底层智能体为完成任务而执行的 Bright Data CLI 命令。
最终结果应包含三篇选定的 NVIDIA 新闻文章,并附上每篇文章的简短摘要和链接。
看吧!这个非常简单的示例展示了 OpenHuman 现在如何可靠地访问网页,而不会被拦截或受限。这得益于通过专用的 brightdata-cli 智能体技能,经由 Bright Data CLI 集成 Bright Data 解决方案。
后续步骤
到目前为止,你看到的只是 OpenHuman 和 Bright Data 可以实现的一个简单示例。该集成可以支持复杂得多的用例。下面是一些值得探索的可行场景:
- 自动化研究:让 OpenHuman 研究一个主题,从多个在线来源收集信息,并将研究结果整理成带有来源的结构化报告。
- 竞争情报:创建一个持续研究竞争对手的工作流,监控其网站和公开信息,并用最新进展更新你的本地知识库。
- 电商监控:将网页数据访问与 OpenHuman 的持久记忆结合起来,长期跟踪在线市场中的产品、价格、库存、评论和其他变化。
- 新闻简报:设置一个定期工作流,监控你关注的主题,研究新的进展,总结最重要的发现,并通过 Telegram、WhatsApp、Slack 或其他受支持的渠道发送简报。
- 潜在客户研究:让 OpenHuman 研究公司或潜在客户,收集相关公开信息,整理研究结果,并将结果保存到其持久记忆中,以便未来任务使用。
- 可视化工作流:构建由触发器驱动的工作流,让 OpenHuman 可以根据预定义条件自动开始研究、处理网页数据,并执行后续操作。
结论
在这篇博客文章中,你了解了 OpenHuman 是什么,以及它如何成为你的个人 AI 超级智能助手。你还看到了如何通过 brightdata-cli 技能,将它连接到 Bright Data 的网页数据产品套件,并通过 Bright Data CLI 完成集成。
Bright Data 可以用生产级、可扩展且可靠的工具扩展并替代 OpenHuman 内置的网页搜索工具。这些工具让 OpenHuman 智能体能够搜索信息、发现新来源、爬虫网页内容,并像真人一样与网页交互。
今天就免费创建 Bright Data 账户,并探索我们的 AI 就绪网页数据产品!


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。