Claude Code 的大部分工作时间都在 shell 内度过。每一次搜索、测试运行、提交和 API 调用都通过 Bash 完成。这意味着安装在你机器上的工具决定了智能体实际能做什么的上限。给它一个薄弱的工具链,它就会写出缓慢、脆弱的变通方案。给它一个锋利的工具链,同一个模型就能在少得多的轮次内完成。本指南介绍值得安装在 Claude Code 旁边的十个命令行工具,从 Bright Data CLI 开始,它修复了智能体最大的单一盲点:可靠访问开放网络。
这个列表带有明确取向。这里的每个工具都是非交互式、可脚本化,并且适合智能体无人值守运行的。需要人在键盘前操作的工具被排除在外,末尾还有一小节解释为什么几个热门选择没有入选。
TL;DR:10 个 CLI 以及它们各自解决的问题
| # | CLI | 它为 Claude Code 解决的问题 | 安装 |
|---|---|---|---|
| 1 | Bright Data CLI | 真实网页访问:解锁、搜索引擎 API、40+ 个结构化数据流水线、浏览器控制 | npm i -g @brightdata/cli |
| 2 | ripgrep | 在整个代码库中进行快速、感知 .gitignore 的搜索 |
brew install ripgrep |
| 3 | ast-grep | 按语法而不是正则进行结构化搜索和重构 | brew install ast-grep |
| 4 | gh | 完整 GitHub 工作流:PR、issue、CI 运行、API | brew install gh |
| 5 | jq | 切分 JSON,让只有需要的字段进入上下文 | brew install jq |
| 6 | just | 智能体可以读取和运行的可发现任务列表 | brew install just |
| 7 | uv | 近乎即时的 Python 安装、运行和 lockfile | curl -LsSf https://astral.sh/uv/install.sh | sh |
| 8 | bun | 用一个二进制文件完成 JS 安装、运行、测试和打包 | curl -fsSL https://bun.sh/install | bash |
| 9 | gitleaks | 在智能体提交密钥之前阻止它们 | brew install gitleaks |
| 10 | Firecrawl CLI | 对网页数据的第二意见,加上面向编码智能体的搜索索引 | npm i -g firecrawl-cli |
什么样的 CLI 特别适合 Claude Code
通常的“最佳终端工具”列表是为人类优化的。智能体有不同的要求,而这种不匹配很重要。一个在交互式会话中让你满意的工具,对 Claude Code 可能毫无用处,而一个朴素、无聊的二进制文件却可能带来变革。在向你的机器添加任何东西之前,用五个标准检查它,这些标准可以预测智能体是否真的能成功使用它。
它必须能非交互式运行。 智能体无法回答确认提示,也无法导航全屏界面。任何需要 TTY 的东西都会让该轮挂起,直到超时。
它必须输出结构化结果。 --json 标志会把一墙文本变成智能体可以用 jq 过滤并精确推理的内容。散文式输出会招致解析错误。
它必须节省 token。 工具打印的每一个字节都是上下文窗口中的一个字节。带有静默模式、字段选择和分页的工具可以让会话成本更低、持续更久。
它必须返回诚实的退出码。 Claude Code 部分依据退出状态来决定下一步做什么。一个失败时仍以 0 退出的工具,会自信地把智能体带到错误路径上。
它必须可组合。 对管道友好的工具可以串成一条命令,而不是五轮对话。下面的示例是一次 Bash 调用,否则会是一段多步骤对话:搜索网页、取得顶部结果并抓取它。
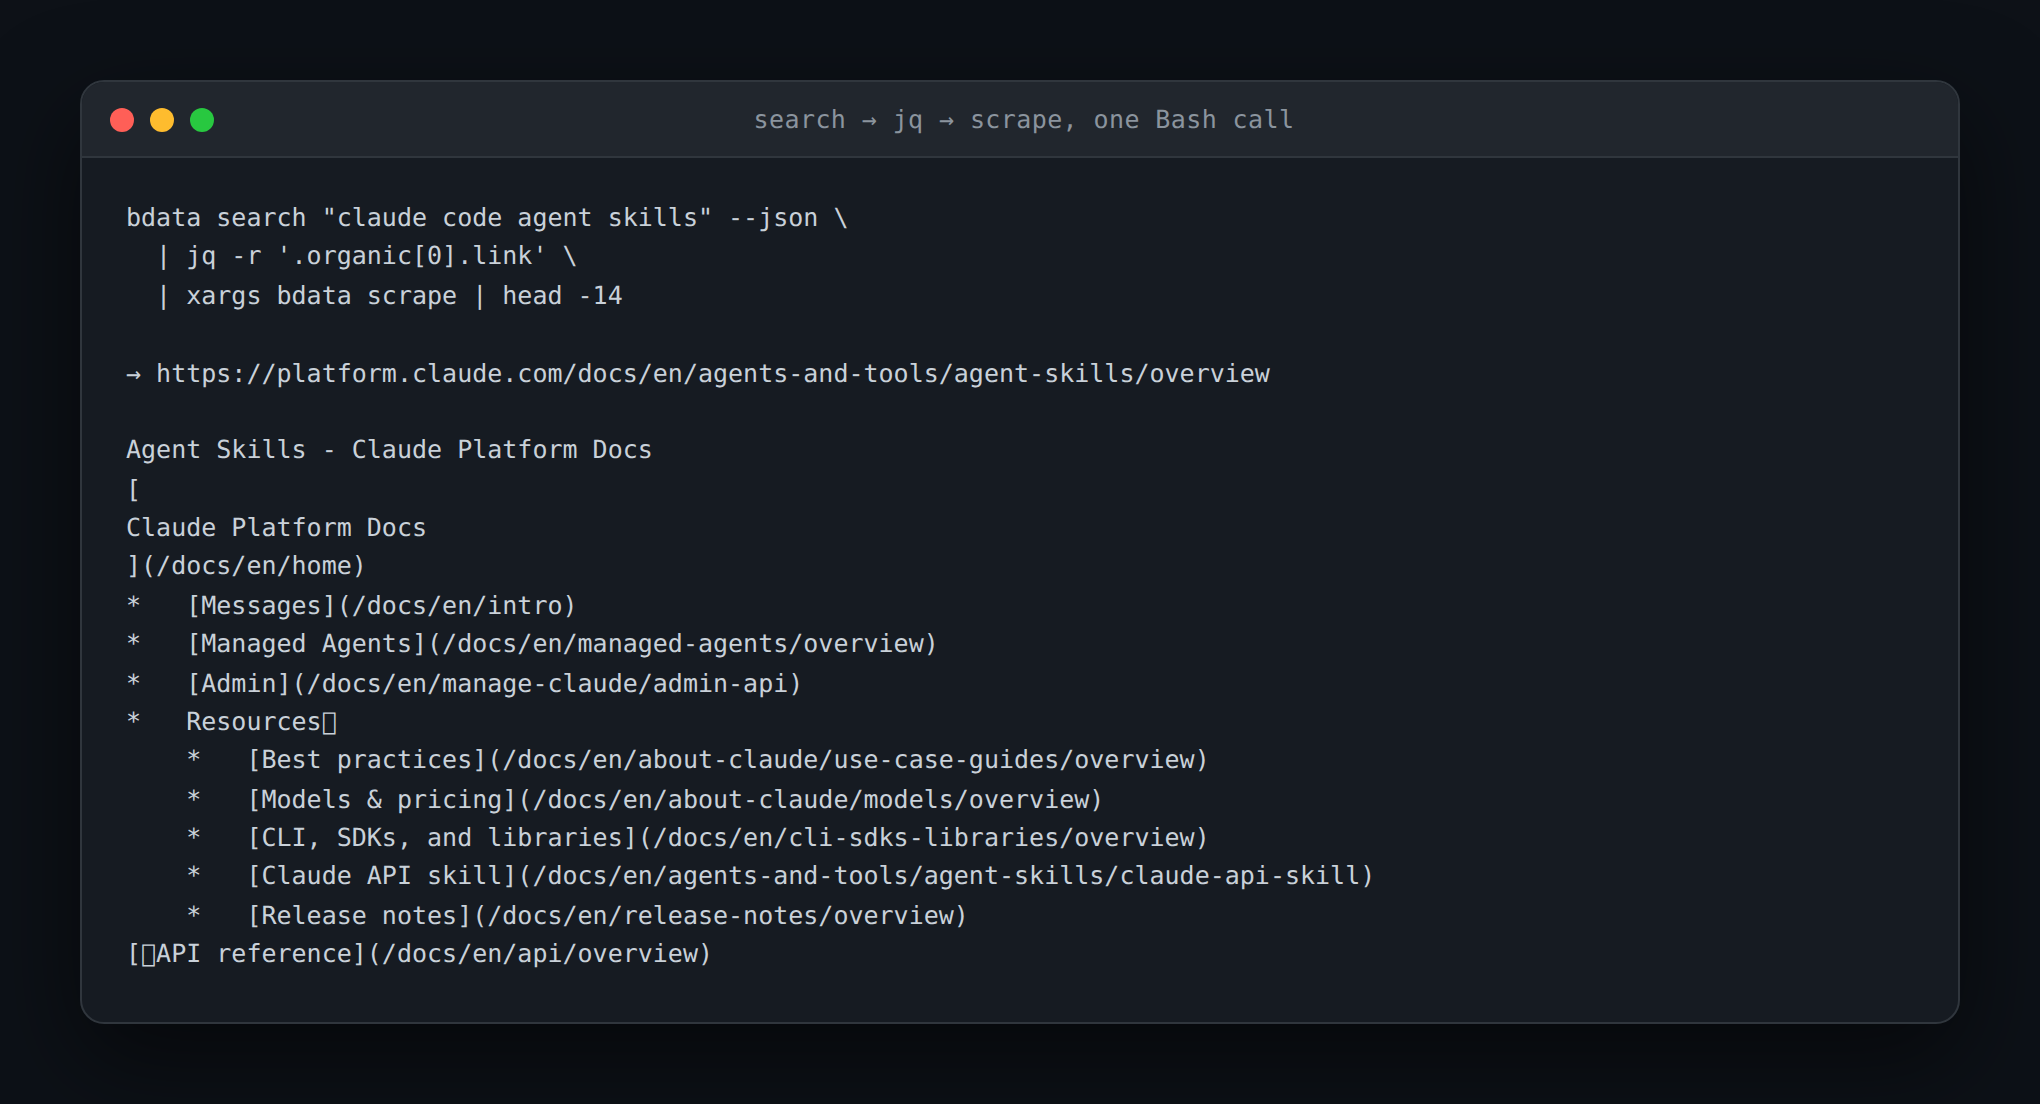
其他列表没有覆盖的缺口:Claude Code 几乎无法触达开放网络
Claude Code 自带两个网页工具,而两者都比人们预期的受限得多。WebSearch 仅限美国,因此任何依赖本地结果的查询都不在考虑范围内。WebFetch 执行普通 HTTP GET,然后通过一个小模型对页面进行摘要。它不执行 JavaScript,不解决反机器人挑战,也不轮换 IP。
实际失败模式直接来自这种设计。位于 Cloudflare、DataDome 或 Akamai 后面的站点会返回挑战页面而不是内容。单页应用会返回空壳,因为没有 JavaScript 内容根本不会加载。经过身份验证的私有 URL 会直接失败。响应会按 URL 缓存十五分钟,因此修复后重试会返回同一个过时的 body。跨主机重定向会被交还给模型而不是被跟随,每次都会消耗一轮。
这些都不是对 Claude Code 的批评。可靠的网页访问是基础设施问题,不是模型问题,它通过代理、浏览器指纹管理和验证码处理来解决。这正是本列表第一个工具被构建出来要完成的工作。
1. Bright Data CLI:来自终端的真实网页访问
Bright Data CLI 把完整的网页数据栈放在一个二进制文件后面。单次 bdata login 会对工具进行身份验证,并预配它需要的区域,之后爬虫、搜索、结构化提取和浏览器自动化都无需进一步配置即可工作。它是最接近网页访问瑞士军刀的东西,也是这里唯一一个改变 Claude Code 能力范围的工具,而不仅仅是让它更快完成已经能做的事。
npm install -g @brightdata/cli   # or: curl -fsSL https://cli.brightdata.com/install.sh | sh
bdata login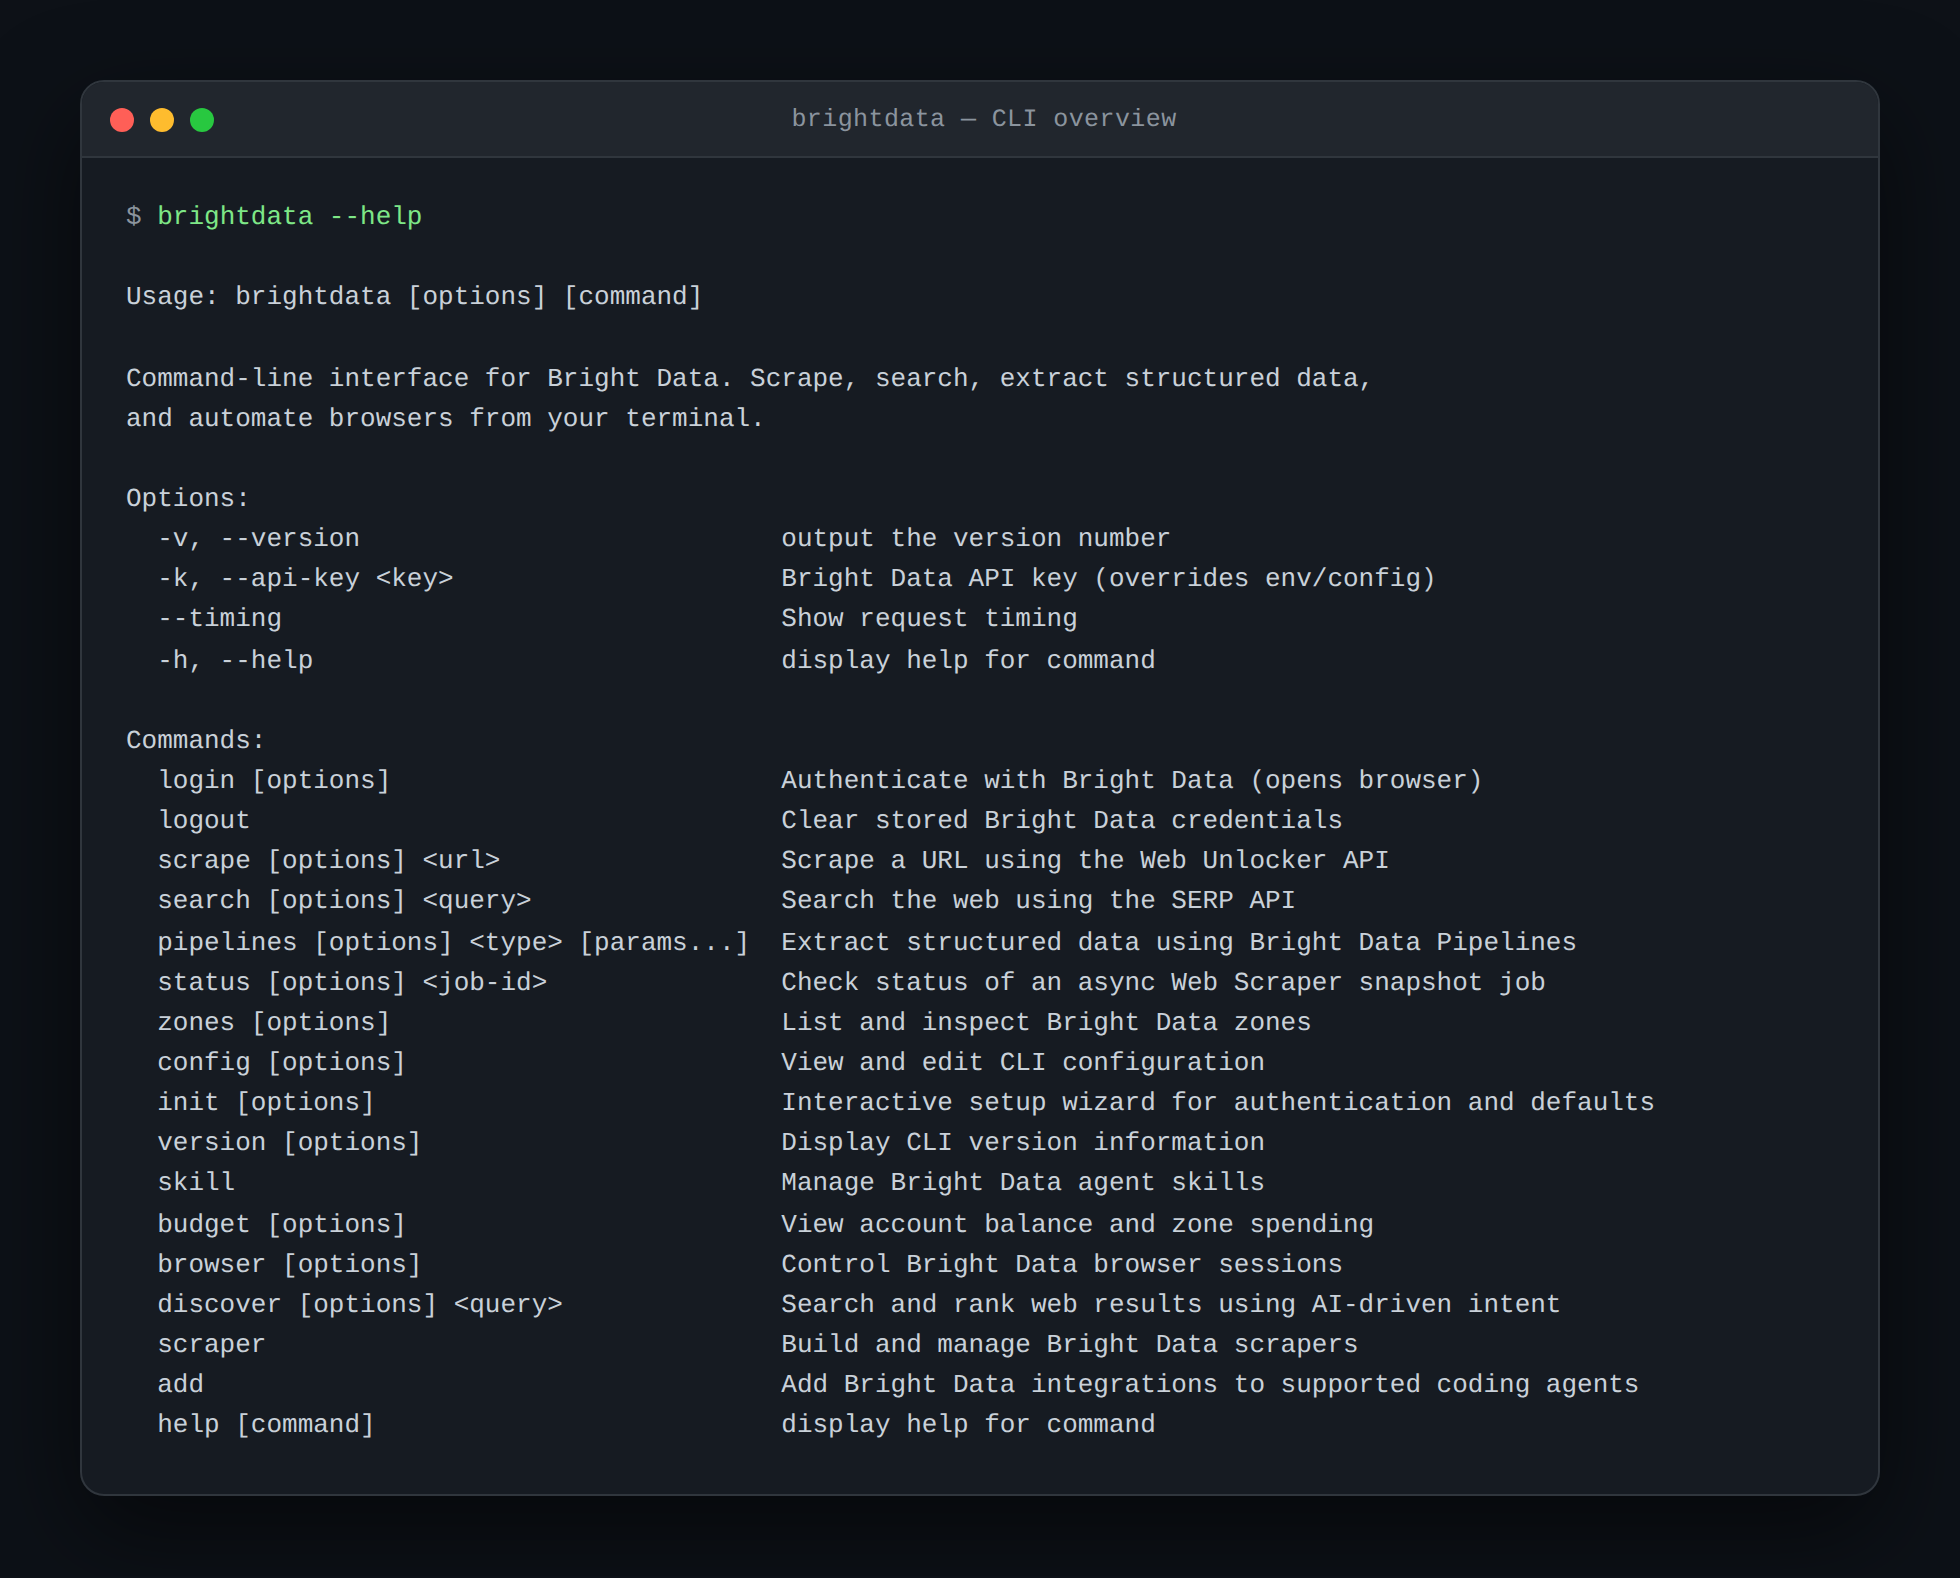
抓取任何内容,包括受保护页面。 bdata scrape 通过 网络解锁器 运行,它会自动处理 CAPTCHA、JavaScript 渲染和反机器人系统。输出可以是 markdown、HTML、JSON 或截图,请求可以进行地理定位,或使用移动端 user agent 发送。
bdata scrape https://example.com                              # clean markdown
bdata scrape https://example.com --country de --mobile      # geo + device targeting
bdata scrape https://example.com --format json --pretty -o page.json
在没有美国限定的情况下搜索。 bdata search 通过 搜索引擎 API 访问 Google、Bing 或 Yandex,并返回结构化结果,可控制国家/地区、语言、设备和结果类型。
bdata search "best python orm" --country de --language de --json
bdata search "nvidia earnings" --type news --pretty
从 40+ 个平台拉取预解析数据。 这是没有竞争 CLI 能匹配的能力。bdata pipelines 会从 Amazon、LinkedIn、TikTok、Instagram、YouTube、Reddit、Zillow、Crunchbase、Google Maps 等平台的 网页爬虫工具 API 返回干净、schema 稳定的记录,因此智能体永远不需要写 selector 或维护 parser。
bdata pipelines list                                          # all 40+ types
bdata pipelines amazon_product https://www.amazon.com/dp/B08N5WRWNW --pretty
bdata pipelines linkedin_person_profile <url> --format csv -o profile.csv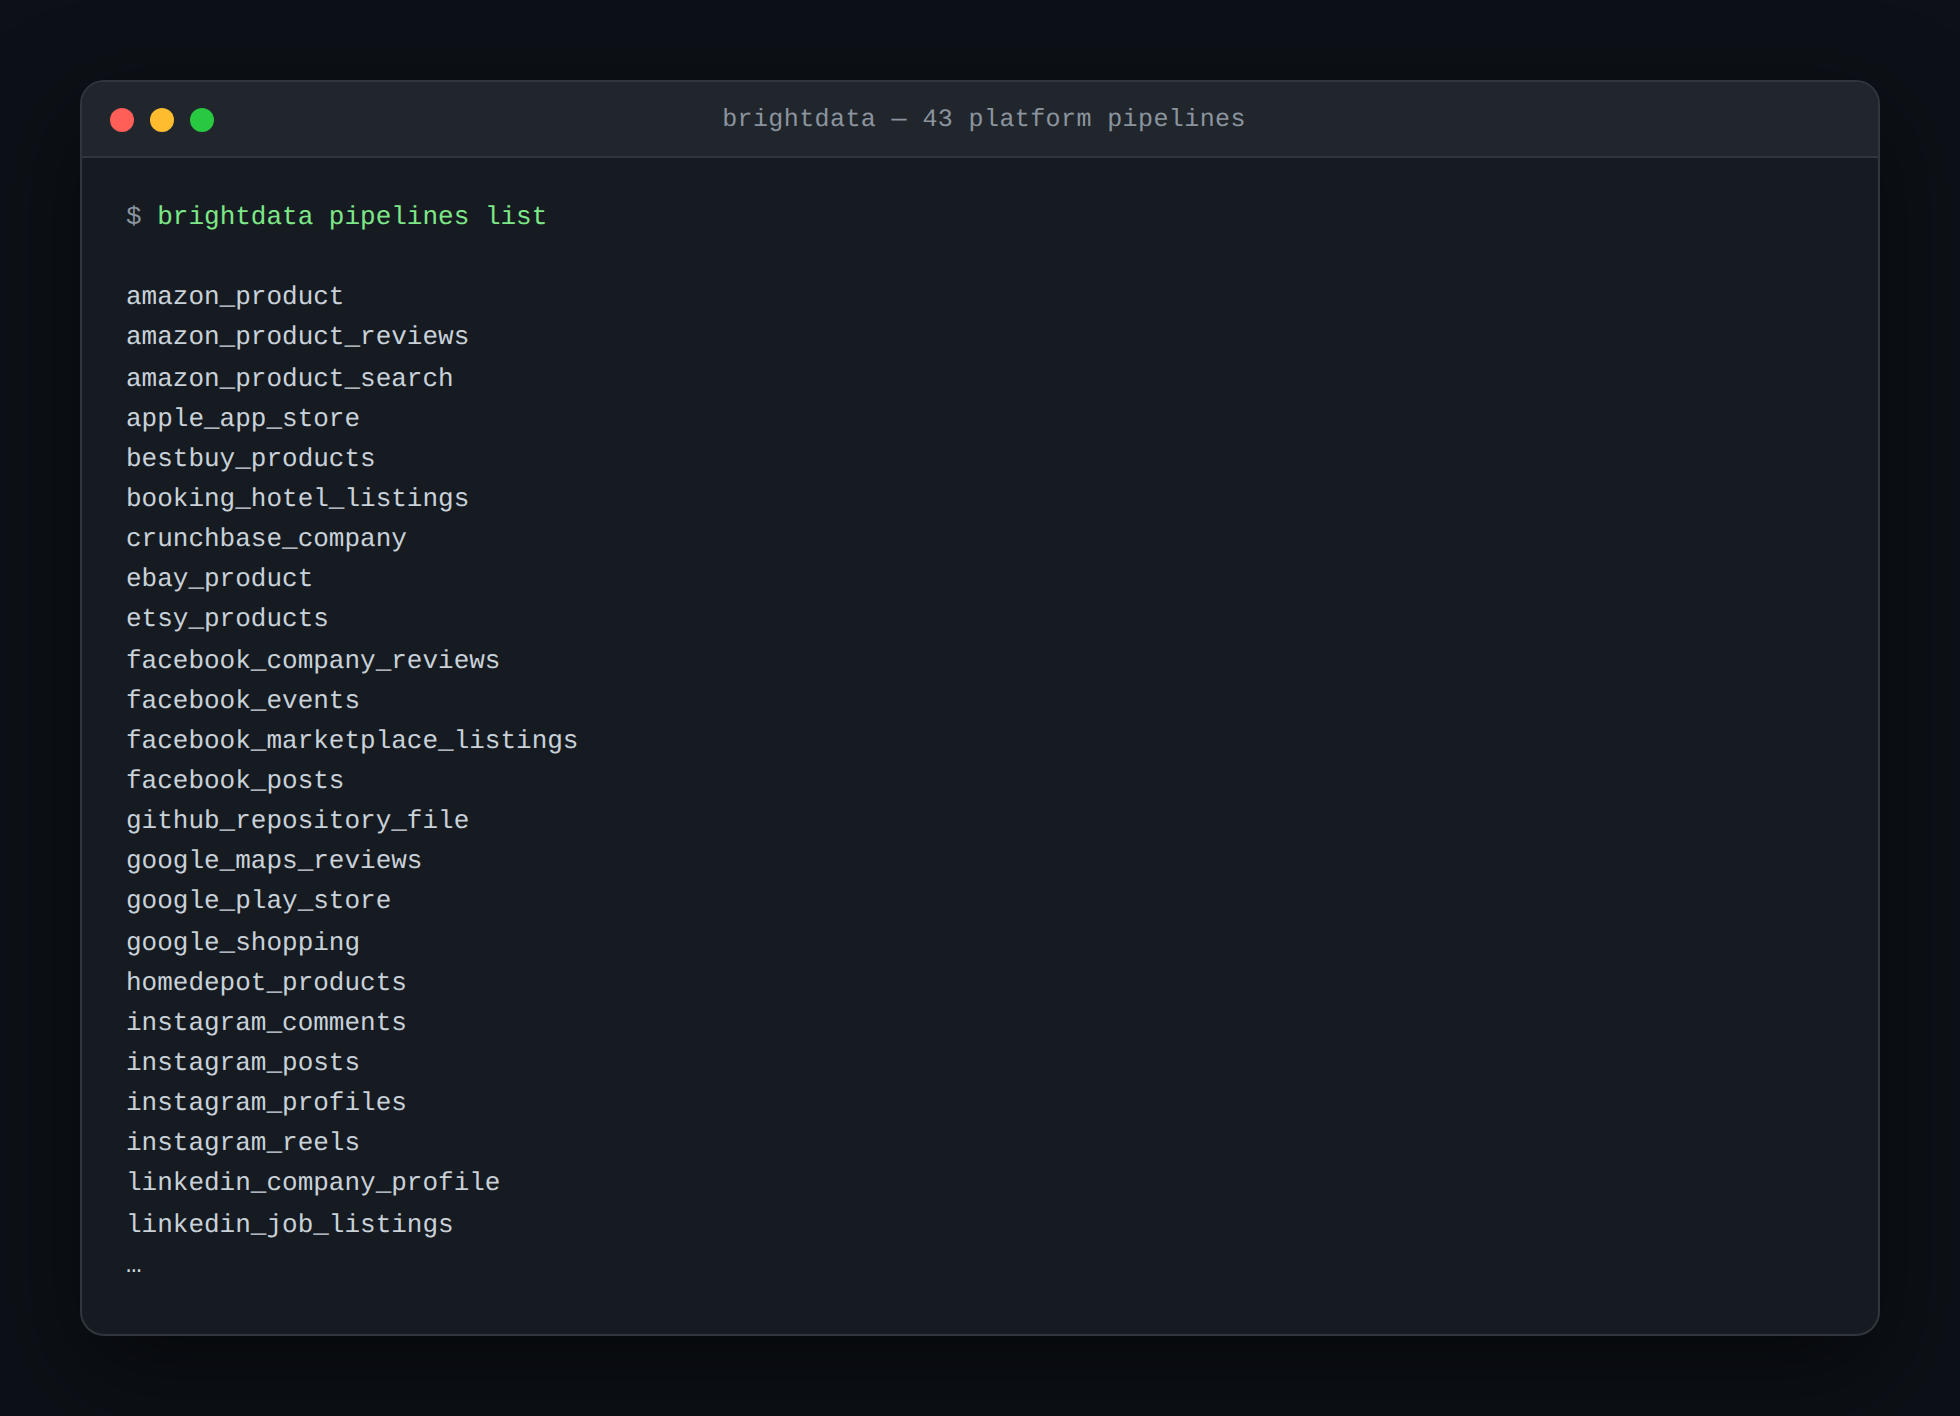
构建能自我修复的爬虫工具。 bdata scraper create 会根据自然语言描述生成 collector。当目标网站发生变化时,bdata scraper heal 会提出修复方案,并在应用之前等待批准。这个批准门槛让智能体维护生产级爬虫工具变得安全。
bdata scraper create https://example.com/products "extract title, price, and SKU"
bdata scraper run <collector_id> https://example.com/products/123
bdata scraper heal <collector_id> "price selector changed"
bdata scraper approve <collector_id>
从 shell 驱动真实浏览器。 browser 子命令运行在 爬虫浏览器 上,并在持久化命名会话中打开页面、点击、输入和读取状态。snapshot 返回文本可访问性树而不是原始 HTML,--compact 会将其裁剪为仅交互元素,在复杂页面上显著降低 token 使用量。
bdata browser open https://example.com --session checkout
bdata browser snapshot --compact
bdata browser click <ref> && bdata browser get text "#total"
将它安装为 Claude Code skill。 与其每个会话都在提示中描述该工具,不如安装官方 技能,让智能体预先知道命令表面。如果你更偏好协议路线,同一个账户也支持 Claude Code 的 Web MCP 服务器。
bdata skill list
bdata skill add search
bdata add mcp            # optional: also register the MCP server
定价和注意事项。 每个账户每月包含 5,000 个免费 credits,按月续期,无需信用卡。抓取、搜索和 pipeline 调用每次消耗一个 credit,足以舒适覆盖真实探索工作。Browser API 单独计量,并且确实需要信用卡。需要 Node.js 20 或更高版本。
给 Claude Code 真实的网页访问能力。安装 Bright Data CLI,并从每月 5,000 个免费 credits 开始,无需信用卡。
2. ripgrep:智能体已经依赖的搜索
Claude Code 内置的 Grep 工具是在 ripgrep 之上实现的,并且软件包随附一个捆绑二进制文件。系统级安装 rg 仍然重要,因为通过 Bash 调用的搜索可以获得完整的标志表面,智能体自己组合的任何命令也都可以使用它。ripgrep 默认遵循 .gitignore,因此 node_modules、dist、.venv 和 target 永远不会污染结果。在大型 monorepo 上,它能把三十秒的 grep -r 变成亚秒级答案,这会直接减少任务所需的轮数。
rg "createUser" -t ts -n --json
rg -l "TODO" --glob '!**/vendor/**'
将它与 fd 搭配用于文件发现。fd 将同样的 .gitignore 感知应用于查找文件,而且它的语法比 find 难出错得多。
3. ast-grep:按语法而不是正则重构
基于正则的重写是智能体造成最多损害的地方。一个看起来安全的模式会匹配注释、测试 fixture 或无关文件中的字符串,而 diff 会悄悄破坏某些东西。ast-grep 通过 tree-sitter 在语法树上工作,因此一个模式匹配的是真实代码结构而不是其他东西。它支持用于检查的结构化输出,以及在确认模式后进行原地重写,这符合智能体先检查、再应用的自然循环。
ast-grep run -p 'requests.get($$$)' --lang python .
ast-grep run -p 'foo($A, $B)' -r 'foo($B, $A)' --lang ts --update-all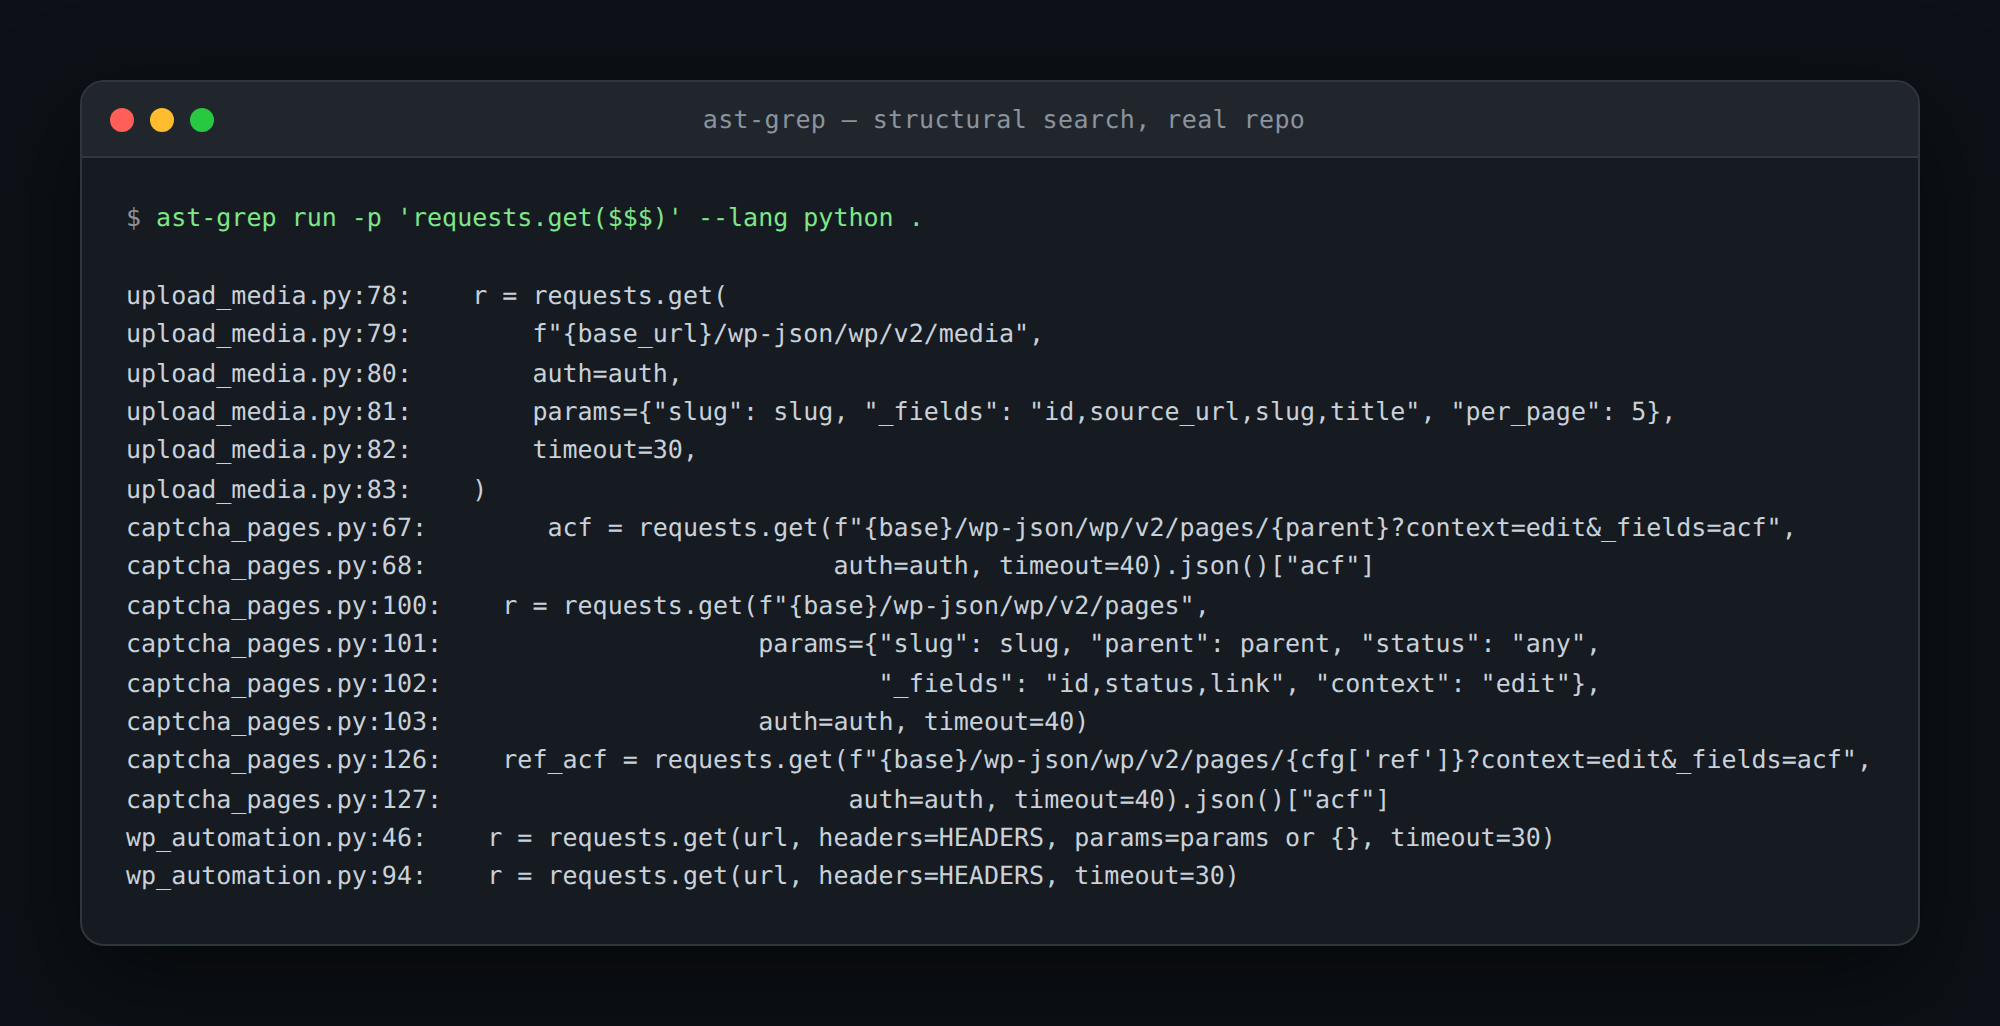
一个值得写进你的 CLAUDE.md 的注意点:短二进制名称 sg 在某些系统上会与标准 Linux 工具冲突。告诉智能体始终显式调用 ast-grep。
4. gh:工作的 GitHub 半边
没有 gh,GitHub 上的一切都会变成你和智能体之间的复制粘贴中继。有了它,Claude Code 拥有整个循环:读取 issue、创建分支、实现、打开 PR、观察 CI,并读取失败日志。大多数子命令上的 --json 标志会返回结构化数据,而 --jq 会在行内过滤它,无需第二个进程。gh api 覆盖 porcelain 命令遗漏的任何内容。
gh issue list --state open --label bug --json number,title,body
gh pr create --fill --base main
gh run watch --exit-status
gh api repos/:owner/:repo/pulls/42/files --jq '.[].filename'
5. jq:让 JSON 远离上下文窗口
此列表中的大多数工具都能输出 JSON,而这只有在智能体能在读取前缩小范围时才有用。jq 就是让 400 KB API 响应变成三个关键字段的方式。这是最便宜的 token 优化,并且会在长会话的每一轮中复合发挥作用。
bdata search "postgres jsonb index" --json | jq -r '.organic[] | "\(.title) \(.link)"'
gh pr list --json number,title,author | jq '.[] | select(.author.login == "renovate")'
6. just:智能体可以发现的任务列表
智能体会浪费轮次去猜测如何构建、测试和 lint 一个项目。一个 justfile 会用一份可读的命名任务列表取代猜测。just, list 会向智能体准确展示存在哪些命令,使用项目特定词汇,并且没有 shell 引号陷阱。与 Make 不同,它不绑定到文件 target,因此它建模的是工作流而不是构建。向代码库添加一个 justfile,是可用的智能体赋能中杠杆最高的二十分钟。
# justfile

# run the test suite
test:
    uv run pytest -q

# scrape a URL to JSON
scrape url:
    bdata scrape {{url}} --format json --pretty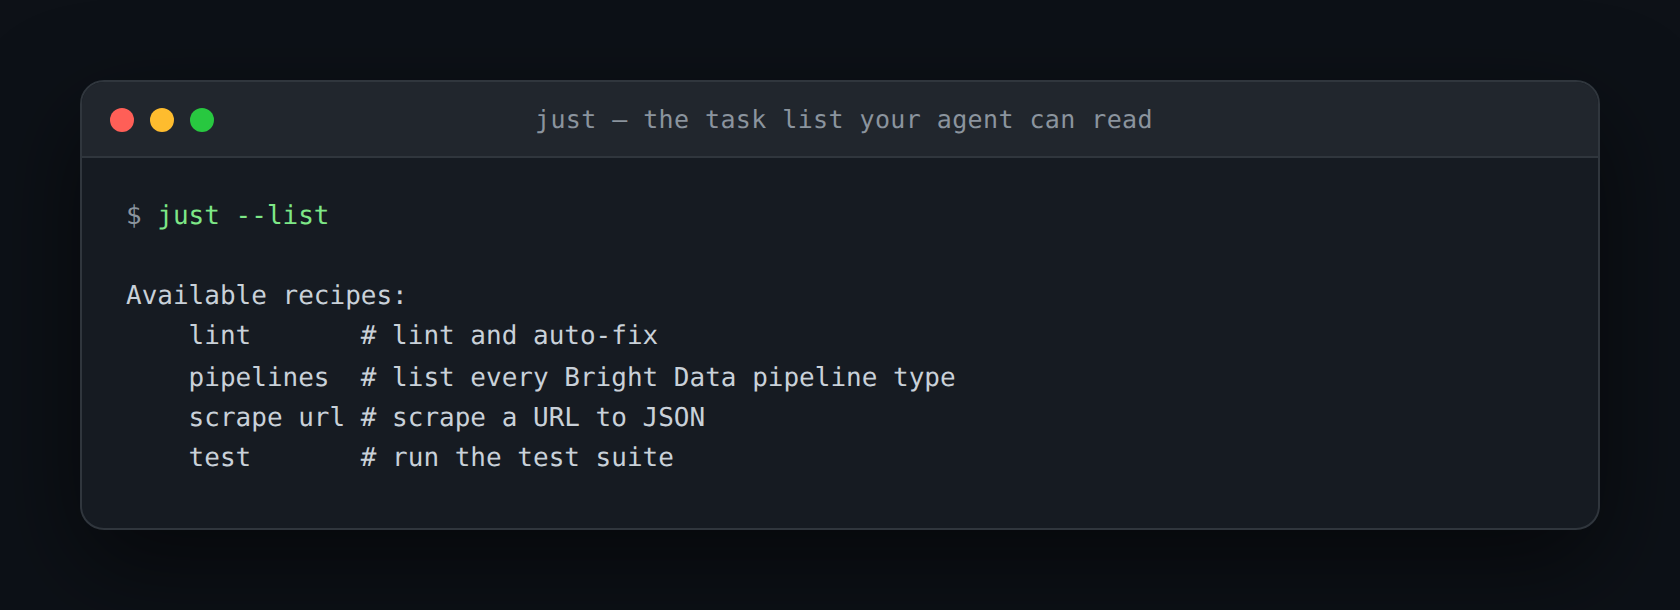
7. uv:无需等待的 Python
依赖安装是智能体循环中的死时间,而 Python 历来是最糟糕的罪魁祸首。uv 用一个 Rust 二进制文件取代 pip、venv、pip-tools 和 pyenv,它能在数秒内解析并安装。uv run 会在带有行内依赖的临时环境中执行脚本,因此智能体可以测试一个想法而不污染任何东西。lockfile 是确定性的,这意味着智能体测试的环境与你发布的环境一致。
uv sync
uv run pytest -q
uv run --with requests python fetch.py
uvx ruff check .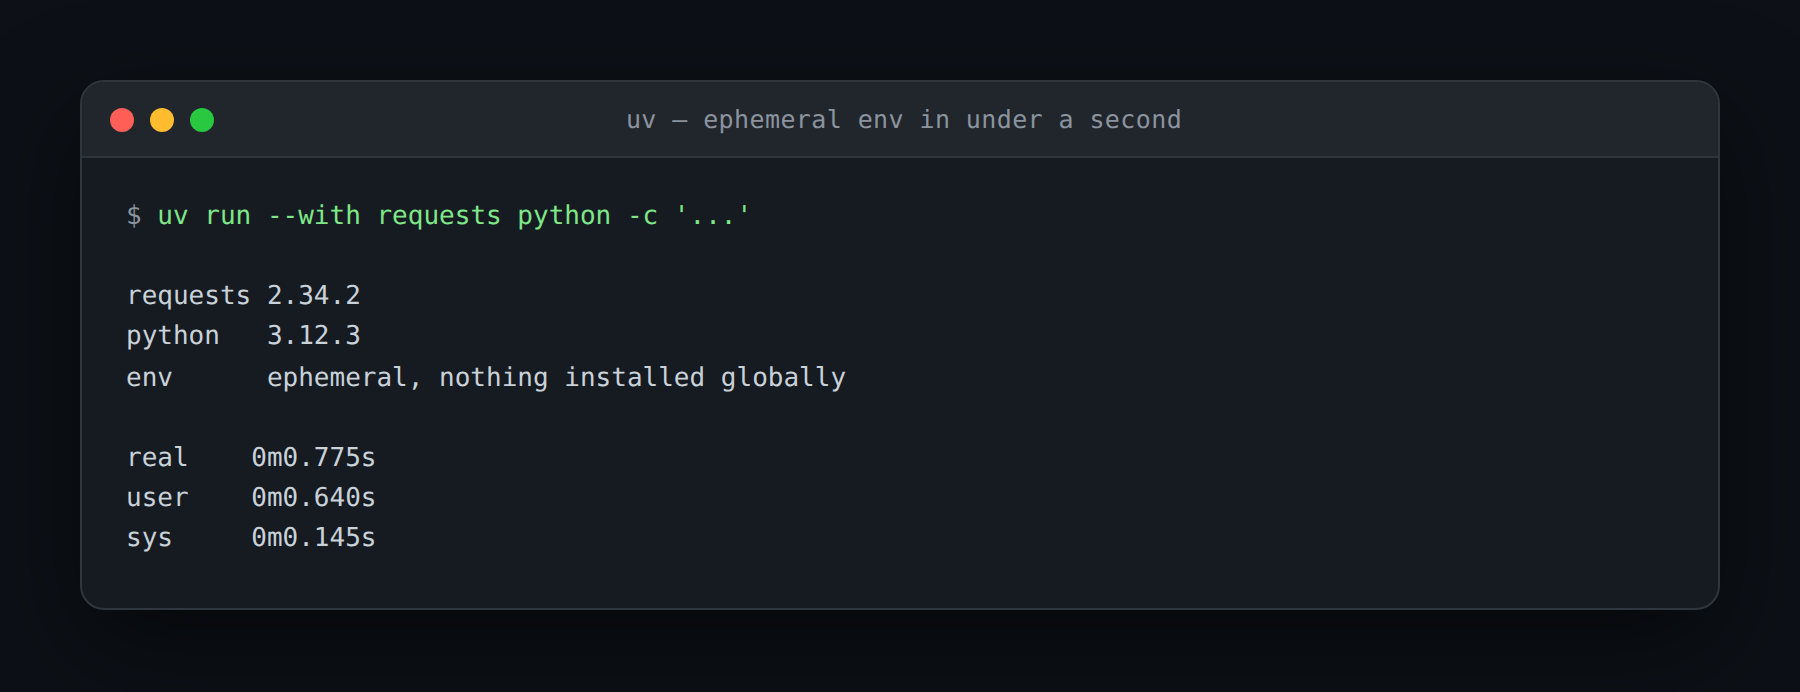
8. bun:JavaScript 侧的一个二进制文件
bun 将通常的 Node 工具链压缩成一个单一可执行文件,用于安装、运行、测试和打包。安装速度比 npm 快得多,内置测试运行器从新项目中移除了整整一层依赖。它无需构建步骤即可直接运行 TypeScript,这意味着智能体写出一个 .ts 文件的瞬间就可以执行它。兼容性很好但并不完美,因此为带有不寻常原生构建步骤的软件包保留 npm 可用。
bun install
bun test
bun run src/index.ts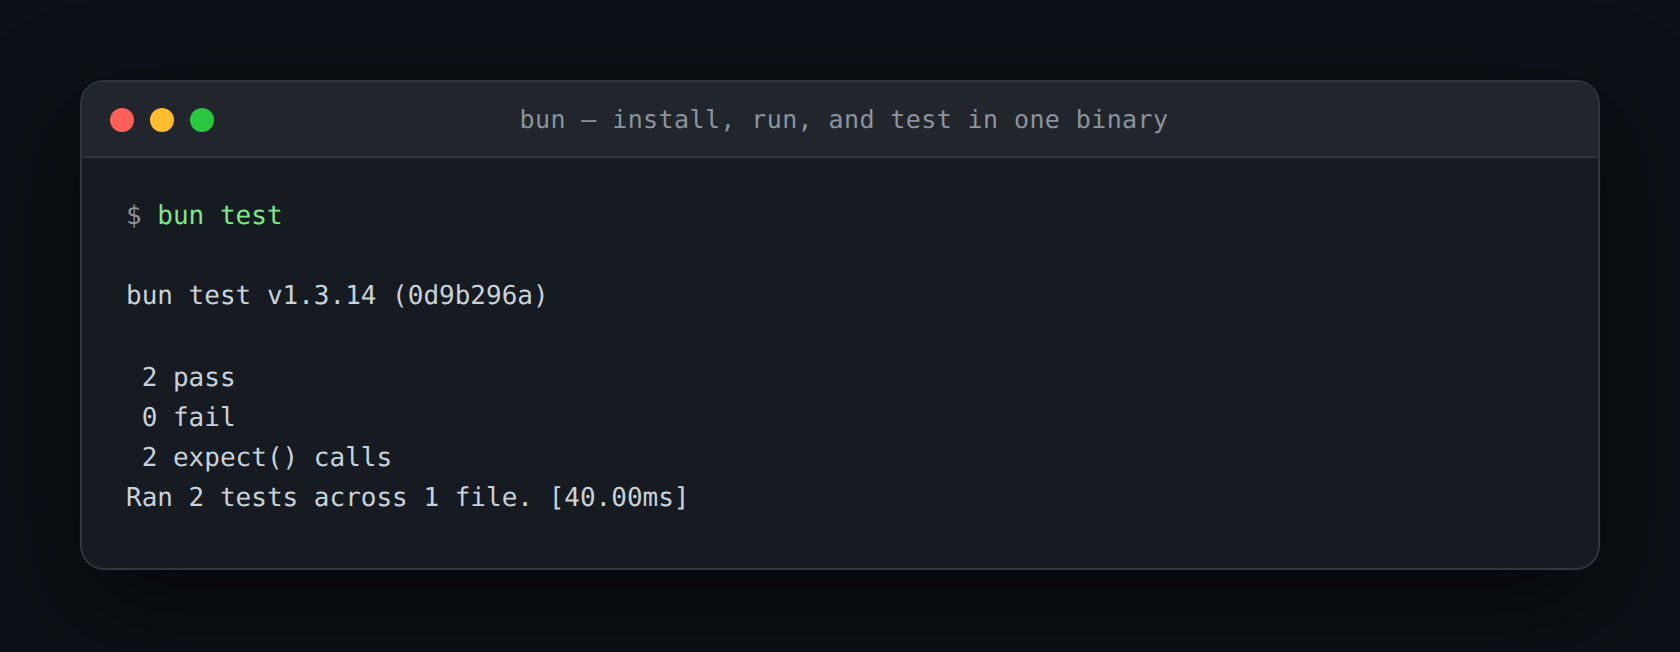
9. gitleaks:提交之前的护栏
快速工作的智能体最终会 stage 一个 .env、把 key 粘贴进 fixture,或在 debug log 中提交 token。gitleaks 会扫描工作树和历史中的凭证模式,并在发现时以非零状态退出,这正是 Claude Code 停下来并自行修复问题所需的信号。把它接入 pre-commit hook,无论提交来自你还是智能体,护栏都会生效。它是这里唯一一个价值完全体现在其所防止事情上的工具。
gitleaks detect --no-banner --redact --report-format json --report-path leaks.json
gitleaks protect --staged --no-banner --redact -v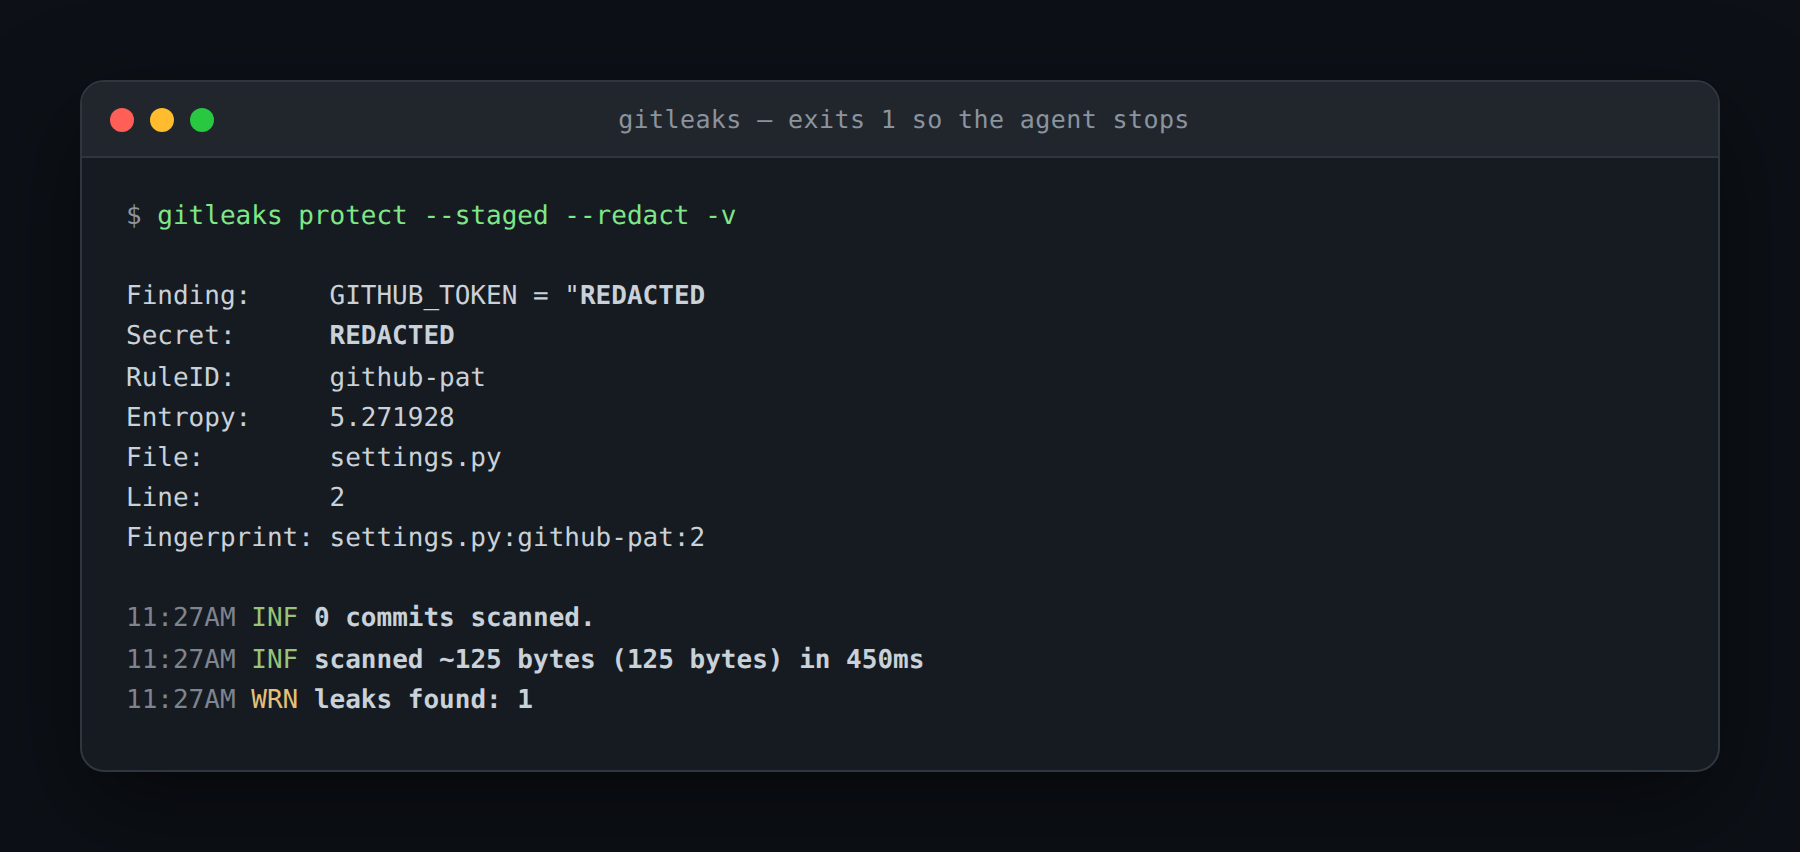
10. Firecrawl CLI:另一个值得了解的网页 CLI
Firecrawl 是本列表第一个工具最接近的竞争者,而且它确实很好。它的 CLI 覆盖 scrape、crawl、map、search,以及用于 AI 驱动提取的 agent 命令。有两个功能很突出,今天 Bright Data 还没有等价物。firecrawl developer 会搜索一个由 GitHub issues、已合并 pull requests、READMEs 和文档站点组成的精选索引,这比通用网页搜索更适合编码智能体最常见的问题。firecrawl monitor 会安排定期爬取并随时间跟踪内容变化。
npm install -g firecrawl-cli
firecrawl init                       # installs skills into Claude Code
firecrawl developer "tokio select cancellation safety" --json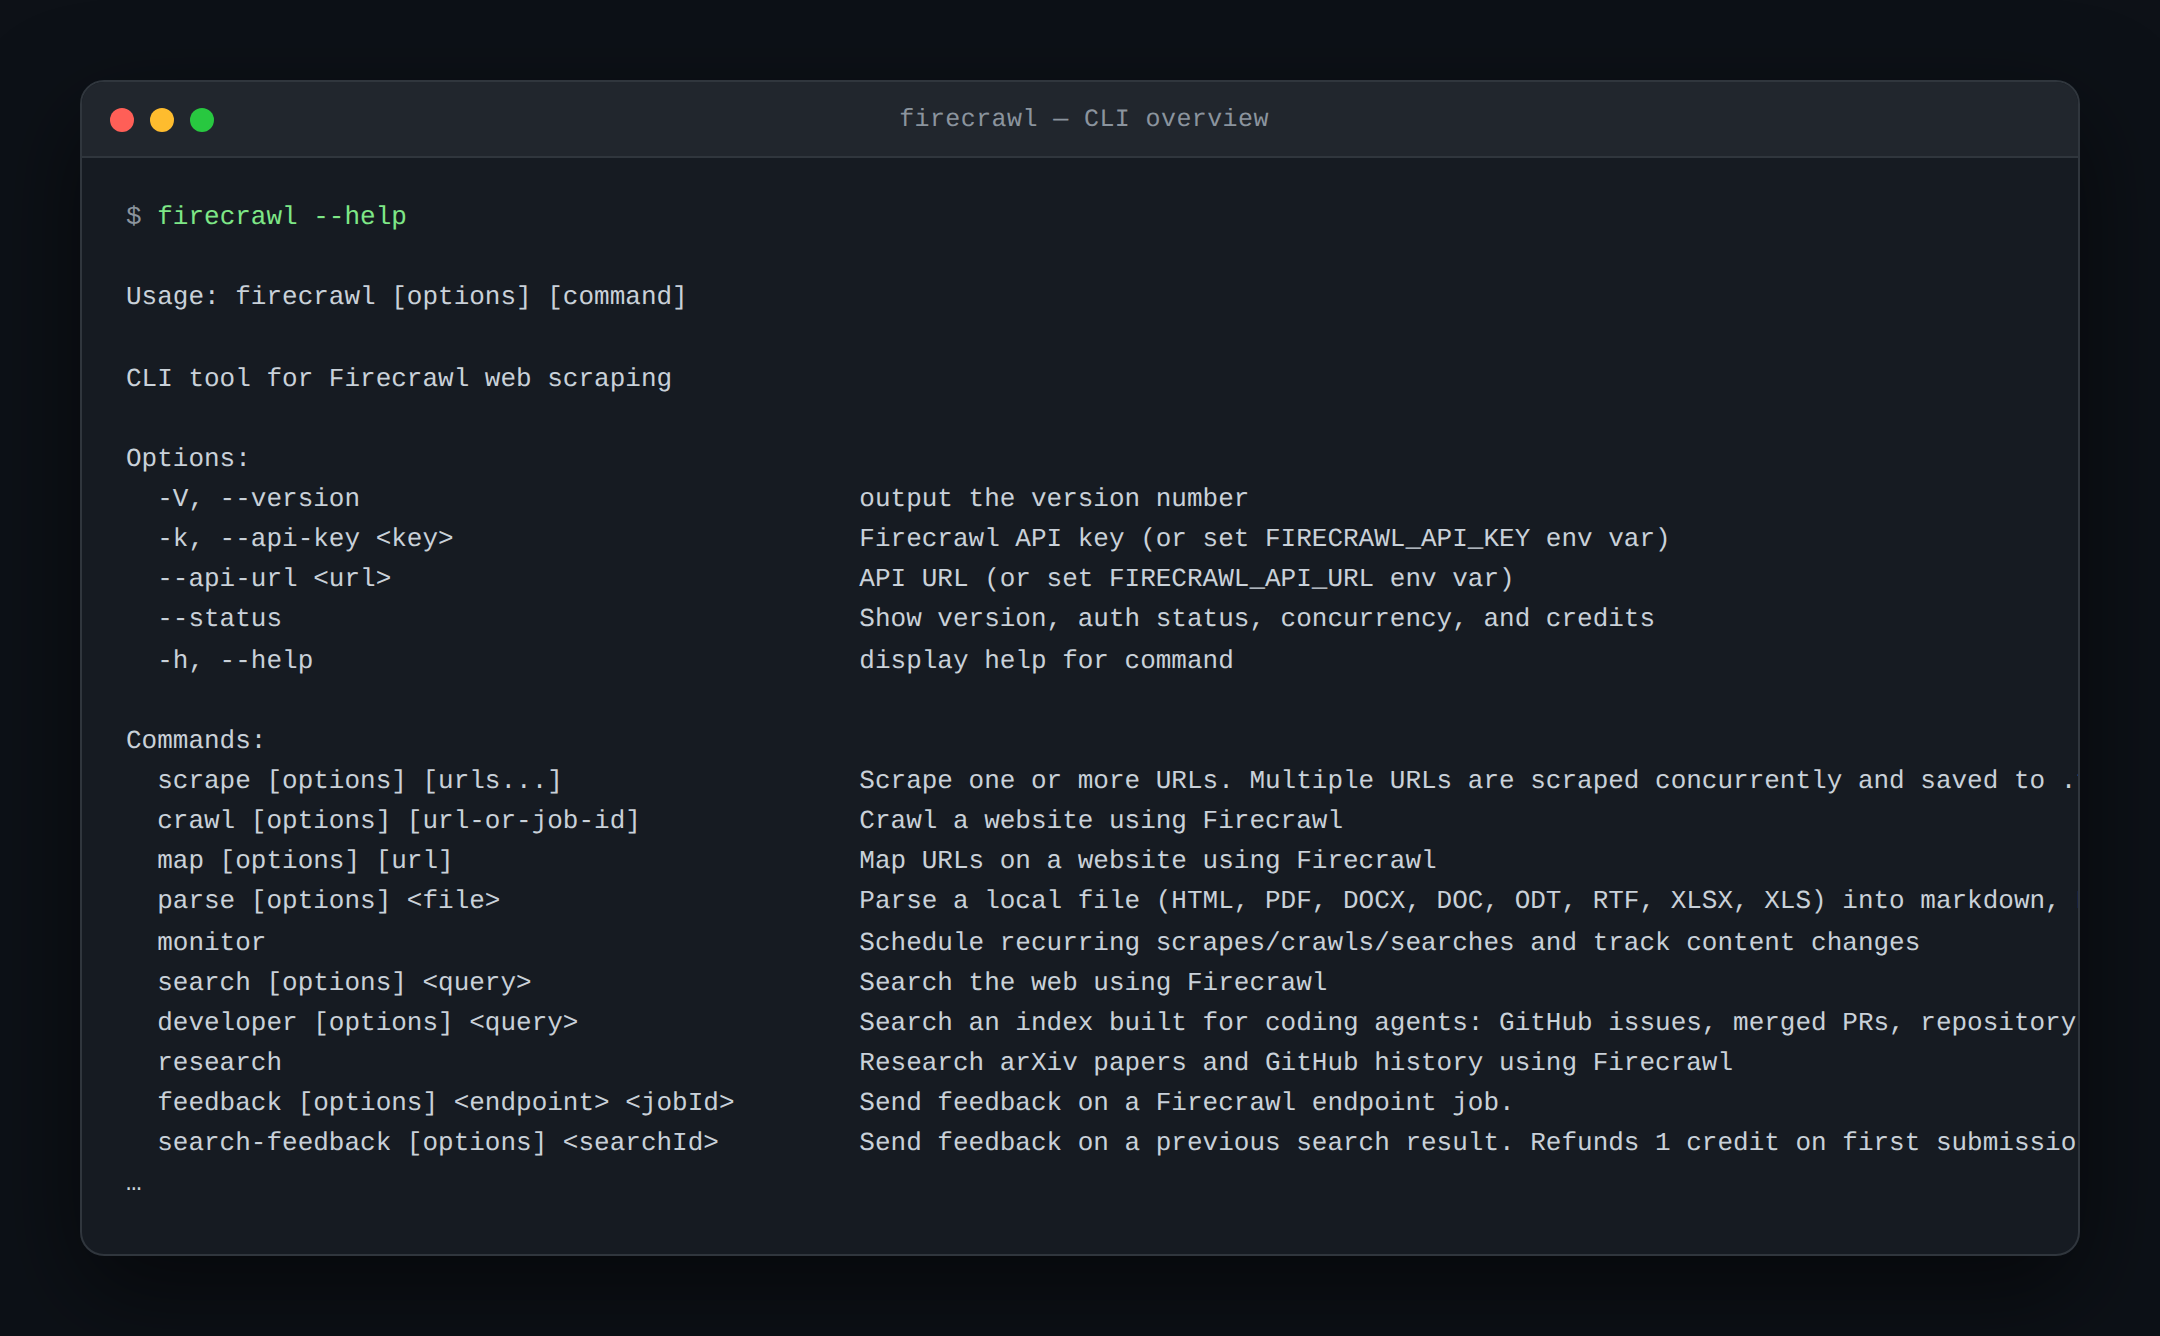
两者的分歧在于采集深度。Firecrawl 针对编码智能体的研究循环调优,而 Bright Data 针对生产数据采集调优。如果你需要来自 Amazon 或 LinkedIn 的预解析记录、通过特定代理区域进行按请求地理定位,或一个能经受网站重新设计的抓取工具,这些能力只存在于 Bright Data 一侧。许多团队两者都运行,用 Firecrawl 做开发者研究,用 Bright Data 处理任何必须在大规模下可靠运行的事情。
不要安装什么:你的智能体无法驱动的工具
有几个工具出现在每个“Claude Code 最佳 CLI 工具”列表中,但不应该出现。lazygit 和 btop 对人类非常出色,对智能体几乎没用,因为它们渲染期望键盘输入的全屏界面。Claude Code 无法导航它们,而等待按键的命令会让该轮停滞。同样适用于任何没有 --yes 标志却提示确认,或自行分页输出的工具。
区别不是“TUI 不好”。而是智能体的接口是 stdin、stdout 和退出码。如果一个工具的价值在于它的渲染,它就是给你用的工具。如果它的价值在于它的输出,它就是给智能体用的工具。为你自己安装交互式工具,并确保 Claude Code 有非交互式等价物,例如 lazygit 旁边的 git log --oneline,或 btop 旁边的 ps 和 free。
告诉 Claude Code 这些工具存在
安装一个工具并不意味着智能体会使用它。Claude Code 默认依赖它能从环境中推断出的东西,因此未被说明的二进制文件经常被闲置,而智能体会手写一个更差的替代方案。有两个机制可以解决这个问题。第一个是在 CLAUDE.md 中放一个简短小节,列出已安装的工具以及何时优先使用每个工具。保持事实性和简短,因为它会加载到每个会话中。
## Available CLI tools
- `bdata`: web access. Use for any URL that WebFetch fails on, and for SERP.
- `ast-grep`: structural search/refactor. Prefer over regex for code edits.
- `just list`: project task list. Use these instead of guessing commands.
第二个是 技能,它们按需加载,而不是在启动时加载。Bright Data 和 Firecrawl 都提供官方 skill packs,用来教智能体完整命令表面,因此 bdata skill add 会给 Claude Code 准确用法,而无需每个会话都为它花费上下文。对于任何拥有不止少量子命令的东西,技能 都是更好的机制,同一套 packs 也适用于 Claude 技能 和 Web MCP 服务器。
常见问题
如果我有这些 CLI,还需要 MCP 服务器吗?
通常不需要。MCP 工具 schema 会加载进上下文窗口并停留在那里,而且当服务器描述超过窗口大约百分之十时,Claude Code 现在会切换到按需工具搜索。通过 Bash 调用的 CLI 在运行之前没有任何成本。对于表面很大的工具,CLI 加 skill 通常比 MCP 服务器 更节省上下文。
为什么付费工具排第一?
因为它是唯一一个添加 Claude Code 完全没有的能力的条目。此列表上的其他一切都是让现有能力更快。可靠访问受保护站点需要代理基础设施,而没有免费工具提供这一点。免费层每月 5,000 credits,无需信用卡,足以正确评估它。
安装这些会让 Claude Code 变慢吗?
不会。这里没有任何东西会在启动时加载。工具只有在智能体运行它们时才被调用,而且其中大多数存在的目的正是减少任务需要的轮数。
最小有用集合是什么?
如果你只想要三个,就是 ripgrep、gh 和 jq。第一次 WebFetch 返回 Cloudflare challenge 时添加 Bright Data CLI,在真实项目中这通常会在第一周内发生。
这些能与 Cursor、Codex 或 Gemini CLI 一起工作吗?
可以。这里的每个工具都是普通命令行二进制文件,没有 Claude 特定依赖。Bright Data 和 Firecrawl skill 安装器会检测并支持多个编码智能体,因此同一套设置可以跨 harness 使用。


高级 SEO 专家
 6 years experience
Daniel Shashko 是 Bright Data 的高级 SEO/GEO 专家,专注于 B2B 营销、国际 SEO,以及开发 AI 驱动的代理、应用与网页工具。