有时你只是需要快速从页面上获取数据。你不想编写爬虫工具或启动服务器。这正是网页抓取浏览器扩展的用途。你点击一个按钮,就能得到一份干净的电子表格。
这些工具已经进入主流。仅 Instant Data 抓取工具 在 Chrome Web Store 上的用户就超过了 1,000,000。需求也在持续攀升。网页抓取市场在 2026 年价值 15.6 亿美元,并有望在 2031 年达到 34.9 亿美元。
在本指南中,你将了解:
- 网页抓取浏览器扩展的作用,以及它适合的场景。
- 如何根据你的数据和技能水平选择一个扩展。
- 7 个最佳网页抓取扩展,已排名并测试。
- 何时从扩展升级到完整的 网页爬虫工具 API。
TL;DR:最佳网页抓取扩展一览
时间紧?这里是带有已验证定价和 Chrome Web Store 评分的排名短名单。
| Extension | Best For | Free Tier | Starting Price | Rating |
|---|---|---|---|---|
| Thunderbit | 总体最佳(AI 爬虫工具) | 6 页/月 | $9/月 | 4.2/5 |
| Instant Data 爬虫工具 | 免费单击式抓取工具 | 无限(免费) | 免费 | 4.9/5 |
| Web 抓取工具 | 用于结构化多页面任务 | 本地无限制 | $50/月(云端) | 4.1/5 |
| Data Miner | 用于预构建配方 | 500 页/月 | $19.99/月 | 3.9/5 |
| Bardeen | 用于自动化工作流 | 100 积分/月 | $10/月 | 4.4/5 |
| Simplescraper | 用于抓取到 API | 100 积分/月 | $39/月 | 4.4/5 |
| Easy 爬虫 | 用于单击式分页 | 是 | $9/月 | 5.0/5 |
定价和评分已于 2026 年 7 月在每个工具自己的页面和 Chrome Web Store 列表中验证。
什么是网页抓取浏览器扩展?
网页抓取浏览器扩展会从你正在查看的页面中提取结构化数据。它在 Chrome 或 Edge 内运行。你在实时页面上点击扩展,它就会检测表格、列表或字段并将其导出。大多数不需要代码,有些还使用 AI 为你选择正确的列。
这些工具在小型、快速任务中表现出色。比如产品列表、目录或单个搜索结果页面。取舍在于规模。扩展在你的浏览器中运行,因此大型或被阻止的任务很难处理。
如何选择网页抓取扩展
根据以下六个因素评估每个扩展。
- 易用性: 是单击自动检测,还是手动选择器构建器?
- AI 功能: 它会为你选择字段,还是你必须映射它们?
- 分页: 它能否跟随下一页和无限滚动?
- 导出: CSV、Excel、Google Sheets,或直接 API。
- 云端和调度: 任务能否在你的浏览器未打开时运行?
- 价格: 将免费层和付费限制与你的使用量相匹配。
现在让我们对最擅长这些功能的扩展进行排名。
2026 年 7 个最佳网页抓取浏览器扩展
1. Thunderbit
Thunderbit 是一款面向所有用户的 AI 网页爬虫工具,而不仅仅是开发者。它可以一键抓取大多数网站。你点击 AI Suggest Fields,它就会读取页面。它会为你选择列并结构化数据。它能处理让无代码工具容易出问题的部分。子页面抓取、分页和无限滚动都能工作。预构建模板覆盖热门网站。你可以抓取 Amazon、Google Maps 等网站,无需设置。导出即时且免费。一键将数据发送到 Excel、Google Sheets、Notion 或 Airtable。它还可以安排定期抓取。Thunderbit 会按照你设置的频率刷新数据。该工具曾是 Product Hunt 上的 #1 Product of the Week。它现在为全球超过 200,000 名用户提供服务。
关键详情:
- 最适合: 想要在许多网站上进行 AI 驱动、无代码抓取的商业用户。
- 关键功能: AI 字段检测、子页面抓取、分页和定时爬虫工具。
- 模板: 20+ 个用于热门网站的预构建抓取工具。
- 导出: Excel、CSV、Google Sheets、Notion 和 Airtable。
- 免费层: 每月 6 页,无需银行卡。
- 定价: Starter 起价 $9/月;Pro 为 $16.5/月,均按年计费。
优点:
- AI 设置几乎无需配置。
- 强大的导出选项,包括 Notion 和 Airtable。
- 处理子页面、分页和调度。
缺点:
- 较低层级有积分限制。
- 大量、定期任务需要付费计划。
⭐ Chrome Web Store 4.2/5(187 条评分,200,000 名用户)
2. Instant Data 爬虫工具
Instant Data 爬虫工具 是抓取表格的最快方式。它可以一键自动检测结构化数据。它使用启发式方法查找表格和列表。你点击图标,它会立即高亮显示数据。不需要账户或设置。该扩展完全免费,没有使用上限。内置分页。它可以点击下一页并滚动以自动加载更多行。导出到 Excel 或 CSV。它适合从任何页面进行快速的一次性提取。
关键详情:
- 最适合: 快速、免费、一次性表格和列表提取。
- 检测: 自动启发式和 AI 辅助字段检测。
- 导出: Excel 和 CSV。
- 免费层: 完全免费,无使用限制。
- 定价: 免费。
优点:
- 真正免费且无上限。
- 零设置和即时自动检测。
- 开箱即用处理分页。
缺点:
- 没有云端运行或调度。
- 在复杂自定义布局上表现吃力。
⭐ Chrome Web Store 4.9/5(7,500 条评分,1,000,000 名用户)
3. Web 抓取工具
Web 爬虫工具 是高级用户的选择。它的站点地图系统定义多层级抓取流程。你构建一个选择器站点地图。然后它会按顺序导航类别、列表和详情页。该扩展可在本地免费运行。付费云端层可在你的浏览器未打开时运行任务。它能很好地处理复杂网站。嵌套导航和分页是核心功能。导出到 CSV、XLSX 或云端。它适合可重复的结构化爬虫项目。
关键详情:
- 最适合: 结构化、多页面抓取项目。
- 模型: 可视化站点地图和选择器构建器。
- 云端: 定时运行,高级层级提供专用 IP。
- 免费层: 在浏览器中无限制本地抓取。
- 定价: 云端计划起价 $50/月。
优点:
- 强大的站点地图模型,适用于复杂网站。
- 本地无限制抓取免费。
- 成熟、稳定且文档完善。
缺点:
- 学习曲线比单击式工具更陡。
- 云端定价基于带宽。
⭐ Chrome Web Store 4.1/5(1,100 条评分,800,000 名用户)
4. Data Miner
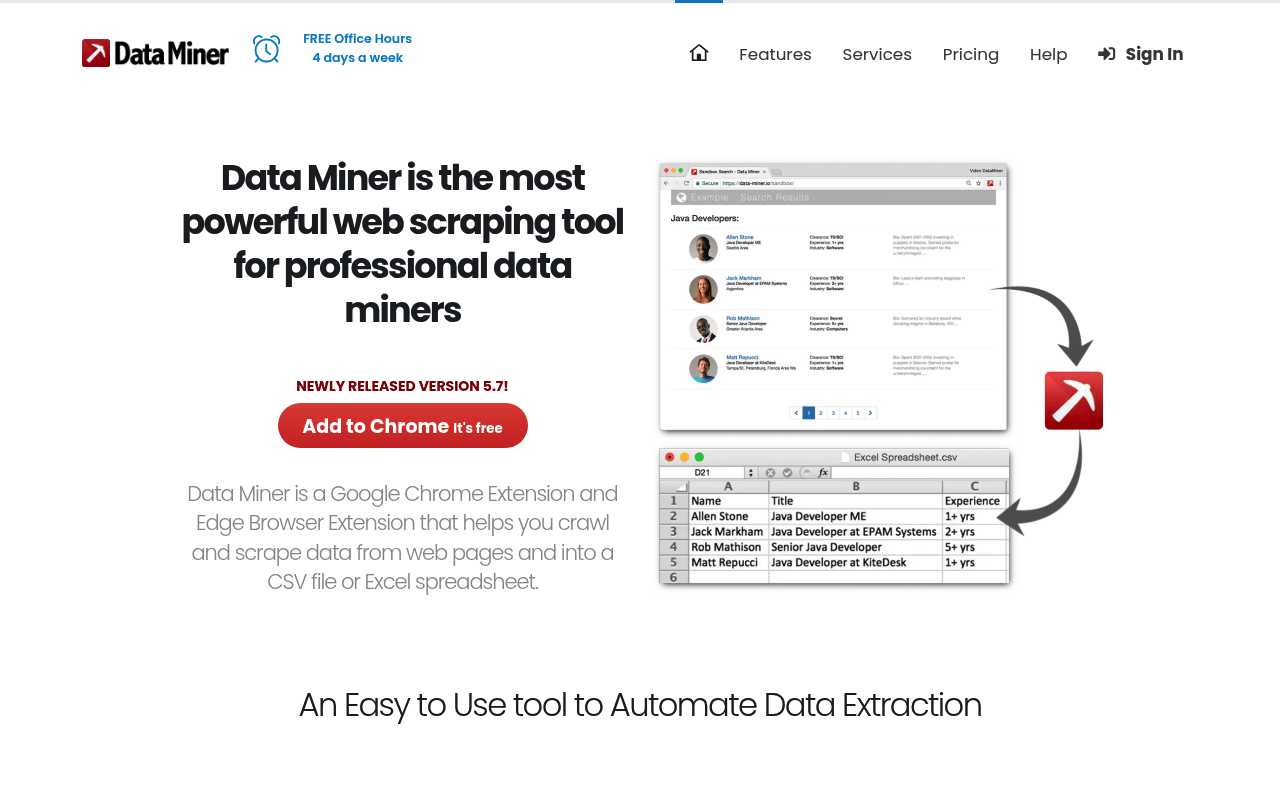
Data Miner 使用配方抓取页面。配方是针对特定网站保存的规则集。它提供超过 60,000 个公共配方。许多热门网站无需配置即可使用。你也可以构建自定义配方。一个点击式编辑器会以可视化方式映射字段。导出到 Excel、CSV 和 Google Sheets。付费计划增加自动化和调度。它面向商业和研究用户。配方库是它最大的吸引力。
关键详情:
- 最适合: 预构建、特定站点的抓取配方。
- 库: 60,000+ 个社区配方。
- 导出: Excel、CSV 和 Google Sheets。
- 免费层: 每月 500 页。
- 定价: Solo 起价 $19.99/月,最高 $200/月可处理 9,000 页。
优点:
- 庞大的现成配方库。
- 灵活的自定义配方编辑器。
- 可靠导出到 Sheets 和 Excel。
缺点:
- 界面感觉过时。
- 免费页面上限相当低。
⭐ Chrome Web Store 3.9/5(704 条评分,300,000 名用户)
5. Bardeen
Bardeen 将爬虫与工作流自动化结合起来。它提取数据,然后对其执行操作。抓取到的行可以流入其他应用。将结果自动推送到 Google Sheets、Notion 或 Slack。它采用积分模型。每个产出结果的步骤都会消耗积分。Playbooks 将步骤串联起来。你可以在一个自动化中抓取、丰富和交付。它偏向销售和 GTM 团队。潜客开发和数据丰富是常见用例。
关键详情:
- 最适合: 与自动化工作流绑定的抓取。
- 集成: Google Sheets、Notion、Slack 和 100+ 个应用。
- 模型: 基于积分的 playbooks。
- 免费层: 每月 100 积分。
- 定价: 付费计划起价 $10/月。
优点:
- 将抓取与自动化结合。
- 广泛的应用集成和 playbooks。
- 轻度使用有可靠的免费层。
缺点:
- 大型任务会很快耗尽积分。
- 重点已转向销售用例。
⭐ Chrome Web Store 4.4/5(452 条评分,200,000 名用户)
6. Simplescraper
Simplescraper 将任何网站变成 API。你指向、点击,然后获得一个数据端点。本地浏览器抓取无限制且免费。云端运行和 API 访问使用积分。它导出到 Sheets、JSON 和 webhooks。开发者可以将数据直接拉入应用。云端抓取无需你的浏览器即可运行。更高层级增加代理轮换。它适合想要随取随用数据的开发者。API 输出是它的突出功能。
关键详情:
- 最适合: 将网站变成数据 API。
- 输出: Google Sheets、JSON、API 和 webhooks。
- 云端: 定时运行,Premium 提供代理轮换。
- 免费层: 每月 100 个云端积分,本地抓取无限制。
- 定价: Plus 起价 $39/月。
优点:
- 清晰的从抓取到 API 的工作流。
- 每个计划都提供无限制本地抓取。
- 对开发者友好的 JSON 和 webhooks。
缺点:
- 大型任务会累积大量云端积分。
- 高级功能需要付费计划。
⭐ Chrome Web Store 4.4/5(364 条评分,60,000 名用户)
7. Easy 爬虫工具
Easy 爬虫工具 是一款无需设置的单击式爬虫工具。它读取当前页面并提取结构化数据。它处理分页和无限滚动。该工具会加载更多行并自动收集它们。免费层覆盖休闲使用。付费计划提高限制并增加云端运行。导出到 CSV 和 Excel。它专注于速度和简单性。它保持着近乎完美的商店评分。用户称赞它对用户要求极少。
关键详情:
- 最适合: 带分页的快速单击式抓取。
- 检测: 自动结构化数据检测。
- 导出: CSV 和 Excel。
- 免费层: 是,用于休闲使用。
- 定价: Starter 起价 $9/月;Pro 为 $29/月。
优点:
- 极其简单,无需设置。
- 强大的分页和滚动处理。
- 出色的 Chrome Web Store 评分。
缺点:
- 高级功能少于较老的工具。
- 生态系统和模板库较小。
⭐ Chrome Web Store 5.0/5(1,200 条评分,100,000 名用户)
何时从扩展升级到爬虫 API
浏览器扩展非常适合小型、手动任务,但一旦你需要规模化,它们就会吃力。扩展在你的浏览器中运行。这意味着会有封锁、CAPTCHA,并且没有内置代理。大型任务需要真正的基础设施,包括代理轮换、反机器人处理和云端运行。
这正是 Bright Data 接手的地方,因为它的工具从扩展止步的地方开始。网页爬虫工具 API 可大规模返回结构化 JSON,并为你处理代理、CAPTCHA 和解析。抓取浏览器 运行带内置解锁功能的无头会话,并可接入 Playwright、Puppeteer 和 Selenium。更喜欢现成数据?数据集市场 直接销售预收集记录。想深入了解,请阅读我们的指南:最佳即时数据抓取工具 和 AI 网页抓取。
试用我们的网页抓取扩展,并免费获得 5K 条记录/月
网页抓取扩展:汇总表
| Extension | Best for | Free tier | Starting price | Chrome Web Store rating |
|---|---|---|---|---|
| Thunderbit | 总体最佳(AI 爬虫工具) | 6 页/月 | $9/月 | 4.2/5(187 条评分,200,000 名用户) |
| Instant Data 爬虫工具 | 免费单击式抓取工具 | 无限(免费) | 免费 | 4.9/5(7,500 条评分,1,000,000 名用户) |
| Web 抓取工具 | 用于结构化多页面任务 | 本地无限制 | $50/月(云端) | 4.1/5(1,100 条评分,800,000 名用户) |
| Data Miner | 用于预构建配方 | 500 页/月 | $19.99/月 | 3.9/5(704 条评分,300,000 名用户) |
| Bardeen | 用于自动化工作流 | 100 积分/月 | $10/月 | 4.4/5(452 条评分,200,000 名用户) |
| Simplescraper | 用于抓取到 API | 100 积分/月 | $39/月 | 4.4/5(364 条评分,60,000 名用户) |
| Easy 爬虫 | 用于单击式分页 | 是 | $9/月 | 5.0/5(1,200 条评分,100,000 名用户) |
结论
最佳网页抓取扩展取决于任务,因此请将工具与你的数据和技能水平相匹配。对于 AI 驱动、无代码抓取,从 Thunderbit 开始。对于快速免费抓取,Instant Data 抓取工具 很难被击败。当任务超出浏览器能力时,转向爬虫 API。那就是引入 Bright Data 的时机。
常见问题
什么是网页抓取浏览器扩展?
它是一个 Chrome 或 Edge 附加组件,可从你正在查看的页面中提取结构化数据。你在实时页面上点击它,并将结果导出到电子表格。
最好的网页抓取扩展是什么?
Thunderbit 是在许多网站上进行 AI 驱动、无代码抓取的总体最佳选择。对于免费的一次性抓取,Instant Data 爬虫工具 是最强选择。
网页抓取扩展免费吗?
许多是免费的。Instant Data 抓取工具 完全免费,其他大多数提供免费层。付费计划增加云端运行、调度和更高限制。
抓取扩展有哪些限制?
它们在你的浏览器中运行,因此缺少代理和反机器人处理。大型或被阻止的任务很慢,而且浏览器通常必须保持打开。
什么时候应该使用爬虫 API 而不是扩展?
一旦你需要规模、可靠性或访问被阻止的网站,就使用 API。爬虫 API 增加了扩展无法匹配的代理、反机器人处理和云端运行。

增长营销经理
Dvir Sharon 负责 Bright Data 的增长营销工作。他对创建能够为希望利用网络数据的企业提供价值的病毒式内容感兴趣。