Exa 是一个语义搜索引擎。Bright Data 是网络数据基础设施。两者是本质上不同的产品,选择哪一个完全取决于你的 AI 智能体实际需要完成什么任务。
这份对比涵盖生产级 AI 团队关注的各个关键维度:成本、速率限制、覆盖范围、访问能力和历史数据。没有含糊的评价,只有数字和事实。
TL;DR – Bright Data 与 Exa 一览
- Exa 是语义搜索引擎;Bright Data 是网络数据基础设施。
- Bright Data 搜索引擎 API 的费用为每 1,000 次请求 1.50 美元;Exa 收费 7 美元。
- Exa 的默认
/search速率限制为 10 QPS。Bright Data 不限制并发请求数。 - Bright Data 网络解锁器可以抓取受反爬虫保护的页面。Exa 无法做到。
- Bright Data 拥有超过 50PB 的历史网络数据。Exa 仅提供实时数据。
- Exa 的 Find Similar 功能独一无二,Bright Data 没有直接对应的功能。
- 使用 Exa 进行语义发现。使用 Bright Data 大规模提取真实数据。
Bright Data 与 Exa:正面对比
| 维度 | Bright Data | Exa |
|---|---|---|
| 产品类别 | 网络数据基础设施(代理网络 + 抓取 + 数据集) | 语义搜索引擎 API |
| 搜索方式 | 通过搜索引擎 API 抓取真实搜索引擎(Google、Bing、Yandex 等) | 基于自定义嵌入的神经网络索引(自有索引) |
| 完整页面内容 | 是,通过网络解锁器实时提取,并以 Markdown 返回 | 是,通过 /contents 端点提供(每 1,000 个页面额外收费 1 美元) |
| 反爬虫和 CAPTCHA 绕过 | 是,内置于网络解锁器中;提供 超40000万 个代理 IP | 否,无法抓取登录墙或反爬虫保护后的内容 |
| 历史数据 | 是,拥有超过 50PB 的 Web Archive;以及预构建数据集 | 否,仅提供实时索引 |
| 速率限制 | 不限制并发请求数(搜索引擎 API) | /search 默认限制为 10 QPS;企业版可自定义 |
| 定价(按量付费) | 每 1,000 次请求 1.50 美元起(搜索引擎 API) | 每 1,000 次请求 7 美元(标准搜索,返回 1–10 条结果) |
| 支持的搜索引擎 | Google、Bing、DuckDuckGo、Yandex、Baidu、Naver、Yahoo | Exa 自有的专有神经网络索引 |
| 合规性 | GDPR、CCPA、SOC 2、SOC 3、ISO 27701 | SOC 2 Type II、ZDR 选项 |
| MCP 集成 | 是,Bright Data MCP 服务器(免费,每月 5,000 次免费请求) | 是,Exa MCP 服务器 |
| 框架集成 | LangChain、LlamaIndex、CrewAI、Agno、Dify、n8n、Zapier 等 70 多种 | LangChain、LlamaIndex、CrewAI、Vercel AI SDK 等 20 多种 |
| 免费套餐 | 是,提供免费试用 | 是,每月 1,000 次请求 |
| 企业级 SLA | 是,99.9% SLA,配备专属客户经理 | 是,自定义 SLA,提供一对一引导 |
什么是 Exa?
Exa 是一个专为 AI 应用构建的搜索引擎。Exa 没有采用传统的关键词索引,而是构建了自己的神经网络索引,即一个基于网络数据训练的大规模嵌入模型。当你查询 Exa 时,它会在该索引中执行语义向量搜索,并根据概念相关性而非关键词重合度对结果进行排名。
这种架构选择是 Exa 的主要差异化优势。它可以回答“查找与这个 arXiv URL 相似的论文”或“有哪些公司在半导体领域做着类似 Nvidia 的事情”之类的问题,而基于关键词的 SERP 抓取工具无法做到这一点。截至 2026 年 3 月,Exa 的索引包含超过 10 亿个人资料和 7,000 万条公司记录,并提供针对新闻、代码和财务报告的专用搜索模式。如果你正在评估 Exa 的替代方案适用于 AI 网络搜索的最佳 Exa 替代方案对包括 Bright Data、Tavily 和 Firecrawl 在内的竞品工具进行了详细比较。
Exa 的优势
语义“Find Similar”搜索。没有其他搜索 API 能够提供“帮我查找与这个 URL 在概念上相似的页面”功能。这是一项真正的能力差距,而 Bright Data 并未填补这一空白。
低延迟检索。Exa Instant 的响应时间低于 200 毫秒。标准搜索耗时为 100–1,200 毫秒。对于交互式聊天界面和实时智能体而言,这种速度是一项真正的优势。
开发者体验。提供 Python 和 TypeScript SDK、原生 LangChain、LlamaIndex 和 CrewAI 集成、MCP 服务器支持,以及每月 1,000 次免费请求的慷慨额度。从零开始完成可用的智能体集成只需几分钟。
专用领域索引。Exa 的人员索引(超过 10 亿份个人资料,每周更新超过 5,000 万份)和公司索引(超过 7,000 万家公司)专为招聘智能体、销售情报管道和公司数据丰富工作流而构建。
出色的基准测试准确率。在 WebWalker 多跳检索测试中,Exa 在一家《财富》100 强企业的评估中取得 81% 的成绩,而 Tavily 为 71%(2025 年 1 月)。在 AIMultiple 针对 8 个 API、包含 100 个查询的基准测试中,Exa 以 14.39 的智能体得分位列第 3。
Exa 在规模化应用中的核心限制
Exa 的速率限制制约生产工作负载。默认 /search 限制为 10 QPS(每分钟 600 次请求)。这一点已由 Exa 的官方速率限制文档直接确认。对于同时运行数千个并行研究任务的多智能体管道,这一上限迫使团队从第一天起就构建重试逻辑和请求队列。企业客户可以协商更高的限制,但需要另行与销售团队沟通。
Exa 无法突破反爬虫保护。Exa 按照自己的时间安排抓取开放网络。它无法获取 Cloudflare、登录墙、CAPTCHA 系统或大量使用 JavaScript 的机器人检测机制背后的页面。对于竞争情报、价格监控或任何最有价值的页面同时也是受保护程度最高页面的用例而言,这是一个硬性限制。
没有历史数据层。Exa 仅提供实时数据。它没有存档产品、历史数据集,也无法将今天的结果与上季度进行比较。对于异常检测、趋势分析或基于基线的智能体输出而言,这是一个结构性缺口。
Exa 的索引不是 Google。Exa 返回的是其自有专有神经网络索引中的结果,而不是来自 Google、Bing 或 Yandex 的结果。对于任何需要准确了解真实用户此刻在 Google 上看到什么的用例(SEO 监控、广告情报、排名跟踪、品牌保护),Exa 的索引都不是正确的数据源。
高流量下的定价扩展性较差。每月 100 万次请求时,Exa 标准搜索的成本超过 7,000 美元。如果加入完整页面内容,费用将升至 8,000 美元以上。Exa 于 2026 年 3 月更新定价,将标准搜索从每 1,000 次 5 美元提高到 7 美元,并推出每 1,000 次 12 美元的智能体套餐。
什么是 Bright Data?
Bright Data 是网络数据基础设施。它没有自己的搜索索引,而是通过一套针对不同数据获取模式设计的产品,大规模访问真实的实时网络。
搜索引擎 API可以从 195 个国家/地区实时抓取真实的 Google、Bing、Yandex、Baidu、DuckDuckGo、Yahoo 和 Naver 搜索结果,并支持城市级地理定位。它返回的是当地真实用户此刻会看到的内容,而不是任何索引认为用户应该看到的内容。
网络解锁器可以获取任何网页,包括 Cloudflare、CAPTCHA、登录墙或 JavaScript 渲染背后的页面,并返回干净的 Markdown 内容。它通过覆盖 195 个国家/地区的 超40000万 个住宅 IP 网络路由请求,并自动处理检测绕过。
数据集层提供覆盖 100 多个领域的预构建结构化数据。Web Archive API提供超过 50PB、可追溯多年的历史网络数据,是历史数据支撑的理想解决方案。
Bright Data 如何处理 AI 所需的网络数据
Bright Data 的架构围绕一个核心前提构建:真实依据是实际的实时网络,而不是任何索引对它的近似呈现。对于构建生产系统的企业 AI 团队而言,这在以下场景中至关重要:
- 你的智能体需要获取竞争对手的定价页面,而该页面会屏蔽爬虫
- 你的智能体需要知道 Google 针对某个关键词实际显示什么,而不是神经网络索引估算的结果
- 你的智能体需要并行运行 10,000 个查询,而不会触及速率限制上限
- 你的智能体需要了解今天的结果与六个月前相比是否异常
Bright Data 获得包括《财富》500 强企业在内的 超50000 家客户信赖,并被 Gartner 的网络数据采集解决方案竞争格局报告引用。它已获得 GDPR、CCPA、SOC 2、SOC 3 和 ISO 27701 认证。
核心产品:搜索引擎 API、网络解锁器、数据集
| 产品 | 功能 | 定价 |
|---|---|---|
| 搜索引擎 API | 实时抓取 7 个搜索引擎,覆盖 195 个国家/地区,输出结构化 JSON/Markdown | 每 1,000 条结果 1.50 美元起(按量付费);每月 200 万条时低至每 1,000 条 1.00 美元 |
| 网络解锁器 | 获取任何受反爬虫保护的页面,并返回干净的 Markdown | 每 1,000 次请求 1 美元起 |
| 数据集 | 来自 100 多个领域的预构建结构化数据 | 每 10 万条记录 250 美元起 |
| 网页存档 API | 超过 50PB 的历史网络数据 | 每 1,000 个 HTML 页面 0.20 美元起 |
| MCP 服务器 | 将 AI 智能体直接连接到 Bright Data 的完整产品套件 | 免费,每月 5,000 次请求 |
定价比较:Bright Data 与 Exa
Exa 定价(2026 年 3 月)
| 产品 | 价格 |
|---|---|
| 标准搜索(1–10 条结果) | 每 1,000 次请求 7 美元 |
| 超过 10 条的额外结果 | 每 1,000 条结果另加 1 美元 |
| 智能体搜索/深度搜索 | 每 1,000 次请求 12 美元 |
| 带推理功能的深度搜索 | 每 1,000 次请求 15 美元 |
| Contents(完整页面文本) | 每 1,000 个页面 1 美元 |
| 问答 API | 每 1,000 个答案 5 美元 |
| 免费套餐 | 每月 1,000 次请求 |
| 企业版 | 自定义 |
重要细节:Exa 的费用是叠加计算的。如果你的智能体需要 10 条结果和完整页面内容,则每 1,000 次请求需要同时支付搜索费用(7 美元)和内容费用(1 美元)。对于需要内嵌完整文本的智能体,最低实际成本为每 1,000 次 8 美元。
Bright Data 定价
| 产品 | 价格 |
|---|---|
| 搜索引擎 API(按量付费) | 每 1,000 条结果 1.50 美元 |
| 搜索引擎 API(每月 38 万条结果) | 每 1,000 条结果 1.30 美元 |
| 搜索引擎 API(每月 90 万条结果) | 每 1,000 条结果 1.10 美元 |
| 搜索引擎 API(每月 200 万条结果) | 每 1,000 条结果 1.00 美元 |
| 网络解锁器 | 每 1,000 次请求 1 美元起 |
| 数据集 | 每 10 万条记录 250 美元起 |
| 网页存档 | 每 1,000 个 HTML 页面 0.20 美元起 |
| MCP 服务器 | 免费(每月 5,000 次请求) |
规模化成本:数字差距十分显著
| 请求量 | Exa(仅标准搜索) | Exa(搜索 + 内容) | Bright Data 搜索引擎 API |
|---|---|---|---|
| 10,000 次请求 | 70 美元 | 80 美元 | 15 美元 |
| 100,000 次请求 | 700 美元 | 800 美元 | 130–150 美元 |
| 1,000,000 次请求 | 7,000 美元以上 | 8,000 美元以上 | 1,000–1,500 美元 |
每月 100 万次请求时,仅搜索服务一项,Bright Data 就比 Exa 便宜 5–7 倍。如需查看规模化场景下 SERP 和网络搜索 API 提供商的完整比较,请参阅2026 年最佳搜索引擎 API 和网络搜索 API。对于需要完整页面内容的智能体,差距会进一步扩大:Exa 每 1,000 次还要额外收取 1 美元;Bright Data 网络解锁器的全包价格则从每 1,000 次 1 美元起。
Bright Data 不限制并发请求数
这不是一个细微差别。Exa 的默认 /search 速率限制为 10 QPS即每秒 10 个查询、每分钟 600 个查询。这一点已在 Exa 的官方速率限制文档中得到确认。
Bright Data 的搜索引擎 API 不限制并发请求数。其 FAQ 明确写道:“并发请求数没有限制。搜索引擎 API 专为规模化应用而构建。”
对于单智能体、每次执行一个查询的工作负载,这并不重要。但对于同时运行数十或数百个并行研究任务的生产级 AI 管道、竞争情报系统、多智能体研究框架和实时监控技术栈,这一区别具有根本性。使用 Exa 时,你从第一天起就需要围绕这个上限进行工程设计。
Bright Data 可以访问 Exa 无法触及的页面
Exa 抓取开放网络。它无法访问:
- 受 Cloudflare 保护的页面
- 设有登录墙或身份验证要求的网站
- 强制执行 CAPTCHA 的页面
- 不会向原始 HTTP 请求提供内容、重度依赖 JavaScript 的网站
- 需要本地 IP 地址才能访问的地理限制内容
这并非批评,只是这些功能不在 Exa 的产品范围内。
Bright Data 的网络解锁器正是为解决这一问题而构建。它通过 超40000万 个住宅 IP 路由请求、处理浏览器指纹识别、管理验证码破解,并以干净的 Markdown 返回完整的页面渲染内容。对于需要全面了解反爬虫绕过技术的团队在网页抓取中绕过 Cloudflare指南深入介绍了相关技术。对于竞争性价格情报而言,最有价值的数据往往位于保护最严密的页面上,因此这是一项关键能力。
以下是一个极简示例,展示生产环境中的智能体如何使用 Bright Data 搜索引擎 API 和 Exa 执行同一项任务:
# Bright Data SERP API - real Google results, no rate limit ceiling
import requests

response = requests.get(
    "https://api.brightdata.com/serp/req",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    params={
        "q": "competitor pricing enterprise 2026",
        "gl": "us",
        "num": 10,
        "data_format": "markdown"  # LLM-ready output
    }
)
results = response.json()

# Exa - semantic search, 10 QPS limit
from exa_py import Exa

exa = Exa(api_key="YOUR_EXA_KEY")
results = exa.search_and_contents(
    "competitor pricing enterprise 2026",
    num_results=10,
    text=True
)
# $7/1k (search) + $1/1k (contents) = $8/1k effective cost
对于基本查询,两者的功能输出相似。当你需要针对 1,000 个竞争对手并行执行查询,或目标页面屏蔽 Exa 的爬虫工具时,差异就会显现。请看这个示例:
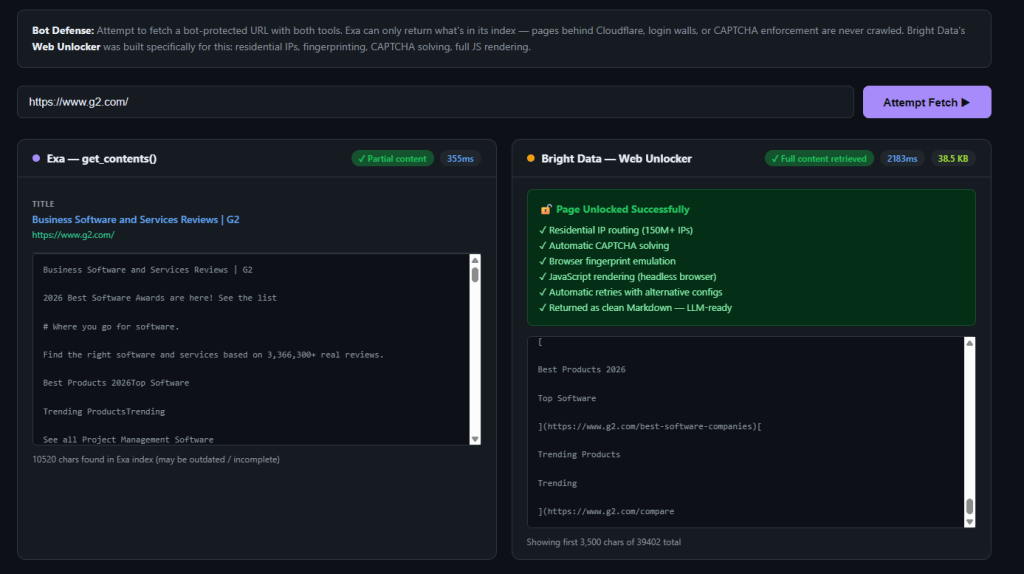
如果你想亲自尝试,请查看这个 GitHub 演示。
Exa 没有历史数据层
用于检测价格变化、政策转向或市场动向的 AI 智能体需要有可供参考的基线。如果不知道正常情况是什么,就无法将某种现象标记为异常。
Exa 仅提供实时数据。它没有存档产品、历史数据集或时间序列功能。
Bright Data 的 Web Archive API 拥有超过 50PB 的历史网络数据,并且每天持续增长。预构建的结构化数据集覆盖 100 多个领域,可为电商、社交媒体、房地产等行业提供历史基线。对于纵向情报工作,例如监控竞争对手的定价页面在 12 个月内发生了哪些变化、长期跟踪监管申报,或检测公众情绪的变化,Bright Data 拥有相应的基础设施,而 Exa 没有。
用例选择指南
| 用例 | 最佳选择 | 原因 |
|---|---|---|
| RAG 原型开发/黑客松 | Exa | 速度快、有免费套餐、原生支持 LangChain、设置简单 |
| 语义相似性搜索(“查找与这个 URL 相似的页面”) | Exa | Find Similar 端点在 Bright Data 中没有对应功能 |
| 人员/公司数据丰富(招聘智能体、销售情报) | Exa | 超过 10 亿份索引个人资料、结构化公司索引 |
| 竞争性价格情报(实时页面内容) | Bright Data | 网络解锁器可绕过反爬虫机制;Exa 无法访问受保护页面 |
| 拥有 1,000 个以上并发查询的生产级智能体 | Bright Data | 没有速率限制上限;搜索引擎 API 专为并行工作负载而构建 |
| 真实 Google SERP 数据(SEO、广告监控、排名跟踪) | Bright Data | 搜索引擎 API 抓取真实 Google 结果,Exa 使用自有索引 |
| 历史基线/异常检测 | Bright Data | Web Archive 拥有超过 50PB 数据,并提供数据集和时间序列功能 |
| Cloudflare/登录墙背后的页面 | Bright Data | 网络解锁器;Exa 无法访问受保护内容 |
| 多搜索引擎搜索(Google + Bing + Yandex) | Bright Data | 搜索引擎 API 覆盖 195 个国家/地区的 7 个主流搜索引擎 |
| 低延迟交互式聊天体验 | Exa | Exa Instant 的响应时间低于 200 毫秒 |
| 高流量下对成本敏感(每月 10 万次以上查询) | Bright Data | 每 1,000 次 1–1.50 美元,而 Exa 为 7–15 美元 |
何时选择 Exa
以下情况适合选择 Exa:
- 你正在构建原型或开展早期研究。每月 1,000 次免费请求、原生 LangChain/LlamaIndex 支持以及简单的 SDK 接入,使 Exa 成为向 AI 智能体添加网络搜索功能时阻力最小的方式。
- 你的核心用例是语义相似性。“帮我查找与这个 URL 相似的页面”是 Exa 独有的功能。如果这是你的主要搜索模式,请选择 Exa。
- 你需要结构化的人员或公司数据。Exa 超过 10 亿份个人资料的索引和超过 7,000 万家公司的索引,确实是专为销售和招聘情报智能体构建的。
- 延迟是首要限制因素。对于实时交互式应用,Exa Instant 低于 200 毫秒的响应时间优于任何实时抓取解决方案。
- 你的查询量低于每月 50,000–100,000 次并且不需要真实 Google 数据,也无需访问受保护的页面。
何时选择 Bright Data
以下情况适合选择 Bright Data:
- 你正在生产规模下运行。无限并发请求和 99.9% 正常运行时间 SLA 意味着无需为速率限制设计工程变通方案。
- 你需要真实的 Google 搜索结果。搜索引擎 API 可以从任何国家/地区实时抓取真实的 Google(以及 Bing、Yandex、Baidu、Yahoo、Naver、DuckDuckGo)结果,展示真实用户看到的内容,而不是神经网络索引估算的结果。
- 你的智能体需要访问受保护的页面。网络解锁器可以处理 Cloudflare、CAPTCHA 墙、登录页面和 JavaScript 渲染。Exa 无法做到。
- 你需要历史数据。Web Archive API 提供超过 50PB 的历史数据,可用于基线支撑和纵向分析。
- 规模化成本是重要因素。每月请求量达到 100,000 次以上时,Bright Data 比 Exa 便宜 5–7 倍。
- 你正在构建企业级系统。超50000 家客户、《财富》500 强企业采用、Gartner 认可,以及与 70 多种 AI 框架集成意味着 Bright Data 可以融入现有的企业数据技术栈。
结论:针对两类不同任务的两种不同工具
Exa 和 Bright Data 并不是在竞争同一种任务。
Exa 非常擅长它所针对的场景:语义神经网络搜索、快速的开发者接入,以及专门面向人员和公司的索引。如果你需要查找概念上相似的页面、探索某个语义邻域,或搜索 10 亿份 LinkedIn 个人资料,Exa 的架构非常适合这些任务。
Bright Data 面向的是另一类问题:以生产规模访问实时网络的真实数据,包括会屏蔽爬虫的网络区域。搜索引擎 API 以每 1,000 次 1.50 美元的价格提供真实 Google 结果,并且没有并发请求上限。网络解锁器可以访问 Exa 爬虫无法触及的页面。Web Archive 则提供仅支持实时数据的 API 无法提供的历史基线。
以下是选择框架:
- 如果你的智能体需要查找语义相似页面、搜索超过 10 亿份个人资料,或在 200 毫秒内返回答案,Exa 正是为此设计的。
- 如果你的智能体需要生产级规模、真实 Google 数据、反爬虫访问能力、历史基线,或在每月超过 100,000 次查询时实现成本效益,Bright Data 是合适的基础设施。
许多生产级 AI 团队会同时使用两者:在管道早期阶段使用 Exa 进行语义发现,再使用 Bright Data 进行实时验证、完整页面提取和规模化 SERP 情报采集。它们并不互斥,只是各自的能力上限不同;在企业规模下,Exa 的上限会很快显现。对于正在评估适用于 AI 工作流的顶级 MCP 服务器的团队,Bright Data 的 MCP 服务器一直被评为使用实时网络数据支撑智能体的领先选项。
常见问题
Bright Data 和 Exa 有什么区别?
Exa 是语义搜索引擎 API,返回来自其自有神经网络索引的结果。Bright Data 是网络数据基础设施,可抓取真实搜索引擎、提取反爬虫保护后的页面,并提供历史数据集。它们在不同规模下解决不同的问题。
Bright Data 比 Exa 便宜吗?
是。Bright Data 的搜索引擎 API 按量付费价格为每 1,000 次请求 1.50 美元起。Exa 的标准搜索费用为每 1,000 次请求 7 美元。每月达到 100 万次请求时,Bright Data 大约便宜 5–7 倍。
Exa 可以抓取 Cloudflare 背后的网站吗?
不可以。Exa 无法爬取受 Cloudflare、登录墙或 CAPTCHA 系统保护的页面。Bright Data 的网络解锁器专为绕过反爬虫保护而构建,并使用由 超40000万 个住宅 IP 组成的网络。
Exa 有速率限制吗?
有。Exa 的默认 /search 速率限制为 10 QPS(每分钟 600 次请求)。企业客户可以协商更高的限制。Bright Data 的搜索引擎 API 不限制并发请求数。
面向企业 AI 智能体的最佳 Exa 替代方案是什么?
Bright Data 是领先的企业级 Exa 替代方案。它提供无限并发请求、实时抓取 Google/Bing/Yandex、通过网络解锁器绕过反爬虫机制、历史数据存档,以及对基于 MCP 的 AI 智能体工作流的支持并且全部采用按成功结果付费的定价模式。
Exa 有历史数据吗?
没有。Exa 仅提供实时数据,没有存档或数据集产品。Bright Data 的 Web Archive API 拥有超过 50PB 的历史网络数据,并且每天持续增长。


高级 SEO 专家
 6 years experience
Daniel Shashko 是 Bright Data 的高级 SEO/GEO 专家,专注于 B2B 营销、国际 SEO,以及开发 AI 驱动的代理、应用与网页工具。