本文将介绍:
- 什么是 Oracle 生成式 AI 智能体服务,以及它能带来哪些优势。
- 为什么企业 AI 智能体需要访问实时网络数据以获取有针对性的市场洞察,以及 Bright Data 如何实现这一点。
- 如何使用由 Bright Data 提供支持的自定义工具,构建可访问网络的 Oracle 生成式 AI 智能体。
让我们开始吧!
什么是 Oracle 生成式 AI 智能体服务?

Oracle 生成式 AI 智能体是一项完全托管的 OCI(Oracle 云基础设施)服务,用于构建和部署 AI 智能体。这些智能体能够理解自然语言、保留对话上下文、编排工具、访问企业数据,并自动执行复杂的工作流。
常见用例包括客户支持、技术故障排除、法律和金融研究、内容创作、教育辅导、供应链分析、房地产洞察以及旅行协助。
主要功能
Oracle 生成式 AI 智能体提供的核心功能包括:
- 轻松设置智能体:通过引导式的完全托管设置流程创建和部署 AI 智能体,无需管理基础设施。
- 多轮对话:支持自然、类似人类的对话,并能在多条消息中进行上下文感知交互。
- 上下文保留:记住之前的对话内容,以提供个性化、一致且相关的回答。
- 自定义指令:通过可配置指令定义智能体的行为、语气、目标和路由逻辑。
- 内置防护机制:帮助防范提示词注入攻击、审核内容并检测敏感的 PII 数据。
- 人机协同支持:针对敏感操作和关键业务运营启用人工审核与干预。
- 企业级可扩展性和安全性:在 OCI 安全、可扩展的基础设施上运行,提供企业级可靠性和治理能力。
- 内置和自定义工具:通过 SQL、RAG、智能体间编排、函数调用和自定义 API 集成扩展智能体。
如需了解更多信息,请参阅官方文档。
为什么企业级 Oracle AI 智能体需要网络访问能力
为了做出切实可行的业务决策,企业 AI 智能体需要访问外部市场数据,包括当前趋势、竞争对手动态、客户情绪、突发新闻和监管更新。
问题在于,LLM 默认并未连接到实时网络。因此,它们面临两个主要限制:
- 无法访问实时信息:LLM 无法原生检索最新的网络内容。
- 对网站的访问受限:许多网站采用反机器人技术,阻止自动化系统采集数据。
通过使用外部工具和集成来扩展 AI 智能体,可以克服这些限制。
这正是 Oracle 生成式 AI 智能体支持多种工具选项的原因。尤其是API 端点调用工具可使其安全连接到 Bright Data 等基于 API 的外部服务。
Bright Data 解决方案

Bright Data 是领先的企业级 AI 就绪网络数据平台。借助全面的产品套件你可以大规模且合乎道德地采集、构建和分析公共网络数据。
其中包括:
- Unlocker API:绕过 CAPTCHA、反机器人系统和网站封锁,从任何网页检索数据。
- 搜索引擎 API:提供来自 Google、Bing、Yandex 及其他主流搜索引擎的结构化实时搜索结果。
- Crawl API:支持大规模网站爬取和自动化数据提取。
- 爬虫 API:从 120 多个热门网站和平台提取结构化数据。
Bright Data 的突出优势在于其覆盖 195 个国家/地区、拥有超过 4 亿个住宅 IP 的网络。该基础设施支持高度可扩展且分布于不同地理位置的网络数据采集,同时实现 98.50% 的成功率和由 SLA 保障的 99.99% 正常运行时间。此外,它还符合所有主要的隐私和安全框架包括 GDPR 和 CCPA。
通过 API 端点调用工具集成 Bright Data,Oracle 生成式 AI 智能体可以搜索网络、访问最新在线信息、从网站检索数据,并将真实世界的上下文融入回答。这将带来更准确、更及时且更具可操作性的结果。
将 Bright Data 与 Oracle 生成式 AI 智能体集成
在本分步章节中,你将学习如何构建一个集成 Bright Data 的 Oracle 生成式 AI 智能体。具体来说,你将了解如何定义两个自定义 API 端点调用工具,以连接 Bright Data 的网络解锁器 API 和搜索引擎 API。
搜索引擎 API 使智能体能够发现新来源,而网络解锁器 API 则允许智能体访问其中的内容。两者结合即可实现强大的搜索和提取模式。这有助于智能体自主地以实时、可验证且包含上下文的网络数据为依据生成回答,从而产出更符合事实且达到企业级标准的结果。
请按照以下说明操作!
前提条件
要完成本章节,请确保你具备:
- 一个 Oracle Cloud 账户(免费套餐账户即可)。
- 一个已配置 API 密钥的 Bright Data 账户。请按照官方指南设置 Bright Data API 密钥。
步骤 1:设置 VCN
登录 Oracle 账户,搜索“虚拟云网络”,然后选择对应的服务:

在“虚拟云网络”页面上,打开“操作”下拉菜单并选择“启动 VCN 向导”:

接下来,选择“创建具有互联网连接的 VCN”选项,然后按照设置向导操作:

为 VCN 指定一个名称(例如“ai”),然后继续完成向导。默认设置即可满足此配置的需求。
注意:必须为子网启用“DNS 解析”功能,否则自定义工具将无法调用外部端点。不过,使用 OCI 网络向导时默认会启用此功能,因此无需担心。
创建 VCN 后,你应该会看到类似以下的界面:

很好!你现在已经拥有一个带子网的 OCI 虚拟云网络(VCN),Bright Data 工具可以使用它来路由 HTTP 流量。
步骤 2:将 Bright Data API 密钥存储在 Oracle Vault 中
首先,按照 Oracle 官方指南设置 Oracle Vault(包含加密密钥)。接下来,在 Oracle 账户中搜索“密钥管理”并打开该服务。点击“创建密钥”按钮:

在“创建密钥”表单中,为密钥指定一个名称(例如“bright-data-api-key-bearer”),选择 Oracle Vault 和加密密钥,然后选择“手动生成密钥”选项。使用以下格式填写密钥值:
Bearer <BRIGHT_DATA_API_KEY>将 <BRIGHT_DATA_API_KEY> 占位符替换为你的实际 Bright Data API 密钥。
注意:API 密钥前必须添加“Bearer”前缀。这是用于 Bright Data API 身份验证的标准令牌格式需要在 Authorization 标头中设置。

点击“创建密钥”完成创建。现在,你应该能在“密钥”页面看到该密钥:

很好!该密钥将用于对自定义智能体工具向 Bright Data API 发出的请求进行身份验证。
步骤 3:添加所需的 IAM 策略
默认情况下,Oracle 生成式 AI 服务无权访问存储在 Vault 中的密钥。要启用此访问权限,你必须添加正确的 IAM 策略。
在 OCI 控制台中搜索“策略”,然后打开相应页面。接着点击“创建策略”:

在“创建策略”表单中,为策略指定一个名称(例如“genaiagent”)。然后点击“显示手动编辑器”,并粘贴以下 IAM 策略:
allow any-user to read secret-family in tenancy where any {request.principal.type='genaiagent'}此策略允许所有生成式 AI 智能体读取整个租户范围内存储在 OCI Vault 实例中的密钥,包括之前创建的“bright-data-api-key-bearer”密钥。
点击“创建”以确认创建策略:

创建后,该策略将显示在“策略”页面中:

或者,你也可以按照设置动态组的官方指南实现相同目标。
做得好!现在,你已经具备构建 Oracle 生成式 AI 智能体所需的所有基础组件,它们可以通过自定义工具连接到 Bright Data。
步骤 4:初始化具备网络访问能力的智能体
搜索“智能体”,然后在“生成式 AI 智能体”服务中打开相应页面:

点击“创建智能体”按钮继续:

这将启动智能体创建向导。按以下方式填写表单:
- 名称:
Web Access AI Agent - 描述:
You are a web agent with web access powered by the Bright Data integration - 路由指令:
When asked to search the web, retrieve online data, or scrape web pages, use the Bright Data tools
然后,选择你偏好的 LLM 作为智能体的大脑。在本例中,默认的 Llama 3.3 70B 模型就足够了。

非常好!点击“下一步”进入向导的“工具”部分。在定义 Bright Data 集成工具之前,我们先完成初始设置。
步骤 5:开始使用 Bright Data 的 Unlocker API 和搜索引擎 API
现在,你需要在 Bright Data 账户中创建 Unlocker API 和搜索引擎 API。如需快速设置,请参阅官方文档页面:
或者,也可以按照以下说明操作。
如果尚未注册,请创建 Bright Data 账户。如果已有账户,请登录并打开控制面板:
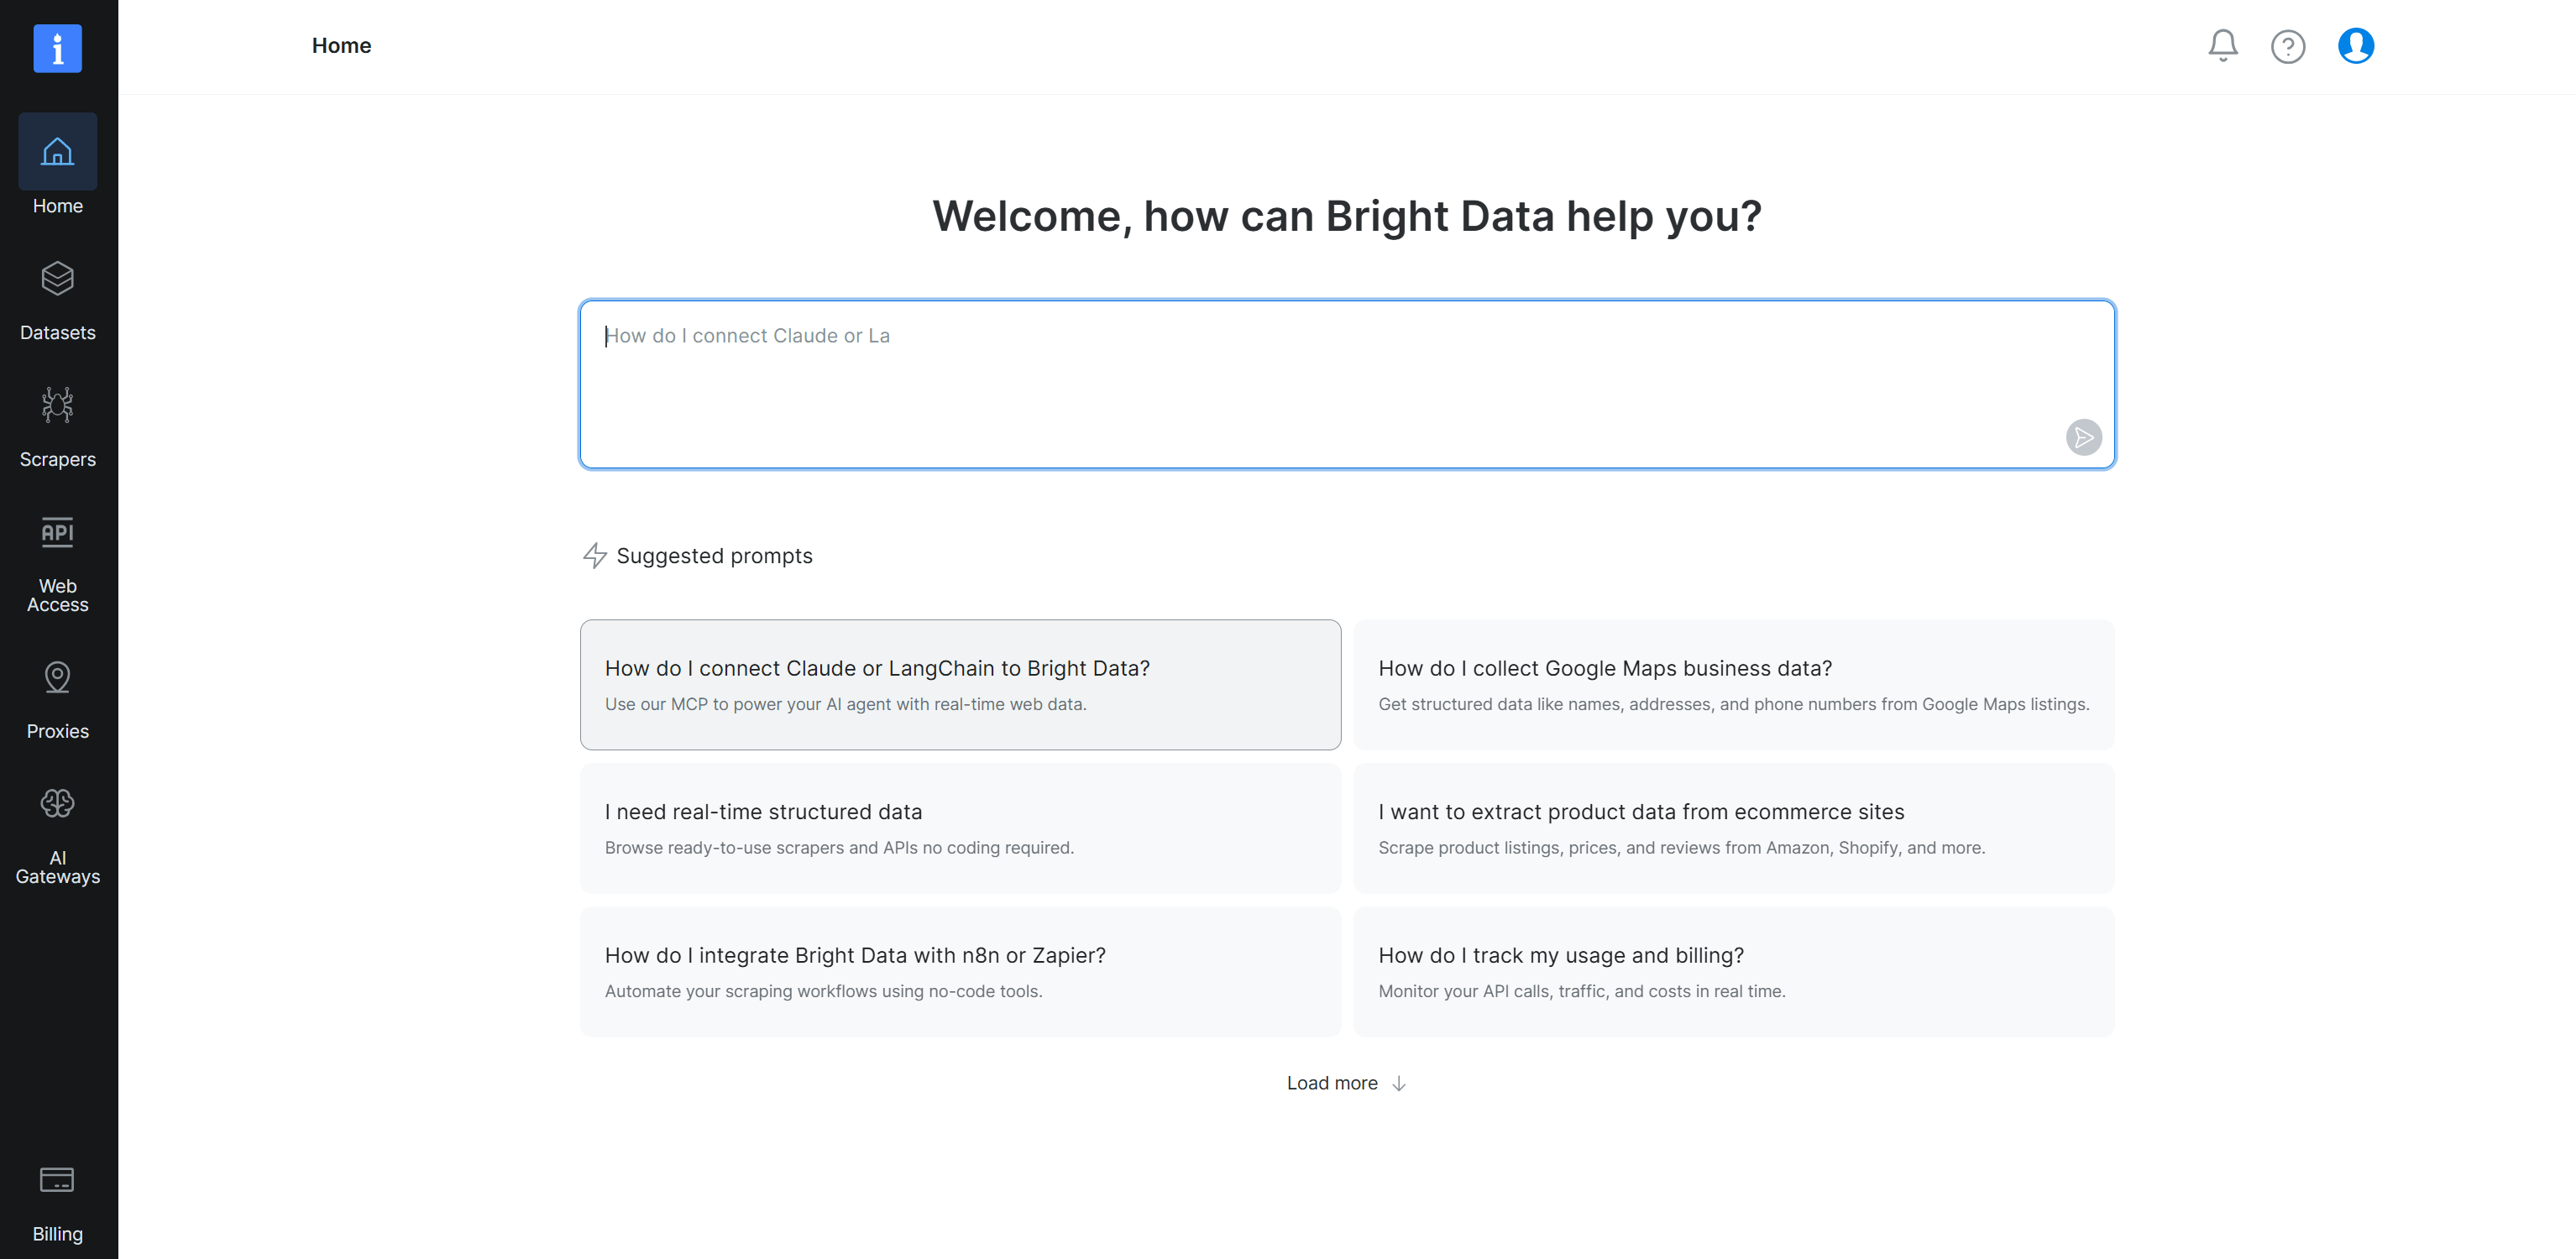
接下来,从左侧菜单导航至“网络访问 > 网络访问 API”:
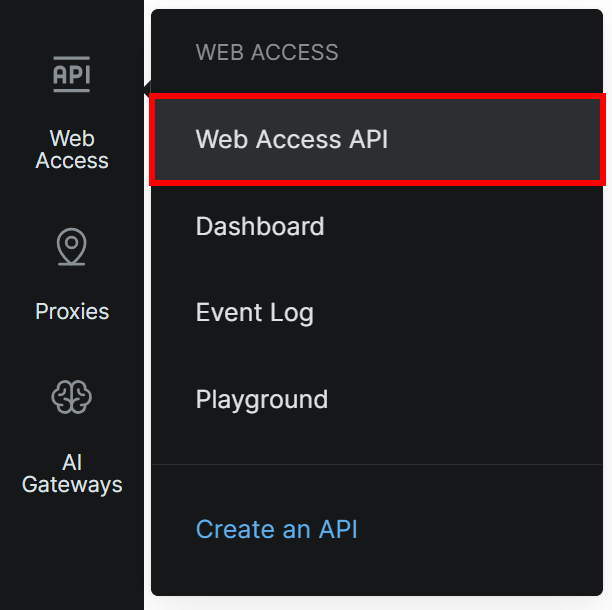
如果“我的 API”表格中已经显示“网络解锁器 API”和“搜索引擎 API”条目,则可以直接继续:

否则,请点击“创建 API”按钮上的下拉菜单,然后选择“Unlocker API”(如果你想创建搜索引擎 API,也可以选择“搜索引擎 API”):

这将启动 Unlocker/搜索引擎 API 设置向导。为 API 指定一个名称(例如 unlocker_api/serp_api),然后根据你的需求配置 API:

完成后,点击“添加 API”。接下来,我们将假设你设置了以下 API 名称:
unlocker_api用于 Bright Data Unlocker API。serp_api用于 Bright Data 搜索引擎 API。
现在,你可以定义连接到这些 API 的自定义 API 端点调用工具了。太棒了!
步骤 6:创建用于集成网络解锁器 API 的自定义工具
返回生成式 AI 智能体创建向导。在“工具”部分,点击“添加工具”。
要创建用于集成 Unlocker API 的工具,请选择“自定义工具”选项。然后按以下方式填写表单:
- 名称:
Web Unlocker API - 描述:
An automated web scraping tool that extracts content from web pages and bypasses anti-bot protections
在“工具配置”部分,选择“API 端点调用(智能体执行)”选项:

在“示例”部分,选择“无”以从空白配置开始,然后粘贴以下 OpenAPI 规范:
{
  "openapi": "3.0.4",
  "info": {
    "title": "Bright Data Web Unlocker API",
    "version": "1.0.0",
    "description": "Bright Data Unlocker API enables you to bypass anti-bot measures. It manages proxies and solves CAPTCHAs automatically for easier web data collection.\n\n\[Web Unlocker API documentation\](https://docs.brightdata.com/scraping-automation/web-unlocker/introduction)\n"
  },
  "servers": [
    {
      "url": "https://api.brightdata.com"
    }
  ],
  "paths": {
    "/request": {
      "post": {
        "operationId": "sendWebUnlockerRequest",
        "summary": "Send a Web Unlocker API request",
        "description": "Submit a Web Unlocker API request using your Bright Data Web Unlocker API zone.\n\n\[Web Unlocker API `/request` documentation\](https://docs.brightdata.com/api-reference/rest-api/unlocker/unlock-website)\n",
        "requestBody": {
          "required": true,
          "content": {
            "application/json": {
              "schema": {
                "type": "object",
                "required": ["zone", "url", "format"],
                "properties": {
                  "zone": {
                    "type": "string",
                    "description": "Your Web Unlocker zone name.",
                    "default": "unlocker_api"
                  },
                  "url": {
                    "type": "string",
                    "description": "The target website URL to unlock and fetch.",
                    "example": "https://example.com/products"
                  },
                  "format": {
                    "type": "string",
                    "description": "Response format.\nAllowed values:\n- raw: Returns the response immediately in the body.\n- json: Returns the response as a structured JSON object.",
                    "default": "raw"
                  },
                  "method": {
                    "type": "string",
                    "description": "HTTP method used when fetching the target URL.",
                    "example": "GET"
                  },
                  "country": {
                    "type": "string",
                    "description": "Country code for proxy location (ISO 3166-1 alpha-2 format).",
                    "example": "us"
                  }
                }
              }
            }
          }
        },
                "responses": {
          "200": {
            "description": "Successful response containing search results."
          },
          "400": {
            "description": "Invalid request (missing required fields or invalid parameters)."
          },
          "401": {
            "description": "Unauthorized (invalid or missing Bright Data API key)."
          }
        }
      }
    }
  }
}
这对应于 Bright Data 网络解锁器 OpenAPI 规范。如需更多参考信息,请阅读“OpenAPI 规范:通过搜索引擎 API 和 Unlocker API 实现 AI 集成”指南。
重要提示:请注意 zone 属性下的 "default": "unlocker_api" 字段。该字段至关重要,因为它会指示 AI 智能体如何调用你的 Bright Data Unlocker API。请将 "unlocker_api" 替换为 Unlocker API 的实际名称。
要配置身份验证方法,请按以下方式填写表单:
- 身份验证类型:
API key - 密钥位置:
Header - 密钥名称:
Authorization - 密钥值:
bright-data-api-key-bearer(或你存储的 Bright Data API 密钥名称) - VCN:
ai(或你的 Oracle VCN 名称) - 子网:
private-subnet-ai(关键:请选择私有子网,否则所有工具调用都会因500错误而失败)

此配置会按照 Bright Data 的要求,为自定义工具设置所需的身份验证方法。同时,它还确保对 Unlocker API 的调用通过 OCI VCN 私有子网执行。
最后,点击“添加工具”完成设置。由 Bright Data 提供支持的网页抓取工具现在将可供智能体使用。太棒了!
步骤 7:创建搜索引擎 API 工具
如果无法自主发现网络内容,仅具备抓取能力的智能体会受到很大限制。这正是 Bright Data 搜索引擎 API 的用武之地!
再次点击“添加工具”,重复之前的操作流程。这一次,按以下方式填写表单:
- 名称:
SERP API - 描述:
An endpoint that provides real users'search results at high volume across major search engines, including Google
接下来,粘贴以下规范:
{
  "openapi": "3.0.4",
  "info": {
    "title": "Bright Data SERP API",
    "version": "1.0.0",
    "description": "Extract search engine results using Bright Data SERP API. Extract structured data from major search engines, including Google, Bing, Yandex, DuckDuckGo, and more.  \nGet organic results, paid ads, local listings, shopping results, and other SERP features.\n\[SERP API documentation\](https://docs.brightdata.com/scraping-automation/serp-api/introduction)\n"
  },
  "servers": [
    {
      "url": "https://api.brightdata.com"
    }
  ],
  "paths": {
    "/request": {
      "post": {
        "operationId": "sendSerpRequest",
        "summary": "Send a SERP API request",
        "description": "Submit a SERP API request using your Bright Data SERP API zone.  \n\n\[SERP API `/request` documentation\](https://docs.brightdata.com/api-reference/rest-api/serp/scrape-serp)\n",
        "requestBody": {
          "required": true,
          "content": {
            "application/json": {
              "schema": {
                "type": "object",
                "required": [
                  "zone",
                  "url",
                  "format"
                ],
                "properties": {
                  "zone": {
                    "type": "string",
                    "description": "The name of your SERP API zone.",
                    "default": "serp_api"
                  },
                  "url": {
                    "type": "string",
                    "description": "The search engine URL to query (e.g., `https://www.google.com/search?q=<search_query>`).",
                    "example": "https://www.google.com/search?q=pizza&hl=en&gl=us"
                  },
                  "format": {
                    "type": "string",
                    "description": "Response format.  \nAllowed values:  \n- `raw`: Returns the response immediately in the body.  \n- `json`: Returns the response as a structured JSON object.  \n",
                    "default": "raw",
                    "enum": [
                      "raw",
                      "json"
                    ]
                  },
                  "country": {
                    "type": "string",
                    "description": "Country code for proxy location (ISO 3166-1 alpha-2 format). \n",
                    "example": "us"
                  }
                }
              }
            }
          }
        },
        "responses": {
          "200": {
            "description": "Successful response containing search results."
          },
          "400": {
            "description": "Invalid request (missing required fields or invalid parameters)."
          },
          "401": {
            "description": "Unauthorized (invalid or missing Bright Data API key)."
          }
        }
      }
    }
  }
}重要提示:如前所述,请确保 zone 属性下的 default 字段与你的搜索引擎 API 名称一致。
添加此工具后,你应该会看到以下内容:

注意:你也可以采用类似方式连接其他所有基于 API 的 Bright Data 解决方案。
很好!现在只需完成最后的收尾工作。
步骤 8:完成智能体创建
点击“下一步”进入智能体端点设置。要测试智能体,必须完成此设置。然后,检查所有智能体信息,点击“创建智能体”,并接受 Llama 3 许可协议。
你将被重定向回“智能体”页面,其中会显示状态为“正在创建”的“网络访问 AI 智能体”条目。预配过程可能需要几分钟,请耐心等待。

稍等片刻后,状态将变为“活动”,这意味着集成 Bright Data 的 Oracle 生成式 AI 智能体已准备就绪!
步骤 8:测试智能体
点击智能体名称,你将被重定向至以下页面:

在这里,你可以点击“启动聊天”来测试智能体。
确保已选择你的 AI 智能体和相关端点,然后粘贴如下提示词:
Search Google for the latest news about SpaceX stock, review the content from the 2,3 most relevant sources, and provide a report summarizing the most important information这是一个理想的测试,因为它可以验证 Bright Data 集成能否同时处理网络搜索和抓取任务。
在“聊天”页面中执行该提示词。你应该会看到类似以下的结果:

可以看到,AI 智能体返回了有关 SpaceX 股票的上下文信息。由于 SpaceX 就在几小时前上市(截至撰写本文时),因此这些信息非常新。
标准 LLM 无法提供这些信息,因为它基于静态数据集进行训练。要确认 Bright Data 工具确实已被调用(并且结果并非幻觉),请展开“跟踪”下拉菜单,然后点击右侧的“查看”按钮。
你可以在此检查智能体的计划和执行步骤。你会看到,它调用了搜索引擎 API 工具,通过 Google 搜索有关 SpaceX 股票的新闻:

在底层,智能体工具会调用 Bright Data 搜索引擎 API,后者返回此 Google SERP 的 JSON 版本:

智能体会从发现的 URL 中选择最相关的来源,对其进行抓取,并将检索到的全部信息汇总为最终的上下文结果。
大功告成!这个简单示例展示了 Bright Data 提供的网络搜索和爬虫能力如何让 Oracle 生成式 AI 智能体生成有事实依据且准确的结果。现在,你可以尝试不同的提示词,探索其他所有受支持的企业用例。
总结
在本教程中,你了解了 Oracle 生成式 AI 智能体服务及其提供的功能。你还探索了 AI 智能体的局限性,以及如何通过 Bright Data API 在企业场景中解决这些问题。
本文指导你定义了一个配备自定义工具的 Oracle 生成式 AI 智能体,用于调用 Bright Data 端点。最终得到的 AI 智能体能够像人类一样探索网络并从中检索信息。
这只是 Bright Data 集成所支持的众多用例之一。如果你需要实施方面的帮助,或想探索其他可能的场景,请联系我们的全天候支持团队。
立即免费创建 Bright Data 账户,开始探索我们的网络数据解决方案!


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。