Amazon Nova Act 可以理解网页并对其执行操作。到 2026 年,生产级网页智能体的难点并不是模型,而是网页访问:可靠地访问实时网页,具备正确的地理定位,同时保持合规。本文将 Nova Act 与 Bright Data 面向 AI 智能体的网页访问层配合使用,这里的测量数据来自实时运行。
TL;DR
生产级 AI 网页智能体的瓶颈是网页访问,而不是模型。解决办法是拆分:Amazon Nova Act 负责多步骤浏览器决策,Bright Data 的网页访问层负责访问、合规和规模化。Bright Data 的 Data for AI 2026 报告发现,97% 的 AI 组织依赖实时网页数据,90% 的组织表示访问限制正在限制其 AI 计划。
完整的可运行脚本,包含每个 import、schema 和 helper,都在配套仓库中。如果你想运行它,请克隆该仓库,而不是从这里复制粘贴。
要跟着操作,你需要 Python 3.10+、pip install nova-act,以及来自 nova.amazon.com/act 的 Nova Act API key。你还需要一个 Bright Data 账户,其中包含一个浏览器 API 区域,以及用于数据层调用的 API key。只有 Web MCP 部分需要 Node.js。
为什么浏览器智能体的默认方式不够好
使用浏览器智能体的显而易见方法是让它做所有事情。打开页面、关闭 cookie 横幅、滚动、提取。它在演示中看起来不错,但对大多数数据工作来说,这是错误的默认方式。
- 它很重。 一个真实的消费者页面(一次 eBay 搜索)通过浏览器传输了约 3.4 MB。把它乘以数百万个页面,你就在为移动整个渲染后的网页付费,包括每张图片,只为了提取三个字段。
- 它在执行操作时很脆弱。 指向 booking.com 时,Nova Act 在与弹窗和延迟加载内容周旋时抛出
ActActuationError,即使页面本身加载正常。普通读取通常可靠。繁重的多步骤执行会在那里崩溃。 - 它是不确定的。 可靠性会快速下降。十个可靠性为 90% 的步骤最终接近
0.9¹⁰ ≈ 35%,除非你为此做规划。
这些都不意味着浏览器智能体毫无用处。所以要把它们用于只有它们能做的事情(多步骤操作和决策),并把其他所有东西下沉到基础设施。
Amazon Nova Act 是什么,以及不是什么
Nova Act 是一个 AWS SDK,2026 年中期版本为 3.4.x,正在从研究预览走向生产,用于在 Python 中构建浏览器智能体。它的设计理念与一个巨大提示词相反。你把工作流拆成小型、原子化、可靠的命令,并用普通 Python 将它们连接起来。两个命令分别是一个操作和一个类型化读取:
from nova_act import NovaAct
from pydantic import BaseModel

class Product(BaseModel):
    title: str | None = None
    price: str | None = None
    availability: str | None = None

with NovaAct(starting_page="https://example.com/product/123") as nova:
    nova.act("search for wireless headphones")          # an action
    data = nova.act_get(                                 # a typed read
        "Return the product title, price, and availability.",
        schema=Product.model_json_schema(),
    )
通过 Pydantic schema,act_get 可以把页面转成类型化数据,而无需脆弱的选择器。Nova Act 底层通过 Playwright 驱动一个真实的 Chromium,这一细节对连接很重要。Nova Act 给你推理、导航和结构化提取。它不给你任何应对开放网页敌意的答案。它没有地理覆盖、没有大规模解锁、没有内置合规。这不是它的工作。这是基础设施层的工作。
Bright Data,网页访问层
这一层围绕一个理念构建:为你的 AI 解锁网页。Web MCP 是一个 Model Context Protocol 服务器,为智能体提供它可直接调用的结构化网页工具。网络解锁器和搜索引擎 API返回干净页面和搜索结果。网页爬虫工具 API和数据集执行批量结构化检索。浏览器 API是一个你可以远程驱动的云端 Chrome,适用于智能体需要执行操作的场景。底层是一个覆盖 195 个国家、拥有 4 亿+住宅 IP 的网络,并处理常见 CAPTCHA 挑战、指纹管理和地理定位。
在 Bright Data 的 Data for AI 2026 调查中,87% 的组织同意“二级互联网”正在出现,即自动化流量的智能体网页与人类网页并行运行。65% 的组织已经依赖专门的网页数据基础设施提供商,而不是在内部构建访问能力。
这是一层,而不是一个工具。你的智能体栈会变化。它下面的网页访问层不会。因此,工程问题从来不是抽象地讨论浏览器与 API 哪个更好。你把工作拆成两部分:智能体负责决策,基础设施负责访问。
架构,上层是大脑,底层是基础设施
Nova Act 向下发送操作,结构化数据返回。
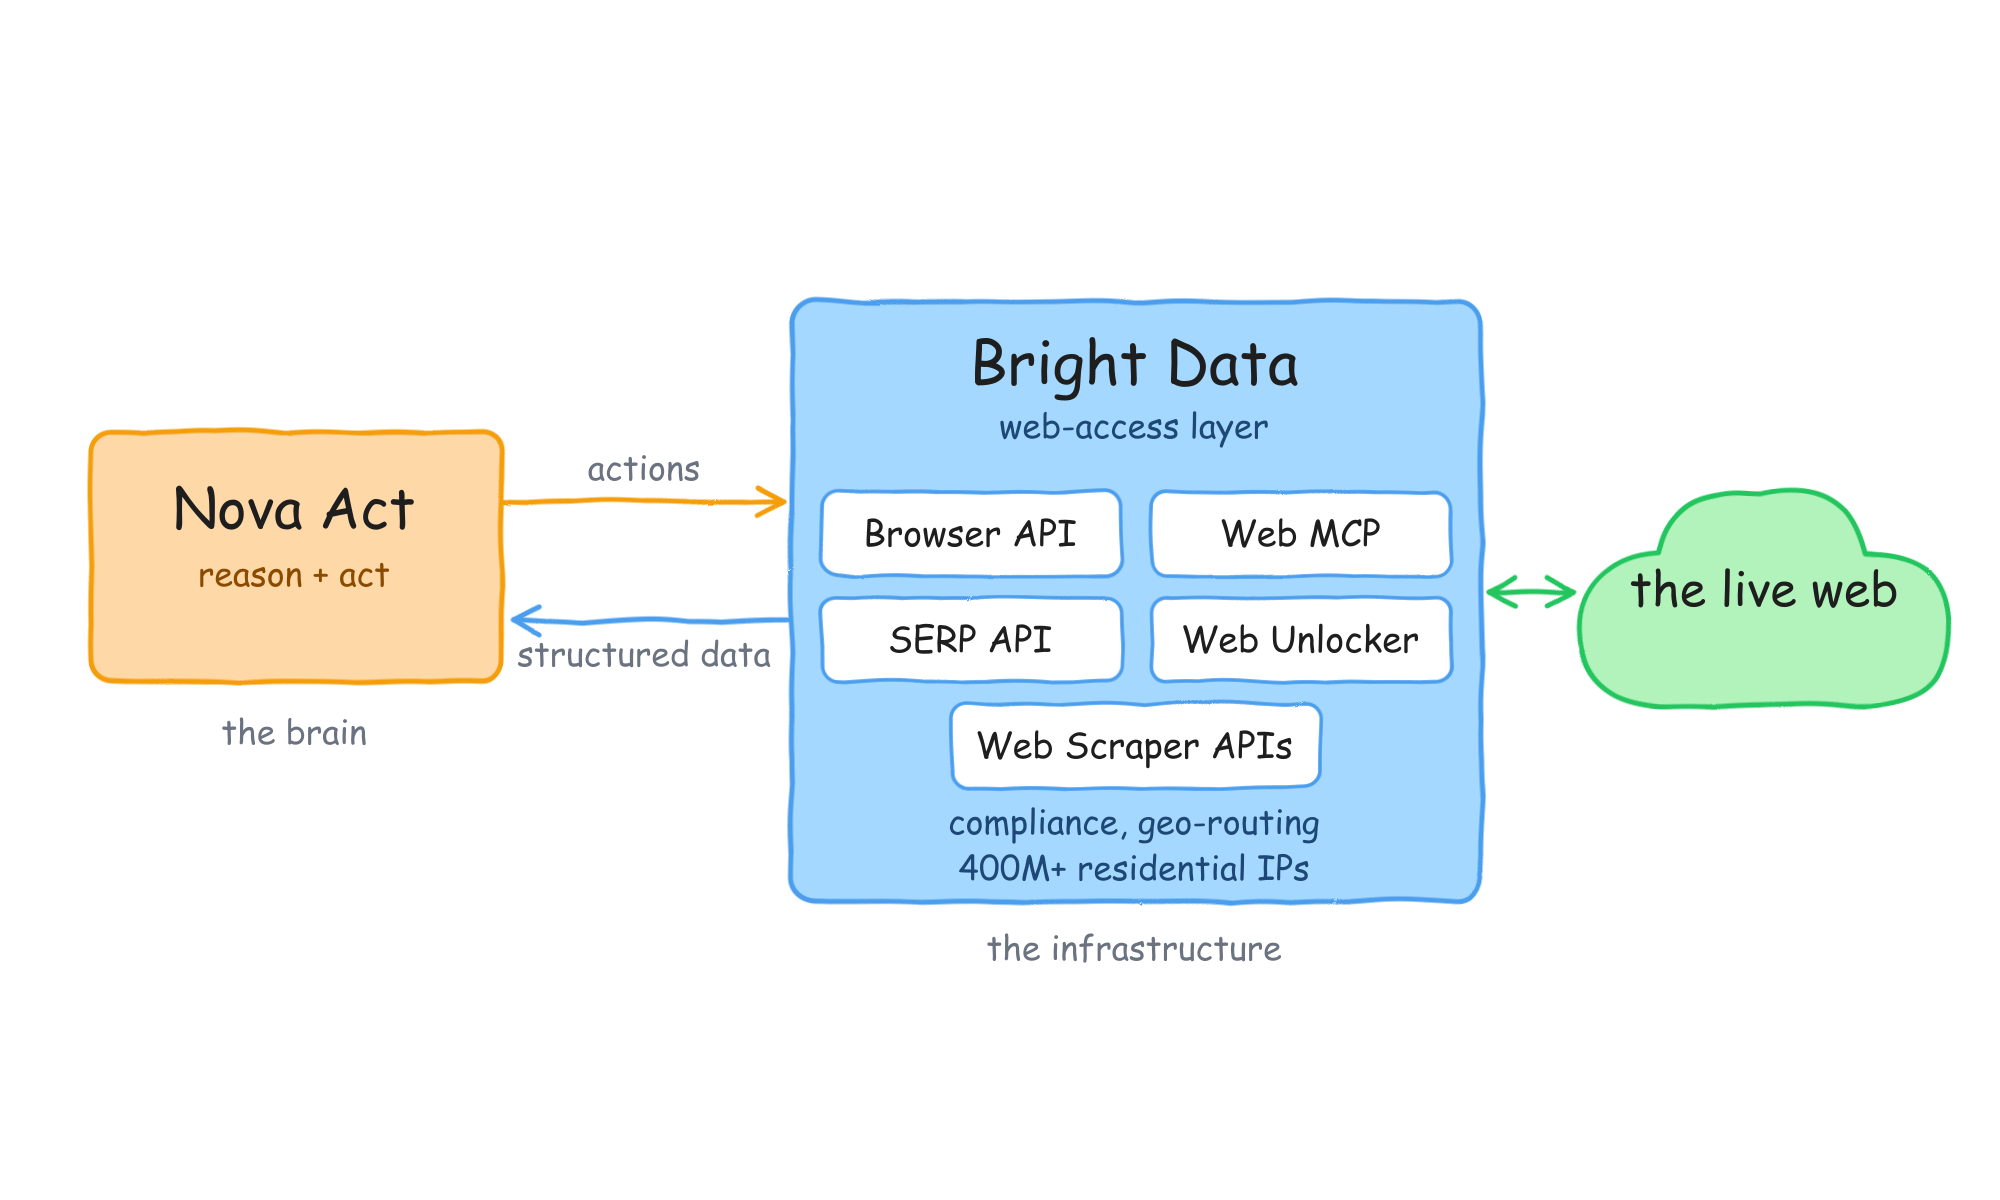
Nova Act 做出决策和操作。Bright Data 的网页访问层处理访问、合规、地理位置和规模化,然后访问实时网页。
对于操作模式,Nova Act 通过 Chrome DevTools Protocol (CDP) 连接到 Bright Data 的浏览器 API,这是 Playwright(因此也是 Nova Act)已经使用的同一个协议。你替换浏览器,同时保留智能体。
接线,以及预期会遇到的设置错误
创建一个浏览器 API 区域(其验证码破解默认开启),控制面板会给你一个 URL:
wss://brd-customer-<id>-zone-<name>:<password>@brd.superproxy.io:9222该字符串来自区域的 Overview 标签页,位于 Access details 下。
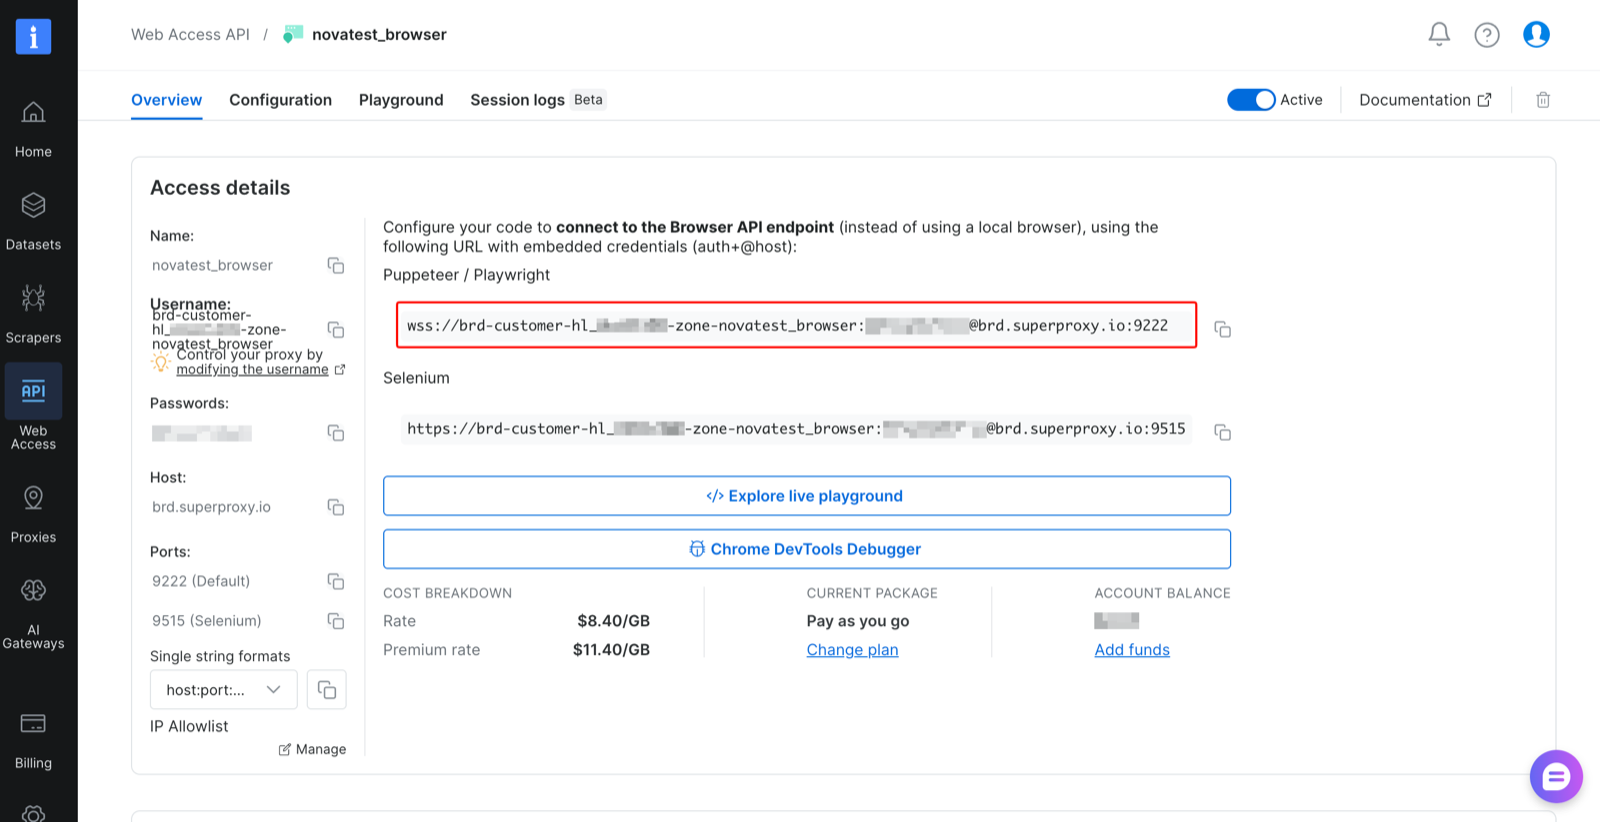
浏览器 API 区域的 Access details。控制面板会给你带有内联凭据的 wss:// 字符串,即面板顶部显示的 auth+@host 形式。现代 Playwright 会拒绝这种内联形式,因此 split_cdp() 会把凭据移入 Authorization: Basic header。左侧的 IP Allowlist 是另一个陷阱。如果你的 IP 不在其中,调用会返回空 body,而原因会出现在响应 header 中,而不是状态码中。
Invalid URL 错误:Playwright 拒绝内联 wss:// 凭据
直接把它粘贴到 Nova Act 中会失败:
playwright._impl._errors.Error: BrowserType.connect_over_cdp:
    Invalid URL: wss://brd-customer-...:[email protected]:9222
这是常见的首次运行失败。现代 Playwright,即与 Nova Act 3.4 捆绑的 1.56 版本,会拒绝嵌入在 WebSocket URL 中的凭据。控制面板显示内联形式,是因为它适用于较旧的客户端,而不适用于 Nova Act 内部的 Playwright。修复方法是把凭据剥离出来,并通过 cdp_headers 将其作为 Authorization: Basic header 传递。
import os
import base64

def split_cdp(raw_url: str) -> tuple[str, dict | None]:
    """Bright Data gives an inline-credential wss URL; Playwright rejects that.
    Move credentials into a Basic auth header. (Parsed manually because
    Python 3.14's urlsplit also rejects the multi-colon netloc.)"""
    scheme, sep, rest = raw_url.partition("://")
    if not sep or "@" not in rest:
        return raw_url, None
    creds, _, hostport = rest.rpartition("@")
    user, _, pwd = creds.partition(":")
    token = base64.b64encode(f"{user}:{pwd}".encode()).decode()
    return f"{scheme}://{hostport}", {"Authorization": f"Basic {token}"}

endpoint, headers = split_cdp(os.environ["BRIGHTDATA_CDP_URL"])
with NovaAct(starting_page=URL, cdp_endpoint_url=endpoint, cdp_headers=headers,
             logs_directory="runs/demo") as nova:    # NOTE: logs dir must already exist
    ...
间歇性的 InvalidScreenResolution 陷阱
另一个大陷阱是视口。Bright Data 的远程浏览器给 Nova Act 的窗口大约是 1280×585,小于 Nova Act 预期的大约 1600×900。Nova Act 不会优雅降级。它会抛出一个间歇性的硬 InvalidScreenResolution ActError。它是间歇性的,因为每个云端会话都会获得略有不同的尺寸。这使其难以诊断,也很容易被误读为需要重试的不稳定智能体。强制连接页面使用支持的尺寸:
with NovaAct(starting_page=URL, cdp_endpoint_url=endpoint, cdp_headers=headers,
             screen_width=1600, screen_height=900, logs_directory="runs/demo") as nova:
    nova.page.set_viewport_size({"width": 1600, "height": 900})   # force a supported size to stop InvalidScreenResolution
...两个较小的陷阱:StartFailed 和缺失的 logs_directory
不要在使用 cdp_endpoint_url 时传递 headless=True,因为远程浏览器已经是 headless,你会得到 StartFailed。并且 logs_directory 必须在启动前存在,因为 Nova Act 会验证路径且不会创建它。
智能体用于什么
连接完成后,问题就是让智能体做什么。普通读取是它提供的最不独特的能力,而 Bright Data 的网页爬虫工具 API 能更好、更便宜地做到这一点。智能体比爬虫工具更有价值,因为它可以执行操作。
它最有用的操作是访问表单后面的数据。那里没有可提前知道的静态 URL,也没有 API,因此抓取工具没有可请求的目标。智能体可以填写表单并读取结果。因此我们将 Nova Act 指向 Drugs@FDA,这是美国权威的药品批准数据库,并要求它检索一条药品记录:
nova.act("Search for the drug named ibuprofen")            # fill the form, submit
drug = nova.act_get("Return the brand name, active ingredient, application number, "
                    "and marketing status of the first result.", schema=Drug.model_json_schema())
它自己的 trace 显示了一个没有 URL 能捕获的四步流程。它在搜索框中输入并按 Enter,发现第一个结果处于折叠状态并点击展开,点击进入详情页,然后读取字段:
{'drug_name': 'ACETAMINOPHEN AND IBUPROFEN', 'active_ingredient': 'ACETAMINOPHEN; IBUPROFEN',
 'application_number': '214836', 'marketing_status': 'Over-the-counter'}    # all 4 DOM-grounded
浏览器中的这四个步骤:
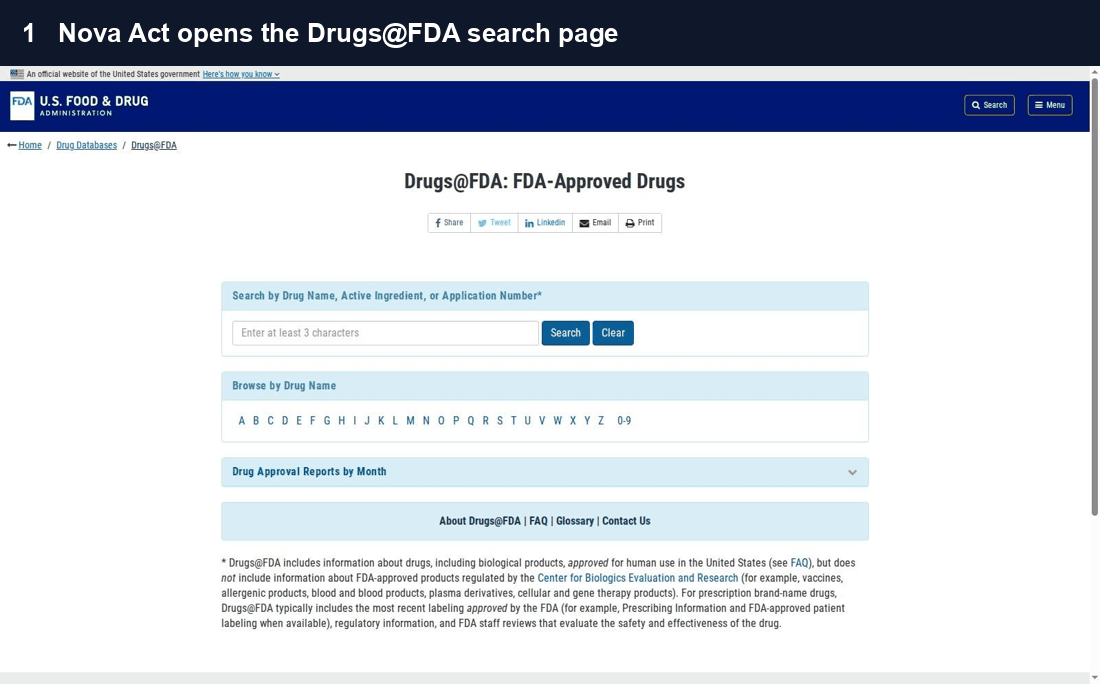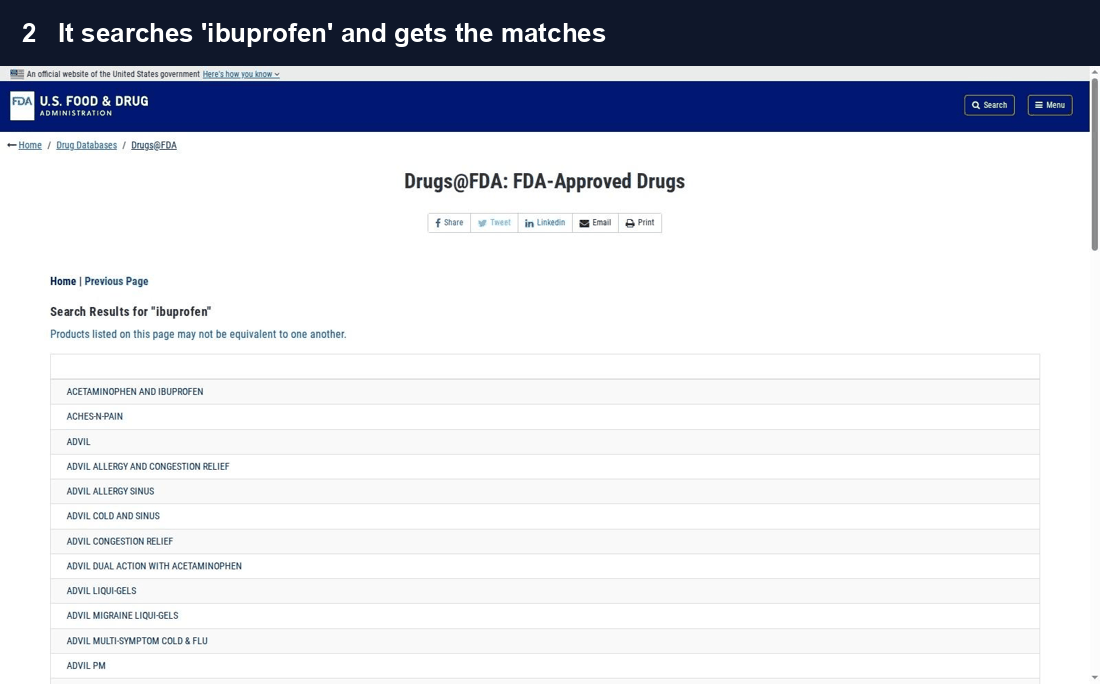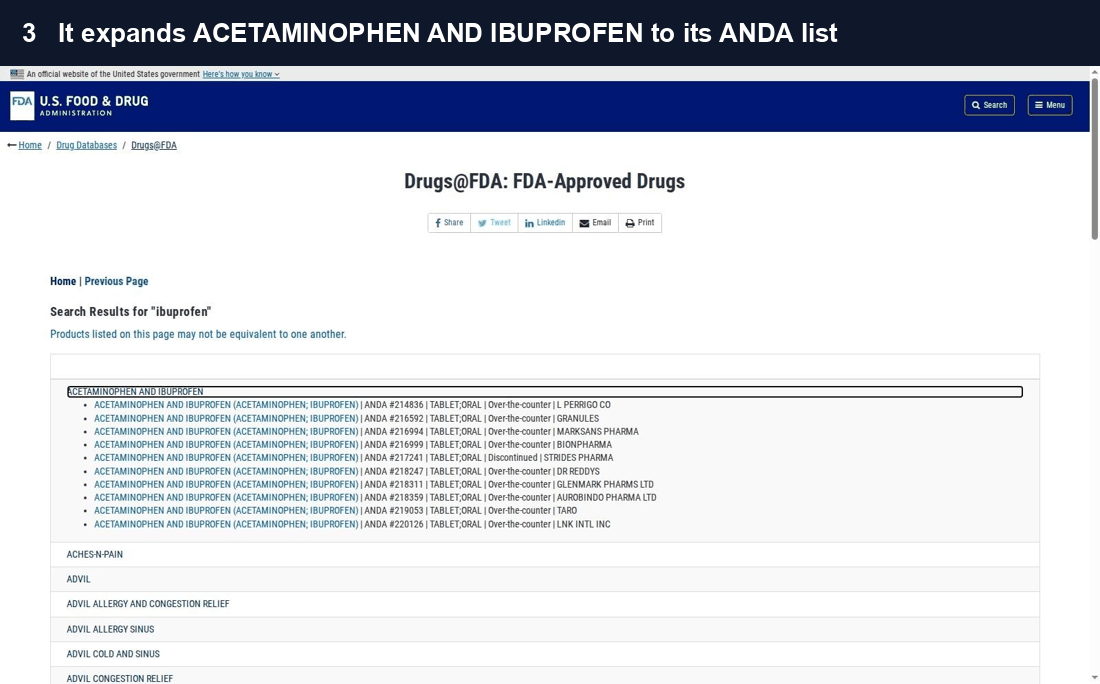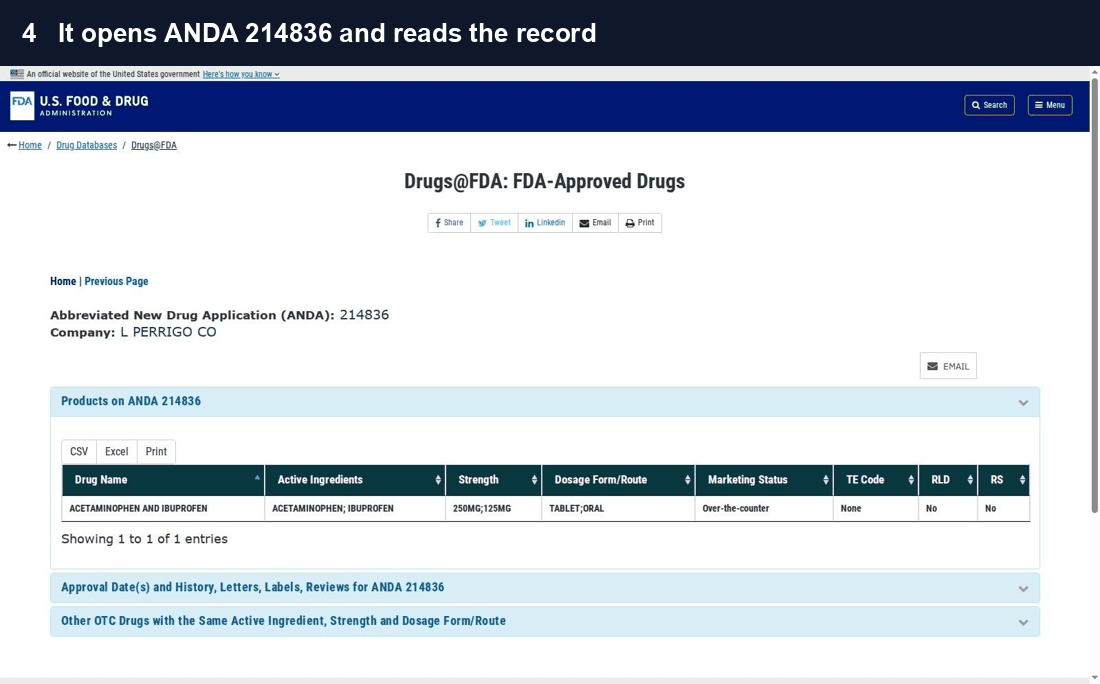
该次运行的真实录制,逐帧展示。Nova Act 在 Drugs@FDA 上搜索“ibuprofen”,打开第一个结果,并读取 ANDA #214836,即运行返回的同一个申请编号。
我们在不同药品上运行,以确认一致性:aspirin 给出 8-HOUR BAYER (#016030),metformin 给出 ACTOPLUS MET (#021842)。加上 ibuprofen,这是 3/3,每个字段都有依据。 这正是智能体证明其成本合理的地方。智能体填写表单并导航到权威的、由表单门控的公共数据,而爬虫无法访问。让 AI 基于深网公共数据是一个真实问题。在一个配合良好、结构清晰的网站上,它是可靠的。
长尾
同样的方法覆盖长尾,即没有预置爬虫工具的小众网站。Bright Data 的网页爬虫工具 API 已经覆盖超过 100 个高价值网站。指向 BoardGameGeek 时,Nova Act 返回了一条干净的六字段记录,Catan / 1995 / 3,4 players / 60,120 min / rating 7.1 / lowest price。你可以在同一会话中通过 nova.page(Playwright handle)根据实时 DOM 验证它:
assert game.parsed_response["bgg_rating"] in nova.page.inner_text("body") # 7.1 -> present出现了两个 grounding 经验。比较前先规范化,因为页面的 en-dash 3,4 与智能体的 hyphen 3-4 是假不匹配,不是幻觉。并且在会话中验证,绝不要稍后验证,因为一个实时 marketplace 价格在提取时有依据,但重新加载后消失了,所以对易变数据进行第二遍检查可能是错的。有了这些,全部六个字段都有依据。它在五路并发运行下也保持住了。
边界取决于地形,而不是任务。Nova Act 在 eBay 和 booking.com 这类敌对消费者网站上会挣扎:受 bot 防护的电商网站,有 cookie wall、自定义变体组件和延迟加载内容。在这些网站上,多步骤操作会变慢并变得不稳定,繁重链路会超时。它在配合良好、结构化的网站上可靠:公共数据库、内部应用和构建良好的表单。它在敌对消费者网站上脆弱。保持操作数量少,使用 nova.page 验证每个字段,重试,并让 Bright Data 的数据层处理敌对、高容量场景。
地理路由实际改变了什么
没有本地浏览器能在没有相同底层路由基础设施的情况下做到这一点。我们在一个大型预订网站上运行了同一个酒店搜索,通过在 Bright Data username 中添加 -country-XX 路由到三个国家:
| 路由经过 | 货币 | 示例每晚价格 |
|---|---|---|
| 美国 | US$ | US$30, US$128, US$171 |
| 英国 | £ | £30, £167, £194 |
| 德国 | € | €40, €194, €225 |
货币会干净地切换,价格反映真实市场差异,而不是换算。我们用原始浏览器读取了这三个结果,因为地理位置是基础设施的工作,不是智能体的工作。智能体会提取它所指向的任何市场,和美国路由的 eBay 运行相同。这对于竞争性价格监控、票价聚合,或任何需要像本地客户那样查看的场景都很重要。
对一次运行来说,重要的是你从哪个 IP 出口,所以我们检查了每个路由会话。出口 IP 返回为真实消费者 ISP,而不是数据中心网段:一家主要美国有线电视提供商、一家英国宽带运营商、一个德国移动网络、一家日本运营商和一家巴西地区 ISP。
这就是看起来像本地和真正位于本地之间的区别。请求以该国真实住宅用户的身份抵达。因此,价格、库存和反 bot 处理都比被标记的数据中心网段更接近本地客户所看到的情况。
合规,90% 问题
这正是访问限制重要的地方,也就是 90% 问题本身:大多数 AI 组织表示这些限制正在限制其 AI 计划。在这里,Bright Data 充当护栏。指向一个航班元搜索网站时,智能体被拒绝:
Page.navigate: Requested URL (kayak.com/flights/...) is restricted in accordance
with robots.txt. Ask your account manager to get full access (brob)
几分钟前,一个原始本地浏览器毫无问题地抓取了同一个网站。Bright Data 拒绝了。拒绝是更有能力的行为,而不是更弱的行为。Bright Data 默认执行 robots.txt,并将敏感目标置于 Know Your Customer (KYC) 检查之后,这是企业法律团队可以批准的方法。
对于大多数企业目标,你没有问题。在我们的检查中,booking.com、Expedia、Hotels.com、Airbnb、eBay、Best Buy 和 Tripadvisor 都通过了。受限目标是一次客户经理对话,而不是绕过方法。基础设施处理访问侧合规,这样你的代码就不必处理。
成本和可靠性预算
采购审核人员会问两个问题:它有多可靠,成本是多少。
可靠性
可靠性有一个主要杠杆和一个硬上限。杠杆是视口修复。在我们设置之前,大约一半的运行因 InvalidScreenResolution 失败,而这个 bug 是大部分看起来像不稳定智能体的原因。
修复后,我们在真实网站而非 sandbox 上进行了测量。五路并发 eBay 读取返回 5/5,每个值都通过 nova.page 在实时 DOM 中确认,耗时 47s,而顺序执行约 198s,4.2×。每个会话都运行在一个新的 Bright Data IP 上,这避免了将请求集中在单个 IP 上。
这不是免费的线性扩展。我们把它推到 12 路并发,12 个中有 8 个干净返回。这是免费和按量付费层级的并发上限,而不是智能体崩了。真实企业级容量意味着提高区域的并发限制并为重试做预算,而不是假设五个会话可以免费扩展到五千个。
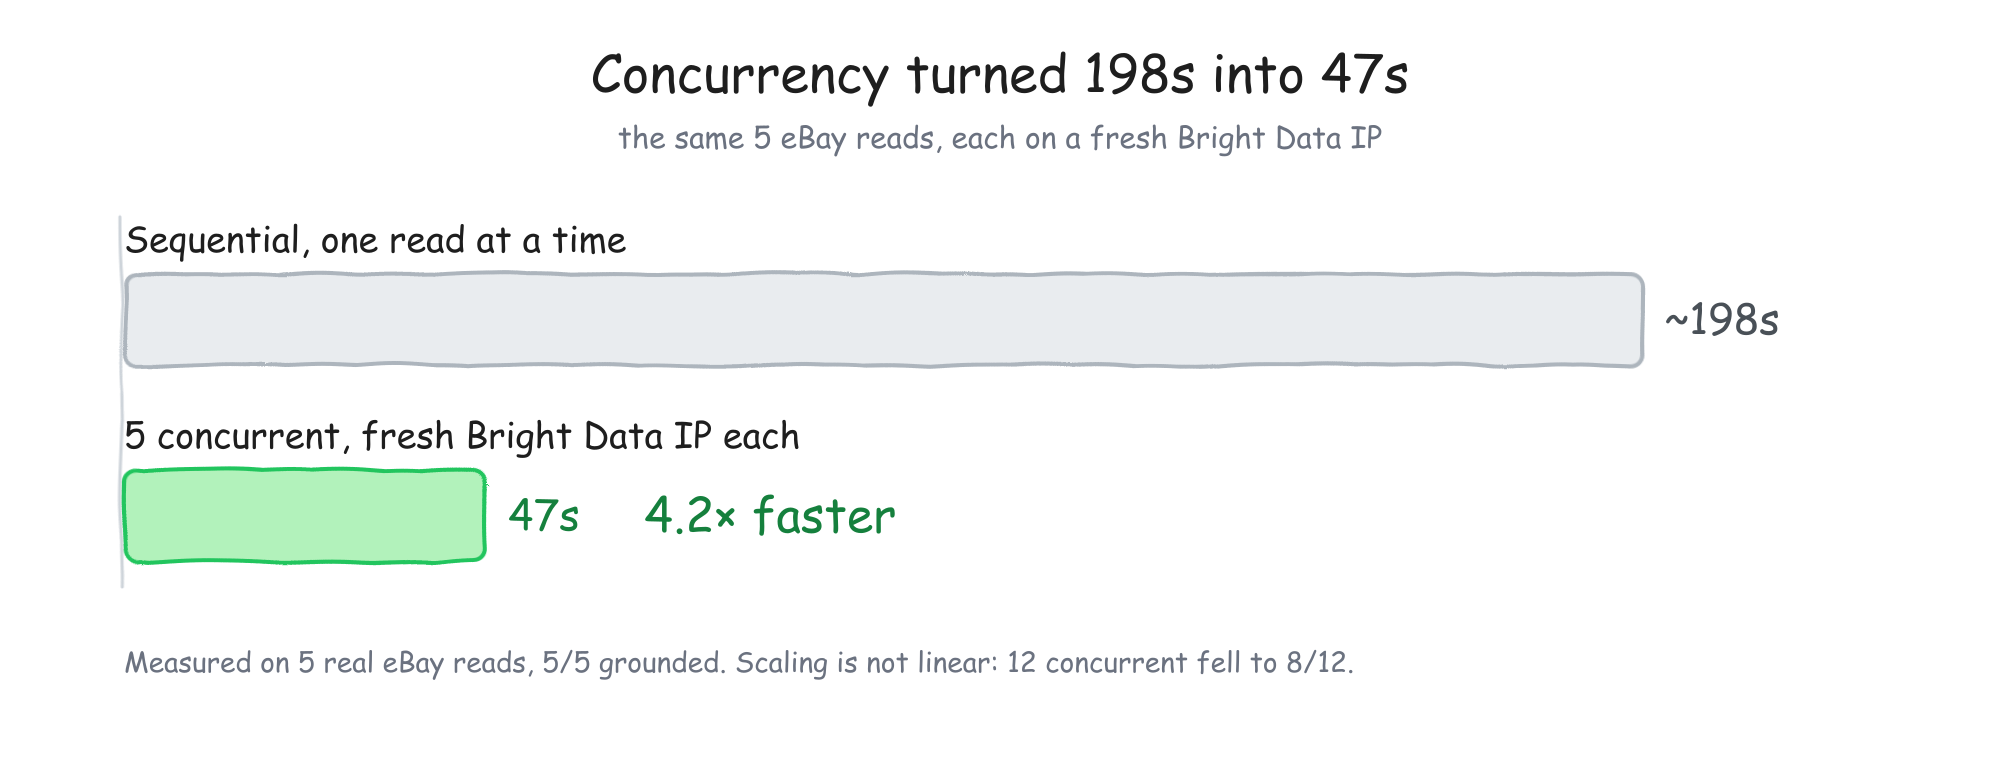
并发带来的收益是真实的,但不是线性的。超过方案的并发上限后,12 个并发读取中有 8 个干净返回。
一个轻量单操作(排序,然后读取)需要偶尔重试,剩余的失败是在会话启动时发生的瞬态 StartFailed。所以要把工作拆成小型幂等步骤,用重试包裹它们,预算约 1.2 到 1.5×,并用 nova.page 验证每个输出。
剩余限制是地形。在结构化一侧,它保持可靠。三次 Drugs@FDA 查询各自运行相同流程:填写、提交、点击展开、导航、提取。三次都返回 3/3,每个字段都有依据,尽管较慢,每次约 50 到 90 秒。在消费者侧,多步骤链路仍会变慢并超时。
可靠性数字一览:
| 场景 | 结果 | 含义 |
|---|---|---|
| 视口修复前 | 约一半运行失败 | InvalidScreenResolution,主要失败原因 |
| 修复后 5 路并发读取(eBay) | 5/5 有依据 | 47s vs 约 198s 顺序执行,4.2×,每会话新 IP |
| 推到 12 路并发(raw) | 8/12 | 按量付费并发上限,而不是智能体 |
| 轻量单操作(排序,然后读取) | 偶尔重试 | 未命中是可重试的 StartFailed |
| 多步骤 FDA 表单,3 种药品 | 3/3 有依据 | 配合良好的网站,但每次较慢,约 50,90s |
成本
带宽成本是可测量的,模型成本是开放问题。浏览器 API 按 GB 计费,按量付费约 $8/GB(此处所有价格截至 2026 年中期)。我们通过它测量了真实页面重量:
| 页面类型 | 重量 | 浏览器 API @ $8/GB |
|---|---|---|
| 重型消费者页面(eBay 搜索) | ~3.4 MB | ~$0.027/page → ~$27 / 1,000 pages |
| 轻量页面(sandbox product) | ~0.2 MB | ~$0.0016/page → ~$1.60 / 1,000 pages |
加上重试倍数,然后加上 Nova Act 的推理成本,该成本今天没有公开定价。免费层会计量你收集的量,生产运行通过 AWS,但没有公布价格。所以预算归结为两行。浏览器 API 带宽是已知、可预测的项目。智能体推理是你在扩展前必须向 AWS 确认的成本。
移动 3.4 MB 只为提取三个字段,也是为什么对批量工作来说,你根本不驱动浏览器。数据层按请求计费,而不是按 GB。搜索引擎 API 和网络解锁器大约每 1,000 次 $1.50,而通过浏览器处理 1,000 个重型页面约 $27。
何时使用智能体,何时使用数据层
Bright Data 提供 Web MCP 和网页爬虫工具 API,所以你不必为所有事情都驱动浏览器。分界线是决策复杂度:
- 固定、已知 schema 的拉取,例如 100,000 个 SKU 的价格和库存。不要使用智能体。网页爬虫工具 API 只返回记录,没有 3.4 MB 页面、没有推理成本,且瞬态失败少得多。它更便宜、更可靠。
- 抓取无法捕获的推理:多步骤导航、条件逻辑(例如满足你约束的最便宜可退款票价)、表单提交、网页应用 QA,或没有预置爬虫工具的陌生门户。这就是 Nova Act 和浏览器 API 值得其成本的地方。
规则是:如果你能把它表达为固定抓取或 API 调用,就那样做。在真实系统中,两者会组合。Nova Act 驱动决策流程,并将批量检索交给 Bright Data 的结构化 API。
数据层的实际使用
“对批量使用数据层”是常见建议。这里就是它,针对同一个 Bright Data 账户运行,三次调用,没有浏览器,没有智能体。
一次调用完成结构化搜索(搜索引擎 API),用于为 AI 提供依据的新鲜解析搜索结果,以 JSON 返回:
requests.post("https://api.brightdata.com/request",
    headers={"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"},
    json={"zone": "serp_api2", "format": "raw",   # gl/hl pin the locale so results are stable
          "url": "https://www.google.com/search?q=amazon+nova+act+sdk&brd_json=1&gl=us&hl=en"})
9 organic results → 1. github.com/aws/nova-act · 2. nova.amazon.com/act · 3. docs.aws.amazon.com/nova-act …任意 URL 转为干净的 LLM-ready markdown(网络解锁器),即我们的智能体通过填写表单到达的同一 FDA 药品记录,直接获取:
json={"zone": "web_unlocker", "format": "raw", "data_format": "markdown",
      "url": "https://www.accessdata.fda.gov/.../ApplNo=214836"}
→ 8.4 KB of clean markdown, one call, no browser, no CAPTCHA handling, no parsing.已知来源只获取结构化记录(网页爬虫工具 API),触发预置采集器并获取干净字段,绝不获取页面。我们为一家公司运行了 Crunchbase 抓取工具:
requests.post("https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_l1vijqt9jfj7olije",
    headers={"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"},
    json=[{"url": "https://www.crunchbase.com/organization/anthropic"}])   # -> snapshot_id, then poll
→ 89 structured fields (employees, HQ, CB rank, status, funding …),
ready in ~70s, no browser, no agent, no 3.4 MB page, no parsing.对比就是架构。这里智能体是正确工具,因为你必须执行操作才能到达数据。没有 URL 存在,所以它搜索表单并导航到申请 214836。一旦 URL 存在,或者你需要搜索结果或批量已知 schema 记录,就不要驱动浏览器。你调用数据层。它更确定、更快、更便宜,并且消耗更少的智能体可靠性预算。Nova Act 发现并执行操作。Bright Data 的数据层进行规模化检索。
智能体直接调用 Bright Data 的工具
到目前为止的集成是手动编排的。我们调用搜索引擎 API 和网络解锁器,然后把一个浏览器交给智能体。还有一种更紧密的集成。你把 Bright Data 的 Web MCP 服务器作为工具提供给 Nova Act,智能体自己决定何时搜索、抓取或发现。Nova Act 运行在 AWS 的 Strands 框架上,因此它直接接受 MCP 工具:
from strands.tools.mcp import MCPClient
from mcp import StdioServerParameters
from mcp.client.stdio import stdio_client

bd_mcp = MCPClient(lambda: stdio_client(StdioServerParameters(
    command="npx", args=["-y", "@brightdata/mcp"], env={"API_TOKEN": BRIGHTDATA_TOKEN})))

with bd_mcp:
    tools = bd_mcp.list_tools_sync()          # search_engine, scrape_as_markdown, discover, batch…
    with NovaAct(starting_page="https://example.com", tools=tools,
                 cdp_endpoint_url=endpoint, cdp_headers=headers) as nova:
        nova.act_get("Use the search_engine tool to find 'Amazon Nova Act SDK'; "
                     "return the top result's URL.", schema=Out.model_json_schema())
我们运行了它,智能体自己的 trace 显示了这一点。“The tool call was successful and returned information of the search. The top organic result is ‘https://github.com/aws/nova-act’…”,它返回了 {'top_result_url': 'https://github.com/aws/nova-act'}。智能体自己选择了 Bright Data 的 search_engine 工具,Bright Data 运行搜索,智能体使用结果。它只需要一次 act 调用,约 32s,没有抓取搜索页面,而浏览器智能体很可能无论如何都会在搜索页面上被阻止。
这就是同时使用两个工具与一个智能体自行调用另一个工具之间的区别。在这次运行中,智能体直接获得五个工具:search_engine、scrape_as_markdown、search_engine_batch、scrape_batch 和 discover。对于浏览器智能体最不擅长的工作,即搜索和批量获取,这是一条干净且合规的路径。
组合流水线,广度与深度
到目前为止,每个组件都可以独立存在。组合起来,它们会围绕一个主题构建有依据的结构化情报记录。你从开放网页获取广度,从由表单门控的权威来源获取深度。我们在 GLP-1 药物这一备受关注的制药类别上运行了它:
# 1. BREADTH  , Bright Data SERP API discovers authoritative sources   (no browser)
sources = serp_api("Ozempic semaglutide")[:3]
# 2. FETCH    , Bright Data Web Unlocker pulls the top source as markdown (no browser)
context = web_unlocker(sources[0])
# 3. DEPTH    , Nova Act fills the Drugs@FDA form for the authoritative record (agent)
fda     = nova_act_fda("semaglutide")        # verified against the live DOM
真实的端到端输出:
{
  "web_sources": ["ozempic.com", "mayoclinic.org/…semaglutide…", "accessdata.fda.gov/…/209637lbl.pdf"],
  "web_context_chars": 59270,
  "fda_authoritative": {"drug_name": "OZEMPIC", "active_ingredient": "SEMAGLUTIDE",
                        "application_number": "209637", "marketing_status": "Discontinued"},
  "fda_grounded": true
}
每一半都做了另一半做不到的事情。数据层通过两次 API 调用搜索开放网页,返回三个权威来源和 59 KB 干净的 LLM-ready 上下文,没有浏览器,也没有智能体。智能体去到数据层无法自行到达的地方。它填写 FDA 搜索表单,并导航到权威监管记录,申请 209637,该产品行状态为 Discontinued,这是位于没有 URL 的表单后面的数据。
两者还相互确认。数据层独立返回了同一申请编号的 FDA label 209637lbl.pdf,而这个编号也是智能体通过执行操作到达的。广度确认深度。
这次运行还显示了一个你需要为之规划的失败。智能体的 FDA 步骤在品牌名 “Ozempic” 上失败,ActAgentFailed 三次,而在活性成分 “semaglutide” 上成功。这就是地形带来的可靠性成本。这也是为什么你要用 fda_grounded: true 验证,并为重试做预算。
同一条流水线,不同行业
这不仅适用于制药,我们也验证了这一点。我们在另一个行业,即金融合规上运行了相同流水线。搜索引擎 API 找到了该公司的网页存在、其自有网站和一个金融数据 profile。智能体导航 FINRA 的 BrokerCheck(一个比 FDA 表单更难的 Angular 应用)到一家 broker-dealer 的权威监管记录:公司名称、CRD 编号、监管机构和披露数量。它在一次重试后有依据。
从制药到金融,同一流水线在除查询和 schema 外没有代码变更的情况下运行成功。它应该能以同样方式扩展到竞争性定价、市场研究和产品安全监控。数据层处理广度和规模,智能体处理门控深度,并且智能体字段会根据实时页面进行 grounding。
从一条记录到一个市场
它也可以从一条记录扩展到一个市场。我们在整个 GLP-1 药物市场上运行了相同流水线,并获得一个结构化竞争数据集。数据层处理广度,而智能体提供每种药品的权威 FDA 记录:
| 活性成分 | FDA 品牌 | App # | 状态 | 顶级来源(搜索引擎 API) |
|---|---|---|---|---|
| semaglutide | OZEMPIC | 209637 | Prescription | drugs.com |
| tirzepatide | MOUNJARO | 215866 | Prescription | ncbi.nlm.nih.gov |
| liraglutide | LIRAGLUTIDE | 212552 | Prescription | drugs.com |
市场运行甚至揭示了一个实时差异。申请 209637 在上面的单记录运行中读取为 Discontinued,在这个表中为 Prescription。一个 FDA 申请可以包含多个状态不同的产品记录,因此每次智能体读取都是一个 row 的快照。这正是为什么你要验证每次读取。
未编写脚本的 reCAPTCHA
有一个我们没有编写脚本的时刻自行证明了架构的价值。在三次查询中的两次,FDA 网站向智能体展示了一个 reCAPTCHA。
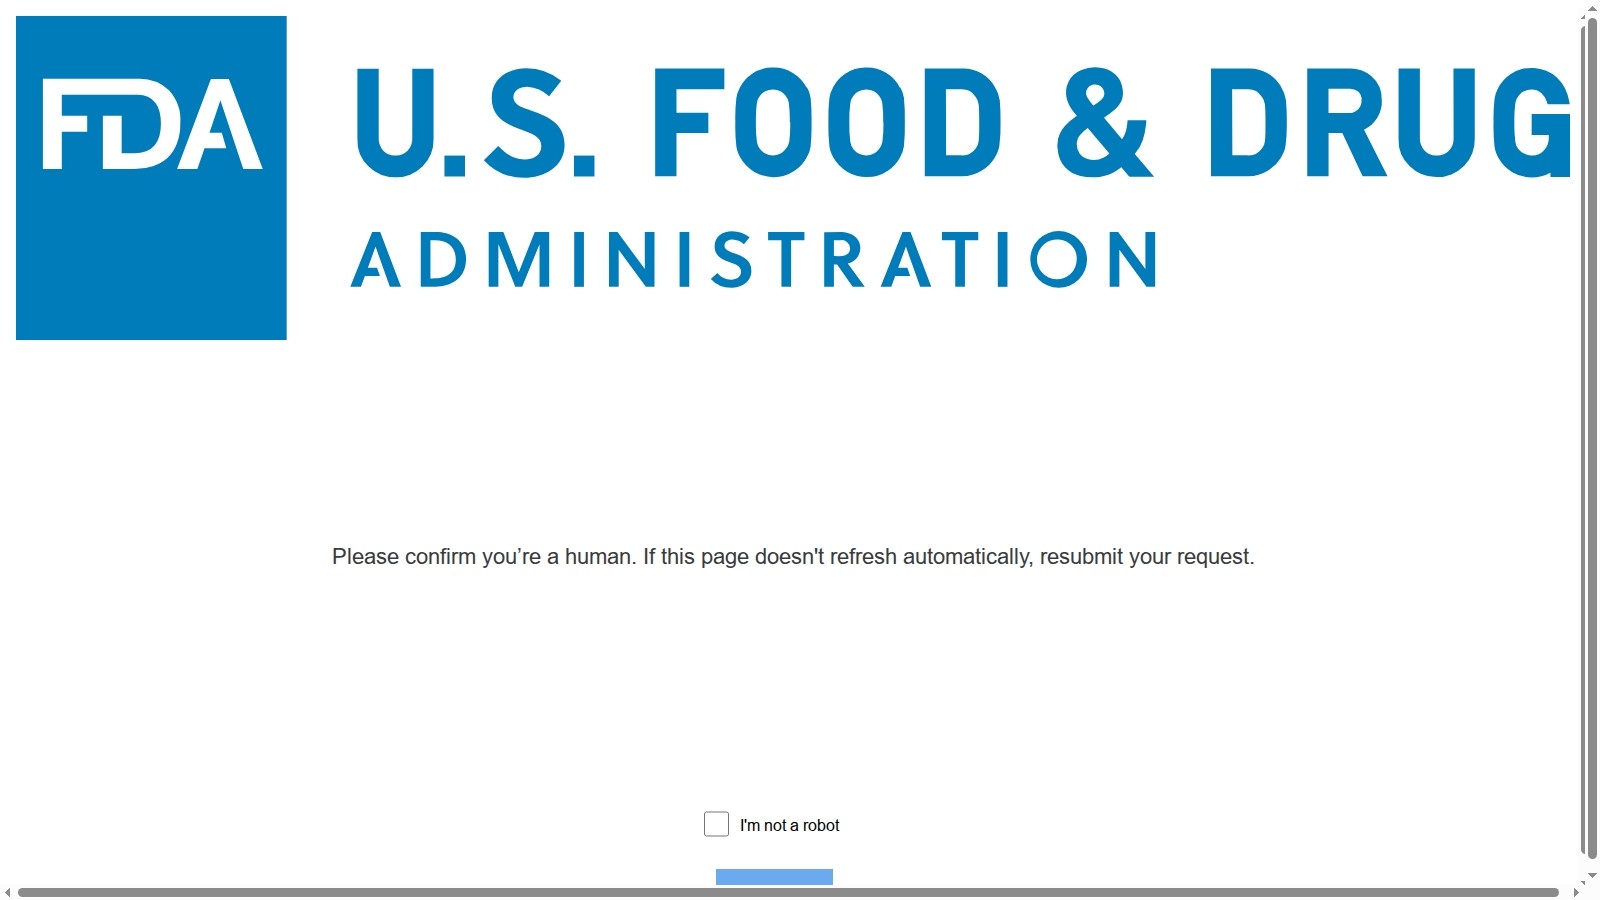
智能体在 Drugs@FDA 上遇到的真实 reCAPTCHA,运行中捕获。Nova Act 的护栏拒绝解决它。会话仍然到达了记录,因为它运行在 Bright Data 的浏览器 API 上。
Nova Act 的护栏拒绝把它当作一个要解决的谜题。从它的 trace 中逐字来看,“I should not impersonate a human, or mis-direct being one by solving captchas or any other challenge.” 这正是你希望自主智能体表现出的行为。
它仍然通过了,因为会话运行在 Bright Data 的浏览器 API 上。一个裸本地浏览器甚至无法加载 FDA 网站。该浏览器两次在 90 秒时超时,尽管在同一次运行中它可以正常访问 example.com。它既没有到达 CAPTCHA,也没有到达数据。Bright Data 会话到达了记录。
因此分工是真实且经过验证的。智能体不解决 CAPTCHA。它不会,也不应该。数据层无法导航表单。只有运行在 Bright Data 上的智能体能完成任务。
CAPTCHA 是间歇性的,后续一次 raw 运行没有遇到。这两次遇到 CAPTCHA 的智能体查询产生了约 1m50s 和 2m37s 的真实摩擦。数据集只有三行,但这一模式适用于整个市场。
这就是 Nova Act 与 Bright Data 的组合。任一工具单独都无法解决它。
限制
- Nova Act 仍处于早期。 截至 2026 年中期,它是一个研究预览版,仅支持英语,免费层会限制你的交互。它在每次运行时都会打印 “Amazon collects data on interactions on this version”。生产与 AWS 绑定,涉及 IAM、S3 和 Bedrock AgentCore。在基于它构建任何关键内容之前,请向 AWS 确认生产层级条款和定价。
- 智能体在弹窗繁多的消费者网站上很脆弱。 在 booking.com 上,
ActActuationError是智能体在与页面周旋,而不是 Bright Data 未能提供页面。优先使用直接结果 URL,明确关闭弹窗,依赖重试预算,或卸载到数据层。 - 合规有两面。 它是你想要的护栏,但受限目标意味着客户经理或 KYC 步骤,所以要规划提前量。并且 2026 年用于 AI 的抓取合法性仍有争议,标志性的公共数据裁决、欧盟 AI Act 和版权诉讼仍在进行中。公共数据并不自动意味着许可,所以要让你的法律团队参与。
- 检测是一场军备竞赛。 智能体指纹识别和按爬取付费不断升级。保持领先是持续工作,这正是为什么这一层是托管依赖,而不是一次性修复。
- 自主浏览器是一个攻击面。 页面可以携带 prompt-injection 来引导智能体,Nova Act 自己的文档也指出了这一点。限制它。使用 URL allowlist 和 blocklist,并让它远离不需要的页面。对于凭据和支付等敏感输入,通过带有
nova.page的直接 Playwright 驱动,而不是让模型输入它。
后续步骤
把 Nova Act 换成明年的智能体,拆分仍然适用:底层才是持久部分。因此,从对工作分类开始,而不是从工具开始。如果目标有稳定 URL 或预置采集器,把它发送到数据层并跳过浏览器。把 Nova Act 留给需要操作的内容:要填写的表单、多步骤路径、背后没有爬虫工具的门户。
对于你计划运行不止一次的任何内容,从第一次会话起就设置这些:
- 将区域的内联凭据移入
Authorization: Basicheader,并把你的 IP 添加到区域 allowlist。跳过任一项,你都会得到Invalid URL或空 body,原因在响应 header 中。 - 在连接页面上强制 1600×900 视口,并在运行开始前创建
logs_directory。 - 在同一会话中根据
nova.page为每个提取字段提供依据,并为重试预算 1.2 到 1.5×。
当一个区域跟不上时,在责怪智能体之前先提高其并发限制。将批量检索移到搜索引擎 API、网络解锁器或网页爬虫工具 API。浏览器 API 和 Web MCP 都带有免费层,因此你可以在承诺之前测试这种拆分。受限目标是一次客户经理对话,而不是绕过方法。
这里每个演示的可运行脚本都在配套仓库中。克隆它,将其指向你自己的目标,并看看你的工作实际需要拆分中的哪一半。
常见问题
什么是 Amazon Nova Act?
Amazon Nova Act 是一个 AWS SDK,用于在 Python 中构建浏览器智能体。你把工作流拆成小型、可靠的命令:act() 用于操作,act_get() 用于类型化提取。它通过 Playwright 驱动真实 Chromium。截至 2026 年中期,它是研究预览版。
Nova Act 是否适用于 Bright Data?
是的,通过 Chrome DevTools Protocol。Nova Act 通过 cdp_endpoint_url 和 cdp_headers 连接到 Bright Data 的浏览器 API。设置上的注意点是现代 Playwright 会拒绝内联凭据的 wss:// URL,因此要把凭据移入 Authorization: Basic header,并强制 1600×900 视口。
我可以在 Nova Act 中使用代理吗?
当你通过 CDP 连接时,不能使用原生 proxy 参数。Nova Act 会抛出 ValidationFailed,消息为 Cannot specify a proxy when connecting over CDP。改为通过 CDP 连接到 Bright Data 的浏览器 API,解锁、地理路由和 CAPTCHA 处理都发生在 Bright Data 一侧。
Nova Act 是否生产就绪?
截至 2026 年中期,它是研究预览版,仅支持英语,带有计量免费层。生产运行在 AWS 上,涉及 IAM、S3 和 Bedrock AgentCore。在我们的运行中,它在配合良好、结构化的网站上可靠,在敌对消费者网站上脆弱。在基于它构建之前,请向 AWS 确认生产条款和定价。
以这种方式运行浏览器智能体的成本是多少?
Bright Data 的浏览器 API 按量付费约 $8/GB(2026 年中期)。一个重型页面移动约 3.4 MB:重试前大约每 1,000 页 $27。在此基础上预算 1.2 到 1.5×。轻量页面接近每 1,000 页 $1.60。Nova Act 的推理没有公开定价,因此对于批量工作,请使用数据层,而不是浏览器。
为什么不使用我自己的 headless 浏览器和代理?
测得的失败模式只是答案的一半。驱动浏览器很重,在多步骤执行上脆弱,并且不确定。但更难自己运行的另一半是地理位置、合规和规模:一场永无止境的军备竞赛。基础设施层会运行它,这样你的工程团队就不必运行。
什么时候应该使用智能体,而不是数据层?
如果工作是固定、已知 schema 的拉取,请使用网页爬虫工具 API,它会返回记录,没有页面,也没有推理成本。如果它需要抓取无法捕获的推理(多步骤导航、表单提交、条件逻辑),请使用智能体。在真实系统中,两者会组合。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。