2026 年 7 月,Together AI 和 Y Combinator 推出了首个专用 YC GPU 集群。YC 创始人现在可以在数周内获得可观的算力。过去那种两年期合同不再是唯一途径。
假设你在一家新创企业负责 AI。你正在为物理 AI、视频或搜索训练一个基础模型。这些模型需要大量 FLOPs 和大量训练数据。那则公告应该让你同时产生两种感受。松一口气,因为你最困难的采购问题刚刚缓解。不安,因为它对其他所有人也同样缓解了。
这就是整个周期的模式。你争取的每一种投入,正在以同样条件向你的竞争对手开放。这迫使你面对董事会一直在问的问题。你的护城河到底是什么?
先划掉那些不是的东西
你的代码不是你的护城河。智能体式编码终结了这场争论。你的训练基础设施、服务栈和评测框架都可以重建。一个有能力的团队借助编码智能体,可以在数周内重建它们。不完美,但足够接近。
你的架构不是你的护城河。架构会被发表、泄露,或从行为中被逆向工程。DeepSeek 表明,快速跟随者可以把多年的领先压缩到数月。无论你今天偏好的注意力变体或状态空间技巧是什么,距离变成所有人的东西都只差一篇博客文章。
你的 GPU 本身也不是你的护城河。算力稀缺,但正变得可以采购。Together 和 YC 的交易就是证明:卖方众多,切换成本下降,合同条款正朝着灵活性竞速。算力是一场你不能输的竞赛。它不是一场你能赢的竞赛。
你的数据本身也不是你的护城河。如果你的计划是使用和其他人一样的授权数据集以及同样的 API,那你就有麻烦了。你正在以高昂成本预训练和其他人一样的模型。那么还剩下什么?
算力 + 数据 + 配方 = 公司
这是我会带进你下一次董事会会议的框架。
2026 年,这个等式很简单:算力 + 数据 + 配方 = 公司。其他一切,代码、基础设施和应用层,智能体都可以重建。你的权重是三者相遇并实体化的地方。那就是护城河。
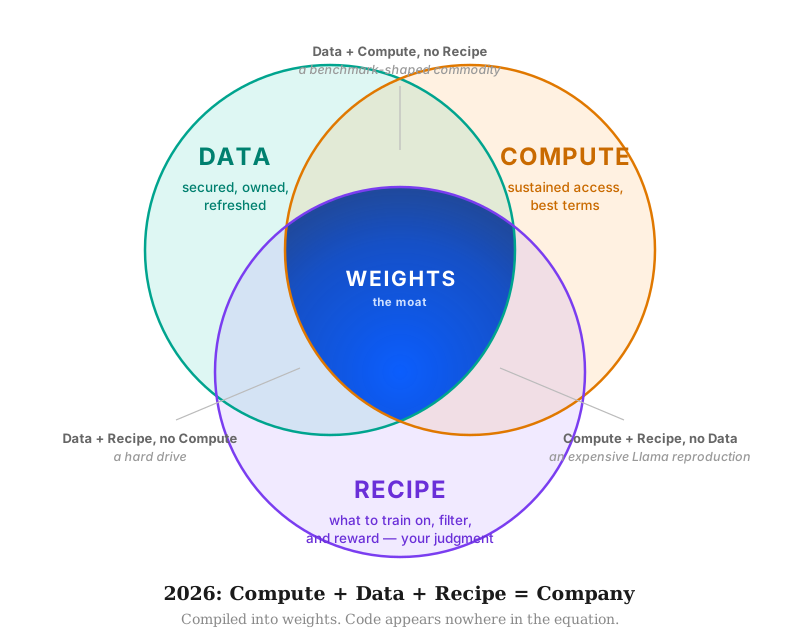
护城河不是任何单一投入,因为投入可以买到。它是交集,被编译进一个智能体无法重新实现的产物。
权重是你公司中智能体式编码无法复制的唯一产物。不是因为它们是秘密。而是因为它们是决策的压缩记录。每一次过滤、每一次课程选择、每一个 RL 环境,都被烘焙进参数里。你的领域专家说 40% 的语料是垃圾,因此决定丢弃它们,这样的每一次判断也在其中。两个团队即使拥有相同的集群和相同的原始数据,最终仍会发布不同的模型,因为配方就是模型。
这就是为什么交集比任何单个圆圈都更重要。
- 没有算力的数据只是一个硬盘。
- 没有差异化数据的算力,是以极其昂贵的方式复现 Llama。
- 没有判断力的数据和算力,会让你烧掉 A 轮资金,产出一个形似基准测试的商品。
权重位于三者重叠之处。你栈中的其他一切都可以替换。那个产物不行。
你同时身处两场竞赛
每个人都认识到算力竞赛,因为它有一个响亮的计分牌。集群公告、巨额融资轮和两年期合同。现在还有 YC 式合作来走捷径。数据竞赛正在并行进行,就在此刻,遵循同样的物理规律和同样的紧迫性。供应稀缺、访问权集中,早期行动者锁定条款。
信号无处不在。Reddit 与 Google 签署了一项每年 6000 万美元的授权协议。一家推理云公司支付2.75 亿美元收购一个网络访问层。超大规模云厂商现在把数据访问作为第一方基础设施提供。这与算力是同一种头条模式。只是它刊登在更安静的版面上。
数据竞赛有一个关键区别。对于你尚未收集的数据,没有现货市场。错过一个算力窗口,你等一个季度。错过数据窗口,你所需要的语料根本就从未被收集。
那么,那种规模的数据实际上存在于哪里?不在学术快照中,因为它们是冻结的。不在授权目录中,因为它们是狭窄的孤岛,一次只覆盖一个领域。不在 Common Crawl 中,因为它已经被耗尽,而且从来就不包含视频。开放网络是现存最大的训练数据来源。文本、图像、PDF,最重要的是视频,每日刷新,覆盖每种语言、每个领域。
但网络不会自动交出自己。在 PB 级规模上,采集是一种工业能力。机器人墙、速率限制、渲染、新鲜度,以及你的法律团队可以捍卫的来源证明。开源抓取技术栈的成功率大约止步于 60% 到 75%,并且会在运行中途崩溃。这就是为什么如此多资金充足的实验室最终让研究人员看管爬虫,而不是训练模型。
正如你不会自己制造 GPU 一样,自己收集网络就是在你的公司内部再建一家会社。在这里我会直接说明我的立场,因为这正是我们在 Bright Data 所做的事情。我们每周收集约 1 PB 的网络数据。这建立在一个 90 PB 的网络归档之上。它包含横跨 3.2 亿个域名的 6300 亿个页面。我们以 99.99% 的正常运行时间运行,并拥有已经在法庭上经受检验的合规性。据我所知,没有其他人以一次前沿训练运行所需的规模运营网络采集。
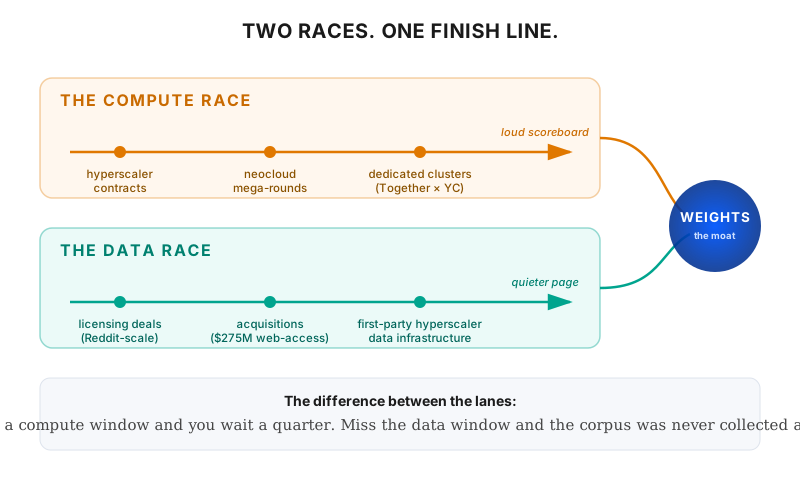
同样的物理规律,同样的紧迫性,并行进行。供应稀缺、访问权集中,早期行动者锁定条款。算力竞赛只是有更响亮的计分牌。
把这个类比一路画到底。及早 확보算力是基本要求。及早 확보网络规模的数据供应是相同的动作,发生在相同的时刻。同样的市场动态,正在此刻,在较少人关注的赛道中上演。
这对你如何花这笔融资意味着什么
1. 把算力当作竞赛,把数据当作资产。 算力要以你能获得的最佳条件租用。市场正朝着有利于你的方向移动,所以顺势而为。数据则要拥有:已 확보、已版本化、已刷新,并且不同于竞争对手能够获得的东西。对大多数团队而言,这意味着越过已经耗尽的公共语料。研究人员现在预测,高质量公共文本将在2026 年至 2032 年之间被用尽。如果你在所有人都能下载的东西上训练,你就已经选择了竞争对手的模型。
2. 如果你在物理 AI 或视频领域,这一点加倍成立。 你的语料从来不在 Common Crawl 里。世界模型和 VLA 依赖视频,自我中心、任务丰富且多样。赢得那场竞赛的实验室,是那些现在就在工业化其采集的实验室,在类别标准化之前。你的数据管道不是支撑性基础设施。它是产品决策。
3. 把稀缺的高级人才放在配方上,而不是管道工程上。 智能体可以编写你的数据加载器。它们无法决定机器人需要观看什么才能学会叠衣服。它们无法决定搜索模型必须看到什么,才能在你的垂直领域击败 Google。那种判断力,第三个圆圈,正是你的研究人员不可替代之处。相应地配置人员。
4. 向你的董事会直白说明。 我们的护城河是我们的权重:竞争对手缺乏的数据供应、我们自己的配方,以及我们及早 확보的算力。这是一句经得起尽职调查的话。我们有优秀的工程师,这句话已经不再是。
令人不安的时钟
Together 和 YC 的交易还告诉你另一件事。投入正在快速集中。算力正被锁定在集群和合作关系中。数据正被锁定在授权和收购中。你在 2026 年能够构建的交集,比 2027 年可用的交集更大。对于后来者来说,圆圈正在缩小。
算力 + 数据 + 配方 = 公司。 两场竞赛正在并行进行。你只有在两场中都完成,才会被算作完赛者。