您将通过本文学到以下知识:
- HTTPX 库简介及其功能
- 通过指南掌握使用 HTTPX 进行网页抓取的具体操作
- 用于网页抓取的高级 HTTPX 功能
- 比较 HTTPX 与 Requests在自动请求方面的差异
现在就来一探究竟吧!
什么是 HTTPX?
HTTPX 是一款基于 retryablehttp 库构建的 Python 3 HTTP 客户端,功能非常齐全。即使在多线程情况下,其也能确保获得可靠的结果。HTTPX 提供同步和异步 API,支持 HTTP/1.1 和 HTTP/2 协议。
⚙️ 功能
- 简单和模块化的代码库,易于贡献代码。
- 快速且完全可配置的参数标志,支持探测多个元素。
- 支持多种基于 HTTP 的探测方法。
- 默认情况下,可智能自动地从 HTTPS 回退到 HTTP。
- 接受主机、URL 和 CIDR 作为输入。
- 支持代理、自定义 HTTP 标头、自定义超时、基本身份验证等。
👍 优点
- 可通过
httpx[cli]命令行直接使用。 - 功能丰富,例如支持 HTTP/2、提供异步 API 等。
- 该项目仍处于积极开发中……
👎 缺点
- ……更新频繁,可能会在新版本中引入破坏性更改。
- 不如
Requests库受欢迎。
使用 HTTPX 进行抓取:分步指南
HTTPX 是可用于获取网页原始 HTML 内容的 HTTP 客户端。不过,在获取内容后,您还需使用 BeautifulSoup 之类的 HTML 解析器,以解析 HTML 内容并提取相关数据。
事实上,HTTPX 并非普通的 HTTP 客户端,而是用于网页抓取的最佳 Python HTTP 客户端之一。
请按照本教程进行操作,学习如何使用 HTTPX 和 BeautifulSoup 进行网页抓取!
警告:虽然人们仅在抓取流程的早期阶段使用 HTTPX,但本教程将带您了解整个工作流程。如您想要了解更高级的 HTTPX 抓取技巧,可直接跳至步骤 3 后的内容。
步骤 #1:项目设置
在开始之前,请确保您的电脑已安装 Python 3 或更高版本。如未安装,请先从官方网站下载软件,并按照说明进行安装。
现在,请使用下方命令为您的 HTTPX 抓取项目创建目录:
mkdir httpx-scraper
导航至该目录,并在其中初始化虚拟环境:
cd httpx-scraper
python -m venv env
在您喜欢的 Python IDE 中打开项目文件夹。带 Python 扩展的 Visual Studio Code 或 PyCharm Community Edition 都是不错的选择。
接着,在项目文件夹中创建 scraper.py 文件。scraper.py 目前仍是空的 Python 脚本,但其很快就会包含抓取逻辑。
在您的 IDE 终端中,激活虚拟环境。如使用的是 Linux 或 macOS 系统,则运行以下命令:
./env/bin/activate如在 Windows 系统上,则运行下方命令:
env/Scripts/activate太棒了!您现在已完成项目设置。
步骤 #2:安装抓取库
在已激活的虚拟环境中,使用下方命令安装 HTTPX 和 BeautifulSoup:
pip install httpx beautifulsoup4这可以将 httpx 和 beautifulsoup4 都添加至项目的依赖项中。
将它们都导入至您的 scraper.py 脚本:
import httpx
from bs4 import BeautifulSoup
非常好!现在可以进入抓取工作流程中的下一步。
步骤 #3:获取目标网页的 HTML
在本示例中,目标网页为 “Quotes to Scrape” 网站:
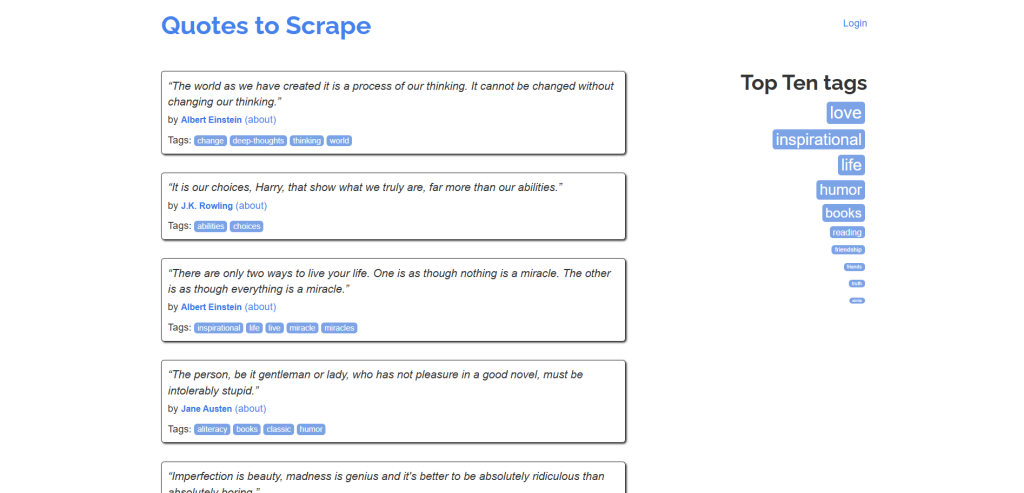
使用 HTTPX 的 get() 方法获取该网站主页的 HTML 内容:
# Make an HTTP GET request to the target page
response = httpx.get("http://quotes.toscrape.com")
HTTPX 会在后台向服务器发出 HTTP GET 请求,服务器将予以响应,返回目标网页的 HTML 内容。您可通过 response.text 属性访问 HTML 内容:
html = response.text
print(html)
这将打印网页的原始 HTML 内容:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <title>Quotes to Scrape</title>
    <link rel="stylesheet" href="/static/bootstrap.min.css">
    <link rel="stylesheet" href="/static/main.css">
</head>
<body>
    <!-- omitted for brevity... -->
</body>
</html>
很好!现在可以解析这些内容并提取所需数据了。
步骤 #4:解析 HTML 内容
将 HTML 内容传递给 BeautifulSoup 构造函数,以进行解析:
# Parse the HTML content using
BeautifulSoup soup = BeautifulSoup(html, "html.parser")
html.parser 是用于解析内容的标准 Python HTML 解析器。
现在,soup 变量中保存了已解析的 HTML 内容,并提供提取所需数据的方法。
HTTPX 已完成 HTML 内容获取工作,您现在可使用 BeautifulSoup 进行传统的数据解析操作。如想了解更多信息,请参阅有关使用 BeautifulSoup 进行网页抓取的教程。
步骤 #5:从中抓取数据
您可使用下方代码从目标网页抓取相关引言 (quotes) 数据:
# Where to store the scraped data
quotes = []

# Extract all quotes from the page
quote_elements = soup.find_all("div", class_="quote")

# Loop through quotes and extract text, author, and tags
for quote_element in quote_elements:
    text = quote_element.find("span", class_="text").get_text().get_text().replace("“", "").replace("”", "")
    author = quote_element.find("small", class_="author")
    tags = [tag.get_text() for tag in quote_element.find_all("a", class_="tag")]

    # Store the scraped data
    quotes.append({
        "text": text,
        "author": author,
        "tags": tags
    })
此代码片段定义了一个名为 quotes 的列表,用于存储抓取的数据。然后,它会选择并遍历所有的引言 HTML 元素,以提取引言文本、作者和标签。每一条被提取出来的引言都会以字典形式存储在 quotes 列表,从而让数据变得有序、结构化,便于后续使用或导出。
很好!现在已实现抓取逻辑。
步骤 #6:导出抓取的数据
使用以下逻辑将抓取的数据导出为 CSV 文件:
# Specify the file name for export
with open("quotes.csv", mode="w", newline="", encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["text", "author", "tags"])

    # Write the header row
    writer.writeheader()

    # Write the scraped quotes data
    writer.writerows(quotes)
通过此代码片段,系统会以写入模式打开名为 quotes.csv 的文件,定义列标头(text、author、tags),并将标头写入文件,然后将 quotes 列表中的每个字典写入 CSV 文件。其中的 csv.DictWriter 用于处理格式问题,从而让您可以轻松存储结构化数据。
千万别忘记从 Python 标准库中导入 csv:
import csv步骤 #7:整合所有代码
您的最终 HTTPX 网页抓取脚本将包含以下代码:
import httpx
from bs4 import BeautifulSoup
import csv

# Make an HTTP GET request to the target page
response = httpx.get("http://quotes.toscrape.com")

# Access the HTML of the target page
html = response.text

# Parse the HTML content using BeautifulSoup
soup = BeautifulSoup(html, "html.parser")

# Where to store the scraped data
quotes = []

# Extract all quotes from the page
quote_elements = soup.find_all("div", class_="quote")

# Loop through quotes and extract text, author, and tags
for quote_element in quote_elements:
    text = quote_element.find("span", class_="text").get_text().replace("“", "").replace("”", "")
    author = quote_element.find("small", class_="author").get_text()
    tags = [tag.get_text() for tag in quote_element.find_all("a", class_="tag")]

    # Store the scraped data
    quotes.append({
        "text": text,
        "author": author,
        "tags": tags
    })

# Specify the file name for export
with open("quotes.csv", mode="w", newline="", encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["text", "author", "tags"])

    # Write the header row
    writer.writeheader()

    # Write the scraped quotes data
    writer.writerows(quotes)
使用以下命令执行脚本:
python scraper.py或者,如使用的是 Linux/macOS 系统,则通过下方命令执行脚本:
python3 scraper.py您的项目根文件夹中将出现 quotes.csv 文件。打开此文件后,您会看到:
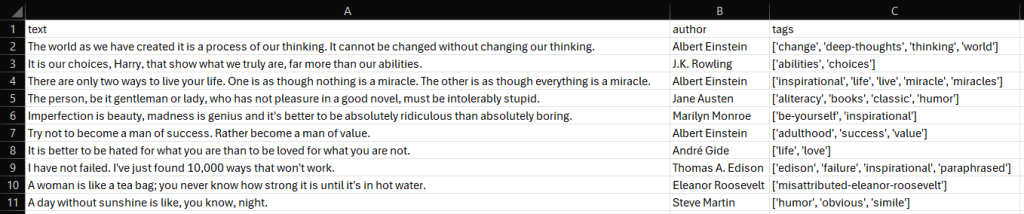
大功告成!您已了解如何使用 HTTPX 和 BeautifulSoup 进行网页抓取。
HTTPX 网页抓取高级功能和技巧
您现在已知道使用 HTTPX 进行网页抓取的基本操作,现在可以学习在更复杂的使用场景中使用 HTTPX 的技巧了。
在下方示例中,目标网站是 HTTPBin.io /anything 端点。这是一个特殊的 API,可返回调用者发送的 IP 地址、标头和其他信息。
熟练掌握 HTTPX 网页抓取技巧!
设置自定义标头
HTTPX 允许通过 headers 实参来指定自定义标头:
import httpx

# Custom headers for the request
headers = {
    "accept": "application/json",
    "accept-language": "en-US,en;q=0.9,fr-FR;q=0.8,fr;q=0.7,es-US;q=0.6,es;q=0.5,it-IT;q=0.4,it;q=0.3"
}

# Make a GET request with custom headers
response = httpx.get("https://httpbin.io/anything", headers=headers)
# Handle the response...
设置自定义用户代理
User-Agent 是最重要的,用于网页抓取的 HTTP 标头之一。默认情况下,HTTPX 使用以下 User-Agent:
python-httpx/<VERSION>但目标网站很容易通过该值发现您的请求是自动发出的,从而可能将其屏蔽。
如下所示,为防止出现这种情况,您可对 User-Agent 进行自定义设置,以模拟真实的浏览器:
import httpx

# Define a custom User-Agent
headers = {
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/132.0.0.0 Safari/537.36"
}

# Make a GET request with the custom User-Agent
response = httpx.get("https://httpbin.io/anything", headers=headers)
# Handle the response...设置 Cookie
与 HTTP 标头一样,您可使用 cookies 实参在 HTTPX 中设置 Cookie:
import httpx

# Define cookies as a dictionary
cookies = {
    "session_id": "3126hdsab161hdabg47adgb",
    "user_preferences": "dark_mode=true"
}

# Make a GET request with custom cookies
response = httpx.get("https://httpbin.io/anything", cookies=cookies)
# Handle the response...
这样,您就可以将网页抓取请求所需的会话数据都包含其中。
代理集成
您可通过代理路由 HTTPX 请求,以保护您的身份,防止在进行网页抓取时 IP 被封禁。使用 proxies 实参即可做到这一点:
import httpx

# Replace with the URL of your proxy server
proxy = "<YOUR_PROXY_URL>"

# Make a GET request through a proxy server
response = httpx.get("https://httpbin.io/anything", proxy=proxy)
# Handle the response...
如想了解详情,请参阅有关如何通过代理使用 HTTPX 的指南。
错误处理
默认情况下,HTTPX 仅在出现连接或网络问题时才会报错。如需要对状态码为 4xx 和 5xx 的 HTTP 异常响应报错,请使用 raise_for_status() 方法,具体代码如下所示:
import httpx

try:
    response = httpx.get("https://httpbin.io/anything")
    # Raise an exception for 4xx and 5xx responses
    response.raise_for_status()
    # Handle the response...
except httpx.HTTPStatusError as e:
    # Handle HTTP status errors
    print(f"HTTP error occurred: {e}")
except httpx.RequestError as e:
    # Handle connection or network errors
    print(f"Request error occurred: {e}")
会话处理
使用 HTTPX 中的顶层 API 时,HTTPX 会为每个请求建立一个新连接。换言之,TCP 连接不会被复用。随着向主机发出的请求数量增加,该方法会变得低效。
而使用 httpx.Client 实例则可实现 HTTP 连接池功能,即向同一主机发出的多个请求可以复用现有的 TCP 连接,无需为每个请求创建新的连接。
与顶层 API 相比,使用 Client 有如下好处:
- 减少请求延迟(避免重复握手)
- 降低 CPU 占用率,减少往返次数
- 减轻网络拥塞
此外,Client 实例支持会话处理,提供顶层 API 所不具备的功能,例如:
- 实现跨请求的 Cookie 持久化。
- 将配置应用于所有发出的请求。
- 通过 HTTP 代理发送请求。
如要在 HTTPX 中使用 Client,则建议使用上下文管理器(with 语句):
import httpx

with httpx.Client() as client:
    # Make an HTTP request using the client
    response = client.get("https://httpbin.io/anything")

    # Extract the JSON response data and print it
    response_data = response.json()
    print(response_data)
或者,您可手动管理客户端,使用 client.close() 显式关闭连接池:
import httpx

client = httpx.Client()
try:
    # Make an HTTP request using the client
    response = client.get("https://httpbin.io/anything")

    # Extract the JSON response data and print it
    response_data = response.json()
    print(response_data)
except:
  # Handle the error...
  pass
finally:
  # Close the client connections and release resources
  client.close()
注意:如您熟悉 Requests 库,则 httpx.Client() 的用途与 requests.Session() 类似。
异步 API
默认情况下,HTTPX 提供标准的同步 API。同时,它还可在有需要时提供异步客户端。如您在网页抓取时使用 asyncio,则使用异步客户端是高效发送 HTTP 请求的重要保障。
异步编程是一种并发模式,其效率明显高于多线程。它能显著提升性能,并支持 WebSockets 之类的长时间网络连接。这使得它成为加快网页抓取进程的一大重要因素。
要在 HTTPX 中发送异步请求,您需要使用 AsyncClient。如下所示,您需初始化该客户端并使用它来发送 GET 请求:
import httpx
import asyncio

async def fetch_data():
    async with httpx.AsyncClient() as client:
        # Make an async HTTP request
        response = await client.get("https://httpbin.io/anything")

        # Extract the JSON response data and print it
        response_data = response.json()
        print(response_data)

# Run the async function
asyncio.run(fetch_data())
with 语句可确保客户端在代码块结束后自动关闭。或者,如果您想手动管理客户端,则可使用 await client.close() 显示关闭它。
请记住,在使用 AsyncClient 时,所有 HTTPX 请求方法(get()、post() 等)都是异步的。因此,在调用这些方法获取响应前,您必须添加 await。
重试失败的请求
如在网页抓取过程中出现网络不稳定问题,则可能导致连接失败或超时。HTTPX 通过 HTTPTransport 接口简化了此类问题的处理。当出现 httpx.ConnectError 或 httpx.ConnectTimeout 错误时,该机制会重试相关请求。
以下示例演示了配置 Transport 以重试请求(最多 3 次)的代码操作:
import httpx

# Configure transport with retry capability on connection errors or timeouts
transport = httpx.HTTPTransport(retries=3)

# Use the transport with an HTTPX client
with httpx.Client(transport=transport) as client:
    # Make a GET request
    response = client.get("https://httpbin.io/anything")
    # Handle the response...
注意,只有与连接相关的错误才会触发重试。要处理读取/写入错误或特定的 HTTP 状态码错误,则需使用 tenacity 等库实现自定义重试逻辑。
HTTPX 与 Requests 在网页抓取方面的异同之处
以下汇总表对比了 HTTPX 和 Requests 在网页抓取方面的异同之处:
| 功能 | HTTPX | Requests |
|---|---|---|
| GitHub 星数 | 8000 | 52400 |
| 异步支持 | ✔️ | ❌ |
| 连接池 | ✔️ | ✔️ |
| HTTP/2 支持 | ✔️ | ❌ |
| 自定义用户代理 | ✔️ | ✔️ |
| 代理支持 | ✔️ | ✔️ |
| Cookie 处理 | ✔️ | ✔️ |
| 超时 | 自定义连接和读取 | 自定义连接和读取 |
| 重试机制 | 通过 Transport 提供 | 通过 HTTPAdapter 提供 |
| 性能 | 高 | 中等 |
| 社区支持和受欢迎程度 | 人气日益高涨 | 广受欢迎 |
结语
在本文中,您学习了使用 HTTPX 库进行网页抓取的具体操作。您了解了它的基本含义、功能和优势。在收集在线数据时,HTTPX 是快速可靠的 HTTP 请求发送工具。
问题在于自动发送的 HTTP 请求会泄露您的公共 IP 地址,暴露您的身份和位置,进而威胁您的隐私。因此,您最好使用代理服务器来隐藏 IP 地址,这是加强安全并保护您的隐私的最有效方法之一。
Bright Data 掌控着全球最出色的代理服务器,为财富 500 强企业和 20,000 多家客户提供服务。其代理网络涵盖不同类型的代理:
立即创建免费的 Bright Data 账户,测试我们的抓取解决方案和代理!


技术写作
 5.5 years experience
Antonello是一名软件工程师,但他更喜欢称自己为技术传教士。通过写作传播知识是他的使命。