搜索 API 让你的智能体能够快速访问网络数据。但对于生产工作负载来说,如果背后的数据陈旧或不完整,仅仅快速访问还不够。你的智能体会根据获取到的内容进行报告。
假设某个竞争对手一夜之间更改了定价页面。你的智能体虽然检测到了该页面,却返回了数小时前的缓存摘要。它无法读取实际页面内容,无法与历史定价进行比较,也无法找到那些能揭示此次变动背后策略的非显而易见的信息来源。
摘要:
搜索 API 适用于原型开发。生产环境中的 AI 智能体会遇到 5 个结构性限制:时效性、召回率、完整内容、吞吐量和历史基准。知识供应链可以解决这些问题。
- 搜索 API 返回的是缓存摘要。生产环境中的智能体需要按意图排序并包含完整网页内容的结果。
- Google 正在限制基于 SERP 的数据访问。单一的 SERP 路径就是单点故障。
- Bright Data 搜索引擎 API、网络解锁器和数据集构成了一个三层知识供应链。
- 通过可运行的代码和真实输出对比这两种架构。文末附有决策框架和参考表。
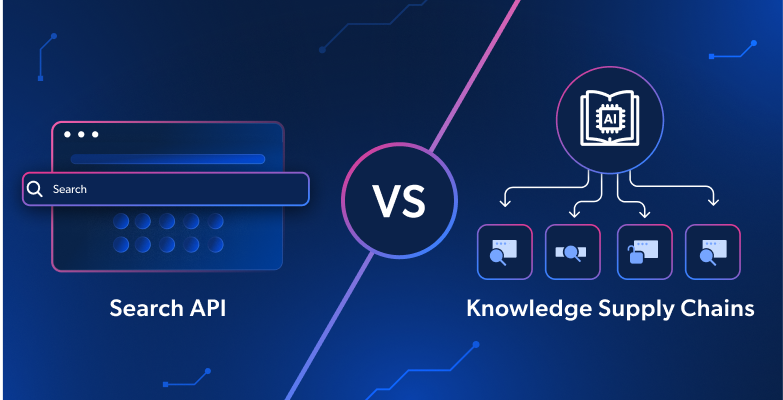
搜索 API 与知识供应链:关键定义
搜索 API 这一类别之所以出现,是因为仅靠训练数据集并不足够。聊天机器人和智能体需要实时访问网络数据。获取实时数据只是第一个问题。更难的是,如何确保数据具备足够的深度、时效性和可验证性,从而支持决策,而不仅仅是回答问题。
两个术语决定了基础设施的选择。以下是它们在实际应用中的含义。
搜索 API:
搜索 API 是一种接受查询并返回按相关性排序的 URL 列表和/或页面摘要的端点,其数据来源于现有搜索索引。它针对低延迟和易于集成进行了优化。输出结果是当前已编入索引内容的快照,不一定能反映查询时网络内容的实时状态。
知识供应链:
知识供应链是 AI 智能体用来持续获取、验证网页数据并为其补充上下文的端到端基础设施。它结合了实时发现、完整页面内容提取、生产级吞吐能力和历史数据集。每一层解决不同的问题:时效性、覆盖范围、可验证性、并行处理和评估。它不是一次 API 调用,而是一套架构。
这两种方法在三个方面有所不同:
| 搜索 API | 知识供应链 | |
|---|---|---|
| 模型 | 基于快照的单次调用 | 多层、基于流水线 |
| 专为以下场景优化 | 速度 | 证据质量 |
| 输出 | 链接排名与摘要 | 经过验证的内容 + 上下文 + 历史记录 |
这种区别至关重要,因为正如 TinyFish CEO Sudheesh Nair 所说:“搜索是针对人类局限性而设计的一种捷径”。人类需要 10 个蓝色链接,因为他们只能处理数量有限的结果。智能体不需要将互联网压缩成排名前 10 的列表,而是需要获取这些链接背后的内容,并对其进行验证和提供相关背景信息。
再补充一个定义:市场感知型智能体。这类智能体会做出影响营收、风险或运营的决策,例如定价情报、竞争应对、监管监控和供应链追踪。它们需要可验证的真实数据,而不是看似合理的摘要。
目前,只有 11% 的组织已在生产环境中部署自主 AI 智能体(Deloitte 2026 年技术趋势)。然而,在使用公共网络数据构建 AI 的组织中,已有 97% 依赖实时网络基础设施(2026 年 AI 数据报告)。两者之间的差距正是问题所在。当前做出的基础设施决策,将决定哪些智能体能够成功,哪些智能体只会给出听起来信心十足、却无人能够审计的答案。
如果错误答案最坏的结果只是用户重新发起查询,那么使用搜索引擎 API 就足够了。如果最坏的结果是你的团队根据错误情报采取行动,那么你需要一条知识供应链。
搜索 API 的优势所在(以及为何这很重要)
像 Tavily 这样的搜索 API 能在特定场景中发挥真正的价值:
亚秒级延迟。当响应时间是 UX KPI 时(例如交互式聊天,或用户等待期间面向智能体的工具调用),搜索 API 正是为此类场景量身打造的。Proxyway 2026 年搜索 API 报告证实,基于索引的提供商可实现低于 0.4 秒的响应时间中位数。对许多用例而言,速度是首要考量。
极低的集成门槛。原生支持 LangChain,端点文档详尽。对于需要在原型中加入网页搜索的开发者,只需几分钟即可完成集成。
非常适合原型开发和轻量级问答。搜索 API 能够很好地处理 RAG 演示、内部聊天机器人和低风险的数据丰富化工作流。Tavily 尤其提供可直接引用的输出和来源可信度评分,适合需要在智能体输出中添加来源引用的场景。
小规模使用成本低。按每积分 0.008 美元计算(Tavily 定价),实验门槛几乎为零。
如果你正在构建原型、聊天机器人或轻量级问答工作流,搜索 API 是合适的工具。但当任务要求更高时,它的局限性就会显现出来。
天花板:搜索 API 在生产规模下暴露的五大缺口
以下差距属于结构性限制,并非对搜索引擎 API 的批评。AI 智能体不需要完整的 SERP。广告、小组件和移动端布局对知识检索毫无帮助。
Proxyway 的搜索引擎 API 报告证实,快速 API 可以提供 SERP 结果,但无法获取结果背后的网页;而索引 API 返回的是预构建语料库中的网页,其更新速度可能落后于实时网络。单靠这两种架构中的任何一种都无法解决问题。
差距 1:时效性——缓存索引提供的是过时的真实数据
搜索 API 通过缓存和预索引来实现延迟目标。它们沿用了一种架构,a16z 的 “搜索之战”分析称,这种架构“主要针对人类进行了优化”而非针对如今依赖它的智能体工作流。
这些基准测试记录了由此形成的三层划分:完整 API 实时抓取(P95 超过 5 秒);快速 API 可迅速返回核心 SERP 元素(中位数为 0.6–0.7 秒);索引 API 从预抓取的数据语料库中提供结果(P50 低于 0.4 秒),但“该数据语料库可能存在过时或不完整的风险”。
对于定价情报、政策监控或突发新闻,缓存结果就是错误结果。在 2026 年 Bright Data Web Discovery Summit 上,演讲者用数据半衰期来描述这一问题:社交媒体数据会在几分钟或几小时内失去相关性。非社交类网页数据(定价页面、职位列表、产品目录)则会在几天内失效。即使搜索索引昨天才刷新,其中提供的数据也可能已经超过其有效半衰期。
定价页面一夜之间发生了变化,但搜索索引要等到下一次抓取时才会更新。你的智能体却基于过时的数据信心满满地给出结果。而且,问题正变得越来越严重。
Google 正在主动限制基于 SERP 的数据访问。AI 智能体“不在乎浏览内容,更不会在乎购买广告”(《搜索引擎 API 报告》,2026 年)。这直接威胁到广告商业模式。
同一份报告指出,SearchGuard 使抓取成本增加了约 10 倍。&num=100 参数已被完全移除。2025 年 12 月,Google 依据 DMCA 起诉了一家搜索引擎 API 提供商,要求其每次规避行为赔偿 200–2,500 美元(Proxyway 搜索引擎 API 报告,2026 年)。随着 Google 不断收紧访问限制,数据时效性差距正日益扩大。
如果你的唯一数据路径依赖搜索索引,就会面临可靠性问题。Bright Data 通过多种数据采集方式在查询时获取网络的当前状态,而不仅仅是抓取搜索结果。你的智能体与真实信息之间不存在单一索引这一中间环节。
差距 2:召回率——仅靠搜索索引中的片段还不够
搜索 API 返回搜索索引中的摘要片段。搜索结果由索引自身的算法排序,该算法针对关键词查询进行了优化,而非针对智能体研究任务背后的具体意图。对于聊天机器人来说,这种方式可行。但对于竞争情报智能体,则会出现两个问题。
首先,按关键词排名的结果可能与研究智能体的实际需求并不匹配。在同一场峰会上,与会嘉宾表示,一次生产环境中的深度研究调用可能会根据早期阶段的排名信号评估 10,000 个 URL。智能体会读取其中的 5%–30%,最终在答案中引用 1%–5%。
搜索 API 会返回索引中针对你的关键词排名最高的结果,而不会根据智能体任务背后的具体意图进行筛选。
其次,底层数据越来越难以访问。2026 年网页抓取行业调查发现,各垂直领域头部网站的数据可访问性大幅下降:电商领域可访问的网站从 2020 年的 10 个中有 9 个降至 10 个中仅有 4 个。
社交媒体访问成功率从 4/5 降至 0/5,房地产网站从 10/10 降至 3/10。通过标准数据中心访问方式,越来越多类别的网站正变得无法访问。
Bright Data 的搜索引擎 API 解决了前半部分问题:它可以从 195 个国家/地区中的任意一个实时抓取 Google、Bing、Yandex、Baidu、DuckDuckGo、Yahoo 和 Naver,因此你的智能体绝不会依赖单一索引对单一查询的解读。后半部分则完全不是排名问题。排名只能呈现来源;访问该来源需要另行处理,而这正是上述访问数据所揭示的问题所在。无论能否通过标准数据中心访问网络解锁器都能获取页面。
竞争情报中最重要的信号很少出现在第一页。它们往往隐藏在长尾结果中:一则招聘信息显示企业正在进入新市场,一条经销商商品信息中出现了尚未公布的 SKU,或是客服人员在论坛帖子中确认了产品路线图。这些内容很少出现在 SERP 前 10 条结果中。
缺口 3:你的智能体看到的是摘要,而非源内容
搜索 API 在设计上以摘要优先。它们默认返回提取的片段和描述,便于快速了解概况。但摘要并非可验证的证据。
完美的推理加上糟糕的搜索,仍然会产生幻觉。一套 AI 搜索评估框架表明,LLM 的推理能力已经超出了大多数搜索系统返回结果所能支持的范围。瓶颈在数据,而非模型。
对于具备市场感知能力的智能体而言,代价并非聊天机器人给出错误回答,而是企业做出错误决策。
做出高风险决策的智能体需要实际的源文本,而不是改述内容。在同一场活动中,一位开发智能体的企业买家指出,他们的客户想要的最丰富内容(LinkedIn 帖子、Twitter 主题帖)并不是 SERP 结果所返回的内容。相反,排名靠前的结果是引用这些内容的博客文章。与搜索排名质量相比,从一手来源完整提取内容更为重要。
完整内容之所以重要,还有另一个原因:网络内容正日益由 AI 合成。在 2025 年的一场网络数据行业会议上,研究员 Domagoj Maric 展示了仅用 2 美元即可生成 10,000 条虚假机器人评论。如果不对完整内容进行验证,你的智能体就无法区分真实评论和人为制造的干扰信息。在 2026 年的一项网络抓取行业调查中,使用 AI 工具的专业人士将幻觉列为最主要的担忧之一。
当有人询问你的智能体是如何得出结论时,你需要提供带时间戳的实际内容。仅凭片段不足以完成审计。
Bright Data 网络解锁器以 Markdown 格式返回经过清理的完整页面内容。在下面的实时测试中,它仅用 2.2 秒就从该供应商自己的定价页面返回了 26,758 个字符:这是实际的源文本,而不是对其内容的改写。
差距 4:吞吐量——RPM 上限会造成隐性架构债务
搜索 API 会实施速率限制。例如,Tavily 的生产计划上限为 1,000 RPM(每分钟请求数)。对于运行单个研究任务的单个智能体来说,这不成问题。但如果一组并发智能体同时运行数千个研究任务,情况就不同了:监控数百个竞争对手、追踪数十个市场的定价,以及核查多个司法管辖区的法规。面对 1,000 RPM 的限制,你不得不构建分页逻辑、重试处理程序、指数退避策略和队列管理机制。
最终产出只是纯粹的胶水代码,即连接各个系统却不创造任何业务价值的集成逻辑。它在预发布环境中运行正常,到了生产环境却频频出错,而且没人为维护工作预留时间。
并发问题进一步加剧。搜索 API 基准测试指出,由于大规模使用时的延迟和成本,完整的搜索引擎 API 对 AI 工作负载的“适用性有限”。在峰会上,一家金融数据公司估算,若每天监控 15 万家公司涉及的 150 种重大事件,仅搜索引擎 API 费用每月就约为 340 万美元。
再来对比一下实际生产环境。CentricSoftware 在 2025 年的一场网络数据行业大会上透露,仅为获取商品情报,其运行的 5,000 个爬虫工具每天就会发出 1.3 亿次请求,而不是每分钟 1,000 次请求。
Bright Data 搜索引擎 API 没有严格的并发请求限制。吞吐量可随你的工作负载扩展。
差距 5:缺乏历史基准——没有对比,就无法评估
当你尝试提升智能体的输出质量时,就会遇到差距 5。
如果你的智能体检测到的是真实异常,还是通过幻觉虚构出的模式,你该如何区分?你需要一个基准。你还需要可复现的历史数据,以便持续对输出质量进行基准评估。如果你想用竞争对手的历史定价数据回填新的智能体,而无需从头重新采集,就需要数据集。
搜索 API 在设计上仅提供实时数据。正如 Boaz Grinvald(零售洞察总经理)所指出的,要正确理解实时情报,就需要更深入的背景信息。如果不知道整个品类的价格都在上涨,那么仅仅知道竞争对手今天降价毫无意义,因为这次降价可能根本不值得采取应对措施。
这种情境信息层只有借助历史数据才会存在。如果你向搜索 API 查询上季度的定价数据,得到的会是今天关于上季度的搜索结果,而这完全是两码事。
构建基线的成本比大多数团队预想的更低。研究人员 Andrew Chan 证明抓取 10 亿个网页只需 25.5 小时,成本为 462 美元。Bright Data 维护着超过 2000 亿个已归档的 HTML 页面并且每月新增 150 亿个。
B2B 数据每月约有 2.1% 失效,复合计算后年失效率超过 22%(MarketingSherpa)。如果缺乏历史背景,智能体就无法区分真正的定价异常与正常的季节性波动。
在那次峰会上,一家数据公司的创始人介绍了他们如何通过观察相关职位发布数量和 LinkedIn 技能新增量随时间突然上升,来判断客户何时采用了新技术。这种时间信号只有通过长期纵向爬取才能发现,并帮助他们预测客户何时签下了该公司最大订单之一。搜索 API 只能返回当前的网页内容,无法检测此类信号。Bright Data 数据集提供按主题组织的历史数据,可用于数据回填、建立基线和可复现评估,并支持 JSON、CSV 或 Parquet 格式。
搜索 API 与知识供应链:7 个关键维度
同一项成本分析发现,基于索引的 API 成本趋近于每 1,000 次请求约 5 美元。正如他们所说:“实时 API 几乎总是更便宜。不过,要获得与索引相同的结果,它们需要投入更多工作”。Bright Data 搜索引擎 API 的即用即付方案每 1,000 次请求仅需 1.50 美元起。而这些“更多工作”,正是知识供应链所能自动完成的。
典型的知识供应链工作流(一次 Discover 调用、几次网络解锁器页面抓取和一次数据集查询)每项研究任务的成本通常不到 10 美元。分析师手动完成相同的工作大约需要 30–60 分钟。
以下是这两种架构在 7 个维度上的对比:
| # | 维度 | Bright Data | 搜索 API(类别) | Tavily(示例) |
|---|---|---|---|---|
| 1 | 新鲜度 | 实时发现与提取 | 可使用缓存/索引来提高速度 | 可能会返回缓存或已编入索引的结果——不保证为最新结果 |
| 2 | 每次查询的召回率 | 覆盖 7 个搜索引擎的排序结果来源,每个结果均可展开查看完整页面内容(搜索引擎 API + 网络解锁器) | 针对 top-K 进行优化 | 每次调用最多返回 20 条片段级结果 |
| 3 | 可验证的上下文 | 可选的已清理完整页面内容(内联 Markdown) | 通常先总结 | 默认先给出摘要 |
| 4 | 吞吐量 | 专为并行工作负载打造,支持生产级规模 | 通常受 RPM 限制 | 生产环境限制为 1,000 RPM |
| 5 | 延迟概况 | 可靠的生产级检索 + 低延迟选项(快速 SERP) | 针对低延迟进行优化,通常通过缓存实现 | 速度极快,优先考虑低延迟 |
| 6 | 按量付费价格 / 每 1,000 次请求 | 1.50 美元起(SERP 按量付费) | 因情况而异 | 每 1,000 次 8 美元(1 个积分)–16 美元(2 个积分) |
| 7 | 历史数据集 | 用于回填和基线分析的主题结构化数据集 | 并非该类别的核心内容 | 非数据集产品 |
成本与延迟之间的权衡取决于你的具体用例。
演示:同一个智能体,两种基础设施
同一个竞争情报智能体被构建了两次:任务相同、LLM 相同、系统提示词相同。唯一变化的是底层数据基础设施。
两个智能体都使用 Bright Data 端点。这是有意为之:它排除了供应商差异的影响。唯一的变量是架构:一个工具与三个工具。
场景
我们选择了竞争性定价情报任务,因为它需要信息发现、整页数据提取和历史背景分析。
竞品定价情报智能体
任务:监控竞争对手的 SaaS 定价页面,检测价格变化,结合历史定价趋势分析其背景,并评估这究竟代表结构性战略转变,还是临时促销。
仅靠搜索 API 无法出色地完成这项任务。a16z 将深度研究定义为“智能体搜索中占主导地位且最具变现潜力的形式”(《搜索大战:第二集》,2025 年)。这项任务要求数据具备时效性、高召回率、完整内容和历史记录。
框架:两个智能体均为使用 LangChain 构建的 LangGraph 竞争情报智能体,并使用 Bright Data REST API(也可通过 langchain-brightdata 使用搜索引擎和网络解锁器工具)。代码使用 GPT-4o。我们还使用 Cohere Command-A 测试了输出,以确认该架构不依赖特定 LLM。系统提示词相同,工具不同。
智能体 1:搜索 API 模式
智能体 1 封装了单个 SERP 端点。一个工具,一个数据源:
# Agent 1: Search API pattern
# Single SERP endpoint, snippet-level output

import os
import requests
from langgraph.prebuilt import create_react_agent
from langchain_openai import ChatOpenAI
from langchain_core.tools import tool

@tool
def search_web(query: str) -> str:
    """Search the web and return top results."""
    response = requests.post(
        "https://api.brightdata.com/request",
        headers={
            "Authorization": f"Bearer {os.environ['BRIGHT_DATA_API_KEY']}",
            "Content-Type": "application/json"
        },
        json={
            "zone": os.environ["SERP_ZONE"],
            "url": f"https://www.google.com/search?q={query}&num=10&brd_json=1",
            "format": "raw"
        }
    )
    # Response contains: organic[] with title, link, description per result
    results = response.json()
    organic = results.get("organic", [])[:10]
    return "\n".join([
        f"- {r.get('title')}: {r.get('description', '')[:200]}"
        for r in organic
    ])

llm = ChatOpenAI(model="gpt-4o")

search_api_agent = create_react_agent(
    llm,
    tools=[search_web],
    state_modifier="""You are a competitive intelligence analyst.
    Use web search to analyze competitor pricing changes.
    Provide a structured assessment with your findings."""
)

result_1 = search_api_agent.invoke({
    "messages": [{
        "role": "user",
        "content": "Analyze recent pricing changes for [Competitor]. "
                   "Has their pricing strategy shifted? "
                   "What does this mean for our positioning?"
    }]
})
我们在 Notion 定价页面上对此进行了实时测试。
AGENT 1 OUTPUT (Search API):

Sources consulted: 10 Google results (snippets only)
Content depth: Titles + 200-char descriptions

Finding: Notion's pricing strategy in 2026 appears to be
tiered, with four main plans: Free, Plus, Business, and
Enterprise. The Plus plan is priced at $10 per user per month
and is designed for small teams. The Business plan is priced
at $18-$20 per user per month and includes additional features
such as AI integration.

Confidence: Confident (based on snippets alone).
该智能体根据搜索摘要给出了较为合理的分析。它识别出了 4 个套餐层级及其大致价格,但无法读取实际的定价页面,也没有找到 Reddit 或论坛上关于近期价格调整的任何讨论,并且缺乏历史背景信息,无法判断当前定价是否意味着定价策略发生了变化。
智能体 2:知识供应链模式
现在,同样的任务可借助 Bright Data 搜索引擎 API、网络解锁器和数据集来完成,分别提供实时发现、完整内容提取和历史基准:
# Agent 2: Knowledge Supply Chain
# Live discovery + full content + historical baseline

import os
import json
import requests
from langgraph.prebuilt import create_react_agent
from langchain_openai import ChatOpenAI
from langchain_core.tools import tool

HEADERS = {
    "Authorization": f"Bearer {os.environ['BRIGHT_DATA_API_KEY']}",
    "Content-Type": "application/json"
}

# Tool 1: Live discovery across real search engines via SERP API
@tool
def discover_sources(query: str) -> str:
    """Search the live web with Bright Data's SERP API.
    Returns ranked sources with titles, URLs and snippets."""
    response = requests.post(
        "https://api.brightdata.com/request",
        headers=HEADERS,
        json={
            "zone": os.environ["SERP_ZONE"],
            "url": (f"https://www.google.com/search?q={query}"
                    "&gl=us&hl=en&num=20&brd_json=1"),
            "format": "raw"
        }
    )
    # Response contains: organic[] with title, link, description
    organic = response.json().get("organic", [])
    return f"Discovered {len(organic)} sources:\n" + "\n".join(
        f"- {r.get('title')} ({r.get('link')})\n"
        f"  {r.get('description', '')[:200]}"
        for r in organic
    )

# Tool 2: Targeted page extraction.
# Discovery finds candidates; Web Unlocker reads the page that matters.
@tool
def fetch_full_content(url: str) -> str:
    """Fetch the full cleaned content of a specific webpage
    in Markdown format via Web Unlocker."""
    response = requests.post(
        "https://api.brightdata.com/request",
        headers=HEADERS,
        json={
            "zone": os.environ["UNLOCKER_ZONE"],
            "url": url,
            "format": "raw",
            "data_format": "markdown"
        }
    )
    # Returns full page content as cleaned Markdown text
    return response.text[:8000]

# Tool 3: Historical dataset baseline
@tool
def get_historical_pricing_data(competitor_domain: str) -> str:
    """Retrieve historical pricing snapshots from Bright Data
    Datasets for baseline comparison."""
    response = requests.post(
        "https://api.brightdata.com/datasets/v3/trigger",
        params={"dataset_id": os.environ["PRICING_DATASET_ID"]},
        headers=HEADERS,
        json=[{"url": f"https://{competitor_domain}/pricing"}]
    )
    # Returns: {"snapshot_id": "sd_xxxxx"} for async data retrieval
    snapshot_id = response.json()["snapshot_id"]
    return json.dumps({
        "snapshot_id": snapshot_id,
        "status": "Historical data retrieved"
    })

llm = ChatOpenAI(model="gpt-4o")

knowledge_supply_chain_agent = create_react_agent(
    llm,
    tools=[discover_sources, fetch_full_content,
           get_historical_pricing_data],
    state_modifier="""You are a competitive intelligence analyst
    with access to live web discovery, full page content,
    and historical pricing datasets.

    For pricing analysis:
    1. Discover broadly to map the landscape
    2. Fetch the actual pricing page - do not rely on snippets
    3. Compare against historical baseline data
    4. Identify whether this is a structural shift or temporary
    5. Provide a structured assessment with source citations."""
)

result_2 = knowledge_supply_chain_agent.invoke({
    "messages": [{
        "role": "user",
        "content": "Analyze recent pricing changes for [Competitor]. "
                   "Has their pricing strategy shifted? "
                   "What does this mean for our positioning?"
    }]
})
相同的查询。相同的 LLM。不同的数据基础设施。注意:我们没有为本次测试配置历史数据集,因此未使用工具 3(历史基线)。在生产环境部署中,历史数据对比将提供第三层证据。
AGENT 2 OUTPUT (Knowledge Supply Chain):

Sources discovered: 7 (SERP API, 4.1 seconds)
Pages extracted:    3 (Web Unlocker)
Evidence budget:    86,298 characters - 118x Agent 1
Tool calls:         6

Finding: Structural shift, not a promotion. Notion is moving
agent functionality off the seat price and onto a consumption
meter, while leaving the seat prices themselves untouched.

Seat pricing unchanged: Free $0, Plus $10/member/month,
Business $20/member/month, Enterprise custom.

The change is a second, parallel meter:
  - "Custom Agents ... Free to try, then $10 per 1,000 monthly
    Notion credits." (notion.com/pricing, verbatim)
  - The plan comparison table lists "Custom Agents - Requires
    Notion credits" under every tier, Enterprise included.
    Paying the top seat price does not exempt you.
  - "Workers (Beta) ... Free to try now. Starts using credits
    on October 15." A second product is already scheduled onto
    the same meter, with a date.

Corroboration (eesel.ai): credits run "on top of your seats",
and "'Getting AI in Notion' isn't a single number anymore."

Why structural rather than promotional: a promotion is
time-boxed and reversible. This has the opposite signature - a
dated forward commitment, application at every tier including
Enterprise, and a second product migrating onto the same meter.

Positioning implication: any per-seat comparison now understates
Notion's real cost for AI-heavy teams.

Confidence: High for mechanism and tier scope - quoted from the
vendor's own live page. Medium for magnitude, which depends on
per-team credit burn that is not published.
区别不在于智能,而在于证据
两个智能体使用同一个 LLM 运行了相同的查询。智能体 1 正确识别了全部四个套餐等级及其醒目价格。智能体 2 则读取了定价页面本身,并回答了实际提出的问题:这一变化是否属于结构性调整。
两个智能体的推理能力同样出色。变化的是证据量。智能体 1 从七条结果中获得了 732 个字符的摘要文本。智能体 2 不仅获得了相同的七条结果,还提取了 86,298 个字符的页面内容——证据量是前者的 118 倍,而只多调用了五次工具。
智能体 1 并非毫无发现,这一点值得准确说明。供应商自有页面的摘要确实透露了那个醒目的数字:“每月每 1,000 个 Notion 积分收费 10 美元。”但摘要无法呈现其背后的计费结构:所有套餐层级(包括 Enterprise)都采用积分计费;积分费用是在席位定价之上额外收取,而非取而代之;而且已有第二款产品确定将接入同一计费体系。摘要会呈现数字,却无法体现承诺。
智能体 2 的运行时间更长(发现 + 提取,而非单次 SERP 调用)。正如峰会上的一位嘉宾所说:对于智能体,一秒延迟的限制已不再适用。延迟可能是 100 毫秒,也可能是 100 秒,具体取决于智能体是在生成聊天回复,还是在执行通宵研究任务。
本次测试共调用六次工具:两次探索性查询和四次数据提取。生产部署中则为七次(增加数据集用于建立历史基准)。这就是知识供应链的实际运作方式。
搜索覆盖广度,数据提取挖掘深度,数据集则为两者的评估增添历史背景。
亲自运行。只需 Bright Data API 密钥和任意兼容 LangChain 的 LLM,这两个智能体即可完整运行。复用这一模式,将其指向真实的竞争对手,然后比较输出结果。如需完整教程,请参阅如何构建智能体 RAG 系统。
搜索 API 还是知识供应链?决策框架
并非每个智能体都需要知识供应链。如果你正在为企业级工作负载寻找 Tavily 的替代方案,正确答案取决于风险有多高,而非采用何种技术。
| 场景 | 合适的工具 |
|---|---|
| 将延迟作为 KPI 的交互式聊天用户体验 | 搜索 API(Tavily 或 Bright Data Fast SERP) |
| RAG 原型、内部演示、黑客松 | 搜索 API——快速、低成本、轻松易用 |
| 生产级智能体:竞争情报、定价和风险管理 | Bright Data 搜索引擎 API + 网络解锁器 + 数据集 |
| 智能体需要包含完整页面内容的排名结果 | Bright Data 搜索引擎 API + 网络解锁器(对来源进行排名,并按需提供完整页面内容) |
| 需要验证特定页面的当前状态 | Bright Data 网络解锁器 / 搜索引擎 API(含完整内容) |
| 需要历史基准数据或评估数据集 | Bright Data 数据集 |
| 同时运行 1,000 多个研究任务 | Bright Data — 吞吐量随工作负载扩展,不受速率限制门槛制约 |
a16z 发现,大多数搜索 API 提供商的核心功能都较为相似(他们称之为“有限的早期产品差异化”),主要在速度和定价方面展开竞争(《搜索大战:第二集》,2025 年)。Bright Data 同时提供实时 SERP 和亚秒级 Fast SERP 访问。基于索引的搜索 API 响应速度最快,但其数据来自预先构建的语料库。
生产环境中的智能体越来越需要兼顾实时访问与速度,而不是二选一。在实践中,许多团队会在单个智能体内根据意图进行路由:低延迟工具调用使用 Fast SERP;当智能体进入深度研究循环时,则使用搜索引擎 API 与网络解锁器。
选择与你的智能体决策相匹配的基础设施。
知识供应链技术栈:参考
对于准备超越搜索 API 的团队,以下是关键构建模块(另请参阅完整的 AI 智能体技术栈指南):
| 构建模块 | 最适合 | 核心功能 |
|---|---|---|
| 快速 SERP / 搜索引擎 API | 监控、聊天 UX、低延迟工作流 | 亚秒级结构化 SERP 输出,支持地理位置和语言定向 |
| 网络解锁器 | 抓取受反爬虫保护的特定页面 | 99.95% 成功率,内置验证码破解,支持 Markdown 输出 |
| 数据集 | 回填、基线、可复现评估 | 按主题组织的历史数据,支持 JSON/CSV/Parquet 格式 |
它们并非相互竞争的产品,而是不同的层级。发现层用于寻找来源,提取层用于读取内容,数据集则提供历史记录,以评估发生了哪些变化。
这对 AI 智能体团队意味着什么
网络正变得越来越难以读取,而不是越来越容易。五个月内,Cloudflare 拦截了 4160 亿次 AI 爬虫请求(WIRED,2025 年)。大多数网页抓取专业人士表示,反爬虫保护措施正逐年加强。
然而,不到一年时间里,公开披露的融资中就有超过 3.23 亿美元流向了智能体搜索初创公司(根据该报告所列融资轮次计算)。对于 AI 智能体而言,“搜索 API”与生产级网页数据基础设施之间的差距并未缩小。
面向市场感知智能体的 Bright Data 技术栈:
- 通过发现按意图排序内容,并可选择获取完整内容
- 用于低延迟监控和交互式体验的快速 SERP
- 用于回填、基线构建和更快采集的数据集
试用交互式演示、阅读智能体文档或通过各产品的免费套餐或免费试用开始构建。
常见问题解答
什么是面向 AI 智能体的搜索 API?
它是一种由你的智能体调用以获取搜索结果的 API,可返回排序后的 URL、摘要,有时还包括页面概述。Tavily 是一个广为人知的例子。这类 API 非常适合聊天机器人、RAG 演示和原型,尤其适用于速度比深度更重要的场景。但其结果来自缓存索引,而非实时网络。
为什么 AI 智能体不能只依赖搜索 API?
搜索 API 返回的是缓存索引中的摘要片段。需要做出业务决策的智能体需要实际的页面内容,而不是内容摘要。它们还需要历史数据来检测内容是否发生变化,并需要足够高的吞吐量,以便并行执行数千项研究任务,同时不触发速率限制。
AI 智能体如何使用网络数据?
智能体不会只搜索一次就停止。它们会在执行任务的过程中,根据找到的内容决定搜索什么、阅读多少个页面,以及是否再次搜索。定价智能体可能会先搜索并获取实际页面,与上个月的数据进行比较,然后再搜索相关新闻。网络只是多种工具之一。
与 Tavily 相比,Bright Data 的费用是多少?
Bright Data 搜索引擎 API 按量付费价格为每 1,000 次请求 1.50 美元起。网络解锁器和数据集根据使用量单独计费。Tavily 的价格为每积分 0.008 美元起(每 1,000 次单积分请求 8 美元)。Bright Data 的每款产品均提供免费套餐或免费试用,且无最低消费承诺。
Bright Data 是一个不错的 Tavily 替代方案吗?
具体取决于工作负载。对于需要完整页面内容、按意图排序的结果和历史基准数据的生产级智能体,Bright Data 能够覆盖 Tavily 无法满足的需求。对于优先考虑延迟的原型和聊天用户体验,Tavily 仍然是一个不错的选择。两者都是适用于不同问题的优秀工具。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。