


- 超过 4 亿个住宅代理
- 快速响应时间
- 99.95%成功率
- 地理位置定位 - 免费
深受全球 超50000 家客户信赖


Bright Data 与 ScrapFly 相比如何?
Bright Data
ScrapFly
网页爬虫工具 API 定价
只为成功交付的内容付费。无隐藏费用,交付失败不收费。
- 只为成功结果付费,无隐藏费用
- 每月 5,000 个免费 credits,免费开始
- 无需预先承诺,可随时取消
- 7*24 小时专家支持和企业级功能


100% 合规的代理网络
为保护您的声誉并确保数据可靠,您的代理必须通过合乎道德的方式获取,并符合合规标准。Bright Data 全面致力于遵守所有相关的数据保护法律要求,包括欧盟新的数据保护监管框架、GDPR 以及 2018 年《加州消费者隐私法案》(CCPA),并尊重用户行使隐私权的请求。
对于代理和网页爬虫,Bright Data 是您的不二之选
内置代理基础设施
超过 1.5 亿个代理 IP 可直接购买——ScrapFly 仅在其 API 中捆绑代理,不提供独立访问,也未公布 IP 池规模
可预测且透明的定价
无按功能计算的积分倍数——使用 JS 渲染、住宅代理或截图时,ScrapFly 的积分成本会从 1 倍跃升至 60 倍
120 多个持续维护的 API
由官方维护、针对特定网站的结构化 API——ScrapFly 仅提供一个通用端点和 AI 模板,您仍需针对每个目标进行配置
基于浏览器的开发
可随时随地访问完整的网页 IDE——ScrapFly 提供 SDK、CLI 和请求测试器,但不提供浏览器内开发环境
数据集市场
即时获取预采集数据——ScrapFly 完全不提供数据集,仅提供实时抓取
企业级认证
SOC2、ISO 27001、CSA STAR 认证与代理直接所有权相结合——ScrapFly 虽拥有可靠的认证(SOC2、ISO27001、HIPAA),但不具备代理或数据集基础设施
网页爬虫工具 API 库
与 Oxylabs 有限的域名目标范围不同,Bright Data 的每个爬虫工具均由我们的内部工程团队进行官方维护,并提供正常运行时间保证、结构化输出和企业级 SLA。
 79.5K+

相比竞争对手,开发者更青睐 Bright Data
- 最高质量的数据
- 最广泛的地理覆盖范围
- 最佳网络正常运行时间
- 最快输出速度

最佳性能
业内最高的成功率

持续创新
每天发布新功能

最可靠
企业级扩展能力

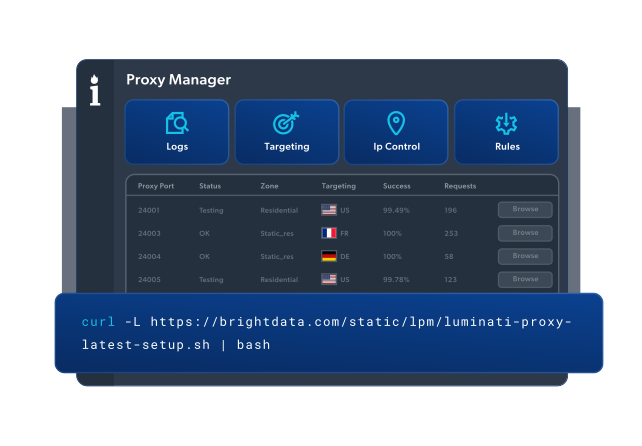
借助网络上最受欢迎的代理管理工具,轻松使用
- 最受欢迎且易于使用的代理控制面板
- 通过简单易用的界面管理代理
- 新手也能轻松集成
- 定义自定义规则以优化结果
- 专为开发者打造,为企业提供强劲支持
在代理和数据收集行业中领先者

650TB的公共数据每天收集

每天发布新功能

服务于世界7/10大的顶尖大学

4.6/5 Trustpilot评分
业内最佳的客户体验
每天发布新功能
在您需要时回答任何问题
实时网络性能仪表板
优化您的性能
满足您的数据收集目标
全球顶尖品牌都在使用的住宅代理




我们对 Bright Data 的可靠性印象深刻,对整体服务也非常满意。我们与客户经理保持着定期沟通,他的协助对我们非常有帮助。


常见问题
Bright Data 比 ScrapFly 更好吗?
Bright Data 和 ScrapFly 采用不同的网络数据采集方式。ScrapFly 是一种基于积分的爬虫 API:单一端点 (asp=true) 可针对任意公开 URL 处理代理轮换、JS 渲染和反机器人绕过,并拥有可靠的认证(SOC 2 Type II、ISO 27001、HIPAA、GDPR)和慷慨的免费套餐(1,000 积分、无需信用卡、永不过期)。对于希望只需调用单一 API 的开发者而言,它是一个不错的选择。
Bright Data 提供超过 1.5 亿个可直接购买的住宅代理 IP(而非仅捆绑在 API 中)、120 多个针对特定网站(Amazon、LinkedIn、Google 等)的预构建结构化爬虫 API、数据集市场、专属 ISP 代理以及基于浏览器的网页 IDE。如果需要单一的通用抓取端点,请选择 ScrapFly;如果需要可直接控制的代理基础设施、针对各网站的结构化数据,以及在同一平台上获取预采集数据集,请选择 Bright Data。
基于积分的定价与 Bright Data 相比如何?
ScrapFly 根据每次请求收取不同数量的积分:通过数据中心 IP 进行基础 HTTP 抓取需要 1 积分,JS 渲染或反机器人绕过额外需要 5 积分,住宅代理额外需要 25 积分,整页截图则需要 60 积分。套餐价格从每月 30 美元(20 万积分)到每月 500 美元(550 万积分)不等,Pro 及以上套餐可按使用量支付超额费用。积分无法逐月结转,且不提供年度套餐。独立机构 Scrapeway 的基准测试(2026 年 8 月)显示,ScrapFly 每 1,000 次请求的平均成本为 4.9 美元,高于 2.7 美元的行业平均水平,同时成功率高达 98%,处于领先水平。
Bright Data 的定价避免了这种叠加倍数结构,因此您不会仅因在同一请求中使用住宅 IP 或获取截图,就被收取高出 25 至 60 倍的费用。对于大规模、高度依赖 JS 或住宅代理的工作负载,这通常可使规模化运行时的成本更可预测。
代理基础设施方面如何?
ScrapFly 不单独销售代理产品,也未公布其 IP 池的总规模。住宅代理和数据中心代理(覆盖 190 多个国家/地区)仅用于处理其自身的网页爬虫工具 API 调用,其中住宅代理请求需要 25 积分,而数据中心代理请求仅需 1 积分。
Bright Data 运营着全球最大的代理网络:在 195 个国家/地区拥有超过 1.5 亿个住宅 IP、130 多万个数据中心 IP,以及 130 多万个专属 ISP IP,所有这些均可作为独立且完全可配置的代理产品使用。如果您需要在 API 封装之外为自定义工具直接访问代理,Bright Data 正是为此而构建;ScrapFly 的代理则仅用于支持其自身的 API 流程。
从 ScrapFly 切换到 Bright Data 可以节省费用吗?
ScrapFly 的免费套餐(1,000 积分,无需信用卡)和每月 30 美元的入门套餐对原型开发很有吸引力。但费用并非线性增长:一次使用住宅代理并进行 JS 渲染的请求可能消耗 30 积分,这意味着每月 30 美元的 Discovery 套餐可能仅支持约 6,600 次全功能抓取,而不是 200,000 次原始抓取。未使用的积分也会每月到期,无法结转。
Bright Data 的代理和 API 定价避免了按功能叠加倍数计费,其数据集市场甚至可以完全省去常见数据需求的抓取成本。对于大规模运行大量 JS 或依赖住宅代理的工作负载,计入 ScrapFly 的全部积分倍数后,团队通常会发现 Bright Data 的成本更可预测。
从 ScrapFly 迁移到 Bright Data 需要多长时间?
迁移通常需要 24 至 72 小时,具体取决于范围。如果您正在使用 ScrapFly 的通用网页爬虫工具 API 抓取知名网站(Amazon、LinkedIn 等),Bright Data 的预构建结构化 API 可立即提供对应功能,并且需要维护的自定义解析逻辑更少。对于自定义目标,团队通常会使用 Bright Data 的网络解锁器或 Web IDE 重新构建。
该流程包括:(1) 将 ScrapFly 的 asp=true 调用映射到 Bright Data 对应的代理或 API;(2) 使用现有解析代码测试结构化输出;(3) 验证针对您特定目标的反爬虫绕过能力;(4) 逐步切换流量。我们的支持团队会在整个迁移过程中提供协助。
Bright Data 是否支持与 ScrapFly 相同的功能?
两个平台都支持绕过反爬虫机制、JS 渲染和代理轮换。ScrapFly 还提供云浏览器 API(由 CDP 驱动的远程 Chromium)、用于全站抓取的爬虫 API、截图 API、AI 浏览器智能体,以及用于集成 AI 智能体的 MCP 服务器,所有功能共用同一个积分池。
Bright Data 提供可直接购买的代理基础设施、120 多个持续维护的结构化爬虫 API、基于浏览器的 Web IDE、数据集市场以及专用 ISP 代理,而 ScrapFly 完全不提供这些功能。两者都支持 Python/Node SDK 和 MCP;Bright Data 的平台还进一步扩展到独立代理访问和预采集数据交付。
ScrapFly 为何对开发者具有吸引力?
ScrapFly 确实非常适合 API 优先的开发者:只需设置一个 asp=true 标志,无需针对每个目标进行配置,即可处理反爬虫绕过、代理轮换和 JS 渲染;此外,它还提供一流的 SDK(Python、TypeScript、Go、Rust、Scrapy)、适用于 Shell/CI 流水线的 CLI,以及与 Zapier、Make、n8n、LangChain 和 CrewAI 的集成。独立的 Scrapeway 基准测试显示,在受测爬虫 API 中,ScrapFly 的成功率排名第一(98%)。
对于希望通过一个简洁 API 端点处理任意 URL 的团队,ScrapFly 是一个不错的选择。对于需要直接掌控代理、特定网站的结构化数据、预采集数据集,或不受积分倍数影响的可预测定价的团队,Bright Data 更广泛的平台通常更适合长期使用。
我可以在取消 ScrapFly 订阅前试用 Bright Data 吗?
可以。Bright Data 的所有产品均提供免费试用,且无需信用卡。ScrapFly 的免费套餐(1,000 积分、无需信用卡、永不过期)对于原型开发确实很慷慨,因此许多团队会同时使用这两个平台:继续通过 ScrapFly 运行现有的通用抓取脚本,同时使用 Bright Data 的代理基础设施、结构化 API 和数据集,之后再根据特定目标的成本和覆盖范围进行整合。
ScrapFly 的主要局限是什么?
独立的 Scrapeway 基准测试(2026 年 8 月)发现,ScrapFly 的平均响应时间(15.3 秒)慢于行业平均水平(9.1 秒),平均成本(每 1,000 次请求 4.9 美元)也高于行业平均水平(每 1,000 次请求 2.7 美元),这是其以 98% 的成功率排名第一所带来的权衡。其他不足包括:不单独销售代理,也未公布 IP 池规模;没有数据集市场;没有针对特定网站的结构化爬虫 API(仅提供通用端点);没有基于浏览器的 Web IDE;没有专用 ISP 代理套餐;积分无法结转;也没有年度套餐。
对于需要的不只是单一通用抓取端点的团队,Bright Data 的直接代理访问、120 多个持续维护的结构化 API、数据集市场和 Web IDE 弥补了这些不足。
两者的开发方式有何区别?
ScrapFly 采用单端点架构:一次带有 asp=true 的 API 调用会经由两个专有引擎之一进行路由(用于 HTTP 的 Curlium,或用于托管 Chromium 的 Scrapium),在后台自动处理代理轮换、渲染和重试。开发通过 SDK(Python、TypeScript、Go、Rust、Scrapy)或 CLI 完成,不提供基于浏览器的编码环境。
Bright Data 提供多种方式:(1) 直接销售超过 1.5 亿个可用于各种场景的代理 IP;(2) 针对不同平台提供 120 多个预构建结构化爬虫 API(零配置);(3) 可从任意地点访问、用于自定义开发的浏览器版 Web IDE;(4) 可即时获取预采集数据的数据集市场。对于拥有不同技术水平成员的团队,Bright Data 提供了更大的灵活性,而不仅仅面向 API 优先的开发者。
支持哪些导出格式和集成?
ScrapFly 可输出 HTML(原始或净化后)、Markdown、纯文本、通过其提取 API 生成的结构化 JSON(使用 LLM 提示词、CSS/XPath 规则或预训练模型)、截图(PNG/JPEG/WebP),以及用于爬取任务的 WARC 存档。集成包括 Zapier、Make、n8n、LangChain、LlamaIndex 和 CrewAI,另有五个官方 SDK。
Bright Data 支持 JSON、NDJSON、CSV、Excel、直接数据库集成(MySQL、PostgreSQL、MongoDB)、Webhook 交付、云存储(Amazon S3、Google Cloud)和定时导出。两者都提供完善的集成:ScrapFly 专注于面向开发者的 LLM/智能体工作流输出格式,而 Bright Data 则侧重企业级数据交付以及与数据库和云平台的直接集成。
两个平台都能处理企业级规模的运营吗?
ScrapFly 为 30,000 多家企业提供服务,每月处理超过 150 亿次请求和 8 PB 以上的数据;Custom 合同起价约为每月 1,200 美元,对于承诺并发量和专用住宅代理池的方案,费用可扩展至每月 30,000 美元以上。它是大规模 API 抓取的可靠选择,但高级全天候支持仅面向 Custom 合同客户提供。
Bright Data 为包括《财富》500 强企业在内的 超50000 家客户提供服务,其基础设施每天支持采集 650 TB 数据,并提供超过 1.5 亿个可直接访问的代理 IP、99.99% 的正常运行时间 SLA,以及所有套餐均包含的全天候专属支持,而非仅限最大规模的合同。对于需要直接掌控代理、按网站划分的结构化数据、预采集数据集以及爬虫 API 的企业,Bright Data 更广泛的平台能力是专门为此打造的。
两个平台都遵循哪些合规与安全标准?
ScrapFly 拥有一套真正强大的合规体系:通过了 ISO 27001、SOC 2 Type II、SOC 3 和 HIPAA 认证,并符合 GDPR/CCPA 要求;定制套餐还可提供业务伙伴协议(BAA)。对于受监管行业而言,这是一项值得肯定的显著优势。
Bright Data 持有 GDPR、CCPA、ISO 27001、SOC 2 Type II 和 CSA STAR 一级认证,并在每项企业合作中提供完整的审计追踪记录和数据处理协议。两家公司都高度重视合规性,区别在于 Bright Data 不仅拥有相关认证,还直接持有代理资源并交付数据集。对于需要审查源 IP 的获取地点和获取方式,而不仅仅是 API 请求处理方式的合规团队来说,这一点至关重要。