



- 通过单次 API 调用实时提取
- 自动代理轮换和反机器人绕过
- 结构化 JSON 输出,可直接使用
深受全球 超50000 家客户信赖


两种数据提取方式,一个平台
从任意页面拉取实时数据,或直接使用已经采集、清洗并结构化的数据集。

哪种提取方式更适合?
同一底层网络,两类不同任务。通常可以这样选择。
网页爬虫工具 API
最适合
实时和按需
设置时间
API 集成,通常只需几分钟
数据新鲜度
请求时实时获取
覆盖范围
来自 600+ 个网站的 1,200+ 个爬虫工具
交付
交付到首选存储或下载
网页数据集
最适合
批量或周期性数据需求
设置时间
无需设置 - 下载即可使用
数据新鲜度
定时更新
覆盖范围
数百个预构建数据集
交付
JSON、CSV、Parquet,或推送到存储
不确定你需要哪款产品?让我们帮你找到合适的产品。
支撑两类产品的同一网络
数据集和爬虫 API 都基于同一代理和解锁基础设施,确保规模化提取保持可靠。
4 亿
网络中的 IP
195
覆盖国家/地区
99.95%
正常运行时间 SLA
1,000+
现成爬虫工具
 15.3K+

满足你需求的灵活定价选项
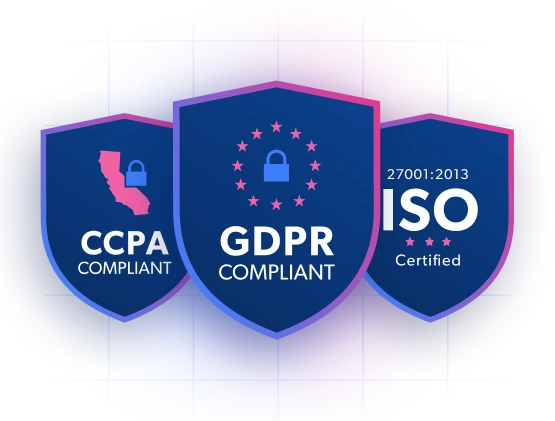
引领合规网页数据采集实践
我们为合规且符合伦理的网页数据实践树立了黄金标准。我们的 peer 网络建立在信任之上,每位成员都亲自选择加入,并保证零个人数据采集。我们倡导仅采集公开可用数据,并由行业领先的 Know Your Customer 流程和透明的可接受使用政策提供支持。我们的全球多语言合规与伦理团队开创行业先河,确保我们始终领先于监管变化和最佳实践。
为什么 超50000 家客户选择 Bright Data

100% 合规
抓取数据以合规方式获取,并符合所有隐私法律。

7*24 小时全球支持
专属数据专业团队随时为你提供帮助。

完整数据覆盖
访问 超40000万 个全球 IP,从任意网站抓取数据。

无与伦比的数据质量
先进技术和验证方法,确保高质量数据。

强大基础设施
抓取大规模数据且不被封锁。

自定义解决方案
获取量身定制的解决方案,以满足独特需求和目标。