


- 基于 API 的爬虫工具
使用我们的界面构建您的 API 请求 - 大规模自动化
构建您自己的调度程序来控制频率 - 交付
将数据交付到您首选的存储位置,或直接下载
- 免费层级 - 每月免费 5K 条记录
- 通过 API 或无代码爬虫工具按需抓取
- 只为成功交付的结果付费
- 批量请求处理,最多 5K 个 URL
值得信赖 全球 超50000 位客户


全球 超50000 位客户信赖


即时扩展您的 SEO 和 GEO 数据采集
将您的平台连接到专为高速增长打造的基础设施。无缝运行覆盖 Google AI、ChatGPT 和 Gemini 的复杂查询,无需管理任何代理或解析器。
- 通过一个平台提取所有 LLM 的回答
- 选择您的工作流:API 或无代码控制面板
- 定位任意国家/地区以获取本地化结果
- 通过 CSV 上传提示词列表,即时进行批量采集
- 从 1 条提示词无缝扩展至 1,000,000 个请求

网页爬虫工具 API
可用的 LLM 爬虫工具
轻松获取高级 AI 模型的结构化回复,包括来源、引用和上下文等相关元数据。
 320+
 289+

LLM 爬虫工具体验平台
代码示例
LLM 爬虫 API 定价
仅为成功交付的结果付费。无隐藏费用,交付失败不收费。
我们接受这些支付方式:
每个套餐都提供完整权限——规模越大,每条记录成本越低
数据采集
- 自动化代理管理
- 全浏览器渲染
- 验证码破解
大规模性能
- 并发不限
- 批量与定时采集
- 任务管理 API
数据交付
- 数据校验与发现
- 数据解析(JSON 或 CSV)
- 通过 Webhook 或 API 交付
性能领先的 LLM 爬虫 API
按 AI 模式筛选
为保持高标准的数据质量,比较图表中仅展示成功率高于 90% 的提供商。
在 AI Multiple 的 LLM 爬虫工具基准测试中,所有 LLM 均排名第一
AI Multiple 针对每家提供商,在 ChatGPT、Gemini、Perplexity 和 Google AI Mode 上分别进行了 1,000 次测试。Bright Data 在所有类别中均排名第一。
- 在测试的全部 4 种 LLM 模式中均排名第一
- 返回 25 个元数据字段,是竞争对手的 6 倍
- 唯一在 Gemini 上达到 90% 以上成功率的提供商
- 成功率和数据丰富度均优于所有竞争对手
面向 AI 搜索引擎的网页爬虫工具 API
追踪您的品牌在 ChatGPT、Perplexity 等平台生成的 AI 搜索结果中的表现
实时追踪提及、推荐和竞争对手比较,确保您的品牌在 AI 生成的搜索结果中得到准确呈现。

监控 OpenAI GPT、Perplexity AI 等 AI 搜索引擎中动态变化的 AI 搜索排名和品牌提及,保持竞争优势。

分析 AI 搜索引擎如何对您的品牌与竞争对手进行排名,帮助您优化可见度,并提升在 AI 生成推荐中的定位。

全新!面向 AI 搜索引擎的网页爬虫工具 API
追踪您的品牌在 ChatGPT、Perplexity 等平台生成的 AI 搜索结果中的表现

AI 搜索可见度
实时追踪提及、推荐和竞争对手比较,确保您的品牌在 AI 生成的搜索结果中得到准确呈现。

搜索与采集
- 从任意网站查找并提取实时数据。
- 使用基于 LLM 的查询检索最相关的记录。
- 只需极少的手动操作,即可高效筛选海量数据集。
- 通过定时提取自动检索数据。

发现与交互
- 专为网页自动化和 AI 驱动的应用场景而打造。
- 采用 API 优先方案,并以用户界面作为备用方式来浏览动态页面。
- 实时搜索、筛选和优化数据提取。
- 抓取整个网站或特定版块,以获取相关数据。
引领合规网页数据采集实践
我们为合规且符合伦理的网页数据实践树立了黄金标准。我们的 peer 网络建立在信任之上,每位成员都亲自选择加入,并保证零个人数据采集。我们倡导仅采集公开可用数据,并由行业领先的 Know Your Customer 流程和透明的可接受使用政策提供支持。我们的全球多语言合规与伦理团队开创行业先河,确保我们始终领先于监管变化和最佳实践。
更快部署
通过一次 API 调用抓取 LLM

数据发现
检测数据结构和模式,确保高效、精准地提取数据。

批量请求处理
降低服务器负载,并为大规模抓取任务优化数据收集。

数据解析
高效地将原始 HTML 转换为结构化数据,简化数据集成和分析。

数据验证
确保数据可靠性,并节省手动检查和预处理时间。
底层能力
再也不用担心代理和 CAPTCHA 了
- 自动 IP 轮换
- CAPTCHA 识别/破解
- User Agent 轮换
- 自定义请求头
- JavaScript 渲染
- 住宅代理
顶级用户体验
易于开始,更易扩展。
无与伦比的稳定性
依靠全球领先的代理基础设施,确保一致的性能并将故障降至最低。
简化的网页抓取
使用可投入生产的API将您的抓取任务自动化,节省资源并减少维护。
无限扩展性
轻松扩展您的抓取项目以满足数据需求,同时保持最佳性能。
用于无缝访问 LLM 数据的 API
全面、可扩展、且合规的网页数据提取
用于无缝访问 LLM 数据的 API
全面、可扩展、且合规的网页数据提取
贴合你的工作流
通过 Webhook 或 API 交付,以 JSON、NDJSON 或 CSV 文件获取结构化数据。
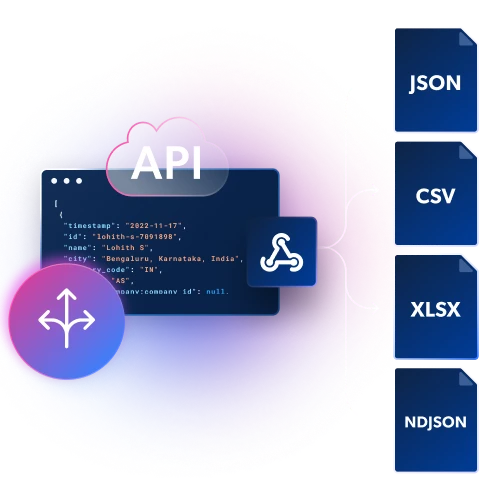
内置基础设施与自动解封
无需维护代理与解封基础设施,即可获得最大的控制力与灵活性。轻松从任何地理位置抓取数据,同时规避验证码与封锁。

经实战验证的基础设施
Bright Data 平台为全球 20,000+ 家公司提供支持,以 99.99% 的在线率带来安心体验,并可访问覆盖 195 个国家/地区的 1.5 亿+ 真实用户 IP。

行业领先的合规标准
我们的隐私实践遵守包括欧盟数据保护监管框架、GDPR 和 CCPA 在内的数据保护法律。

ChatGPT 爬虫 API 应用场景
抓取 Zoopla 数据,寻找新的投资机会
抓取房地产数据,紧跟价格趋势
抓取 Zoopla 数据,发现英国的新房源
获取房地产数据用于市场分析
为什么 超50000 位客户选择Bright Data

100%合规
抓取的数据是通过道德方式获取的,并符合所有隐私法律。

全球 24/7 支持
一支专注的数据专业团队随时为您提供帮助。

全面的数据覆盖
访问超40000万全球 IP,抓取任何网站的数据。

无与伦比的数据质量
先进的技术和验证方法确保高质量数据。

强大的基础设施
抓取大量数据而不被封锁。

定制化解决方案
获取量身定制的解决方案,以满足独特的需求和目标。
Bright Data 深受全球顶级品牌信赖
我们通过安全、可扩展且灵活的数据管理,助力企业增长。
 我推荐任何公司使用 Bright Data 的产品,尤其是金融行业。Bright Data 是值得信赖的合规公司、 服务一流,产品完美无瑕,网络快速稳定。
 Xiaolong ShiBitget 的爬虫工程师
- Bright Data 拥有自有代理基础设施,助您持续获取网络数据。此外,他们的网页解锁工具还能帮助您轻松绕过烦人的验证码(CAPTCHA)。点击观看
 Nicholas Renotte数据科学专家
 根据我的使用体验,Bright Data 的服务价值不可估量。Bright Data 帮助我们采集了充足的公共网络数据以满足需求,并通过其支持团队和开发团队,让我们对许多流程进行了优化。
 Charmagne Cruz—— Shopee Philippines Inc. 报告与分析、业务技术与定价负责人
- 最重要的是拥有质量最好、数量最多的数据,而这正是 Bright Data 和 tgndata 发挥作用的地方。点击观看
 George Koutsoudopoulostgndata 的首席执行官 (CEO)
我们对 Bright Data 的可靠性印象深刻,对整体服务也非常满意。我们与客户经理保持着定期沟通,他的协助对我们非常有帮助。
 Yorgos PanzarisConvert Group 的 CTO
 我们对与 Bright Data 的合作感到非常满意。各方面都很不错,网络非常稳定,而我们对其客户服务和支持团队也非常认可。
 Cheddi RaiAdRetreaver CEO
LLM 爬虫 API 常见问题
什么是 LLM 爬虫 API?
LLM 爬虫 API 是一款功能强大的工具,旨在自动从 LLM 网站提取数据,让用户能够针对各种应用场景高效采集和处理海量数据。
LLM 爬虫 API 如何工作?
LLM 爬虫 API 通过向 LLM 网站发送自动请求、提取所需数据点并以结构化格式交付数据来工作。此流程可确保数据采集准确而快速。
LLM 爬虫 API 可以采集哪些数据点?
LLM 爬虫 API 可以采集的数据点包括:查询 ID、查询文本、回复 ID、完整回复内容、用户 ID、对话 URL、来源、引用、时间戳、关键词排名等。
LLM 爬虫 API 是否符合数据保护法规?
是的,LLM 爬虫 API 的设计符合包括 GDPR 和 CCPA 在内的数据保护法规,可确保所有数据采集活动都以合乎道德且合法的方式进行。
我可以使用 LLM 爬虫 API 进行竞争分析吗?
当然可以!LLM 爬虫 API 非常适合竞争分析,可帮助您深入了解竞争对手的活动、趋势和策略。
如何将 LLM 爬虫 API 与我的现有系统集成?
LLM 爬虫 API 可与各种平台和工具无缝集成。您可以将其与现有的数据管道、CRM 系统或分析工具搭配使用,以增强数据处理能力。
LLM 爬虫 API 有哪些使用限制?
LLM 爬虫 API 没有特定的使用限制,让您可以根据需要灵活扩展。价格低至每条记录 0.001 美元,确保您的网页抓取项目能够以高性价比实现扩展。
你们是否为 LLM 爬虫 API 提供支持?
是的,我们为 LLM 爬虫 API 提供专属支持。我们的支持团队全天候待命,协助您解决使用 API 时可能遇到的任何问题。
有哪些可用的交付方式?
Amazon S3、Google Cloud Storage、Google PubSub、Microsoft Azure Storage、Snowflake 和 SFTP。
有哪些可用的文件格式?
JSON、NDJSON、JSON Lines、CSV 和 .gz 文件(压缩文件)。