Yahoo Finance 提供免费的报价、价格历史、财务报表和分析师预期,但没有官方 API。其报价页面将这些数据以 JSON 形式嵌入 HTML,因此 Python 管道无需浏览器即可读取。
许多旧教程中的代码会以两种方式失败。使用默认 User-Agent 时,Python 的 requests 库在第一次请求时就会收到 429 Too Many Requests。即使请求成功,旧选择器也匹配不到任何内容,或者匹配到的是标普 500 指数的价格,而不是股票价格。
本指南将介绍如何从这些 JSON 中爬虫 Yahoo Finance 数据、避免 429 错误,以及如何将流程迁移到服务器。
简要说明
- Yahoo 在第一次请求时返回 429 取决于客户端,而不是请求速率。通过模拟 Chrome,curl_cffi 请求了 503 个标普 500 指数成分股的报价页面,没有遇到任何 429。
- 一次请求即可返回某个股票代码的完整价格历史。当 period1=0 时,MSFT 的历史数据选项卡返回了自 1986 年以来的所有日线数据。
- 验证每个页面,即使它返回 200。Meta 的旧股票代码 FB 返回的是一只 ProShares ETF,而 Vodafone 的伦敦市场价格以便士计价。
- 只需替换获取函数,即可迁移到服务器。Bright Data 的网络解锁器 API 提供 IP 轮换和自动重试功能。或者,Bright Data 的 Yahoo Finance 抓取工具 API 可返回结构化记录。
Yahoo Finance 将数据存放在哪里
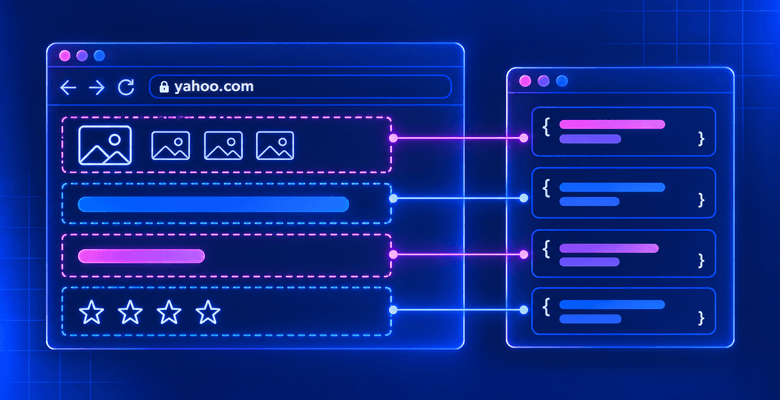
报价页面上的数字以 JSON 形式嵌入其 HTML。Yahoo 使用 JavaScript 框架 SvelteKit 在服务器端渲染页面,并在渲染期间调用自己的 JSON API。SvelteKit 会将每个响应内联到 HTML 中因此浏览器无需再次获取即可复用。每个响应都位于单独的 script 标签中,该标签具有 data-sveltekit-fetched 属性,并在 data-url 中包含源 API URL。
MSFT 摘要选项卡中的一个标签如下所示,其中 JSON 正文已缩短:
<script type="application/json" data-sveltekit-fetched
data-url="https://query1.finance.yahoo.com/v1/finance/quoteType/MSFT?formatted=true&enablePrivateCompany=true&overnightPrice=true&lang=en-US&region=US"
data-hash="1ibomen" data-ttl="1800">
{"status":200,"statusText":"","headers":{"cache-control":"public, max-age=1800, stale-while-revalidate=1800"},"body":"{\"quoteType\":{\"result\":[{\"symbol\":\"MSFT\",\"quoteType\":\"EQUITY\",\"exchange\":\"NMS\",\"longName\":\"Microsoft Corporation\"}],\"error\":null}}"}
</script>body 字段以 JSON 字符串形式包含 API 响应。解析一个标签需要调用两次 json.loads()。第一次调用解析包装对象,第二次调用解析 body 字符串。报价页面的每个选项卡都会嵌入不同的一组 API 响应:
| 选项卡 | 嵌入的 API 响应 | 可从中读取的内容 |
|---|---|---|
/quote/MSFT/ |
v10/finance/quoteSummary 和 v7/finance/spark |
价格、市值、市盈率、股息、52 周区间、分析师目标价,以及最多 24 小时的 5 分钟收盘价 |
/quote/MSFT/history/ |
v8/finance/chart |
每日、每周或每月价格、复权收盘价、拆股和股息 |
/quote/MSFT/financials/、balance-sheet/、cash-flow/ |
ws/fundamentals-timeseries |
年度和过去 12 个月的明细项目 |
/quote/MSFT/analysis/ |
包含 earningsTrend 的 v10/finance/quoteSummary |
每股收益和营收预期、分析师人数、盈利超预期情况 |
/quote/MSFT/key-statistics/ |
ws/fundamentals-timeseries |
季度市值、企业价值和估值比率 |
/quote/MSFT/profile/ |
包含 assetProfile 的 v10/finance/quoteSummary |
主要高管、员工人数、行业和 SEC 文件 |
/quote/MSFT/holders/ |
包含持股模块的 v10/finance/quoteSummary |
机构、基金和内部人士持股情况 |
/quote/MSFT/options/ |
v7/finance/options |
最近到期日的期权链,以及到期日列表 |
Yahoo 的 API 主机 query1.finance.yahoo.com 和 query2.finance.yahoo.com 提供相同的 JSON,开源 yfinance 库会直接调用它们。在这些主机上,如果请求中没有 crumb,quote、quoteSummary 和 options 端点会返回 401。crumb 是 Yahoo 随每个会话 Cookie 签发的令牌,并要求将其作为 crumb= 查询参数传递。
旧版 CSV 下载接口返回了 401 User is not logged in。在两个 API 主机上,robots.txt 都禁止访问所有路径(Disallow: /)。嵌入报价页面的响应不需要 Cookie、crumb,也不需要访问 API 主机:
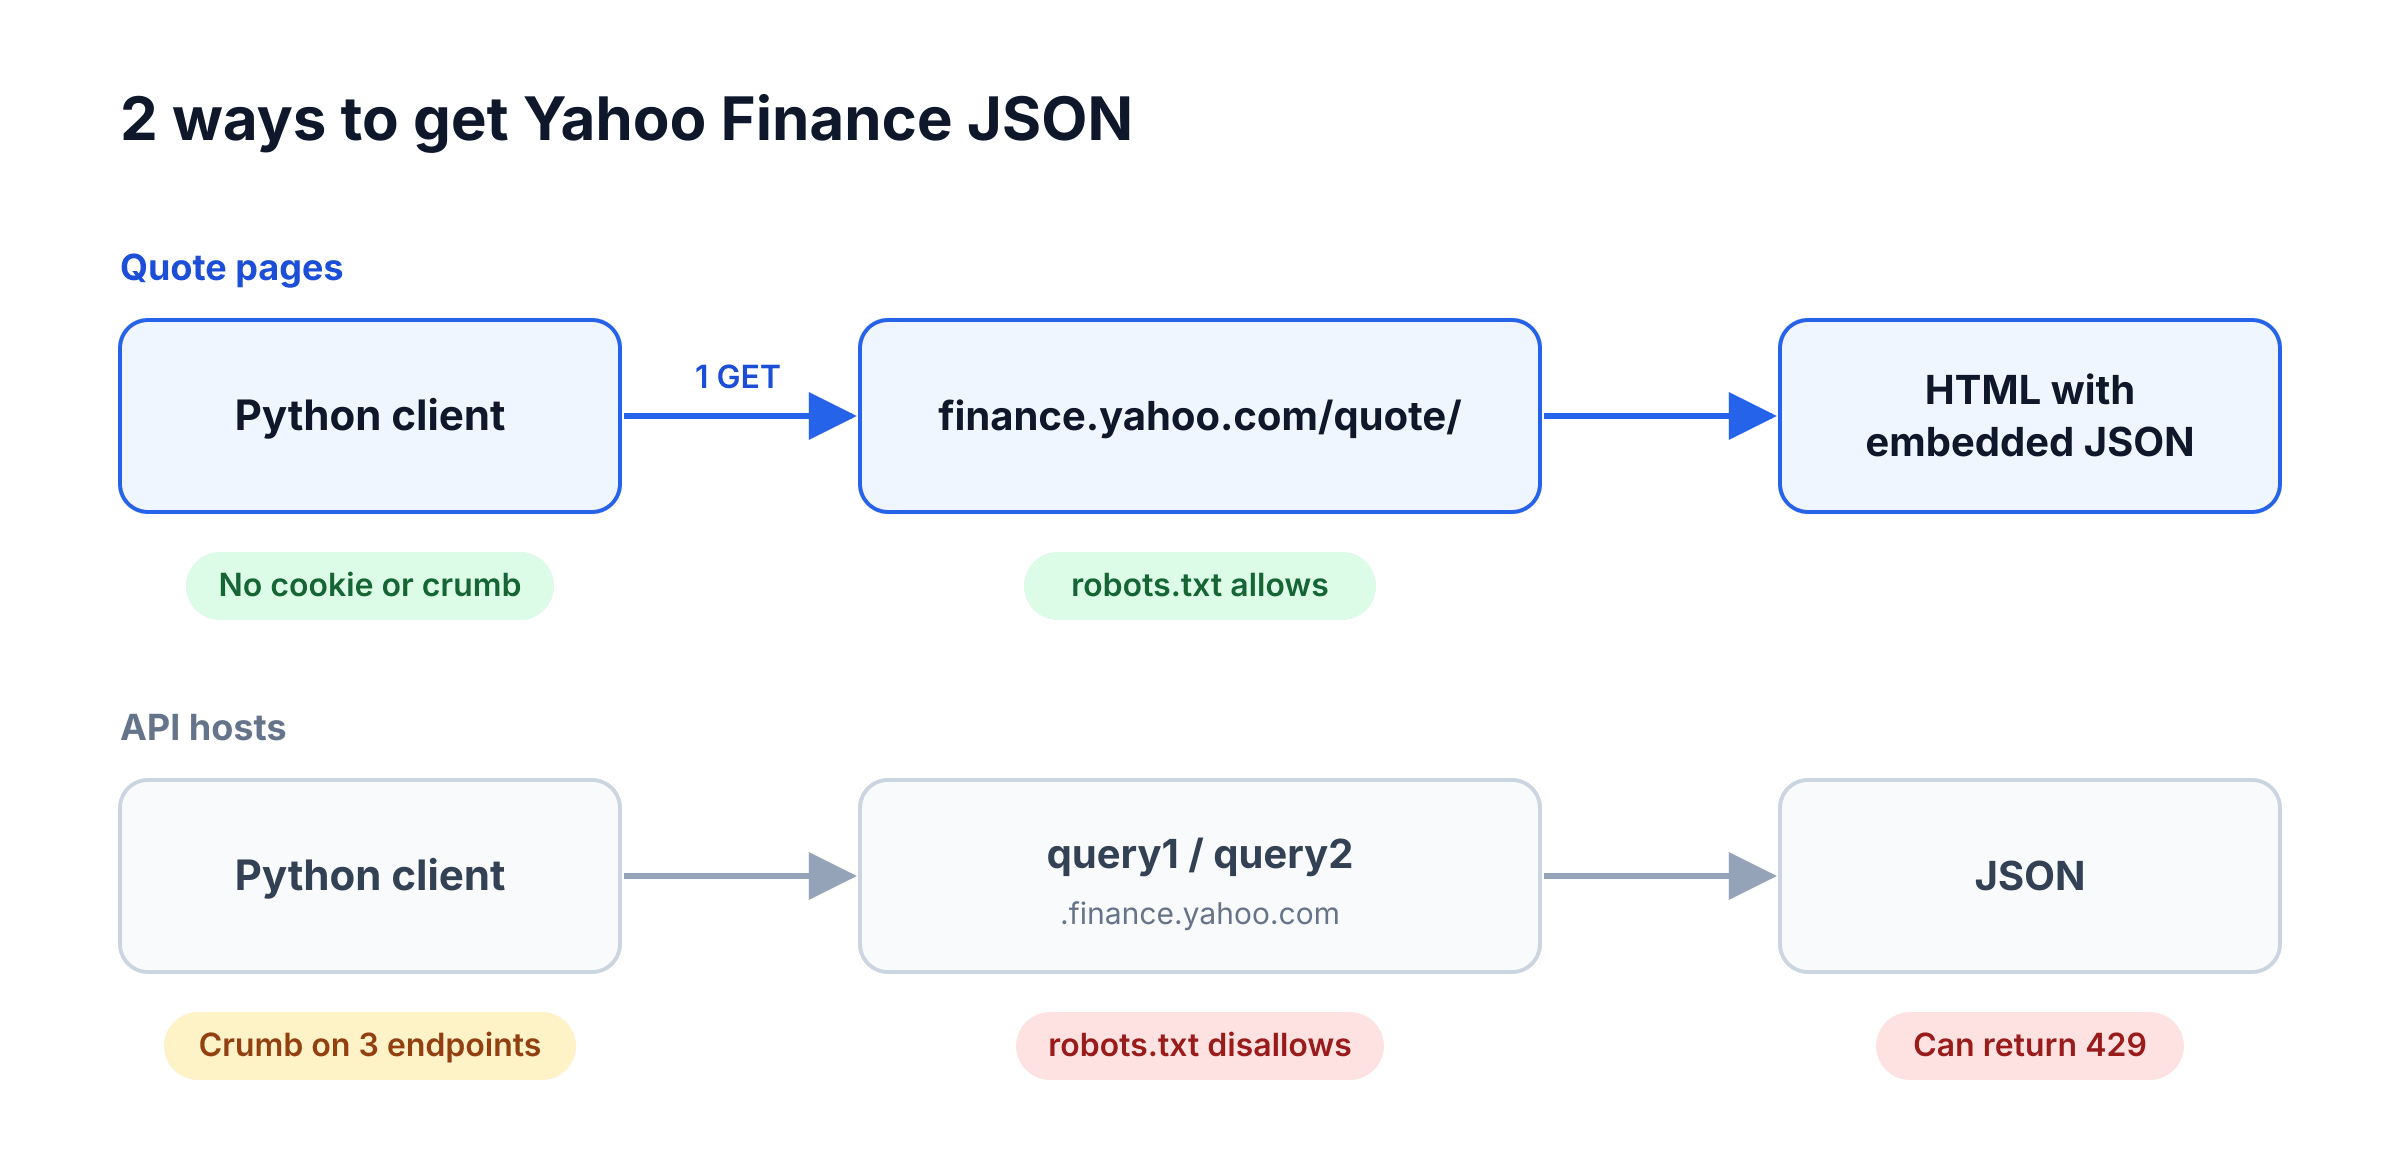
这些脚本只读取报价页面,因此从不调用 API 主机。
许多旧教程使用已经失效的 CSS 选择器读取价格。在 MSFT 页面上[data-symbol="MSFT"][data-field="regularMarketPrice"] 和 #quote-summary [data-test="PREV_CLOSE-value"] 匹配到 0 个元素。限定较少的 fin-streamer[data-field="regularMarketPrice"] 选择器匹配到 9 个元素,而第一个匹配项包含页面市场摘要中的标普 500 指数价格。
其他教程会自动化浏览器。对于报价、每日历史、年度报表和预期数据,嵌入式 JSON 使浏览器不再必要,因为每个选项卡只需 1 个 HTTP 请求即可返回相同数据。
如果你使用浏览器,请读取原始 HTML 响应,因为 SvelteKit 的客户端代码会在读取后删除每个 script 标签。在 4 次测试页面加载中,有 2 次 page.content() 返回的页面不含这些标签。其中 1 次,爬虫在 DOMContentLoaded 触发后立即读取了页面。
为什么 Yahoo Finance 会在第一次请求时返回 429
Yahoo 的响应取决于客户端的 User-Agent 和 TLS 握手,因此客户端可能在第一次请求时就收到 429。响应中的 server: ATS 标头表明其使用 Apache Traffic Server。采用默认设置时,Python 的 requests 库在第一次请求时就收到了 429。429 响应有两种形式:
- 使用默认
python-requests/2.34.2User-Agent 时,下表中的每个 TLS 栈都收到一个 23 字节的Edge: Too Many Requests响应。Python 的 requests 库在finance.yahoo.com上也收到相同响应。 - 在 API 主机上,某些通过 Python TLS 栈发送的浏览器 User-Agent 会收到一个 19 字节的
Too Many Requests响应。
下表显示了 yfinance 使用的 API 主机 query1 如何响应从 1 个住宅网络连接发出的图表请求,各请求之间至少间隔 1.5 秒。Python HTTP 客户端库 curl_cffi 可以模拟浏览器的 TLS 握手。每一行都将一个 TLS 栈与一个 User-Agent 标头配对:
| TLS 栈 | User-Agent 标头 | 收到 429 |
|---|---|---|
| Python requests(OpenSSL) | python-requests/2.34.2默认值 |
5 次中有 5 次 |
| Python requests(OpenSSL) | macOS 上的 Chrome 140 | 26 次中有 26 次 |
| Python requests(OpenSSL) | Windows 上的 Firefox 147 | 17 次中有 16 次 |
| Python requests(OpenSSL) | macOS 上的 Safari 26 | 11 次中有 8 次 |
| Python requests(OpenSSL) | macOS 上的 Chrome 150 | 6 次中有 3 次 |
| Python requests(OpenSSL) | Windows 上的 Chrome 150 | 11 次中有 0 次 |
| Python requests(OpenSSL) | 仅 Mozilla/5.0 |
11 次中有 0 次 |
| curl_cffi(Chrome、Firefox 或 Safari 握手) | Chrome 140 或 150、Firefox 147、Safari 26 或 Mozilla/5.0 |
80 次中有 0 次 |
| curl_cffi(同样的 3 种握手) | python-requests/2.34.2 |
15 次中有 15 次 |
为什么 TLS 握手很重要?
即使 User-Agent 相同,Yahoo 的响应也取决于 TLS 栈。在一项受控测试中,requests 和 curl_cffi 从同一 IP 地址通过 HTTP/1.1 发送了相同的 User-Agent(macOS 上的 Chrome 140)和 Accept 标头。唯一变化的是 HTTP 客户端及其 TLS 栈。通过 Python 的 requests 库发送的 8 次请求全部失败,而通过 curl_cffi 的 Chrome TLS 栈发送的 8 次请求全部成功。
这两个栈甚至在发送任何标头之前就已经有所不同。JA4 指纹是一种常见的 TLS 指纹识别形式,它概括了 ClientHello,也就是客户端在 TLS 握手中发送的第一条消息。Python 的 OpenSSL 握手生成 t13d1812h1_85036bcba153_b26ce05bbdd6curl_cffi 的 chrome 目标生成 t13d1516h2_8daaf6152771_806a8c22fdea后者与 Chrome 的密码套件相匹配。用你自己的客户端请求 https://tls.peet.ws/api/all即可查看它发送的内容。
每个结果都取决于 TLS 栈和 User-Agent 的组合。仅使用 Mozilla/5.0 字符串通过 Python TLS 发送时,11 次全部成功。macOS 上的 Chrome 140 在 26 次请求中全部失败,而 Firefox 147 在 17 次请求中失败了 16 次。因此,真实的浏览器 User-Agent 反而可能让 Python 的 requests 库更容易失败。
使用 curl_cffi 提供的浏览器 TLS 握手时,表中的浏览器 User-Agent 在 80 次请求中全部成功。在一项规模较小的测试中finance.yahoo.com 本身接受了通过 Python TLS 发送的 Chrome 140 字符串,但拦截了默认的 python-requests 字符串。爬虫代码在 finance.yahoo.com 上也使用 curl_cffi,因此 User-Agent 和 TLS 握手都与 Chrome 匹配。
如果你发送浏览器的 User-Agent,也要同时发送浏览器的 TLS 握手。
请求速率重要吗?
对于首次请求时出现的 429 并不重要,因为这类错误取决于客户端。使用 8 个线程时,curl_cffi 请求了全部 503 个标普 500 指数成分股报价页面,随后又请求了 501 个历史数据页面,没有遇到任何 429。这相当于每日刷新一次标普 500 指数成分股的请求量。如果在更高请求量下出现 429,爬虫代码会退避并重试。
yfinance 问题跟踪器中发布的一个限速代码片段将流量限制为每分钟 60 个请求、每小时 360 个请求、每天 8,000 个请求。这些数字来自 Yahoo DSP Traffic API 的速率限制页面。Yahoo DSP 是一个用于购买广告的需求方平台,因此该代码片段使用的是另一个产品的限制。
yfinance 库也曾从 Yahoo 收到 429 错误,并将其作为 YFRateLimitError('Too Many Requests. Rate limited. Try after a while.') 抛出。在一个有关 429 错误的问题讨论串收到 140 多条评论后,yfinance 维护者采用了相同的解决方案:使用浏览器的 TLS 握手。0.2.58 版(2025 年)将该库迁移到 curl_cffi,而 1.7.0 版使用 impersonate="chrome" 创建默认会话。
这些代码可以在云服务器上运行吗?
可以,我们在 3 个使用 Microsoft Azure IP 地址的 GitHub Actions 运行器上进行了测试。在每个运行器上,curl_cffi 的首次请求都成功返回了 20 个股票代码各自的报价页面,涵盖美国股票、ETF、加密货币和海外上市证券。在第二轮运行中,每个运行器都请求了全部 503 个标普 500 指数成分股报价页面,没有遇到 429。
这些脚本返回的历史数据、报表和预期数据与从家庭网络运行时相同。在这些运行器上,使用默认 User-Agent 的 Python requests 库收到了相同的 23 字节 429 响应,而 yfinance 成功获取了 MSFT 的完整每日历史。
已报告的云端故障涉及较旧的客户端和共享 IP 范围,因此在安排定时任务之前,请先从你自己的服务器测试这些脚本。2025 年,在 yfinance 迁移到 curl_cffi 之前,其维护者因无法从 Yahoo 获取数据而移除了 GitHub Actions 测试任务。另一位开发者将 401“Invalid Crumb”响应追溯到云平台 Render 的共享免费套餐 IP 范围。相同调用从住宅 IP 发出时可以正常工作。
从报价页面提取嵌入式 JSON
你需要 Python 3.11 或更高版本以及 5 个软件包。代码已在 Python 3.11、3.13 和 3.14 上测试,使用的版本包括 curl_cffi 0.16.3、beautifulsoup4 4.15.0、lxml 6.1.3、pandas 3.0.6 和 requests 2.34.2。使用 pip 安装它们:
pip install curl_cffi beautifulsoup4 lxml pandas requests有关 Python 抓取基础知识,请参阅我们的 Python 网页爬虫指南。核心模块会获取单个选项卡,检查 Yahoo 是否返回了报价页面,并返回以其 API URL 为键的嵌入式响应。将其保存为 yahoo_embedded.py因为读取 Yahoo 页面数据的脚本依赖它:
import json
import random
import threading
import time
from urllib.parse import quote

from bs4 import BeautifulSoup
from curl_cffi import requests

QUOTE_URL = "https://finance.yahoo.com/quote"
_local = threading.local()


class SymbolNotFound(Exception):
    """Yahoo returned its lookup page or a soft 404 instead of a quote page."""


def page_url(symbol: str, tab: str = "") -> str:
    return (
        f"{QUOTE_URL}/{quote(symbol.upper(), safe='')}/{tab}"  # ^GSPC becomes %5EGSPC
    )


def embedded(html: str) -> dict[str, dict]:
    """Map the API URLs the page was rendered from to their JSON bodies."""
    soup = BeautifulSoup(html, "lxml")
    found = {}
    for tag in soup.select('script[type="application/json"][data-sveltekit-fetched]'):
        try:
            wrapper = json.loads(tag.string)
            found[tag["data-url"]] = json.loads(wrapper["body"])
        except (TypeError, KeyError, ValueError):
            continue  # an embedded response whose body isn't JSON
    return found


def pick(found: dict[str, dict], path: str) -> dict:
    """Return the first embedded response whose URL contains `path`."""
    for url, body in found.items():
        if path in url:
            return body
    raise LookupError(f"no embedded response for {path}")


def is_quote_page(html: str, symbol: str) -> bool:
    """True for a quote page, False otherwise, SymbolNotFound for an unknown symbol."""
    found = embedded(html)
    if any("/v1/finance/lookup" in url for url in found):
        raise SymbolNotFound(symbol)
    for url, body in found.items():
        if "/v1/finance/quoteType/" in url:
            result = (body.get("quoteType") or {}).get("result") or [{}]
            if not result[0].get("exchange"):
                # A soft 404, as for BRK.B (Yahoo spells it BRK-B)
                raise SymbolNotFound(symbol)
            return True
    return False


def _session() -> requests.Session:
    # One Chrome-impersonating session per thread, as curl_cffi recommends.
    if not hasattr(_local, "session"):
        _local.session = requests.Session(impersonate="chrome")
    return _local.session


def fetch_page(
    symbol: str, tab: str = "", params: dict | None = None, attempts: int = 4
) -> str:
    """Return the HTML of a quote page, for example tab="history/"."""
    for attempt in range(attempts):
        if attempt:
            time.sleep(2**attempt + random.random())  # back off before each retry
        try:
            response = _session().get(
                page_url(symbol, tab), params=params, timeout=30, allow_redirects=False
            )
        except requests.RequestException:
            continue  # timeout or dropped connection
        if response.is_redirect:
            location = response.headers.get("location", "")
            if "/lookup" in location:
                raise SymbolNotFound(symbol)
            # For example, a tab that doesn't exist
            raise LookupError(f"{symbol} {tab}: Yahoo redirected to {location}")
        if response.status_code == 200 and is_quote_page(response.text, symbol):
            return response.text
        if 400 <= response.status_code < 500 and response.status_code != 429:
            response.raise_for_status()
    # Every attempt timed out or got a 429, a 5xx, or a page without quote data
    raise RuntimeError(f"{symbol} {tab}: no quote data after {attempts} attempts")


if __name__ == "__main__":
    from urllib.parse import urlsplit

    found = embedded(fetch_page("MSFT"))
    print(len(found), "embedded responses")
    for url in found:
        if url.startswith("https://"):
            print(urlsplit(url).netloc, urlsplit(url).path)
该模块会处理 3 种边界情况:
allow_redirects=False会让客户端在重定向处停止,而不是继续跟随。302 重定向到/lookup/表示股票代码未知,因此模块会抛出SymbolNotFound。它不会获取 robots.txt 禁止访问的查找页面。任何其他重定向(例如 ETF 不具备的选项卡)都会在第一次尝试时抛出LookupError。is_quote_page()会检查quoteType响应,因为仅有 200 状态并不能证明页面包含数据。MSFT 的全部 11 个选项卡都嵌入了该响应,包括news/。不带交易所信息的quoteType表示软 404,也就是状态为 200 但没有报价数据的页面。Yahoo 为BRK.B返回了这种页面,因为其股票代码应拼写为BRK-B。quote(symbol.upper(), safe='')会将股票代码转为大写,并对^GSPC等指数代码进行百分号编码,因为^在编码前不是有效的 URL 字符。
对于 MSFT,该模块会列出页面调用的 Yahoo API:
23 embedded responses
query1.finance.yahoo.com /ws/obi-integration/v1/premiumTiersMeta
query1.finance.yahoo.com /v1/finance/quoteType/MSFT
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v6/finance/quote/marketSummary
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v6/finance/recommendationsbysymbol/MSFT
query1.finance.yahoo.com /v6/finance/markettime
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v10/finance/quoteSummary/MSFT
query1.finance.yahoo.com /v1/finance/trending/US
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v1/finance/screener/predefined/saved
摘要选项卡中的统计数据来自 v10/finance/quoteSummary对于 MSFT,其中 17 个模块共包含约 223 KB 的 JSON。列表显示了 13 个绝对 API URL,另外 10 个响应来自 Yahoo 自己的 /xhr/ 端点。这 23 个响应中的大多数为热门股票代码和市场摘要等页面组件提供数据。数量会有所变化:从美国云端运行器访问时,同一页面嵌入了 26 个响应,额外响应中包括 price-insights。
解析价格、估值和评级字段
quoteSummary 中的许多数值都是 {"raw": 516.17, "fmt": "516.17"} 对,因此辅助函数会保留原始值。此函数返回 20 个报价字段。将其保存为 quote_summary.py因为预期数据脚本和批处理脚本会复用它:
import json

from yahoo_embedded import embedded, fetch_page, pick


def raw(module: dict, key: str):
    """Many numbers are {"raw": 516.17, "fmt": "516.17"} pairs. Keep the raw value."""
    value = module.get(key)
    return value.get("raw") if isinstance(value, dict) else value


def quote_summary(symbol: str, fetch=fetch_page) -> dict:
    found = embedded(fetch(symbol))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    price = result.get("price", {})
    detail = result.get("summaryDetail", {})
    stats = result.get("defaultKeyStatistics", {})
    analysts = result.get("financialData", {})
    return {
        "symbol": price.get("symbol"),
        "name": price.get("longName") or price.get("shortName"),
        "quote_type": price.get("quoteType"),
        "currency": price.get("currency"),
        "price": raw(price, "regularMarketPrice"),
        "change_pct": raw(price, "regularMarketChangePercent"),
        "market_time": raw(price, "regularMarketTime"),
        "market_state": price.get("marketState"),
        "delay_minutes": price.get("exchangeDataDelayedBy"),
        "market_cap": raw(price, "marketCap"),
        "trailing_pe": raw(detail, "trailingPE"),
        "forward_pe": raw(detail, "forwardPE"),
        "dividend_yield": raw(detail, "dividendYield"),
        "beta": raw(detail, "beta"),
        "week52_low": raw(detail, "fiftyTwoWeekLow"),
        "week52_high": raw(detail, "fiftyTwoWeekHigh"),
        "eps_ttm": raw(stats, "trailingEps"),
        "target_mean": raw(analysts, "targetMeanPrice"),
        "recommendation": analysts.get("recommendationKey"),
        "reporting_currency": analysts.get("financialCurrency"),
    }


if __name__ == "__main__":
    print(json.dumps(quote_summary("MSFT"), indent=2))
在一次收盘后,该函数为 MSFT 输出了全部 20 个字段的原始值:
{
  "symbol": "MSFT",
  "name": "Microsoft Corporation",
  "quote_type": "EQUITY",
  "currency": "USD",
  "price": 516.17,
  "change_pct": 0.0366316,
  "market_time": 1790366401,
  "market_state": "CLOSED",
  "delay_minutes": 0,
  "market_cap": 3832843862016,
  "trailing_pe": 28.739979,
  "forward_pe": 21.801512,
  "dividend_yield": 0.0076,
  "beta": 1.108,
  "week52_low": 349.2,
  "week52_high": 553.72,
  "eps_ttm": 17.96,
  "target_mean": 577.26135,
  "recommendation": "strong_buy",
  "reporting_currency": "USD"
}
摘要选项卡显示了相同数字的格式化形式,例如 3.833T 的市值、28.74 的市盈率和 0.76% 的股息收益率:
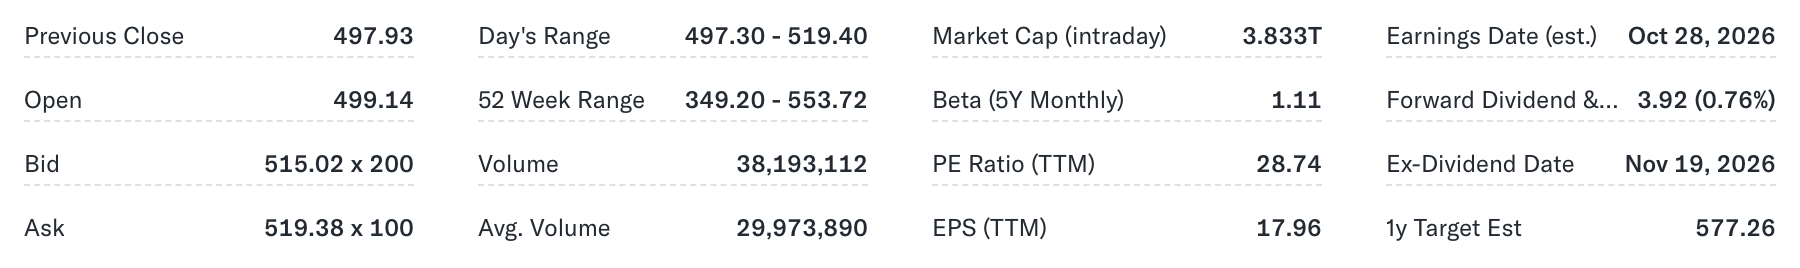
JSON 包含原始值,例如 3.833T 市值对应的 3832843862016。
在原始值中,百分比以小数表示,因此 change_pct 为 0.0366316 表示变动 3.66%dividend_yield 为 0.0076 表示 0.76%。该函数使用 .get() 读取每个模块,因为不同资产类型嵌入的模块有所不同。SPY、^GSPC、BTC-USD 和 EURUSD=X 都能在没有 financialData 模块的情况下返回价格,因此其分析师字段为 None。SPY 则包含 fundProfile 和 topHoldings。
通过 1 次请求下载完整价格历史
历史数据选项卡(history/)会将其自身 URL 中的 period1、period2 和 frequency 参数传递给它嵌入的图表请求。两个 period 参数都是 Unix 时间戳,因此将 period1 设为 0 会请求自 1970 年 1 月 1 日以来的所有数据柱。日期选择器随后会从该日期开始,而 frequency=1d 会显示每日数据行:
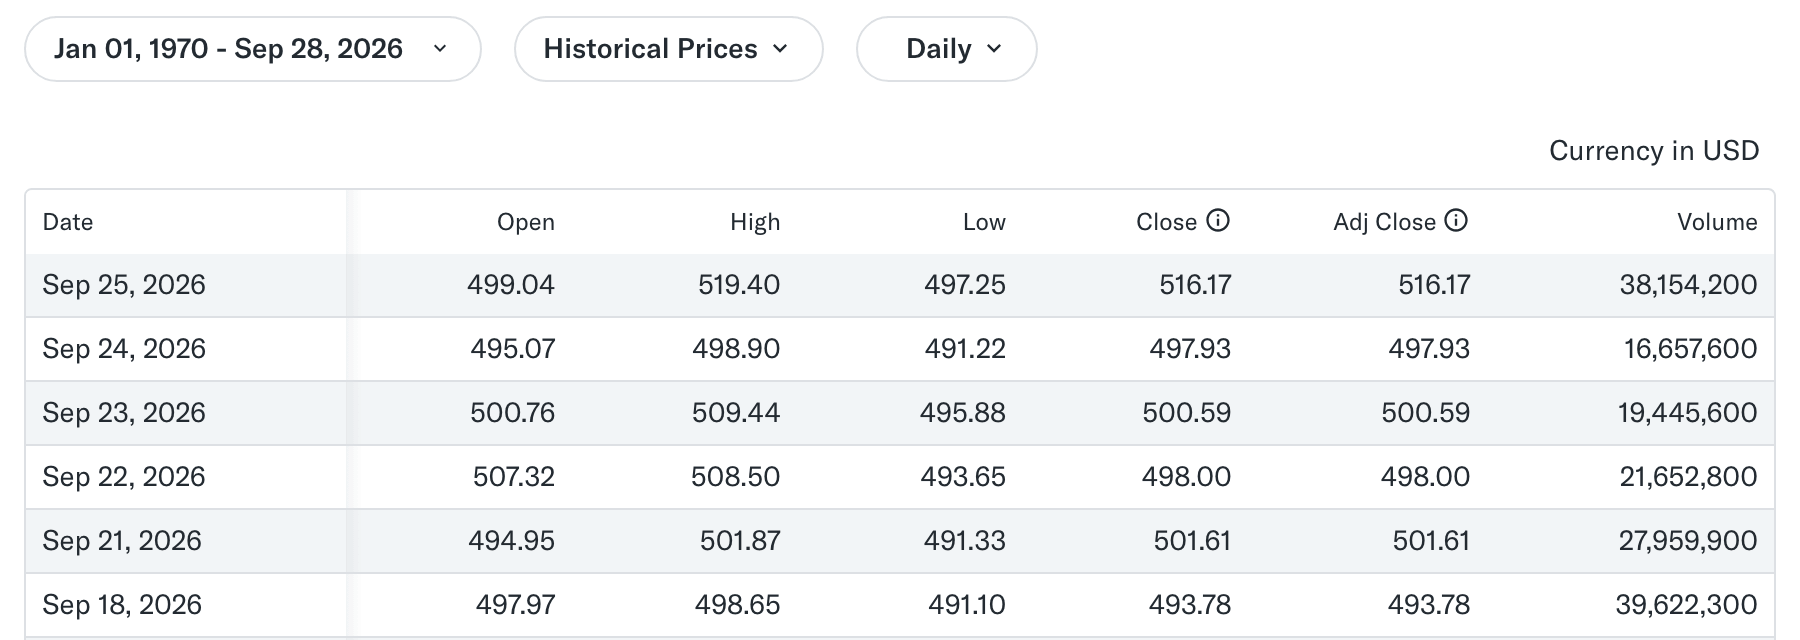
表格中的最新一行与下方 price_history() 输出的最后一行相匹配。
price_history() 函数将嵌入的图表响应转换为 DataFrame,并以交易所时区中的日期作为索引。将其保存为 price_history.py:
import time

import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def price_history(
    symbol: str, frequency: str = "1d", fetch=fetch_page
) -> tuple[pd.DataFrame, dict]:
    """Every bar since 1970 at 1d, 1wk or 1mo, plus split and dividend events."""
    params = {"period1": 0, "period2": int(time.time()), "frequency": frequency}
    found = embedded(fetch(symbol, "history/", params))
    result = pick(found, "/v8/finance/chart/")["chart"]["result"][0]
    bars, meta = result["indicators"]["quote"][0], result["meta"]
    utc = pd.to_datetime(result["timestamp"], unit="s", utc=True)
    index = utc.tz_convert(meta["exchangeTimezoneName"]).tz_localize(None).normalize()
    frame = pd.DataFrame(
        {
            "open": bars["open"],
            "high": bars["high"],
            "low": bars["low"],
            "close": bars["close"],
            "adj_close": result["indicators"]["adjclose"][0]["adjclose"],
            "volume": bars["volume"],
        },
        index=index,
    )
    if frequency != "1d" and result["timestamp"][-1] == meta.get("regularMarketTime"):
        frame = frame.iloc[:-1]  # Yahoo appends the latest session as an extra bar
    return frame.dropna(how="all"), result.get("events", {})


if __name__ == "__main__":
    history, events = price_history("MSFT")
    print(history.tail(3).round(2).to_string())
    print(
        f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
        f"to {history.index[-1]:%Y-%m-%d}"
    )
    splits = sorted(
        pd.Timestamp(s["date"], unit="s").date()
        for s in events.get("splits", {}).values()
    )
    if splits:
        print(f"{len(splits)} splits, the last one on {splits[-1]}")
一次请求就返回了 MSFT 的完整历史:
              open    high     low   close  adj_close    volume
2026-09-23  500.76  509.44  495.88  500.59     500.59  19445600
2026-09-24  495.07  498.90  491.22  497.93     497.93  16657600
2026-09-25  499.04  519.40  497.25  516.17     516.17  38154200
10,213 daily bars from 1986-03-13 to 2026-09-25
9 splits, the last one on 2003-02-18
通过 API 主机,yfinance 为该范围返回了相同的 10,213 根数据柱。在历史数据管道中需处理以下 5 个细节:
- 在测试中,历史数据最早只能追溯到 1970 年。Yahoo 的历史数据帮助页面指出,价格通常不会早于该年份。可口可乐自 1919 年起就已上市交易,但其完整历史始于 1970-01-02。负数
period1会返回 404。 frequency支持1d、1wk和1mo。使用1wk和1mo时,Yahoo 会将最近一个交易日作为额外数据柱附加到末尾,而该函数会将其删除。删除这根数据柱后,最终的周线或月线数据可能不包含最近一个交易日,因此应从日线数据中获取近期收盘价。1h、5m和1m等日内周期返回的却是日线数据。摘要选项卡通过/v7/finance/spark嵌入最多 24 小时的 5 分钟收盘价。它还会为市场摘要嵌入第二个 spark 响应,因此应选择symbols参数与你的股票代码匹配的响应。报价页面仅包含这 24 小时的日内数据,因为更长时间范围的日内历史来自 robots.txt 禁止访问的 API 主机。- Yahoo 会针对拆股调整
close并针对拆股和股息调整adj_close。每次发生新的拆股或派息后,旧数据柱都会发生变化,因此每次下载时都应保存拆股和股息事件。 - 页面大小会随日期范围增长。使用完整日期范围时,MSFT 的历史数据选项卡包含 4.9 MB HTML,而摘要选项卡约为 1.1 MB。对于每日刷新,请将
period1设为近期时间戳,并在每次发生新的拆股或派息后重新下载完整范围。
获取财务报表和分析师预期
报表和预期位于不同的选项卡,因此各自需要单独的函数。
获取年度财务报表
财务报表来自财务、资产负债表和现金流选项卡上的 fundamentals-timeseries 响应。在 MSFT 的财务选项卡中,该响应包含 96 个年度序列和 96 个过去 12 个月序列。statement() 会保留年度序列,并将其透视为每个财年一列的表格。将其保存为 statements.py:
import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def statement(symbol: str, tab: str = "financials/", fetch=fetch_page) -> pd.DataFrame:
    """Annual line items from the financials/, balance-sheet/ or cash-flow/ tab."""
    found = embedded(fetch(symbol, tab))
    series = pick(found, "/fundamentals-timeseries/")["timeseries"]["result"]
    rows = []
    for item in series:
        name = item["meta"]["type"][0]  # for example "annualTotalRevenue"
        if not name.startswith("annual"):
            continue  # skip non-annual series, such as trailing 12 months
        for point in item.get(name) or []:
            if point:
                rows.append(
                    {
                        "line_item": name.removeprefix("annual"),
                        "fiscal_year_end": point["asOfDate"],
                        "value": point["reportedValue"]["raw"],
                    }
                )
    table = pd.DataFrame(rows).pivot(
        index="line_item", columns="fiscal_year_end", values="value"
    )
    return table.sort_index(axis=1)


if __name__ == "__main__":
    income = statement("MSFT")
    billions = (
        income.loc[["TotalRevenue", "GrossProfit", "OperatingIncome", "NetIncome"]].T
        / 1e9
    )
    billions["DilutedEPS"] = income.loc["DilutedEPS"]
    print(billions.round(2).to_string())
    print(f"{len(income)} line items")
该脚本输出了 4 个财年的损益表,除每股收益外,其他数值均以十亿美元为单位:
line_item        TotalRevenue  GrossProfit  OperatingIncome  NetIncome  DilutedEPS
fiscal_year_end
2023-06-30             211.92       146.05            88.52      72.36        9.68
2024-06-30             245.12       171.01           109.43      88.14       11.80
2025-06-30             281.72       193.89           128.53     101.83       13.64
2026-06-30             331.84       225.46           155.24     133.75       17.95
47 line items
在财务选项卡上,Yahoo 以千为单位显示相同数字,因此输出中的 331.84B 营收会显示为 331,839,000:
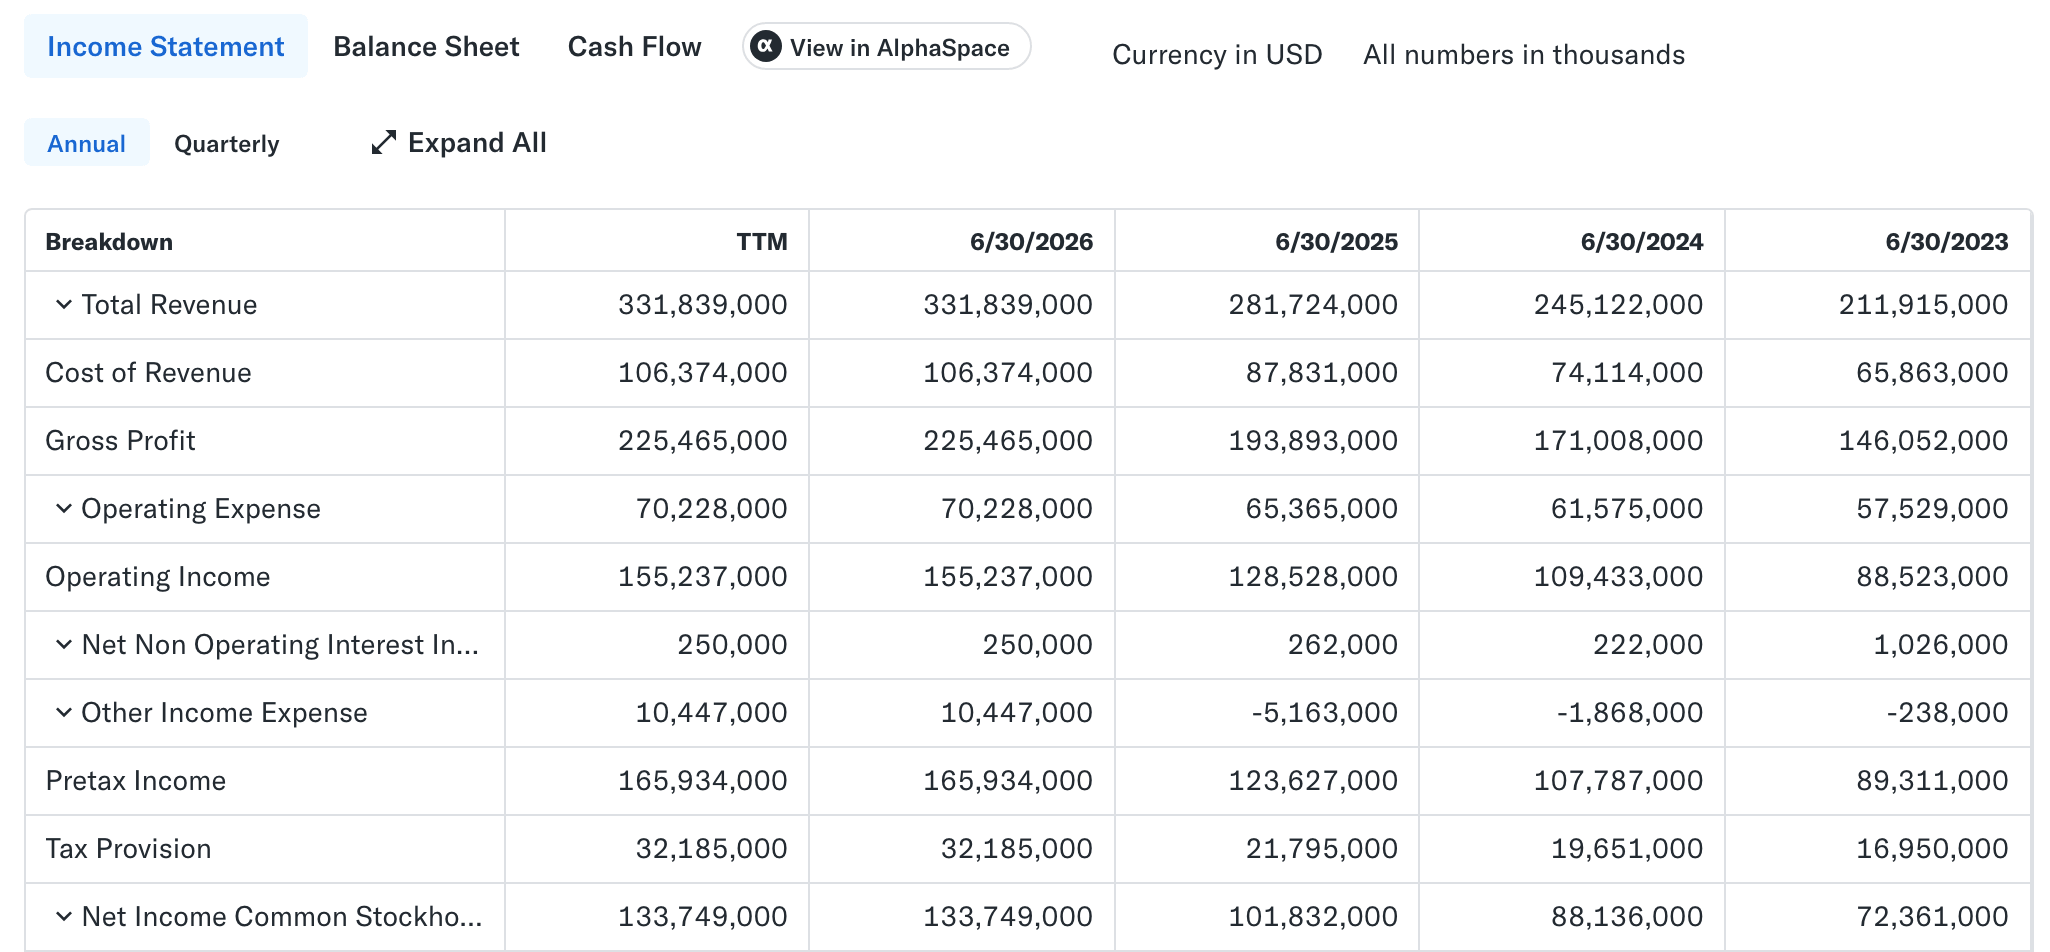
损益表、资产负债表和现金流视图分别对应 statement() 读取的 financials/、balance-sheet/ 和 cash-flow/ 选项卡。
对于 MSFT,96 个年度序列中有 47 个包含数值。空序列包括保险索赔、优先股股息和消费税等明细项目。在这 4 年中,该函数从 balance-sheet/ 返回了 79 个明细项目,从 cash-flow/ 返回了 59 个明细项目。季度报表只有在选择 Quarterly 切换项后才会加载,测试的 URL 参数均无法改变这一点。
跳过 quoteSummary 中的 incomeStatementHistory 和 balanceSheetHistory 模块。无论是年度版还是季度版,其损益行都只有总营收和净利润包含实际值。资产负债表行则只有日期。其他收入字段使用 0 作为占位符,因此信任这些字段的解析器会错误地存储毛利润为 0。
获取分析师预期
分析选项卡嵌入了 earningsTrend其中包含当前季度、下一季度、当前年度和下一年度的每股收益与营收共识预期。estimates() 会将其展开为每个期间一行。将其保存为 estimates.py:
import pandas as pd

from quote_summary import raw
from yahoo_embedded import embedded, fetch_page, pick


def estimates(symbol: str, fetch=fetch_page) -> pd.DataFrame:
    """Consensus EPS and revenue for the current and next quarter and year."""
    found = embedded(fetch(symbol, "analysis/"))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    rows = []
    for period in result["earningsTrend"]["trend"]:
        eps, revenue = period["earningsEstimate"], period["revenueEstimate"]
        revenue_avg = raw(revenue, "avg")
        rows.append(
            {
                "period": period["period"],  # 0q, +1q, 0y, +1y
                "ends": period["endDate"],
                "eps_avg": raw(eps, "avg"),
                "eps_low": raw(eps, "low"),
                "eps_high": raw(eps, "high"),
                "eps_analysts": raw(eps, "numberOfAnalysts"),
                "revenue_avg_bn": None if revenue_avg is None else revenue_avg / 1e9,
                "revenue_analysts": raw(revenue, "numberOfAnalysts"),
            }
        )
    return pd.DataFrame(rows).set_index("period")


if __name__ == "__main__":
    print(estimates("MSFT").round(2).to_string())
对于 MSFT,每项预期都来自 25 至 51 位分析师:
              ends  eps_avg  eps_low  eps_high  eps_analysts  revenue_avg_bn  revenue_analysts
period
0q      2026-09-30     4.72     4.43      4.83            25           90.66                38
+1q     2026-12-31     4.82     4.72      5.02            25           95.49                37
0y      2027-06-30    19.76    19.21     20.70            33          391.04                50
+1y     2028-06-30    23.68    22.08     26.00            32          467.27                51
在分析选项卡上,Earnings Estimate 表显示了相同的每股收益数据。其 Current Qtr.、Next Qtr.、Current Year 和 Next Year 列分别对应 0q、+1q、0y 和 +1y 行:
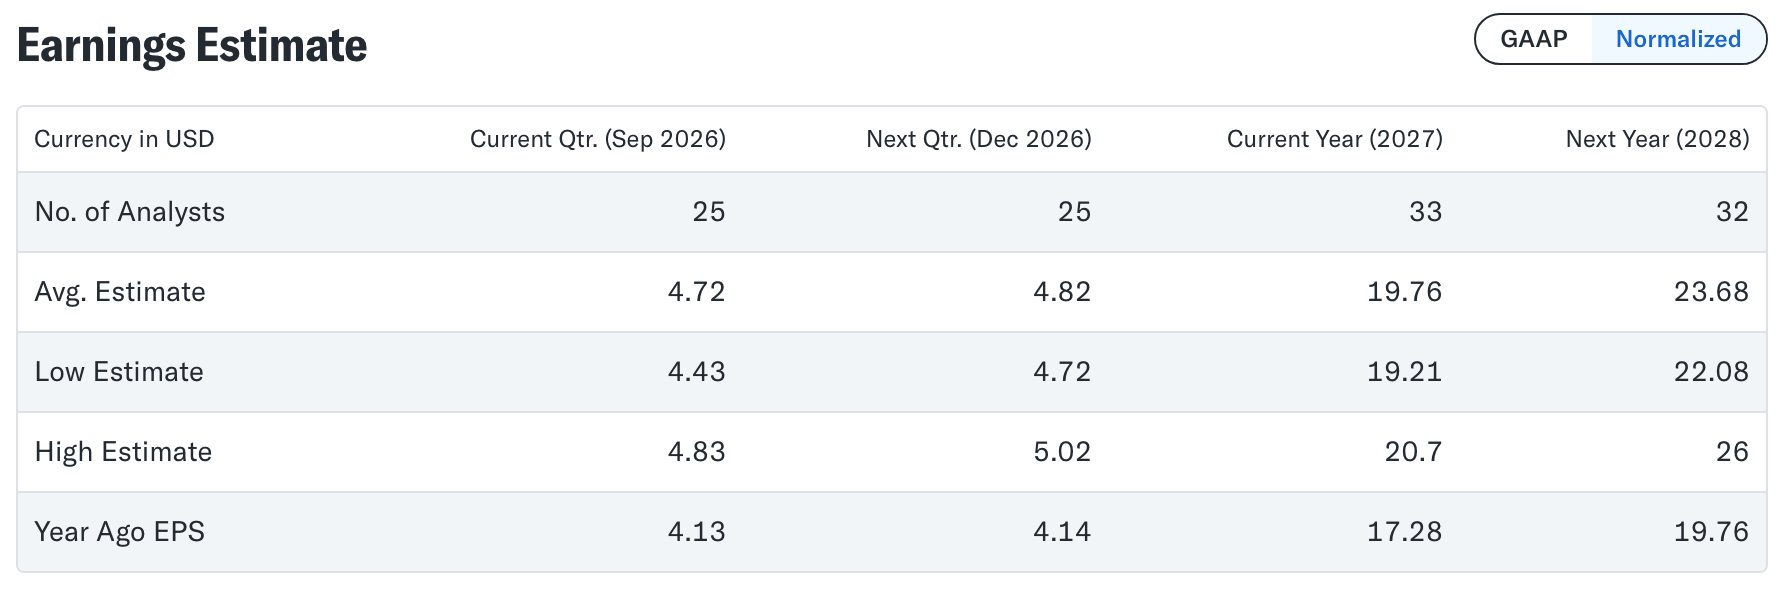
表格的 Normalized 视图显示了与 earningsTrend 中相同的数字。
同一请求还会返回每个期间的 epsTrend 和 epsRevisions以及包含最近 4 个已报告季度及其超预期百分比的 earningsHistory。
爬虫数百个股票代码的 Yahoo Finance 数据
许多生产环境的股票代码列表都包含旧代码、指数和海外上市证券,因此批处理脚本必须报告问题并继续运行。将下一个脚本保存为 batch.py。它默认运行 8 个线程,分别收集缺失和失败的股票代码,并转换次级货币单位:
from concurrent.futures import ThreadPoolExecutor

import pandas as pd

from quote_summary import quote_summary
from yahoo_embedded import SymbolNotFound, fetch_page

# Yahoo quotes many London, Johannesburg, and Tel Aviv prices in minor units.
# Market cap stays in major units.
MINOR_UNITS = {"GBp": ("GBP", 100), "ZAc": ("ZAR", 100), "ILA": ("ILS", 100)}
PRICE_FIELDS = ("price", "week52_low", "week52_high", "target_mean")


def to_major_units(row: dict) -> dict:
    unit = MINOR_UNITS.get(row["currency"])
    if unit is None:
        return row
    currency, divisor = unit
    prices = {key: row[key] / divisor for key in PRICE_FIELDS if row[key] is not None}
    return {**row, **prices, "currency": currency}


def collect(symbols: list[str], fetch=fetch_page, workers: int = 8):
    """Quote rows for many symbols, plus the symbols that were missing or failed."""
    # " msft" and "MSFT" are the same ticker
    symbols = list(dict.fromkeys(s.strip().upper() for s in symbols))
    missing, failed = [], {}

    def one(symbol: str) -> dict | None:
        try:
            return to_major_units(quote_summary(symbol, fetch=fetch))
        except SymbolNotFound:
            missing.append(symbol)
        except Exception as error:  # keep the batch running, report at the end
            failed[symbol] = repr(error)
        return None

    with ThreadPoolExecutor(max_workers=workers) as pool:
        rows = [row for row in pool.map(one, symbols) if row]
    return pd.DataFrame(rows), missing, failed


if __name__ == "__main__":
    tickers = "AAPL MSFT SQ ^GSPC SPY BTC-USD 7203.T SAP.DE VOD.L NPN.JO".split()
    table, missing, failed = collect(tickers)
    cols = "symbol price currency market_cap delay_minutes reporting_currency".split()
    print(table[cols].to_string(index=False))
    print("missing:", missing, "| failed:", failed)
一个包含 10 个股票代码的混合列表在 2.5 秒内处理完成:
 symbol     price currency   market_cap  delay_minutes reporting_currency
   AAPL   341.070      USD 4.977637e+12              0                USD
   MSFT   516.170      USD 3.832844e+12              0                USD
  ^GSPC  7743.410      USD          NaN              0                NaN
    SPY   771.350      USD          NaN              0                NaN
BTC-USD 85011.320      USD 1.707212e+12              0                NaN
 7203.T  2989.500      JPY 3.540116e+13             20                JPY
 SAP.DE   185.920      EUR 2.145897e+11             15                EUR
  VOD.L     1.258      GBP 2.907280e+10             15                EUR
 NPN.JO   709.380      ZAR 5.307029e+11             15                USD
missing: ['SQ'] | failed: {}
批处理将 SQ 报告为缺失,因为 Block, Inc. 已将其股票代码改为 XYZ。Yahoo 会将旧代码重定向到其查找页面,但被重新使用的股票代码会无声地失败。Meta 的旧代码 FB 返回了一只状态为 200 的 ProShares ETF,因此应将每个 name 与你的股票代码列表进行比较。FB 报价页面看起来与任何其他报价页面没有区别:
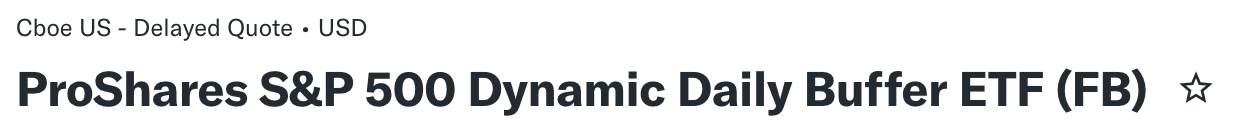
被重新使用的股票代码会返回正常报价页面,因此名称是识别变化最明确的线索。
检查单位、货币和延迟
仅检查状态码无法发现另外 3 个问题:
- 次级货币单位。Yahoo 将 VOD.L 的价格报告为 125.8
GBp(便士),而其市值为 290.7 亿英镑。NPN.JO 的价格为 70,938ZAc(分)。to_major_units()只会换算价格字段,因此市值仍保留主要货币单位。 - 报告货币。报表数值使用公司的报告货币,时间序列数据点会在
currencyCode字段中包含该货币。Vodafone(VOD.L)以便士交易,但使用欧元报告;Naspers(NPN.JO)以兰特交易,但使用美元报告。比率可能混用这两种货币。TEVA.TA 的远期市盈率为 43.5,而其纽约上市证券 TEVA 的远期市盈率为 12.9。Yahoo 用 TEVA.TA 的谢克尔价格除以了美元计价的每股收益预期。 - 交易所延迟。美国上市证券和比特币的
delay_minutes为 0。Xetra、伦敦和约翰内斯堡报价延迟 15 分钟,东京报价延迟 20 分钟。在跨交易所比较价格之前,应为每一行保留delay_minutes和market_time。
运行更大规模的批处理
使用默认的 8 个线程时collect() 从住宅网络连接处理全部 503 个标普 500 指数成分股耗时 74 秒,没有遇到 429 或重试。只有 BRK.B 和 BF.B 缺失,因为 Wikipedia 的标普 500 指数成分股列表使用点号拼写它们,而 Yahoo 使用 BRK-B 和 BF-B。将 period1 设置为 7 天前后,全部 501 份历史数据在 48 秒内完成刷新。页面大小中位数不到 1 MB,而 MSFT 的完整历史页面为 4.9 MB。
借助指数退避fetch_page() 已经会重试超时、429、5xx 响应和不含报价数据的页面。我们的 Python 失败请求重试指南介绍了如何使用 urllib3 的 Retry 和 Tenacity 实现退避。
如果你迁移到 asyncio,请先检查客户端对响应标头大小的限制。MSFT 摘要选项卡的响应包含约 37 KB 标头,其中包括一个 8,765 字节的 Content-Security-Policy 标头和一个 27,039 字节的 Link 标头。使用默认设置时,aiohttp 3.14.3 在 Yahoo 以状态 200 返回的页面上抛出了 ClientResponseError。其消息以 400, message='Got more than 8190 bytes when reading 开头。
将 max_field_size=65536 传递给 aiohttp.ClientSession 可修复该错误。httpx 和 curl_cffi 的 AsyncSession 均能使用默认设置处理该页面。我们的 requests、httpx 与 aiohttp 对比介绍了它们之间的其他权衡。
使用网络解锁器 API 从服务器运行相同的解析器
我们的网络解锁器 API接收 URL 并返回页面。它会在我们的服务器上处理 IP 轮换、验证码破解和自动重试,因此同一个解析器可以在你的服务器上运行,而解除封锁工作由我们维护。fetch_page_unlocker() 接收与 fetch_page() 相同的 symbol、tab 和 params 参数,因此 quote_summary()、price_history()、statement() 和 estimates() 都可以通过其 fetch 参数使用它。将其保存为 unlocker.py:
import os
from urllib.parse import urlencode

import requests

from yahoo_embedded import page_url

API_URL = "https://api.brightdata.com/request"


def fetch_page_unlocker(symbol: str, tab: str = "", params: dict | None = None) -> str:
    """Takes the same symbol, tab, and params as fetch_page(), via Web Unlocker API."""
    url = page_url(symbol, tab) + (f"?{urlencode(params)}" if params else "")
    response = requests.post(
        API_URL,
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={
            "zone": os.environ["BRIGHTDATA_UNLOCKER_ZONE"],
            "url": url,
            "format": "json",  # Yahoo's status, headers, and HTML, wrapped in JSON
            "country": "us",
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.json()["body"]
它会从 2 个环境变量中读取你的 API 密钥和网络解锁器 API 区域名称。区域是你账户中的命名产品配置。你可以在账户设置页面找到密钥,并在网络解锁器 API 快速入门中查看创建区域的步骤。区域创建后,其 Overview 选项卡会显示这两个值:
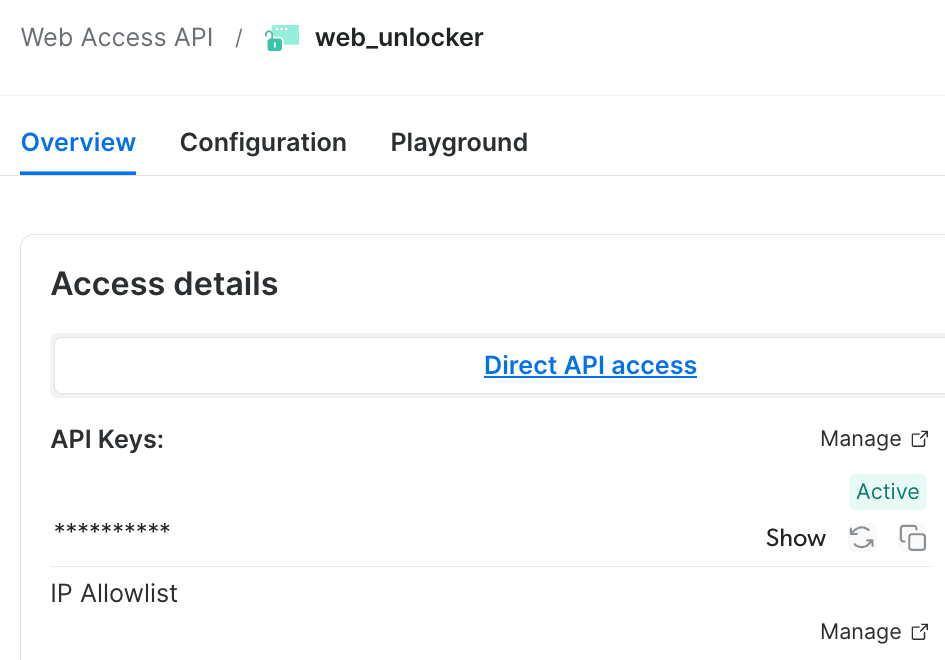
区域名称(此处为 web_unlocker)位于顶部,API Keys 下方的复制按钮可复制你的密钥。
运行下一个脚本前,请在 shell 中设置这两个值:
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_UNLOCKER_ZONE="your-zone-name"
要通过网络解锁器 API 路由 quote_summary()、price_history()、statement() 或 estimates()请将 fetch_page_unlocker 作为 fetch 参数传递。将此脚本保存为 unlocker_demo.py:
from price_history import price_history
from unlocker import fetch_page_unlocker

history, events = price_history("MSFT", fetch=fetch_page_unlocker)
print(
    f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
    f"to {history.index[-1]:%Y-%m-%d}"
)
它输出了与 price_history.py 相同的历史数据:
10,213 daily bars from 1986-03-13 to 2026-09-25一次请求就返回了完整的历史数据页面,解析器无需任何更改即可读取。批处理脚本也通过 collect(tickers, fetch=fetch_page_unlocker) 接受同一函数。
请注意以下 3 个细节:
- 使用
"format": "json"。这样,响应会在单个 JSON 对象中包含 Yahoo 的状态码、标头和完整 HTML。该函数会返回其body字段中的 HTML。 - 对特殊字符进行编码。
page_url()已经将^GSPC等指数代码百分号编码为%5EGSPC因此它构建的每个 URL 都有效。 - 或者使用我们的 Python SDK。使用
pip install brightdata-sdk安装brightdata-sdk并将response_format="json"传递给scrape_url()即可在获取页面的同时获得 Yahoo 的状态码。
每个选项卡都是一次单独请求,你只需为成功的请求付费。
通过 Yahoo Finance 爬虫工具 API 获取结构化记录
我们的 Yahoo Finance 抓取工具 API 会为每个股票代码返回一条结构化记录,并内置代理、解锁和重试功能。它是我们网页爬虫工具 API中的预构建爬虫工具。一条记录会整合摘要字段、公司简介、主要高管、年度财务数据和分析师目标价;爬虫产品页面会逐一列出这些字段。控制面板会显示爬虫的同步和异步模式,以及下方代码调用的端点:
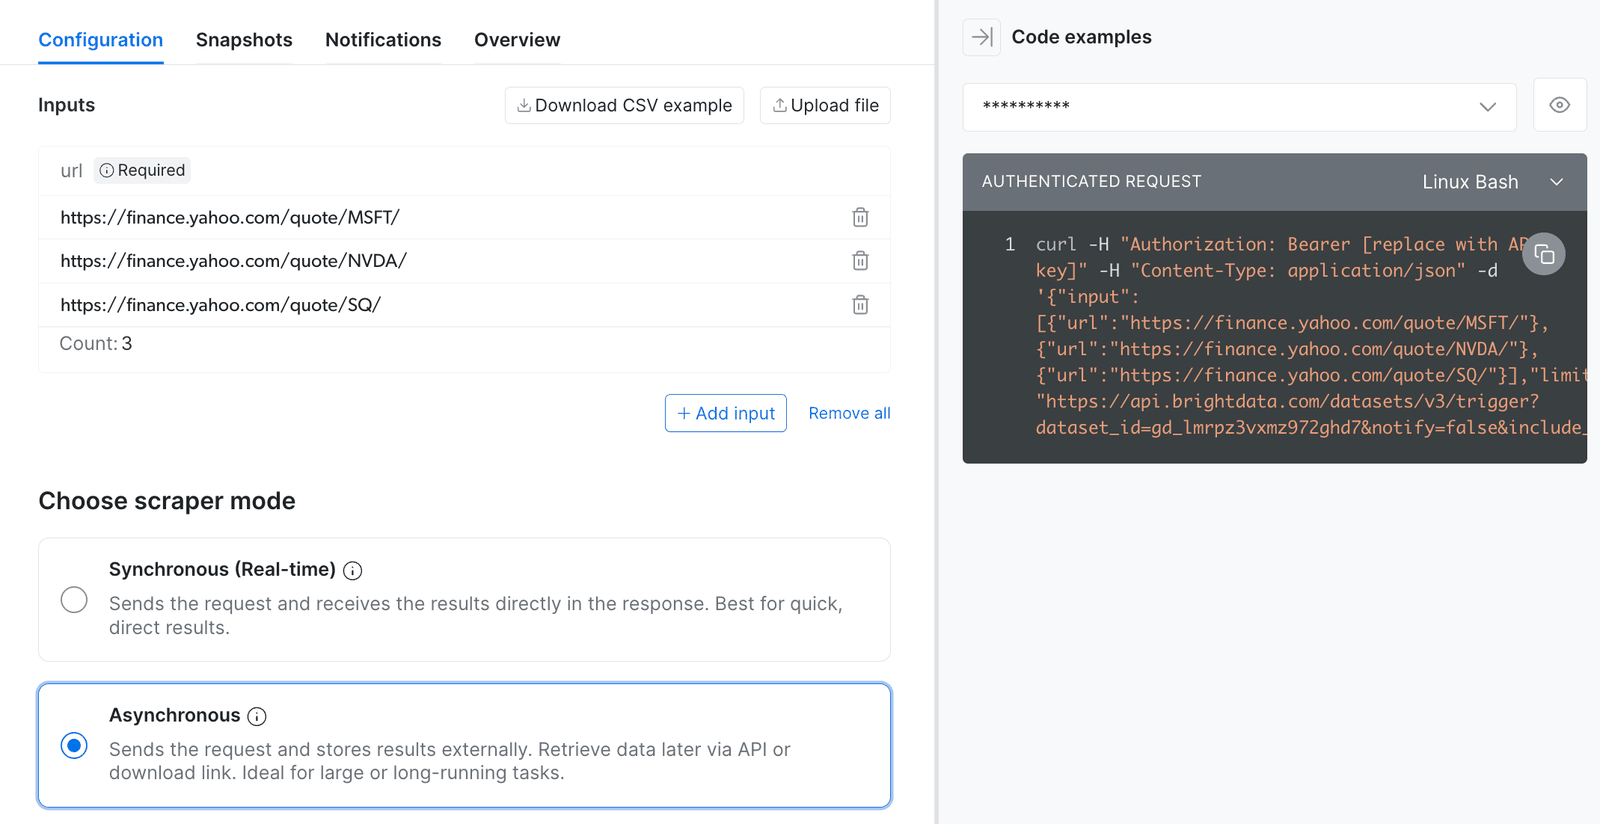
面板中的 curl 示例使用与 scraper_api.py 相同的报价 URL、触发端点和数据集 ID,而异步模式最适合定时批处理任务。
触发任务并下载记录
将下一个脚本保存为 scraper_api.py。它会为 URL 列表触发任务、轮询进度、下载记录,并报告 Yahoo 未列出的股票代码:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_lmrpz3vxmz972ghd7"  # Yahoo Finance business information
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
# The API returns only these fields, so the list keeps input, error, and error_code.
FIELDS = (
    "input|error|error_code|stock_ticker|closing_price|"
    "market_cap|pe_ratio|currency|timestamp"
)


def job_status(snapshot_id: str) -> str:
    progress = requests.get(
        f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60
    )
    return progress.json()["status"]


def run_batch(urls: list[str], poll_seconds: int = 30) -> list[dict]:
    """Trigger one collection job, wait until it's ready, and return its records."""
    trigger = requests.post(
        f"{API}/trigger",
        params={
            "dataset_id": DATASET_ID,
            "include_errors": "true",
            "custom_output_fields": FIELDS,
        },
        headers=HEADERS,
        json={"input": [{"url": url} for url in urls]},
        timeout=60,
    )
    trigger.raise_for_status()
    snapshot_id = trigger.json()["snapshot_id"]

    while job_status(snapshot_id) != "ready":
        time.sleep(poll_seconds)

    records = requests.get(
        f"{API}/snapshot/{snapshot_id}",
        params={"format": "json"},
        headers=HEADERS,
        timeout=300,
    )
    records.raise_for_status()
    return records.json()


def collect_records(urls: list[str]) -> tuple[list[dict], dict[str, str]]:
    """Run one job and split its records into results and per-URL errors."""
    records = run_batch(list(dict.fromkeys(urls)))  # drop duplicate URLs
    done = [record for record in records if not record.get("error")]
    errors = {
        record["input"]["url"]: f'{record.get("error_code")}: {record["error"]}'
        for record in records
        if record.get("error")
    }
    return done, errors


if __name__ == "__main__":
    urls = [f"https://finance.yahoo.com/quote/{s}/" for s in ("MSFT", "NVDA", "SQ")]
    records, errors = collect_records(urls)
    for record in records:
        print(record)
    print("errors:", errors)
它输出了 2 条记录和 1 个关于 SQ 的错误:
{'input': {'url': 'https://finance.yahoo.com/quote/MSFT/'}, 'stock_ticker': 'MSFT', 'closing_price': 516.17, 'market_cap': 3832843862016, 'pe_ratio': 28.739979, 'currency': 'USD', 'timestamp': '2026-09-27T16:15:44.789Z'}
{'input': {'url': 'https://finance.yahoo.com/quote/NVDA/'}, 'stock_ticker': 'NVDA', 'closing_price': 225.07, 'market_cap': 5434765213696, 'pe_ratio': 28.489874, 'currency': 'USD', 'timestamp': '2026-09-27T16:16:02.513Z'}
errors: {'https://finance.yahoo.com/quote/SQ/': 'dead_page: Target quote not found on lookup page'}
爬虫工具将 SQ 标记为 dead_page因为 Yahoo 会将 SQ 重定向到其查找页面,而 fetch_page() 在相同情况下会抛出 SymbolNotFound。
设置定时管道
将抓取工具 API 作为批处理任务运行。在每次触发调用中发送多个股票代码,然后轮询进度端点或等待 webhook。
同步 /scrape 端点会直接在响应中返回记录。对于耗时较长的任务,该端点会返回一个可供轮询的 snapshot_id详情请参阅同步 API 参考文档。
触发调用支持几项对定时管道很重要的设置。异步 API 参考文档列出了这些设置,控制面板也在爬虫 settings 下提供了相同选项:
- 错误报告。
include_errors=true会为任何没有结果的输入添加error和error_code例如 Yahoo 不再列出的股票代码。collect_records()会按 URL 报告这些输入。 - 输出字段。
custom_output_fields仅保留你列出的字段,各字段以|分隔,因此请添加input、error和error_code以保留错误报告。 - 记录限制。
limit_per_input限制每个输入的记录数limit_multiple_results限制每个任务的记录数。这两个限制都会控制 Discover by keyword 搜索的成本。 - 交付和 webhook。
endpoint会将记录发送到你的 webhook URL。notify=true会在任务完成时发送通知,因此调度程序无需轮询/progress。传递uncompressed_webhook=true可接收未压缩的 webhook 负载。面板中的 Delivery settings 也可以将结果写入 Amazon S3、Google Cloud Storage 或 Snowflake,详情请参阅数据交付文档。 - 计划任务。控制面板可以按周期计划运行相同的数据采集,例如每日刷新股票代码。
在更长的股票代码列表中,爬虫工具还将 MMC、BK 和 FI 标记为 dead_page。这些公司已分别将股票代码改为 MRSH、BNY 和 FISV。你只需为成功交付的记录付费。
按关键词搜索或从 CLI 运行
Discover by keyword 模式可以跨交易所和资产类型查找与关键词匹配的上市证券。WIX 查询找到了 Wix.com、Wickes Group(WIX.L)和 WIX 期权合约MSFT 查询还找到了 Microsoft 的多伦多上市证券和单一股票 ETF。可按 entity_type 和 stock_ticker 进行筛选,以保留你需要的上市证券。
Yahoo Finance 抓取工具 API 还可以在终端中通过 Bright Data CLI 以 brightdata pipelines yahoo_finance_business <url> 形式运行。通过 web_data_yahoo_finance_business 工具,AI 智能体可以获取你提供的报价 URL 对应的记录。启用其 finance 工具组后,该工具会在我们的 Yahoo Finance MCP 服务器上运行。
为你的管道选择合适的方法
首先免费读取报价页面,然后为定时服务器任务添加网络解锁器 API。对于结构化记录,请使用抓取工具 API 或 Yahoo Finance 数据集:
| 选项 | 最适合 | 你需要处理 | 定价 |
|---|---|---|---|
| yfinance | 根据其 README,适合个人研究 | 库更新、被封锁的 IP | 免费 |
| 使用 curl_cffi 的报价页面 | 每天从家庭网络或 GitHub Actions 运行器处理数百个股票代码 | 解析器、重试、被封锁的 IP | 免费 |
| 使用网络解锁器 API 的报价页面 | 读取任意选项卡的定时服务器任务 | 解析器 | 按成功请求计费 |
| 使用 Browser API 的 Playwright | 选择切换项后才显示的季度报表和其他数据 | 浏览器脚本、解析器 | 按流量 GB 计费 |
| Yahoo Finance 抓取工具 API | 按计划交付的已解析记录 | 输出字段列表 | 按交付记录计费 |
| Yahoo Finance 数据集 | 公司、基金和指数的现成文件 | 交付设置 | 按记录计费 |
要估算每月预算,请按每个选项卡、每个股票代码、每次刷新计算 1 次网络解锁器 API 请求。Yahoo Finance 抓取工具 API 每次刷新每个股票代码需要 1 条记录。将任一用量乘以网络解锁器 API 定价页面或网页爬虫工具 API 定价页面上的当前价格。
对于季度报表,Playwright 或 Puppeteer 脚本可以在我们的浏览器 API中选择财务选项卡的 Quarterly 切换项。它在云端运行 Chromium,并内置 CAPTCHA 破解和 JavaScript 渲染功能。我们的 Python 动态网站爬虫指南会逐步介绍该工作流。
我们的 Yahoo Finance 数据集将与抓取工具 API 相同类型的记录打包为现成的 JSON、NDJSON、CSV 或 Parquet 文件。它涵盖股票、共同基金、指数、ETF、货币和货币市场基金,因此可按 entity_type 筛选所需的资产类别。
你可以只获取包含所需数据点的子集,并按每日、每周、每月或自定义计划获取更新。每次交付可以只包含新增或更新的记录,并直接发送到 Amazon S3、Google Cloud、Azure、Snowflake 或 SFTP。数据集页面会显示当前记录数和定价,你可以在获取前下载 JSON 或 CSV 示例文件。
有关其他市场数据来源,请参阅我们的金融数据爬虫指南和 Google Finance 爬虫指南。我们的其他爬虫工具和数据集可提供更多股票数据及其他 Yahoo 结果:
- 股票市场爬虫工具从 Yahoo Finance、Google Finance 和 TradingView 等网站采集股票数据。
- Google Finance 爬虫工具和 TradingView 爬虫工具从这两个网站采集股票价格和市场趋势。
- Nasdaq 爬虫工具采集开盘价、收盘价和成交量等 Nasdaq 数据。
- Stocktwits 爬虫工具采集 Stocktwits 帖子、市场情绪和热门股票代码。
- 金融数据爬虫工具 API返回公司名称、股票代码、交易所和收盘价等字段。
- 股票市场数据集、股票价格数据集和金融数据集以现成文件形式交付公司简介、股票代码和价格。
- Google Finance 数据集、历史金融数据和金融新闻数据集以现成文件形式交付 Google Finance 数据、历史金融数据和金融新闻。
- Yahoo 新闻 API和 Yahoo 搜索 API返回 Yahoo 新闻和 Yahoo 搜索结果。
总结
Yahoo Finance 的报价页面以 JSON 形式包含自身的 API 响应,因此每个选项卡只需 1 次请求即可返回数据,无需浏览器、Cookie 或 crumb。在增加延迟之前,应先修正客户端,因为 Yahoo 在首次请求时返回 429 取决于客户端的 TLS 握手和 User-Agent。解析嵌入式响应、验证每个页面、将每个名称与你的股票代码列表进行比较,并在解析器中转换次级货币单位。
对于定时服务器任务,可通过网络解锁器 API 路由同一解析器,或者让 Yahoo Finance 抓取工具 API 返回结构化记录。我们的每月免费额度适用于这两种服务,因此你可以使用自己的股票代码列表试用任意一种。
常见问题
Yahoo Finance 有官方 API 吗?
没有。Yahoo 表示由于其数据提供商“目前不授权”以 API 形式重新分发数据,因此已禁用对报价数据的 API 访问。yfinance 使用的内部 API 主机没有文档记录,并在 robots.txt 中被禁止访问。Yahoo 的报价页面则会以 JSON 形式嵌入相同数据。
yfinance 仍然可用吗?
可以。从家庭网络和 3 个 GitHub Actions 运行器测试时,yfinance 在 1.5 秒内获取了 MSFT 的完整每日历史。它使用 curl_cffi 的 Chrome TLS 握手。其 README 将 Yahoo API 描述为“仅供个人使用”。开发者曾报告从某些云主机访问时出现 401 和获取失败,因此请从你自己的服务器进行测试。
Yahoo Finance 会阻止网页爬虫吗?
会,部分客户端会被阻止。Yahoo 在 Python 默认 requests 客户端的第一次请求时就将其封锁。使用 Chrome 的 TLS 握手时,curl_cffi 在住宅网络连接和 3 个 GitHub Actions 运行器上均未遇到 429。对于定时任务,Bright Data 的网络解锁器 API 会通过 IP 轮换和自动重试获取相同页面。
可以从 Yahoo Finance 下载数据吗?
可以,但 Yahoo 的帮助页面将 CSV 下载功能限制为付费 Yahoo Finance 订阅用户。在代码中,对历史数据选项卡的一次请求返回了 MSFT 自 1986 年以来的全部日线数据。对于批量文件,Bright Data 的 Yahoo Finance 数据集可按你选择的计划交付公司、基金和指数记录。
Yahoo Finance API 免费吗?
官方并未提供。调用 Yahoo 的内部端点无需付费,但这些端点没有文档记录,并且禁止爬虫访问。Yahoo 的帮助页面将 CSV 下载限制为付费订阅用户。Bright Data 的 Yahoo Finance 抓取工具 API 会返回结构化记录,新账户可获得每月免费额度用于测试。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。