Amazon Bedrock Knowledge Bases 是用于检索增强生成 (RAG) 的托管服务。将它指向一个数据源,它会对你的文档进行分块、嵌入和索引,然后用引用来源回答查询。它的连接器包括 Amazon S3、SharePoint,以及用于公开页面的原生 Web Crawler。
这个爬虫覆盖的是配合度高的 Web。许多产品目录、市场平台和新闻网站使用 JavaScript 渲染,位于机器人防护之后,或按国家/地区提供不同内容。爬虫返回的可能是一个空壳、一个拦截页面,或错误国家/地区的内容。本指南通过 Bright Data 和 S3 将这些页面送入知识库。
TL;DR
- 网络解锁器 在一次请求中将公开页面以 Markdown 形式返回,除非该页面需要交互。将每个页面写入 S3,保存为
.md并附带一个.metadata.json边车文件。 - 写入前先对内容进行哈希,这样刷新时只会重新嵌入你重写的页面,而不是整个语料库。
- 扩展之前先用黄金集衡量检索效果,因为分块设置在数据源上,而不可过滤的元数据键设置在 S3 Vectors 索引上。两者之后都无法更改。
- 按查询路由。当最高分低于相关性下限时,回退到实时查找。
为什么原生 Web Crawler 留下了缺口
Web Crawler data source 是第一方连接器,对于你自己的静态页面来说很合适。如今它的限制使得大规模公开 Web 数据更适合交给 Bright Data。
- 它支持静态网站。文档中直接说明了这一点,而且该爬虫不会检索客户端渲染的页面。许多目录、控制面板和列表页都是这样渲染的,所以爬虫看到的是本应出现数据的位置上的空壳。
- 它是为配合度高的 Web 构建的。该爬虫按 RFC 9309 遵守
robots.txt如果找不到该文件,就将站点视为不允许访问。它将自己标识为bedrockbot并且按设计会在机器人防护处停止。 - 它每次同步最多 25,000 个页面,并且支持一个向量存储。如果超过该限制,同步会失败且不会摄取任何内容。该存储目前是 Amazon OpenSearch Serverless,因此 S3 Vectors 不能与该爬虫一起使用。
- 它返回页面,而不是干净的记录。该爬虫摄取 HTML。导航、Cookie 横幅和样板内容会随正文一起进入,并且没有结构化提取步骤。你的分块会把噪声带入嵌入中。
在你选择 Web Crawler 的屏幕上,控制台将其标记为 Preview:
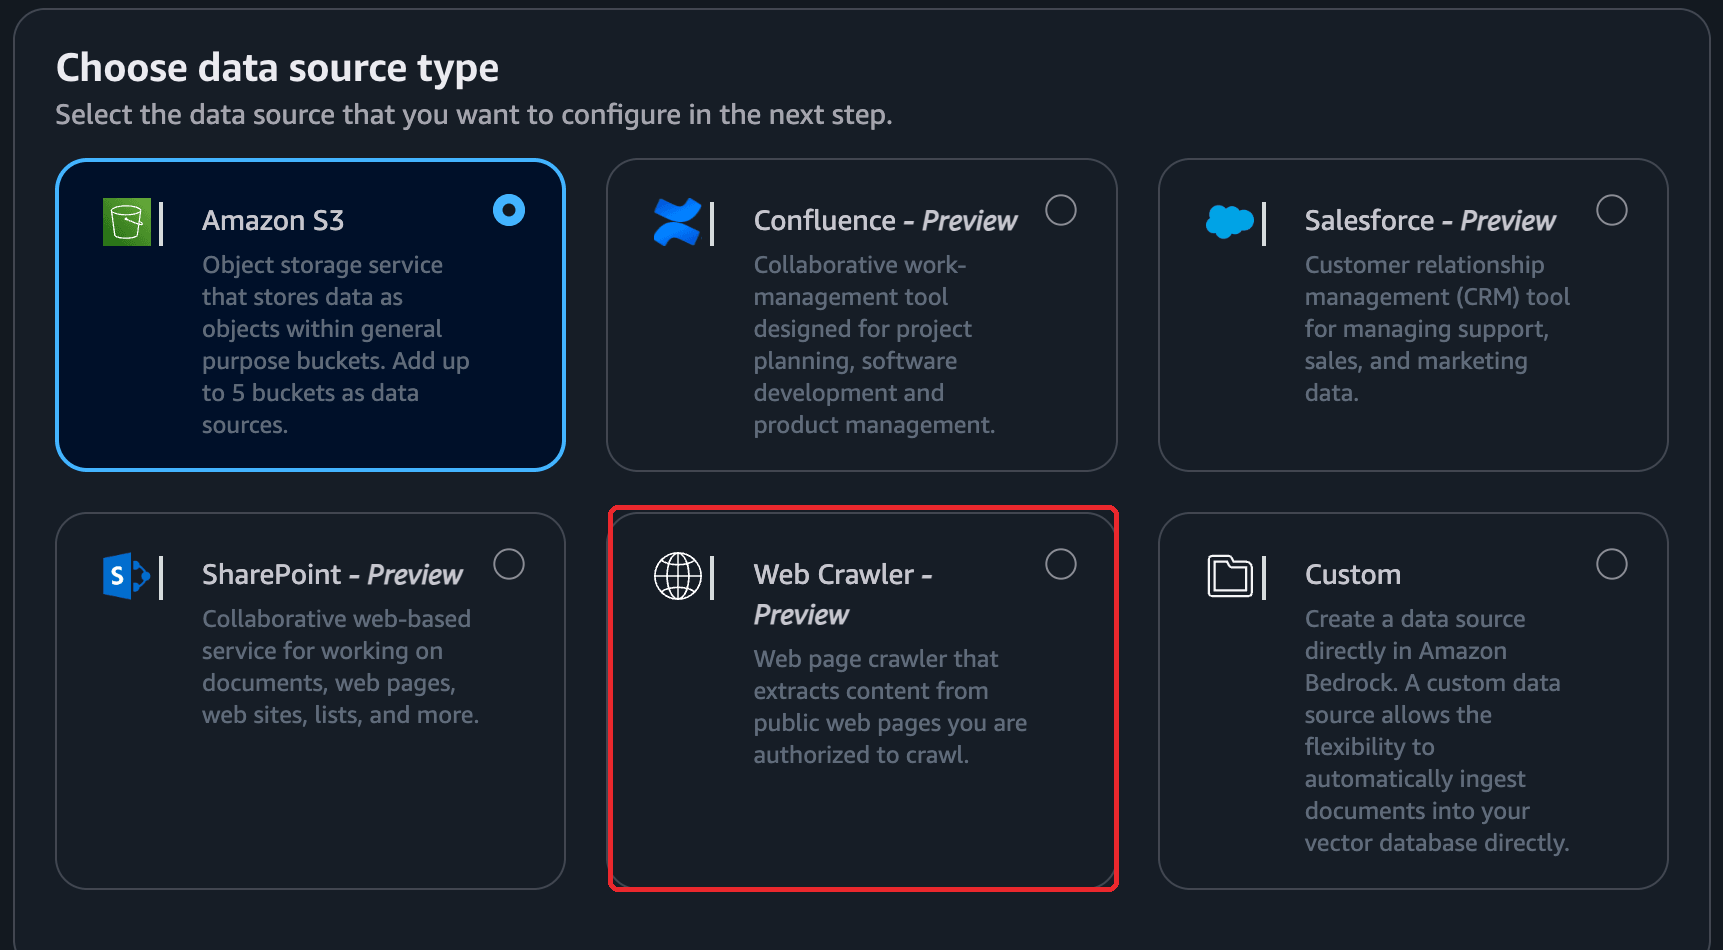
这些都不意味着对于它原本面向的静态、配合度高的页面来说,该爬虫是错误选择。在 Bright Data 的 Data for AI 2026 报告中,90% 的 AI 组织表示访问限制正在限制他们的计划。Cloudflare 在 2026 年 7 月重新分类了 AI 爬虫。它表示,从 2026 年 9 月 15 日起,对于新客户、新网站以及未变更的免费账户中的广告支持页面,默认会拦截混合用途爬虫。保持访问可用需要持续投入,而 Bright Data 会替你完成这些工作。
架构
该流水线将一组公开 URL 转换为可搜索、带引用的知识库,并保持其内容最新。Bright Data 负责访问和 Markdown 转换。S3 负责交接。Bedrock 负责索引和检索。
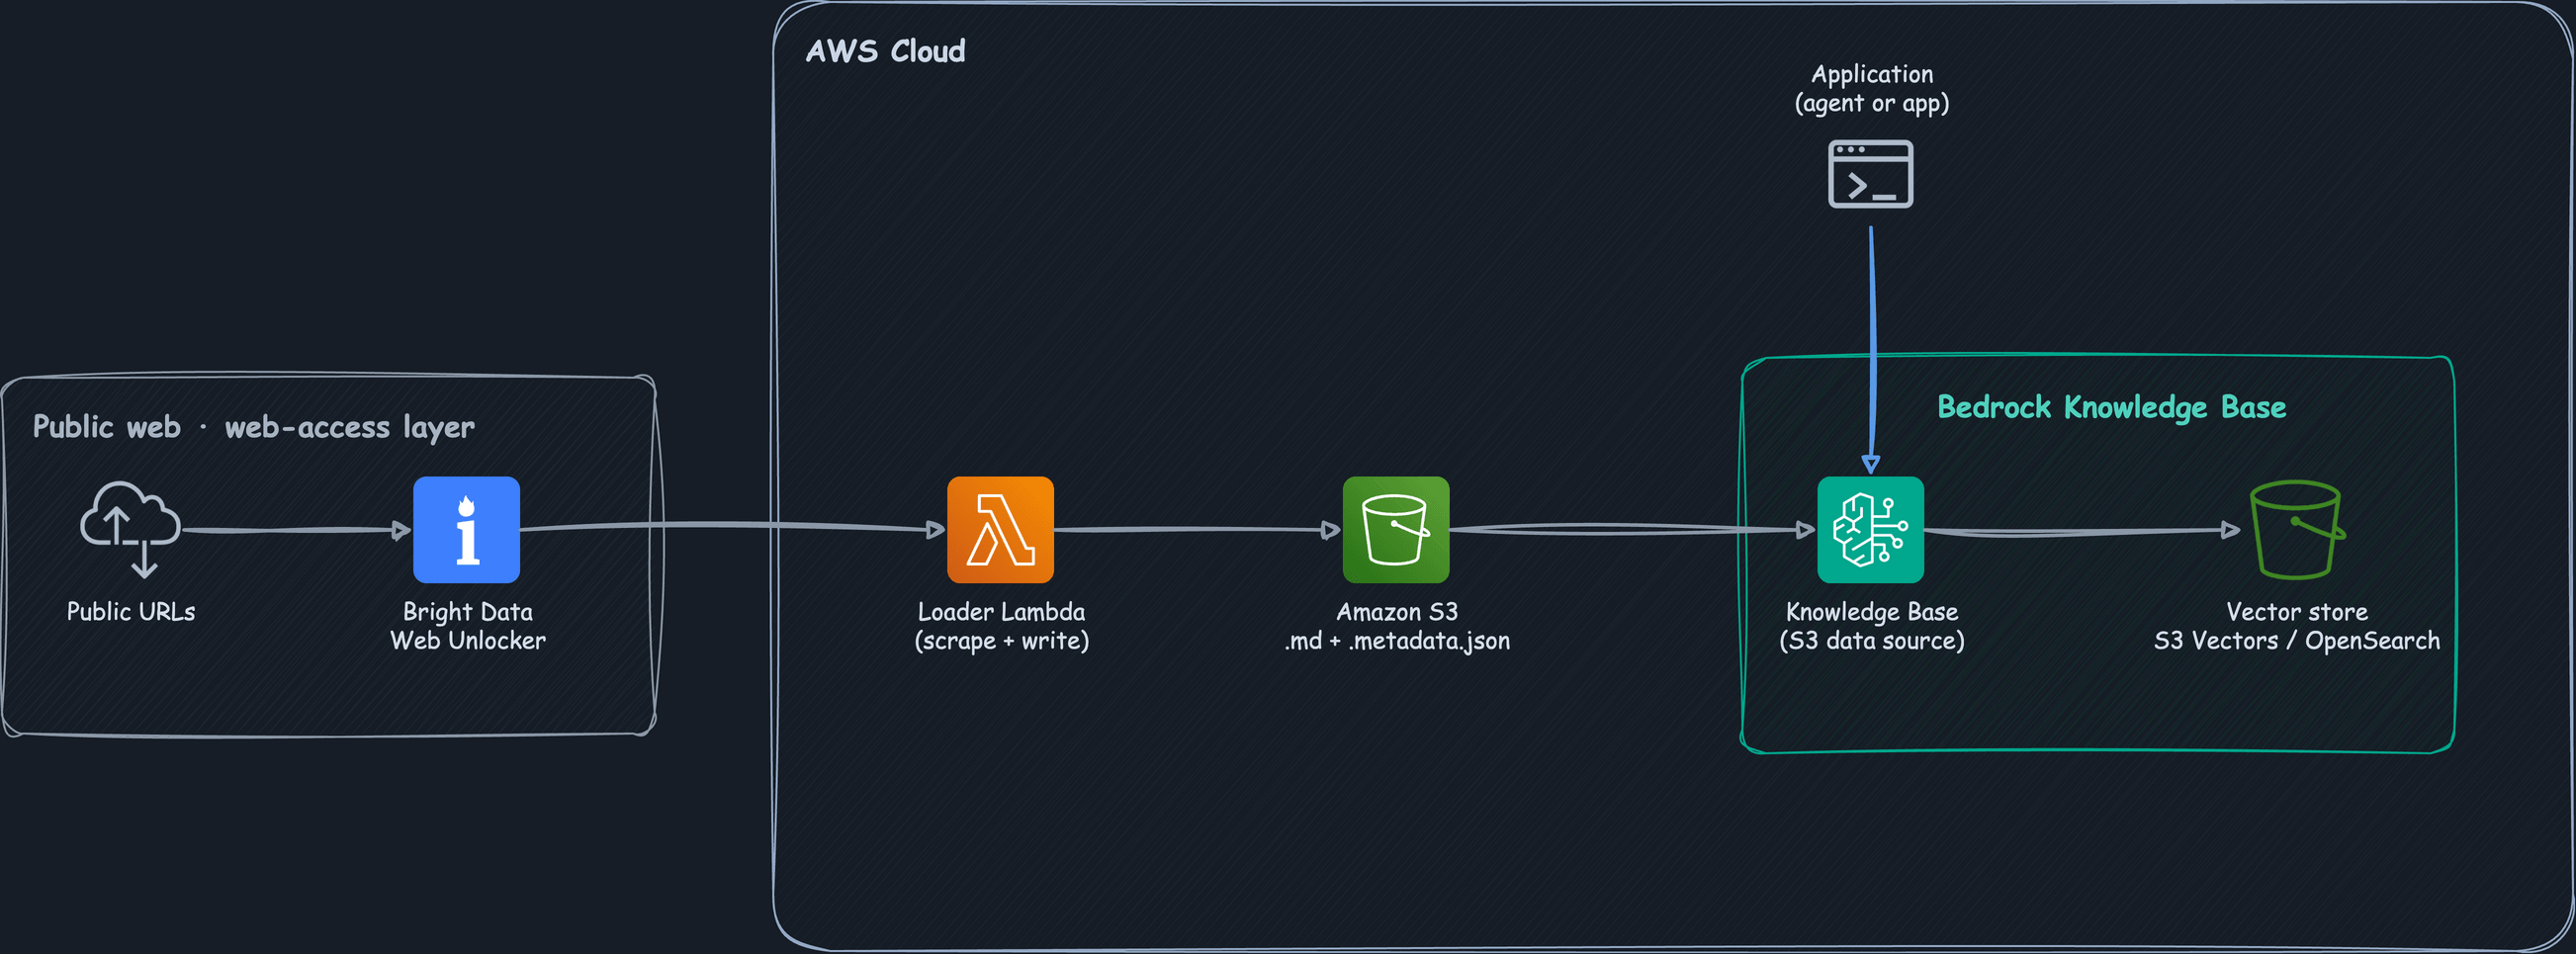
图中展示了核心路径:
- 加载器调用 Bright Data 的 网络解锁器,用于处理机器人防护、地理路由和 JavaScript 渲染,并以 Markdown 形式取回页面。
- 随后,加载器将每个页面作为
<slug>.md文档写入 Amazon S3,并附带一个<slug>.md.metadata.json边车文件。 - 知识库使用
StartIngestionJob同步 S3 数据源,之后的运行会增量执行。 - Bedrock 对每个文档分块,使用 Titan Text Embeddings V2 对其嵌入,并将向量写入 Amazon S3 Vectors 或 OpenSearch Serverless 等存储。
- 应用程序调用
Retrieve获取原始分块,或调用RetrieveAndGenerate获取基于来源、带引用的答案。
生产封装中的三个部分位于这条核心路径之外,图中没有展示。Amazon EventBridge 计划会按你选择的频率触发加载器,AWS Secrets Manager 保存 Bright Data 令牌,知识库则承担一个最小权限 IAM 角色。图中将加载器画作 Lambda,这是你为其设置计划后它运行的位置。下面,你会从自己的机器运行加载器,这样可以先观察每个阶段。
写入 S3 是一种选择,而不是默认做法,因为你也可以通过自定义数据源和 IngestKnowledgeBaseDocuments API 直接发送文档。对于抓取语料库,存储桶是更好的选项。对象可以重放,边车文件让你检查元数据约定,失败的运行不会影响之前的语料库。Bright Data 的 Crawl API 也可以原生交付到同一个存储桶。
前提条件
- 一个 AWS 账户,能够在受支持的区域访问 Amazon Bedrock,并且已在该区域启用 Amazon Titan Text Embeddings V2 (
amazon.titan-embed-text-v2:0)。如果你希望第 5 步返回书面答案而不是原始分块,还需要同一区域中的生成模型。 - 一个 IAM 主体,能够创建 S3 存储桶、Bedrock 知识库和数据源、向量存储,以及知识库承担的 IAM 服务角色。配套仓库列出了确切的策略语句。
- 一个 Bright Data 账户,带有 API 令牌和一个 网络解锁器 区域。每个请求都通过名称引用该区域。免费层每月包含前 5,000 个 credits,足以完成下面的每个步骤。请在 网络解锁器 pricing 查看当前额度和费率,然后在该区域上设置支出限制。
- Python 3.10 或更高版本,并安装
boto3和requests。 - 熟悉 Amazon S3 和 IAM。
嵌入模型决定你的向量维度,而向量存储的索引必须与之匹配。如果你手动创建存储且两者不一致,摄取会在写入时失败。Titan Text Embeddings V2 支持 256、512 或 1024 维。
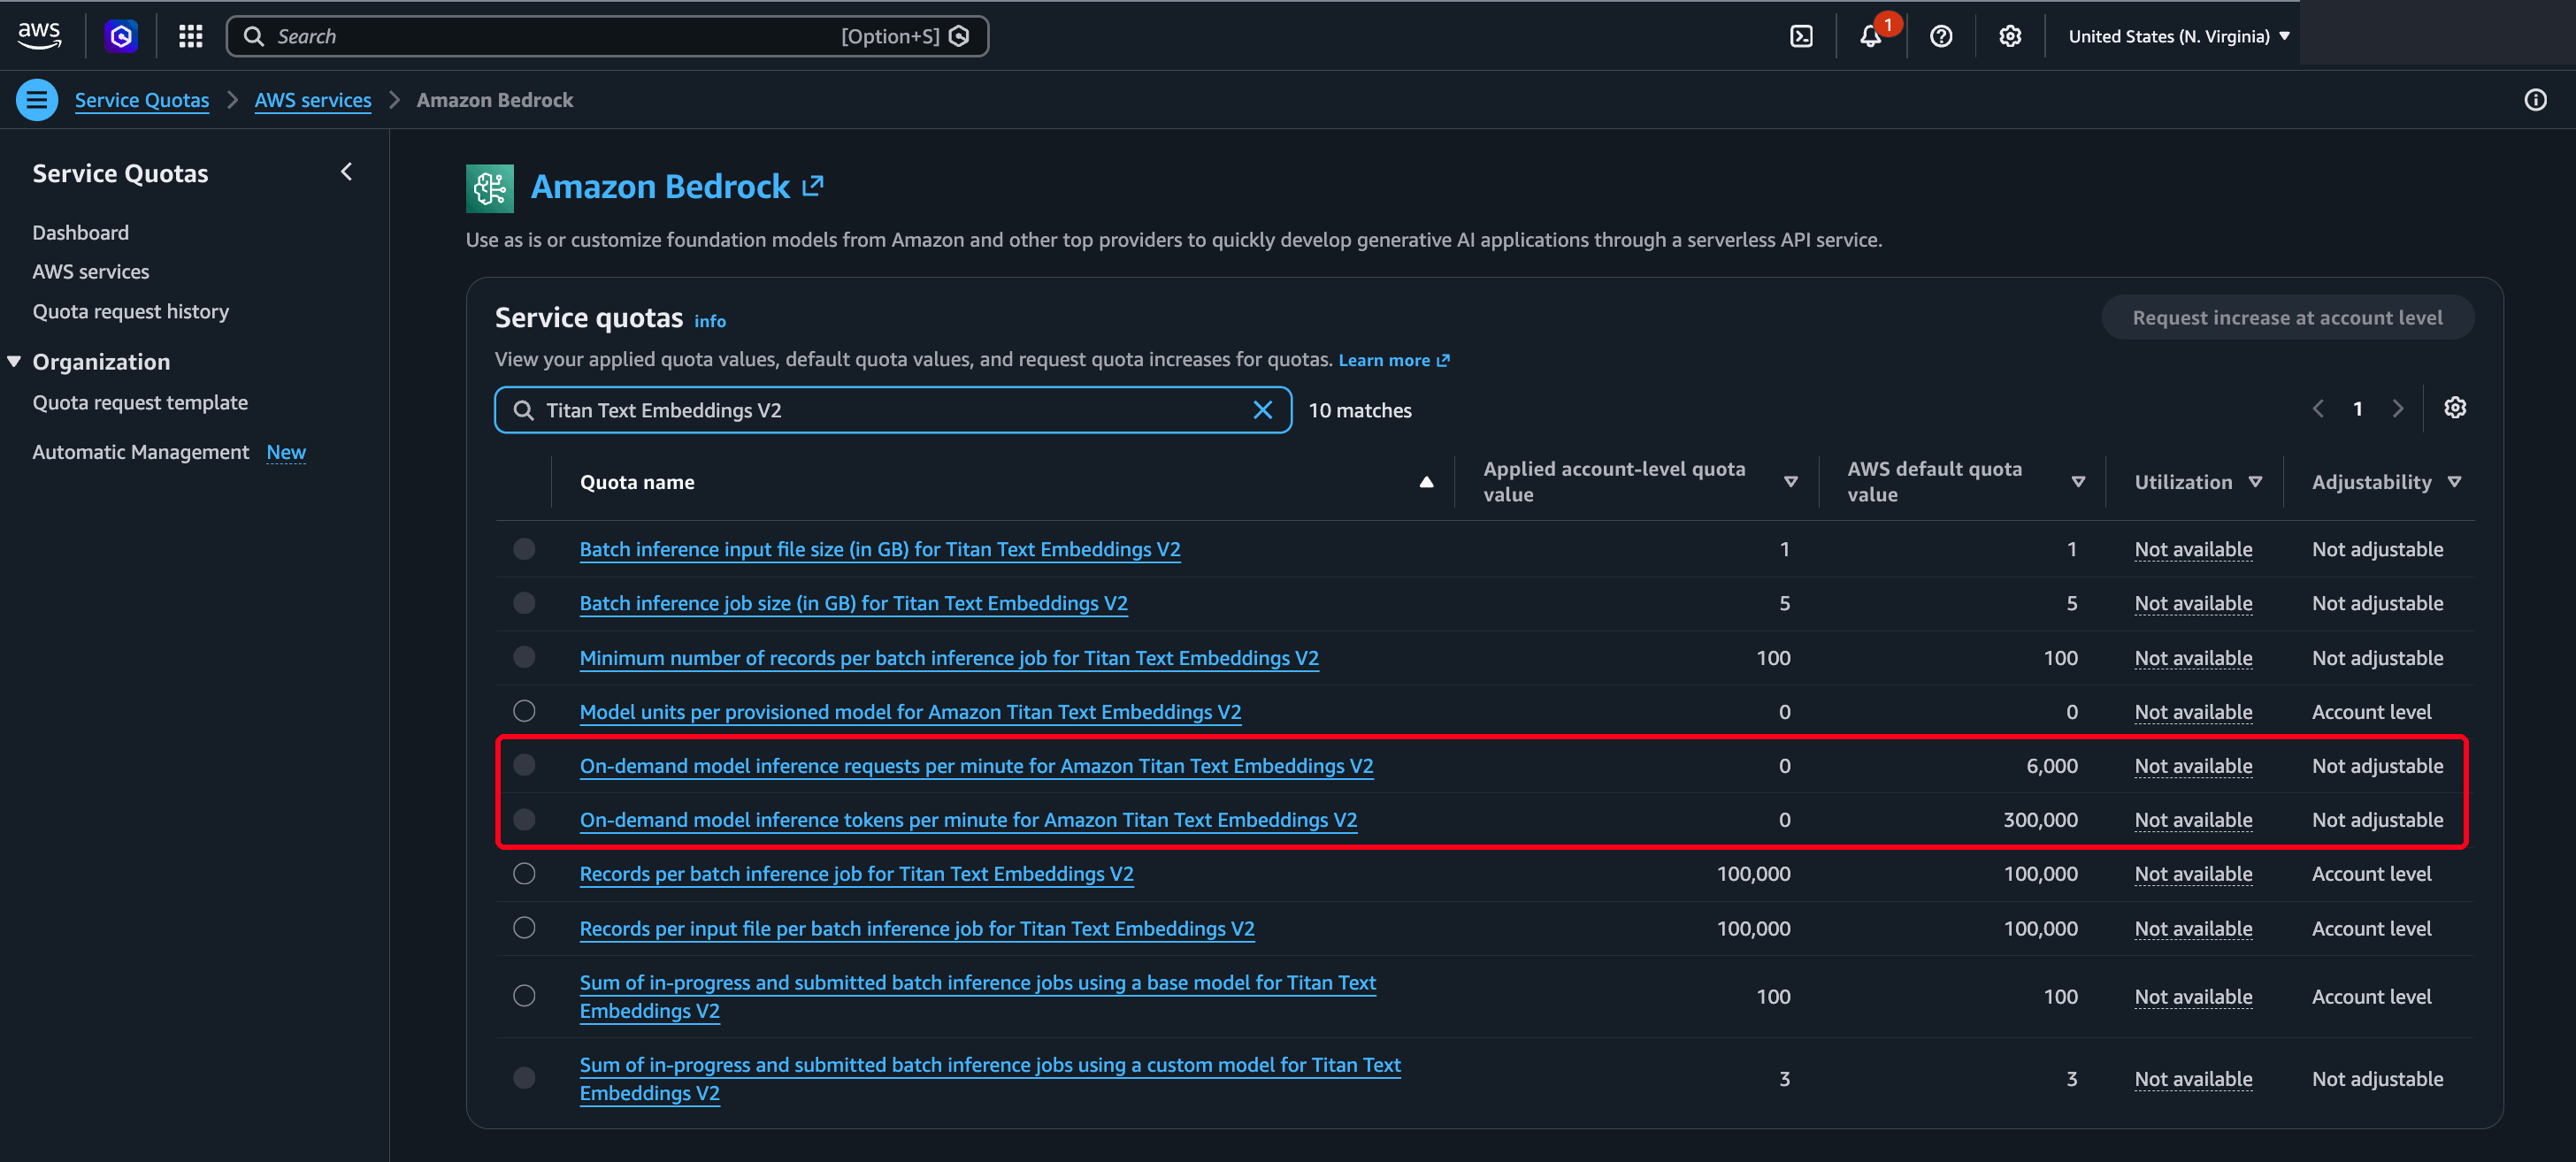
在构建任何东西之前先检查你的嵌入配额,因为它可能为零,而创建流程中不会有任何提示。新账户针对该嵌入模型的按需配额可能是每分钟 0 个请求。这个配额会让你正常创建知识库和数据源,然后让每个摄取作业都失败。用一次调用确认它,如果读数为零,就在 Service Quotas 中请求提高配额:
aws service-quotas list-service-quotas --service-code bedrock --region YOUR_REGION \
  --query "Quotas[?contains(QuotaName,'Titan Text Embeddings V2')].[QuotaName,Value]" --output text
请针对你实际打算使用的区域运行它,因为 AWS 按区域设置配额,差别可能是能用或完全不能用。在同一天的一个账户中,Titan Text Embeddings V2 在 US East (N. Virginia) 的已应用按需配额为每分钟 0 个请求和每分钟 0 个令牌:
在 US East (Ohio),同一模型的配额为每分钟 60 个请求和每分钟 300,000 个令牌:
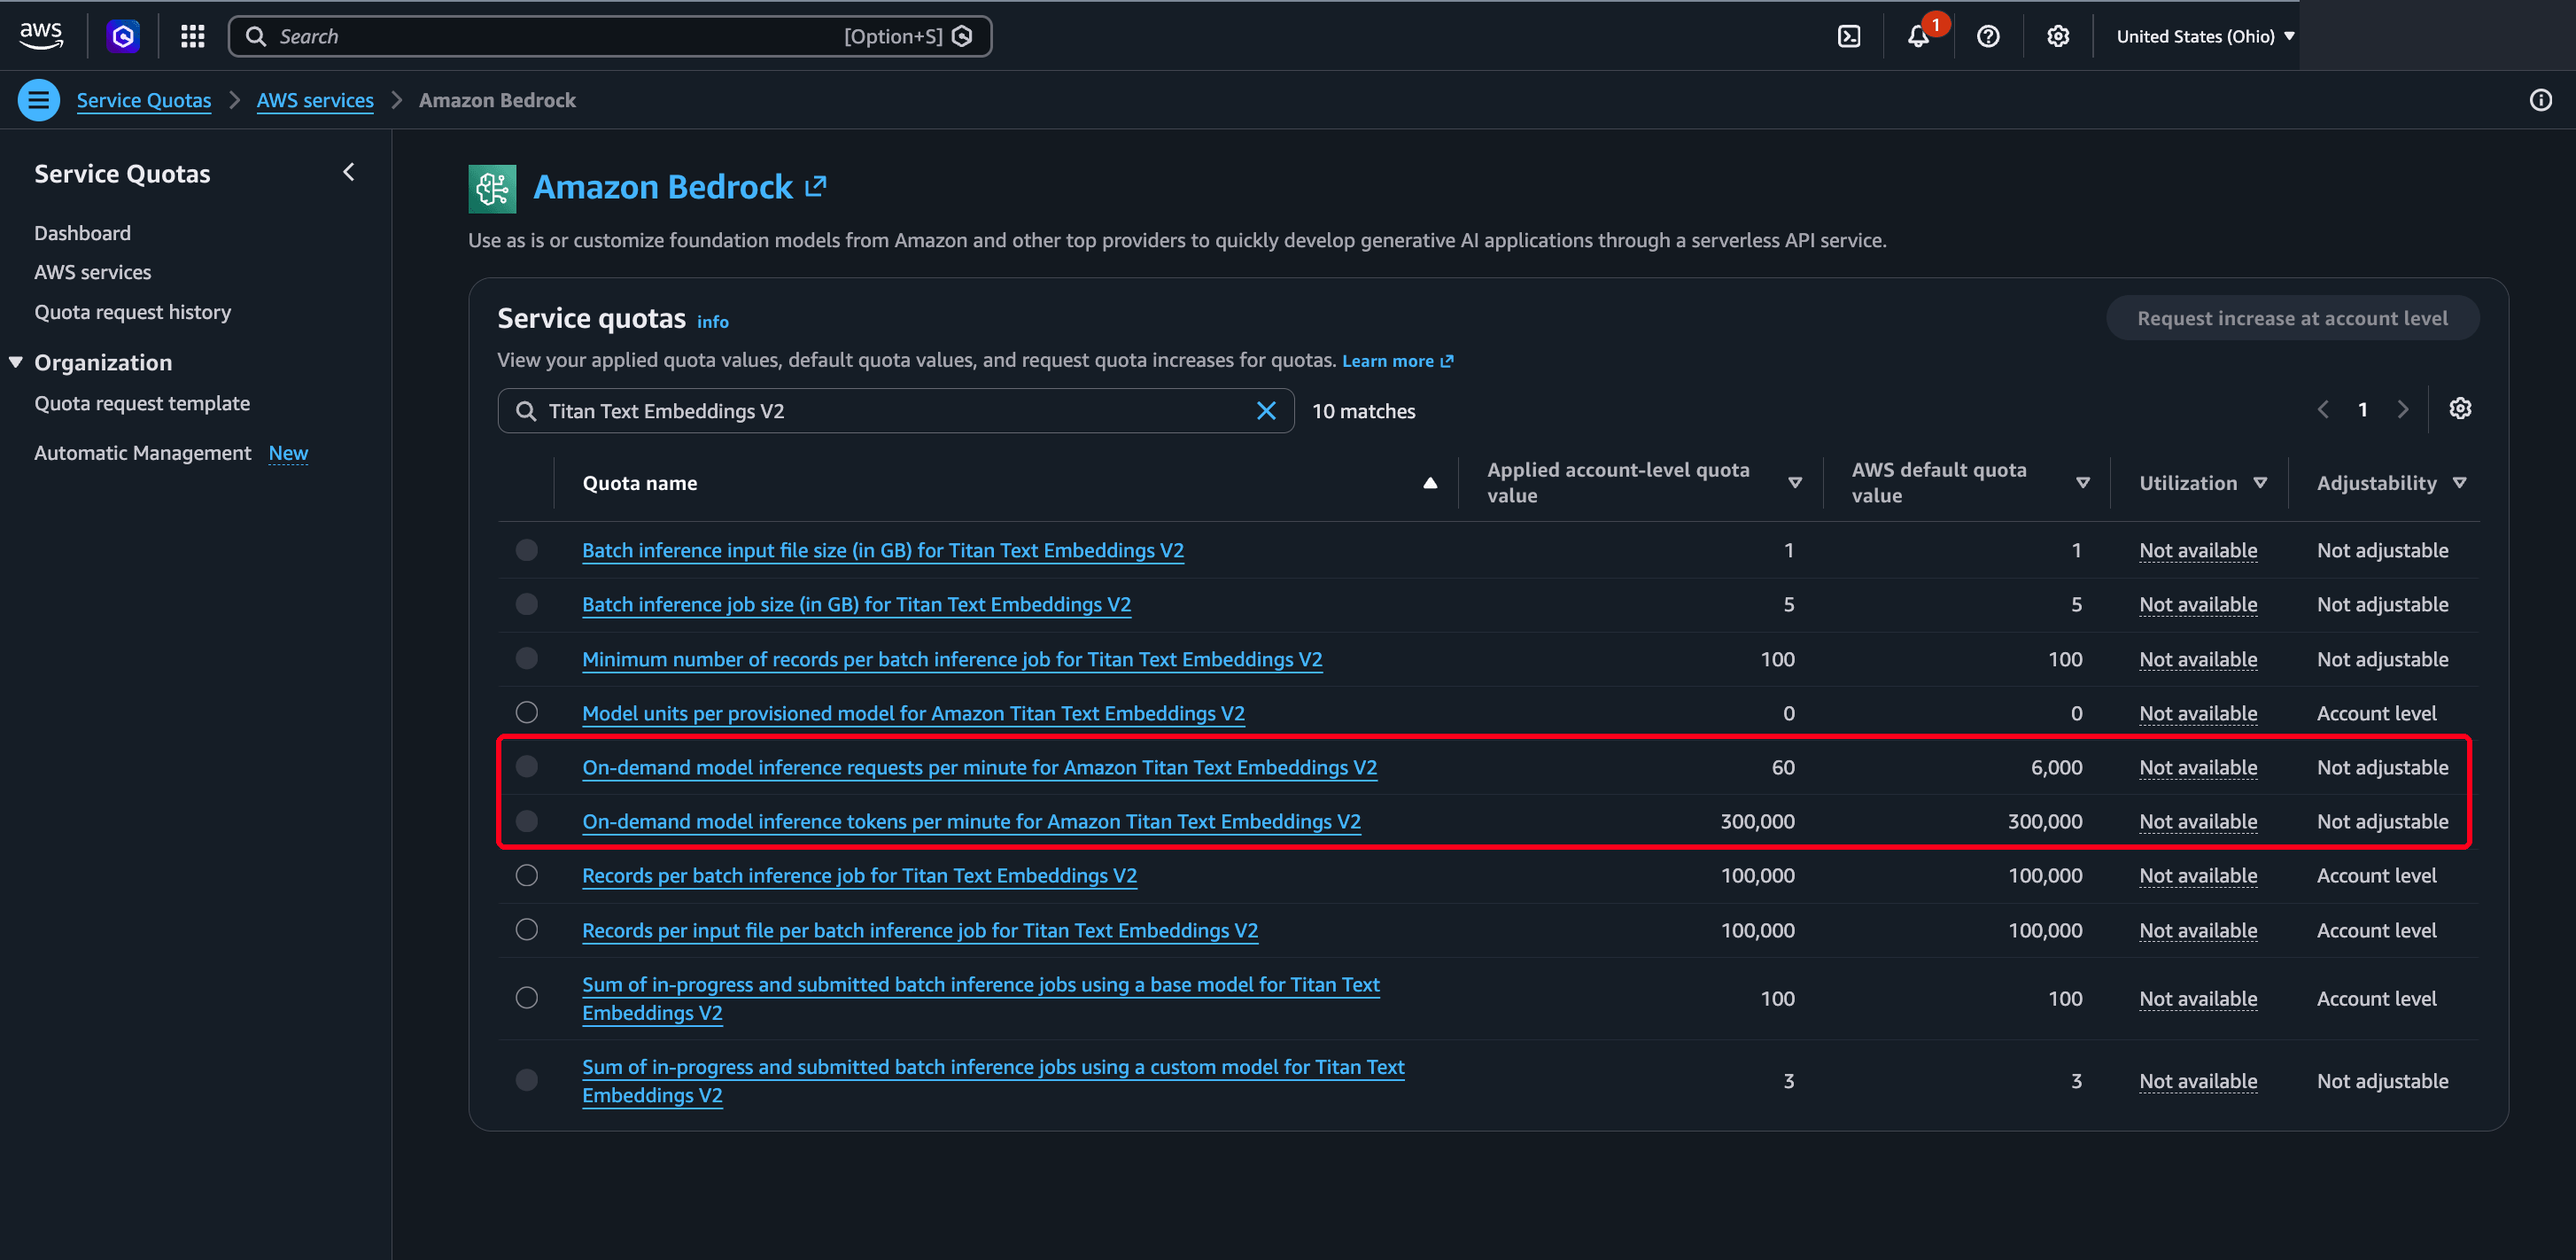
在 Service Quotas 控制台中将已应用值与 AWS 默认值进行比较。相对于默认 6,000 而言,配额为 60 意味着可用的区域仍只以标准请求速率的百分之一运行。旁边的令牌配额处于完整默认值,因此每分钟请求数才是关键限制。按每个分块约 300 个令牌计算,每分钟 60 个请求约等于每分钟 18,000 个令牌,低于 300,000 的上限。这对小型语料库足够。对大型语料库来说则是瓶颈。
这条流水线中的两条错误消息会指向错误的原因。
AccessDeniedException出现在CreateKnowledgeBase上,并提到你的用户和操作。这通常意味着roleArn格式错误,而不是权限问题,所以在审计 IAM 之前先检查 ARN 字符串。- 摄取期间出现
not able to call specified bedrock embedding model。这看起来像权限错误,但嵌入配额为零也会产生它。直接以你自己的身份调用嵌入模型,如果它也被限流,那就是配额问题。
两者都是设置问题,而不是流水线问题;账户配置正确后,两者都不会再出现。
步骤 1:使用 Bright Data 抓取页面
Bright Data 的 网络解锁器 接收单个 URL 并返回页面。机器人检查和代理路由在它那一侧发生,并且当你启用该选项时,它会渲染 JavaScript。将 data_format 设置为 markdown你得到的就不是原始 HTML,而是 Markdown 形式的页面,这正是 RAG 所需的形式。
你只需在 Bright Data 控制面板中创建一次 网络解锁器 区域,每个请求都会按名称引用它。该区域也承载地理位置设置。对于按国家/地区提供不同内容的网站,网络解锁器 会从你在那里配置的国家/地区获取,而不是从加载器恰好运行的位置获取。下面的代码需要从该区域的 Overview 选项卡中取得两项内容:区域名称(此处为 web_unlocker)和 API 令牌。
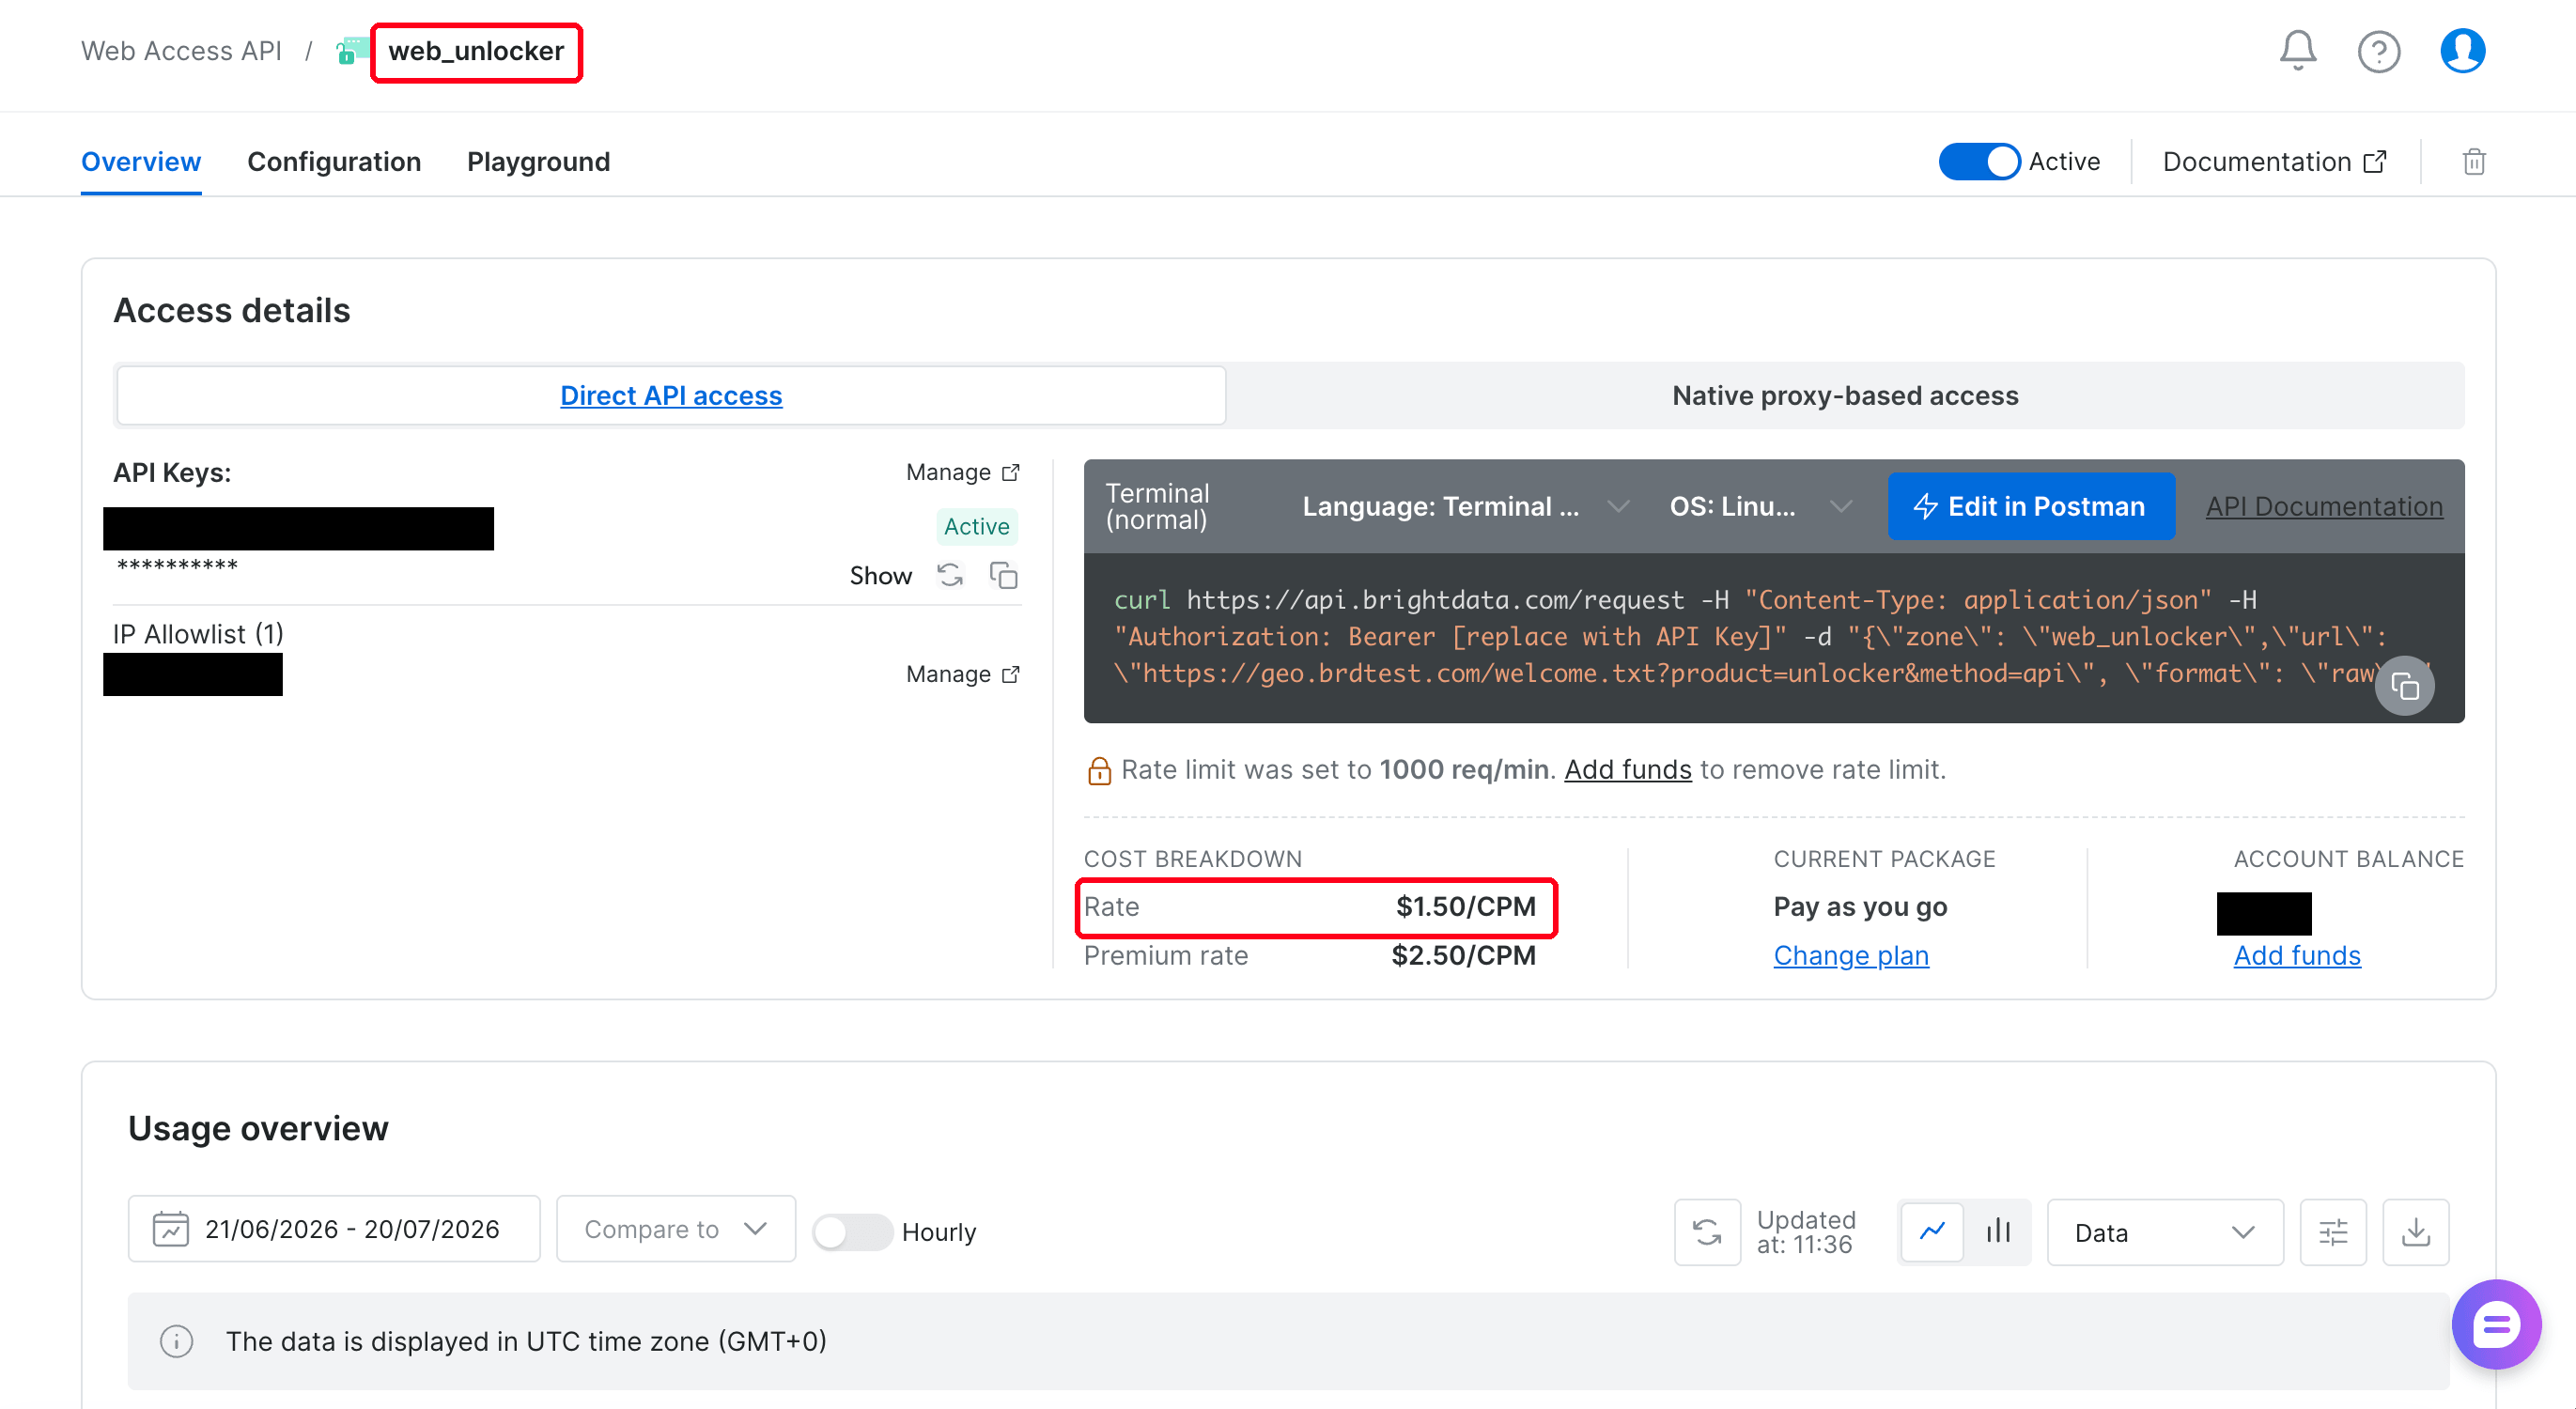
在 Python 中,这个调用就是一次 POST,其中包含区域、目标 URL,以及你想要的输出格式:
import requests

BRIGHTDATA_TOKEN = "..."   # from your Bright Data account
UNLOCKER_ZONE = "web_unlocker"

def scrape_markdown(url: str) -> str:
    """Fetch a public URL as Markdown via Bright Data Web Unlocker."""
    resp = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"},
        json={
            "zone": UNLOCKER_ZONE,
            "url": url,
            "format": "raw",            # return the response body directly
            "data_format": "markdown",  # convert the page to Markdown
            # add "render": "true" when content exists only after client-side JS
        },
        timeout=120,
    )
    resp.raise_for_status()
    return resp.text
无需管理浏览器会话,没有 CAPTCHA 步骤,也无需解析 HTML。
这里的一次失败看起来并不像失败。有三种情况会返回空的 200,而不是错误:区域名称错误、令牌被撤销,或者 IP 允许列表不再匹配你当前的地址。因此 raise_for_status 会接受它,你的加载器会把页面存成空白文档。检查响应长度,而不只是状态码。对于定时管道,跳过允许列表,让令牌作为凭证。
无头浏览器也会为你渲染 JavaScript,这部分一样。其余部分不是一次配置好的设置。它是一个不断变化的流程:为这个目标找到可用的出口 IP、自定义标头,并在检测方式变化时轮换指纹。定价把这种风险放在 Bright Data 一侧,因为失败请求不会计费。
拿到页面后,它仍然需要结构化、解析和清理,因为 HTML 很杂乱。markdown 格式把这项工作转移到 Bright Data 一侧。
仅在页面需要时开启渲染
网络解锁器不会在每个请求上都启动浏览器。对于无需执行 JavaScript 就能获取的页面,它会使用快速路径。对于只在客户端渲染后才存在的内容,将 render 设置为 "true"。
练习页面 quotes.toscrape.com/js 使用 JavaScript 注入内容。普通 GET 只得到 96 个字符的可索引文本,且没有任何引语;快速路径返回了 191 个字符的外壳;只有渲染请求返回了全部 1,583 个字符。在该页面上,渲染请求用 7.7 秒完成,而快速路径为 17.1 秒。每条路径都只有一个样本,所以应把渲染视为正确性开关,而不是延迟惩罚,并测量你自己的目标。
仓库中的 8_render_check.py 会对任意 URL 运行这个三路检查,所以当一次抓取看起来少得可疑时,它是首先应该尝试的工具。它只需要一个 Bright Data 令牌,不需要其他任何东西。你可以把它指向自己的 URL,在创建任何 AWS 资源之前查看每条路径返回的内容。如果开启渲染后内容仍然不存在,那么页面很可能需要交互,这由 Browser API 覆盖,而网络解锁器不覆盖。当你传入 --probe 时,脚本会在该页面上以非零状态退出:

下面抓取的页面都是服务器端渲染的,因此默认运行会关闭 render。
抓取一个列表,而不是一个页面
网络解锁器对每个 URL 发出一个请求,因此一个小型线程池就能在不使用重型框架的情况下保持高吞吐量:
from concurrent.futures import ThreadPoolExecutor

def scrape_many(urls: list[str], workers: int = 8) -> dict[str, str]:
    """Scrape a batch of URLs. Return {url: markdown} for the ones that succeed."""
    out: dict[str, str] = {}
    with ThreadPoolExecutor(max_workers=workers) as pool:
        for url, md in zip(urls, pool.map(_safe_scrape, urls)):
            if md:
                out[url] = md
    return out

def _safe_scrape(url: str) -> str | None:
    try:
        return scrape_markdown(url)
    except requests.RequestException:
        return None   # a page that fails is skipped, not fatal
失败的页面会返回 None 并离开批次,而不是停止运行。仓库中的加载器比这个片段更严格。它会重试两次,分别使用 1 秒和 2 秒的退避。它还会把空正文或 HTML 正文视为失败,而不是内容。这意味着获取失败的页面会在语料库中保留其先前版本,后续答案中不会有任何内容把它标记为过期。应把获取失败视为需要采取行动的信号,而不是日志中的一行。
网络解锁器获取了 6 个文档页面。每个请求耗时在 24.6 到 36.7 秒之间,中位数为 30.6 秒。这里每个编号步骤都是在同一天针对这一个 6 页语料库实时运行的。这些页面很配合,所以计时衡量的是管道本身,而不是目标的防护。解锁一个页面并不是静态获取,这解释了耗时,而并发让它变得可行。同样 6 个页面在 6 个 worker 下耗费了 43.1 秒的墙钟时间,相比之下,串行运行大约需要 3 分钟。
不过仍要把 worker 数量保持在较低水平,因为这个池面向的是一个站点。Bright Data 将上面的区域限制为每分钟 1,000 个请求,直到你添加资金。以 30 秒的中位数来看,这比少量 worker 会用到的余量大得多。检查你区域的上限,并在扩展列表之前确认你自己目标上的延迟。
优先使用站点自己的 Markdown 对应版本
在你抓取某个站点之前,先检查它是否已经发布了你正准备重建的内容。许多文档平台会为每个页面提供一个适合 LLM 使用的 Markdown 对应版本,通常形式为 <page-url>.md并在 /llms.txt 索引中列出这些对应版本。Bright Data 自己的文档发布了对应版本,并在 docs.brightdata.com/llms.txt 为它们建立索引,因此上面的 6 个页面都有对应版本。这些对应版本是免费的,单次 GET 就能返回它们,而不需要一次 30.6 秒的爬取。它们不包含爬虫会带上的任何导航内容。
它们并不是纯文本。下面的对应版本仍然带有平台自己的组件标签和完整图片 URL,因此你用站点外壳换来了基于行的剥离无法捕获的标记:
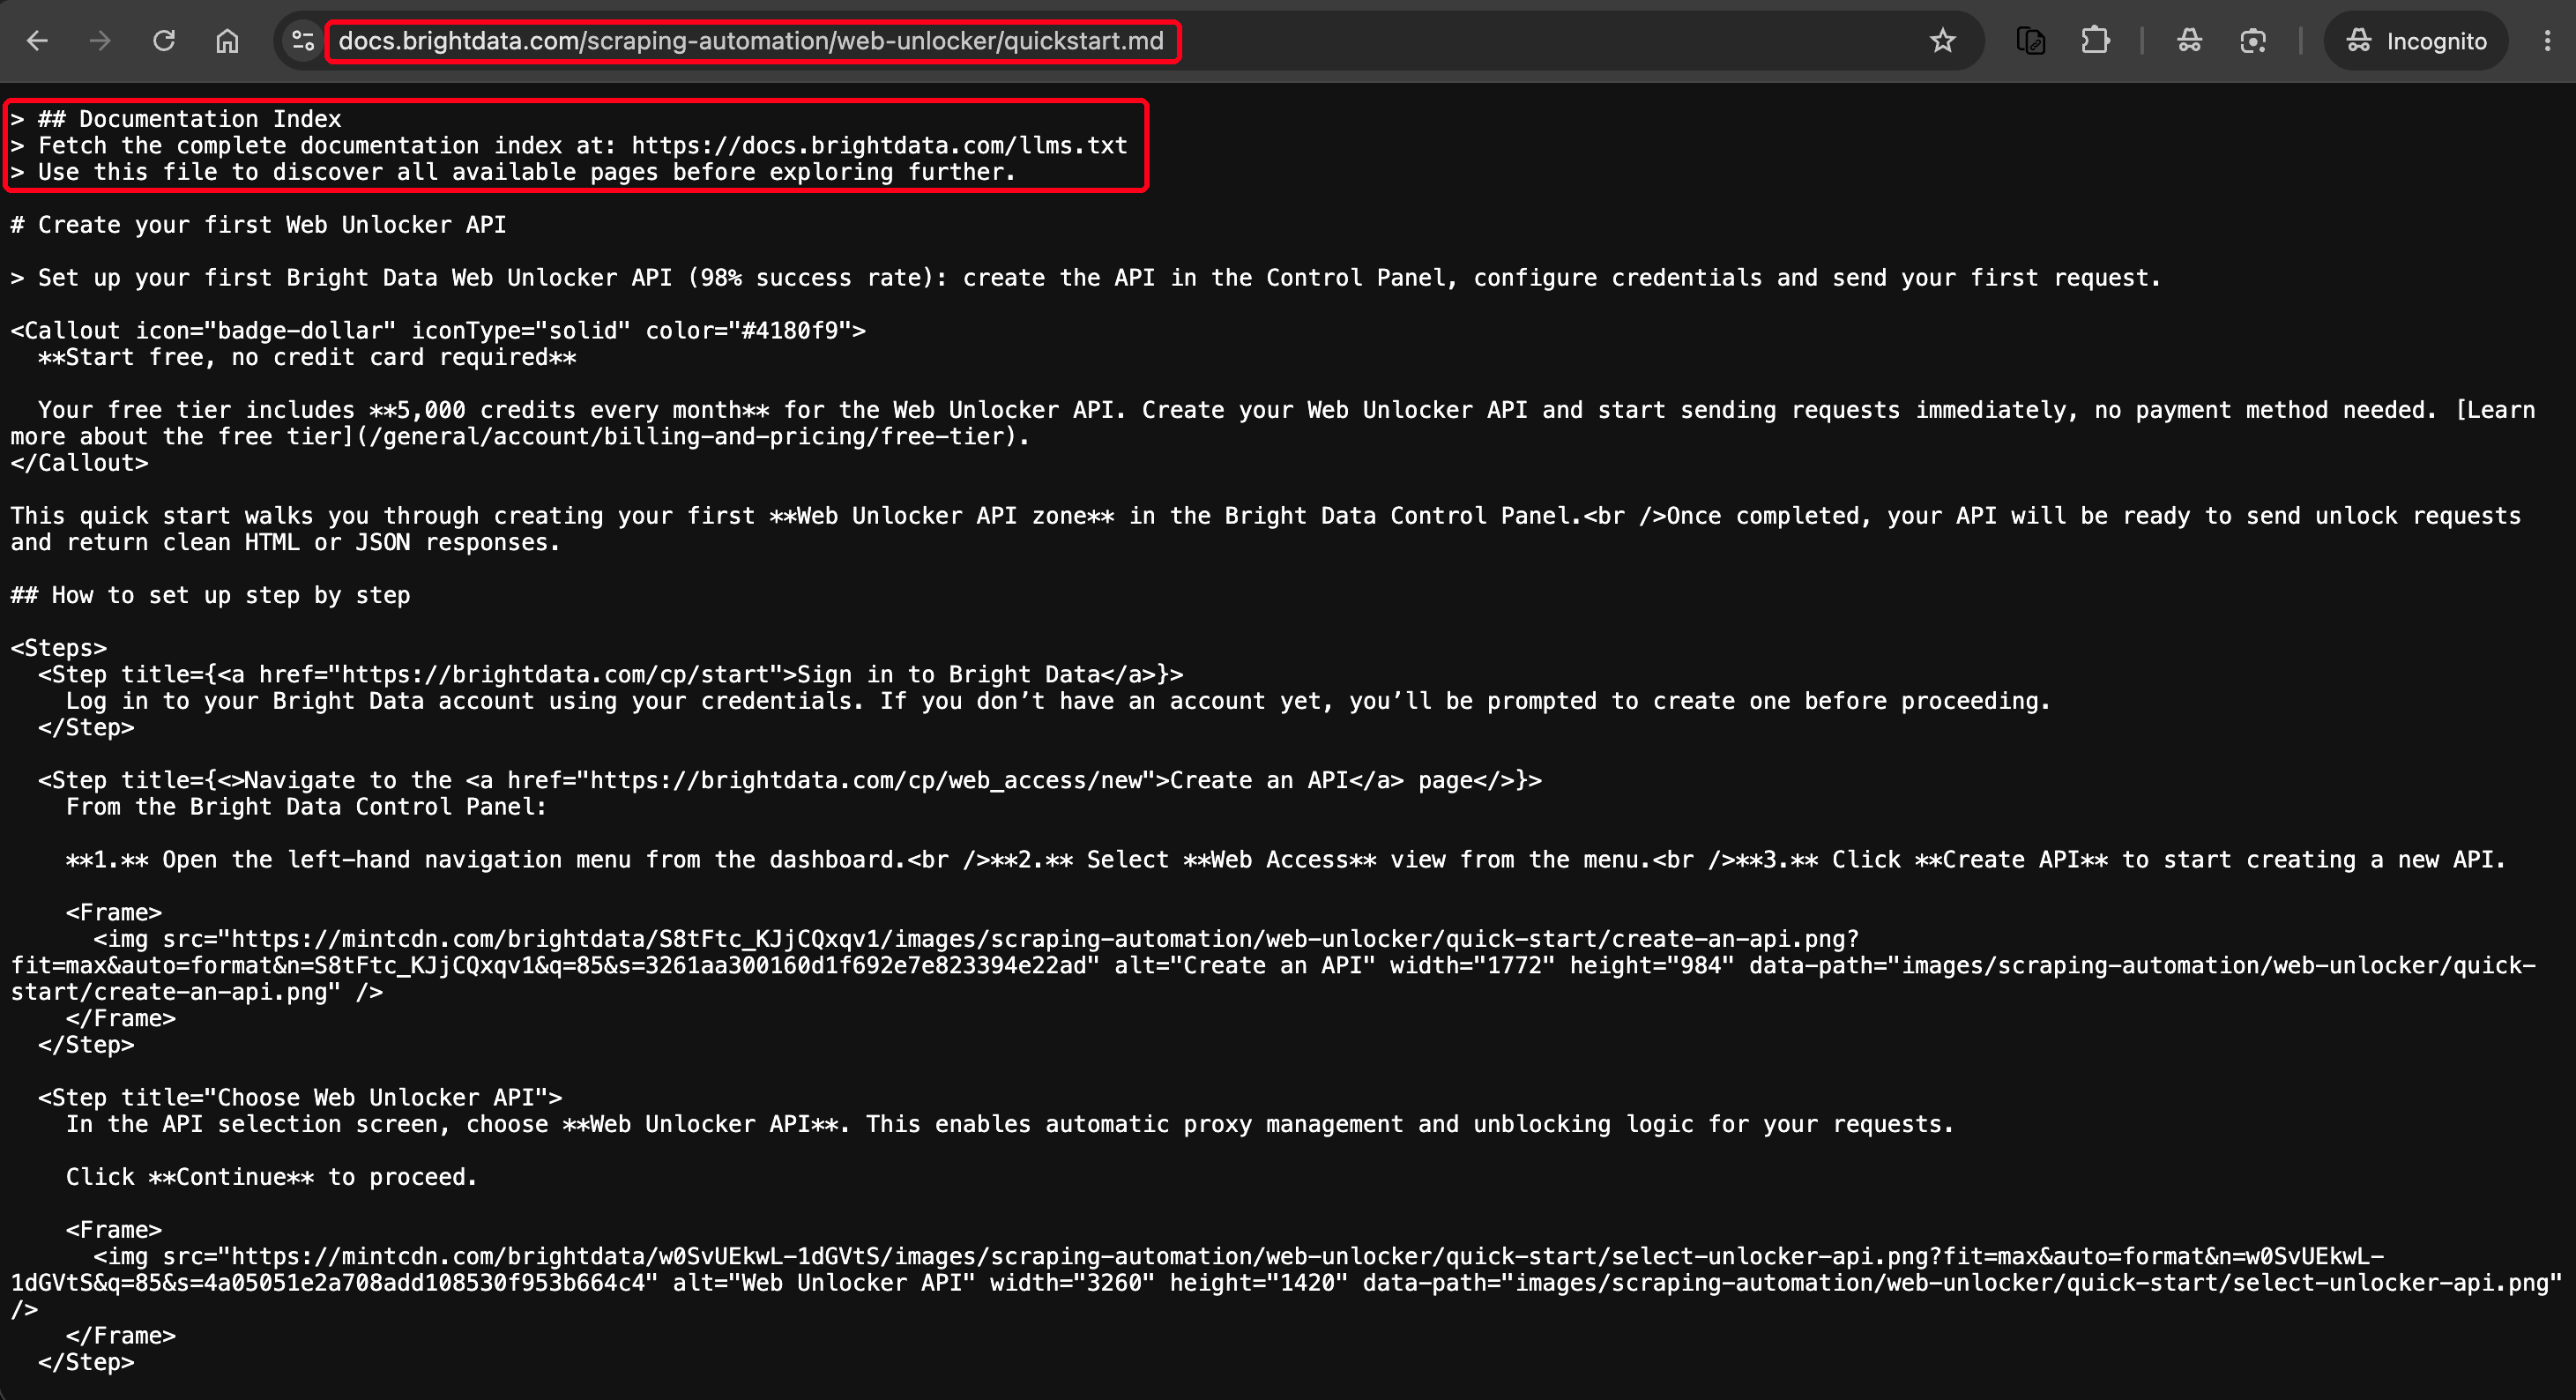
在开发者文档平台之外,Markdown 对应版本很少见,网络解锁器会在那里完成工作。这让获取变成一个两步决策:
def fetch_page(url: str) -> str:
    """Prefer the site's own Markdown twin. Scrape only when there isn't one."""
    return native_markdown(url) or scrape_markdown(url)
native_markdown 是仓库中的 src/web_kb/clean.py 辅助函数,它对 <page-url>.md 发起 GET当页面没有对应版本时返回 None。它不会移除组件标记,第 2 步中的页面外壳剥离也不会。一个以对应版本为主的语料库需要自己增加一次感知标签的处理。
当你确实必须抓取时,网络解锁器会返回页面,而不是决定其中哪些部分是主要内容。在一个实时文档站点的 6 个页面中,Markdown 仍然带有站点外壳:徽标条、“Skip to main content”链接、搜索框、完整的侧边栏导航树,以及“Was this page helpful”页脚。这些外壳大约占字符数的 43%。第 2 步会处理对重复内容的剥离。
第 2 步:将干净文档和元数据写入 S3
Bedrock 会读取你给定前缀下的每个受支持文件。每个文件都会成为一个最大 50 MB 的文档,旁边可以有一个可选的元数据 sidecar。两者都由你写入。
先剥离页面外壳
导航块在一个站点的每个页面上几乎相同,因此一个 50 页语料库会把同一个块嵌入 50 次。你要为嵌入它付费,要为存储它付费,并且在查询时,这 50 个近乎相同的块会与用户请求的内容竞争。本步骤后面的去重无法捕获它,因为页面并不是重复的。只有它们的页面外壳在重复。
你不需要特定于站点的规则来移除它,因为大多数外壳都是重复出现的文本。统计每一行在批次中出现的频率,并删除那些出现在大多数页面上的行:
from collections import Counter

KEEP = {"", "-" * 3, "`" * 3}          # blanks, bare rules, and bare fences are never chrome

def strip_repeated(pages: dict[str, str], threshold: float = 0.6) -> dict[str, str]:
    """Drop lines that repeat on most pages of the batch. Those are the chrome."""
    counts = Counter()
    for markdown in pages.values():
        for line in {ln.strip() for ln in markdown.splitlines()}:
            if line not in KEEP and len(line) >= 2:   # >= 2 so the ⌘K hint counts
                counts[line] += 1

    cutoff = max(2, int(len(pages) * threshold))
    boilerplate = {line for line, n in counts.items() if n >= cutoff}
    return {url: "\n".join(ln for ln in md.splitlines() if ln.strip() not in boilerplate)
            for url, md in pages.items()}
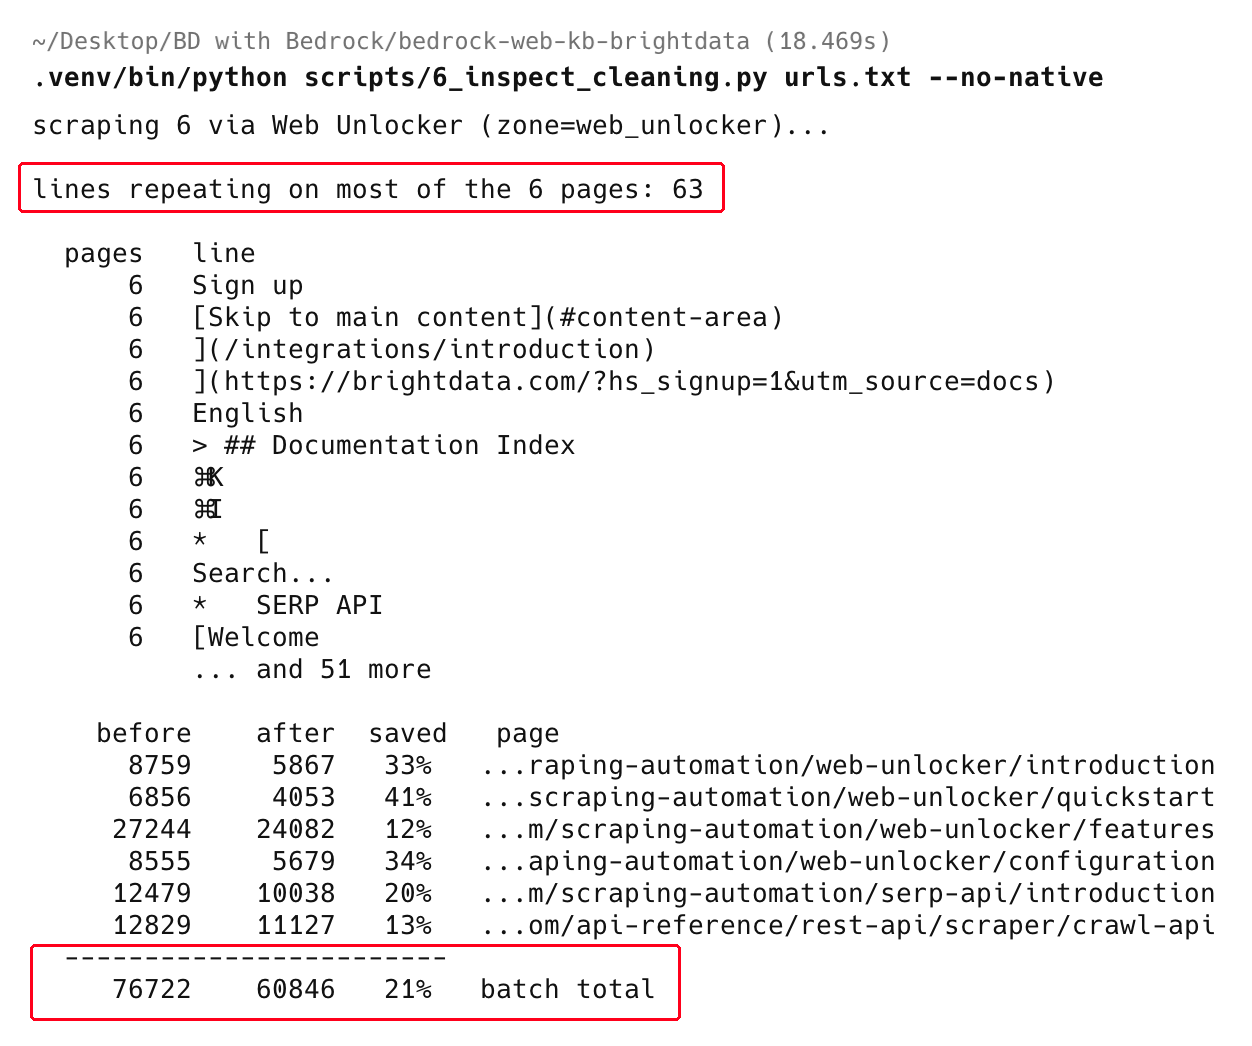
在 6 页样本上,这让批次从 76,722 个字符降到 60,846 个字符,减少了 21%。这大约是第 1 步测得外壳的一半。该规则只会作用于在页面之间完全相同的行,但有些站点会在每个页面上把导航措辞写得略有不同。在批次大多数页面中重复的行从 63 行降到 0 行。这些行中的每一行原本都可能变成一个重复块。所有 6 个页面都显示了搜索框、⌘K 快捷键提示、语言切换器,以及每个侧边栏导航链接。
节省并不均匀,因为外壳是每页的固定成本。在这次运行中,它从最短页面移除了 41%,从最长页面移除了 12%。包含许多短页面的语料库原本会为嵌入导航付出最多成本。
这种技术是一种启发式方法,不是解析器,所以在你信任它处理新站点之前要进行审查。在代码很多的语料库中,也要把带语言标签的围栏加入 KEEP因为 KEEP 只保护不带标签的围栏,删除一个共享的开头围栏会让它的结束围栏失去配对。
仓库中的 6_inspect_cleaning.py 会列出它将删除的每一行--verify 会将保留下来的内容与页面自己的 Markdown 对应版本进行评分。在这个语料库上,剥离没有丢失任何页面独有内容。按这个比较,每个页面唯一缺失的行都是相同的 llms.txt 样板。对于原始 HTML 而不是 Markdown,请使用专用提取器,例如 Trafilatura。
这 6 个页面都发布了 Markdown 对应版本,所以默认运行每次都会使用它们。上面的爬取和外壳数据来自使用 --no-native 强制走网络解锁器路径。
写入文档及其 sidecar
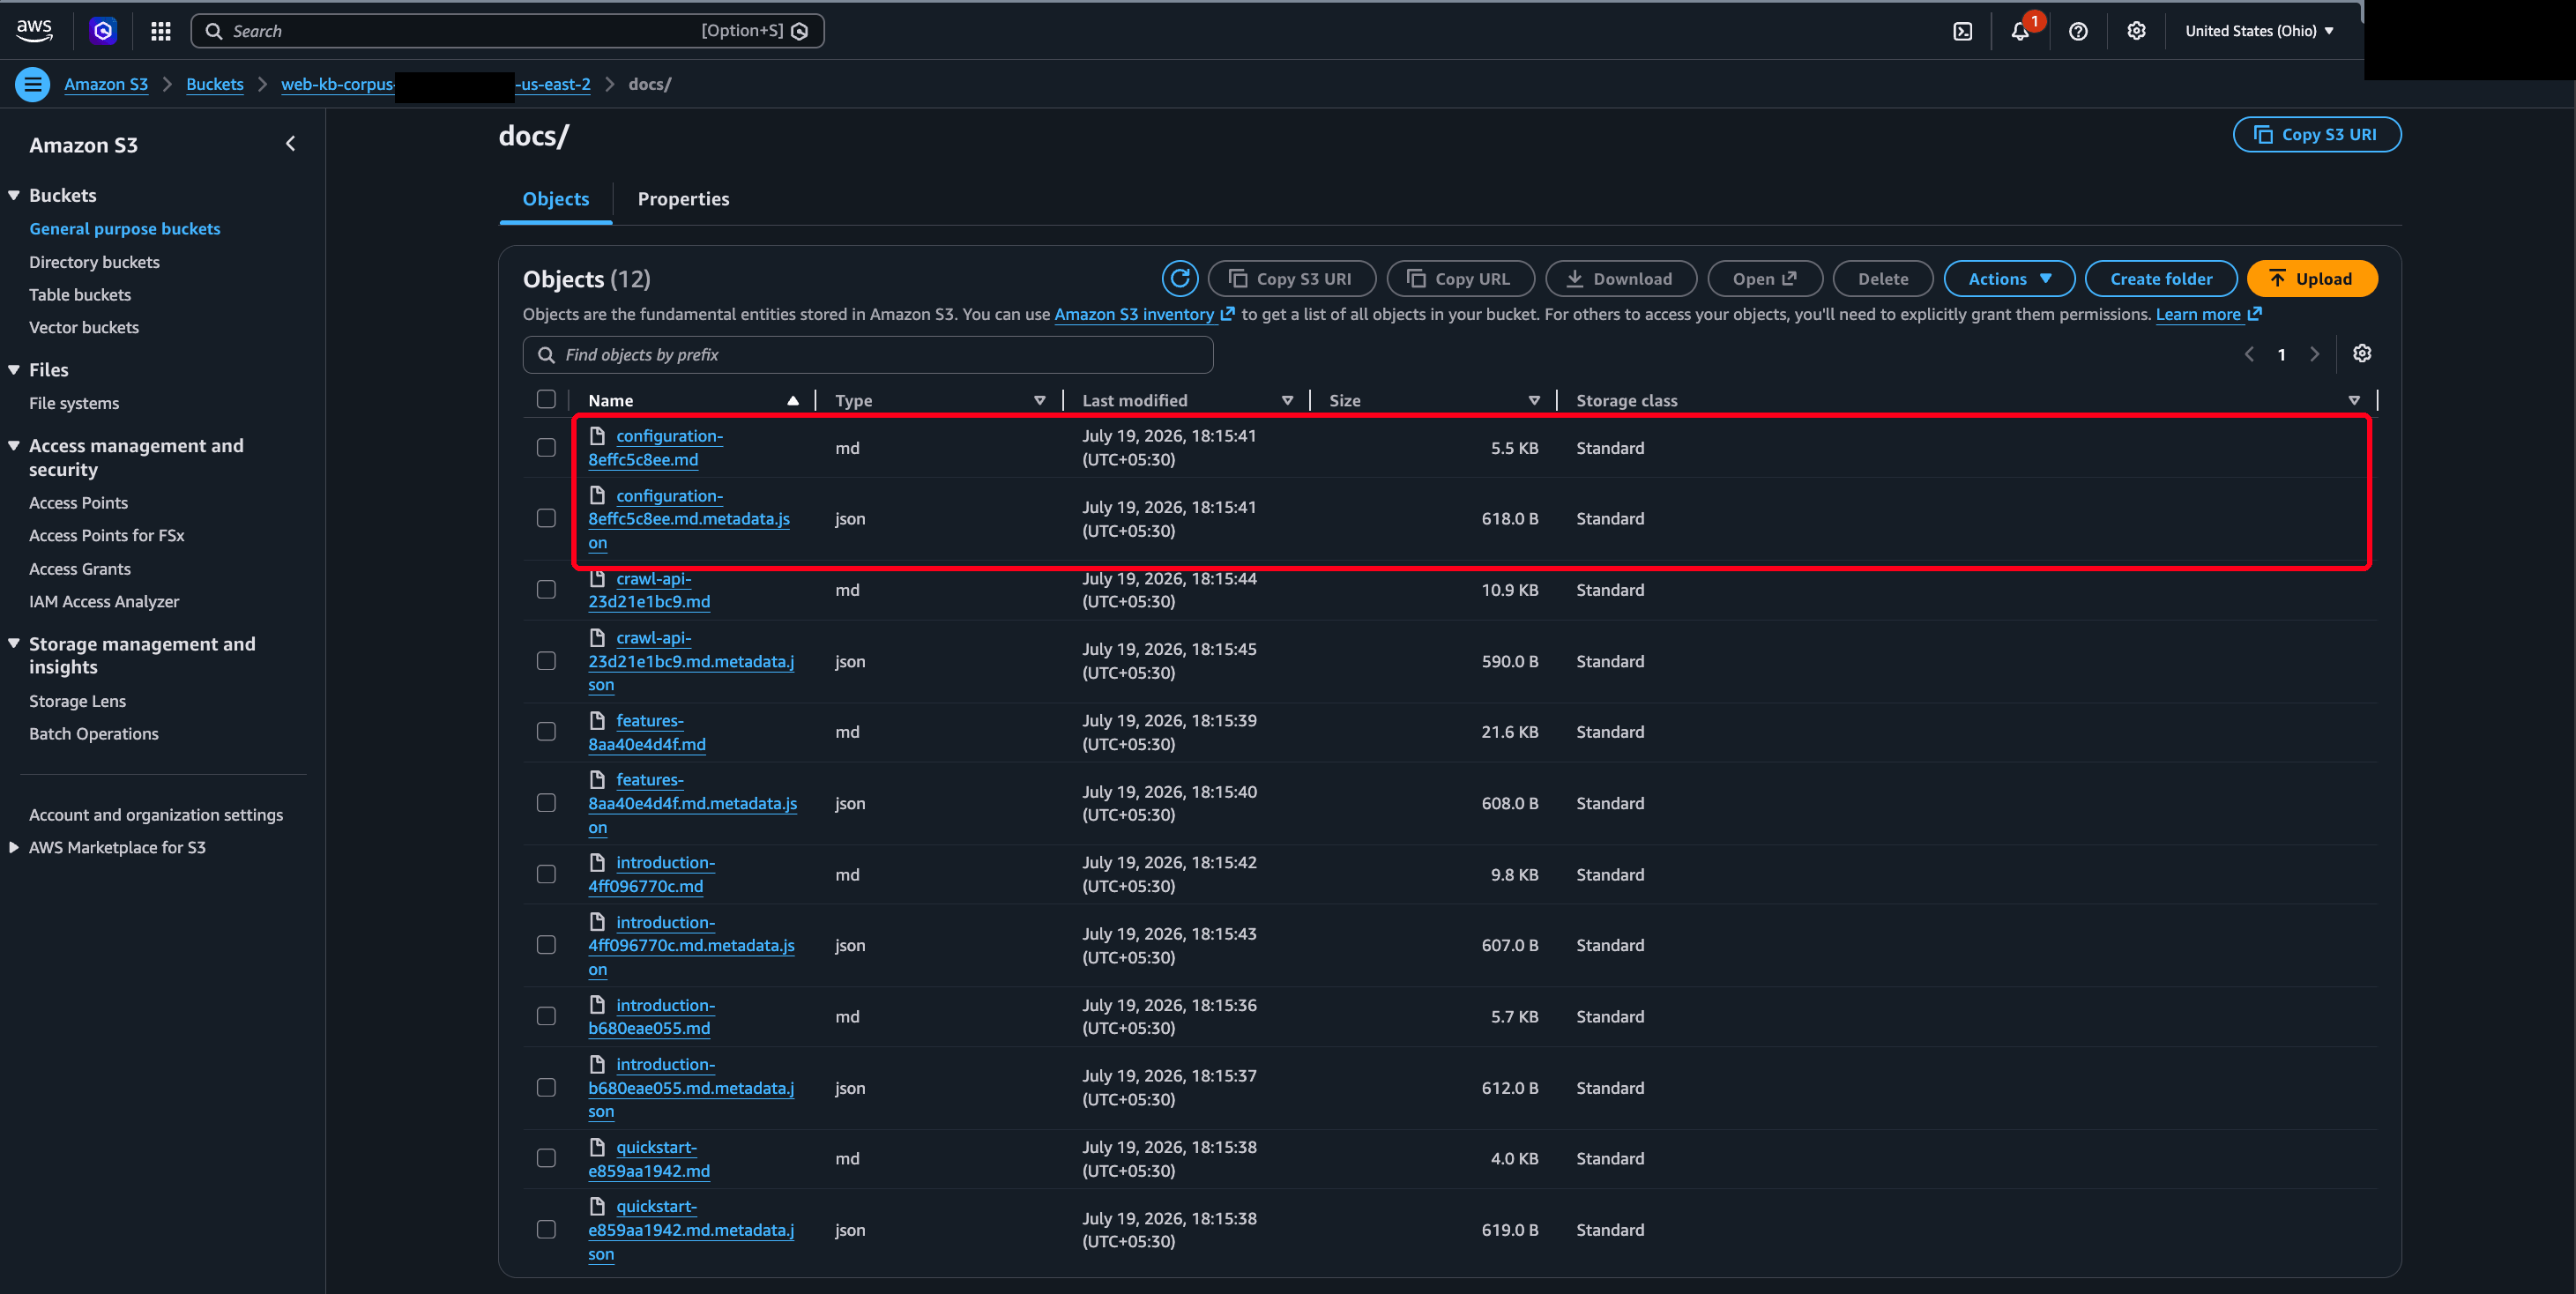
Bedrock 仅通过文件名把文档与其元数据配对。对于文档 quickstart-3f9a2c1b04.md元数据文件是 quickstart-3f9a2c1b04.md.metadata.json。在内部,每个属性都有一个带类型的值和一个 includeForEmbedding 标志。该标志控制 Bedrock 是否把该值加入嵌入文本。加载器先写入 sidecar,再写入文档,并带上内容哈希,使下一次运行可以跳过两者:
import boto3, json, hashlib, re
from datetime import datetime, timezone

REGION = "us-east-2"                    # a Region with non-zero embedding quota
s3 = boto3.client("s3", region_name=REGION)
BUCKET = "web-kb-corpus-111122223333"   # your bucket
PREFIX = "docs"

def slugify(url: str) -> str:
    """Stable, safe object key derived from the URL."""
    digest = hashlib.sha1(url.encode()).hexdigest()[:10]
    tail = url.rstrip("/").split("/")[-1][:40] or "page"
    safe = "".join(c if c.isalnum() or c in "-_" else "-" for c in tail)
    return f"{safe}-{digest}"

def content_hash(markdown: str) -> str:
    """Hash the meaningful text. Normalizing whitespace stops different
    line breaks from looking like a content change."""
    return hashlib.sha256(re.sub(r"\s+", " ", markdown).strip().encode()).hexdigest()

def stored_hash(key: str) -> str | None:
    """The hash saved on the object last run, or None if the object is not there.

    Only a missing object counts as absent. Catching every ClientError would report
    AccessDenied or throttling as a new page, rewrite it, and re-embed the corpus."""
    try:
        return s3.head_object(Bucket=BUCKET, Key=key)["Metadata"].get("content-hash")
    except s3.exceptions.ClientError as exc:
        if exc.response["Error"]["Code"] in ("404", "NoSuchKey", "NotFound"):
            return None
        raise

def put_document(url: str, markdown: str, title: str, section: str,
                 raw: str | None = None) -> str:
    key = f"{PREFIX}/{slugify(url)}.md"
    chash = content_hash(raw or markdown)   # hash the RAW scrape, not the stripped body

    if stored_hash(key) == chash:
        return "unchanged"          # leave the object alone, so the next sync skips it

    metadata = {
        "metadataAttributes": {
            "source_url":  {"value": {"type": "STRING", "stringValue": url},
                            "includeForEmbedding": False},
            "title":       {"value": {"type": "STRING", "stringValue": title},
                            "includeForEmbedding": True},
            "section":     {"value": {"type": "STRING", "stringValue": section},
                            "includeForEmbedding": True},
            "scraped_date":{"value": {"type": "NUMBER",
                                      "numberValue": int(datetime.now(timezone.utc).strftime("%Y%m%d"))},
                            "includeForEmbedding": False},
        }
    }
    # Sidecar first. The document carries the hash the next run compares against, so it is
    # the commit point. The reverse order can leave a new document beside a stale sidecar
    # that never self-heals, because the hash already matches.
    s3.put_object(Bucket=BUCKET, Key=f"{key}.metadata.json",
                  Body=json.dumps(metadata).encode("utf-8"),
                  ContentType="application/json")
    s3.put_object(Bucket=BUCKET, Key=key, Body=markdown.encode("utf-8"),
                  ContentType="text/markdown", Metadata={"content-hash": chash})
    return "written"
仅在内容哈希变化时写入
put_document 顶部的哈希门控让刷新保持低成本。在增量同步中,Bedrock 使用数据源自己的变更跟踪来决定要重新嵌入什么。AWS 文档目前没有说明 Bedrock 会读取 S3 的哪个信号。一个每次运行都重写每个对象的加载器,无论内容是否变化,都会更新那个信号。安全的假设是,一次本意只触碰三个页面的同步会重新嵌入整个语料库,而你要为全部内容付费。在写入前比较内容哈希意味着你会让未变化的页面保持不动,下游也不会产生任何成本。
Cloudflare 的数据表明超过一半的 AI 爬虫流量都用于重新获取没有变化的页面。这个门控无法解决这个问题,因为无论如何你都会获取页面,它只节省嵌入成本。第 4 步中的重新同步计划控制的是获取本身。
对原始抓取结果做哈希,而不是对剥离外壳后的正文做哈希。本步骤前面的剥离是相对于批次的,所以同一个未变化页面如果出现在不同批次中,否则会得到不同哈希并无意义地重新嵌入。这个片段正是为此接收一个单独的 raw 参数,所以调用它时请传入未剥离的文本。
仓库的加载器会保留它在一次运行中见过的哈希,因此也会删除精确重复项,也就是两个 URL 返回字节级完全相同文本的情况。实践中,这覆盖了 ?utm_source= 和 ?print=1 这类别名。联合发布的副本或分页变体只差几个字节,会绕过这个检查。
捕获这些情况需要近重复检测,仓库把它作为 MinHash 随加载器提供,位于一个可选启用的 --near-dup 标志之后。它默认使用 0.85 的相似度阈值。在这个语料库中,不同页面的得分最高只有 0.02,而一个页面与它自己的 Markdown 对应版本得分为 0.75,所以默认设置会保留两者。纯 Python 实现适合最多几千页的语料库。按前面测得的延迟来看,这通常已经超过单次批处理运行会覆盖的范围。
选择元数据携带的内容
sidecar 保存的是抓取语料库在进入向量存储过程中会丢失的两类信息。source_url 为每个检索到的块提供回到来源页面的引用,因此答案可以显示其来源。section 和 scraped_date 会在查询时成为过滤键。你可以把搜索限制在语料库的一部分,或限制为某个截止日期之后发生变化的内容。
sidecar 还携带页面 title。在 title 和 section 上将 includeForEmbedding 设置为 True 会把它们加入嵌入文本,因此命名其中任一项的查询会有更多可匹配内容。在 source_url 上将它设置为 False 会把长 URL 排除在向量之外,因为它在那里带来的噪声会多于信号。
Bedrock 支持 STRING、NUMBER、BOOLEAN 和 STRING_LIST 元数据类型。将 scraped_date 以 YYYYMMDD 形式存为 NUMBER可以让你之后用 greaterThan 和 lessThan 过滤。你不会重写未变化的页面,所以它会保留较早的日期。这让 scraped_date 成为内容年龄过滤器,而不是页面仍在刷新的信号。那个信号需要单独的 last-seen 标记,仓库会在每次成功获取时写入一个。
在你的 URL 列表上运行加载器,随后存储桶中会为每个页面保存一个文档和一个 sidecar。先在控制台中确认这些成对文件,再将知识库指向该前缀:
步骤 3:创建知识库
知识库只需创建一次。之后,流水线会写入文件并触发同步。控制台是完成该设置最清晰的路径create-knowledge-base 流程涵盖了每个界面。
选择托管或客户托管
AWS 的文档默认推荐完全托管的知识库。根据你所在的 Region,控制台也可能提供该选项。托管知识库会运行自己的数据存储、解析和重排序。它们还会加入智能体式检索,并包含 Google Drive 等原生连接器。
这个构建采用客户托管路径。选择自己的向量存储可以让你使用下面的 S3 Vectors 定价,并将索引保留在你的账户中。托管知识库也可以通过同一个 S3 数据源,摄取这条流水线写入 S3 的文档。无论选择哪条路径,爬虫差距都一样存在。
设置之后无法更改的选项
四个选择会影响检索。其中三个会在知识库及其数据源创建后锁定。
- 数据源。 选择 Amazon S3并将其指向你的存储桶和
docs/前缀。之后每次同步时,Bedrock 都会从那里读取文档及其 sidecar。一个知识库最多可以使用 5 个存储桶作为数据源。 - 嵌入模型。 Amazon Titan Text Embeddings V2 (
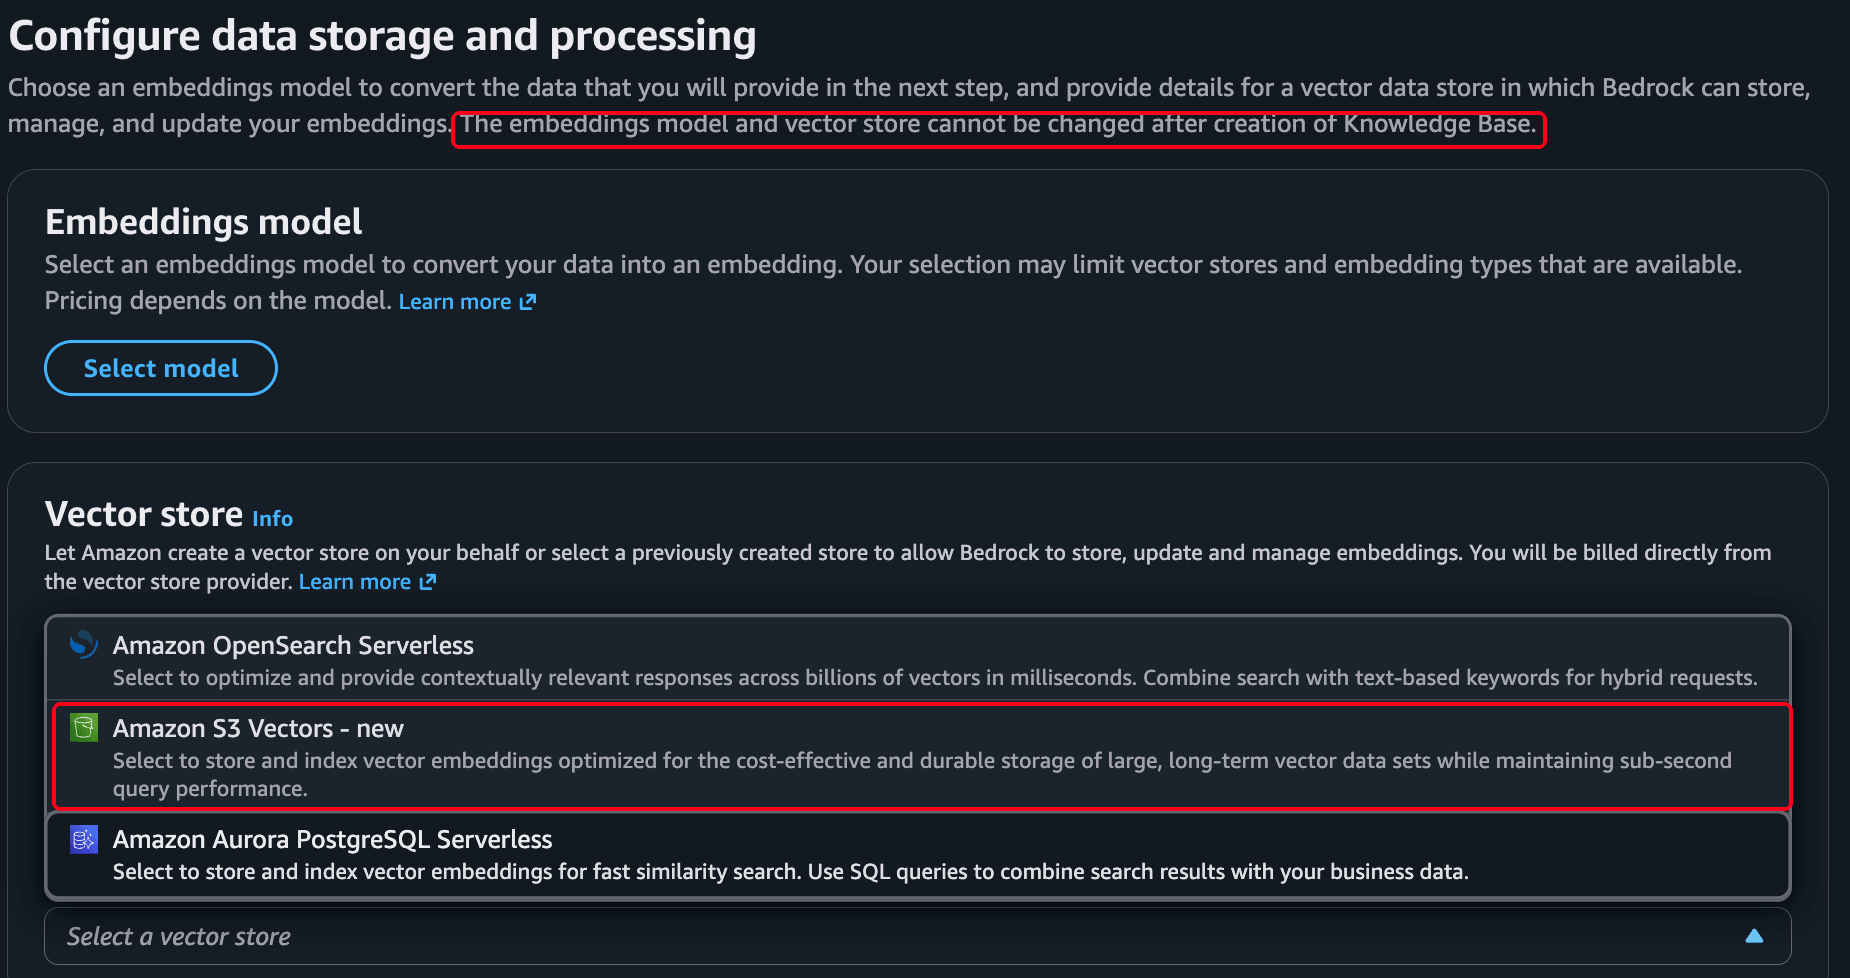
amazon.titan-embed-text-v2:0) 是文本的默认模型,也是下面每个检索数字背后的模型。使用 1024 维可以获得更好的检索质量,使用 256 维则可以降低存储成本。支持的嵌入模型包括 Amazon Nova Multimodal Embeddings,当语料库同时包含文本和图像时值得考虑。只能选择一次,因为你无法更改现有知识库上的嵌入模型。 - 向量存储。 Amazon S3 Vectors 于 2025 年 12 月正式可用。它按需付费地存储和查询向量,无需运行集群,并且在知识库创建后无法替换。打开向导之前,先创建它的存储桶和索引。然后让向导指向这个现有存储,而不是让 Amazon 为你创建一个。下一节会解释原因。AWS 表示,与未具名的替代方案相比,S3 Vectors 可将上传、存储和查询向量的成本最多降低 90%。当你需要 Amazon OpenSearch Serverless 的查询功能或更高吞吐量时,它仍然是可选方案,不过这个构建只运行在 S3 Vectors 上。对于按计划刷新而不是服务于高查询量的语料库,这种取舍通常是值得的。控制台还提供 Amazon Aurora PostgreSQL Serverless。构建时请根据 S3 Vectors 文档确认当前状态和定价。
- 分块。 抓取来的文章具有句子和段落结构,因此按句子边界进行约 300 个 token 的默认分块是一个合理的起点。如果你爬取较长的参考页面,分层分块可以检索精确的子块,并返回其更宽泛的父块作为上下文,不过 Bedrock 不建议在 S3 Vectors 存储上使用它。Bedrock 还提供其他策略。固定大小拆分使用你设置的 token 数。语义分块按含义而不是长度分组。无分块选项会将每个文档视为单个块。创建数据源后,你无法更改分块策略。
在你设置嵌入模型和向量存储的界面上,向导会对此发出警告:
命名不可过滤的元数据键
如果你选择 S3 Vectors,在创建索引时,将块文本和 Bedrock 自身的元数据标记为不可过滤。否则 Bedrock 会无法摄取语料库中的大部分内容。S3 Vectors 每个向量最多允许 2048 字节的可过滤元数据,而 Bedrock 会将其中一部分用于块文本和自身的簿记。除了非常短的块之外,任何内容都会超出预算。扣除这部分开销后S3 Vectors 知识库文档给出的实际可用额度是每个向量 1 KB 和 35 个键。保持 sidecar 精简。
第一次运行时,6 个文档中有 5 个因 Filterable metadata must have at most 2048 bytes 失败,唯一成功的文档有一个 499 字节的块。创建索引时命名 Bedrock 自己的两个键即可修复该问题,并且之后无法更改这个选择:
aws s3vectors create-vector-bucket --vector-bucket-name YOUR_VECTOR_BUCKET --region YOUR_REGION

aws s3vectors create-index --vector-bucket-name YOUR_VECTOR_BUCKET --region YOUR_REGION \
  --index-name web-kb-index --data-type float32 --dimension 1024 --distance-metric cosine \
  --metadata-configuration '{"nonFilterableMetadataKeys":["AMAZON_BEDROCK_TEXT","AMAZON_BEDROCK_METADATA"]}'
人们容易弄错的名称是 AMAZON_BEDROCK_TEXT。AMAZON_BEDROCK_TEXT_CHUNK 是 OpenSearch 字段名,如果改为命名这个字段,失败会原样保留。配套代码库中的 2_create_kb.py 会用这种方式为你创建索引。它还会拒绝在缺少这些键的现有索引上继续执行。另一种做法,是在一次报告成功的同步中才发现这个问题。
在下一个界面中,向导会再次针对解析和分块策略给出警告。
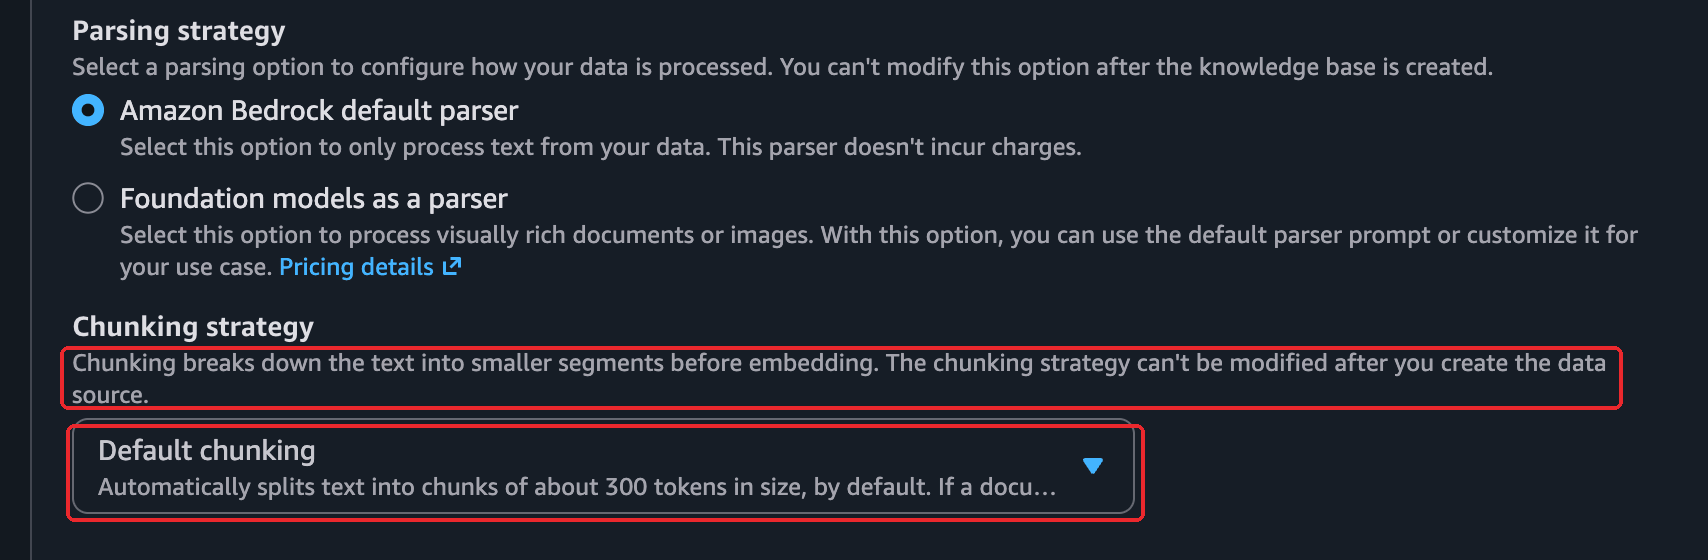
同一界面还带有一个可选的转换函数。Contextual retrieval 会在嵌入前,为每个块添加一段由模型编写的说明,描述该块在文档中的位置。Anthropic 测得 top-20 检索失败率下降了 35%。Bedrock 会在摄取时运行该函数,代价是每个块一次模型调用。这个构建没有启用它,因此下面的检索数字只来自默认分块。
如果你更喜欢用代码创建知识库,同一个 2_create_kb.py 会调用 bedrock-agent 客户端的 create_knowledge_base 和 create_data_source。它会为你设置 S3 配置和 IAM 服务角色。代码库还附带了整个 AWS 侧的 Terraform。如果你不想逐项点击这些界面,这是更短的路径,并且它会设置上面的不可过滤元数据键,因此你不会忘记它们。
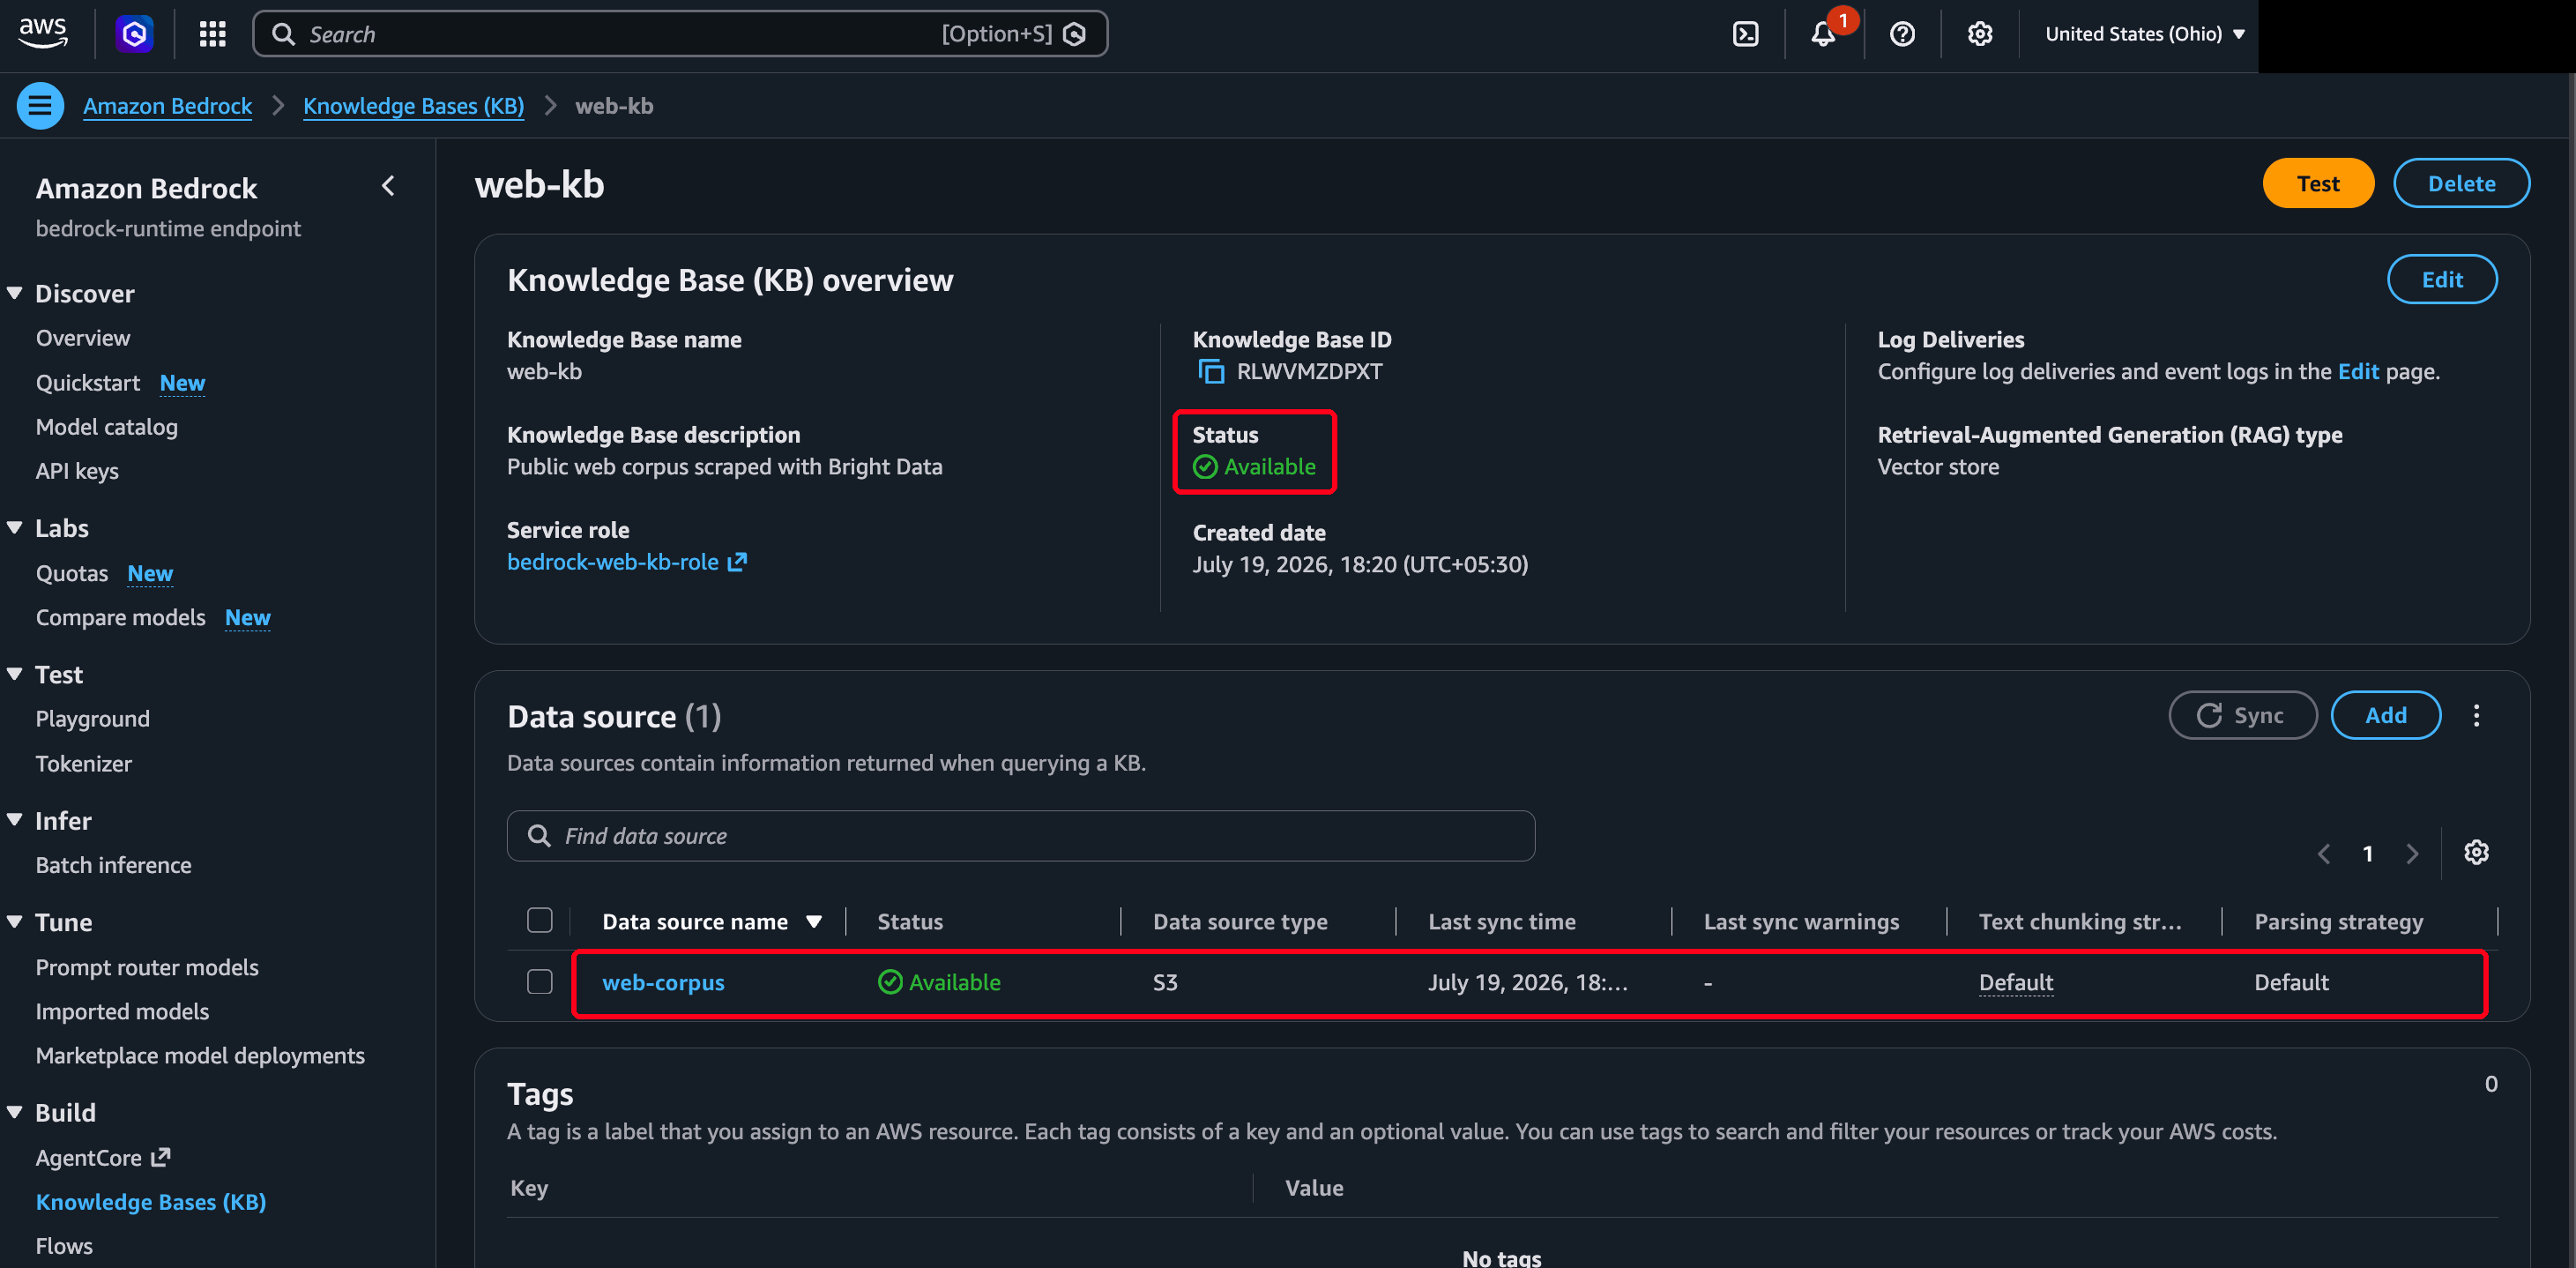
创建流程完成后,知识库详情页面会显示你构建的内容:
步骤 4:摄取并保持数据新鲜
创建知识库并不会读取你的数据。摄取才会读取。一次同步称为摄取作业,它会读取存储桶、对文档进行分块和嵌入,并写入向量。你会在首次加载后启动一次,并在每次刷新后再次启动:
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

def sync(knowledge_base_id: str, data_source_id: str) -> str:
    job = bedrock_agent.start_ingestion_job(
        knowledgeBaseId=knowledge_base_id,
        dataSourceId=data_source_id,
    )
    return job["ingestionJob"]["ingestionJobId"]
第一次完整同步之后,后续同步都是增量的。Bedrock 会摄取新增和修改过的文件,并移除已离开存储桶的文件对应的向量,因此一次刷新只会重新嵌入加载器重写过的页面。这种行为让步骤 2 中的哈希门控变得必要,因为你用相同字节重写的对象仍然可能被计为已修改。slugify 键是确定性的,因此重新抓取同一个 URL 会覆盖同一个对象,而不是创建副本。
这可以处理新增和已更改的页面,但不会移除你下线的页面。加载器只会写入,因此从列表中删除某个 URL 并不会删除它的对象。那部分过期内容会留在语料库中,并可能出现在之后的任何答案里。下线页面是一个单独的对账步骤,它会列出存储桶、找到 URL 已不存在的对象并删除它们,这样下一次同步就会清除对应向量。配套代码库将其作为 7_reconcile.py 提供,这是一个默认 dry-run 的脚本。它会与完整 URL 列表做差异比较,因此绝不会把只是抓取失败的页面误认为你已移除的页面。
将重新同步计划与语料库中变化最快的内容匹配。社交帖子可能在数小时内过期,新闻可能在数天内过期,定价和财务页面可能在数周内过期,而参考文档可以保持数月不过时。这些是起点,不是测量结果。新闻页面知识库可以每天重新同步一次,而基于产品文档构建的知识库可以每周重新同步一次。Amazon EventBridge 计划可以按你选择的任意间隔触发抓取和同步,因此刷新无需人工启动。
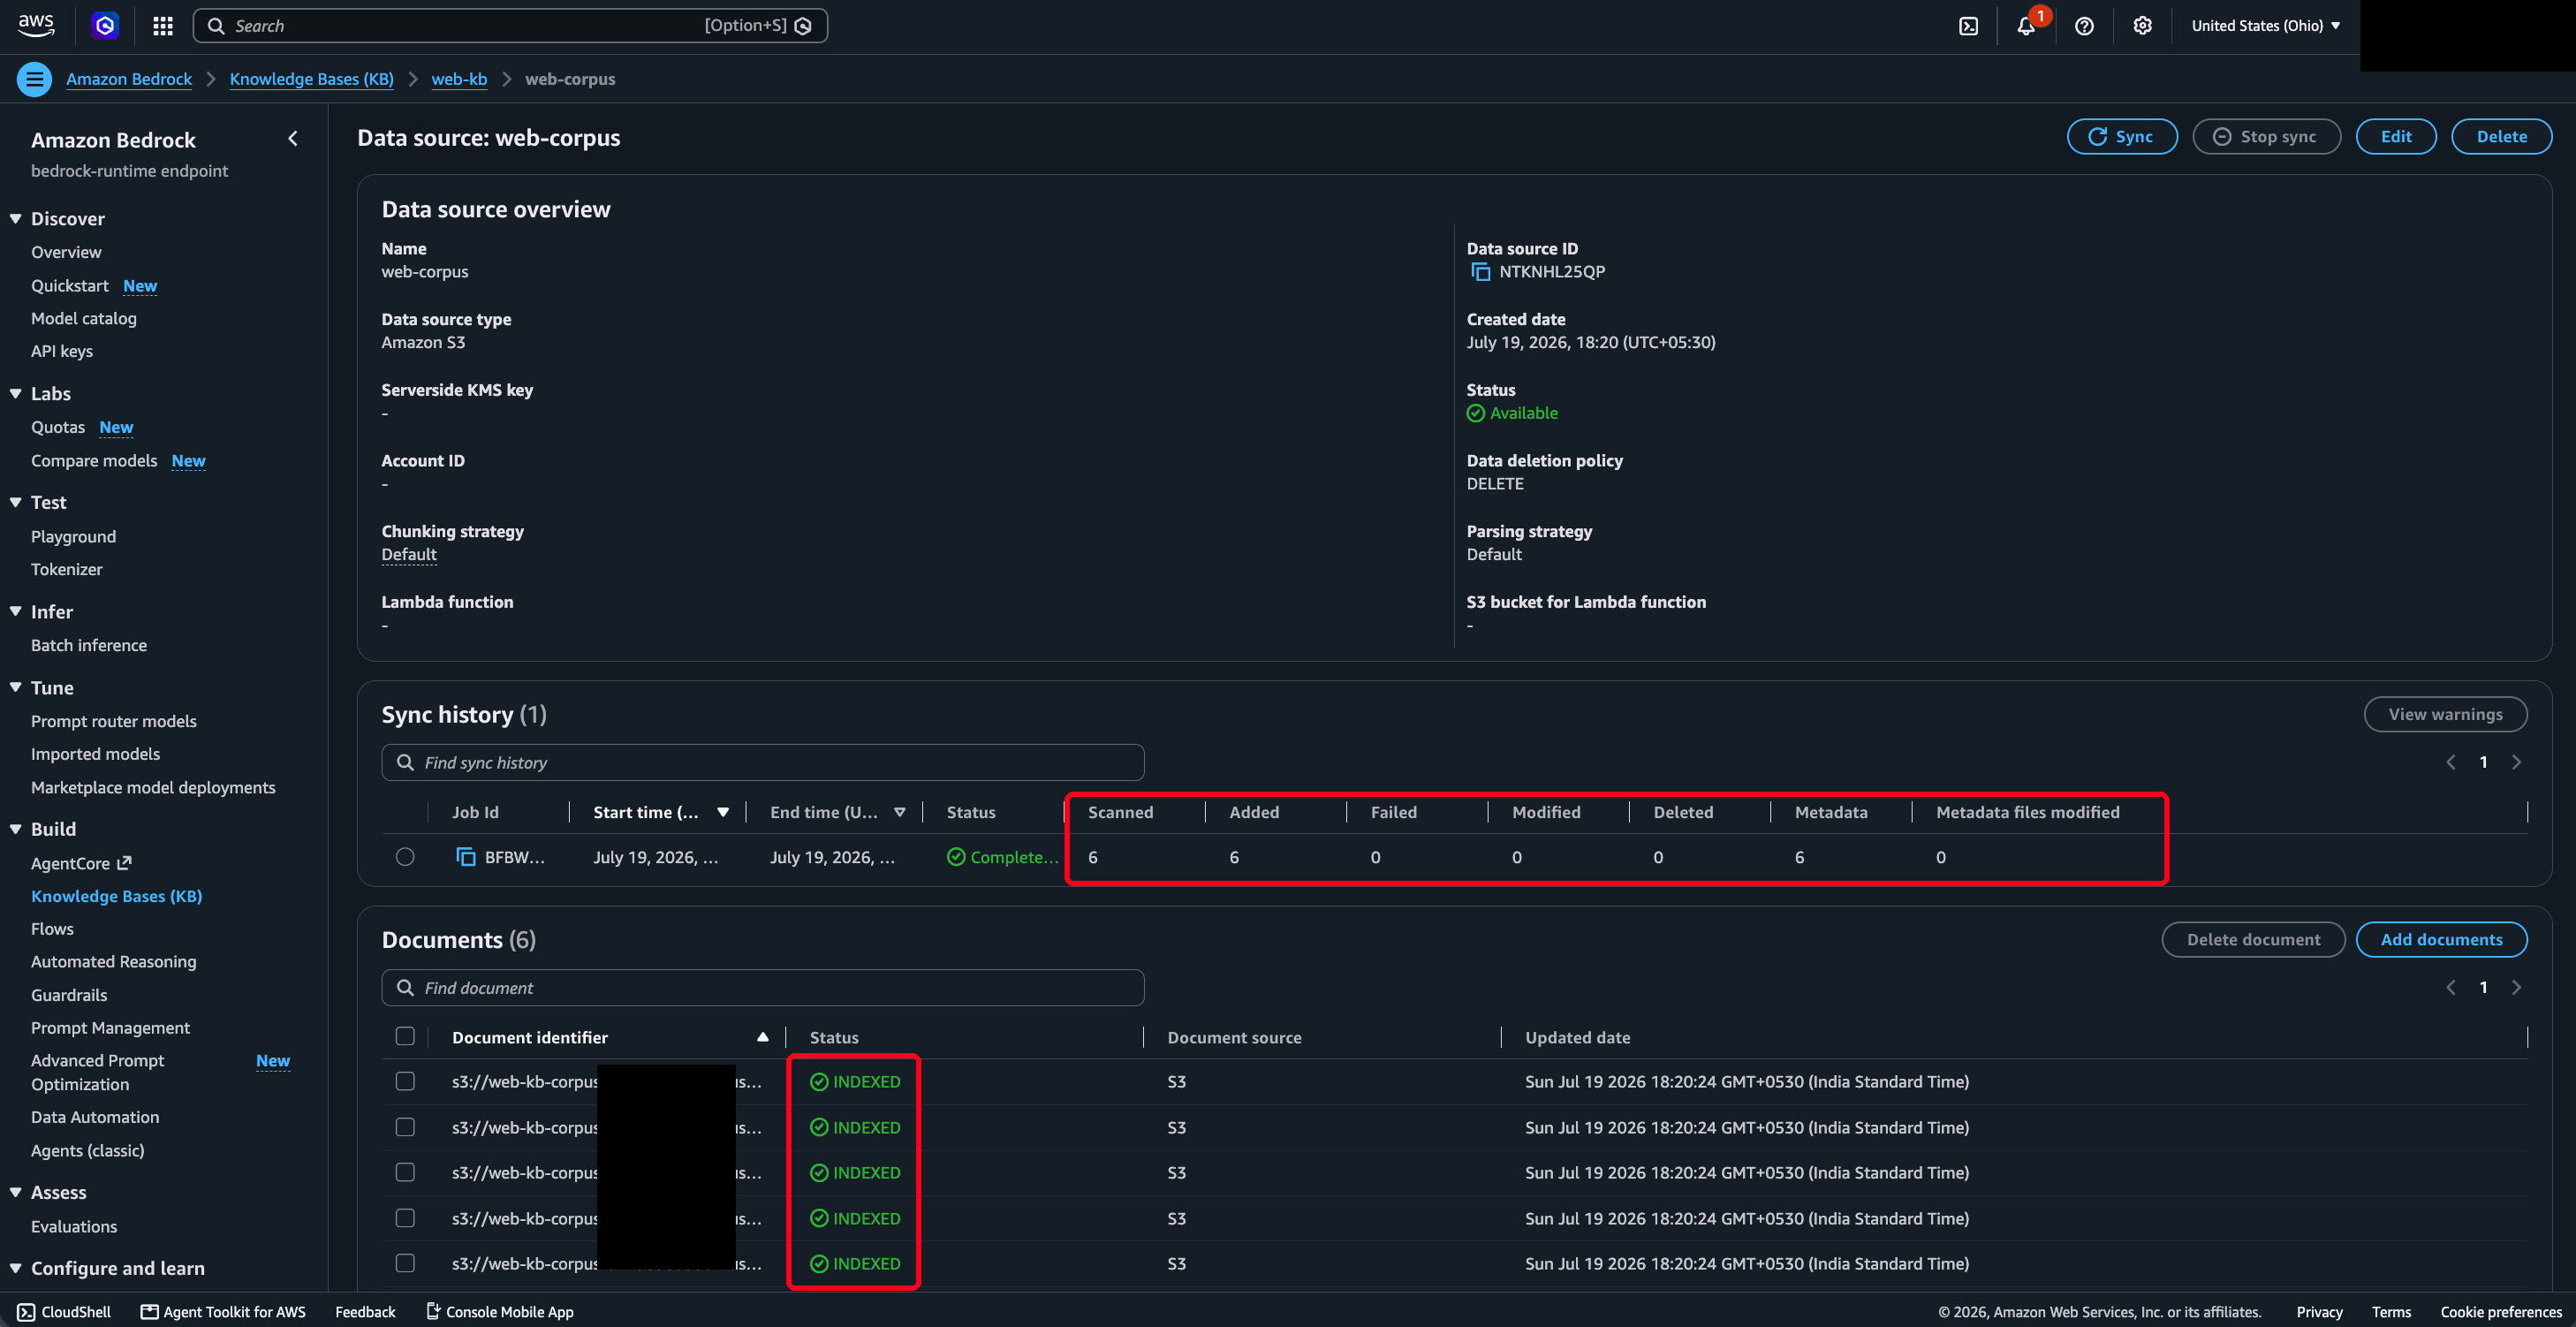
读取统计数据,而不是只看状态。即使大多数文档失败,摄取作业也会报告 COMPLETE。一次只索引了 6 个页面中的 1 个页面的运行,仅从状态字段看仍然像是成功。代码库中的 3_sync.py 会打印这些计数,并在失败时以非零状态退出:
{"status": "COMPLETE",
 "statistics": {"numberOfDocumentsScanned": 6, "numberOfNewDocumentsIndexed": 6,
                "numberOfModifiedDocumentsIndexed": 0, "numberOfDocumentsDeleted": 0,
                "numberOfDocumentsFailed": 0}}
这是来自 6 页语料库的实测结果,并且尝试了两次才得到。第一次运行报告 COMPLETE同时 numberOfDocumentsFailed: 5它们全部遇到了步骤 3 中描述的 S3 Vectors 元数据限制。文档失败时,作业上的 failureReasons 会带有实际错误,这是首先要看的内容。零嵌入配额也会出现在这里,并且看起来像权限问题。摄取 6 个页面大约花了 25 秒。时间和块数量会随语料库以及分块方式扩展,因此请在自己的数据上测量。
数据源页面会在同步历史中列出每个作业,并显示每个文档的统计信息:
步骤 5:查询知识库
Bedrock 提供一个检索调用和一个生成调用。你选择哪一个,取决于你想要原始证据还是写好的答案。两者都在 bedrock-agent-runtime 客户端上。
Retrieve 只返回源块,不返回其他内容。当你自己的模型或应用负责写作,而你只需要有依据的上下文和引用时,它是正确选择:
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

def retrieve(kb_id: str, query: str, section: str | None = None,
             num_results: int = 5) -> list[dict]:
    config = {"vectorSearchConfiguration": {"numberOfResults": num_results}}
    if section:
        config["vectorSearchConfiguration"]["filter"] = {
            "equals": {"key": "section", "value": section}
        }
    resp = runtime.retrieve(
        knowledgeBaseId=kb_id,
        retrievalQuery={"text": query},
        retrievalConfiguration=config,
    )
    return resp["retrievalResults"]
每个结果都包含块文本、相关性 score、源对象的 location以及你在步骤 2 中写入的 metadata。在这个语料库上,正确的首位结果得分为 0.67,这个数字之后可用来设置相关性下限。这些元数据让可选的 filter 可以工作,将搜索限制在一个 section 或一个日期范围内:
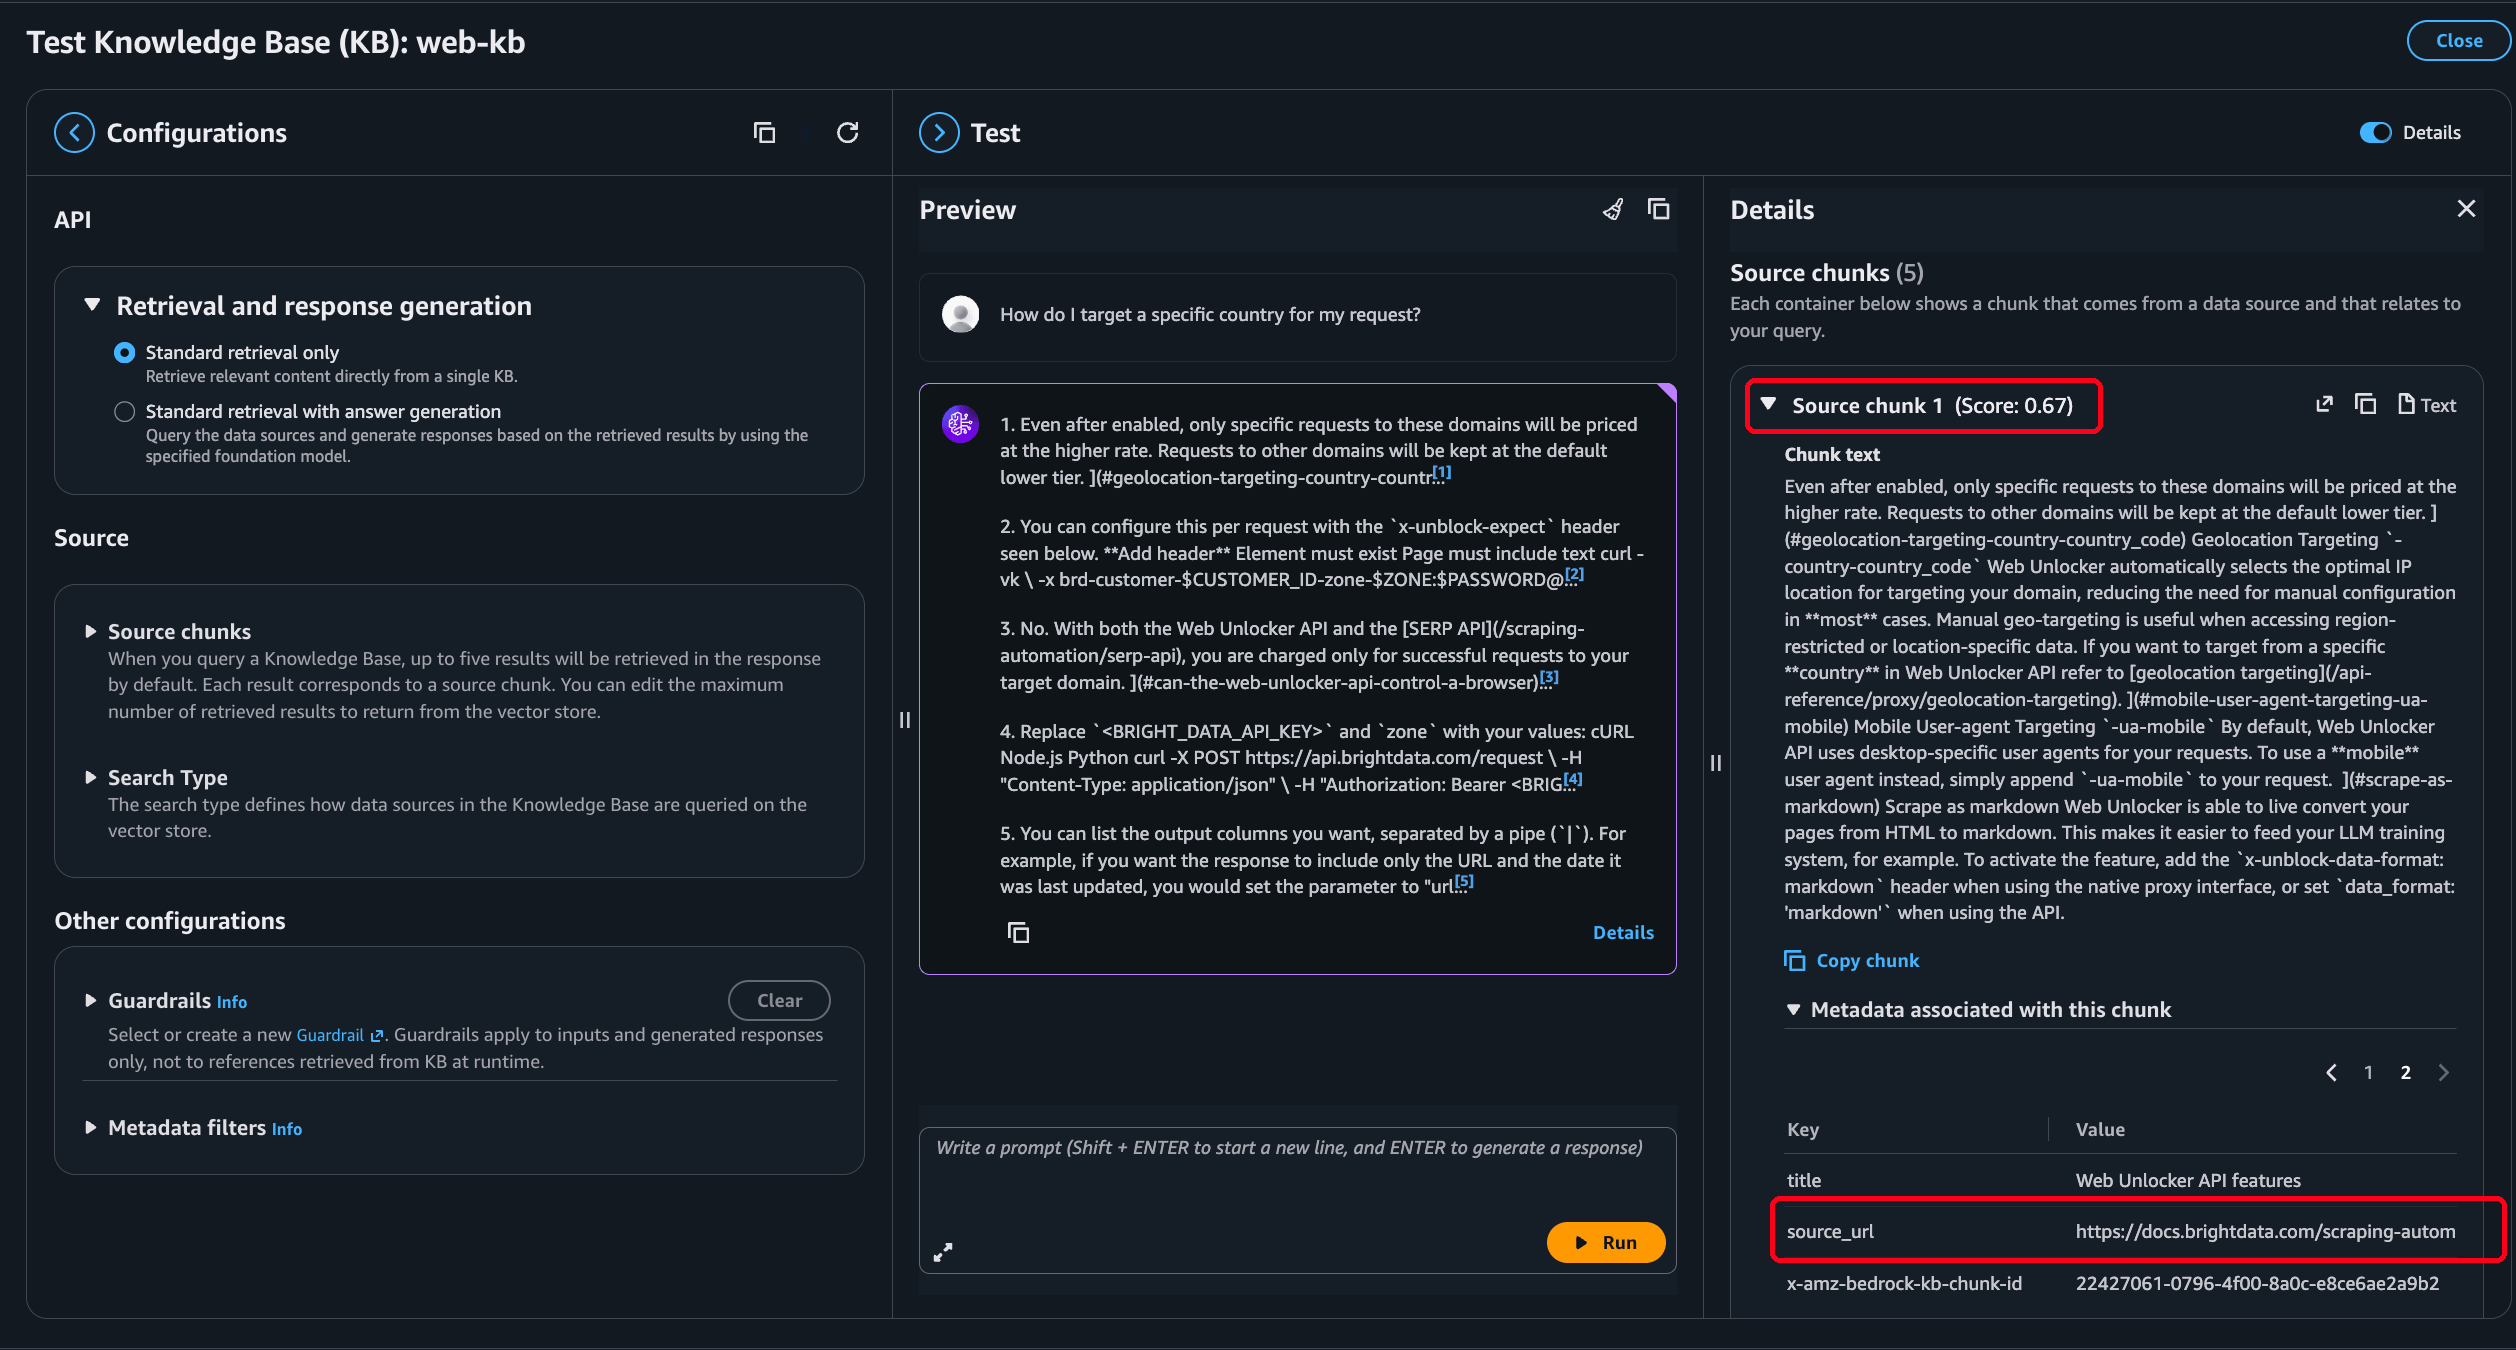
原生爬虫工具会摄取没有 sidecar 步骤的 HTML,因此这些属性没有来源。
RetrieveAndGenerate 会执行 Retrieve 所做的事,然后写出答案。它会将答案基于检索到的块,并一同返回引用:
def answer(kb_id: str, query: str, model_arn: str) -> dict:
    resp = runtime.retrieve_and_generate(
        input={"text": query},
        retrieveAndGenerateConfiguration={
            "type": "KNOWLEDGE_BASE",
            "knowledgeBaseConfiguration": {
                "knowledgeBaseId": kb_id,
                "modelArn": model_arn,
            },
        },
    )
    return resp   # resp["output"]["text"] plus resp["citations"]
响应包含生成的文本,以及一个 citations 数组,该数组会把答案中的片段映射到它们来源的块。因为你在 sidecar 中设置了 source_url每条引用都会解析到你爬取的页面。关于某个产品定价的答案随后会引用 Bright Data 获取的定价页面。
如果你构建的是完全托管的知识库,请使用 managedSearchConfiguration 代替 vectorSearchConfiguration因为托管知识库默认运行开启重排序的混合搜索。配套代码库中的 retrieve() 标出了替换位置。
步骤 6:衡量检索是否有效
到目前为止,流水线中没有任何内容能告诉你,知识库是否会针对用户提出的问题返回正确页面。修正错误的块大小意味着要重新创建数据源,因此应该在 20 个页面上发现问题,而不是在 20,000 个页面上。
用于此目的的工具是黄金集,也就是一组问题列表,每个问题都带有应该回答它的页面。这条流水线的集合包含 6 个问题,并以 eval/golden.json 的形式放在代码库中,旁边还有 eval/golden-v1-mislabeled.json也就是本节将解释其错误标签的第一个版本:
[
  {"question": "How do I get the page back as markdown instead of HTML?",
   "expect": ["https://docs.brightdata.com/scraping-automation/web-unlocker/features"]},
  {"question": "How do I target a specific country for my request?",
   "expect": ["https://docs.brightdata.com/scraping-automation/web-unlocker/features",
              "https://docs.brightdata.com/scraping-automation/web-unlocker/configuration"]}
]
然后,你通过 Retrieve 运行每个问题,并记录预期页面出现在结果中的位置:
def evaluate(kb_id: str, golden: list[dict], k: int = 5):
    ranks = []
    for item in golden:
        chunks = retrieve(kb_id, item["question"], num_results=k)
        got = [c.get("metadata", {}).get("source_url", "") for c in chunks]
        # 1-based rank of the first expected page, or None if it never appeared
        ranks.append(next((i + 1 for i, u in enumerate(got) if u in item["expect"]), None))

    hit_rate = sum(r is not None for r in ranks) / len(ranks)
    mrr = sum(1 / r if r else 0 for r in ranks) / len(ranks)
    missed = [g["question"] for g, r in zip(golden, ranks) if r is None]
    return hit_rate, mrr, missed
命中率是预期页面曾经出现过的问题所占比例。它告诉你语料库是否首先能够为答案提供依据。平均倒数排名会对 1 除以该页面排名的结果取平均值。当正确页面出现了但排在第 5 位时,它会下降,而仅看命中率会掩盖这一点。
未命中列表才是你需要采取行动的部分。未命中通常意味着四种情况之一。页面从未进入语料库,因此要检查加载器输出中是否有获取失败。分块太大,导致周围文本稀释了相关段落。分块太小,导致该段落丢失了让它匹配上的上下文。或者你的黄金集是错的。
第一次评估运行得到 83% hit@5,其中一个未命中是 “How do I target a specific country for my request?” 黄金集预期的是配置页面。阅读检索返回的分块后,问题就解决了。来自功能页面的段落逐字包含了国家定向文档。检索是正确的,标签是错误的。修正后,hit@5 达到 100%,MRR 为 0.88,hit@3 为 83%,MRR 为 0.83。这是针对 6 个页面的 6 个问题,所以请把它们看作一个经过测量的数据点,而不是基准测试。
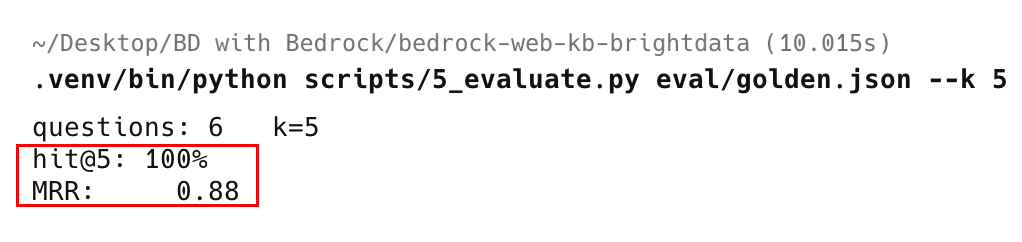
在你修改流水线的任何内容之前,务必先阅读未命中时检索返回了什么。只有检索到的文本才能告诉你是检索错了,还是标签错了。流水线问题会让你去检查加载器,分块问题会让你回到数据源,而标注错误的问题只需要一个更好的黄金集。
在扩展语料库之前运行它,并持续运行。一旦命中率达到你满意的水平,就把它作为发布门禁。配套仓库的评估脚本正是为此提供了 --min-hit-rate 标志。这样,定时刷新如果悄悄降低了检索质量,就会明显失败,而不是发布更差的答案。
Bedrock 还提供托管评估,用评判模型为检索和生成打分。用它来研究质量,同时把黄金集保留为发布门禁。这个集合是确定性的,只产生检索调用成本,并且在这个规模下几秒钟即可运行。
何时超越知识库
知识库是你所选择页面的快照。你嵌入它们一次,然后查询它们很多次。这个快照让每次查询都很便宜,同时也让两类问题超出它的能力范围。关于事实变化速度快于同步计划的问题,会得到过时答案。关于从未进入语料库的页面的问题,则没有任何内容可供匹配。
不要在持久化知识库和实时检索之间只做一次性选择,而是按每次查询进行路由。先询问知识库,当它无法为问题提供依据时,再回退到实时 Bright Data 查询:
def route_answer(kb_id: str, query: str, min_score: float = 0.4):
    chunks = retrieve(kb_id, query, num_results=5)
    top = max((c.get("score", 0.0) for c in chunks), default=0.0)

    if chunks and top >= min_score:
        return "knowledge_base", chunks

    # nothing in the corpus covers this, so search and fetch it live
    return "live_web", live_context(query)      # Bright Data SERP + Web Unlocker
live_context 是仓库中位于 src/web_kb/live_tool.py 的先搜索后获取辅助函数,它需要一个 Bright Data SERP 区域,并与第 1 步中的网络解锁器区域配合使用。你用同样的方式创建 SERP 区域,并通过相同的 api.brightdata.com/request 端点调用它。它会以 JSON 形式返回结果页面,因此回退逻辑可以选择要获取的 URL。
相关性下限就是路由信号。Bedrock 会随每个分块返回一个分数,当最高分低于下限时,语料库很可能不覆盖这个问题。仍然从语料库回答正是要避免的失败模式,因为结果会是一个自信的答案,却引用了并不支持它的页面。
上面的 0.4 是起点,不是测量值。它低于第 5 步中正确首位结果得到的 0.67。请结合第 6 步的黄金集,以及几个你知道语料库不覆盖的问题来调优它。5_evaluate.py 会打印它观察到的区间、命中时的最低分和未命中时的最高分。下限应位于它们之间。请把这些额外问题放在单独文件中,因为没有预期页面的问题会在发布门禁中计为未命中。
托管知识库会在内部做出这种决策的一个版本,称为智能体检索。把这个决策保留在你自己的代码中,意味着你可以检查信号、下限和回退逻辑,并且实时路径可以触达 AWS 之外的内容。你可以把它连接为 Bedrock 智能体操作组,作为 Strands 智能体 这类框架中的工具,或者作为 Bright Data 的 MCP 服务器。
该服务器为任何兼容 MCP 的智能体提供相同的实时搜索、解锁和爬取能力。在 AgentCore Gateway 中,它与调用 Retrieve 的工具并列存在。路由规则不会改变,改变的只是回退逻辑运行的位置。
当你反复查询同一批页面、需要引用、筛选器和访问控制,并且语料库变化速度慢于查询速度时,知识库就是正确选择。当事实变化快于同步、问题空间开放,或者你会嵌入远多于实际检索的内容时,实时检索更有优势。平衡失当最明显的信号是,同步频繁到在任何人查询页面之前,你就已经重新嵌入了大多数页面。那时你是在为维护索引付费,而不是在使用它。
提示缓存改变了这条规则的一部分。如果语料库足够小且稳定,能够放进模型的上下文窗口,你就可以完全跳过检索。一旦语料库超出缓存容量,或者答案必须引用精确页面、筛选器必须限制查询、页面按不同计划刷新,这条流水线就值得构建。如果没有这些需求,缓存整个语料库更简单。
使用 Crawl API 和原生 S3 交付实现整站覆盖
到目前为止,这条流水线接收的是一份已知 URL 列表。当语料库增长时,你可能无法提前知道每个 URL,也不想自己运行获取循环。Bright Data 的 Crawl API 可以同时处理这两点。它会从种子 URL 发现并爬取站点的内部页面,并将每个页面以 Markdown 形式返回。它还可以把输出直接交付到你的 S3 存储桶。
这条路径是根据文档整理的,而不是实际运行得出的。下面的调用顺序和字段名遵循 Bright Data 的 API 参考,因此在依赖这条路径之前,请先对照 Crawl API 文档 进行检查。
这个代码片段延续前面的步骤:它复用第 1 步中的 BRIGHTDATA_TOKEN 和第 2 步中的 REGION。Crawl 任务是异步的,交付是单独调用,而不是触发器上的一个选项。你触发一次爬取并收到一个快照 ID,轮询直到该快照为 ready然后把它交给交付端点,并使用 s3 目标。交付调用会把输出写入你的存储桶,你的代码中无需下载步骤:
import requests, time

BD = "https://api.brightdata.com"
HEADERS = {"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"}
CRAWL_DATASET_ID = "..."   # the Crawl API dataset ID from your Bright Data control panel
AWS_KEY, AWS_SECRET = "...", "..."   # delivery credentials. Prefer an IAM role ARN with an external ID

def _call(method: str, path: str, **kw):
    resp = requests.request(method, f"{BD}{path}", headers=HEADERS, timeout=60, **kw)
    resp.raise_for_status()
    return resp.json()

def crawl_to_s3(seed_url: str, bucket: str, directory: str) -> str:
    # 1. Trigger. The body is a bare array of input objects, not a wrapper object.
    snapshot = _call("POST", "/datasets/v3/trigger",
                     params={"dataset_id": CRAWL_DATASET_ID,
                             "custom_output_fields": "markdown|url|page_title"},
                     json=[{"url": seed_url}])["snapshot_id"]

    # 2. Poll. Delivery only accepts a snapshot already in `ready` status.
    while (state := _call("GET", f"/datasets/v3/progress/{snapshot}")["status"]) != "ready":
        if state == "failed":
            raise RuntimeError(f"crawl {snapshot} failed")
        time.sleep(15)

    # 3. Deliver. Returns a delivery job ID, which you poll at
    #    GET /datasets/v3/delivery/{id} until its status is "done".
    return _call("POST", f"/datasets/v3/deliver/{snapshot}",
                 json={"type": "s3",
                       "bucket": bucket,
                       "directory": directory,
                       "region": REGION,
                       "credentials": {"aws-access-key": AWS_KEY,
                                       "aws-secret-key": AWS_SECRET},
                       "filename": {"template": "crawl", "extension": "json"}})["id"]
Bright Data 交付的是 JSON、NDJSON 或 CSV 记录,而不是每个页面一个 Markdown 文件,因此在交付和摄取之间需要一个规范化步骤。由 S3 触发的 Lambda 函数会处理这一步,在交付把输出写入落地区前缀时触发。该函数会把每条记录拆分为知识库源前缀下的一个 <slug>.md 文档及其 .metadata.json sidecar。这正是你在第 2 步中手动写出的形状。然后 Bedrock 的 S3 数据源会在下一次同步时摄取这些文件。
上面的示例传入了密钥对。更推荐使用带外部 ID 的 IAM 角色 ARN,这样请求中就不会出现长期有效的密钥。
两条路径之间的取舍是控制力与规模。网络解锁器配合你自己的加载器,可以让你精确控制每个文件名和元数据字段。这非常适合经过策划的列表。Crawl API 配合 S3 交付和规范化 Lambda,可以提供广覆盖,并且无需你自己维护获取循环。这非常适合你想保持同步的整站版块语料库。
成本考量
请把下面的数字当作你自己估算的模板,而不是报价;在做出承诺之前,请根据 Bright Data 价格 和 Amazon S3 价格 为你自己的语料库计价。
| 组件 | 计价方式 | 驱动因素 |
|---|---|---|
| Bright Data 网络解锁器 | 按量付费时,每 1,000 次成功请求 $1.50,高级费率为 $2.50。失败不计费 | 每抓取一个页面 1 次请求 |
| Bright Data Crawl API | 按量付费时,每 1,000 条记录 $1.50 | 每个任务发现并爬取的页面数 |
| Bedrock embeddings (Titan V2) | 按输入 token 计费 | 摄取时所有分块的总 token 数,加上每次查询 |
| 向量存储 | S3 Vectors 按量付费,或 OpenSearch Serverless 按 OCU 小时计费 | 语料库大小和查询量 |
| Amazon S3 | 存储和请求,在这个规模下只有几美分 | 每个页面 1 个 .md 加 1 个 sidecar |
| RetrieveAndGenerate | 按生成模型的 token 计费 | 答案量和模型选择 |
以下是按标准费率走网络解锁器路径时,对 6 页语料库刷新一次的成本。
- 抓取。 6 次网络解锁器请求,按每 1,000 次 $1.50 计算为 $0.009。
- 嵌入。 60,846 个清洗后的字符,按每 4 个字符约 1 个 token 计算,约 15,000 个 token,按每 1,000 个 $0.00002 计算,约为百分之三美分。
- 向量存储。 约 50 个默认大小的分块,远小于 1 MB,按每 GB 每月 $0.06 计算,小到几乎可以忽略。
这个试点每周刷新一次,每月成本约 4 美分,几乎全部来自网络解锁器请求。哈希门禁在没有变化时让嵌入成本保持为零。如果线性扩展,每周刷新 500 个页面,每月抓取成本约为 $3.25,存储成本不到 1 美分。
每次查询的生成 token,以及你选择的向量存储,是可能超过这些数字的两项成本。经典 Amazon OpenSearch Serverless 集合即使空闲也有基线成本。在降低后的开发测试最低配置下,大约为每月 $175;在标准 2-OCU 下限下,大约翻倍。AWS 还提供一种可扩展到零的集合类型,其价格见 OpenSearch Service 价格页面。与经典集合相比,在中等查询量的定时刷新场景下,S3 Vectors 会改变成本计算。
限制与生产加固
这条流水线是参考架构,不是可直接投产的产品。
- 新鲜度由你自己的计划决定。 知识库是上一次同步时的快照,在两次同步之间,它会按照源数据衰减的速度变得陈旧。同步失败时要发出警报,因为跳过一次运行会让旧数据继续保留。
- 失败的抓取会隐藏在好数据后面。 当你无法获取某个页面时,它之前的版本会继续作为当前版本提供服务。仓库中的加载器会列出失败的 URL,并以非零状态退出,以便定时运行报告这些问题。发现某个页面悄悄停止刷新则是另一个问题。
scraped_date无法回答它,因为一个页面可以连续几个月正常获取但没有变化。仓库会在每次成功获取时为页面打上 last-seen 日期,并报告自某个截止日期以来未见到的 URL。 - 之后无法更改分块或嵌入。 在第一次完整同步之前,请先在页面样本上测试两者。修复模型意味着重新创建知识库,修复分块意味着重新创建数据源。
- 检索到的内容质量取决于页面本身。 Bright Data 会返回页面提供的内容并将其转换为 Markdown。它不会验证页面是否正确。对于你会据此采取行动的任何内容,都要让人工参与,并使用
source_url引用,让验证变成一次点击,而不是猜测。 - 代码片段中的 token 是占位符。 任何定时任务都应从 AWS Secrets Manager 读取它。它绝不应进入仓库。
- 这些数字是测量得出的,但不是来自你的语料库。 在依赖任何具体数字之前,请先用你自己的账号和数据复现它们。
最后的想法
Amazon Bedrock Knowledge Bases 会处理分块、嵌入和带引用的检索,其原生连接器覆盖你已经持有的数据和你拥有的静态页面。会变化、在客户端渲染并会自我防护的公共网络位于这个范围之外,而它往往包含让知识库值得构建的数据。Bright Data 弥合了这一差距,两者在 S3 中汇合。
要扩展这条流水线,可以添加 EventBridge 调度来自动刷新,使用 Bright Data 的 Crawl API 实现整站覆盖,或者在分块稳定后启用 Bedrock reranking。
Bright Data 的网络解锁器包含免费层,便于你开始使用;Crawl API 覆盖整站爬取;你可以从 Amazon Bedrock 控制台 设置 Amazon Bedrock Knowledge Bases。完整可运行项目,包括加载器、知识库设置脚本和 IAM 策略,都在配套仓库中。
常见问题
Amazon Bedrock Knowledge Bases 能否自行爬取网页?
它有一个处于预览阶段的原生 Web Crawler,很适合你自己拥有的静态页面。目前它只处理静态网站,不允许没有 robots.txt 的站点,每次同步最多 25,000 个页面,并且需要 OpenSearch Serverless。对于 JavaScript 页面或受机器人防护的页面,请使用 Bright Data 渲染并解锁内容,然后从 S3 摄取。
为什么要把数据存储在 S3 中,而不是在查询时从网页检索?
持久化知识库会对每个页面嵌入一次,并通过低延迟向量搜索为大量查询提供服务,同时支持引用、元数据筛选和访问控制。通过 Bright Data 进行实时检索适合快速变化或一次性查询。许多生产系统会同时使用两者,并根据分数为每个查询进行路由。
抓取的页面应以什么格式提供给 Bedrock?
Markdown。当你将 data_format 设置为 markdown 时,Bright Data 的网络解锁器会以 Markdown 返回页面,Bedrock 会将其作为受支持的文档类型摄取。转换会去掉 HTML 标记,但不会去掉站点导航,因此在写入 S3 之前要剥离重复的页面外壳。
答案中的引用如何工作?
你将 source_url 属性写入每个文档的 .metadata.json sidecar。Bedrock 会把这些元数据带入检索,因此 Retrieve 会在每个分块上返回它RetrieveAndGenerate 也会包含一个引用数组,将答案中的每个片段解析回其来源页面。
为什么我的摄取作业在没有任何内容被索引时显示 COMPLETE?
因为 status 并不是成功信号。当大多数文档失败时,作业仍可能报告 COMPLETE在这个流水线中,6 个文档中有 5 个失败,但它仍报告 COMPLETE。读取 statistics 以查看每个文档的计数,并读取 failureReasons 以查看错误,这里的错误是 S3 Vectors 的 filterable-metadata 限制。
如何让知识库保持最新?
按计划重新抓取,只写入内容哈希发生变化的对象,然后启动摄取作业。这个哈希门控会阻止 Bedrock 对未变化的页面重新嵌入。根据来源过时的速度来匹配计划,从新闻的每日更新,到文档的每周或更低频率更新。
黄金集需要多少个问题?
比人们预期的要少,而且问题必须是真实的。来自用户实际提问的问题比编造的问题更好,因为重点是找出你的语料无法提供依据的内容,而不是生成一个数字。每当有人报告一个糟糕答案时就添加一个问题,这个集合就会变成回归测试套件。
运行它需要多少成本?
主要成本是 Bright Data 请求,其规模随页面数量乘以刷新频率而变化,另外还有向量存储,以及按 token 计费的嵌入和生成。S3 Vectors 按使用量付费,适合计划刷新,而经典的 OpenSearch Serverless 集合即使空闲也会产生成本。这里的 6 页试点每月约需 4 cents 即可每周刷新。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。