本指南介绍了十个值得连接到 Claude Code 的 MCP 服务器。第一个是 Bright Data MCP。它弥补了智能体自身工具集中的一个盲区。Claude Code 的内置网页工具在设计上会损失信息,而且每个会话都有调用上限。
这里的每个服务器都是持续维护的产品。下方的每条安装命令都来自相应厂商自己的文档。仅仅重复 Claude Code 已有工具的服务器均未列入。接近文末的一节会列出这些服务器,并解释为什么它们只会消耗上下文,却毫无收益。最后两节介绍 Claude Code 的具体注意事项。它们决定了服务器究竟能提供帮助,还是只会增加你的 token 账单。
TL;DR:10 个 MCP 服务器及其各自增加的能力
| # | MCP 服务器 | 它为 Claude Code 增加的能力 | 传输方式 |
|---|---|---|---|
| 1 | Bright Data MCP | 不受封锁的网页抓取、多引擎搜索,以及来自 100 多个平台的结构化 JSON | 远程 HTTP |
| 2 | GitHub MCP 服务器 | 跨仓库处理 Issue、拉取请求、Actions 和代码搜索 | 远程 HTTP |
| 3 | Context7 | 与版本准确匹配的库文档,让智能体不再编造 API | 远程 HTTP |
| 4 | Sentry MCP | 来自线上应用的生产环境错误、堆栈跟踪和链路追踪 | 远程 HTTP |
| 5 | Supabase MCP | 通过一次 OAuth 登录访问 Schema、SQL、分支和 Supabase 文档 | 远程 HTTP |
| 6 | Postgres MCP Pro | 针对你自己的 Postgres 执行 EXPLAIN 计划分析、索引调优和健康检查 | 本地 stdio |
| 7 | Linear MCP | Issue 和项目状态,并提供只读端点 | 远程 HTTP |
| 8 | Figma MCP | 来自 Figma 文件的设计上下文和代码 | 远程 HTTP 或本地 |
| 9 | Notion MCP | 代码需要实现的规格说明、RFC 和团队文档 | 远程 HTTP |
| 10 | Vercel MCP | 部署状态、构建日志和文档搜索 | 远程 HTTP |
什么样的 MCP 服务器才真正适合 Claude Code
大多数“最佳 MCP 服务器”榜单都按 GitHub Star 数量排名。但这衡量的是受欢迎程度,而不是适配性。Claude Code 是一个终端智能体,拥有庞大的原生工具集,但上下文窗口有限。重复内置工具的服务器只会带来净损失。输出冗长的服务器可能消耗得比带来的价值更多。在连接服务器之前,请根据以下五项标准进行检查。
- 它必须增加新能力,而不是重复现有能力。 Claude Code 已经内置
Read、Write、Edit、Grep、Glob和Bash。文件系统或 Shell 服务器不会给你带来任何新能力,只会浪费 token 来重复说明这些内容。 - 它必须允许你缩小工具范围。 最好的服务器会提供工具集、功能组或只读端点。只需要六个工具时却加载六十个,是 MCP 配置最常见的失败方式。
- 它必须保持较小的工具输出。 当任何 MCP 工具的输出超过 10,000 个 token 时,Claude Code 会发出警告,并且默认在 25,000 个 token 处截断。支持分页和筛选的服务器仍然可用;直接转储整张表的服务器则不然。
- 它必须提供简洁的身份验证方式。 使用 OAuth 的远程 HTTP 服务器不需要在配置文件中保存 token。运行一次
/mcp在浏览器中批准授权,就不会有任何敏感信息进入版本控制。 - 它必须能够安全地连接到生产环境。 任何可以写入数据库、代码仓库或支付账本的工具,都应该提供只读模式。默认使用只读模式,仅在必要时有意识地扩大权限。
有一个细节改变了上述所有判断。Claude Code 现在会延迟加载 MCP 工具定义,而不是预先加载。会话开始时只加载工具名称和服务器说明,完整 Schema 会在 Claude 搜索相关工具时才传入。Anthropic 的文档说得很明确:每个服务器没有固定的工具数量上限,真正的限制是你的上下文预算。工具搜索默认开启,并且需要 Sonnet 4.5、Haiku 4.5、Opus 4.5 或更高版本。过去关于 MCP 服务器会占满上下文窗口的说法,如今最多只对了一半。
其他榜单都未提及的缺口:Claude Code 无法正确读取开放网络
Claude Code 内置了两个网页工具,但它们都没有看起来那么强大。工具参考文档称 WebFetch“在设计上会损失信息”。它先获取网页,将其转换为 Markdown,然后用一个快速的小模型处理。Claude 收到的是该模型的回答,而不是网页本身。转换步骤无法配置。大型页面会在固定字符数处截断。重定向到其他主机时只会报告,而不会继续跟随。如果结果声称页面不包含某项内容,也可能只是因为提取提示词没有要求查找它。
WebSearch 的限制更加严格。它只返回标题和 URL,从不获取搜索结果页面。因此,每次真正读取内容时仍然要回退到 WebFetch。后端无法配置。每个会话最多调用 WebSearch 200 次。这个计数包含主对话以及它创建的所有子智能体,因此一次扇出式研究就可能耗尽额度。Amazon Bedrock 完全不提供该工具,而 Azure 托管的 Microsoft Foundry 部署会直接调用失败。
此外,还有一个无法通过配置解决的问题。WebFetch 会发送以 Claude-User 开头的 User-Agent 标头。任何部署了机器人防护的网站都能准确识别访问者,很多网站会直接拒绝访问。定价页面、电商平台、评论网站、招聘网站和社交平台最常进行拦截,而它们往往也是你最需要访问的网站。Anthropic 在自己的文档中给出了解决方案:要使用其他提供商进行搜索,请添加一个公开搜索工具的 MCP 服务器。
1. Bright Data MCP:真正且不受封锁的网页访问
Bright Data MCP 将完整的网页数据技术栈置于一个端点之后。它公开 69 个工具,涵盖搜索、网页抓取、结构化提取、浏览器自动化和软件包注册表查询。每个请求都会通过 Bright Data 的解锁基础设施进行路由。机器人检测、验证码、速率限制和地理限制均按请求进行处理。它是这里唯一能改变 Claude Code 能力边界的服务器。其他服务器只是改善 Claude Code 已经能够尝试完成的任务。
托管服务器无需安装。使用你的 API token 添加 URL,Claude Code 会在下次启动时连接。从 Bright Data 账户设置中获取 token。新账户包含下述免费额度。
claude mcp add --transport http brightdata "https://mcp.brightdata.com/mcp?token=YOUR_API_TOKEN"抓取任意 URL,包括受保护的页面。 scrape_as_markdown 可以直接替代 WebFetch并且它返回的是页面本身,而不是页面摘要。scrape_batch 一次调用最多可处理十个 URL;如果替代方案是进行十次往返请求,这一点就非常重要。scrape_as_html 返回原始 HTML,而 extract 可使用可选的提取提示词,将任意页面转换为结构化 JSON。
搜索不受会话调用上限限制。 search_engine 通过搜索引擎 API查询 Google、Bing 或 Yandex。Google 会返回包含 URL、标题和描述的结构化 JSON,并使用游标对结果进行分页。search_engine_batch 一次最多运行十个查询。discover 还提供按相关性排序的搜索,支持意图、日期筛选和地理定位,这正是深度研究真正需要的形式。
对于已知平台,可完全跳过解析。 45 个 web_data_* 工具通过网页爬虫工具 API返回干净的 JSON。覆盖的网站包括 Amazon、LinkedIn、Instagram、TikTok、YouTube、X、Reddit、Facebook、Crunchbase 和 Zillow。每个工具都会验证自己的 URL 格式,并按返回的记录数计费。其中两个工具对编程智能体尤其重要:web_data_npm_package 和 web_data_pypi_package 会返回软件包版本、README 和依赖项,两者都不会抓取注册表。
使用分组控制工具范围。 这是让服务器保持低成本的关键。五个基础工具始终开启,其他所有工具只会在你请求时加载。将 &groups= 追加到托管 URL,或在本地 npx 安装中设置 GROUPS。共有十一个可用分组,分别是 ecommerce、social、browser、business、finance、research、app_stores、travel、geo、code 和 advanced_scraping。
# coding-agent setup: base tools plus npm and PyPI package data
claude mcp add --transport http brightdata \
  "https://mcp.brightdata.com/mcp?token=YOUR_API_TOKEN&groups=code"

# research setup: add AI extraction and remote browser control
claude mcp add --transport http brightdata \
  "https://mcp.brightdata.com/mcp?token=YOUR_API_TOKEN&groups=browser,advanced_scraping"
当页面需要点击操作时,控制真实浏览器。 13 个 scraping_browser_* 工具通过浏览器 API打开远程会话,然后执行导航、点击、输入、滚动和快照操作。无需本地 Chrome,也无需持续更新驱动程序。它可以处理登录墙、无限滚动和多步骤表单,这些都无法通过单次获取完成。
此外还有官方 Claude Code 插件。brightdata-plugin 已列入 Anthropic 的 claude-plugins-official 市场。它会同时安装 MCP 服务器和七项技能。其中一项技能会指示 Claude 优先使用这些工具,而不是 WebFetch 和 WebSearch。这条指令比听起来更重要,最后一节会解释原因。
/plugin install brightdata-plugin@claude-plugins-official定价从每月 5,000 次请求的免费额度开始,无需信用卡。额度会在每月 1 日更新,未使用的请求不会结转。在团队账户中,额度池由所有成员共享。超出后,按量付费价格为每 1,000 次请求 1.50 美元托管隐身浏览器的费用为 8 美元/GB。免费额度耗尽后,请求会停止,除非你已预存资金。你还可以在控制面板中设置支出上限。
2. GitHub MCP 服务器:完成工作的另一半
Claude Code 已经可以运行 git如果你已安装 gh也可以运行它。但它无法仅通过 Shell 理解 GitHub 中代码仓库之外的内容。官方服务器涵盖 Issue、拉取请求、代码审查、Actions 运行、代码搜索、通知和安全警报。你可以让它读取失败的工作流运行记录、找出导致回归的提交,然后创建拉取请求。整个过程无需切换窗口。
GitHub 提供托管的远程服务器,这是最简单的使用方式。对于 Claude Code 2.1.1 及更高版本,GitHub 自己的安装指南使用 add-json。较旧的 --transport http 形式在早期版本上仍然有效。
claude mcp add-json github \
  '{"type":"http","url":"https://api.githubcopilot.com/mcp","headers":{"Authorization":"Bearer YOUR_GITHUB_PAT"}}'
有两个标志决定了这个服务器是易用还是令人不堪重负。--toolsets 接受类似 repos,issues,pull_requests,actions,code_security 的允许列表,而 --tools 可指定单个工具,以实现更精细的控制。--read-only 的优先级高于两者,因此即使你明确请求写入工具,它们也会被跳过。对于任何你不希望智能体推送内容的代码仓库,请从只读模式开始。还有一点值得注意:npm 软件包 @modelcontextprotocol/server-github 已于 2025 年 4 月弃用。不要采用仍然推荐它的指南。
3. Context7:与你安装的版本相匹配的文档
每个编程智能体都有相同的失败模式:它会编写一个在两个大版本之前还正确的 API 调用。代码看起来很合理,但你会在一个早已不存在的方法上浪费二十分钟。Context7 会按需从源代码仓库提取特定版本的文档和代码示例,并将其放入上下文。它公开两个工具。resolve-library-id 将库名称转换为 Context7 ID,随后 query-docs 会根据你的问题检索该 ID 对应的文档。
设置命令会处理 OAuth、生成密钥,并为你的智能体安装正确的集成。它提供两种模式:CLI 加技能,或普通 MCP 服务器;--claude 专门面向 Claude Code。托管端点支持匿名使用,提供 API 密钥则可提高速率限制。
npx ctx7 setup --claude

# or connect the hosted server directly
claude mcp add --transport http context7 https://mcp.context7.com/mcp \
  --header "Authorization: Bearer YOUR_API_KEY"
两个习惯能让它发挥价值。首先,在 CLAUDE.md 中添加一行,告诉 Claude 只要需要库文档就使用 Context7。这样你就不必每次手动输入“use context7”。其次,如果你已经知道所用的库,请直接在提示词中指定它的 ID,例如 use library /vercel/next.js。这样可以跳过解析步骤并减少一次往返请求。
4. Sentry MCP:从线上应用了解真正出了什么问题
粘贴到终端里的堆栈跟踪只是一个静态遗迹。Sentry MCP 会向 Claude Code 提供实时 Issue,包括错误、发生频率、受影响的版本、面包屑和链路追踪。这会把“修复这个 Bug”变成智能体能够直接着手处理的任务,而不再需要猜测。所有连接都使用 OAuth,因此第一次调用会打开浏览器授权流程,不会将 token 写入配置文件。
端点接受可选的路径段,用于限定连接范围。推荐将范围限定到项目。这样工具会默认使用该组织和项目,而发现工具也会从工具列表中移除。这意味着更小的工具范围和更少的错误猜测。
claude mcp add --transport http sentry \
  https://mcp.sentry.dev/mcp/YOUR_ORG_SLUG/YOUR_PROJECT_SLUG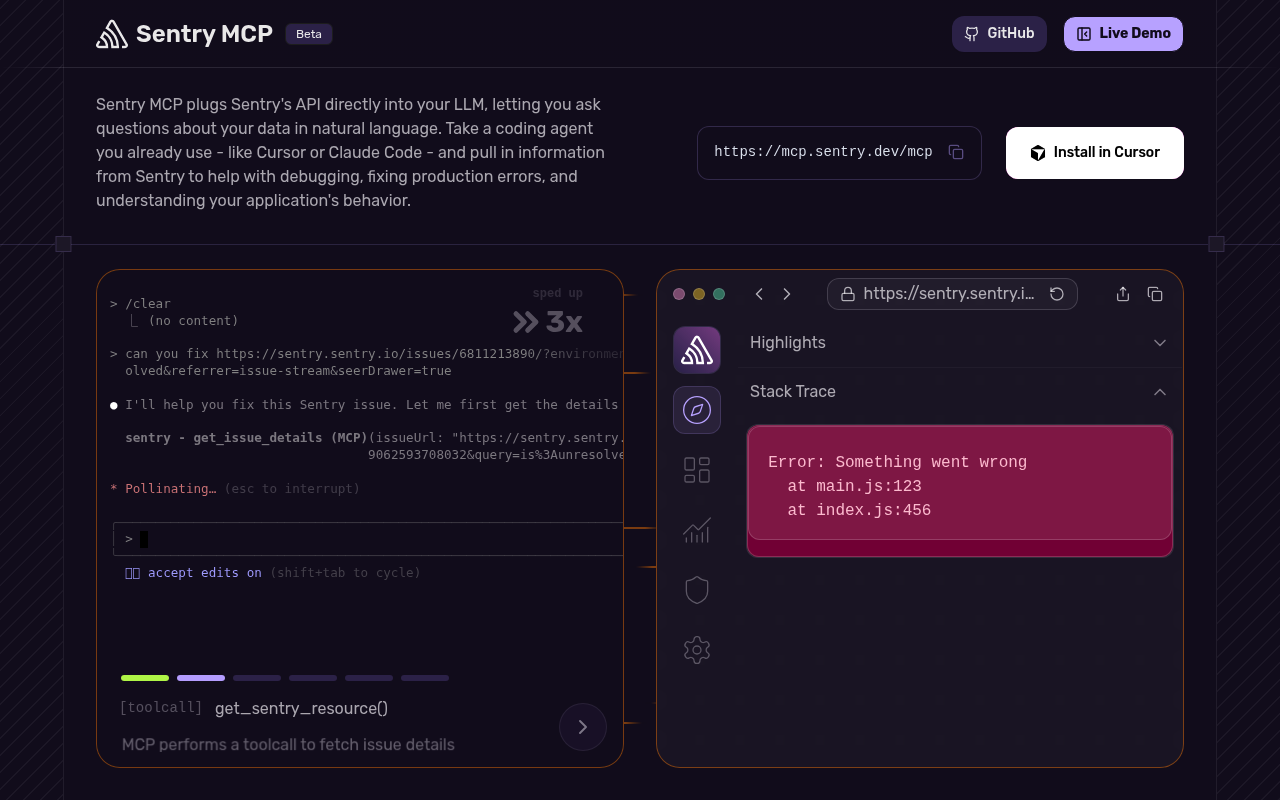
Sentry 还通过自己的市场提供 Claude Code 插件,它可以完成裸服务器无法完成的事情。该插件提供一个 sentry-mcp 子智能体。当你询问错误、Issue、链路追踪或性能时,Claude 会自动将任务委派给它。这个子智能体拥有自己的上下文窗口,因此信息量庞大的 Issue 搜索不会淹没你的主会话。
claude plugin marketplace add getsentry/sentry-mcp
claude plugin install sentry-mcp@sentry-mcp
5. Supabase MCP:通过一次登录访问 Schema、SQL 和文档
如果你的后端使用 Supabase,这个服务器可以打通代码与其所连接数据库之间的闭环。Claude Code 可以读取 Schema、运行 SQL、检查日志、管理分支并搜索 Supabase 自己的文档。实际好处是,它不再需要猜测列名。身份验证通过你的 Supabase 账户使用 OAuth 完成,因此无需个人访问 token。
URL 是你进行安全配置的地方。features 限制加载哪些工具组project_ref 将服务器固定到单个项目,而 read_only=true 会移除所有可执行变更的工具。Supabase 文档展示了项目范围的安装方式,该方式会写入 .mcp.json让整个团队使用相同配置。
claude mcp add --scope project --transport http supabase \
  "https://mcp.supabase.com/mcp?features=docs,database,debugging,development"

# pin one project and drop every write tool
claude mcp add --transport http supabase \
  "https://mcp.supabase.com/mcp?project_ref=YOUR_REF&read_only=true&features=database,docs"
添加后运行 /mcp选择服务器并完成身份验证。请先将它连接到开发项目。对生产环境保持只读是合理的常态。只有在真正需要迁移的会话中才扩大权限。
6. Postgres MCP Pro:不仅仅是连接,还提供查询计划和索引调优
先纠正一个大多数榜单都会犯的错误。参考集合中的 PostgreSQL 服务器已归档,参考 GitHub 服务器也是如此。任何在 2026 年仍然推荐来自 modelcontextprotocol/servers 的“PostgreSQL MCP 服务器”的榜单,指向的都是一个已迁移至 servers-archived 的仓库。Postgres MCP Pro 才是持续维护的选项,而且它能做的远不只是封装连接字符串。
它会分析索引健康状况、连接利用率、缓冲区缓存、Vacuum 健康状况、序列上限和复制延迟。它可以审查 EXPLAIN 计划,并在实际创建索引之前模拟假设索引。它还会从整个工作负载中探索候选索引,而不是一次只分析一个查询。一个智能体编写 SQL,另一个告诉你查询为什么很慢。这就是两者的区别。
它通过 Docker、uvx 或 pipx 作为本地 stdio 服务器运行。--access-mode 是需要重点考虑的标志。restricted 强制执行只读事务和安全 SQL 解析;unrestricted 则允许智能体写入。对于任何重要的数据库,都应使用前者。
claude mcp add postgres -e DATABASE_URI="postgresql://user:pass@localhost:5432/dbname" \
  -- uvx postgres-mcp --access-mode=restricted
7. Linear MCP:直接获取工单,无需复制粘贴
它弥补的是一个虽小却持续存在的缺口。你用自己的话描述工单,却遗漏了验收标准,最后得到的结果只是与需求相近,而不是需求本身。连接 Linear 服务器后,Claude Code 会直接读取 Issue 及其所属项目、状态、评论和链接。它还可以在工作完成时更新状态,让看板保持准确,而你无需切换到另一个窗口。
Linear 运行一个使用 OAuth 的远程服务器。添加后,运行 /mcp 完成浏览器授权流程。有两种方法可以保持只读。你可以连接到仅公开读取工具的 /mcp/readonly 端点,也可以使用标准端点,但只申请 read OAuth Scope。该 Scope 签发的 token 无法访问写入 API。
claude mcp add --transport http linear-server https://mcp.linear.app/mcp

# read-only variant
claude mcp add --transport http linear-server https://mcp.linear.app/mcp/readonly
8. Figma MCP:使用设计上下文,而不是截图
给智能体一张设计截图,只会得到近似实现。把文件交给它,则可以获得间距、组件名称、设计 token 和变体。Figma 服务器会向 Claude Code 提供这些上下文。它还可以写回画布,将你的实时 UI 捕获为设计图层。远程服务器适用于所有席位和套餐;桌面服务器则需要付费套餐中的 Dev 或 Full 席位。
Figma 为 Claude Code 推荐的方式是官方插件。它将 MCP 服务器设置与常见设计转代码工作流的智能体技能捆绑在一起。安装并重启后,从 /plugin 菜单完成授权。如果你更喜欢桌面服务器,它会监听一个本地端口。
claude plugin install figma@claude-plugins-official

# desktop server alternative
claude mcp add --transport http figma-desktop http://127.0.0.1:3845/mcp
关于成本有一点需要注意,因为它将发生变化。Figma 表示,智能体支持在 Beta 期间目前免费,最终会成为按使用量计费的付费功能。在构建依赖其永久免费这一假设的工作流之前,请检查最新条款。
9. Notion MCP:获取代码应该实现的规格说明
大多数需求从未进入代码仓库,而是停留在智能体无法看到的 Notion 页面里。你最终只能凭着模糊记忆转述规格说明。这个服务器让 Claude Code 可以搜索你的工作区、读取页面,以及创建或更新文档。服务器由 Notion 自己托管,并通过 OAuth 授权。它只能访问你自己的账户有权访问的内容。
claude mcp add --transport http notion https://mcp.notion.com/mcpNotion 的文档特别提到了这里的 --scope 标志,值得将其应用于本榜单中的每个服务器。local 是默认设置,只对当前项目中的你开放服务器。project 会写入 .mcp.json让团队通过版本控制共享配置。user 则让服务器可用于你的所有项目。Notion 还发布了 Claude Code 插件,在服务器之外提供技能和斜杠命令。
10. Vercel MCP:了解推送之后发生了什么
从代码到生产环境的闭环,通常终止在智能体看不到的地方。Vercel 官方远程服务器让 Claude Code 可以检查部署状态、读取构建日志、管理项目并查询 Web Analytics。构建失败后,智能体可以根据实际日志进行诊断,而不是依赖你的描述。该服务器实现了当前的 MCP 授权和 Streamable HTTP 规范。
claude mcp add --transport http vercel https://mcp.vercel.com
# then authenticate
claude
/mcp
这些工具分为两组。公共工具无需身份验证即可使用,涵盖文档搜索,本身就很有价值。经过身份验证的工具则可以访问你的项目、部署和分析数据。如果你只需要文档功能,可以在不登录的情况下连接并获得相应价值。
不应安装什么:重复 Claude Code 功能的服务器
流传最广的 Claude Code MCP 榜单通常会推荐 Filesystem、终端或 Shell 服务器,以及 Sequential Thinking。这三者都是真实存在的服务器,但都不适合这个智能体。Filesystem 重复了 Read、Write、Edit、Grep 和 Glob。Claude Code 已原生提供这些工具,并附带权限规则和工作目录边界。Shell 服务器重复了 Bash还会失去内置的只读命令允许列表和沙箱。Sequential Thinking 则要求推理模型通过工具调用来传递自己的推理过程。
参考 Git 服务器也存在同样的问题。git 已经在你的 PATH 中,而且只读的 git 子命令无需提示即可运行。参考 Fetch 服务器只是对 HTTP 请求的简单封装。它继承了前文提到的所有封锁问题,却没有增加任何用于解决这些问题的基础设施。这些榜单提到的另外两个服务器也已消失:PostgreSQL 和 GitHub 都已迁移至 servers-archived。上文第 2 项和第 6 项是持续维护的替代方案。
背后的原则很简单。MCP 服务器只有在能够访问智能体通过其他方式无法触达的系统时,才值得占据一个位置。如果它只是封装智能体本来就很擅长的事情,就不值得。你连接的每个工具都会争夺相同的上下文预算。因此,问题从来不在于某个服务器是否优秀,而在于它能访问哪些 Bash 和内置工具无法访问的内容。
正确连接服务器,让 Claude Code 真正使用它们
连接服务器并不意味着 Claude 会主动使用它。智能体根据自己能够推断的信息工作,一个未被明确说明的工具经常会被忽略,而它可能转而手动拼凑出更糟的方案。解决方法有两点:告诉它这些服务器的存在,并检查它们的成本。
首先,在代码仓库根目录的 CLAUDE.md 中添加一个简短配置块。内容应保持客观,因为它会加载到每个会话中。说明应针对不同任务优先使用哪个服务器,而不是解释每个服务器如何工作。
## MCP servers available
- `brightdata`: any URL or web search. Use instead of WebFetch and WebSearch, always.
- `context7`: library and API docs. Check before writing against an unfamiliar package.
- `sentry`: production errors. Read the live issue before proposing a fix.
- `supabase`: schema and SQL. Read the schema before writing a query.
其次是 /context它会报告当前会话的 token 使用量,并按启用的 MCP 服务器分别统计。添加服务器后运行一次,完成一个真实任务后再运行一次。如果某个服务器占用过多,请使用上文介绍的工具集、功能组或只读选项来缩小范围,而不是直接移除它。使用 /mcp 检查连接状态、进行身份验证,以及在不删除配置的情况下为某个项目禁用服务器。
还有两个设置值得提前了解。MAX_MCP_OUTPUT_TOKENS 可以提高 MCP 工具输出默认的 25,000 token 上限。这对于返回 Schema 或大型结果集的服务器很重要。ENABLE_TOOL_SEARCH 控制工具延迟加载;当 ANTHROPIC_BASE_URL 指向非第一方主机时,Claude Code 会自动关闭该功能。如果你通过网关运行,并发现上下文突然充满工具定义,原因就在这里。
最后是一条适用于这里所有服务器的安全提醒。Anthropic 自己的 MCP 文档警告,获取外部内容的服务器会让你面临提示词注入风险。应将抓取的页面、Issue 评论和文档视为不可信数据,而不是指令。优先使用只读端点,并严格限制 OAuth token 的权限范围。批准项目范围的 .mcp.json 服务器之前,请先进行审查。Claude Code 要求你确认批准是有原因的。
常见问题
2026 年最适合 Claude Code 的 MCP 服务器有哪些?
三个服务器可以覆盖大多数真实工作流。Bright Data MCP 负责网页访问,GitHub 官方服务器负责代码仓库工作,Context7 则提供与版本准确匹配的库文档。调试生产环境时可添加 Sentry,并根据你的技术栈添加对应的数据库服务器。这里的其他服务器都应按具体情况选用。
MCP 服务器会拖慢 Claude Code 或占满上下文窗口吗?
与过去相比,影响已经小得多。Claude Code 默认延迟加载 MCP 工具定义,因此会话开始时只加载工具名称和服务器说明。完整 Schema 会在 Claude 搜索相关工具时才加载。工具搜索需要 Sonnet 4.5、Haiku 4.5、Opus 4.5 或更高版本。运行 /context 可以查看当前会话中每个服务器的实际成本。
为什么在 Claude Code MCP 服务器榜单中,将一个付费服务器排在第一位?
因为它是唯一增加智能体所欠缺能力的条目。其他所有服务器都只是改善 Claude Code 已经能够尝试完成的事情。WebFetch 在设计上会损失信息,并通过受保护网站会拦截的 Claude-User User-Agent 表明自己的身份。WebSearch 只返回链接,而且每个会话最多调用 200 次。免费额度为每月 5,000 次请求,无需信用卡。
在 Claude Code 中应该使用 MCP 服务器还是 CLI 工具?
如果服务提供 CLI,并且命令范围很大,就使用 CLI。Shell 命令在实际运行之前不会产生任何成本。如果你需要类型化工具调用、希望使用 OAuth 而不是存储 token,或者服务没有 CLI,则使用 MCP。由于工具搜索会延迟加载定义,过去反对 MCP 的上下文成本论点已经大幅削弱。
如何与团队共享 MCP 服务器?
使用 --scope project 添加服务器。Claude Code 会将其写入项目根目录的 .mcp.json你可以提交该文件。团队成员第一次使用时会收到批准提示。通过环境变量展开将凭据排除在文件之外。在 url、headers 或 env 字段中使用 ${API_KEY} 或 ${API_KEY:-default}。
Claude Code 需要 Filesystem MCP 服务器吗?
不需要。Claude Code 已内置 Read、Write、Edit、Grep 和 Glob 工具,并且已经应用权限规则和工作目录边界。Filesystem 服务器只是重复这些工具并消耗上下文。同样的理由也适用于 Shell 和 Git 服务器。
可以将这些 MCP 服务器作为 Claude Code 插件安装吗?
其中多个可以。Anthropic 维护着 claude-plugins-official 市场,插件可以将 MCP 服务器与技能、斜杠命令和子智能体捆绑在一起。Bright Data、GitHub、Context7、Sentry、Supabase、Figma、Linear、Notion 和 Vercel 都有对应条目。使用 /plugin install NAME@claude-plugins-official 安装。


高级 SEO 专家
 6 years experience
Daniel Shashko 是 Bright Data 的高级 SEO/GEO 专家,专注于 B2B 营销、国际 SEO,以及开发 AI 驱动的代理、应用与网页工具。