对于价格监控,大规模爬虫 Target 商品意味着从内部 JSON API(而非页面 HTML)读取门店价格和库存。
在我们的测试中,一包 31 颗装的 Tide 洗衣凝珠在 Cedar Rapids 售价 9.99 美元,而同一时间在 Chicago 售价 12.69 美元。有些响应看似有效,但包含的是线上价格或父商品的价格区间。使用美国 IP 时,通过默认设置的 curl 和 Python 客户端发出的 112 次商品 API 调用中,只有 1 次成功。
本指南将向你展示如何采集这些价格、检测错误响应,以及决定是自行构建爬虫,还是使用 Target 价格爬虫工具。
概要
- 按门店 ID 请求价格。先将邮政编码映射到门店 ID,再使用 Target 的公开 API 密钥调用其商品 API。
- 检查每个价格的位置和变体。位置 3991 表示线上价格,而父商品可能返回价格区间,因此每个变体应保存 1 行。
- 从响应正文中识别拦截。被拦截的调用返回 HTTP 435,有时会以有效 JSON 的形式返回。
- 根据位置跟踪方式选择工具。对于邮政编码,Bright Data 的 Target 爬虫 API 在我们的 20 次检查中全部与自建爬虫结果一致。对于门店 ID 或按渠道划分的库存,请在网络解锁器 API 上运行你的代码。
Target 如何提供商品数据
在我们的测试中,爬虫工具可以从 3 个 Target 主机读取价格、库存和商品详情。商品页面 HTML 是唯一不含价格的数据源。Target 使用 TCIN(Target.com Item Number)标识每件商品,即商品 URL 中 A- 后面的数字。
这 3 个主机都位于 Target 的 Fastly CDN 后方。在 www 和 redsky 主机上,HUMAN Security 的机器人检查可能会拦截请求并返回拦截响应而非数据:
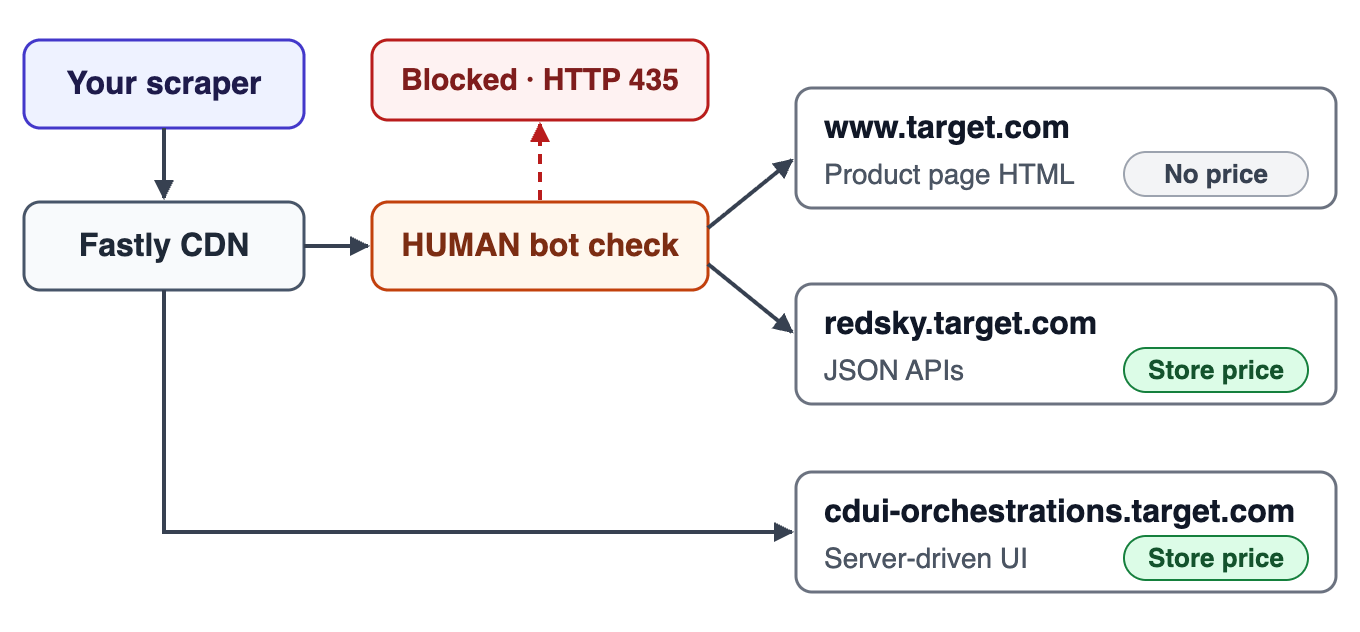
在我们的测试中,页面 HTML 不含价格,而 JSON API 和服务器驱动的 UI 模块包含门店价格。
页面 HTML 不含价格
商品页面是一个 Next.js 应用。其 __NEXT_DATA__ 脚本包含标题、描述、图片和评价摘要,但不含价格。我们使用 curl 获取的每个页面中,页面 props 都包含 isProductDetailServerSideRenderPriceEnabled: false无论 User-Agent 是 curl、python-requests、Chrome 还是 HeadlessChrome。如果该标志变为 true,HTML 可能会包含价格,因此解析 HTML 前请先检查该标志。
同一组 props 还使用 isBot、isAiAgent 和 isSeoPhantom 标志标记每位访问者。声称自己是搜索引擎爬虫(例如 Googlebot)的请求会获得不同的缓存页面,其中包含 schema.org JSON-LD 和已渲染的价格。
该价格属于单个默认位置。搜索引擎会公开如何通过反向 DNS 验证其爬虫,因此网站可以识别伪装的爬虫。要获取门店价格,请使用下方的 JSON API,而不是该页面。
价格和库存来自 JSON API
Target 位于 redsky.target.com 的聚合 API 会返回各门店的价格。我们调用的每个端点都需要 key 参数。如果没有密钥,API 会返回带有 "no API key found in request" 的 401。
该密钥是公开 API 密钥,并非机密信息。除爬虫获得的缓存页面外,它在我们保存的每个商品页面中均出现了 28 次。请从 Target 页面(例如主页)读取它,而不要将其硬编码。
我们检查时,该 API 主机的 robots.txt 禁止所有爬虫,而主站的 robots.txt 允许抓取商品页面。
以下 4 个端点足以完成我们测试过的所有商品数据任务:
| 端点 | 返回内容 | 我们测试中的限制和错误 |
|---|---|---|
pdp_client_v1 |
商品、1 个 store_id 的价格,以及同一商品系列中的所有变体 |
对于已不存在的 TCIN 返回 404 |
plp_search_v2 |
关键字或 UPC 条形码编号的搜索结果 | count 最大为 28offset 最大为 1,199 |
nearby_stores_v1 |
邮政编码附近的门店 ID | 无 |
product_fulfillment_v1 |
请求门店的配送、自提和店内库存,有时还会包含附近门店 | 无 |
以下请求使用 curl 和 jq获取纽约 Chelsea 门店(门店 3412)一盒 Parmalat UHT 牛奶的价格:
KEY=$(curl -s https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
响应中的 location_id 字段显示该价格属于哪家门店:
{
  "current_retail": 3.89,
  "display_was_now": false,
  "formatted_current_price": "$3.89",
  "formatted_current_price_type": "reg",
  "formatted_unit_price": "$0.12",
  "formatted_unit_price_suffix": "/fluid ounce",
  "reg_retail": 3.89,
  "location_id": 3412,
  "external_system_id": "15078349-3412-3.89-2025080815"
}
由于此 TCIN 是父商品的一个变体,因此价格位于 children 下。上面的两个 curl 命令通过我们在印度的网络连接都能正常运行。使用美国 IP 时,在我们的测试中,Target 的机器人检查拦截了几乎所有此类请求。在这种情况下jq 会输出解析错误,因为响应是 HTML 拦截页面,而不是 JSON。
网络解锁器 API 通过其解锁层发送相同的请求,并返回 Target 的 JSON。请先设置 BRIGHTDATA_API_KEY 和 UNLOCKER_ZONE 环境变量,具体方式如网络解锁器 API 快速入门所示:
unlock() {
  curl -s https://api.brightdata.com/request \
    -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
    -H "Content-Type: application/json" \
    -d "{\"zone\": \"$UNLOCKER_ZONE\",
         \"url\": \"$1\", \"format\": \"raw\"}"
}

KEY=$(unlock https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
unlock "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
unlock 函数接受任何 Target URL,包括下方的库存请求。
实时页面加载服务器驱动的 UI 模块
在浏览器网络流量捕获中,商品页面没有调用 pdp_client_v1。其布局来自服务器驱动的 UI 模块,即服务器以数据形式发送的页面区块,这些数据位于 __NEXT_DATA__ 内或来自 cdui-orchestrations.target.com。在 www.target.com 上调用 deferred_enrichment 会添加特定位置的模块。
cdui-orchestrations.target.com 响应和 deferred_enrichment 模块都包含价格。使用 include_data_source_modules=true 时,针对 Chelsea 门店向 cdui-orchestrations.target.com 发出的请求,在 16 件测试商品中全部返回了与 pdp_client_v1 相同的价格和位置 ID。商品页面未调用的端点(如 pdp_client_v1)可能会在没有通知的情况下消失,而匹配的 cdui 价格可提供经过测试的备用方案。
Target 爬虫为何在大规模运行时失效
有些故障会在第一次请求时发生,另一些则只会在任务包含大量门店和商品时出现。
拦截取决于 IP 和客户端
在我们的测试中,Target 使用了 HUMAN Security,这是一项于 2022 年与 PerimeterX 合并的机器人检测服务。我们通过浏览器或 HTTP 客户端 User-Agent 获取的每个商品页面都会从 client.px-cloud.net 加载 HUMAN 的传感器脚本。
在 IP 和客户端测试中,我们从每个 IP 来源和客户端发送相同的 16 个 pdp_client_v1 URL,并将各轮测试分散在 3 小时内。如果调用返回 200 或 206且正文中不含 HUMAN 拦截内容,则视为通过:
| IP 来源 | 客户端 | 通过的调用数 |
|---|---|---|
| 印度 IP | curl | 64 次中 63 次 |
| 美国 IP | curl 或 Python requests默认 User-Agent |
112 次中 1 次 |
| 使用美国出口 IP 的网络解锁器 API | 由网络解锁器 API 选择 | 32 次中 32 次 |
从印度发出请求时,即使 curl 也能通过。使用美国 IP 时,结果取决于客户端,而类似浏览器的标头可以让更多调用通过。网络解锁器 API 会为你选择标头和浏览器指纹,并在本次测试中通过了所有调用。
当我们使用美国 IP 和 Python 的默认 User-Agent交替调用 cdui-orchestrations.target.com 和 pdp_client_v1 时cdui-orchestrations.target.com 主机的行为有所不同。cdui 主机响应了全部 8 次调用,而机器人检查拦截了对 pdp_client_v1 的全部 8 次调用。通过我们在印度的网络连接,包含价格的 cdui 响应传输大小中位数为 80 KB,而 pdp_client_v1 响应为 9 KB。cdui 主机在我们的测试中避开了拦截,但其数据格式会跟随页面布局,可能随任何页面版本发布而改变。
在我们的测试中,只更改一个标头就会让原本可通过的设置失败,而 HUMAN 的拦截响应不会提供原因。请一次只更改一个变量。在信任某项修复前,应将其与旧设置交替测试,并运行足够多的调用,以观察到明显差异。使用指纹回显服务比较 TLS 指纹时,请使用 JA4 和 HTTP/2 指纹,因为 Chrome 风格的握手会在不同连接之间改变 JA3。
HUMAN 还会设置自己的 Cookie。我们检查时,其 Cookie 文档列出的 _px3 有效期为 5.5 分钟_pxvid 有效期为 1 年。同一页面称,这些 Cookie 用于维持会话,并帮助区分真实用户和机器人。在整个会话期间,请将每个 Cookie jar 与接收它的 IP 和客户端搭配使用,或让网络解锁器 API 管理 Cookie。
被拦截的调用以 2 种格式返回 HTTP 435
我们检查时,HUMAN 的执行器文档将 403 和 429 列为拦截状态,并说明每个网站都可以自定义响应。但在 Target 上,被拦截的 API 调用返回的是 HTTP 435且拦截响应有 2 种格式。
我们的 curl 调用没有请求 JSON,因此收到的是 HTML 质询页面。在浏览器中渲染后,该页面会要求访问者按住一个按钮:
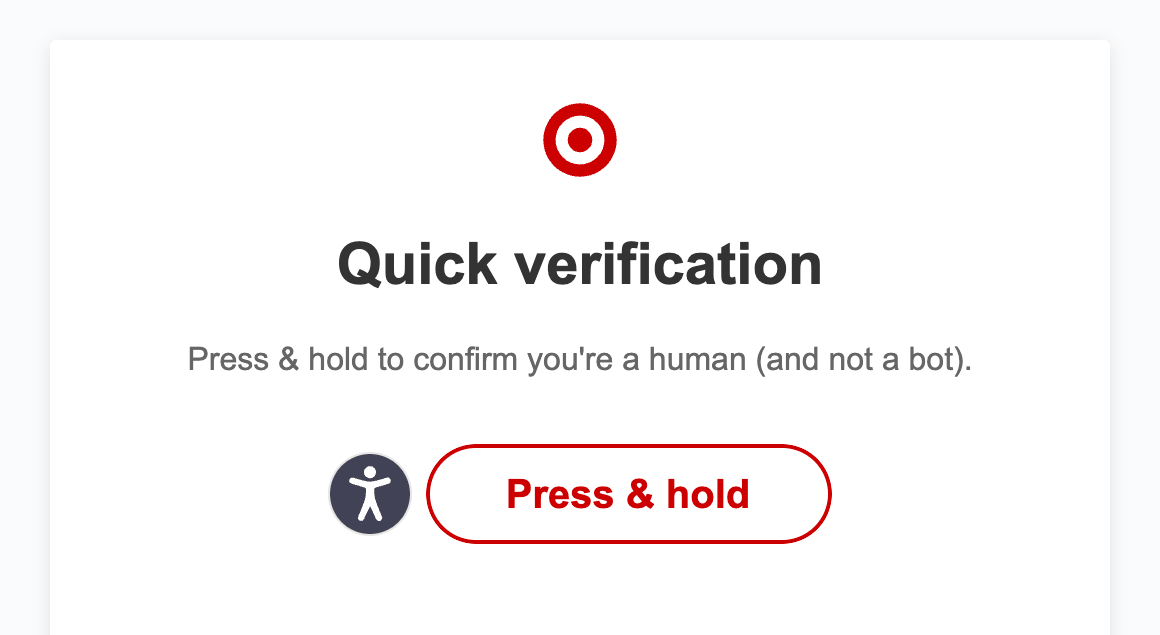
我们的 curl 调用收到的质询页面,以 HTTP 435 代替数据。
我们的 Python requests 调用请求了 JSON,并收到一个 343 字节的 JSON 对象,该对象以 {"appId" 开头。如果只检查 JSON 是否有效,这种拦截会看起来像有效数据。两种格式都包含 HUMAN 验证码脚本的 URL,而我们的样本中没有任何正常响应包含该 URL:
def is_human_block(body):
    """HUMAN sends a block as an HTML page or a small JSON object.

    Both formats contain the URL of its captcha script. Normal Target
    pages do not.
    """
    return "captcha.px-" in body
在一组 21 个 Target 响应中,该检查正确识别了两种格式的全部 4 个拦截,并放行了全部 17 个正常响应。仅检查字符串 px-captcha 的简单方法会错误标记已渲染的商品页面,同时漏掉 JSON 拦截。
价格因门店而异
在 8 家门店中,我们检查的 16 件商品有 12 件存在多个价格。Target 报告称其拥有超过 2,000 家门店。nearby_stores_v1 端点会将邮政编码映射到最近的门店 ID。对于 8 个邮政编码中的每一个,我们都在一次 2 分钟的运行中采集了距离最近门店的 16 件商品价格。
以下为其中 6 件商品在 8 家门店中的 5 家的价格差异,单位为美元。这 5 家门店涵盖了每件商品的最低价和最高价:
| 商品 | New York | Chicago | Cedar Rapids | Anchorage | Honolulu |
|---|---|---|---|---|---|
| Parmalat UHT 全脂牛奶,32 液量盎司 | 3.89 | 3.49 | 3.59 | 4.49 | 3.89 |
| Tide Original 洗衣凝珠,31 颗装 | 11.19 | 12.69 | 9.99 | 10.59 | 10.59 |
| Cheerios,家庭装 18 盎司 | 5.99 | 5.69 | 5.29 | 6.79 | 5.69 |
| Market Pantry Classic Roast,25.9 盎司 | 14.69 | 14.19 | 12.89 | 16.99 | 17.59 |
| Starbucks Fall Blend,10 盎司 | 14.39 | 13.59 | 12.79 | 14.29 | 13.59 |
| LEGO Creator Space Shuttle 31134 | 7.99 | 7.99 | 7.99 | 7.99 | 7.99 |
Market Pantry 咖啡的价格区间最大:Honolulu 的 17.59 美元比 Cedar Rapids 的 12.89 美元高 36%。即使排除 Anchorage 和 Honolulu,16 件商品中仍有 11 件存在多个价格,其中 Tide 洗衣凝珠的差异最大,达到 27%。
价格也可能在一天内发生变化。在同一天的两次运行之间,Chicago 门店将牛奶价格从 3.49 美元降至 2.97 美元,且 pdp_client_v1 将其标记为 sale。请根据商品类别中的价格变化频率设置刷新率。每行都应保留价格类型,例如促销价或常规价。
在所有门店价格相同的 4 件商品中,有 2 款 LEGO 套装和 2 款 AirPods。无论我们请求哪家门店,这 4 件商品的 API 都会返回位置 3991 的价格。位置 3991 表示线上价格,而非门店价格。
将 3991 作为门店 ID 传入时,返回的 206 在 errors 数组中包含 "Parameter store_id cannot be digital store 3991."。通过我们在印度的网络连接,Target 商品页面也会将门店设置为 3991,并将邮政编码设置为 52404。
你可以利用位置 3991 减少请求。首先,为每件商品请求 2 家门店。如果两个响应都显示位置 3991,则每次刷新只采集一次该商品,而不是每家门店各采集一次。对于 16 件测试商品中的 4 件,此规则将每次刷新的请求数从 8 次降至 1 次。
要采集门店价格,请通过网络解锁器 API 使用门店 ID 发送商品请求。Target 爬虫 API 会返回你所发送邮政编码对应的价格。
父商品返回价格区间
Target 将每个变体(例如不同包装数量)列为父商品下的子 TCIN。搜索结果返回子 TCIN,但商品端点返回父商品。Tide 洗衣凝珠 TCIN 87767249 返回父商品 79394303 和价格 "$11.19 - $30.99"其 children 数组列出了 31、42、76 和 112 颗装。如果爬虫只保存顶层价格,就会为实际有 4 个价格的商品记录一个价格区间或该区间的最低值。
价格区间还可能掩盖门店之间的差异。在较早的一次运行中,Pampers Swaddlers 在父商品层级的 8 家门店都显示 "$9.99 - $59.99"。在变体层级,164 片 1 号装在 New York 售价 47.99 美元,在另外 7 家门店售价 44.99 美元。
一次请求会返回请求门店中该商品系列的所有变体。如果每个商品系列只发送 1 个 TCIN,则在每家门店中,每个系列只需支付 1 次请求的费用。
搜索在偏移量 1,199 处停止
搜索端点会拒绝任何大于 28 的 count并返回 "Parameter 'count' cannot be requested with more than 28"。它还会拒绝任何大于 1,199 的 offset因此 1 个查询大约最多返回 1,227 条结果。在我们的测试中,搜索“shirts”报告有 131,690 条结果,因此单个关键字只能返回其中约 1%。
我们检查时www.target.com 的 robots.txt 禁止所有 User-Agent 访问搜索页面,并列出了 6 个站点地图索引。商品站点地图索引指向 110 个文件;下载这些文件后,其中共列出了 2,504,600 个商品 URL。请从站点地图和分类页面发现商品,仅在偶尔查询时使用搜索 API,例如将 UPC 解析为 TCIN。将 UPC 作为关键字时,我们尝试的两个 UPC 都只返回了 1 件商品及其 TCIN。
某些状态码具有误导性
Target 会返回 3 类需要分别处理的响应,其中 2 类的状态码具有误导性:
| 响应 | 实际含义 | 处理方式 |
|---|---|---|
带有 errors 数组的 206 |
部分查询失败,但商品数据仍然存在 | 解析数据并记录错误 |
带有 "No product found with tcin" 的 404 |
商品已不存在 | 将 URL 标记为失效,并跳过重试 |
正文为 HTML 或 JSON 的 435 |
HUMAN 拦截 | 从正文中识别,暂停该客户端,并等待一段时间后重试 |
任何输入列表中都可能出现已下架商品,因此应为此做好处理规划。我们测试列表中的一件商品返回了 "No product found with tcin 1002219928"。
每家门店的库存分为 3 个渠道
在我们的测试中product_fulfillment_v1 端点会分别报告配送、门店自提和店内供应情况,并给出每家门店的数量。以下请求复用了上方商品 API 请求中的 KEY 和 REDSKY并检查 Chelsea 门店的牛奶库存:
Q="key=$KEY&tcin=15078349&store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/product_fulfillment_v1?$Q" \
  | jq '.data.product.fulfillment | {
      shipping: .shipping_options.availability_status,
      stores: [.store_options[] | {
        store: .location_id,
        units: .location_available_to_promise_quantity,
        pickup: .order_pickup.availability_status,
        in_store: .in_store_only.availability_status
      }]
    }'
Chelsea 门店没有库存,也不支持自提,但配送显示该牛奶有货,而附近一家门店列出了 6 件库存:
{
  "shipping": "IN_STOCK",
  "stores": [
    {
      "store": "3412",
      "units": 0.0,
      "pickup": "UNAVAILABLE",
      "in_store": "OUT_OF_STOCK"
    },
    {
      "store": "1886",
      "units": 6.0,
      "pickup": "IN_STOCK",
      "in_store": "IN_STOCK"
    }
  ]
}
在另一次请求中,Anchorage 门店列出了 2 件相同的牛奶。请分别保存每家门店的配送、自提和店内状态,因为单个 is_available 标志无法容纳 3 个独立值。对于库存,请使用 product_fulfillment_v1 等读取端点,它们已经按门店返回数量,而不要使用购物车请求。对零售 API 进行逆向工程的工程师也表示,写入端点通常受到更严格的保护。
使用网络解锁器 API 爬虫 Target 门店价格
网络解锁器 API 会通过其为每个网站选择的 IP 和浏览器指纹路由每个请求。它还会处理标头、Cookie、验证码和重试,并返回网站响应。机器人检测供应商经常更新检查机制,而网络解锁器 API 会为你适配这些更新。你仍可完全控制解析器和端点逻辑。
首先,创建一个带 API 密钥和网络解锁器 API 区域的 Bright Data 账户;区域是用于请求及计费的命名配置。你还需要 Python 和 requests 库该脚本在 Python 3.13 上运行。网络解锁器 API 可自助使用,并且只对成功请求计费。网络解锁器 API 定价页面列出了当前费率,免费套餐每月包含 5,000 次请求,且无需信用卡。
该脚本会从 Target 主页读取其 API 密钥,并将每个邮政编码映射到一家门店。然后,它会获取每个变体的价格,并将有效行与被拒绝的行分开:
"""Collect Target prices per store through Bright Data's Web Unlocker API.

Usage:
    export BRIGHTDATA_API_KEY=...        # account API key
    export UNLOCKER_ZONE=web_unlocker    # your Web Unlocker API zone
    python target_store_prices.py 15078349,87767249 10001,99501
"""
import collections
import html
import json
import os
import re
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone
from urllib.parse import urlencode

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("UNLOCKER_ZONE", "web_unlocker")
REDSKY = "https://redsky.target.com/redsky_aggregations/v1/web/"
ONLINE_STORE = "3991"  # the location Target's API calls a digital store


def is_human_block(body):
    """HUMAN sends a block as an HTML page or a small JSON object.

    Both formats contain the URL of its captcha script. Normal Target
    pages do not.
    """
    return "captcha.px-" in body


def unlock(url, attempts=3):
    """Fetch a URL through Web Unlocker API and return Target's response."""
    status = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=120,
            )
        except requests.RequestException as error:
            status = type(error).__name__
            time.sleep(2 ** attempt)
            continue
        # Web Unlocker API reports Target's own result in the
        # x-brd-status-code and x-brd-error headers.
        status = int(r.headers.get("x-brd-status-code", r.status_code))
        if is_human_block(r.text):
            status = "blocked"  # a block can arrive with any status code
        elif status in (200, 206):
            return status, r.text
        elif "404" in r.headers.get("x-brd-error", ""):
            return 404, ""  # dead product page: do not retry
        time.sleep(2 ** attempt)
    return status, ""


def web_api_key():
    """Read the web API key that Target embeds in its own pages."""
    status, page = unlock("https://www.target.com/")
    keys = re.findall(r'apiKey\\?"\s*:\s*\\?"([0-9a-f]{40})', page)
    if not keys:
        raise RuntimeError(f"no apiKey in the home page (status {status})")
    return collections.Counter(keys).most_common(1)[0][0]


def store_for_zip(key, zip_code):
    """Resolve a ZIP code to the nearest Target store ID."""
    query = urlencode({"key": key, "place": zip_code, "limit": 1,
                       "within": 100, "channel": "WEB", "page": "/s"})
    status, body = unlock(f"{REDSKY}nearby_stores_v1?{query}")
    try:
        store = json.loads(body)["data"]["nearby_stores"]["stores"][0]
    except (ValueError, KeyError, IndexError) as error:
        raise RuntimeError(f"no store for {zip_code} ({status})") from error
    return store["store_id"], store["location_name"]


def price_rows(key, tcin, store_id, zip_code):
    """Return one row per sellable variant (child TCIN) at one store."""
    query = urlencode({"key": key, "tcin": tcin, "store_id": store_id,
                       "pricing_store_id": store_id,
                       "has_pricing_store_id": "true", "channel": "WEB",
                       "page": f"/p/A-{tcin}"})
    status, body = unlock(f"{REDSKY}pdp_client_v1?{query}")
    error = {"tcin": tcin, "store_id": store_id, "zip": zip_code}
    try:
        product = json.loads(body)["data"]["product"]
    except (ValueError, KeyError, TypeError):
        return [{**error, "error": status or "no_response"}]
    # A child TCIN returns its parent. The parent price is a range, so
    # save each child's price on its own row.
    items = product.get("children") or [product]
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    rows = []
    for item in items:
        price = item.get("price", {})
        priced_at = str(price.get("location_id"))
        rows.append({
            "tcin": item["tcin"],
            "parent_tcin": product["tcin"],
            "title": html.unescape(
                item["item"]["product_description"]["title"]),
            "zip": zip_code,
            "store_id": store_id,
            "priced_at": priced_at,
            "scope": "online" if priced_at == ONLINE_STORE else "store",
            "price": price.get("current_retail"),
            "regular_price": price.get("reg_retail"),
            "price_type": price.get("formatted_current_price_type"),
            "collected_at": now,
        })
    return rows


def valid(row):
    """Keep rows with a price from the requested or online store."""
    return (isinstance(row.get("price"), (int, float))
            and row["priced_at"] in (str(row["store_id"]), ONLINE_STORE))


if __name__ == "__main__":
    tcins = sys.argv[1].split(",")
    zips = sys.argv[2].split(",")
    key = web_api_key()
    stores = {z: store_for_zip(key, z) for z in zips}
    jobs = [(t, stores[z][0], z) for t in tcins for z in zips]
    with ThreadPoolExecutor(max_workers=8) as pool:
        results = list(pool.map(lambda job: price_rows(key, *job), jobs))
    # TCINs from one family return the same rows. Keep one row per
    # variant and store, and never let an error replace a row with a price.
    unique = {}
    for row in (r for batch in results for r in batch):
        slot = (row["tcin"], row["store_id"])
        if slot not in unique or "error" in unique[slot]:
            unique[slot] = row
    good = [r for r in unique.values() if valid(r)]
    bad = [r for r in unique.values() if not valid(r)]
    # Append, so every run adds to the price history.
    for name, batch in (("target_prices", good), ("target_rejects", bad)):
        with open(f"{name}.jsonl", "a") as out:
            out.writelines(json.dumps(row) + "\n" for row in batch)
    print(f"{len(good)} valid, {len(bad)} rejected, stores: {stores}")
使用 2 个输入 TCIN 和 2 个邮政编码时,该脚本生成了 12 行,因为每个请求都会返回整个变体系列:
12 valid, 0 rejected, stores: {'10001': ('3412', 'Chelsea 23rd and 8th'), '99501': ('2371', 'Anchorage NE')}target_prices.jsonl 的前几行显示了 Chelsea 门店的牛奶系列:
{"tcin": "15078348", "parent_tcin": "94758333", "title": "Parmalat UHT 2% Reduced Fat Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
{"tcin": "15078349", "parent_tcin": "94758333", "title": "Parmalat UHT Whole Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
生成价格表的运行包含 128 个商品与门店组合,即 16 件商品乘以 8 家门店,并写入了 800 行数据,没有任何拒绝记录。第二天,该脚本使用 8 个工作线程在 97 秒内重复完成了此次运行,且全部 800 个价格都与第一次运行一致。该脚本还会为任何需要重试的组合保留一个 target_rejects.jsonl 文件。
网络解锁器 API 会在 x-brd-status-code 和 x-brd-error 标头中报告 Target 自身的结果,因此脚本会同时读取两者。对于已下架商品x-brd-error 会显示 Target 的 404脚本会记录该结果且不重试。
每项设计选择都针对 Target 爬虫中可能发生的一种故障:
- 从页面获取密钥:密钥轮换后,只要页面仍将密钥嵌入为
apiKey爬虫就能继续工作。 - 每个子商品一行:你的表中永远不会存储父商品的价格区间。
scope列:线上价格会被标记为online因此不会被误认为门店价格。- 拦截检查:无论状态码是什么,HTML 或 JSON 中的 HUMAN 拦截都会记录为
blocked。 - 不覆盖:一个变体的错误永远不会覆盖另一个已有价格的变体行。
- 拒绝记录文件:没有有效门店价格或线上价格的行会保存下来以便重试,已下架商品则保留其
404。
该代码依赖 pdp_client_v1 和 nearby_stores_v1因此请每天向两者发送一次金丝雀请求,并在响应结构发生变化时发出警报。我们的重试失败 Python 请求指南更深入地介绍了退避机制。
要在住宅代理上运行相同代码,请在 unlock() 中发送通过代理的 requests.get()并将普通的 404 视为商品已下架。脚本其余部分保持不变。使用住宅代理时,你需要自行控制客户端和 User-Agent,因此在扩展规模前,请针对 Target 测试它们以及每个端点。
使用 Target 爬虫 API 采集 Target 商品
Target 爬虫 API 是网页爬虫工具 API中面向 Target 的抓取工具。你发送商品 URL 和邮政编码,它就会返回结构化记录,其中包含价格、变体、评分、规格和卖家等字段。Bright Data 负责维护解析逻辑和端点,因此你的代码只需对记录进行标准化。Bright Data 还提供 Target 价格抓取工具、Target 评论爬虫工具和 Target 图片爬虫工具适合范围更窄的任务。
控制台会在同步和异步模式上方显示爬虫的输入字段。这些字段包括 URL、all_variations 标志和邮政编码:
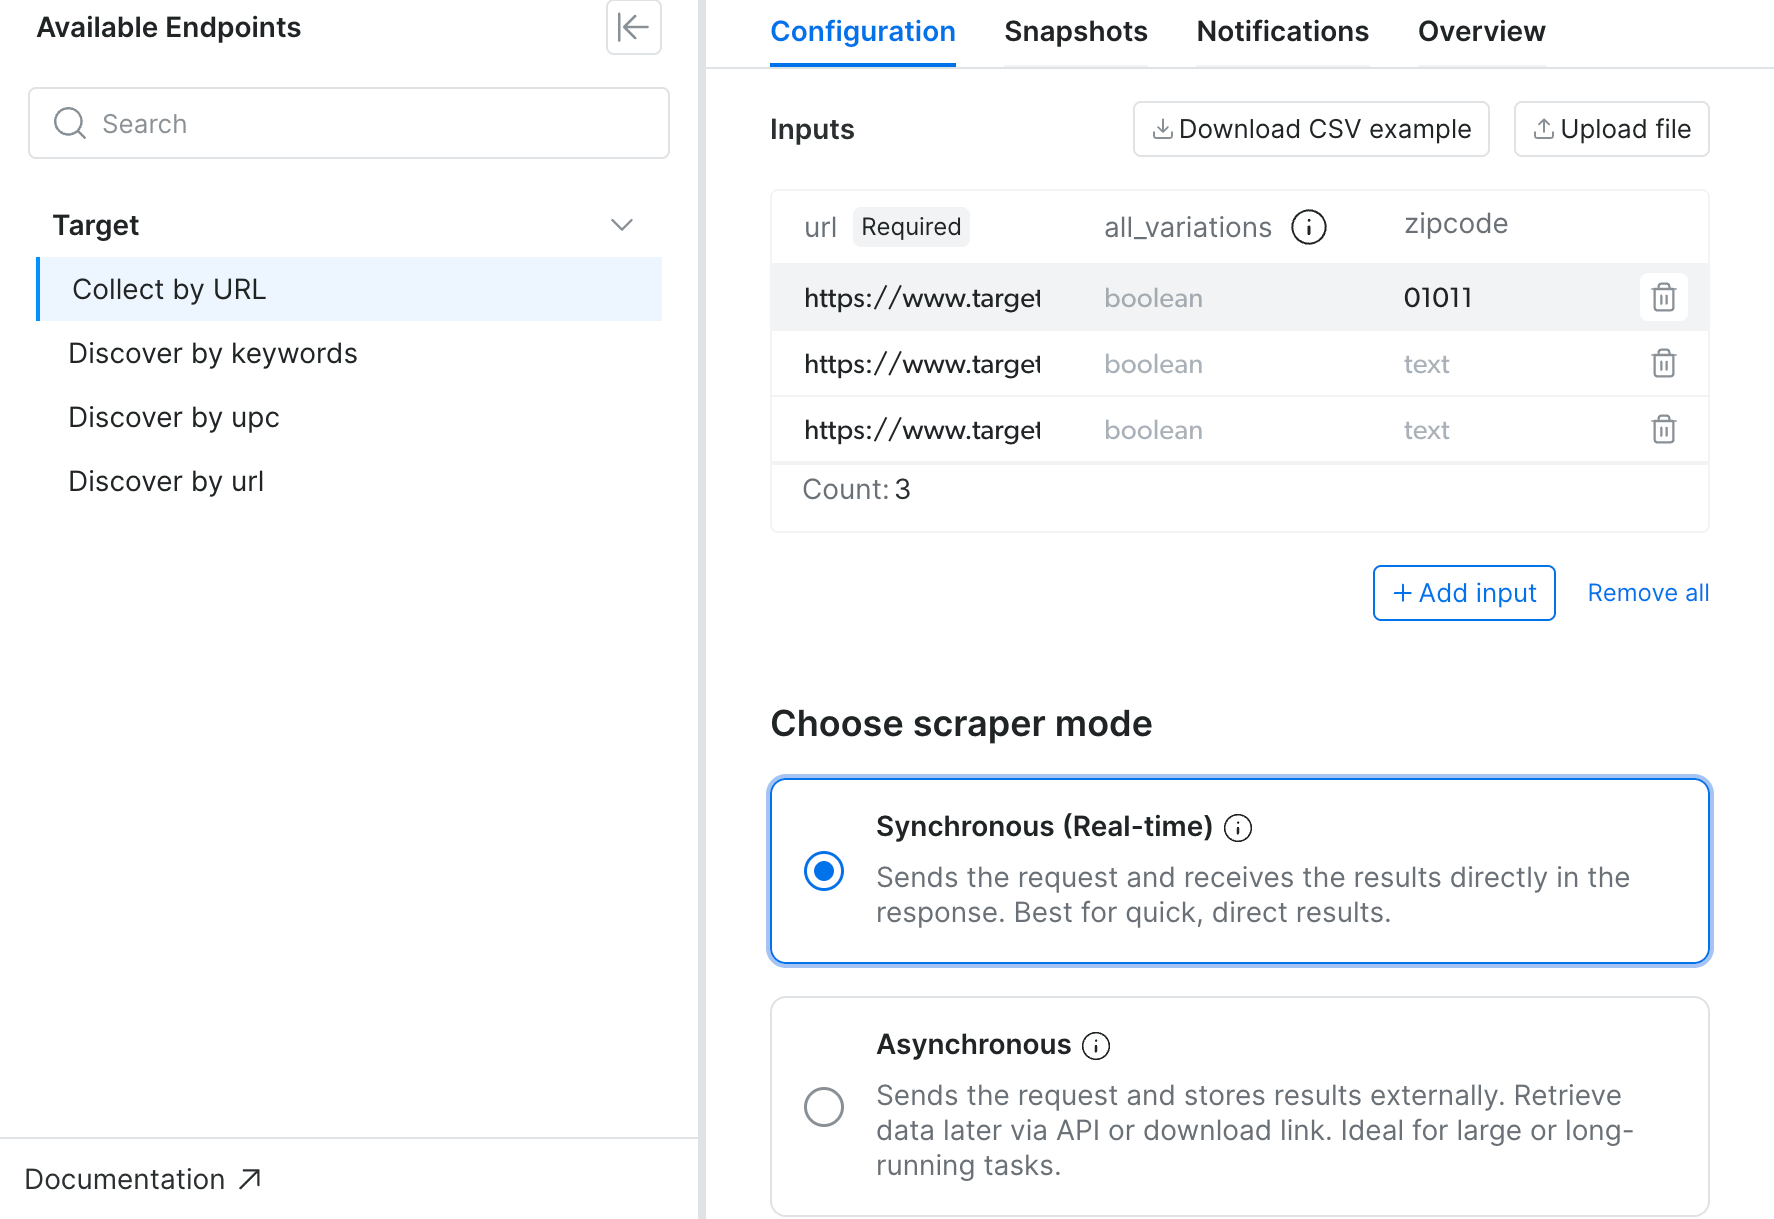
每个输入行列出一件商品,并可添加邮政编码,用于设置记录价格对应的位置。
网页爬虫工具 API 仅对已交付的记录计费。网页爬虫工具 API 定价页面列出了当前费率,免费套餐每月包含 5,000 次请求,且无需信用卡。要使用客户端库,请通过 pip install brightdata-sdk 安装 Bright Data Python SDK。
下方脚本会启动一个异步任务等待任务完成,下载记录并进行标准化:
"""Collect Target product records by URL and ZIP code with the Web Scraper API.

Usage:
    export BRIGHTDATA_API_KEY=...
    python target_scraper_api.py inputs.csv   # columns: url,zipcode
"""
import csv
import json
import os
import re
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_ltppk5mx2lp0v1k0vo"  # Target products scraper
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}


def trigger(inputs):
    """Start an asynchronous collection and return its snapshot ID."""
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": DATASET_ID, "include_errors": "true"},
        json=inputs,
        timeout=60,
    )
    r.raise_for_status()
    return r.json()["snapshot_id"]


def wait(snapshot_id, poll_seconds=15, max_minutes=60):
    """Poll the snapshot until it is ready and return its progress record."""
    deadline = time.time() + max_minutes * 60
    while time.time() < deadline:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=30).json()
        if progress["status"] in ("ready", "failed"):
            return progress
        time.sleep(poll_seconds)
    raise TimeoutError(snapshot_id)


def download(snapshot_id):
    """Download all records, including error records, as a list."""
    r = requests.get(f"{API}/snapshot/{snapshot_id}",
                     headers=HEADERS, params={"format": "json"}, timeout=300)
    r.raise_for_status()
    return r.json()


def normalize(record):
    """Map one record to a flat row, or return None for an error record."""
    if record.get("error_code"):
        return None
    price = record.get("final_price")
    if price is None and record.get("price_range"):
        # A record can have its price in price_range, like "$24.99".
        match = re.fullmatch(r"\$([\d,]+\.\d{2})", record["price_range"])
        price = float(match.group(1).replace(",", "")) if match else None
    origin = record.get("discovery_input") or record.get("input") or {}
    reviewed = bool(record.get("reviews_count"))  # rating 0 means unrated
    url_tcin = re.search(r"/A-(\d+)", record.get("url") or "")
    return {
        "tcin": url_tcin.group(1) if url_tcin else record.get("tcin_id"),
        "parent_tcin": record.get("group_id"),
        "title": record.get("title"),
        "zipcode": origin.get("zipcode") or None,
        "price": price,
        "initial_price": record.get("initial_price"),
        "available": record.get("is_available"),
        "rating": record.get("rating") if reviewed else None,
        "reviews_count": record.get("reviews_count"),
        "collected_at": record.get("timestamp"),
    }


if __name__ == "__main__":
    with open(sys.argv[1], newline="") as f:
        inputs = [{"url": row["url"], "zipcode": row["zipcode"]}
                  for row in csv.DictReader(f)]
    snapshot_id = trigger(inputs)
    progress = wait(snapshot_id)
    records = download(snapshot_id)
    rows = [row for row in map(normalize, records) if row]
    with open("target_records.jsonl", "w") as out:
        out.writelines(json.dumps(row) + "\n" for row in rows)
    print(f"snapshot {snapshot_id}: {len(rows)} rows, "
          f"errors: {progress.get('error_codes', {})}")
输入文件包含 2 个邮政编码下的牛奶商品,以及位于 Anchorage、全国统一定价的 LEGO 套装和一包 112 颗装 Tide 洗衣凝珠。最后一行是 Target 已下架的商品:
url,zipcode
https://www.target.com/p/-/A-15078349,10001
https://www.target.com/p/-/A-15078349,60601
https://www.target.com/p/-/A-86216189,99501
https://www.target.com/p/-/A-84114518,99501
https://www.target.com/p/petal-and-pup-skarlett-top/-/A-1002219928,10001
该任务返回了 4 条记录,并将已下架商品标记为 dead_page:
snapshot sd_muifuppi1d0g830zfd: 4 rows, errors: {'dead_page': 1}全部 4 个价格都与我们的爬虫一致。Market Pantry 咖啡和 31 颗装 Tide 洗衣凝珠的价格因位置而异。我们同时在全部 8 个邮政编码下将其与自建爬虫进行了比较:
| 商品 | 商品与邮政编码组合 | 不同价格数 | 与自建爬虫匹配 |
|---|---|---|---|
| Market Pantry Classic Roast,25.9 盎司 | 8 | 7 | 8 次中 8 次 |
| Tide Original 洗衣凝珠,31 颗装 | 8 | 5 | 8 次中 8 次 |
| 牛奶、LEGO 套装和 112 颗装 Tide(上方输入文件) | 4 | 不适用 | 4 次中 4 次 |
全部 20 个商品与邮政编码组合都与自建爬虫获取的最近门店价格一致。一天后,再次运行输入文件时返回了 Chicago 新的 2.97 美元促销价,自建爬虫也确认了该价格。
每条记录都包含价格所使用的邮政编码,以及该邮政编码下的供货标志。标准化程序会映射以下字段:
- 父 ID:
group_id包含父 TCIN。 - 来源:
input包含已采集记录的 URL 和邮政编码。当 Target 爬虫 API 自行发现商品时discovery_input包含关键字或分类 URL,以及可能存在的邮政编码。 - 价格:标准化程序从
final_price或price_range获取价格。 - 未评分商品:
rating为 0 且评论数为 0,表示商品尚无评分。
选择同步或异步模式
同步 /scrape 端点会直接在响应中返回短任务的结果;对于较长的任务,则会返回一个可供轮询的 snapshot_id。同步请求文档提供当前的时间限制。定时批量任务请使用 /trigger。你可以用相同方式轮询任一端点返回的 snapshot_id。
对于周期性任务,请将 API 设置为主动交付结果。交付选项包括 Webhook 和 Amazon S3、Google Cloud Storage、Microsoft Azure 等云存储。在 /scrape 上,请按文档所示,在请求正文中设置 limit_per_input以限制每条输入对应的记录数。
按关键字或分类发现商品
Target 爬虫 API 还可以为你查找商品:
- 关键字:使用“dog treats”和“shirts”,并将
limit_per_input设置为 20,返回了 40 条记录,且没有错误。 - 分类 URL:2 个分类页面各附带一个邮政编码,返回了 40 条记录。
上方的标准化程序已经会读取 discovery_input因此相同代码也能处理发现的记录。
使用浏览器 API 进行会话和调试
浏览器 API 会运行远程 Chrome,你可以通过 Chrome DevTools Protocol(CDP)使用 Playwright 或 Puppeteer 控制它,也可以通过 WebDriver 使用 Selenium。在 Target 上,它会以完整浏览器会话加载商品页面,包括 HUMAN 的脚本。由于它会加载整个页面,因此当 Target 更改前端后,浏览器 API 非常适合用于捕获网络流量。
Bright Data MCP 服务器通过 Model Context Protocol(MCP)向 AI 智能体提供工具。其浏览器工具可让智能体使用相同的远程浏览器,执行在页面上点击或输入的工作流。
浏览器 API 按 GB 计费,具体如浏览器 API 定价页面所示。拦截图片和跟踪器有助于减少每个会话的数据量。捕获结果显示所需请求后,网络解锁器 API 可以直接发送这些请求,而无需加载页面。
如果没有已存储的位置 Cookie,Target 会为我们的每个美国浏览器会话分配一家靠近出口 IP 的门店。通过 CDP 发送的浏览器 API Proxy.setLocation 命令可选择靠近指定坐标的出口 IP。要运行脚本,请安装 playwright并在 BROWSER_API_WSS 环境变量中设置浏览器 API 区域的连接字符串,具体如浏览器 API 快速入门所示:
import asyncio
import os

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>:<password>@brd.superproxy.io:9222
WSS = os.environ["BROWSER_API_WSS"]


async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(WSS)
        page = await browser.contexts[0].new_page()
        cdp = await page.context.new_cdp_session(page)
        # Exit near Manhattan, so Target geolocates the session there.
        await cdp.send("Proxy.setLocation", {
            "lat": 40.7506, "lon": -73.9972, "distance": 10, "strict": True,
        })
        await page.goto("https://www.target.com/p/-/A-15078349",
                        wait_until="domcontentloaded", timeout=120_000)
        # The page renders the price twice, and one copy stays hidden.
        price = page.locator('[data-test="product-price"]').first
        await price.wait_for(state="attached", timeout=60_000)
        cookies = await page.context.cookies("https://www.target.com")
        store = {c["name"]: c["value"] for c in cookies}.get("fiatsCookie")
        print(store, await price.text_content())
        await browser.close()

asyncio.run(main())
使用相同坐标运行 3 次时,Target 分配了 3 家靠近这些坐标、但各不相同的 New York 门店。fiatsCookie 值列出了门店 ID(DSI)、名称(DSN)和邮政编码(DSZ):
DSI_2475|DSN_Bronx%20Terminal|DSZ_10451 $3.59
DSI_3284|DSN_Lower%20East%20Side%20Grand%20and%20Clinton|DSZ_10002 $3.99
DSI_3394|DSN_Upper%20West%20Side%2098th%20and%20Columbus|DSZ_10025 $3.99
由于每个会话都会获得附近的一家门店,因此此设置适合对都市区域内的价格进行抽样。
获取 Target 数据集以回填目录
Target 数据集提供预采集的 Target 商品记录,你无需运行爬虫即可筛选和获取。它非常适合需要一次性获取大量记录的目录回填任务。
数据集页面列出了当前记录数、字段和定价。在数据集市场中,你可以筛选记录并在获取前预览样本:
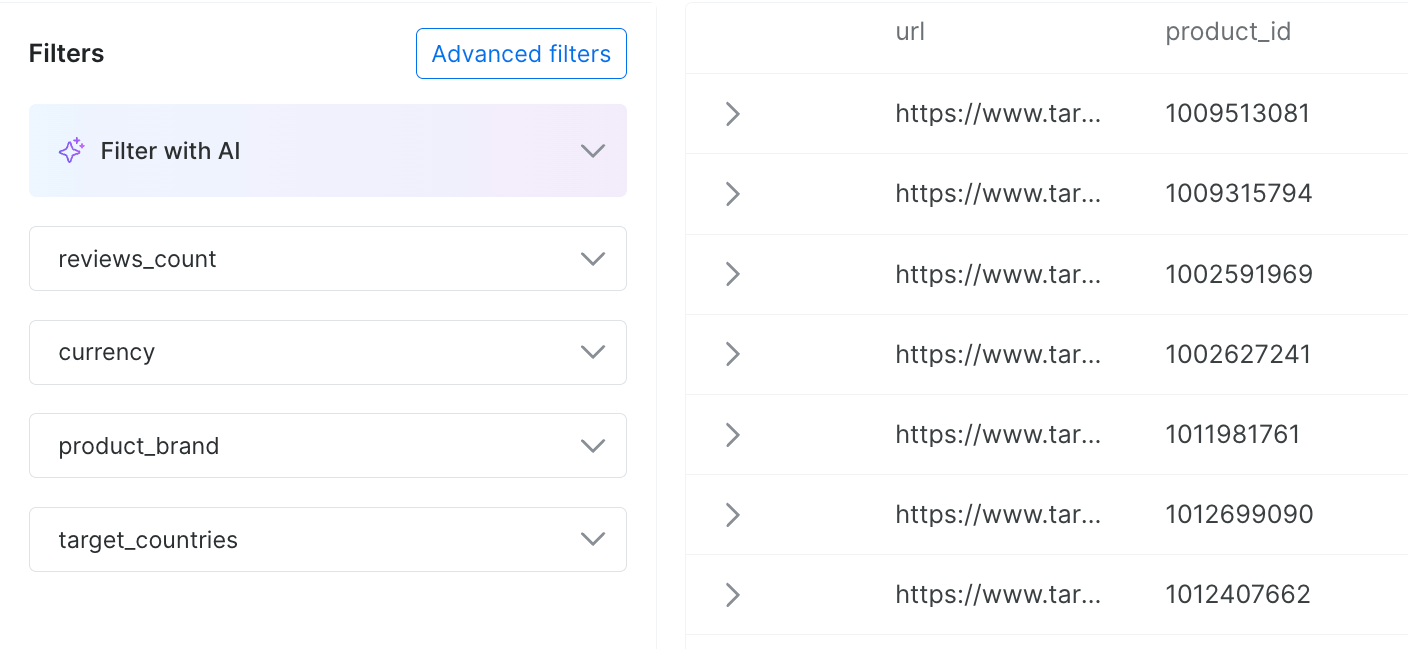
Target 数据集的字段筛选器及其记录样本。
加载前,请将记录映射到你自己的结构:
- 商品 ID:使用每条记录 URL 中的 TCIN 作为表键,与上方爬虫使用的 ID 相同。
- 评分:
rating为 0 且评论数为 0,表示该商品尚无评分。
根据位置、规模和刷新率选择方案
控制能力更强的选项需要更多维护,而维护工作量会随 Target 页面和端点的变更频率增加。需要现成 Target 控制面板的团队可以使用 Target 价格跟踪器或 Target 库存跟踪器。对于其他零售商,请参阅我们的电商网页爬虫指南。每种方案都按各自的单位计费,各产品的定价页面列出了当前费率:
| 方案 | 计费单位 | 1 次调用或 1 条记录的范围 | 最适合 |
|---|---|---|---|
| 你的代码搭配网络解锁器 API | 成功请求 | 1 个门店 ID 下的 1 个变体系列 | 门店 ID 和按渠道划分的库存 |
| 你的代码搭配住宅代理 | 流量 GB | 1 个门店 ID 下的 1 个变体系列,在我们的测试中压缩后约为 15 KB | 单次调用成本较低,并可完全控制客户端 |
| Target 爬虫 API | 已交付记录 | 1 个邮政编码下的 1 件商品 | 周期性采集,并由平台处理解析和维护 |
| 浏览器 API | 流量 GB | 1 个完整浏览器会话 | 会话和调试 |
| Target 数据集 | 记录 | 1 条预采集的商品记录 | 回填和目录研究 |
请根据位置跟踪方式进行选择。如果按邮政编码跟踪,在我们的测试中,Target 爬虫 API 返回的价格与最近门店一致,且由 Bright Data 负责维护。如果按门店 ID 和渠道跟踪库存,请在网络解锁器 API 或住宅代理上运行自己的代码。对于回填任务,请选择数据集,具体可参阅我们的数据集与网页爬虫工具 API 对比。
选择前,请将商品数乘以门店数、每日刷新次数和 30,以估算每月用量。每天跟踪 50 家门店的 5,000 件商品,意味着每月需要 750 万次请求或记录。按渠道划分的库存还会为每个 TCIN 和门店增加 1 次 product_fulfillment_v1 请求。将总数乘以定价页面上的单位费率;月度套餐通常可降低费率。
你自己的代码可以通过 2 种方式减少相对于该估算值的请求数。在 16 件测试商品中,有 4 件在所有门店的价格相同,每次刷新只需 1 次请求。一次商品 API 请求还会返回整个变体系列,因此在我们的运行中,128 个商品与门店组合生成了 800 行数据。
使用住宅代理时,750 万次经过 gzip 压缩的 pdp_client_v1 调用大约会传输 110 GB。正如住宅代理定价页面所述,计费流量包括标头和正文,在我们的测试中平均每次调用为 15 KB。计费常见问题解释了流量的计算方式。请请求压缩响应,因为相同的 pdp_client_v1 正文在未压缩时平均为 134 KB,使用 gzip 后则为 14 KB。
网络解锁器 API 会为你处理解锁,并且只对成功请求计费。在我们的 IP 和客户端测试中,它无需调整客户端,即可让所有调用通过美国出口 IP 成功完成。你也可以同时使用网络解锁器 API 和住宅代理。根据每个端点的流量规模选择合适方案来发送请求;当 Target 的机器人检查发生变化时,可将相应端点迁移到网络解锁器 API。
验证并监控 Target 数据采集
is_human_block() 检测到的拦截会显示为错误。看似有效但门店错误的价格会显示为数据,因此不会触发错误。以下检查有助于发现看起来像有效数据的故障,或避免浪费请求:
| 检查项 | 检查位置 | 可检测的问题 |
|---|---|---|
| 价格是大于零的数字 | price |
缺失价格和价格区间 |
| 价格来自请求的门店,或已标记为线上价格 | location_id、scope |
错误门店价格 |
| 行对应子 TCIN | tcin、children |
父商品层级的价格区间 |
| 正文具有预期 JSON 结构,且不含 HUMAN 拦截 | 响应正文 | HTML 和 JSON 拦截响应(HTTP 435) |
| 商品仍然存在 | 404、dead_page |
每次运行都重试的失效 URL |
| 与上次运行相比,价格变化处于你的阈值内 | 价格历史 | 错误解析或错误价格 |
请对每个批次执行这些检查,并保存每行的 TCIN、门店 ID 和采集时间,以持续积累历史数据。按原因统计失败,例如拦截、门店错误、商品下架或超时。单一的总体失败率可能掩盖某个原因的失败率上升,因此当任一原因的失败率高于正常水平时都应发出警报。还应跟踪每条成功记录的成本,以便使用相同指标比较不同方案。
总结
Target 会公开展示商品数据,但价格可能取决于门店、变体和采集时间。在我们的测试中,位置 3991 的线上价格、父商品价格区间和 JSON 拦截响应看起来都像有效数据。请为每一行保留门店 ID、变体和请求状态,并每天对依赖的每个端点执行金丝雀测试。
网络解锁器 API 负责处理解锁,你的代码控制门店和渠道;Target 爬虫 API 还会负责解析和维护。要做出选择,可利用免费套餐在两者上运行一组商品和邮政编码样本并比较价格。免费套餐每月包含 5,000 次请求,且无需信用卡。
常见问题
Target 是否有公开的商品 API?
没有。Target 的开发者门户仅供 Target 员工、Target Plus 卖家和合作伙伴使用。其网站会使用页面中的 API 密钥调用 redsky.target.com 上的内部 JSON API,而这些端点可能在不另行通知的情况下发生变化。Bright Data 的 Target 爬虫 API 会根据 URL 和邮政编码返回商品记录。
如何按门店获取 Target 商品价格?
使用门店 ID 和 Target 的公开 API 密钥调用商品 API,即可获取该门店中每个变体的价格。另一个端点可将邮政编码映射到最近的门店 ID。位置 ID 3991 表示 Target 的线上价格,而非门店价格。Bright Data 的 Target 爬虫 API 会返回你所发送邮政编码对应的价格。
可以按门店跟踪 Target 库存吗?
可以。在我们的测试中,Target 的 product_fulfillment_v1 端点会返回请求门店的商品数量,以及配送、自提和店内状态。New York 的一家门店库存为 0,附近一家门店库存为 6,而配送显示该商品有货。请按门店和渠道保存库存。
爬虫 Target 数据需要多少费用?
费用会随商品数、门店数和每日刷新次数增加。每天跟踪 50 家门店的 5,000 件商品,意味着每月需要 750 万次请求或记录。Bright Data 对网页爬虫工具 API 按交付记录计费,对网络解锁器 API 按成功请求计费,对住宅代理按 GB 计费。每个定价页面都列出了当前费率。
如何免费爬虫 Target 商品?
Bright Data 的免费套餐每月包含 5,000 次请求,无需信用卡,并同时适用于 Target 爬虫 API 和网络解锁器 API,因此你可以用自己的商品测试价格。普通 HTTP 请求本身免费,但在我们的测试中,Target 的机器人检查会拦截使用美国 IP 且采用默认设置的客户端。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。