你有一个 Pinterest Pin URL,想获取标题、描述和收藏次数。抓取这些数据不需要浏览器。退出登录后的 Pin 页面会在 JSON-LD 块中包含这三项数据,以及发布者和出站链接。个人资料和画板的 RSS Feed 会通过普通 HTTP 列出 Pin URL。
但搜索页面并非如此。Pinterest 会在浏览器中构建搜索结果网格,并向退出登录的访客显示登录弹窗。即使部分图块成功渲染,也没有标题和链接。
本指南将介绍如何正确爬虫 Pinterest并获取你需要的所有公开数据。
简而言之
公开 Pin 可以通过普通 HTTP 解析,而关键词搜索和完整的个人资料爬虫则需要托管 API。
- 搜索限制读取的是账户状态,而非机器人评分,因此隐身浏览器不会带来任何改变。
- 旧版指南失败有两个原因:
pinWrapper匹配不到任何内容,而且记录并不在 Redux store 中。 - 数据中心 IP 能获取 Pin 页面,但其中没有 JSON-LD 块,因此请使用住宅地址运行。
- 针对一个账户的所有画板,两种免费方法共获取了 435 个不重复的 Pin,而这些画板中总共有 9,000 多个 Pin。
你可以从 Pinterest 提取哪些数据
一条 Pin 记录包含标题、描述、图片或视频 URL、话题标签、类别、评论数以及发布者的个人资料 URL。个人资料则会列出粉丝数、画板名称,以及用户发布过的 Pin。
难点在于访问,而非数据模型。Pinterest 的开发者指南禁止“使用任何自动化方式或任何形式的爬虫或数据提取访问 Pinterest 信息”。robots 文件是一份允许列表,而非阻止列表:它逐个列出数百个爬虫,并为 User-agent: * 设置了 Disallow: /。任何未被列出的客户端都不允许访问。
因此,请仅采集公开数据、保持较低的请求频率,并且不要登录个人账户进行自动化操作。根据 GDPR,发布者姓名和个人资料 URL 属于个人数据;同一份指南也禁止使用 Pinterest 素材训练 AI 模型。如需进行超出这些范围的操作,请咨询专业人士。
通过普通 HTTP 请求 Pin 页面会返回什么
对于已有 URL 的 Pin,你不需要浏览器。退出登录后的 Pin 页面会嵌入一个 JSON-LD SocialMediaPosting 块,而这个块本身就是完整记录。
开始时只需要 Python 3,无需安装其他依赖:json、re 和 urllib 都属于标准库。第一个 pip install 会在后面将个人资料转换成画板 Feed 时用到。
解析该数据块,只需几行代码即可获取 Pin 数据:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
BOILERPLATE = "Discover (and save!) your own Pins"

def scrape_pin(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script[^>]*type="application/ld\+json"[^>]*>(.*?)</script>',
        html, re.S)
    if not block:            # deleted pin: no JSON-LD block on the page
        return None
    data = json.loads(block.group(1))

    # Recipe pins use name/description, everything else headline/articleBody
    description = data.get("articleBody") or data.get("description")
    if description and BOILERPLATE in description:
        description = None   # Pinterest filler text, not the pin's own words

    saves = next((s.get("userInteractionCount")
                  for s in data.get("interactionStatistic") or []), None)
    return {
        "schema": data.get("@type"),
        "title": data.get("headline") or data.get("name"),
        "description": description,
        "pinner": (data.get("author") or {}).get("name"),
        "image": data.get("image"),
        "date": data.get("datePublished"),
        "source_link": (data.get("sharedContent") or {}).get("url"),
        "saves": saves,
    }

if __name__ == "__main__":
    print(json.dumps(scrape_pin(
        "https://www.pinterest.com/pin/99360735523397542/"), indent=2))
运行后,一个仍然有效的 Pin 会返回完整记录:
{
  "schema": "SocialMediaPosting",
  "title": "12 Bombshell Hair Color Ideas To Try This Summer | Ecemella",
  "description": "A person with long, straight reddish-brown hair wearing a black leather jacket...",
  "pinner": "Sarah Komnick",
  "image": "https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
  "date": "2023-05-24T22:32:51.000Z",
  "source_link": "https://www.ecemella.com/summer-hair-color-ideas/",
  "saves": 196
}
所有数据都来自一次请求。
记录位于 JSON-LD 块中,而非页面的 Redux store 中。另一个脚本 __PWS_INITIAL_PROPS__ 会将 initialReduxState.pins 设为空对象。读取 store 的爬虫工具将一无所获。已删除的 Pin 则完全没有 JSON-LD 块,因此 scrape_pin 会返回 None而不是残缺记录。
Pinterest 会提供不止一种 JSON-LD 类型,忽略 schema 会导致爬虫静默失效。在 105 个 Pin 中,100 个返回 SocialMediaPosting5 个返回 Recipe并且每个 Pin 都包含 JSON-LD 块。
这 105 个 Pin 来自两个来源:其中 90 个来自 10 个账户的 RSS Feed,完全没有视频 Pin;另外 15 个来自通过爬虫 API 执行的关键词搜索,其中 10 个是视频。视频 Pin 使用相同的 SocialMediaPosting schema,可以正常解析。
这两种 schema 的差异是完全互斥的,而非部分重叠,因此很容易被忽略。在包含 90 个 Pin 的 Feed 样本中,85 个社交帖子全部包含 headline、articleBody、datePublished 和 sharedContent而 5 个食谱帖子一个都没有。食谱 Pin 改用 name 和 description。如果只读取 headline整个类别都会返回空值,日期和出站链接也会丢失。
视频 Pin 存在另一个问题。其 JSON-LD 中的 image 是一个 .jpg 静态帧,而数据块不包含 contentUrl、duration 或 embedUrl。
视频本体是位于 v1.pinimg.com 上的 HLS manifest,即 HTTP Live Streaming 播放列表格式。它出现在页面 HTML 中,而非结构化数据块中,所以视频 Pin 可以成功解析,但只会返回缩略图。爬虫 API 的记录会直接包含 video_length 和媒体 URL,因此无需第二次请求即可识别视频 Pin。
具体比例取决于账户,而且可能完全相反。单独抽样时,某个美食账户的 Feed 在 25 个 Pin 中有 19 个是 Recipe。仅解析 headline 会让其中四分之三的记录返回空标题。如果你需要,食谱 Pin 还会提供 recipeYield 和 aggregateRating。
在食谱 Pin 上description 通常是 Pinterest 自动填充的文本,而非发布者撰写的内容。代码会返回 None而不会将它误当成正文。
大规模爬虫时真正会出问题的地方
Pinterest 在 Pin 页面前使用 Akamai,但响应中没有迹象表明这些页面启用了 Bot Manager。使用默认 urllib User-Agent 快速发送 12 次请求,全部返回 200。响应只设置了 csrftoken、_pinterest_sess、_auth 和 _routing_id。没有出现任何 Akamai Bot Manager Cookie,也没有提供传感器载荷,因此不存在需要破解的 TLS 质询。
在六种客户端身份下,同一个 Pin 每次都会返回 JSON-LD 块。这些身份包括 Chrome User-Agent、curl、Googlebot 和空字符串。因此,解析过程不需要伪造 User-Agent。
但这只适用于住宅地址。测试五个 Pin 时,住宅网络请求每次都包含 JSON-LD 块,而数据中心请求一次也没有。两者都返回正确页面、正确标题和数量相近的脚本。
Pinterest 在页面的 __PWS_DATA__ 中,通过 context 对象明确说明了这种差异。is_hosting 在住宅网络一侧显示 false在托管网络一侧显示 true而两侧的 is_bot 都为 false。因此,决定因素是网络信誉,而非机器人评分。
从云端虚拟机运行 scrape_pin 时,每个测试 Pin 都返回 None页面上没有任何内容说明原因。指纹模拟客户端无法改变运行环境的网络地址。
一旦开始为流量付费,HTTP 客户端的选择比以上因素更重要。标准库 urllib 不发送 Accept-Encoding 标头,因此服务器返回未压缩数据。使用标准库示例时,每个 Pin 要下载约 1.13 MB。
requests 库默认协商 gzip,每个 Pin 只传输约 183 KB。支持 Brotli 的浏览器则约为 124 KB。页面和数据完全相同,但所选客户端让传输字节数相差 9 倍。
这很重要,因为代理通常按传输字节计费。抓取 10,000 个 Pin 时,标准库示例会产生 11.3 GB 流量,而通过 requests 执行同一任务只需 1.83 GB。按照住宅代理 $8/GB 的标价计算,费用分别约为 $90 和 $15。你可以使用标准库版本了解其原理,但实际运行时应切换到 requests 或 curl_cffi。
大规模运行时恶化的是 IP 信誉,而非 TLS 指纹。因此,轮换住宅地址会有帮助,而模拟指纹的客户端通常不会。如果以后遇到确实检查握手的 Pinterest 页面curl_cffi(库文档)是标准替代方案,而且无需修改解析逻辑:
from curl_cffi import requests as cffi   # pip install curl_cffi

resp = cffi.get("https://www.pinterest.com/pin/99360735523397542/",
                impersonate="chrome", timeout=30)
html = resp.text                 # feed this to the same JSON-LD parse
这里有两个限制。它无法访问 Pinterest 内部端点。无论使用普通 urllib还是模拟 Chrome 的客户端PinResource 都返回 403,因此这里的问题不是指纹。并且,如果页面提供 JavaScript 质询,它也无法直接作答。
官方 oEmbed 端点
Pinterest 为公开 Pin 提供 oEmbed 端点。这是本文中最轻量的单 Pin 查询方式,并且直接返回 JSON,而不是整页 HTML。以下调用使用 curlmacOS、Linux、Windows 10 及更高版本均自带该工具。你也可以先将 URL 直接粘贴到浏览器中测试:
PIN="https://www.pinterest.com/pin/99360735523397542/"
curl "https://www.pinterest.com/oembed.json?url=$PIN"
它会返回来源信息、缩略图以及可直接使用的嵌入内容:
{"version":"1.0","type":"rich","provider_name":"Pinterest","title":" ",
 "author_name":"Sarah Komnick",
 "author_url":"https://www.pinterest.com/sarahkomnick/",
 "thumbnail_url":"https://i.pinimg.com/236x/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
 "thumbnail_width":236,"thumbnail_height":314,
"html":"<iframe src=\"https://assets.pinterest.com/ext/embed.html?id=99360735523397542\" ...></iframe>"}在可自行运行的方案中,这种方式风险最低。oEmbed 是网站用于允许第三方嵌入内容的标准格式。它是公开接口,而非内部 API。
它还接受画板和个人资料 URL,不仅限于 Pin。对于这两类 URL,它都会返回真实标题,而 Pin 请求的标题则为空。响应不包含描述、收藏次数或出站来源链接。
Pinterest 的 Pin 页面会返回软 404。已删除的 Pin、不存在的数字 ID 和格式错误的 slug 都会返回 HTTP 200。被截断的 ID 和未使用的数字 ID 同样如此,但都没有 JSON-LD 块。任何基于 response.status 构建的检查都没有意义。
oEmbed 端点则会返回 HTTP 400。在上述 5 种情况下,它全部返回 400,而有效 Pin 返回 200。
在 19 个 Pin 中,它的传输量中位数为 583 字节,而页面约为 124 KB。因此,在解析前用它过滤 URL 列表成本很低。连续发出 80 次请求且不添加延迟时,所有请求都返回 200,没有遇到限流,延迟也没有变化。
无需搜索网格即可发现 Pin URL
JSON-LD 解析和 oEmbed 都需要你已有 Pin URL。那么,这些 URL 从哪里来?
有一条路线看起来很明显,实际上却不可用。检查时,Pinterest robots 文件在 /v3_sitemaps/ 下声明了 50 个 Sitemap: URL。这些名称正是数据采集者需要的内容:image_pin_sitemap_recent_engagement_tier_1、video_product_pin_sitemap以及多个层级的画板链接 sitemap。但这 50 个 URL 全部返回 HTTP 404。
在依赖已声明的 sitemap 前,至少先请求一次进行验证。
对于个人资料或画板,可以从 RSS 获取 URL。Pinterest 仍会在 /<username>/feed.rss 和 /<username>/<board-slug>.rss 提供无需身份验证的 Feed:
import re, urllib.request
import xml.etree.ElementTree as ET

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def list_pins(feed_url):
    req = urllib.request.Request(feed_url, headers={"User-Agent": UA})
    xml = urllib.request.urlopen(req, timeout=30).read()
    pins = []
    for item in ET.fromstring(xml).findall(".//item"):
        desc = item.findtext("description") or ""
        thumb = re.search(r'src="([^"]+)"', desc)
        pins.append({
            "url": item.findtext("link"),
            "published": item.findtext("pubDate"),
            "thumbnail": thumb.group(1) if thumb else None,
        })
    return pins

if __name__ == "__main__":
    feed = list_pins("https://www.pinterest.com/boredpanda/animals.rss")
    print(f"found {len(feed)} pins")
    print(feed[0])
某个画板 Feed 返回了一组可用的真实 Pin URL:
found 26 pins
{'url': 'https://www.pinterest.com/pin/150307706316766946/',
 'published': 'Thu, 23 Jul 2026 12:14:04 GMT',
 'thumbnail': 'https://i.pinimg.com/236x/18/a4/8b/18a48b04fbe868130b0a2ad14759fe87.jpg'}
在浏览器中打开其中一个 Feed URL,结构非常清晰。每个 <item> 都包含 Pin 链接、发布日期,以及描述中的缩略图:
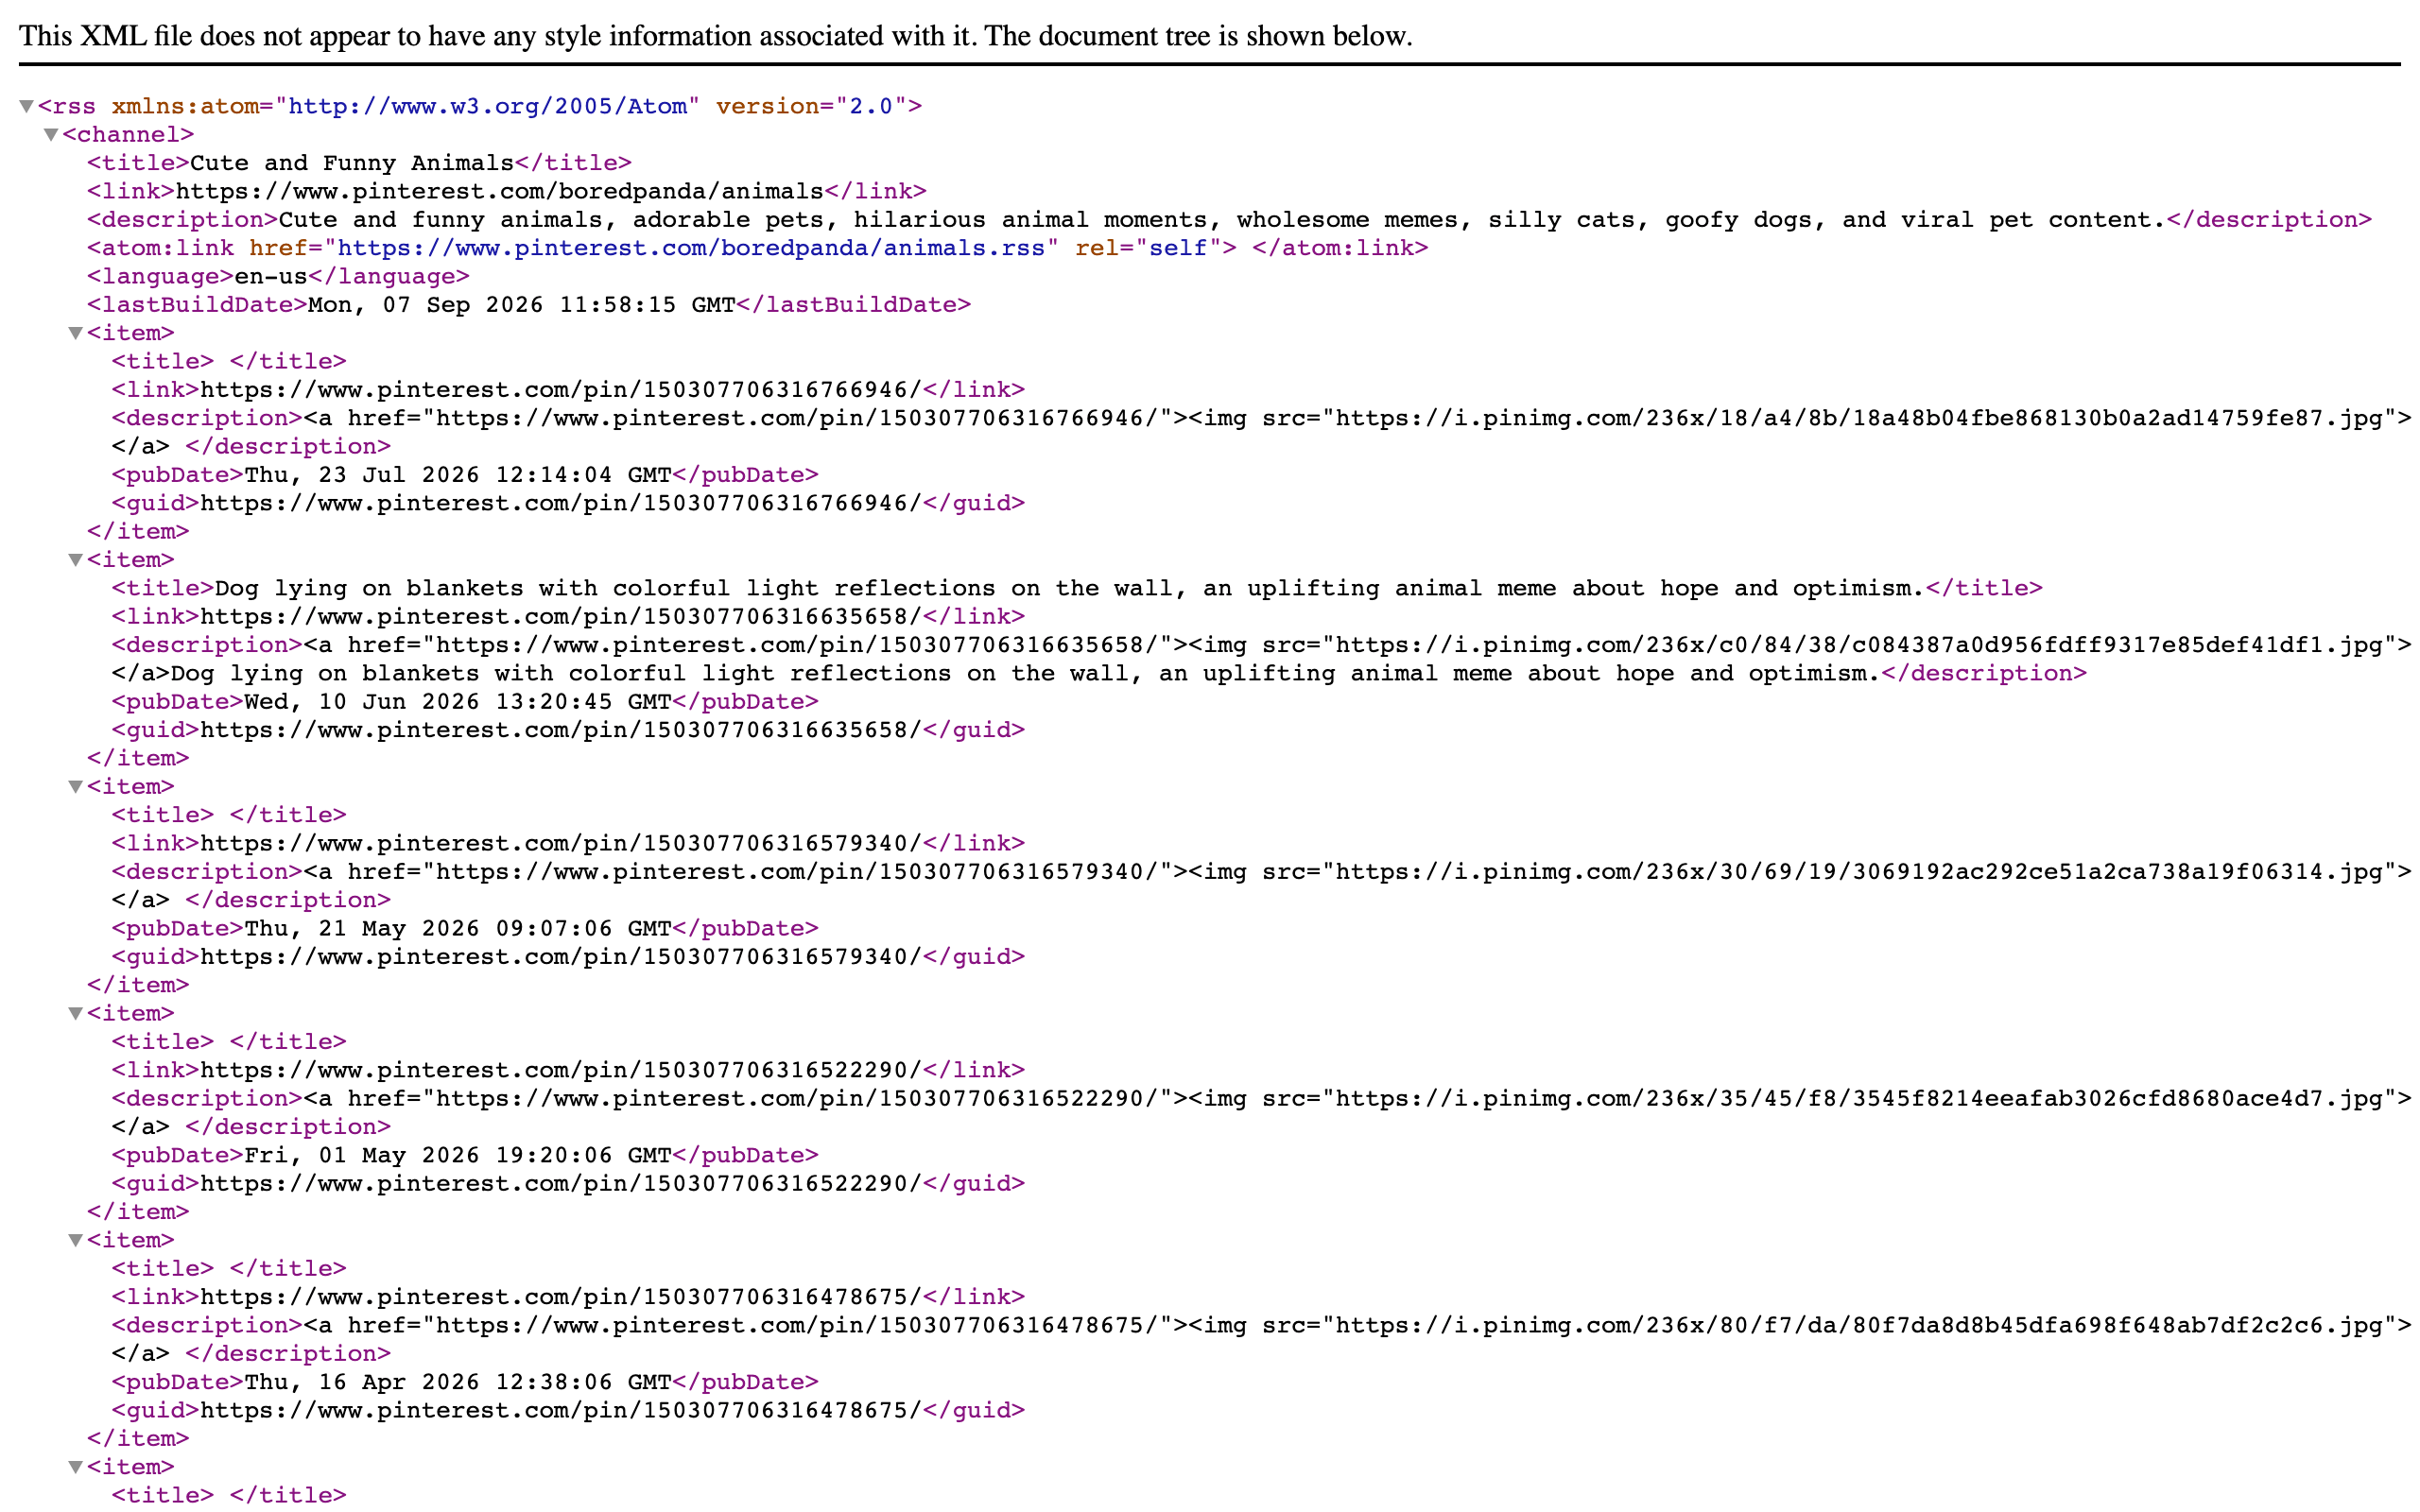
空的 <title> 标签说明 Feed 适合充当 URL 来源,而非元数据来源。这个 Feed 中只有一个条目带有真实标题,其余都为空。
将它与逐个 Pin 解析串联起来,就能得到一条完全不加载浏览器的完整流程。将 scrape_pin 和 list_pins 一起保存为 pinterest.py以下代码会原样导入它们:
import time, json
import xml.etree.ElementTree as ET
from pinterest import scrape_pin, list_pins   # from pinterest.py

def collect_feed(feed_url, delay=0.5):
    records = []
    try:
        pins = list_pins(feed_url)
    except (OSError, ET.ParseError) as err:   # skip a bad feed, keep going
        print(f"skipped feed {feed_url}: {err}")
        return records
    for pin in pins:
        time.sleep(delay)         # before the request, so skips stay polite too
        try:
            record = scrape_pin(pin["url"])
        except (OSError, ValueError) as err:  # transient: keep what you have
            print(f"skipped {pin['url']}: {err}")
            continue
        if record is None:        # deleted pin: the page soft-404s to 200
            continue
        record["url"] = pin["url"]
        record["feed_published"] = pin["published"]
        records.append(record)
    return records

rows = collect_feed("https://www.pinterest.com/foodnetwork/feed.rss")
print(f"{len(rows)} pins enriched")
with open("feed-pins.json", "w") as f:
    json.dump(rows, f, indent=2)
在一个美食账户上,它用 46 秒输出了 25 pins enriched。25 个 Pin 全都有标题,schema 比例为 19 个食谱帖子和 6 个社交帖子。测试的 12 个账户全部提供 Feed,包括个人创作者和大型品牌。个人资料 Feed 返回 22 至 25 个条目,画板 Feed 返回 23 至 26 个。
Feed 有固定上限,不会随画板内容数量增长。一个显示接近 6,000 个 Pin 的画板只返回 24 个条目,与仅有 39 个 Pin 的画板相同。如果低于这个上限,返回数量会接近实际数量:一个有 6 个 Pin 的画板返回了 5 个。
将个人资料转换成一组画板 Feed
一个账户不止有一个 Feed,而且个人资料页面会公开列出这些 Feed,包括名称和 Pin 数量,无需登录:
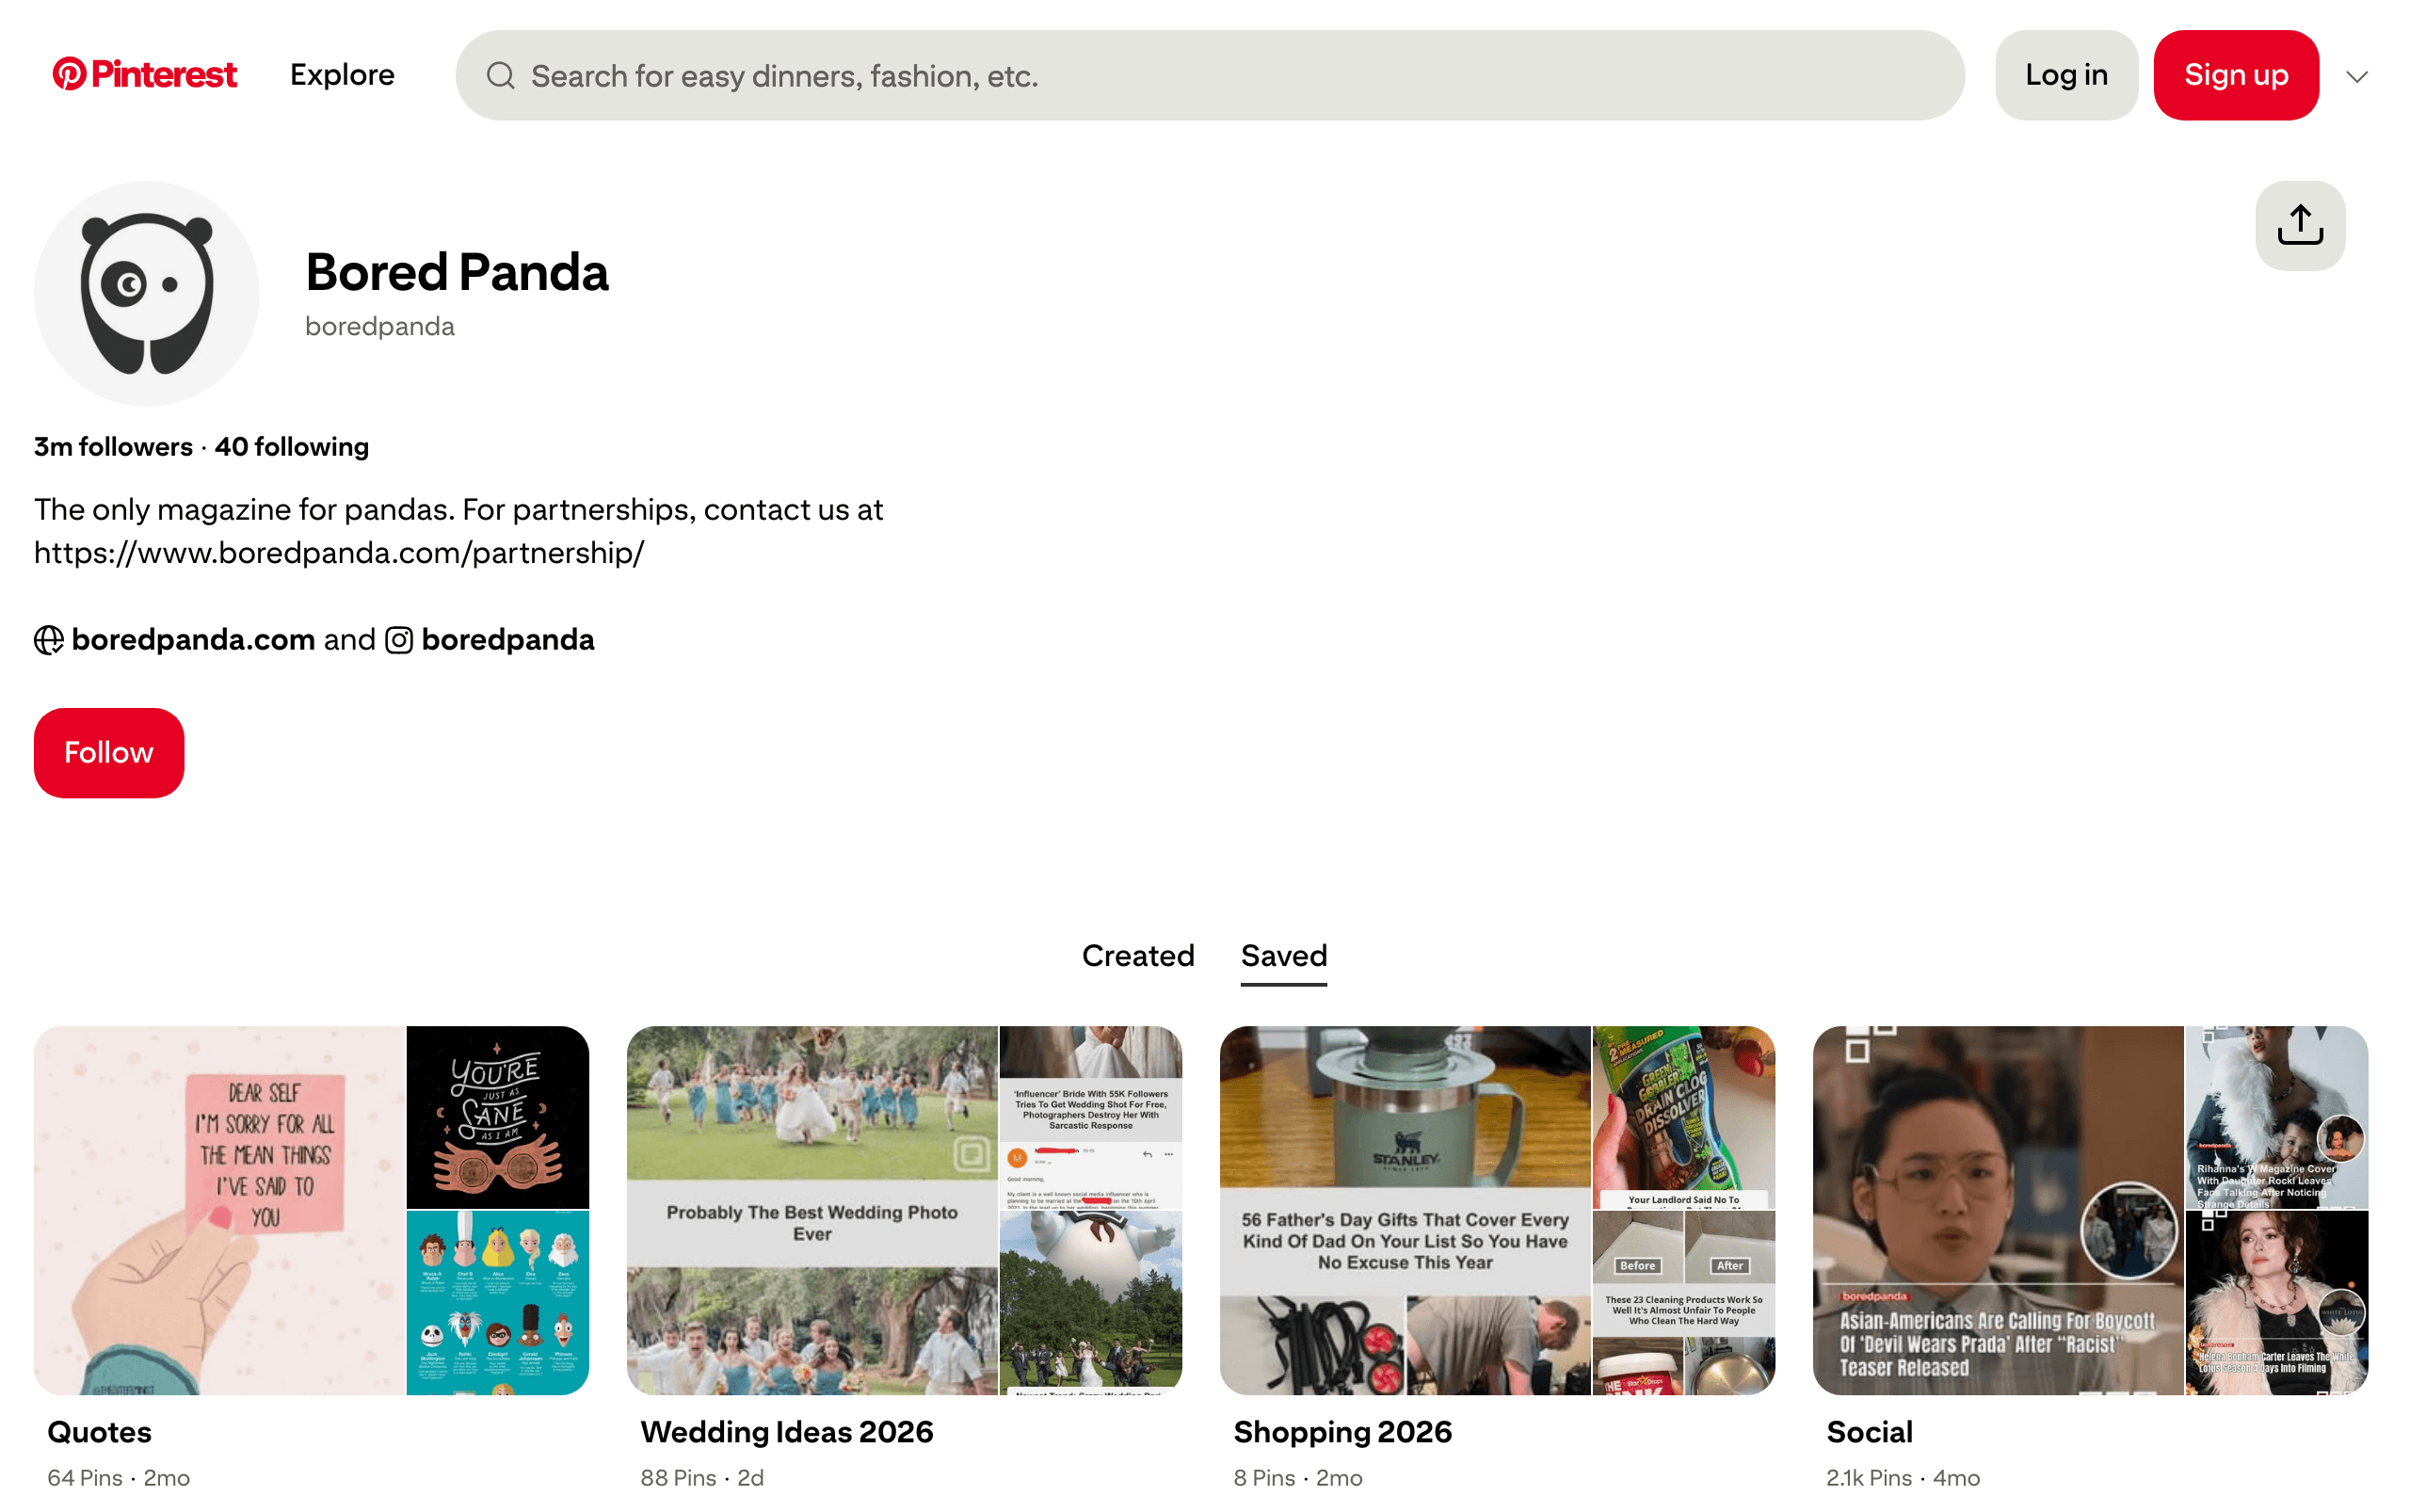
搜索页面会显示登录弹窗,但个人资料页面不会。这些画板名称就是 list_boards 从页面 HTML 中读取的 slug。Pin 数量可以告诉你哪些画板会触及 Feed 上限,以及哪些画板较小、可以返回其中大部分内容。
画板 slug 通常会通过普通 HTTP 出现在个人资料 HTML 中,因此使用正则表达式即可将账户名称转换成一组 Feed URL:
import re, requests            # pip install requests

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
RESERVED = {"pins", "boards", "followers", "following"}   # routes, not boards

def list_boards(handle):
    html = requests.get(f"https://www.pinterest.com/{handle}/",
                        headers={"User-Agent": UA}, timeout=30).text
    found = re.findall(rf'"/{handle}/([A-Za-z0-9][A-Za-z0-9_-]*)/"', html)
    slugs = set(found) - RESERVED
    base = f"https://www.pinterest.com/{handle}"
    return [f"{base}/{s}.rss" for s in sorted(slugs)]

feeds = list_boards("boredpanda")
print(f"{len(feeds)} board feeds")
print(feeds[0])
一个账户返回了九个画板 Feed:
9 board feeds
https://www.pinterest.com/boredpanda/animal-memes.rss
除了画板列表,退出登录后的个人资料 HTML 还会嵌入一个 ProfilePage JSON-LD 块。测试的 8 个账户全部可以解析。
它会提供显示名称、用户名、个人简介、头像 URL 和账户创建日期。sameAs 数组指向账户所有者的其他个人资料;在这些账户中,包括 Instagram 和他们自己的域名。8 个账户中有 6 个还在 interactionStatistic 下包含粉丝数,其中 Etsy 的数字超过 1,100 万。其解析方式与 Pin 页面相同,只是目标 URL 不同。
通过 list_pins 运行全部 9 个画板 Feed 后,从 boredpanda 中获得了 208 个不重复的 Pin URL,而单个 Feed 只能提供 25 个。没有任何 Pin 同时出现在两个画板 Feed 中。测试的每个账户都以这种方式列出了画板:10 个账户中全部成功,每个账户包含 8 至 10 个 slug。所有 10 个账户的第一个画板 Feed 都返回了条目。
这 9 个只是个人资料页面显示的画板,并非账户的完整画板集。API 个人资料记录显示同一账户有 51 个画板。普通 HTTP 只能访问其中 9 个,并且每个都受相同的 25 条上限限制。
此前使用的 animals Feed 并未包含在其中,所以如果你已经知道某个画板,仍值得直接请求。有效的个人资料也可能完全不返回 slug。应将空列表视为检查用户名的信号,而非账户没有画板的证明。
在测试的所有 Feed 中,除一个条目外,其他标题均为空。其余信息交给逐 Pin 解析来提供。
突破 Feed 上限的两种方式
爬虫 API 中的个人资料抓取工具从另一个方向访问画板列表。boards_num 为 boredpanda 报告了 51 个画板,因此你可以在开始前知道集合大小。
其 saved 数组中的每个条目都包含一个 saved_collection_url。在测试的 6 个画板中,将该 URL 与 .rss 组合后都能返回 Feed。数组本身只返回这 51 个画板中的 10 个,同样只是部分列表。
追加内容前要去掉末尾斜杠。saved_collection_url 本身以斜杠结尾,而 Pinterest 对由此生成的两种形式采取完全不同的处理。以 quotes.rss 结尾会返回一个 13 KB 的 Feed。
以 quotes/.rss 结尾则返回 HTTP 200 和 HTML 应用页面。这会让 XML 解析器报无效标记错误,并指向某行 JavaScript。使用 saved_collection_url.rstrip("/") + ".rss" 构建 URL,即可避免这种形式进入解析器。
位于 widgets.pinterest.com/v3/pidgets/ 的旧版 widget 后端也接受无需身份验证的请求,并且在多数画板上返回的内容比 RSS 更多。它的画板端点会返回 50 个 Pin,而同一画板的 Feed 只返回 26 个,并且每个 Pin 都带有描述。它还会报告画板级别的 pin_count让你大致了解遗漏了多少内容。
50 是硬性上限,而非分页大小。page、offset、limit、count 和 page_size 均被忽略,每次都返回相同的 50 条。在 boredpanda 的九个画板中,widget 后端获取了 362 个不重复的 Pin,而画板 Feed 获取了 208 个。两者合计获取 435 个,而这些画板实际拥有 9,000 多个 Pin。
在依赖该方案前,有三点需要注意。它的 repin_count 并不是 JSON-LD 收藏次数。对于本指南一直使用的 Pin,同时读取两者时,widget 返回 77,而 JSON-LD 返回 196。只有 JSON-LD 中的数字才是 Pinterest 标记为“Saves”的数据。
出站链接会因画板而异:一个画板的 50 个 Pin 全部包含链接,另一个画板的 43 个 Pin 中只有 5 个包含链接。几乎每个 Pin 都有描述。而且 widget 并非总是更好:在一个较小画板中,RSS 返回 9 条,而 widget 返回 8 条。该端点没有文档、不支持搜索,也没有兼容性保证。
如果需要获取第 50 个之后的 Pin,或者按计划定期执行,爬虫 API 中的个人资料抓取会以后台任务形式遍历整个账户。它会为找到的每个 Pin 返回一条结构化记录。
爬虫 API 的发现功能在个人资料层级运行,因此请传入个人资料 URL,然后将记录筛选到所需画板。在测试的两个画板中,传入画板 URL 后返回的是个人资料,而非请求中指定的画板。
免费方法为何止步于搜索
请求搜索结果页面时,HTML 中的 JSON-LD 块数量为零。结果网格由浏览器后续请求构建,而退出登录的会话会受到访问限制。截至 2026 年 9 月__PWS_DATA__ 块列出了十项 lop_unauth_lockdown_* 实验,其中包括 _main、_closeup 和 _search。
其中两项实验直接涉及本指南使用的路线:lop_unauth_lockdown_profile 和 lop_unauth_lockdown_board。退出登录限制是一项正在运行的实验,而非网站永久不变的组成部分。因此,应持续监控个人资料和画板访问情况,不要假定它们始终可用。
同一个数据块也展示了限制机制检查的内容,因为 Pinterest 会在其中记录其对客户端的判断。在 context 下,Pin、搜索和个人资料页面都包含相同的 15 个分类字段,其中包括 is_bot、is_proxy、is_vpn、is_tor、is_hosting、is_unauth_botspam_asn 和 is_authenticated。
从普通住宅地址请求时is_bot 返回 "false"所有代理和托管标记均为 false,但搜索网格仍受到限制。这些锁定实验读取的是退出登录状态,而非机器人评分。
is_hosting 区分了会返回 Pin JSON-LD 的请求与不返回它的请求。因此,可以在单个 Pin 页面上从 <script id="__PWS_DATA__"> 标签读取 context。这是确认数据采集地址是否符合预期的最低成本方式。应在开始运行前执行此检查,以免把记录数量过低错误归咎于解析器。
这是未公开的内部信息,并非 Pinterest 的承诺,因此应将其视为需要重复执行的检查。该对象还包含 unauth_id以及你所在 IP 的国家和地区。数据离开本机前,请遮盖这些信息。
该检查本质上是针对另一个 script 标签执行 JSON-LD 解析:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
FLAGS = ("is_bot", "is_proxy", "is_vpn", "is_tor", "is_hosting",
         "is_unauth_botspam_asn", "is_authenticated")

def how_pinterest_sees_you(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script id="__PWS_DATA__" type="application/json">(.*?)</script>',
        html, re.S)
    if not block:
        return None
    ctx = json.loads(block.group(1)).get("context") or {}
    # this object also holds unauth_id and your IP geo: don't return those
    return {k: ctx.get(k) for k in FLAGS}

print(how_pinterest_sees_you(
    "https://www.pinterest.com/pin/99360735523397542/"))
分别从家庭网络和云端虚拟机运行,其中一个字段会发生变化:
# residential
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': False, 'is_unauth_botspam_asn': False, 'is_authenticated': False}

# same pin, same parse, hosting range
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': True, 'is_unauth_botspam_asn': False, 'is_authenticated': False}
is_bot 以字符串 "false" 的形式返回,而其他标记是真正的布尔值,因此要按字符串比较。发生变化的是 is_hosting 字段,它决定 Pin 页面是否包含 JSON-LD 块。
旧版指南调用的内部 JSON 端点已被整体关闭,并非逐个关闭。PinResource、BoardFeedResource、UserResource、BaseSearchResource 和 RelatedModulesResource 对未经身份验证的请求全部返回 HTTP 403。无论是否使用与真实浏览器匹配的 TLS 指纹,结果都一样。
请求会通过作为 CDN 的 Akamai。对搜索页和个人资料页执行相同 Cookie 检查时,也没有发现 Bot Manager 标记。
为什么官方 Pinterest API 不是爬虫工具
Pinterest 确实提供 REST API,首先尝试它似乎很合理。但它无法以任何实用规模采集公开内容,原因在于权限范围,而非质量。
API v5 用于管理你自己的账户:你的画板、Pin、广告和分析数据。org_read 类别适用于经过身份验证账户的“获取用户账户、画板、画板分区或 Pin”。除合作伙伴搜索测试版外,没有任何端点能返回不属于你的公开 Pin。
唯一的关键词搜索是 GET /v5/search/partner/pins这是一个“并非对所有应用开放”的测试版,只返回排名前 10 的 Pin。大多数爬虫项目需要的数据——其他人的公开 Pin 和个人资料——无法通过该 API 获取。
同一页面还公布了速率限制。截至 2026 年 9 月,试用权限允许所有端点每天合计发出 1,000 次请求。标准权限允许每位用户、每个应用每秒发出 100 次请求。Pinterest 还注明,所有限制都“可能随时更改,恕不另行通知”。
对于大规模第三方公开数据,官方 API 并不适用。因此,超出普通 HTTP 路线的采集需要浏览器自动化或托管爬虫工具。
使用 Playwright 爬虫 Pinterest
搜索是唯一需要浏览器渲染页面的路线,而 Playwright 可以通过 Python 驱动浏览器。如果你之前没有用过它,Bright Data 博客提供了更完整的 Playwright 教程其中的 API 使用方式相同。
安装前,先了解这条路线会返回什么:只有图片 URL,没有标题、描述或 Pin 链接。如果这不足以满足你的使用场景,请阅读浏览器方案失效的地方并跳过安装。
安装库和浏览器:
pip install playwright
playwright install chromium
以下脚本会打开搜索页面、滚动并读取 Pin 图块。首先需要注意一个细节:图块选择器已经改变。旧版指南使用 div[data-test-id='pinWrapper']但它在当前退出登录的网站上匹配不到任何内容。现在的退出登录网格使用 gated-pin-rep 表示每个图块,并用 gated-pin-image 表示其中的图片:
import asyncio, json
from playwright.async_api import async_playwright

BROWSER_UA = ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
              "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

async def scrape_pins(query, scrolls=6):
    url = f"https://www.pinterest.com/search/pins/?q={query}&rs=typed"
    seen = set()
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page(user_agent=BROWSER_UA,
                                      viewport={"width": 1280, "height": 900})
        await page.goto(url, wait_until="domcontentloaded")
        for _ in range(scrolls):
            await asyncio.sleep(1.5)
            images = await page.query_selector_all(
                "[data-test-id='gated-pin-image'] img")
            for img in images:
                src = await img.get_attribute("src")
                if src and "/236x/" in src:   # pin thumbnails, not UI images
                    seen.add(src)
            await page.mouse.wheel(0, 4000)
        await browser.close()
    return sorted(seen)

async def main():
    results = await scrape_pins("minimalist%20office")
    print(f"collected {len(results)} thumbnail URLs")
    with open("office-pins.json", "w") as f:
        json.dump(results, f, indent=2)

if __name__ == "__main__":
    asyncio.run(main())
设置 User-Agent 是最常见的 Pinterest 抓取建议,但它并不会产生人们宣称的效果。不覆盖 User-Agent、使用当前 Chrome 字符串、使用两年前的 Chrome 字符串,或直接使用 python-requests/2.32.3都会返回 HTTP 200 和相同数量的图块。每种方式都没有返回 Pin 链接,并显示相同的登录弹窗。尽管如此,仍建议保留一个合理值,因为这样没有成本,也能诚实标识你的流量。
必须使用集合,因为 Pinterest 会在滚动时重复利用图块节点。运行后,一个退出登录的会话会输出:
collected 16 thumbnail URLs因此,Playwright 只能从搜索中返回缩略图 URL,无法提供其他数据。
从 Pinterest 缩略图获取原尺寸图片
这些运行结果返回的缩略图宽度为 236 像素。如果你已有 Pin 的 JSON-LD 或 API 记录,其中就包含原尺寸 URL,无需重写。如果只有缩略图,则原尺寸文件位于相同路径,只需替换尺寸路径段。通常有人会使用单行字符串替换,但仅这样做大多会失败。
在来自实时 Feed 的 40 张缩略图中,将 /236x/ 替换为 /originals/ 并保留 .jpg 扩展名,只有 5 次成功,另外 35 次均返回 HTTP 403。Pinterest 会重新编码图片:缩略图以 .jpg 提供,而存储的原图通常是 .png。依次尝试不同扩展名后,40 张图片全部成功获取。
下载的文件属于他人摄影作品,因此无论你如何使用,都属于许可问题,而非抓取问题:
import re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def full_size(thumb_url):
    """Pinterest re-encodes, so the original's extension often differs."""
    base = re.sub(r"/\d+x\d*/", "/originals/", thumb_url).rsplit(".", 1)[0]
    for ext in ("jpg", "png", "webp", "gif"):
        candidate = f"{base}.{ext}"
        req = urllib.request.Request(candidate, method="HEAD",
                                     headers={"User-Agent": UA})
        try:
            if urllib.request.urlopen(req, timeout=15).status == 200:
                return candidate
        except Exception:
            continue
    return None
不过,不要更改尝试顺序,因为可用扩展名会因账户而异。在一个包含 40 张图片的样本中.png 成功 35 次.jpg 成功 5 次。之后对四个账户的另一个 40 张图片样本中.webp 成功 19 次、.jpg 成功 15 次、.png 成功 6 次。其中,一个账户全部是 .jpg另一个全部是 .webp第三个则主要是 .png。
应按每张图片约两次 HEAD 请求进行规划:在上述四账户样本中,循环平均查询 2.1 次后找到文件。
浏览器方案失效的地方
Playwright 会遗漏记录的其余部分。每个图块的 alt 文本都是固定字符串 Pin因此图块没有标题。它们也没有被 /pin/ 链接包裹,所以无法从网格中继续访问 Pin。
你只能得到一小组图片 URL,没有其他内容:没有描述、发布者、收藏次数或话题标签。在普通的退出登录浏览器中加载相同搜索,就能看出原因:
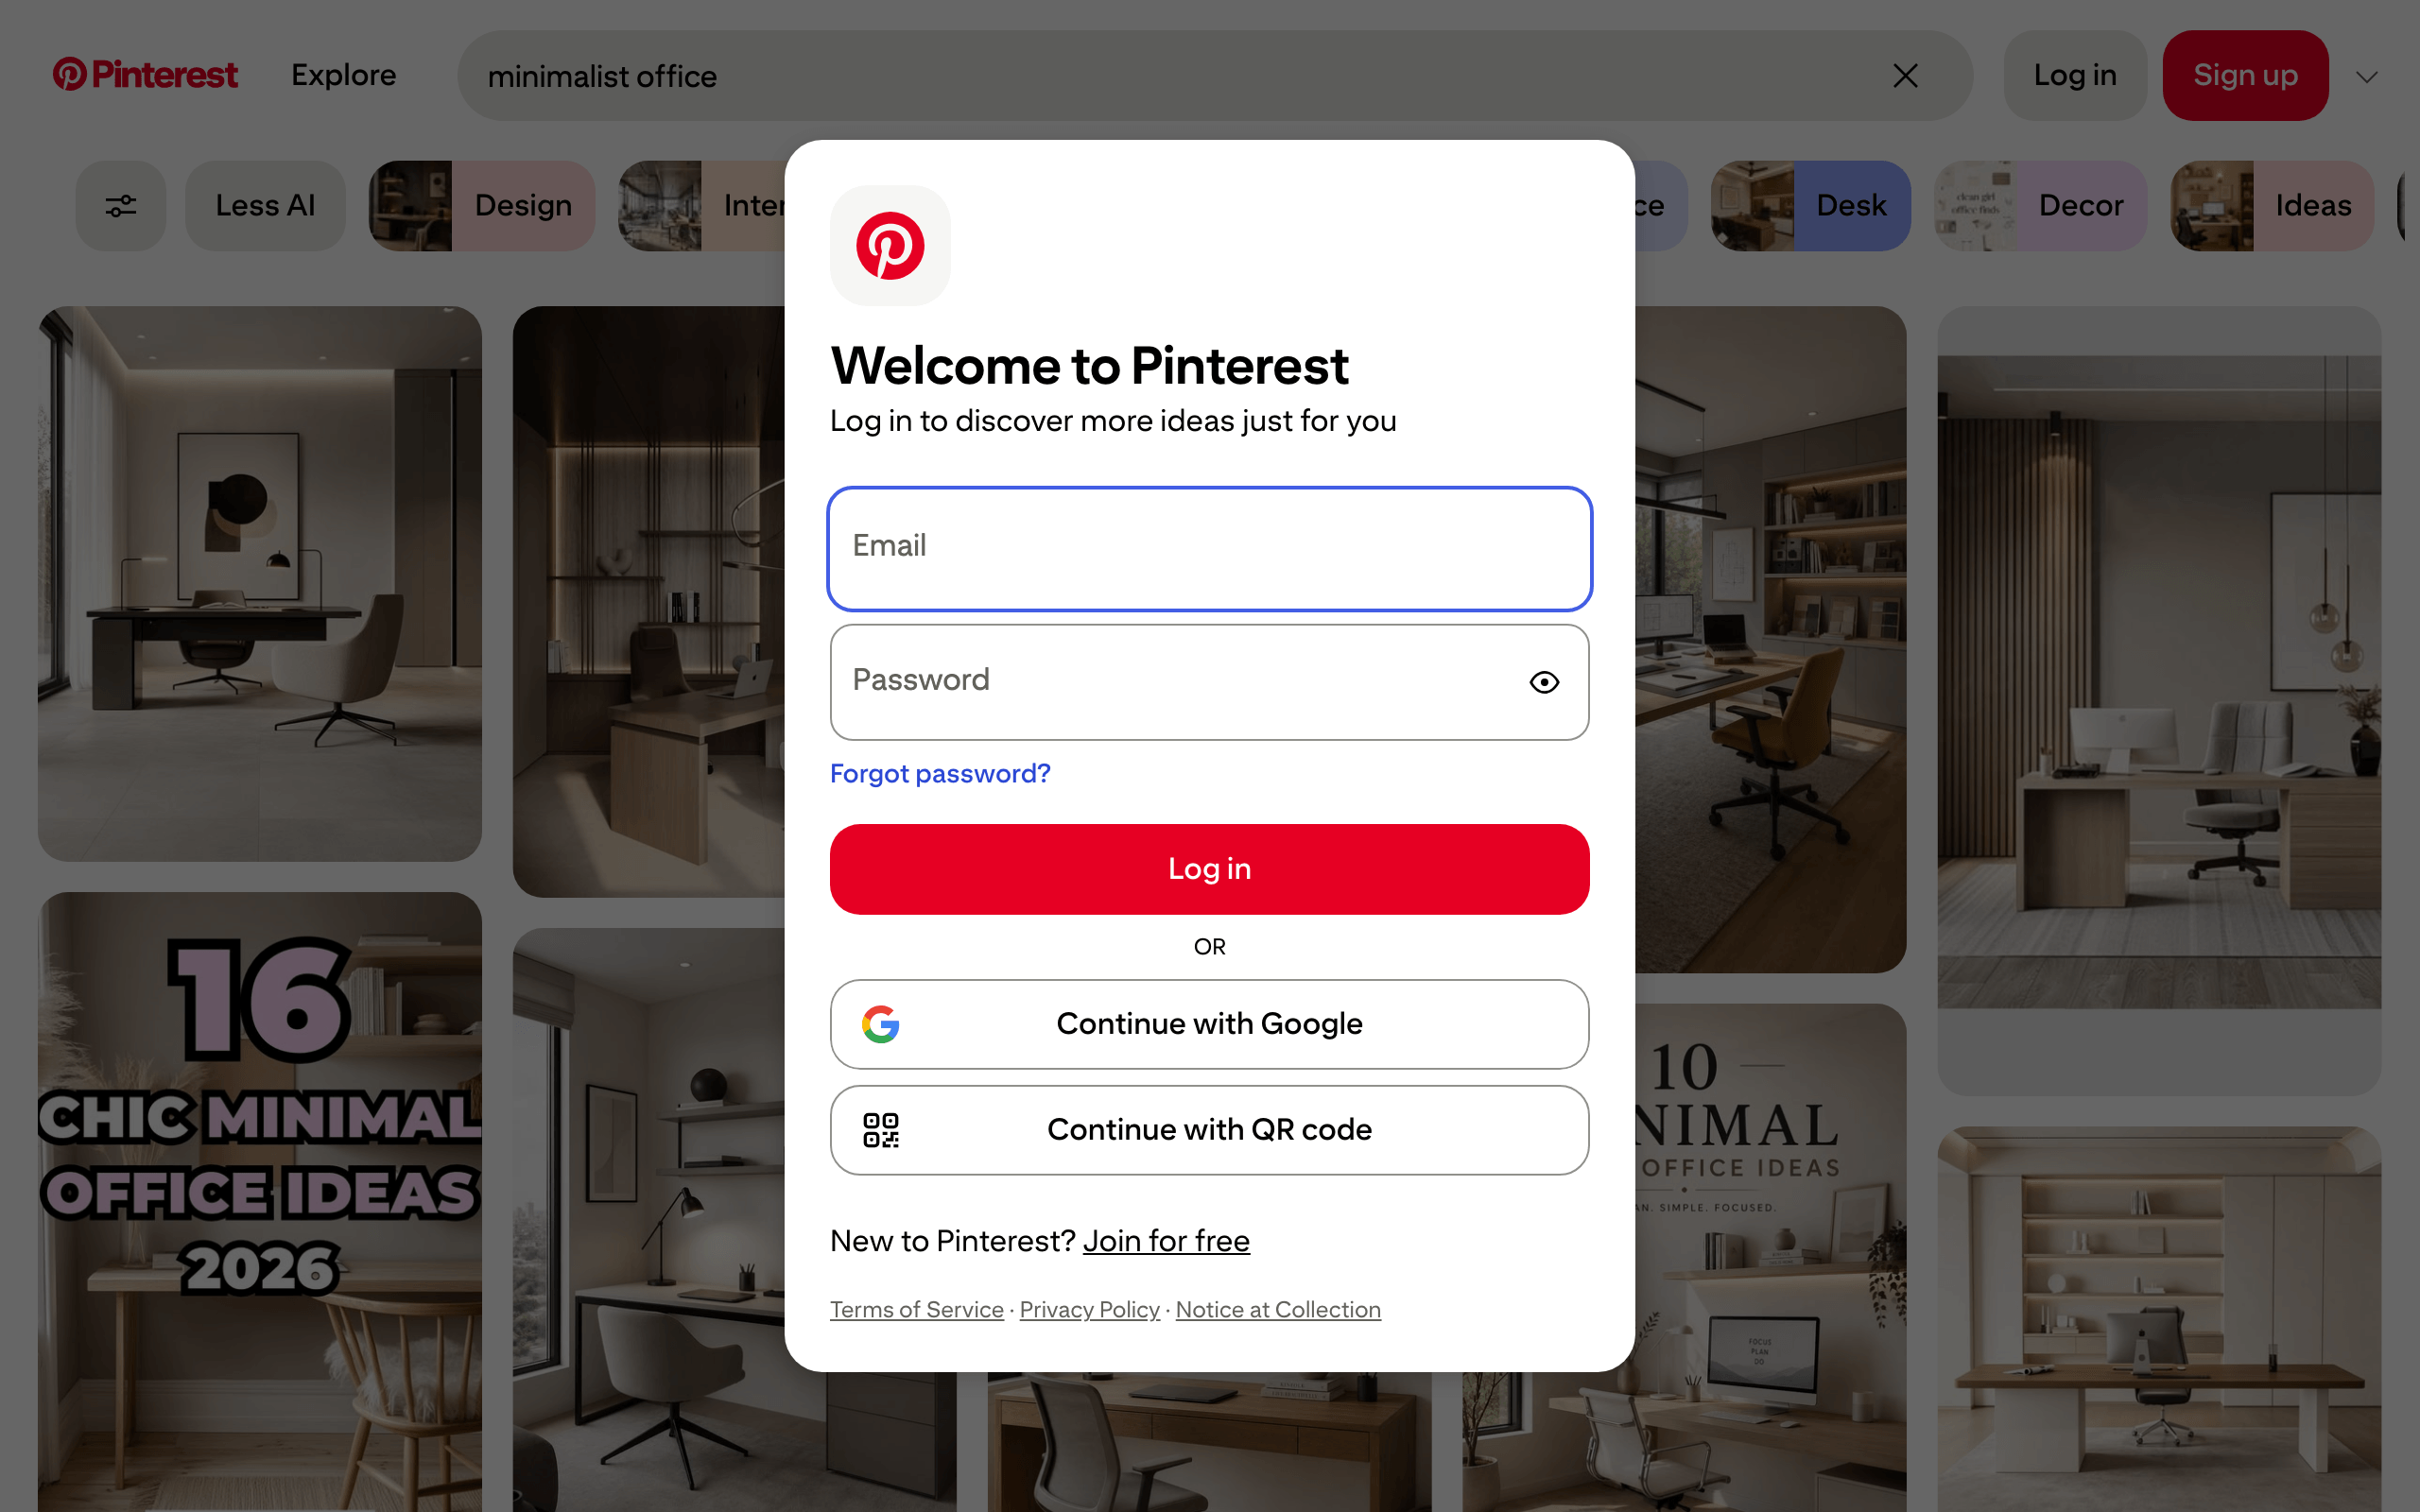
弹窗周围的图块就是脚本读取的 gated-pin-rep 元素。每个元素只包含一张图片,没有其他内容,因此运行结果只有 URL,没有标题。
继续滚动也不会改变结果。滚动 3 次和 25 次后,网格包含的数量完全相同,缩略图 URL 集合也不会继续增长。
同一会话内的数量保持稳定,但不同会话之间会变化。对于 minimalist office同一会话中的重复运行每次都返回 17 个;对于 fall fashion每次都返回 15 个。针对相同两个查询创建独立会话后,则分别返回 16、17 和 18 个。
预计固定数量会在十五到二十个左右。应将确切数字视为会话特有值,不能依赖。登录弹窗会覆盖 Feed,并阻止退出登录会话继续无限滚动,DOM 中还直接包含真实密码字段。
为什么隐身浏览器无法解决问题
很自然的下一步是使用隐身浏览器,但对于受账户状态限制的网格来说,这是错误诊断。未经修改的 Playwright 确实会在协议层暴露自动化信号,其中最明显的是 Chrome DevTools Protocol 中的 Runtime.enable 调用,而补丁版本会隐藏它们。Patchright 可以直接替代 Playwright 软件包,旨在不修改脚本的情况下隐藏这些信号。Camoufox 则是独立的 Firefox 构建版本,并非 Playwright 补丁。
使用渲染浏览器和自有代理池访问相同查询时,某个商业解锁工具完整返回了退出登录页面。这意味着页面包含注册提示、类别按钮和筛选栏,但没有任何 Pin 标题或 /pin/ 链接。
在同一会话中,让 Patchright 与未经修改的 Playwright 针对相同两个查询并行运行,结果完全没有变化。两者针对 minimalist office 都返回 16 个图块,针对 fall fashion 都返回 15 个。两者返回的 /pin/ 链接数量都为零,每个图块的 alt 文本都是 PinDOM 中也都存在相同的密码字段。
限制退出登录 Feed 的是账户状态门槛,而非机器人评分。搜索页和个人资料页都没有 Bot Manager Cookie。截至 2026 年 9 月,十项 lop_unauth_lockdown 实验仍在 __PWS_DATA__ 中运行,而且使用四种不同 User-Agent 时图块数量都没有变化。
进一步抓取需要什么
如果想使用自己的浏览器,在搜索结果中获取描述、链接和互动数据,就需要 Pinterest 认定为真实登录用户的会话。这意味着必须登录并保存 Cookie。自动化个人账户登录违反平台条款该条款禁止“使用自动化方式(未经我们事先明确许可)”访问 Pinterest 数据。
数量是另一个限制,而且该目标关注的是 IP 信誉,而非指纹。使用单个地址发出约 250 次请求时,没有遇到限流或质询,因此上限高于初次尝试时的直觉。但持续从单一地址运行会改变这一点,这是可靠爬虫必须解决的三个问题中的第一个。
可靠爬虫需要什么
获取一屏缩略图只是演示。按计划采集数千条完整 Pin 记录属于基础设施问题。
- IP 多样性。住宅代理会将同一任务分散到大量消费者 IP,而非单个数据中心地址。根据本文的证据,在这三项中,住宅代理最值得付费,而且不只适用于大规模场景。被归类为托管网络的地址会收到缺少 JSON-LD 块的 Pin 页面,因此只能从消费者 IP 进行解析。除此之外,当单一地址持续运行时,轮换也同样重要。
- 指纹和质询处理。像 Browser API 这样的托管浏览器旨在提供一致、真实的指纹。当流水线访问实施质询的网站时,它还能完成普通无头 Chromium 无法处理的验证。Pinterest 公开页面属于较容易的情况:六种客户端身份下均未出现 Bot Manager Cookie、传感器载荷或质询。
- 维护。选择器和访问限制可能随时改变
pinWrapper到gated-pin-rep的变化以及锁定实验都证明了这一点。Scrapling 可以在类名频繁变化时,通过相似度重新定位元素,这有助于解决解析器部分的问题。
你可以自行构建所有这些能力,而且防止爬虫被封锁的通用方法在这里也同样适用。
代价是,这会变成持续的工程工作,而非一次编写后永久运行的脚本。当维护成本超过拥有这套流水线的价值时,可以将任务迁移到托管爬虫 API。
使用 Bright Data 爬虫 API 爬虫 Pinterest
Bright Data Pinterest 爬虫 API将浏览器、代理和解锁层交由托管服务处理。你只需发送 Pin URL、关键词或个人资料 URL,它就会返回结构化记录。它属于网页爬虫工具 API每月提供免费额度,之后按成功交付的记录量计费。本指南中的每个爬虫 API 示例都在免费额度内运行。
这里应使用 Pinterest 爬虫工具,而非通用解锁工具:前者返回解析后的记录,而不是原始 HTML。通用访问模式是另一种路线,可用于跨网站的任意 URL。具体可用模式因账户而异,也会因区域而异;区域是你为每个产品创建的命名配置。
Bright Data 会在这一层应用本指南前文所述的 robots 允许列表。其中一种模式正是基于该规则,直接拒绝了 Pinterest 请求。
设置分为两步。创建 Bright Data 账户无需银行卡,然后你可以在账户设置中自行创建 API 密钥。新账户最初没有密钥,因此 API 密钥表为空:
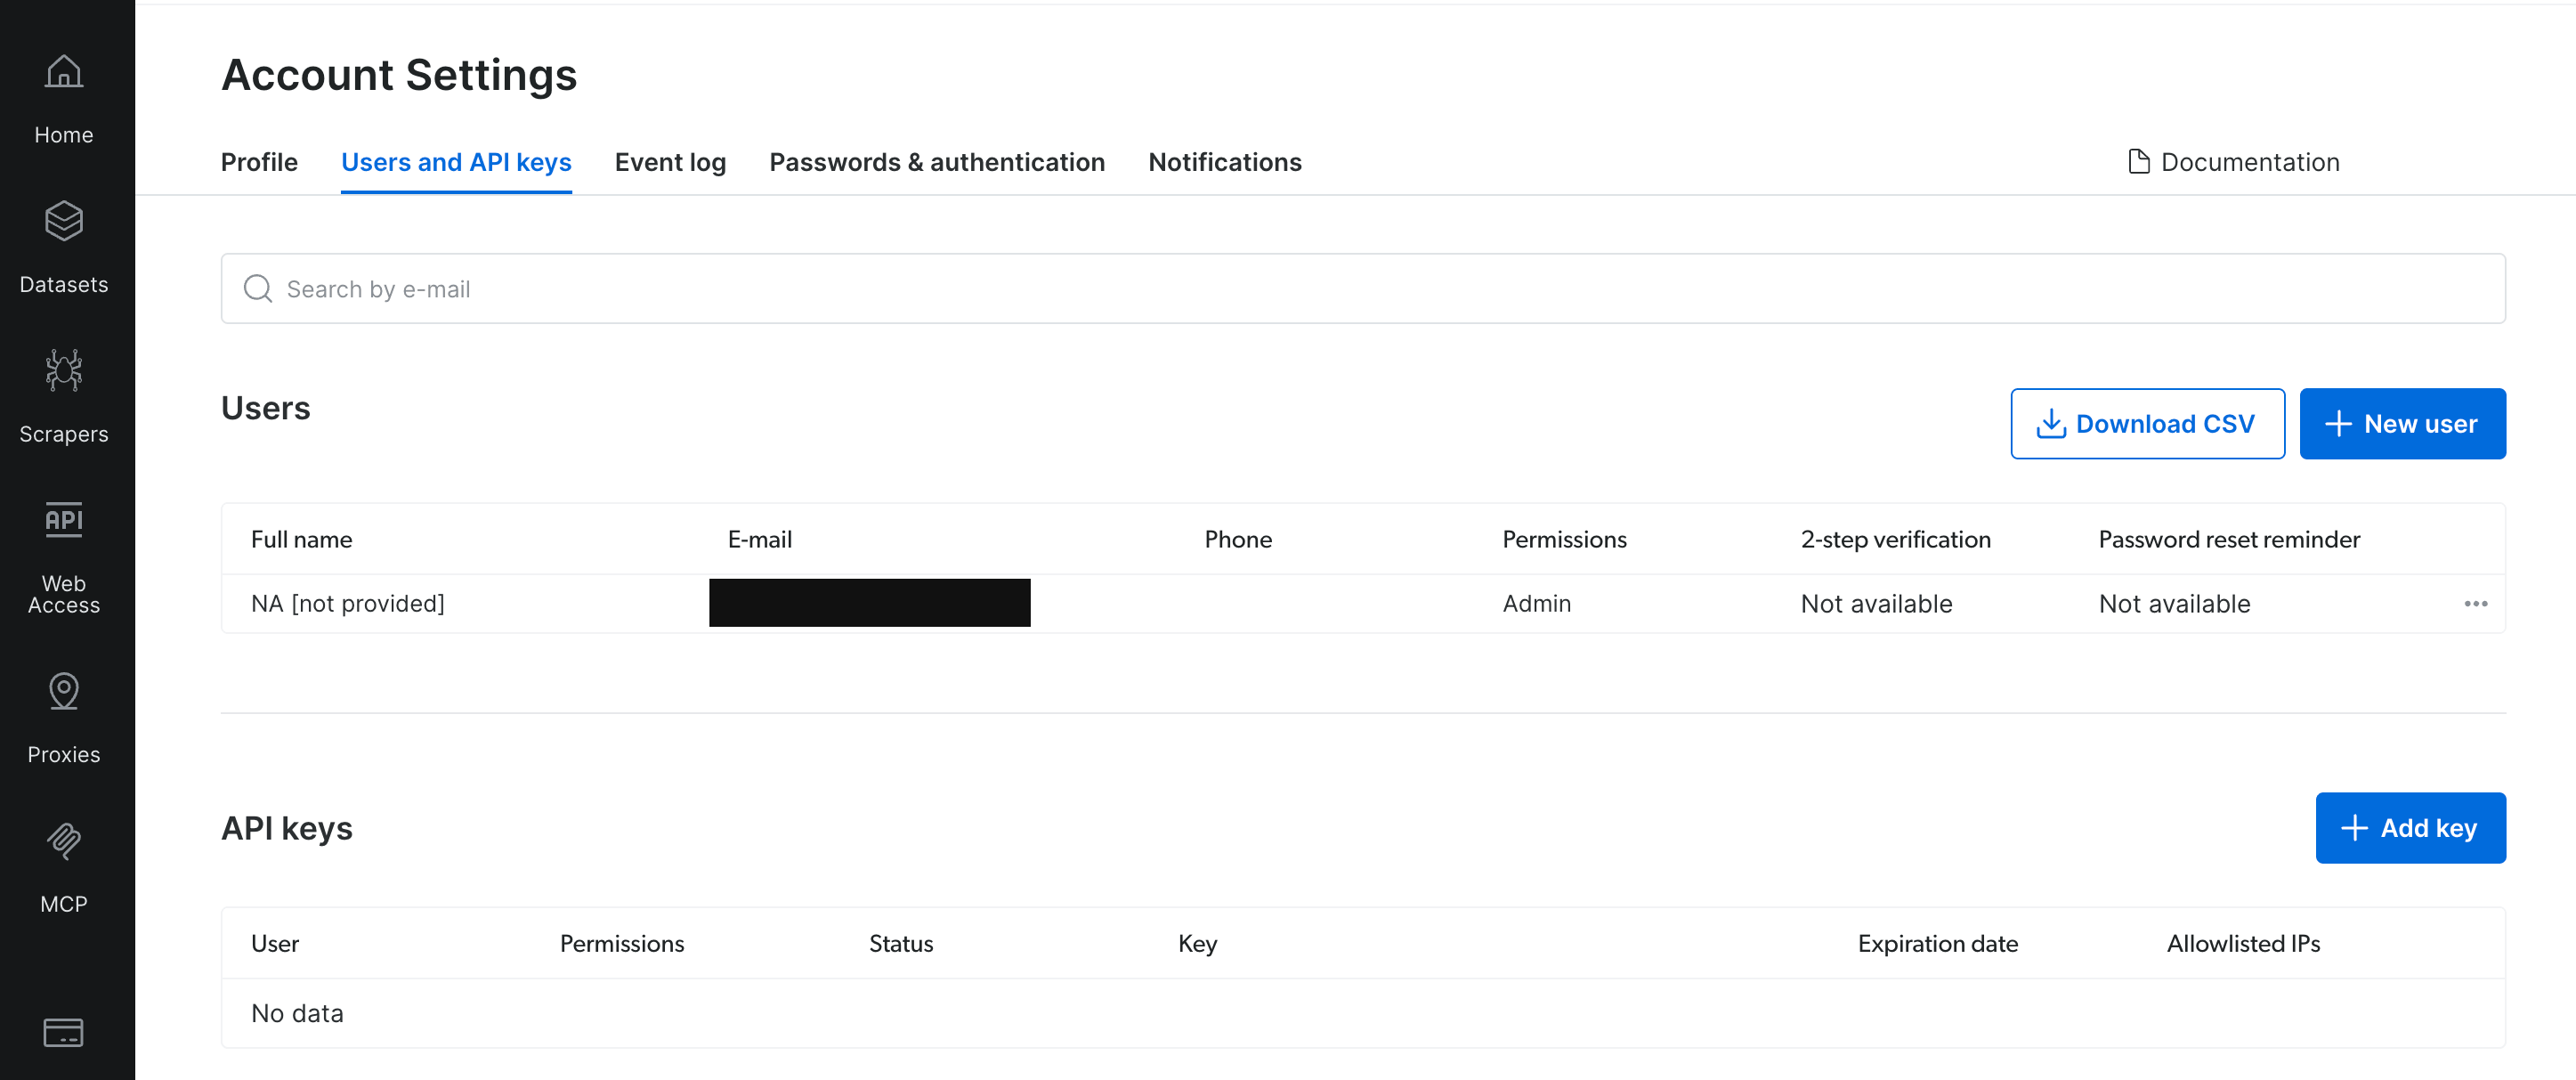
添加密钥时,对话框会要求选择用户、权限级别和到期日期。
请选择用于 API 访问的权限级别,而非账单或管理权限。Bright Data 身份验证文档将其描述为“允许在代理/API 层使用 API”的权限。到期日期应晚于项目结束日期,以免密钥在运行期间失效。
示例使用 requests 软件包,与前面处理画板 Feed 时使用的相同:
pip install requests这一个软件包就是完整依赖列表。所有采集模式共用此设置,控制台会将它们列在一起,方便你在编写代码前了解各自用途:
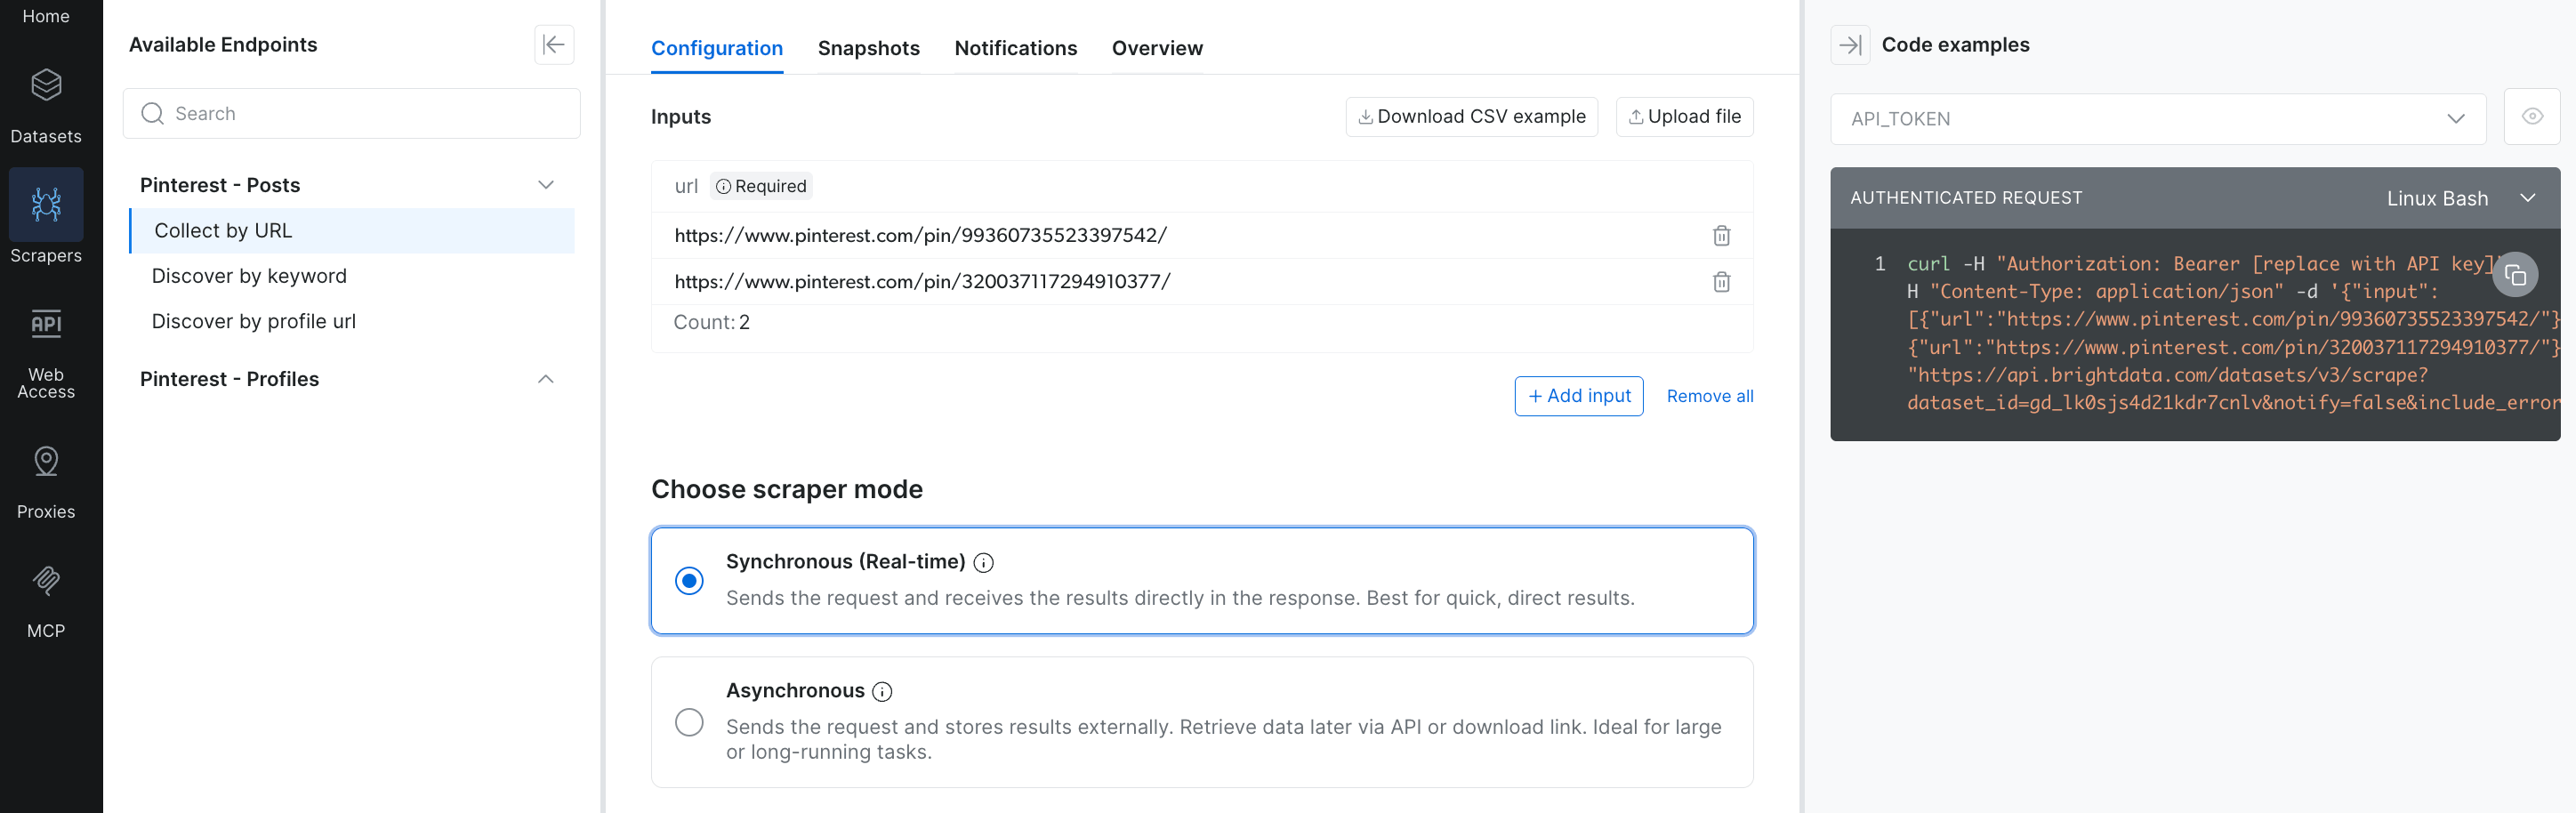
面板列出了该爬虫工具的端点。本文使用的三种模式分别是按 URL 采集、按关键词发现,以及按个人资料发现。
按 URL 采集 Pin
发送一个或多个 Pin URL,然后从响应中读取记录。include_errors=true 标记会让 API 报告失败输入,而不是直接移除它们。你需要自行筛选错误,但相应地可以看到每个输入的处理结果:
import requests

API_KEY = "YOUR_API_KEY"  # create this in your Bright Data account settings
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true"},
    json={"input": [
        {"url": "https://www.pinterest.com/pin/99360735523397542/"},
        {"url": "https://www.pinterest.com/pin/3166662230556591/"},
    ]},
    timeout=60,
)

# an HTTP error raises here, so resp holds records
resp.raise_for_status()
for line in resp.text.strip().splitlines():
    print(line)
响应采用换行分隔 JSON 格式,每个输入对应一个对象。有效 URL 返回了约 20 个字段的记录,下面仅保留相关字段。已删除的 Pin 则返回错误:
{"url": "https://www.pinterest.com/pin/99360735523397542/", "post_id":
"99360735523397542", "title": "12 Bombshell Hair Color Ideas To Try This
Summer | Ecemella", "content": "Copper Red",
"date_posted": "2023-05-24T22:32:51.000Z", "user_name": "ecemella",
"user_url": "https://www.pinterest.com/ecemella", "likes": 2,
"categories": ["Beauty", "Hair"], "hashtags": ["Casual Fall Outfit
Inspiration", "Fall Fashion Outfit Ideas"], "image_video_url":
"https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
"video_length": 0, "post_type": "image", "comments_num": 0}
{"input": {"url": "https://www.pinterest.com/pin/3166662230556591/"},
"error": "Bad input. Page does not exist.", "error_code": "dead_page"}
该记录的标题、日期和图片与 JSON-LD 解析结果一致,并且一次调用即可额外提供发布者用户名、类别和话题标签。收藏次数和出站来源链接仍来自 Pin 页面的 JSON-LD。
失败 URL 对应一个真实但已被 Pinterest 删除的 Pin ID。API 会为它返回 dead_page 错误,而不是崩溃,因此你可以记录错误并继续运行。Bright Data 爬虫 API 按成功交付的记录计费,据此判断,无效 Pin 不应增加费用。
Pin 经常被删除,因此任何批处理都应考虑该错误。请通过每个对象自身的 url 或 input 字段将响应与输入匹配,而不是依赖位置。连续运行三次相同请求时,错误行有两次首先到达,一次排在第二位。
scrape 端点通常会以内联方式响应。如果任务需要更长时间,它会返回 snapshot_id 和仍在进行中的消息,记录则保存在该 ID 下。无论请求哪种模式,在把响应解析为记录前,都应检查是否存在 snapshot_id。
按关键词发现 Pin
发现模式用于关键词搜索,也就是因登录限制而无法通过普通 HTTP 使用的区域。当你有主题而没有 URL 列表时,应使用这种模式。添加 type=discover_new 和 discover_by=keyword并使用 limit_per_input 限制每个关键词的数量:
import requests

API_KEY = "YOUR_API_KEY"
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "keyword"},
    json={"input": [{"keyword": "minimalist office"},
                    {"keyword": "fall fashion"}],
          "limit_per_input": 4},
    timeout=180,
)
# an HTTP error raises here, so resp holds records
resp.raise_for_status()
print(resp.text)
每个关键词最多返回你设置的记录数。每条记录会增加一个 discovery_input 字段,用于标识发现该 Pin 的关键词。如果 Pin 有描述content 字段会包含完整文本。下面是 minimalist office 运行中的一条记录,其中描述已缩短:
{"url": "https://www.pinterest.com/pin/320037117294910377", "title":
"Minimal Cream Office With Ultrawide Monitor, Wood Desk and Natural Window
Light", "content": "A pale wood desk sits beside a bright window with an
ultrawide monitor... #MinimalCreamOffice #PaleWoodWorkspace",
"user_name": "theSetupDistrict", "categories": ["Home Decor"],
"date_posted": "2026-08-25T15:59:51.000Z",
"discovery_input": {"keyword": "minimalist office"}}
因此,仅凭关键词即可获取结构化 Pin 记录。大部分记录都包含描述和类别,而退出登录后的搜索网格不会显示这些信息。
使用异步 API 爬虫整个个人资料
抓取个人资料中的每个 Pin 会产生过多数据,无法放入单个响应,因此 API 会将其作为后台任务运行。你启动任务、接收 ID,并在任务完成后采集记录。在控制台中切换模式时,可以直接看到请求发生的变化:
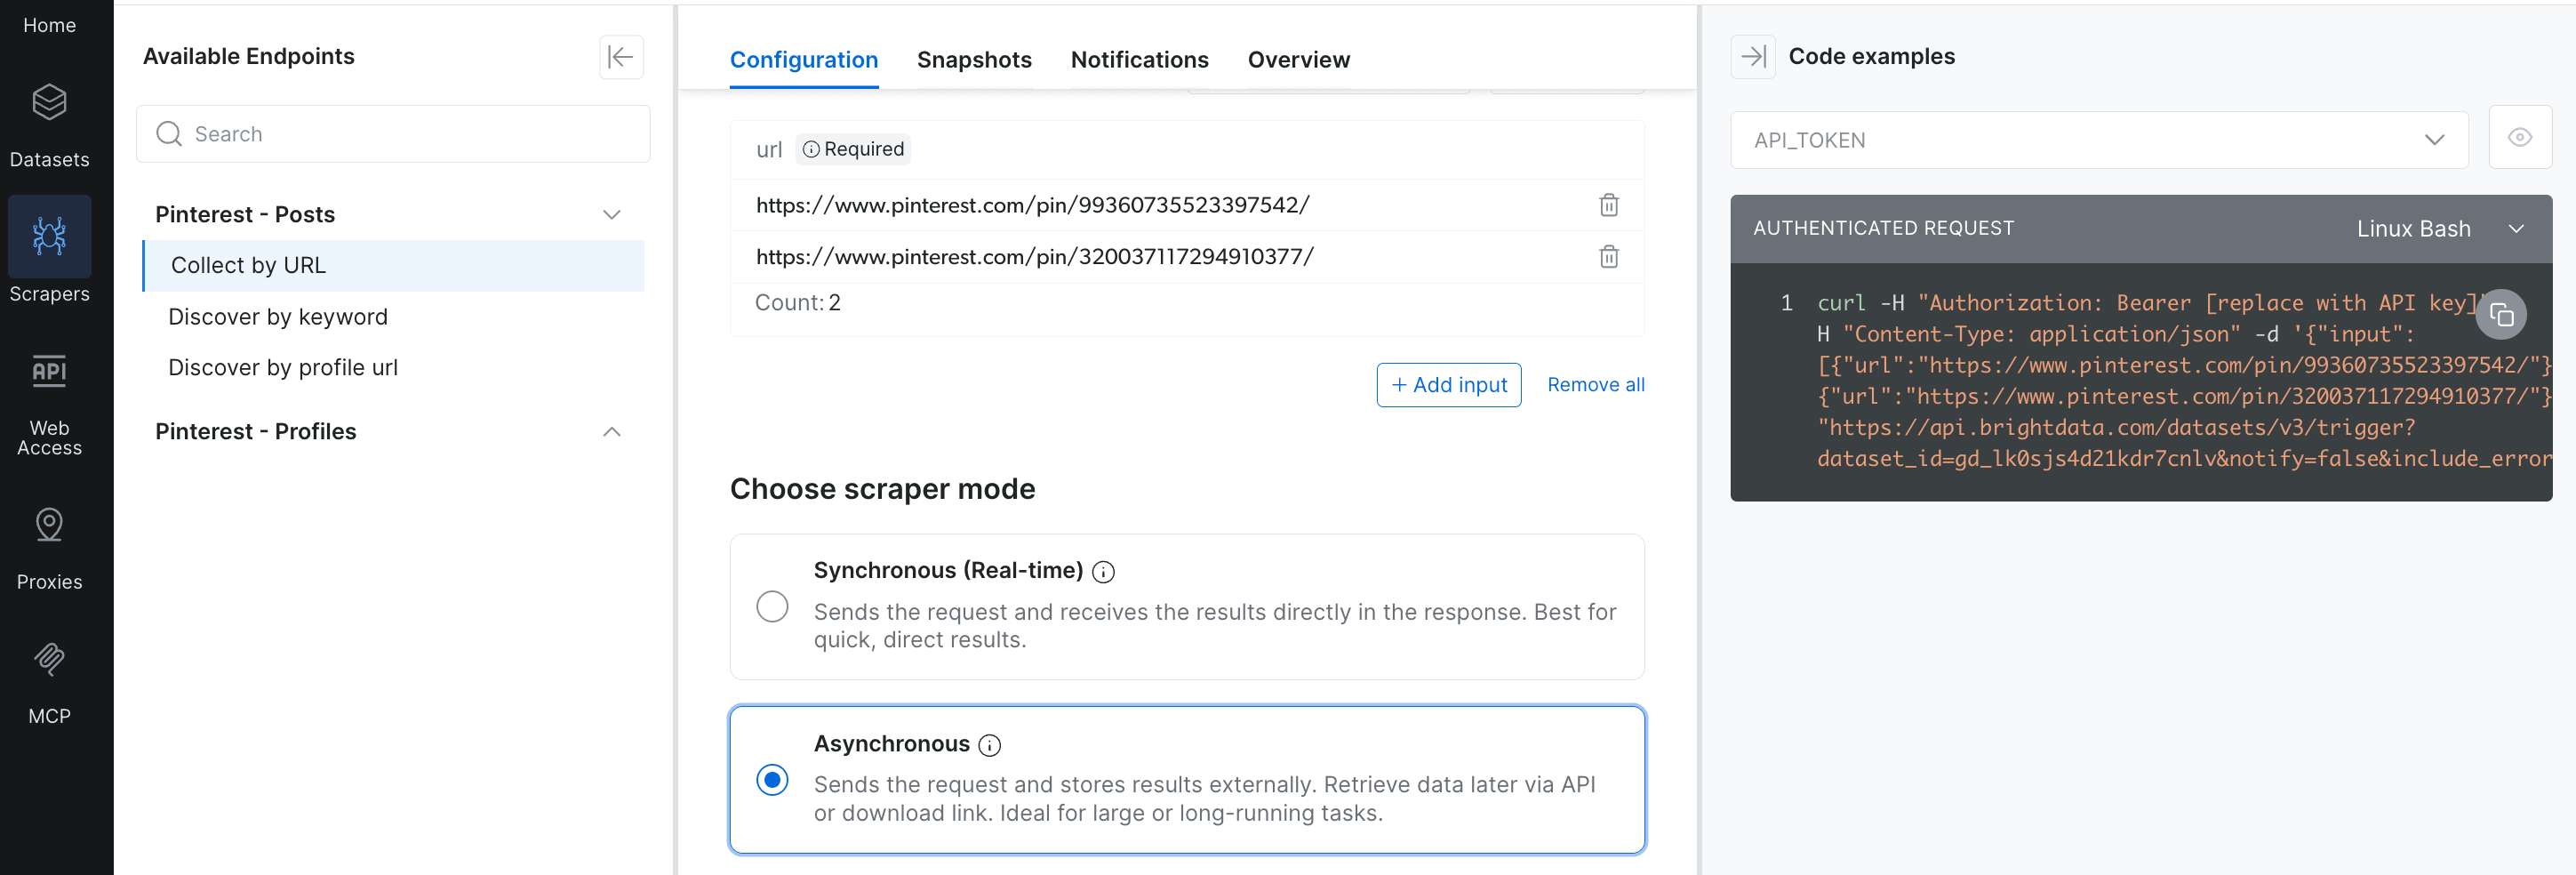
选择异步模式后,路径会自动重写:scrape 端点变成 trigger。随后,运行会返回一个用于轮询的 snapshot_id而不是一直保持连接。
使用 trigger 端点,它会立即返回 snapshot_id:
import requests

API_KEY = "YOUR_API_KEY"
# copy the current dataset ID from the scraper's page
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}

start = requests.post(
    "https://api.brightdata.com/datasets/v3/trigger",
    headers=HEADERS,
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "profile_url"},
    json={"input": [{"url": "https://www.pinterest.com/boredpanda/",
                     "start_date": "", "end_date": ""}],
          "limit_per_input": 4},
    timeout=60,
)
# an HTTP error raises here, so start.json() holds a real snapshot_id
start.raise_for_status()
snapshot_id = start.json()["snapshot_id"]
print("snapshot:", snapshot_id)
空的 start_date 和 end_date 是可选项,留空表示不使用日期筛选进行采集。然后轮询进度端点,直到任务准备完毕,再下载快照。进度响应会报告记录数量和错误代码,因此你可以在下载前知道将获得什么:
import requests, time

API_KEY = "YOUR_API_KEY"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}
# printed by the trigger block; keep it to re-download a crashed run
snapshot_id = "sd_..."

progress_url = f"https://api.brightdata.com/datasets/v3/progress/{snapshot_id}"
while True:
    poll = requests.get(progress_url, headers=HEADERS, timeout=30)
    # an HTTP error raises here, so poll.json() is a real progress object
    poll.raise_for_status()
    progress = poll.json()
    if progress["status"] in ("ready", "failed"):
        break
    time.sleep(10)

# records and error_codes say what the run produced; status only says it stopped
codes = progress.get("error_codes") or {}
if progress["status"] == "failed" or not progress.get("records"):
    raise RuntimeError(
        f"{snapshot_id} finished with no records to download: "
        f"{progress['status']}, {codes}")

data = requests.get(
    f"https://api.brightdata.com/datasets/v3/snapshot/{snapshot_id}",
    headers=HEADERS, params={"format": "json"}, timeout=120,
).json()

# include_errors=true reports failed inputs as rows, so filter before counting
records = [row for row in data if not row.get("error_code")]
if codes:
    print(f"skipped {sum(codes.values())} failed inputs: {codes}")
print(f"downloaded {len(records)} records")
该循环处理了运行机制,但还需要谨慎解读响应对本次运行的说明。
下载前先读取进度响应
进度响应除 status 外,还包含 errors 和 error_codes三者都很重要。仅有 ready 只代表任务已经停止,并不意味着每个输入都成功。一次运行可能以 ready 完成,但同时具有 records: 0 和非零的 errors 数量。
只检查 status 的循环会输出 downloaded 0 records并假装任务成功完成。默认情况下,应在零记录运行时抛出异常。但不应仅因存在错误就抛出异常:如果抓取跳过几个已删除的 Pin,同时仍返回有效记录,这正是预期行为。
下载过程也需要同样谨慎,因为 include_errors=true 会把失败输入作为行与真实记录一起写入快照。因此,原始行数可能高于最终保留的记录数。报告一条记录的运行可能返回三行:两个没有 url 的 dead_page 条目,以及一个完整 Pin。计数或存储前,应按 error_code 进行筛选。
在 boredpanda 上运行个人资料任务时,大约 21 秒后返回限制所允许的 4 条记录,每条都带有对应的 discovery_input。个人资料爬虫在设计上采用异步方式,即使调用同步 scrape 端点也是如此。
关键词或个人资料爬虫也会在进度 error_codes 中将失效 Pin 报告为 dead_page 条目。如果返回的有效记录少于你设置的上限,通常是因为发现了已删除的 Pin,而不是代码存在错误。
检查运行并采集个人资料记录
每次运行都会记录在控制台中,因此无需自行构建运行历史:
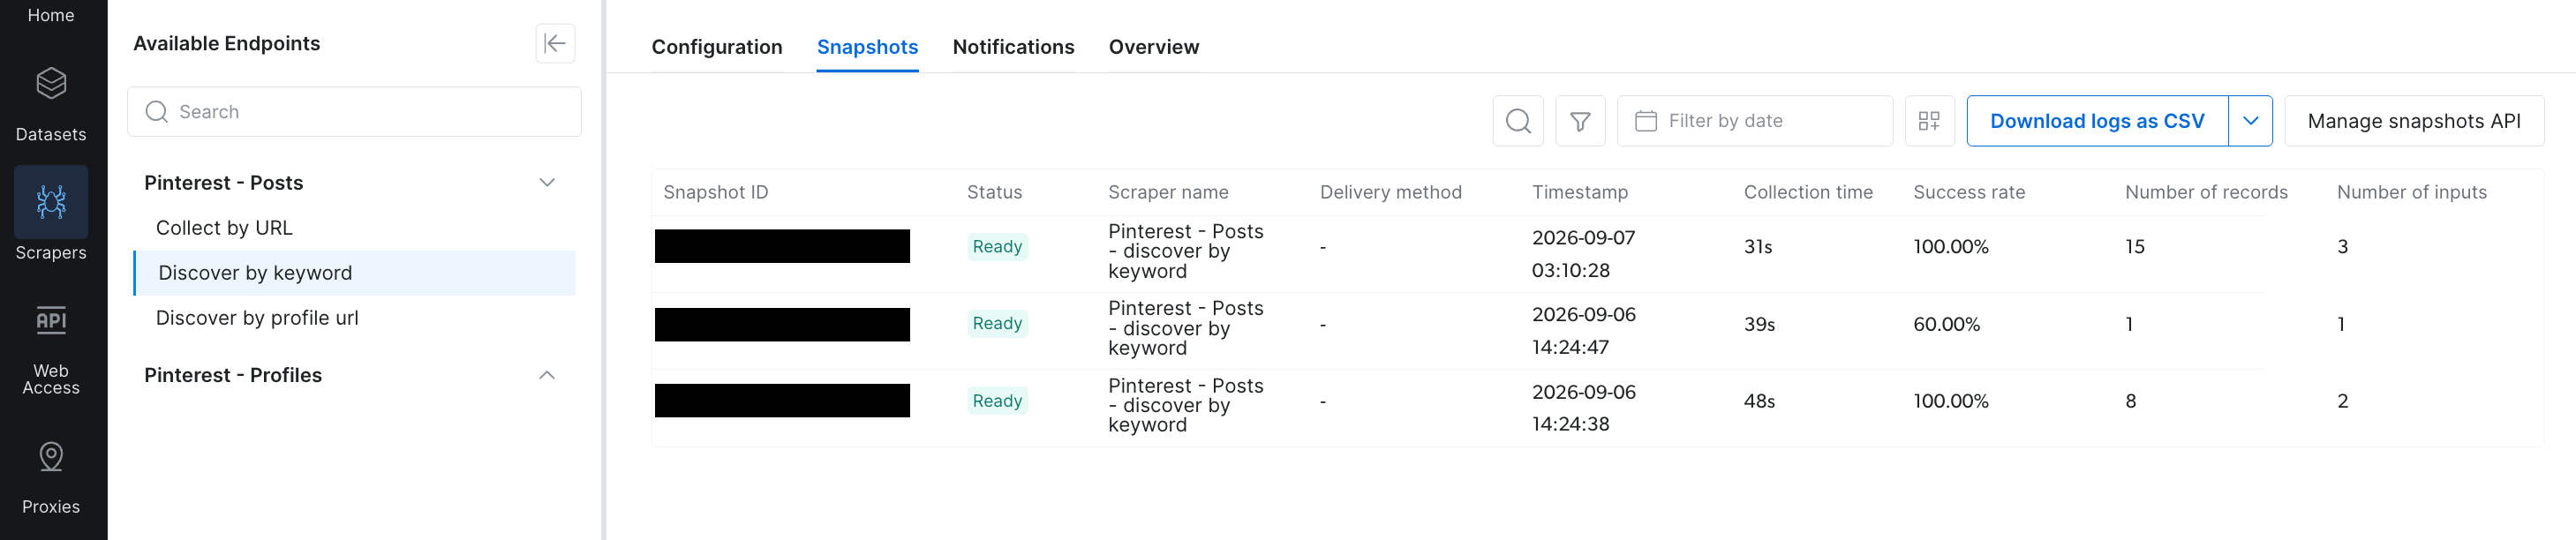
即使你没有记录某次运行的 ID,仍可在此处重新下载。这里两次运行无错误,成功率为 100%;第三次为 60%,错误列中记录了两个已删除的 Pin。
中间那次运行只返回一条记录,因为它找到的另外两个 Pin 已被删除。控制台会在本截图未显示的错误列中将其记录为 dead_page: 2。在把少量记录视为请求故障前,请检查你自己运行中的该列。成功率是控制台根据爬虫访问页面计算出的数据,因此应结合记录数和错误数一起查看。
另一个抓取工具可以返回个人资料记录本身,同时提供个人资料爬虫采集的 Pin。将数据集 ID 切换为 Pinterest 个人资料爬虫工具页面上的 ID,然后发布个人资料 URL,不带 discover_by。对于同一账户,测试时它返回了约 300 万的 follower_count 和 51 的 boards_num。它还返回一个包含画板及其 Pin 数量的 saved 数组,覆盖 51 个画板中的 10 个。
该抓取工具会返回 snapshot_id而不是内联记录,因此应使用相同方式轮询。测试中,它耗时略低于四分钟,而 Pin 爬虫约为 20 秒,因此轮询间隔应按分钟设置。
记录包含哪些内容
测试的全部 30 条记录都包含十个字段:url、post_id、date_posted、user_name、user_url、post_type、image_video_url、video_length、likes 和 comments_num。这些字段是当时的稳定核心。另有四个字段较常见,但并非必定存在:title 出现在 30 条中的 27 条categories 出现在 24 条content 出现在 22 条hashtags 出现在 16 条。读取第二组字段时应使用 .get()而不是直接索引。
收藏次数是大多数 Pinterest 分析最需要的互动数据,可以通过 post_id 对两个来源进行连接来获取。API 负责发现和提供结构化记录;Pin 页面的 JSON-LD 提供收藏次数,在检查的 6 个 Pin 中,有 5 个成功返回该数据。
在基于这些数据构建指标前,应先查看实际数值。分别从三个账户抽取八个最近 Pin 后,收藏次数中位数为 1、1 和 2,但个别 Pin 可达到数百次。因此,计数器针对的是每个 Pin,而非每张图片。在同样 6 个 Pin 中likes 有 5 个返回 0,这与 Pinterest 多年前移除公开点赞指标的情况一致。
在相同的 6 个 Pin 中,两个来源的标题每次都一致,日期则有 3 次一致。发布者姓名通常也一致,但这个字段并不可靠。本指南一直使用的 Pin 就是一个反例:它的 oEmbed 响应与 API 记录显示的是不同的人。
API 记录显示的是 Pin 所链接网站背后的账户,而 JSON-LD 和 oEmbed 显示的是收藏该 Pin 的个人。当 Pin 被另一个账户重新收藏时,两个来源可能显示不同的人。因此,应通过 Pin URL 或 post_id 连接两个数据集,绝不能通过发布者连接。
当日期不一致时,API 的 date_posted 通常接近 Pin 出现在 Feed 中的日期。JSON-LD 的 datePublished 则更早,某个案例甚至早了数年。在混合两者前,请先确定分析所需的日期定义。
应该使用哪种 Pinterest 爬虫方法?
选择取决于你的起点,以及需要多完整的记录:
| 因素 | 普通 HTTP(JSON-LD、oEmbed、RSS) | Playwright(自行搭建) | Bright Data 爬虫 API |
|---|---|---|---|
| 设置 | requests 和标准库 |
安装 Playwright 和浏览器 | API 密钥加 requests |
| 返回的数据 | 已知 Pin 的完整记录,以及结构化个人资料记录 | 搜索或个人资料中只有图片 URL | 标题、描述、发布者、话题标签、类别和媒体;收藏次数来自 Pin 页面,并通过 post_id 连接 |
| 发现方式 | 画板 Feed 和 widget 后端,不支持搜索 | 单次搜索中受限制的图块 | 按 URL、关键词或完整个人资料获取 Pin |
| 封锁处理 | 使用你自己的 IP,未发现 TLS 质询 | 由你管理代理和维护 | 托管代理和解锁层 |
| 维护 | Feed 或 JSON-LD 块变化时由你负责 | Pinterest 更改标记或访问限制时由你负责 | 由提供商应对相同的标记和访问限制变化 |
| 成本 | 使用单个 IP 免费;10,000 个 Pin 页面产生 1.24 GB 流量,通过 oEmbed 则少得多 | 免费,但 10,000 个 Pin 会产生 43.5 GB 代理流量 | 每月提供免费额度,之后按成功交付的记录计费 |
纯 HTTP 能获取的内容比大多数指南所说的更多。它可以返回你指定的任何有效 Pin 图、结构化的个人资料记录,以及账号所展示的每个图板中的近期 Pin 图。对一个账号下的所有图板同时运行这两种免费方法,共返回了 435 个不重复的 Pin 图。
限制在于可获取的数据量,而且实际范围比看起来更窄。这 435 个 Pin 图来自 9 个图板,而这些图板总共包含超过 9,000 个 Pin 图,获取比例不到 5%。没有任何免费方法能获取关键词搜索结果,而 Playwright 只能额外获取受限的缩略图。爬虫 API 适用于关键词发现、完整个人资料爬虫和定期数据采集。
获取 10,000 个 Pin 图时每种方法的成本
费用取决于有效载荷大小,按实际传输的字节数计量。下表假设客户端会协商启用压缩。一个解压后约为 1.13 MB 的 Pin 图页面,使用 Brotli 时传输量约为 124 KB,使用 requests 发送的 gzip 请求头时则约为 183 KB。如果改为运行标准库示例,Pin 图页面 HTML 行中的每个数值都将增加到大约 9 倍。
这里测量的是字节数,而不是费率。表中的所有金额均由两个费率决定。两者均为 Bright Data 在 2026 年 9 月公布的标价,因此带宽行和记录行采用相同的价格基准:
- 住宅代理带宽,8 美元/GB。这是代理网络定价页面上的按量付费标价;在已公布的最大用量承诺套餐中,该价格会降低。
- 爬虫 API,每交付 1,000 条记录 1.50 美元。这是网页爬虫工具 API 定价页面上的按量付费标价;在已公布的更高级套餐中,该价格会随用量增加而降低。同一页面还列出了每月免费额度;表中则对每条记录都按标价计算。
这两个页面也会展示促销优惠,而且即使本文不变,价格也可能发生变化。估算成本前,请先查看这两个页面上的当前费率。将你获得的报价代入最后一列的乘法计算即可。
| 方法 | 计量依据 | 每个 Pin 图传输的字节数 | 10,000 个 Pin 图对应的用量 | 按上述费率计算的成本 |
|---|---|---|---|---|
| RSS Feed,按列出的每个 Pin 图计算 | 带宽 | 147 B | 0.0015 GB | × 8 美元/GB = 0.01 美元 |
| oEmbed JSON | 带宽 | 583 B | 0.006 GB | × 8 美元/GB = 0.05 美元 |
| Pin 图页面 HTML | 带宽 | 124 KB | 1.24 GB | × 8 美元/GB = 9.92 美元 |
| 爬虫 API | 已交付记录 | 不受页面大小影响 | 10,000 条记录 | × 1.50 美元/1,000 条 = 15.00 美元 |
| 通过 Playwright 加载 Pin 图页面 | 带宽 | 4.35 MB | 43.5 GB | × 8 美元/GB = 348.00 美元 |
各行在请求失败时产生的成本不同。已删除的 Pin 图仍会返回包含完整页面的 HTTP 200 响应,因此按带宽计费的方法仍需为这些字节付费。记录行则按成功交付的记录计费。
金额无法体现的成本
在无头 Chromium 中加载同一个 Pin 图,会通过大约 180 个响应下载 4.35 MB 数据。这大约是使用普通请求获取同一条记录时传输量的 35 倍。
其中约 3.1 MB 是 JavaScript,因此常见的节省流量方法几乎不起作用。阻止图片、字体和样式表后,传输量只能降至 3.8 MB,无法进一步降低,因为页面仍需要脚本才能渲染。
时间是另一项成本。在一台机器上进行两轮测试,每轮发送 15 个请求,获取 Pin 图页面的中位耗时为 0.8 至 1.0 秒。完整运行所需的时间会比这个中位数所暗示的更长。
以半秒延迟对包含 25 个 Pin 图的 Feed 执行三轮处理,速度为每分钟 21 至 33 个 Pin 图。如果逐个运行,处理 10,000 个 Pin 图需要 5 至 8 小时。并行运行可以缩短时间,但也会让同一地址在同一时间承受更高的请求频率。
这些成本数字实际比较的是什么
oEmbed 传输 583 字节,而 Pin 图页面会传输 124 KB。仅为读取一个作者姓名而获取整个页面是一种浪费。
托管 API 带来两项价值:更大的数据覆盖范围,以及由其他人负责维护。它能够获取普通 HTTP 无法覆盖的页面类型,包括关键词搜索和完整个人资料爬虫。节省之处来自这些能力,而不是传输的字节数。
按相同基准计算,Pin 图页面行与爬虫 API 行的成本较为接近,相差约 1.5 倍。双方都会推出促销活动,进一步降低价格。哪一种更便宜,取决于本文和你都无法控制的费率。
而与无头浏览器相比,差距则十分明显。按照同一代理定价页面上公布的所有费率,43.5 GB 流量的成本都是获取 10,000 条记录成本的数倍。
这两个数字衡量的并不是同一项内容,因此需要了解各自包含哪些成本。流量一项仅包括带宽,不包含其他费用。它不包括代理套餐的最低消费,也不包括构建和维护数据管道所花费的时间。此外,它还假设你已经拥有 10,000 个 Pin 图 URL,而任何免费方法都无法提供如此大规模的 URL。
记录费用涵盖的范围更广:它包含生成 URL 列表所需的发现过程,而且费率会随用量增加而降低。两种方式都可能有套餐最低消费,因此对于大型任务,你应像核实代理报价一样确认这些要求。
后续步骤
从能满足数据需求的最轻量工具开始。如果你已有 Pin 图 URL,通过普通 HTTP 解析 JSON-LD 即可返回完整记录,而仅使用 oEmbed 就能获得来源信息。如果要跟踪某个创作者或图板,可以将 RSS Feed 接入该解析流程,全程无需加载浏览器。
关键词搜索和完整个人资料爬虫不在这些方法的能力范围内。Pinterest 爬虫 API 可接收关键词或个人资料 URL,并返回结构化记录,同时提供每月免费额度供你测试。
对于计划长期运行的任何任务,请从一开始就设置以下三个默认规则:
- 在每个批次中处理已删除的 Pin 图。这意味着 JSON-LD 解析会返回
None或 API 会返回一条dead_page记录。 - 每次请求之间保持大约半秒的间隔。在完整运行中,这一频率可达到每分钟处理 21 至 33 个 Pin 图;在大约 250 次请求中,没有触发任何频率限制。
- 为异步任务记录
snapshot_id。这样即使任务运行崩溃,也可以重新下载结果。
如果要突破单一地址的限制,可通过住宅代理路由请求,并继续使用已有的解析逻辑。如果你更愿意直接购买数据,而不是自行采集Pinterest 数据集已经构建完成,可直接下载
常见问题
可以爬虫 Pinterest 吗?
可以。通过普通 HTTP 请求,Pin 图 URL 通常会从 JSON-LD 块中返回标题、描述、保存次数、发布者和出站链接,无需浏览器。个人资料和图板 RSS Feed 会列出近期 Pin 图的 URL。关键词搜索是例外,需要使用爬虫 API。
Pinterest 会屏蔽爬虫工具吗?
不会,至少从住宅 IP 地址访问公开 Pin 图页面时不会。使用默认 urllib User-Agent 发送的 12 个请求均返回 HTTP 200,且没有出现 Akamai Bot Manager Cookie。数据中心 IP 是个例外:页面仍会返回 200,但不包含 JSON-LD 块。
为什么我的 Pinterest 爬虫工具无法运行?
记录位于 JSON-LD 块中,而不在 Redux Store 中,因此 initialReduxState.pins 读取到的是空值。在搜索结果网格中,旧的 pinWrapper 选择器无法匹配任何内容,因为未登录状态下的卡片现在使用 gated-pin-rep。已删除的 Pin 图仍会返回 HTTP 200,但完全不包含 JSON-LD 块。
Pinterest 有公共 API 吗?
有,但仅限你自己的账号。Pinterest API v5 可管理你的图板、Pin 图和广告,但无法获取其他用户的公开 Pin 图。试用访问权限设有每日请求上限。唯一的关键词搜索功能仍处于测试阶段,并未向所有应用开放,而且仅限前 10 条结果。
Pinterest 有 RSS Feed 吗?
有。Pinterest 在 /<username>/feed.rss 和 /<username>/<board-slug>.rss 提供无需身份验证的 Feed。在对 12 个账号的测试中,它们分别返回了 22 至 26 个近期条目,其中包含 Pin 图 URL、时间戳和缩略图,但几乎没有标题。Feed 只列出新的 Pin 图,不支持关键词搜索,也不提供历史数据深度。
如何下载 Pinterest 全尺寸图片?
将缩略图 URL 中的尺寸路径段替换为 originals然后依次尝试 .jpg、.png、.webp 和 .gif。继续使用缩略图本身的 .jpg 时,40 个 Pin 图中有 35 个返回 403,因为 Pinterest 会重新编码图片。应按每张图片大约需要发送两次 HEAD 请求进行规划。
如何爬虫 Pinterest 图板?
移除图板 URL 末尾可能存在的斜杠,然后添加 .rss。如果保留末尾斜杠,返回的将是 HTML 页面,而不是 Feed。无论图板有多大,Feed 都会在大约 25 个条目后停止。位于 widgets.pinterest.com/v3/pidgets/ 的小组件后端最多可返回 50 个条目;超过这个数量后,就需要爬虫整个个人资料。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。