大规模爬虫 Walmart 可让定价团队按计划从数千个页面采集购物者看到的价格、库存和评论。
Walmart 的机器人检查只是第一个问题。当我通过动态 IP 获取商品页面时,Walmart 会根据不同门店为每个页面定价。如果你的爬虫工具未设置邮政编码或门店,Walmart 会根据 IP 地址选择门店。这样一来,你的价格表就会混入不同门店的数据,而且不会出现任何错误警告。
本指南将介绍 Walmart 的防御机制和列表限制、如何选择合适的方法,以及如何使用 Python 采集门店级价格。
简要总结
- 门店可能会改变价格。在 8 个邮政编码中,同一加仑牛奶的价格从 $2.42 到 $6.28 不等。
- 为每个请求设置门店确实有效。使用门店 ID 后,Bright Data 的 Walmart 抓取工具 API 返回了与浏览器中显示完全一致的价格,我对比的两家门店都是如此。
- 一个 Walmart 分类列表在接近 390 个独立商品时停止显示。它声称约有 2,450 件商品,但仅显示了 389 件;将其拆分为 9 个价格区间后,找到了 2,069 件商品。
- 状态码 200 并不代表成功。Walmart 会以 HTTP 200 返回“Robot or human?”挑战页面,因此请检查每条记录的内容和门店 ID。
Walmart 如何检测爬虫
Walmart 的商品页面受到 Akamai、HUMAN 和 F5 Web 应用防火墙(WAF)的保护。单个商品页面响应中的标头、Cookie 和运行时配置显示,这 3 层防护均已启用:
| 防护层 | 我的识别依据 | 脚本收到的内容 |
|---|---|---|
| Akamai 边缘服务 | x-ak-protocol 和 server-timing: ak_p 标头、akavpau_p2 Cookie,以及浏览器会话中的 Bot Manager Cookie ak_bmsc 和 bm_sv |
未携带 Walmart 客户端标头的 GraphQL 调用收到 418 Access Denied |
| HUMAN(原名 PerimeterX) | 位于 /px/PXu6b0qd2S/init.js 的第一方传感器,以及 _pxhd、_px3 和 _pxvid Cookie |
通过 307 重定向到 /blocked随后显示状态码为 200、需要长按操作的“Robot or human?”页面 |
| F5 WAF | 浏览器会话中有 6 个以 TS 为前缀的 Cookie,例如 TS012768cf |
未发现可追溯至它的拦截响应 |
我使用 Playwright 启动普通无头 Chrome,两次尝试都触发了 HUMAN 的长按式 CAPTCHA。挑战页面看起来与普通 Walmart 页面无异,并返回状态码 200:
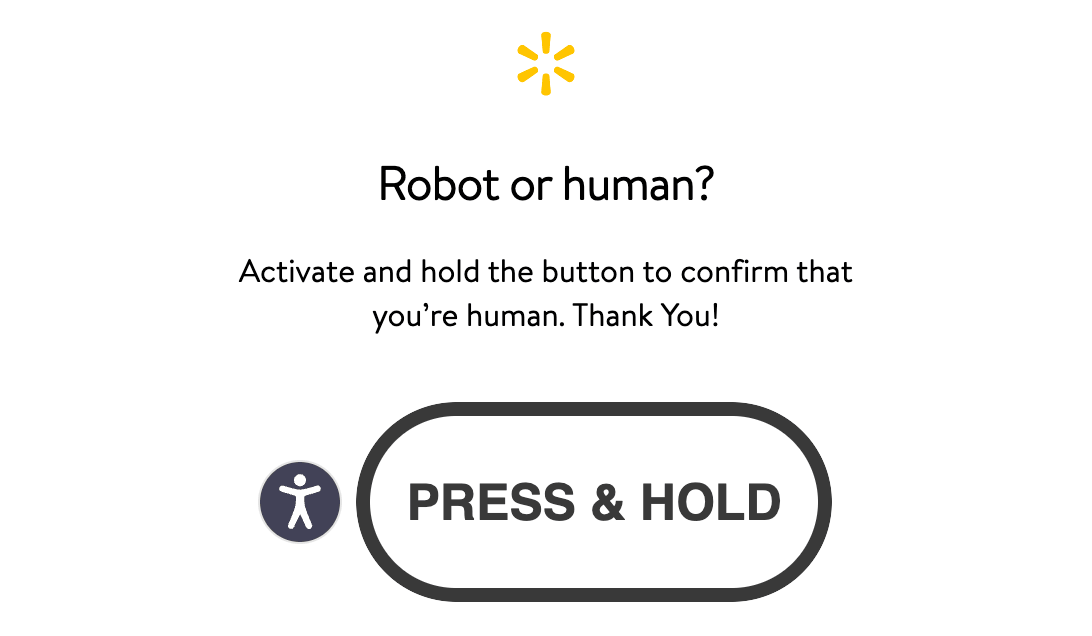
如果爬虫只检查状态码,就会将此页面保存为成功结果。
同一运行时配置还启用了 ThreatMetrix,这是一项设备画像服务,但仅用于购物车、订单、钱包和订阅等账户页面。该列表不包括价格跟踪所需的商品、分类或评论页面。
Walmart 自己的机器人标记无法说明请求是否通过。每个商品页面都嵌入了一个 psych 对象,其中包含 isAkamaiBot 等字段。即使 Walmart 完整返回了页面,该字段仍为 "1"因此应根据响应内容及其门店 ID 判断请求结果。
哪些 HTTP 客户端会触发挑战
在同一 IP 下,Walmart 是否显示挑战页面取决于 HTTP 客户端。我从一个非美国的家庭宽带 IP,使用 6 个 HTTP 客户端请求相同的 5 个 Walmart 商品 URL,每轮请求 1 个 URL。每轮中,各客户端依次请求该 URL,间隔 2 秒,并各自维护独立的 Cookie jar。
在这 5 个 URL 中,有 3 个已经失效,但它们仍能提供清晰的判断信号。通过验证的客户端会收到 Walmart 的 404 页面,而触发挑战的客户端则会收到挑战页面:
| 客户端 | 5 次请求中出现挑战页面的次数 |
|---|---|
| 使用 LibreSSL 的 curl | 4 |
Python requests |
2 |
使用 HTTP/2 的 httpx |
1 |
模拟 Firefox 的 curl_cffi |
2 |
模拟 Chrome 的 curl_cffi |
0 |
模拟 Safari 的 curl_cffi |
0 |
在使用有效商品 URL 的两轮测试中,curl、requests 和 Firefox 配置触发了挑战。在同一轮测试中,仅相隔数秒,Chrome 和 Safari 配置却成功获取了商品页面。
我们的 curl_cffi 指南介绍了模拟配置,而 TLS 指纹识别文章则说明了握手过程会暴露哪些信息。
通过 Bright Data 住宅代理上的美国会话,同样的 6 个客户端共发出 30 次请求,没有一次收到挑战页面。每个客户端都获得了一个美国住宅 IP。结果取决于客户端与代理的具体组合,因此请按照你计划使用的并发量测试 Walmart。
Walmart 页面将数据保存在何处
Walmart 使用 Next.js pages router 渲染商品、搜索、分类和评论页面。每个页面都会在 __NEXT_DATA__ 脚本标签中以 JSON 形式嵌入其数据模型。在一个糖果商品页面中,这段 JSON 占 592 KB HTML 中的 401 KB。以下 JSON 路径包含重要字段:
- 商品页面:
props.pageProps.initialData.data.product其中包括价格、可用性、卖家和一个location对象 - 搜索和分类页面:
props.pageProps.initialData.searchResult.itemStacks[].items报告的总数位于searchResult.aggregatedCount - 评论页面:
props.pageProps.initialData.data.reviews包含其自身的分页块
该标签带有 nonce 属性,因此应通过 id 匹配,并使用允许存在额外属性的模式。
在浏览器中,Walmart 的 GraphQL API 会提供页面未嵌入的数据,例如页面更下方的商品详情。该 API 使用持久化查询,即预先保存的查询,客户端通过 URL 中的 SHA-256 哈希调用:
/orchestra/pdp/graphql/ItemByIdBtf/<sha256-hash>/ip/<item-id>Walmart 会拦截以脚本方式重放的这些 GraphQL 调用。如果没有 Walmart 的 x-o-* 客户端标头,对 /orchestra/home/graphql 的脚本调用会收到 Akamai 的 418。添加这些标头后,则会收到 HUMAN 返回的 JSON 拦截响应,状态码为 412。
这些标头还包括 Web 应用版本,而该版本会随 Walmart 发布更新而变化,因此旧版开源爬虫中硬编码的值会过时。
下面的脚本通过 Bright Data 的网络解锁器 API获取商品页面,然后读取商品数据以及用于定价的门店。它需要 Python 3.9 或更高版本和 requests并需将你的 API 密钥放入 BRIGHTDATA_API_TOKEN将你的网络解锁器区域名称放入 BRIGHTDATA_UNLOCKER_ZONE:
import json
import os
import re

import requests

API_KEY = os.environ["BRIGHTDATA_API_TOKEN"]
ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]  # your Web Unlocker zone name
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__"[^>]*>(.*?)</script>', re.S)


def fetch(url: str) -> tuple[str, str]:
    """Return the page's status code and HTML."""
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": "us"},
        timeout=180,
    )
    r.raise_for_status()
    # Web Unlocker reports the target page's status code in this header.
    return r.headers.get("x-brd-status-code", ""), r.text


def parse_product(html: str) -> dict:
    if "Robot or human" in html:
        raise RuntimeError("challenge page, not a product page")
    match = NEXT_DATA.search(html)
    if match is None:
        raise RuntimeError("no __NEXT_DATA__ block in the page")
    data = json.loads(match.group(1))["props"]["pageProps"]["initialData"]
    product = data["data"]["product"]
    location = product.get("location") or {}
    price = (product.get("priceInfo") or {}).get("currentPrice") or {}
    return {
        "us_item_id": product.get("usItemId"),
        "name": product.get("name"),
        "price": price.get("price"),
        "availability": product.get("availabilityStatus"),
        "seller": product.get("sellerName"),
        "store_id": (location.get("storeIds") or [None])[0],
        "zip": location.get("postalCode"),
    }


status, html = fetch("https://www.walmart.com/ip/10450114")
if status != "200":
    raise RuntimeError(f"page status {status}, not 200")
print(status, json.dumps(parse_product(html), indent=2))
一次运行返回了一个有效商品,其定价门店并非脚本指定。你运行时很可能会看到另一家门店:
200 {
  "us_item_id": "10450114",
  "name": "Great Value Whole Vitamin D Milk, Gallon",
  "price": 3.32,
  "availability": "IN_STOCK",
  "seller": "Walmart.com",
  "store_id": "3081",
  "zip": "95829"
}正如其错误代码页面所述,网络解锁器 API 会在 x-brd-status-code 标头中报告 Walmart 自己的状态码。脚本会先检查该标头,再解析页面。
请先解析嵌入的 JSON。对于页面未嵌入的数据,应从浏览器会话调用 GraphQL,因为脚本调用会被拦截。
为什么 Walmart 价格取决于门店
Walmart 的联盟营销 API 文档指出,商品的价格和可用性取决于请求中的邮政编码和门店 ID。关于店内价格,Walmart 发言人告诉 CNBC:“在任何一家特定门店中,每个人看到的价格都相同。”每个商品页面都会针对特定门店定价。
页面会在“Pickup from”文本中列出该门店,价格也会因门店而异。同一加仑牛奶在 Walmart 分配的 Sacramento 门店售价为 $3.32,而在我手动选择的 Atlanta 门店售价为 $3.03:
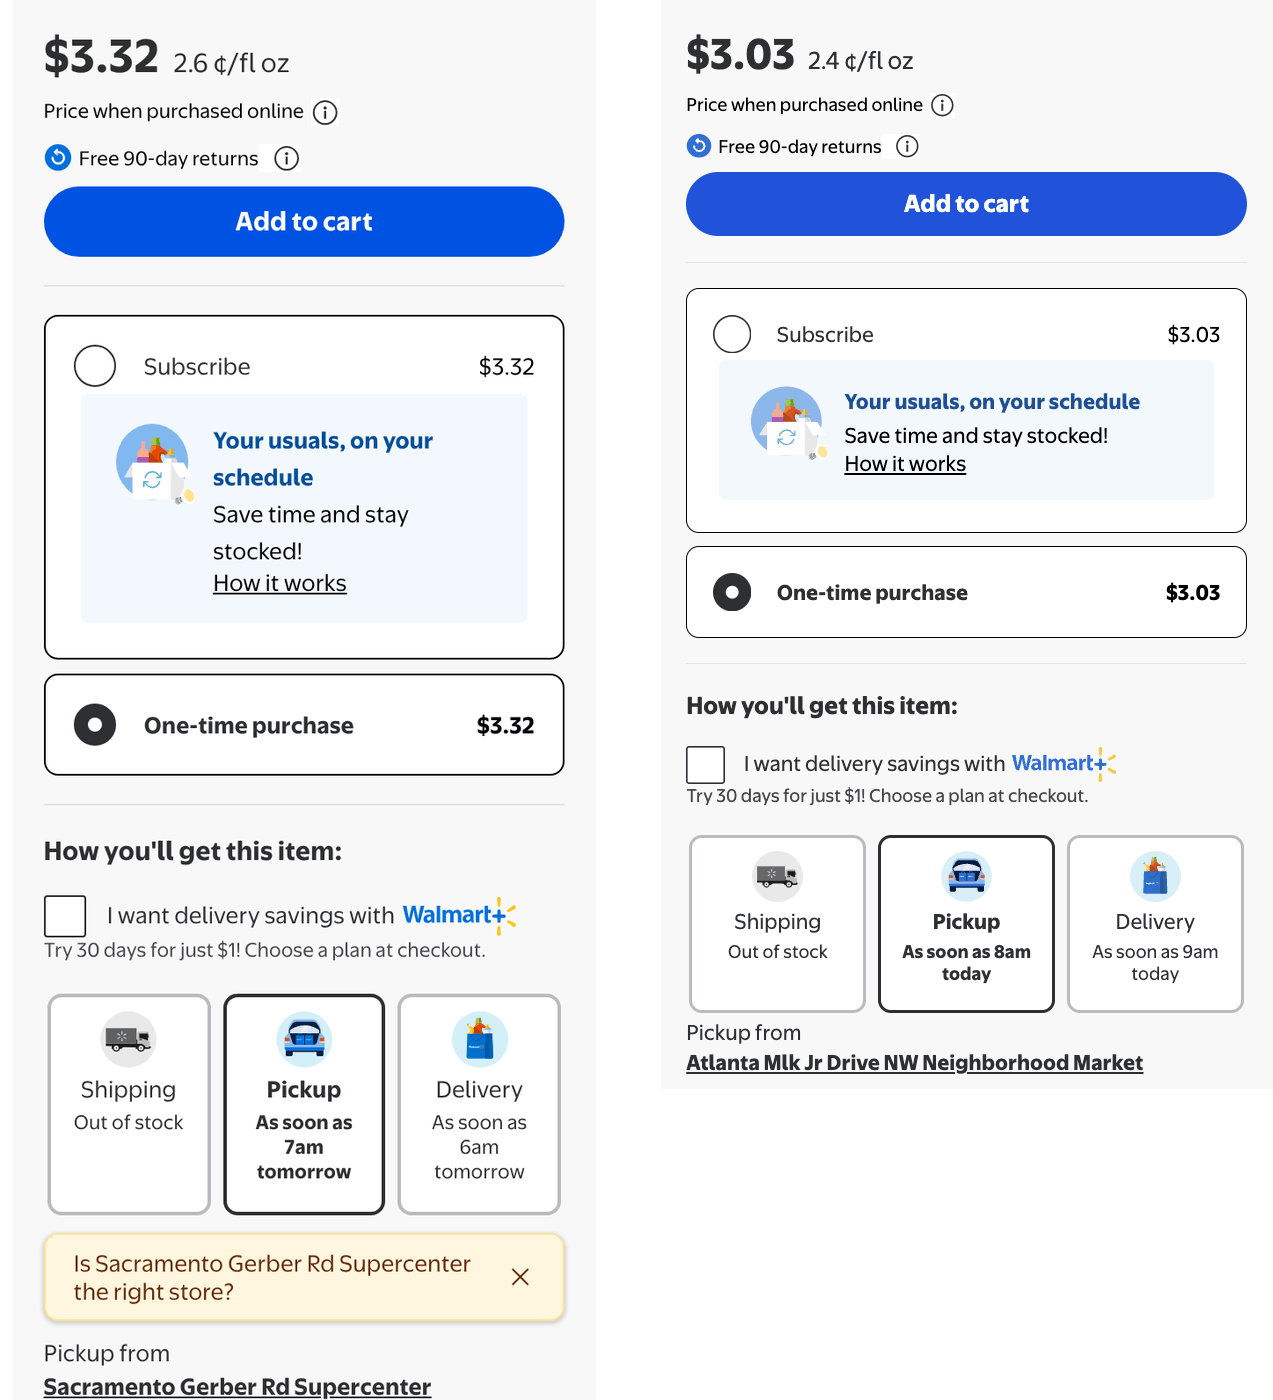
如果每条记录中没有门店信息,同一款牛奶的这两个价格看起来就像发生了价格变动。
当请求不包含位置信息时,Walmart 会选择一家门店,将其记录在页面的 location 对象中,并将该选择标记为 IMPLICIT。某些连接会被分配默认门店,即位于 Sacramento、邮政编码为 95829 的 3081 号门店,这也是脚本输出中的门店。Walmart 根据出口 IP 选择门店,因此动态 IP也会改变门店:
- 动态 IP:48 个商品页面中的每一个都针对不同门店定价。
- 其他连接:一个非美国宽带 IP 和一个卫星网络 IP 都被分配到默认门店。Walmart 还将另一个会话定位到 Utah 州 Big Water,邮政编码 84741,但同样为其分配了默认门店。
为什么通过脚本设置门店并不可靠
我尝试了两种方法,但最终都由 Walmart 决定门店:
- 位置 Cookie:我设置了
assortmentStoreId和一个手动构建的locGuestDataCookie。在携带这些 Cookie 的 9 次请求中,6 次收到挑战页面;而未携带 Cookie 的 3 次请求均未触发挑战。成功通过的 3 次请求仍使用 IP 对应的门店。 - 选择出口 IP:Walmart 使用自己的 IP 地理定位。11 个页面中,只有 5 个页面的定位结果与标准 IP 查询所得的邮政编码一致,因此 IP 的邮政编码无法准确预测门店。
邮政编码或门店 ID 如何设置门店
Bright Data 的 Walmart 抓取工具 API 使用 zipcode 输入为每个请求设置位置。我分别采集了 8 个邮政编码中 4 种杂货商品的数据,同一款 Great Value 全脂牛奶显示出 8 个不同价格:
| 邮政编码 | 记录中的门店 ID | 价格 |
|---|---|---|
| 60614,Chicago,IL | 5402 | $2.42 |
| 75201,Dallas,TX | 5823 | $2.46 |
| 72712,Bentonville,AR | 100 | $2.72 |
| 33177,Miami 地区,FL | 6397 | $2.92 |
| 94103,San Francisco,CA | 2648 | $3.32 |
| 10001,New York,NY | 3520,Secaucus Supercenter,NJ | $4.07 |
| 99504,Anchorage,AK | 4359 | $4.98 |
| 96813,Honolulu,HI | 3478 | $6.28 |
香蕉的价格从 Bentonville 的 $0.13 到 Honolulu 的 $0.42 不等。鸡蛋在全部 8 个邮政编码中的价格均为 $1.67,但其中 3 个地区无法到店取货。请像记录价格一样记录每家门店的可用性。
即使蛋白粉的价格变化小于牛奶,设置门店仍然很重要。我对其中 387 件商品采集了两次数据,第一次未设置邮政编码,第二次使用 Bentonville 的邮政编码。第一次运行的记录来自 170 家不同门店,两次运行之间有 24 件商品的价格发生变化。
邮政编码并不等同于门店。Manhattan 的邮政编码 10001 被解析到 New Jersey 的 Secaucus Supercenter,即 3520 号门店。Walmart 的门店选择器为 Atlanta 的邮政编码 30303 列出了多家门店:
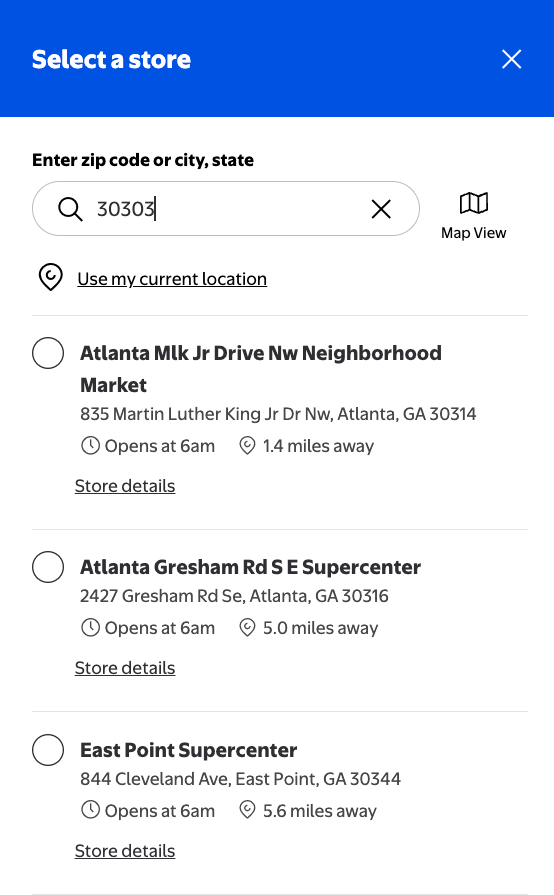
邮政编码 30303 对应列表中的前 3 家门店。邮政编码指向一个区域,而门店 ID 指向一家具体门店。
当你需要指定门店时,Walmart 抓取工具 API 也接受 store_id。walmart.com 上每家门店的页面 URL 都包含其 ID,例如 walmart.com/store/100-bentonville-ar 中的 100。Walmart 的门店站点地图 walmart.com/sitemap_store_main.xml 按门店类型列出了这些 URL,其中包括 3,582 家 Supercenter 和 675 家 Neighborhood Market 的页面。当我设置牛奶截图中的两家门店时,API 返回了与浏览器显示一致的价格:Sacramento 为 $3.32,Atlanta 为 $3.03。
对同一邮政编码重复运行会返回相同价格。在之后 90 分钟内的两次运行中,Chicago 的牛奶价格仍为 $2.42。在 Bentonville,同时运行的两个任务对共同采集的全部 39 件商品返回了相同价格。一天后,邮政编码 72712 仍解析到 100 号门店,该处的牛奶价格仍为 $2.72。
每个价格应记录哪些信息
截图中的两个牛奶价格都带有 Walmart 的“Price when purchased online”标签,因此应将抓取到的价格视为各门店的线上价格。
可用性还取决于履约方式。在牛奶页面上,配送显示缺货,而同一家门店的自提和送货上门则显示有货。Walmart 抓取工具 API 的记录分别提供了自提和送货标记。其中的 Fulfillment_type 字段会指明由谁履约,例如卖家或 Walmart Fulfillment Services。
Walmart 的单位价格也会使用不同单位。同一加仑牛奶在 Miami 的 unit_price 为每液量盎司 0.023,而在 New York 则为每夸脱 1.02。请根据包装规格重新计算单位价格。对于该牛奶,完整记录在 specifications 下将包装规格列为 128 液量盎司。
价格也会随时间变化。Walmart 在单个季度内报告了超过 11,000 次“rollback”,这是其对临时降价的称呼。
应以门店 ID、邮政编码和时间戳作为每个价格的键,并记录每种履约方式的可用性。拒绝任何针对非请求位置定价的记录。
如何应对 Walmart 的列表和评论限制
Walmart 的蛋白粉分类页面报告约有 2,450 件商品maxPage 为 25。第 1 至 10 页每页约有 50 个商品位,其中约 10 个为赞助商品。第 11 页之后不再显示任何商品:
| 分类页面 | 返回的商品位数量 |
|---|---|
| 第 1 至 10 页 | 每页 47 至 50 个 |
| 第 11 页 | 一次运行中为 13 个,另一次为 0 个 |
| 第 12 至 25 页 | 0 |
第 1 至 11 页共有 501 个商品位,其中包含 389 件独立商品。该分页限制来自 Walmart 列表本身,因此在我运行的每个会话中表现都相同。
在桌面浏览器中,页码仍会显示到第 25 页,但第 12 页返回的是 Walmart 的未找到页面:
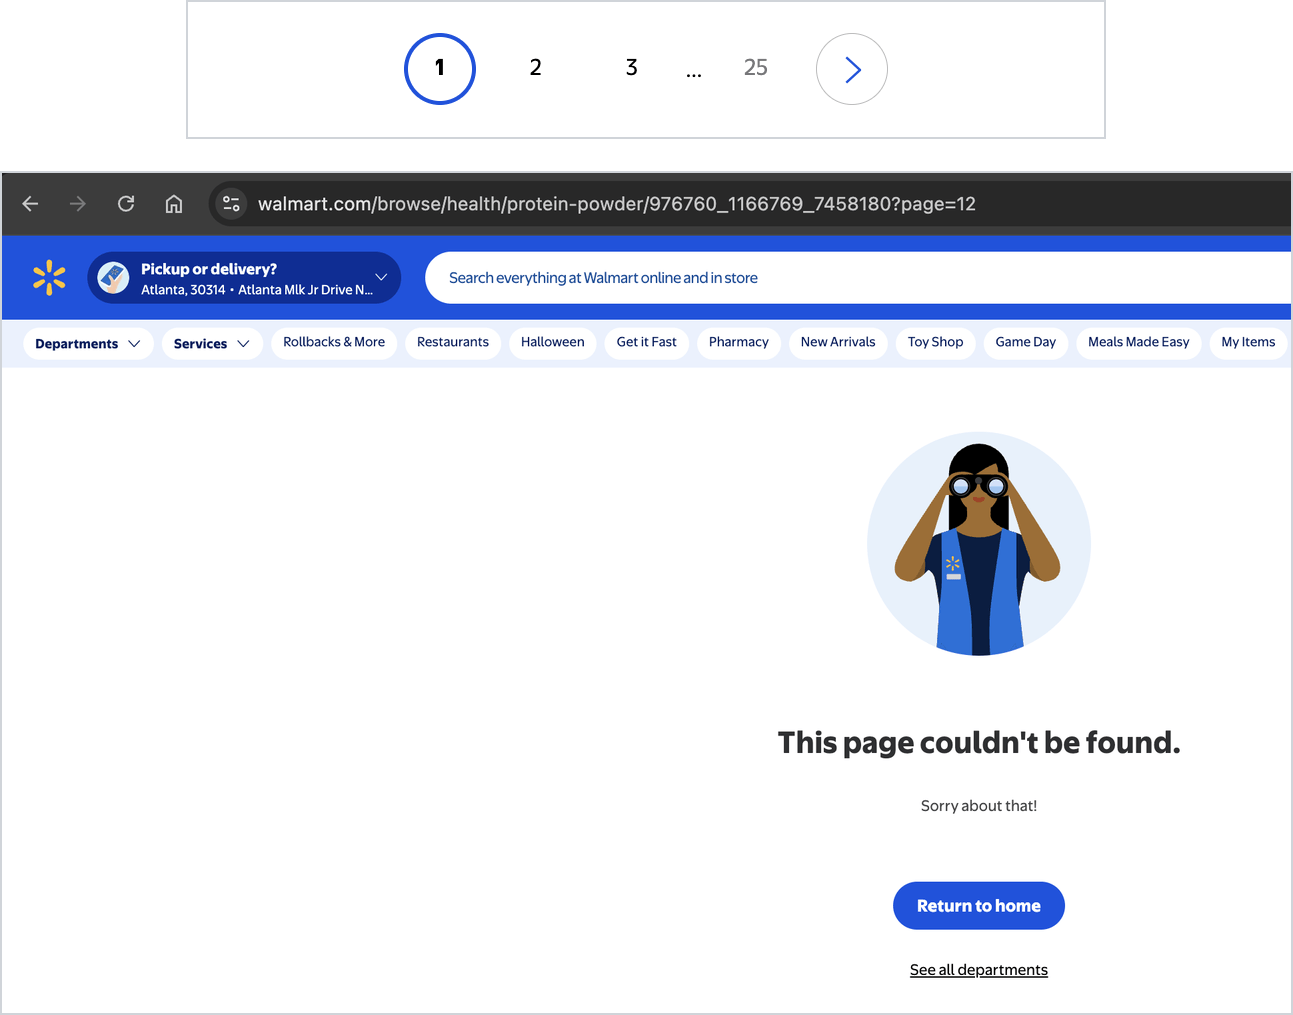
如果爬虫工具按照页码一直抓取到第 25 页,那么第 11 页之后将一无所获。
如何将分类拆分为不同价格区间
Walmart 抓取工具 API 的分类发现功能接受包含 Walmart 价格筛选条件的分类 URL,因此你可以按不同价格区间采集分类。作为基准,未筛选的分类 URL 返回了 393 件独立商品,与列表显示的 389 件接近。
Walmart 的 min_price 和 max_price URL 参数可将分类拆分为不同价格区间,每个区间都会报告自己的商品数量。我先在 $15、$25、$35、$50 和 $75 处拆分分类。随后,又在 $42、$62 和 $100 处拆分了报告商品数超过 500 的 3 个区间,并对全部 9 个区间运行发现任务:
| 价格区间 | Walmart 报告的商品数 | 发现的独立商品数 |
|---|---|---|
| $0 至 $15 | 75 | 60 |
| $15 至 $25 | 230 | 189 |
| $25 至 $35 | 429 | 330 |
| $35 至 $50,拆分为 2 个区间 | 718 | 569 |
| $50 至 $75,拆分为 2 个区间 | 592 | 484 |
| $75 及以上,拆分为 2 个区间 | 519 | 444 |
这 9 个区间共返回 2,069 件独立商品,约为基准数量的 5 倍。该列合计为 2,076,是因为少数商品出现在两个区间中。没有任何区间返回超过 330 件独立商品,因此全部低于分页限制。
Walmart 报告的数量比每行实际返回的独立商品数高 17% 至 30%。在 $0 至 $15 区间中,两个列表页面仅显示 62 件独立商品,而不是 Walmart 报告的 75 件。发现任务返回 60 件,与页面上的 62 件接近。应将 Walmart 报告的数量视为上限。
将每个分类拆分为不同价格区间,直到每个区间返回的独立商品数低于其分页限制;蛋白粉分类的这一限制约为 390。
Walmart 的商品站点地图列出的商品远多于单个分类列表。通过网络解锁器 API,我获取了一个商品站点地图索引,其中指向 5,916 个站点地图文件。仅第一个文件就包含来自不同分类的 50,000 个商品 URL,而且每个 URL 只有最后修改日期。可使用站点地图获取全目录 URL 列表,并对你要跟踪的分类使用价格区间。
搜索结果和评论会在哪里停止
搜索有自己的页面限制。搜索“laptop”时报告有 20,251 条结果,但 maxPage 为 14,每页 40 条结果,因此最多只能访问 560 条结果。只要可行,应通过分类或站点地图发现商品。
当你需要搜索结果本身时,例如进行货架份额跟踪可使用 Walmart 商品搜索爬虫,其记录会标记赞助结果。搜索“protein powder”返回了 568 条记录,其中 164 条为赞助结果。在这些记录中,有 55 个商品 ID 出现不止一次,其中 52 个同时出现在赞助结果和自然结果中。进行货架份额分析时应保留两种展示位置,而制作商品列表时则应按商品 ID 去重。
评论有自己的分页限制。牛奶页面显示有 399,133 个评分,其中 27,412 个包含文字评论。在默认排序下,其分页每页显示 10 条评论,并在 10,000 页处停止。第 1001 页不会报错,而是重新返回第 1 页,因此应根据 Walmart 报告的页数停止,而不是等待空白页面。
Walmart 评论爬虫工具使用 sort_by 输入设置评论顺序。对于一个有 127 个评分的糖果商品,它返回了全部 41 条文字评论。
为什么你的 URL 列表需要定期更新
大约每 7 个旧商品 URL 中就有 1 个已经失效。在约两年前的 150 个商品 URL 中,22 个返回 404 或 410,另有 37 个有效页面没有价格。
应以足够高的频率重新运行发现任务,使 URL 列表保持最新,从而确保每个任务采集的都是有效商品。
如何选择爬虫 Walmart 的方法
下面每种方法为你处理的工作量不同,从访问原始页面到提供完整记录不等。每项产品的定价页面都列出了当前价格:
| 方法 | 它为你处理的内容 | 计费依据 | 门店选择 | 当前定价 |
|---|---|---|---|---|
| 搭配自有解析器的动态住宅代理 | 为你自己的客户端和解析器提供动态住宅 IP | 按流量 GB 计费 | 由 Walmart 根据出口 IP 设置 | 住宅代理定价 |
| 搭配自有解析器的网络解锁器 API | 解除访问限制,并在响应标头中提供 Walmart 的状态码 | 按成功请求计费 | 由 Walmart 根据出口 IP 设置 | 网络解锁器定价 |
| Walmart 爬虫工具 API | 发现、采集和提供包含门店字段的已解析记录 | 按交付记录计费 | 通过 zipcode 和 store_id 为每个请求设置 |
网页爬虫工具 API 定价 |
| 浏览器 API | 配有内置验证码破解功能的完整浏览器,用于交互式流程 | 按流量 GB 计费 | 通过在页面上选择门店进行设置 | 浏览器 API 定价 |
| Walmart 数据集 | 现成的 Walmart 商品、评论和卖家数据 | 按记录计费 | 在采集时设置 | 数据集定价 |
住宅代理和网络解锁器 API 会提供原始页面,因此你的团队需要自行完成解析和门店验证。Walmart 爬虫工具 API 则返回可直接验证的已解析记录。
住宅代理让你能够完全控制每个请求。你可以选择客户端、标头和解析器,适合已经运行自有技术栈的团队。
网络解锁器 API 负责解决访问问题,让你可以专注于解析。它还可以获取 Walmart 的商品站点地图,用于构建全目录 URL 列表。
Walmart 爬虫工具 API 适合大规模门店级任务。其 zipcode 和 store_id 输入用于设置位置,记录则会报告定价所依据的门店,使你的数据管道可以验证每条记录。
使用浏览器 API 处理交互式流程。它运行完整浏览器,适合探索页面和捕获新端点。对于目录级的大规模任务,可将其与 Walmart 爬虫工具 API 或网络解锁器 API 结合使用。
数据集适合历史数据回填和全目录分析。Walmart 数据集支持选择刷新计划。
智能体可以执行单个商品查询。Bright Data CLI 提供 walmart_product 管道Bright Data MCP 服务器则提供 web_data_walmart_product 工具。以商品 URL 作为输入时,CLI 管道会返回与 Walmart 爬虫工具 API 记录采用相同 schema 的记录。
应根据每条有效记录的成本比较所有方法,因为针对错误门店定价的页面不能作为可用的门店级记录。
如何使用 Walmart 爬虫工具 API 构建门店级价格管道
要大规模抓取 Walmart,可按价格区间发现 URL,为每个 URL 设置邮政编码或门店 ID,并检查每条记录的门店 ID。Walmart 爬虫工具 API 分别提供用于商品、评论、卖家和搜索的爬虫工具,均可通过同一个 REST API 使用。新账户可以从免费套餐开始。每个爬虫工具都有自己的数据集 ID 和输入:
| 爬虫工具 | 数据集 ID | 主要输入 | 用途 |
|---|---|---|---|
| Walmart 商品 | gd_l95fol7l1ru6rlo116 |
url 搭配 zipcode 和可选的 store_id或者通过 category_url、keyword 或 sku 进行发现 |
门店级价格、商品详情和图片 |
| Walmart 商品邮政编码 | gd_m693oc1r1gebnayxq |
url 搭配 zip_code 和可选的 store_id或者按分类或关键词发现 |
自提门店、库存数量和预计送达时间 |
| Walmart 评论 | gd_mpql1v8g2o8o6l1wzd |
url 搭配可选的 sort_by |
文字评论 |
| Walmart 卖家信息 | gd_m7ke48w81ocyu4hhz0 |
卖家页面 url |
卖家资料 |
| Walmart 商品搜索 | gd_m7khey0wb7wviejgj |
搜索页面 url |
带有赞助标记的搜索结果 |
在控制面板中,Walmart 商品爬虫工具会为每个 URL 接收一个 zipcode 和 store_id:
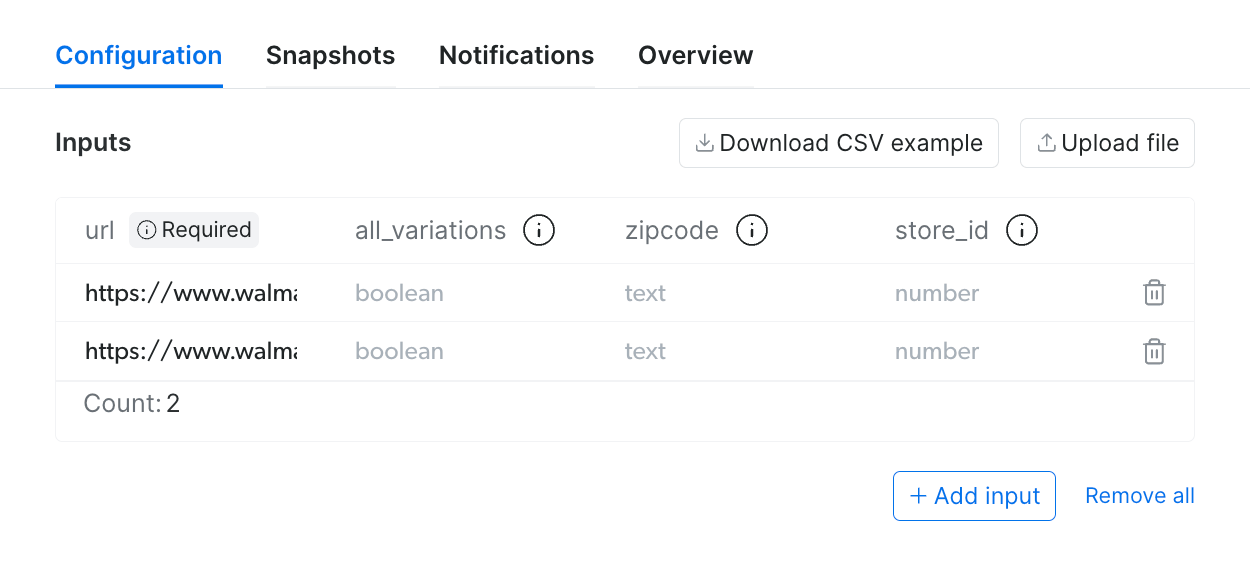
zipcode 和 store_id 列用于为每条记录请求一家门店。
创建共享辅助函数
这些辅助函数需要在 BRIGHTDATA_API_TOKEN 中设置一个 API 密钥。post 函数会遵循 Retry-After因此当达到异步请求限制时,你的客户端会等待并重试:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
WALMART_PRODUCTS = "gd_l95fol7l1ru6rlo116"


def post(url, **kwargs):
    """POST that honors Retry-After to stay within the rate limits."""
    for attempt in range(6):
        r = requests.post(url, headers=HEADERS, timeout=120, **kwargs)
        if r.status_code != 429:
            r.raise_for_status()
            return r
        time.sleep(int(r.headers.get("Retry-After") or 2 ** (attempt + 1)))
    r.raise_for_status()


def wait_and_download(snapshot_id, every=30):
    while True:
        r = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                         timeout=60)
        r.raise_for_status()
        status = r.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id} ended as {status}")
        time.sleep(every)
    while True:  # 202 means the file is still being assembled
        r = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                         params={"format": "json"}, timeout=300)
        if r.status_code == 200:
            return r.json()
        r.raise_for_status()
        time.sleep(10)
下面的发现和采集代码块会复用 post、wait_and_download、API 和 HEADERS因此请将全部 3 个代码块保存在同一文件中。
按价格区间发现商品 URL
这些函数会将分类拆分为不同价格区间,并返回排序后的独立 URL 列表:
def price_ranges(category_url, edges):
    """One discovery input per price range.

    Pick edges that keep each range under the pagination limit.
    """
    sep = "&" if "?" in category_url else "?"
    urls = [f"{category_url}{sep}min_price={lo}&max_price={hi}"
            for lo, hi in zip(edges, edges[1:])]
    return [{"category_url": u, "all_variations": False} for u in urls]


def discover(category_url, edges, per_range=600):
    body = {"input": price_ranges(category_url, edges),
            "limit_per_input": per_range}
    params = {"dataset_id": WALMART_PRODUCTS, "type": "discover_new",
              "discover_by": "category_url", "include_errors": "true"}
    job = post(f"{API}/trigger", params=params, json=body)
    records = wait_and_download(job.json()["snapshot_id"])
    urls = {r["url"].split("?")[0] for r in records if r.get("url")}
    return sorted(urls)
使用 per_range=600 时,一个覆盖 9 个蛋白粉价格区间的发现任务返回了 2,069 个独立商品 URL。
错误记录会在其 error_code 旁包含描述性的 error 消息,例如 Walmart 为已下架商品返回的 410 Gone 状态。discover 只保留包含 url 的记录,因此检查任务时,应从原始快照读取错误记录。
采集并验证门店级记录
接下来,使用邮政编码采集每个 URL,并在每条记录进入数据仓库前进行验证。在字段列表中加入 input、error 和 error_code以便每条记录保留其输入和所有错误详情。如果你需要根据包装规格重新计算单位价格,请添加 specifications:
FIELDS = "|".join([
    "product_id", "product_name", "final_price", "currency", "unit_price",
    "available_for_pickup", "available_for_delivery", "store_id",
    "store_name", "store_location", "seller", "timestamp",
    "input", "error", "error_code",  # keep input and error details
])


def collect(urls, zipcode, store_id=None, webhook=None):
    """Start one async job for a zip code. Returns the snapshot ID."""
    params = {"dataset_id": WALMART_PRODUCTS, "include_errors": "true",
              "format": "json", "custom_output_fields": FIELDS}
    if webhook:  # Bright Data POSTs the finished records to this URL
        params |= {"endpoint": webhook, "uncompressed_webhook": "true",
                   "auth_header": os.environ["WEBHOOK_AUTH_HEADER"]}
    row = {"zipcode": zipcode} | ({"store_id": store_id} if store_id else {})
    body = {"input": [{"url": u, **row} for u in urls]}
    job = post(f"{API}/trigger", params=params, json=body)
    return job.json()["snapshot_id"]


def validate(records, zipcode, store_id=None):
    """Keep records priced for the requested store. Route the rest by reason."""
    valid, rejected, seen = [], [], set()
    for rec in records:
        url = rec["input"]["url"]
        if rec.get("error_code"):
            rejected.append((url, rec["error_code"]))
            continue
        where = rec.get("store_location") or ""
        if store_id:  # store_location then shows the store's own zip
            matched = bool(where) and str(rec.get("store_id")) == str(store_id)
        else:  # store_location should show the requested zip
            matched = where.endswith(", " + zipcode)
        if not matched:
            rejected.append((url, f"priced for {where or 'no store'}"))
            continue
        try:
            price = float(rec["final_price"])
        except (KeyError, TypeError, ValueError):
            rejected.append((url, "no price, check availability"))
            continue
        key = (rec["product_id"], rec["store_id"])
        if key not in seen:
            seen.add(key)
            valid.append(rec | {"final_price": price})
    return valid, rejected


if __name__ == "__main__":
    category = ("https://www.walmart.com/browse/health/protein-powder/"
                "976760_1166769_7458180")
    edges = [0, 15, 25, 35, 42, 50, 62, 75, 100, 100000]
    urls = discover(category, edges, per_range=5)
    print(len(urls), "product URLs discovered")
    records = wait_and_download(collect(urls, zipcode="72712"))
    valid, rejected = validate(records, "72712")
    print(len(valid), "valid records,", len(rejected), "rejected")
一次使用每个区间 5 件商品和 Bentonville 邮政编码 72712 的运行打印了以下数量。在发现和采集任务运行期间,脚本会轮询其结果。你的数量会有所不同,因为它取决于运行管道当天 Walmart 的商品列表:
42 product URLs discovered
41 valid records, 1 rejected
全部 41 条有效记录都针对 Bentonville 的 100 号门店定价。Walmart 列出的另一件商品没有价格。rejected 列表记录了每条记录被拒绝的原因。
仅使用邮政编码时store_location 会显示请求的邮政编码,因此 validate 会根据该邮政编码确认每条记录。若要指定门店,请发送其 store_id并搭配该门店可用的邮政编码,例如门店自身的邮政编码。随后记录会显示门店自己的邮政编码,因此请将同一个 store_id 传递给 validate后者会比较门店 ID。API 会检查该组合,因此如果将 Secaucus 的 3520 号门店与 Bentonville 的 72712 一起发送,就会生成一条说明不匹配问题的错误记录。
在目录级规模下,一个使用邮政编码 72712 的任务运行了全部 2,069 个已发现 URLvalidate 则检查了每条记录报告的位置。
大规模运行管道
在大规模运行时,以下 4 项实践可让管道更具可预测性。
将 URL 分批放入任务。任务以异步方式运行,因此让 wait_and_download 轮询结果。每个任务都应使用异步触发器。如果某个任务需要更长时间同步端点会返回一个可供轮询的快照 ID,因此从异步方式启动可以保持单一代码路径。
统计独立输入。API 会对重复输入去重,因此包含 34 个输入且其中 2 个重复的任务会返回 32 条记录。同一 URL 使用 3 个邮政编码发送时会计为 3 个输入,每个输入都会针对各自的门店定价。
在重试前检查错误记录。错误记录会注明原因,因此应从列表中移除失效的商品 URL,并重新发送其余 URL。
将数据交付到你的存储系统。调用 collect(urls, zipcode, webhook=URL)并将完整标头值(例如 Bearer <secret>)放入 WEBHOOK_AUTH_HEADER。Bright Data 会通过 POST 将完成的记录发送到 webhook URL,并将该值作为 Authorization 标头。交付指南介绍了端点应发送的确认响应、需要加入允许列表的源 IP,以及 Amazon S3、Google Cloud Storage 和 Snowflake 等目标位置。
请在管道中保留门店验证,确保数据仓库中的每条记录都有经过验证的位置信息。
总结
大规模爬虫 Walmart 不仅是访问问题,也是门店位置问题。每个价格都属于其定价所依据的门店,而成功状态无法告诉你具体是哪家门店。应在每个采集请求中设置邮政编码或门店 ID,并将发现任务拆分为多个价格区间,使每个区间都低于分页限制。
如果你需要的是历史数据回填,而非每日门店价格,可以从 Walmart 数据集开始。否则,先在免费套餐中通过 Walmart 爬虫工具 API 运行几个价格区间和邮政编码,待门店验证通过后再扩大规模。
常见问题
如何按邮政编码爬虫 Walmart 价格?
为每个商品 URL 发送邮政编码,而不是依赖出口 IP;否则 Walmart 会使用出口 IP 选择门店。一个邮政编码可能会解析到另一个州的门店,因此当你需要指定门店时,还应添加门店 ID。Bright Data 的 Walmart 抓取工具 API 同时接受这两项信息,并会报告每条记录对应的门店。
Walmart 是否有公共 API?
在我检查时,Walmart 的 API 面向合作伙伴。联盟营销 API 会按邮政编码返回价格和可用性,供赚取推荐佣金的应用使用。门店查询需要额外批准。Marketplace API 仅涵盖卖家自己的商品目录,因此门店级价格跟踪工具需要采集公开商品页面。
可以爬虫 Walmart 评论吗?
可以。在一个牛奶商品页面上,Walmart 的评论分页在默认排序下每页显示 10 条评论,并在 10,000 页处停止。第 1001 页会重新返回第 1 页,因此应根据 Walmart 报告的页数停止。Bright Data 的 Walmart 评论爬虫会采集文字评论,并使用 sort_by 输入设置评论顺序。
是否有 Walmart 商品数据集?
有。Bright Data 提供现成的 Walmart 商品、评论和卖家数据集,你可以选择刷新计划。它们适合历史数据回填和全目录分析。对于每日门店级价格,可使用 Walmart 抓取工具 API,按邮政编码或门店 ID 采集当前记录。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。