爬虫 Zillow 是指从 Zillow 的公开页面采集房源、价格和房产记录,用于定价模型、投资分析工具和市场控制面板。每个页面都将其主要数据嵌入为 JSON。
Zillow 会阻止默认的 Python 请求,但这是比较容易解决的问题。更棘手的是,你的爬虫可能会遗漏数据,却不会通知你。大多数房源页面的 HTML 中都不包含价格历史记录,而且一次搜索最多只能返回 984 条房源,仅占休斯敦待售房屋的 6%。
本指南将介绍如何使用 Python 爬虫 Zillow、获取每条房源及其价格历史记录,以及如何判断何时使用托管式抓取工具成本更低。
简要总结
- 使用浏览器的 TLS 指纹。即使带有 Chrome 标头,Zillow 也会阻止 Python 的默认 TLS 指纹。模拟 Chrome 的
curl_cffi成功获取了 430 个页面中的 429 个。 - 读取页面嵌入的 JSON,并单独获取价格历史记录。大多数房源页面会通过第二个请求加载这些数据,而仅抓取 HTML 的爬虫工具从不会发出该请求。
- 一次搜索最多返回 984 条房源,因此需要拆分大型搜索。你也可以使用 Bright Data Zillow 爬虫 API它通过一个 URL 找到了韦恩堡的全部 1,295 条房源。
- 检查完整性,而不只是状态码。将你的数据行数与 Zillow 报告的总数进行比较,重试失败的数据行,并标记曾经售出但没有价格历史记录的房屋。
你可以爬虫哪些 Zillow 数据,以及在哪里找到它们
你的爬虫可以从 4 个主要来源获取 Zillow 数据,而 Zillow 的 robots.txt 对这些来源的处理方式各不相同:
| 数据 | Zillow 上的来源 | robots.txt 的说明 |
|---|---|---|
| 房源字段:价格、卧室数、Zestimate、照片、房源经纪人 | 房源页面 HTML 中的 __NEXT_DATA__ JSON |
允许用于 /homedetails/ 页面 |
| 价格历史记录、税务历史记录、学校 | 通常由页面加载后发送的 /graphql/ 请求获取 |
禁止用于 /graphql/ |
| 搜索结果,每页 41 条房源 | /fort-wayne-in/2_p/ 等城市页面,或内部 async-create-search-page-state 端点 |
允许用于城市页面,禁止用于该端点和 ?searchQueryState= URL |
| 有变更的房源 | robots.txt 中链接的站点地图,例如 latest.xml.gz |
为爬虫发布 |
Zillow 的页面使用 Next.js 构建,每个页面都将主要数据以 JSON 形式嵌入在 __NEXT_DATA__ 脚本标签中。无需渲染页面即可读取这些 JSON。我们的爬虫 Next.js 网站指南介绍了这种嵌入式数据的工作方式。
你对一条房源和一次搜索发出的请求会遵循以下路径:
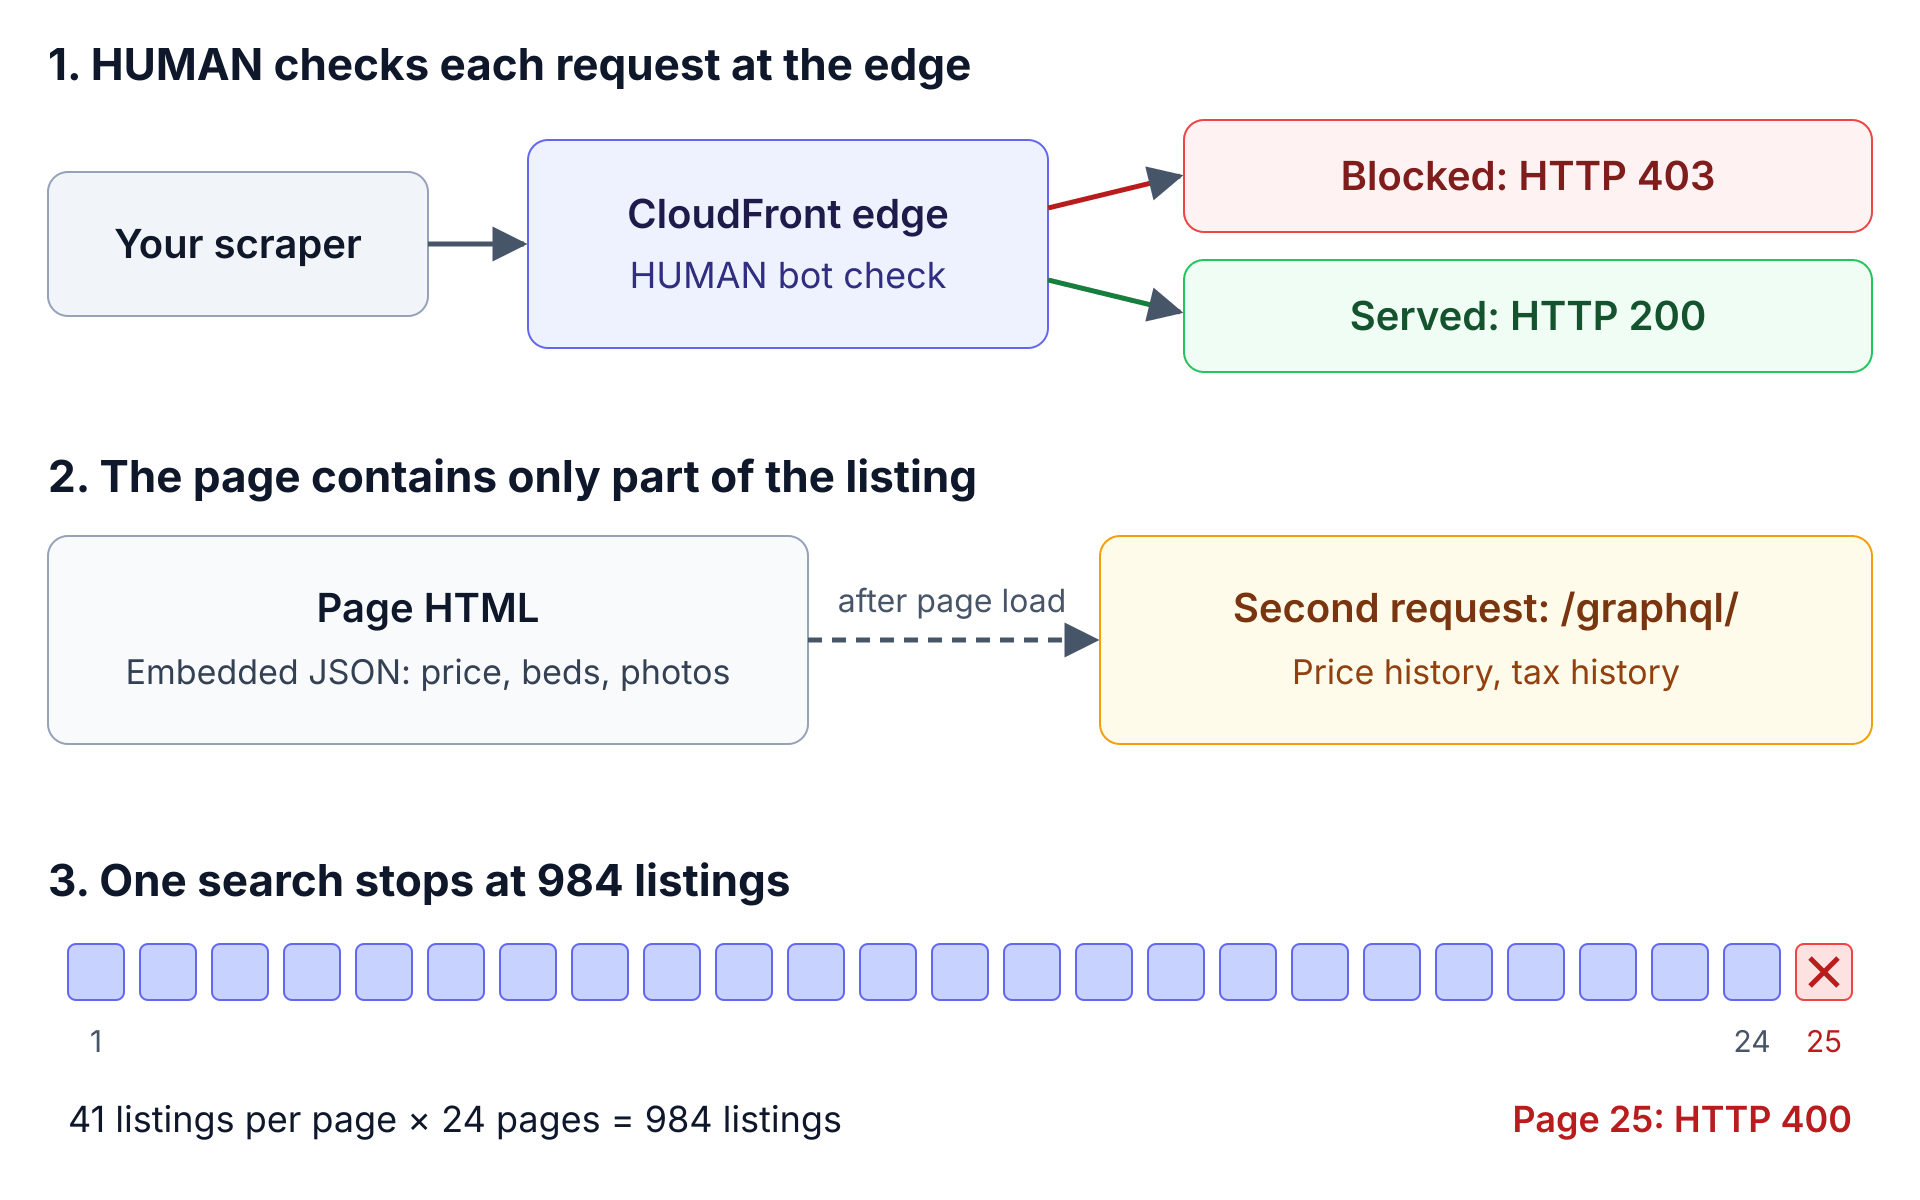
HUMAN 的机器人检查会在边缘节点运行,此时尚未生成任何 HTML;价格历史记录则会在页面加载后才载入。如果你的解析器只读取 HTML,它可能会将被阻止的请求误判为空页面,并且会遗漏大多数房源的价格历史记录。
房源页面和价格历史记录
你需要解析房源 JSON 两次,因为它经过了双重编码。字段 props.pageProps.componentProps.gdpClientCache 的值是一个字符串,而该字符串本身又是一个 JSON 对象。它的键是 Zillow 内部 GraphQL 查询的名称。
待售、非在售和 Zillow Showcase 房源各自使用不同的 GraphQL 操作名称。ForSalePriorityQuery 有 101 个字段NotForSalePriorityQuery 有 122 个字段ViewShowcasePriorityQuery 有 78 个字段。如果你的解析器只识别一个操作名称,它在处理其他类型时就会失败。改为合并缓存中的所有条目,这样一个解析器便可处理全部 3 种房源类型。
大多数房源的该 JSON 中都缺少价格和税务历史记录。对于 20 条待售房源,Bright Data Zillow 爬虫 API 为每条房源返回了 1 到 18 条价格历史事件,而相同页面的 HTML 中完全没有这些事件。如果你的抓取工具只读取 HTML,它会将这些房屋记录为没有价格历史,并且不会引发任何错误。
浏览器会在页面加载后请求历史记录。对于一套待售房屋,该请求(ForSaleNonPriorityQuery)返回了 145 个房产字段,其中包括 21 年的税务历史记录。非在售页面使用另一种请求,即页面通过哈希调用的持久化 GraphQL 查询。
搜索页面和 984 条房源的限制
一个完整的搜索结果页面在其 __NEXT_DATA__ 区块中包含 41 条房源,但其中只有 9 条被渲染为 HTML 卡片。如果使用 CSS 选择器解析卡片,你会漏掉另外 32 条。旧版 Zillow 教程中的卡片选择器(例如 article.list-card)无法匹配任何元素。
Zillow 还会限制每次搜索。即使搜索报告的结果超过 1K 条,其自身的分页也会在第 20 页停止:
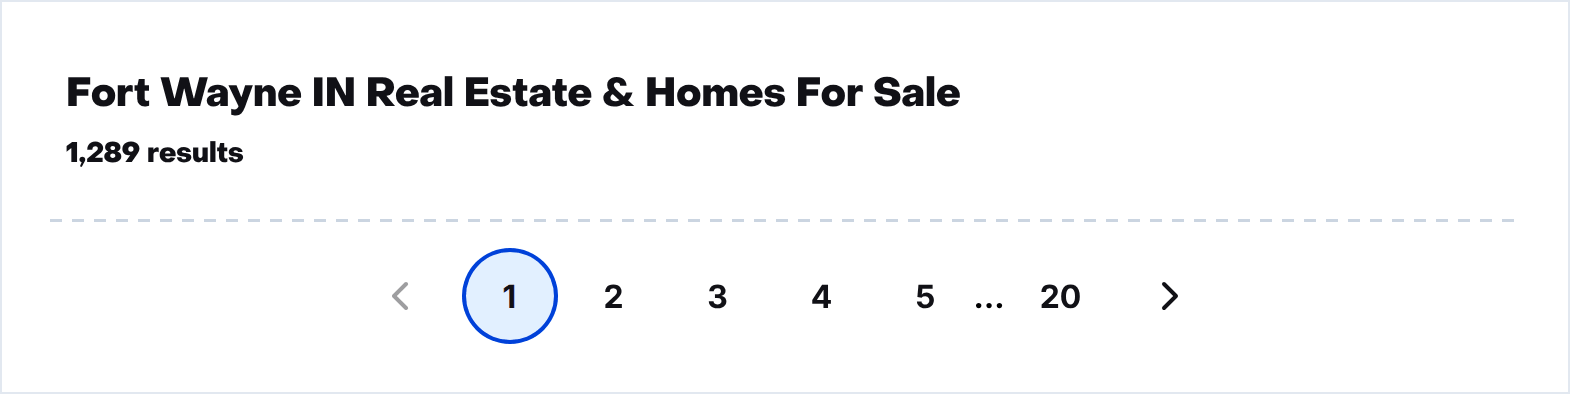
Zillow 韦恩堡结果列表的顶部和底部。随着房源的添加和移除,总数(此处为 1,289)会发生变化,但页码仍然止于第 20 页。
20 页乘以每页 41 条房源等于 820 条,这是一些抓取工具所记录的限制。但通过 URL 请求时,第 21 至 24 页仍会各自返回 41 条房源,而第 25 页会返回 HTTP 400 错误。因此,一次搜索最多可获取 984 条房源,相当于韦恩堡 1,295 条待售房源的 76%,以及休斯敦市 15,410 条待售房源的 6%。每个响应仍会报告完整总数,因此请将该数字与你实际采集的数量进行比较。
解析 JSON 而不是页面标记,这样每页可获取全部 41 条房源,而不是只有 9 条。
Zillow 为何阻止默认 Python 请求
Zillow 的机器人防护由 HUMAN Security 提供,该公司前身为 PerimeterX。有两个细节表明了这一点:拦截页面显示了 PerimeterX 应用 ID PXHYx10rg3而 robots.txt 禁止了 /captchaPerimeterX/ 和 /HYx10rg3/。
拒绝请求的是位于 Zillow 前端的内容分发网络(CDN)CloudFront,而不是 Zillow 自己的服务器。每个被阻止的响应都是带有 x-cache: LambdaGeneratedResponse 和 x-px-blocked: 1 的 HTTP 403。它还缺少正常页面中包含的 x-envoy-upstream-service-time 标头。你的爬虫可以检查该 x-px-blocked 标头,无需解析页面即可检测请求是否被阻止。
被阻止的请求是什么样的
带有 Chrome User-Agent 的 curl 请求遭到了拒绝:
curl -s -o /dev/null -D - \
  -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36" \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
边缘节点在 0.32 秒内返回了大小为 5,952 字节的“Press & Hold”页面:
HTTP/2 403
server: CloudFront
content-length: 5952
x-px-blocked: 1
x-cache: LambdaGeneratedResponse from cloudfront
从 Playwright 启动的无头 Chromium 也遇到了相同拦截,返回带有 x-px-blocked: 1 的 HTTP 403,并渲染了 HUMAN 的验证页面:
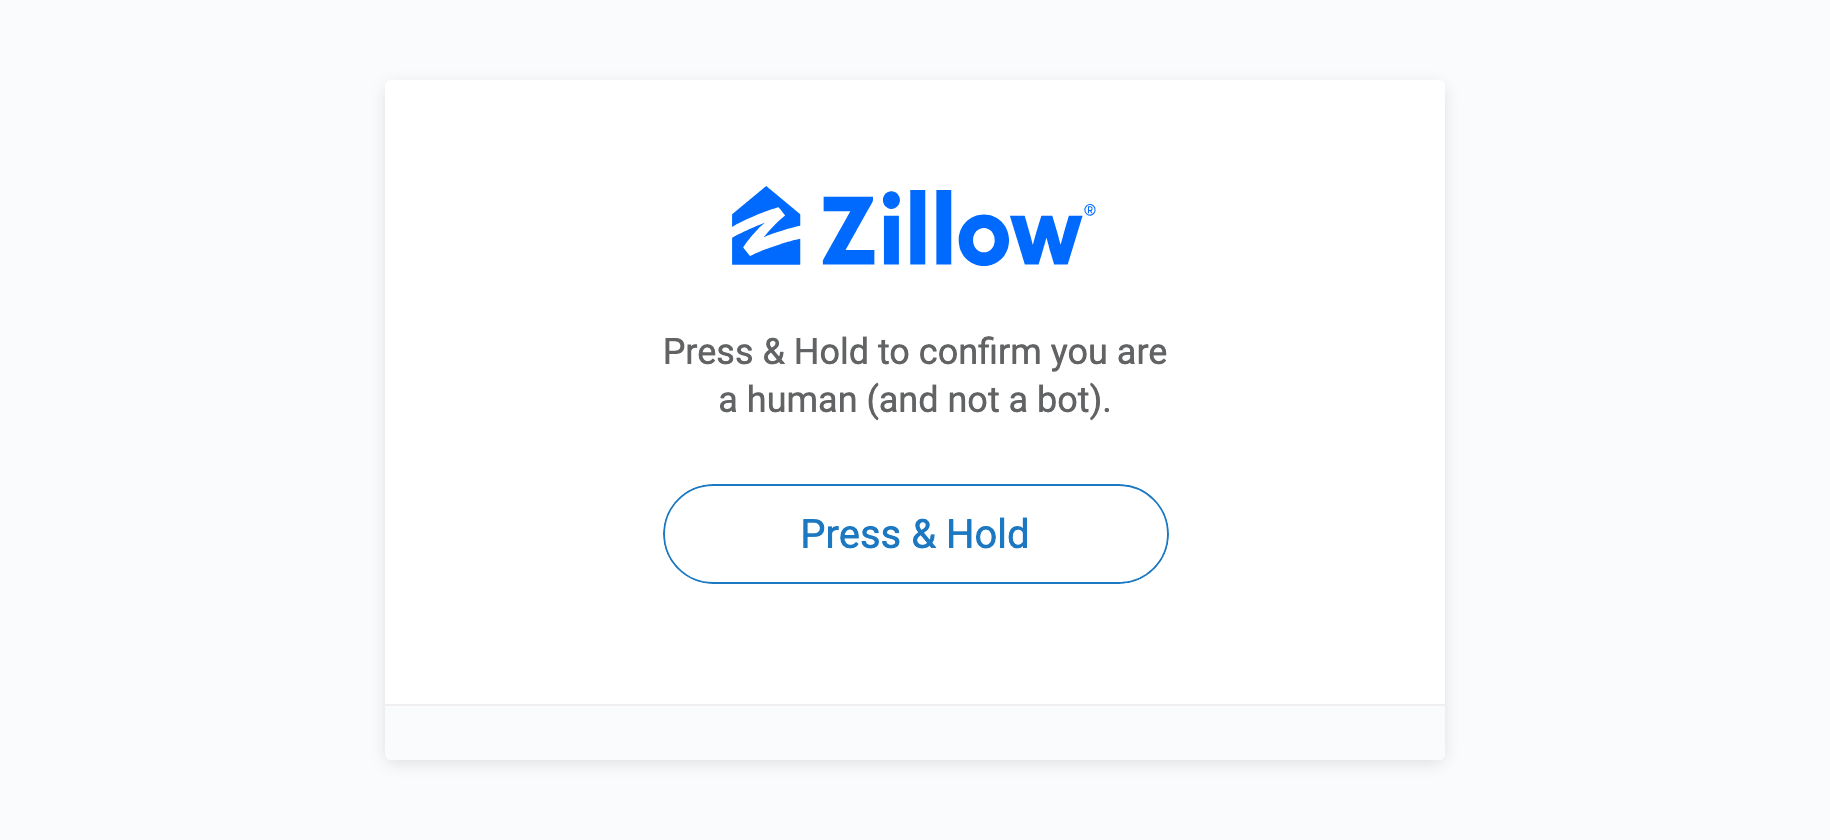
如果你的抓取工具收到此页面,说明请求已在边缘节点被拒绝,页面中不包含任何房源数据。
如需在不自行编写绕过代码的情况下处理此页面,请使用 Bright Data Zillow 验证码破解工具。
哪些 Python 客户端能通过 Zillow 的机器人检查
在同一 IP 上curl 被拒绝几秒后curl_cffi 成功获取了同一条房源。该库会模拟 Chrome 的 TLS 握手和标头:
python - <<'EOF'
from curl_cffi import requests

url = "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
r = requests.get(url, impersonate="chrome")
print(r.status_code, len(r.content))
EOF
它输出了 HTTP 200 和 730,803 字节的 HTML:
200 730803这两个请求的标头和 TLS 指纹不同。TLS 指纹是客户端建立连接时提供的密码套件和扩展所形成的模式。我们的 TLS 指纹指南介绍了网站如何使用这些指纹检测机器人。
使用一个未被 Zillow 阻止的住宅 IP,6 个客户端分别获取了一个房源页面和一个搜索页面,两个页面上的结果相同:
| 客户端 | TLS 指纹 | 结果 |
|---|---|---|
使用默认标头的 Python requests |
Python(OpenSSL) | 403 |
使用 Chrome User-Agent 和浏览器标头的 Python requests |
Python(OpenSSL) | 403 |
httpx浏览器标头 |
Python(OpenSSL) | 403 |
curl_cffiimpersonate="chrome" |
Chrome | 200 |
curl_cffiimpersonate="firefox" |
Firefox | 200 |
curl_cffiimpersonate="safari" |
Safari | 403 |
如果客户端使用 Python 的 TLS 指纹,浏览器标头也无济于事。Safari 配置在两个页面上同样遭到拒绝,因此在依赖某个模拟配置之前,请先针对 Zillow 进行测试。强制使用 HTTP/1.1 时,Chrome 配置仍可通过,因此 HTTP/2 设置并不是决定性因素。
为什么标头和 IP 信誉仍然重要
Zillow 还会检查请求的 HTTP 标头是否像真实浏览器。当代理使用 Chrome 的 TLS 指纹,并为每个请求分配一个新的美国 IP 时,仅标头就能决定请求结果。
Python 的默认 User-Agent 在 5 次请求中全部被拒绝,而仅使用 Chrome User-Agent 则 5 次全部通过。如果使用 Chrome 的完整标头集但不包含其 sec-ch-ua 客户端提示,10 次请求中有 4 次被拒绝。这表明 Zillow 会为每个请求计算风险分数,而不是应用固定规则。
你的 IP 信誉也很重要。从一个住宅 IP 发送约 20 个请求后,由于其中大多数来自 Zillow 拒绝的客户端,Zillow 随后甚至拒绝了几分钟前还能通过的 Chrome 配置,而封锁在 6 分钟内解除。
使用 Chrome TLS 指纹并复用 Cookie 的会话表现不同。在 5 个此类会话中,430 次房源请求有 429 次成功返回页面。唯一一次失败是 HTTP 502,而不是遭到拦截。HUMAN 没有拒绝这 430 次请求中的任何一次,其中包括 12 分钟内从一个 IP 发出的 250 次请求。
因此,应将拒绝视为暂停使用该 IP 的信号,而不是立即重试。在决定需要多少个代理 IP 之前,先测量每个 IP 的拦截率。有关 IP 轮换以及降低拦截率的其他方法,请参阅我们的避免在网页爬虫时被阻止指南。
使用 Python 和 curl_cffi 爬虫 Zillow
下面的爬虫会读取与页面相同的 JSON。它需要 Python 3.10 或更高版本,以及 curl_cffi;我们的使用 curl_cffi 进行网页抓取指南介绍了该工具。请在虚拟环境中安装该库:
python3 -m venv .venv
source .venv/bin/activate  # on Windows: .venv\Scripts\activate
pip install curl_cffi
此脚本 zillow_diy.py 会获取一个韦恩堡搜索页面,然后读取其中的 3 条房源:
"""Scrape Zillow with a browser's TLS fingerprint and the page's embedded JSON."""
import json
import re
import time

from curl_cffi import requests

NEXT_DATA = re.compile(
    r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S
)
# Chrome TLS + matching headers; keep one session per IP
session = requests.Session(impersonate="chrome")


def next_data(url: str) -> dict:
    resp = session.get(url, timeout=30)
    match = NEXT_DATA.search(resp.text)
    # A block can be a 403 or a 200 captcha page,
    # so test for the data, not the status
    if resp.headers.get("x-px-blocked") or not match:
        raise RuntimeError(f"no page data for {url} (HTTP {resp.status_code})")
    resp.raise_for_status()  # Zillow's 404 page also contains __NEXT_DATA__
    return json.loads(match.group(1))


def search_page(city: str, page: int) -> tuple[list[dict], int]:
    """One server-rendered page of results, plus the total that Zillow reports."""
    url = f"https://www.zillow.com/{city}/{page}_p/"
    cat1 = next_data(url)["props"]["pageProps"]["searchPageState"]["cat1"]
    return cat1["searchResults"]["listResults"], cat1["searchList"]["totalResultCount"]


def listing(url: str) -> dict:
    """The server-rendered part of a listing: gdpClientCache is double-encoded JSON."""
    props = next_data(url)["props"]["pageProps"]["componentProps"]
    cache = json.loads(props["gdpClientCache"])
    record = {}
    for query_result in cache.values():  # e.g. ForSalePriorityQuery{...}
        record.update(query_result.get("property") or {})
    return record


if __name__ == "__main__":
    cards, total = search_page("fort-wayne-in", 1)
    print(f"page 1: {len(cards)} listings of {total} reported")
    for card in cards[:3]:
        time.sleep(2)
        home = listing(card["detailUrl"])
        history = home.get("priceHistory") or []
        print(home["zpid"], home["homeStatus"], home["price"], home["bedrooms"], "bd",
              home["livingArea"], "sqft | priceHistory:", len(history))
使用 python zillow_diy.py 运行时,它在第 1 页找到了 41 条房源,并且打开的 3 条房源中有 2 条没有价格历史记录:
page 1: 41 listings of 1295 reported
73145681 FOR_SALE 649900 4 bd 5124 sqft | priceHistory: 3
73159210 FOR_SALE 699900 4 bd 4132 sqft | priceHistory: 0
73110917 FOR_SALE 239900 3 bd 1468 sqft | priceHistory: 0
第一条是 Showcase 房源,其 HTML 中包含价格历史记录。对于另外 2 条房源,Zillow 爬虫 API 分别返回了 2 条和 3 条价格历史事件,而 HTML 中为 0 条。整个运行过程耗时约 11 秒,其中包括两次 2 秒的暂停。
这种方法有两个限制。首先,韦恩堡城市页面的第 24 页仍返回 41 条房源,但第 25 页会返回 HTTP 400 错误。如果你的城市房源数量超出一次搜索所能获取的上限,就需要拆分为更小的搜索。其次,缺失的价格历史记录只能通过 /graphql/ 获取。
拆分城市搜索通常意味着使用邮政编码或筛选搜索,这些搜索使用 /homes/ 和 ?searchQueryState= URL;而缺失的价格历史记录需要通过 /graphql/ 请求获取。Zillow 的 robots.txt 禁止使用这三者,因此是否调用它们应由你的团队从合规角度决定。我们的网页爬虫 robots.txt 指南介绍了如何阅读并遵守这些规则。
如需从多个 IP 运行此爬虫,请向会话传入 Bright Data 住宅代理。对于端到端加密连接,请为端口 44445 加载 Bright Data 证书并使用 verify="brightdata_root_ca_44445.crt"。
住宅 IP 来自主动选择参与的真实用户,因此使用 Bright Data 住宅代理前,需要先通过获批的公司 KYC(了解你的客户)审核。审核会批准特定用例,因此申请时请说明你的 Zillow 数据管道。若未完成 KYC网络解锁器 API可为你处理解锁,而下一节介绍的 Zillow 爬虫 API 会返回包含价格历史记录的房源数据。
使用 Zillow 爬虫 API 抓取 Zillow
Zillow 爬虫 API 在 Bright Data 基础设施上执行数据采集,为你处理解锁和解析,并返回 JSON 记录。你按交付的记录付费,新账户可获得每月续发的 5K 免费额度。它包含以下 Zillow 抓取工具,下文分别称其为房源、价格历史、搜索页面和 Full Properties 爬虫:
| 爬虫工具 | 数据集 ID | 输入 | 输出 |
|---|---|---|---|
| Zillow 房产房源信息 | gd_lfqkr8wm13ixtbd8f5 |
房源 URL、搜索 URL 或位置筛选条件 | 每条房源 1 条记录,最多 139 个字段 |
| Zillow 价格历史 | gd_lxu1cz9r88uiqsosl |
房源 URL | 每个价格历史事件 1 行 |
| Zillow 房产搜索页面 | gd_m71oxpvxwr113ehqg |
带有 searchQueryState 的搜索 URL |
每条搜索结果 1 行,包含 26 个字段 |
| Zillow Full Properties 信息 | gd_m794g571225l6vm7gh |
房源 URL 或搜索 URL | 每条房源 1 条记录,字段名称采用 snake_case,例如 price_history |
这 4 个爬虫工具都通过相同的 API 请求按 URL 采集,你只需更改数据集 ID。Bright Data 还提供 Zillow 图片爬虫 API并在其房地产爬虫 API产品系列中提供适用于其他房产网站的抓取工具。在控制面板中,房源爬虫会显示其 3 种输入方式以及同步和异步模式:
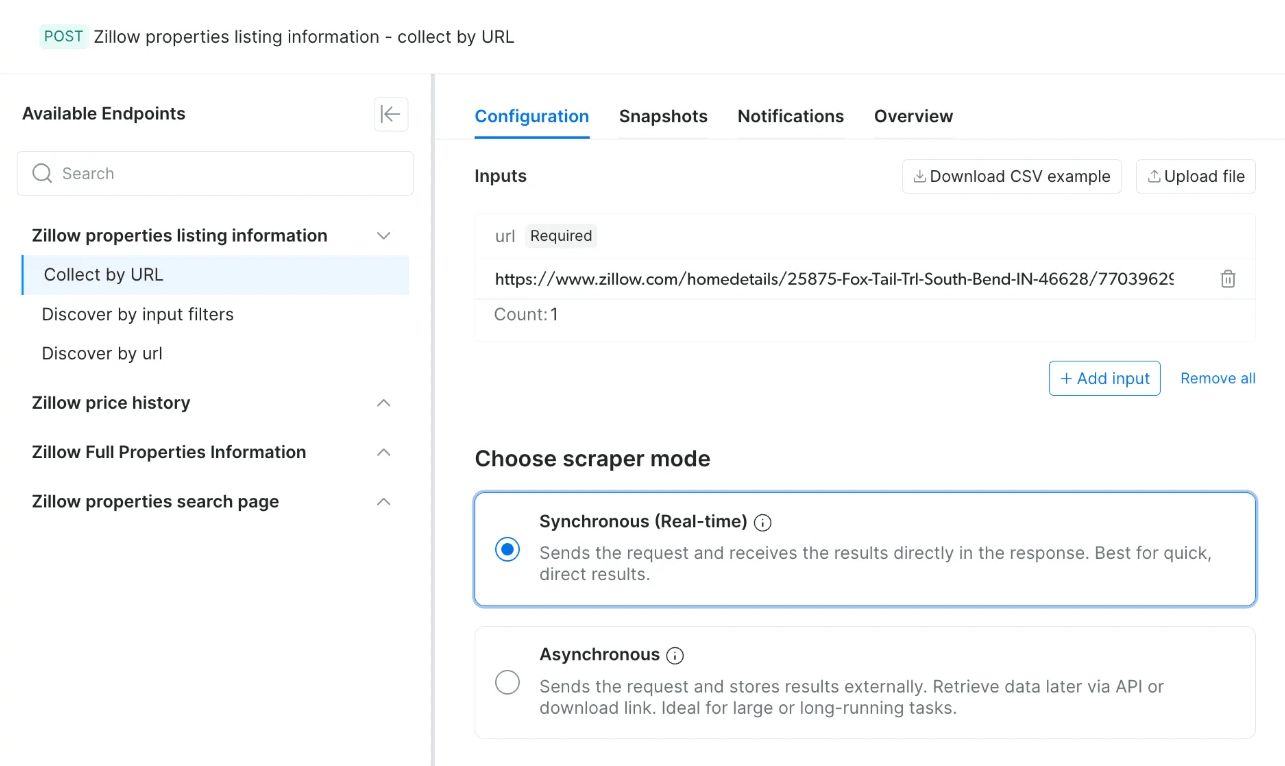
左侧面板列出了与上表相同的 4 个爬虫工具。
采集房源和价格历史记录
要运行下面的脚本 zillow_api.py你需要 requests 包(pip install requests),以及从控制面板获取的 API 令牌。其 collect() 函数会调用同步端点,如果任务耗时超过 1 分钟,则切换为轮询:
"""Listings, price history and discovery with Bright Data's Zillow Scraper API."""
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
LISTINGS = "gd_lfqkr8wm13ixtbd8f5"       # Zillow properties listing information
PRICE_HISTORY = "gd_lxu1cz9r88uiqsosl"   # Zillow price history, one row per event


def collect(dataset_id: str, urls: list[str]) -> list[dict]:
    """Up to 20 URLs per synchronous call; a job past 1 minute returns 202."""
    params = {"dataset_id": dataset_id, "include_errors": "true", "format": "json"}
    resp = requests.post(f"{API}/scrape", headers=HEADERS, params=params, timeout=120,
                         json={"input": [{"url": u} for u in urls]})
    if resp.status_code == 202:
        return wait_and_download(resp.json()["snapshot_id"])
    resp.raise_for_status()
    return resp.json()


def discover(search_url: str) -> list[dict]:
    """Every listing in one Zillow search, collected as full records (async)."""
    resp = requests.post(f"{API}/trigger", headers=HEADERS, timeout=60,
                         params={"dataset_id": LISTINGS, "include_errors": "true",
                                 "type": "discover_new", "discover_by": "url"},
                         json={"input": [{"url": search_url}]})
    resp.raise_for_status()
    return wait_and_download(resp.json()["snapshot_id"])


def wait_and_download(snapshot_id: str, poll_s: int = 15) -> list[dict]:
    while True:
        resp = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                            timeout=60)
        resp.raise_for_status()
        status = resp.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} ended as {status}")
        time.sleep(poll_s)
    while True:  # the download returns 202 while the file is still being prepared
        resp = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                            params={"format": "json"}, timeout=300)
        if resp.status_code != 202:
            resp.raise_for_status()
            return resp.json()
        time.sleep(10)


if __name__ == "__main__":
    homes = collect(LISTINGS, [
        "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/",
    ])
    for h in homes:
        print(h["zpid"], h["homeStatus"], h["price"], "| zestimate", h.get("zestimate"),
              "| priceHistory", len(h.get("priceHistory") or []),
              "| taxHistory", len(h.get("taxHistory") or []),
              "| collected", h.get("timestamp"))
    events = collect(PRICE_HISTORY, [
        "https://www.zillow.com/homedetails/2506-Gordon-Cir-South-Bend-IN-46635/77050198_zpid/",
    ])
    for e in events:
        print(e["zpid"], e["date"][:10], e["event"], e["price"], e["source"])
导出 BRIGHTDATA_API_TOKEN 后,两次调用合计耗时 35 到 65 秒:
77039629 FOR_SALE 359000 | zestimate 351600 | priceHistory 1 | taxHistory 21 | collected 2026-09-27T11:30:53.846Z
77050198 2023-03-03 Sold 265000 IRMLS
77050198 2023-02-03 Pending sale 264900 IRMLS
77050198 2023-02-01 Listed for sale 264900 IRMLS
房源记录与 Zillow 自己的页面所加载的数据一致,包含 1 条价格历史事件和 21 年的税务历史记录。其 timestamp 表明 Bright Data 是在请求期间实时采集这些数据的。
第二套房屋 2506 Gordon Cir 的 3 条事件与其 Zillow 页面上的价格历史表一致:
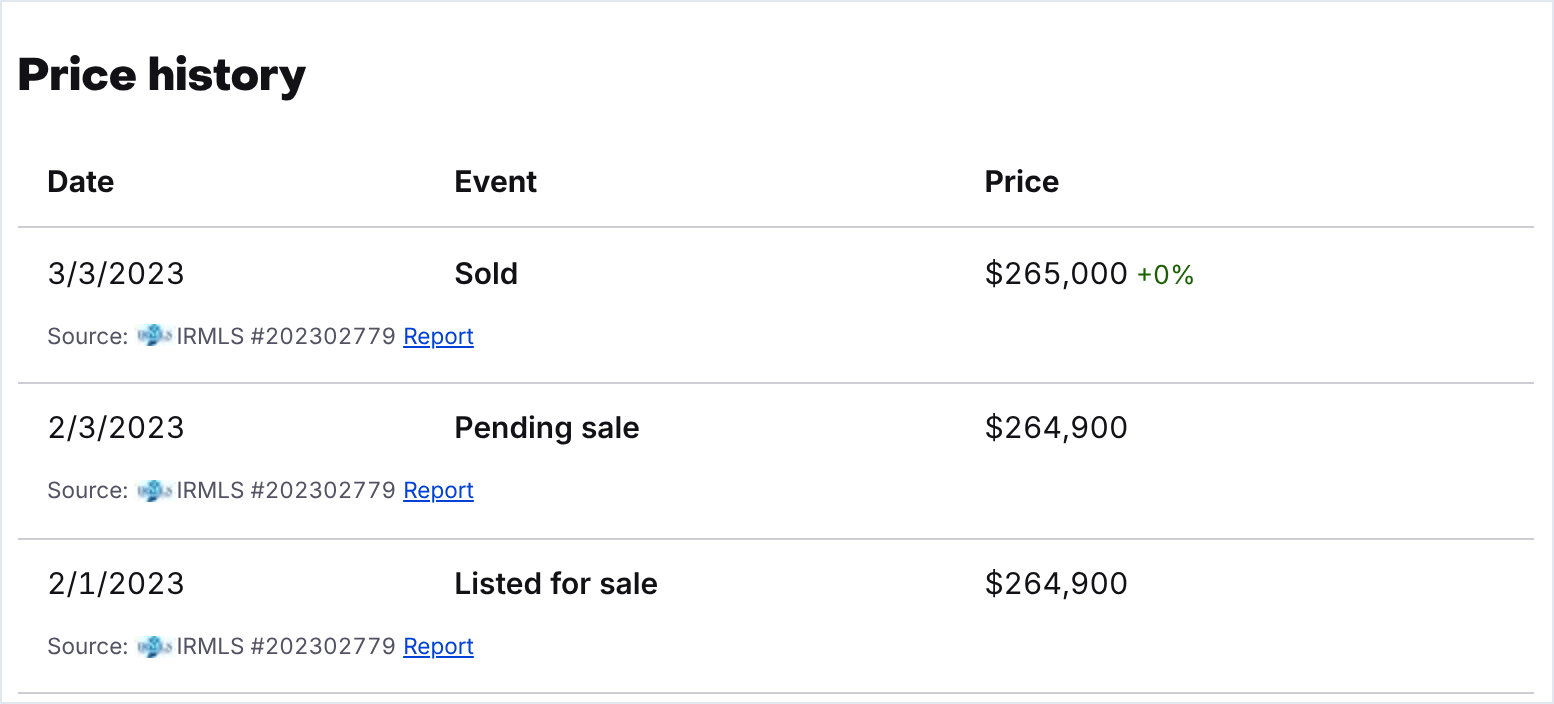
每一行都会注明其来源,即当地的多重房源服务(MLS),API 输出会将其保留在 source 字段中。
同步 /scrape 端点最多可接收 20 个 URL;如果任务在 1 分钟内完成,它会直接返回数据。对于耗时更长的任务,它会改为返回 HTTP 202 和快照 ID。一批 20 条韦恩堡房源耗时约 4 分钟,因此脚本输出任何内容前可能需要轮询几分钟。对于更大的批次,请使用异步 /trigger 端点下一节的发现流程将使用该端点。
发现搜索中的每条房源
发现功能可从一个搜索 URL 采集完整房源记录,并能突破 DIY 爬虫所受的 984 条房源限制。上面的 discover() 函数会通过异步 /trigger 请求,将韦恩堡城市 URL https://www.zillow.com/fort-wayne-in/ 发送到房源爬虫的“按 URL 发现”输入方式。13 到 17 分钟内,它返回了 1,295 行,与 Zillow 报告的每条房源一一对应。如果只需少量样本,可将 search_page() 中最多 20 个房源 URL 通过 zillow_diy.py 传递给 collect()。
如需限制每个搜索 URL 返回的记录数量(例如测试运行时),请将 {"input": [...], "limit_per_input": 50} 作为 JSON 正文发送。你也可以让 /trigger 将结果交付到 Webhook 或 S3无需轮询;每个快照可下载 30 天。
如果只需要价格、卧室数和地址等搜索结果字段,搜索页面爬虫会更快。使用带有 searchQueryState 的韦恩堡搜索 URL 时,它在 65 秒内返回了 1,154 条唯一房源。需要获取每条房源时,请使用发现功能。
获取非在售房屋的价格历史记录
对于待售房屋,房源爬虫的 priceHistory 在 4 条房源中的 4 条上都与 Zillow 自身页面一致。对于非在售房屋,请使用 Full Properties 爬虫。在 6 套非在售房屋中的 6 套上,它都在采用 snake_case 的 price_history 数组中返回了价格历史,每套房屋对应 1 条记录。
对于相同的 6 套房屋,价格历史爬虫按每个事件返回 1 行:37 秒内共返回 28 行。两种输出完全一致。
费用按交付的记录计算,因此一套包含 5 个事件的房屋在价格历史爬虫中会按 5 条记录计费,而在 Full Properties 中仅按 1 条计费。韦恩堡房源平均有 5 个事件,最多为 29 个。因此,请将非在售房屋 URL 发送到 Full Properties 爬虫,并读取 price_history而不是 priceHistory。如果需要每个事件各占 1 行,请使用价格历史爬虫。
从终端或 AI 智能体运行同一个爬虫
Bright Data CLI 可以将房源爬虫作为管道命令运行,适合一次性任务和编程智能体。使用 npm install -g @brightdata/cli 安装并运行一次 bdata login 后,一条命令即可返回一条房源:
bdata pipelines zillow_properties_listing \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
3 分钟内,它输出了与 API 相同的记录,采用单行 JSON,并以以下内容开头:
[{"zpid":77039629,"city":"South Bend","state":"IN","homeStatus":"FOR_SALE","address":{"city":"South Bend","streetAddress":"25875 Fox Tail Trl","zipcode":"46628","state":"IN"},"bedrooms":3,"bathrooms":2,"price":359000,"yearBuilt":1996,如果你的 AI 助手使用模型上下文协议(MCP)Bright Data MCP 服务器会将同一个爬虫公开为 web_data_zillow_properties_listing 工具。要使用该工具,请启用服务器的 business 工具组。每条记录都包含 timestamp因此你的智能体可以在引用价格前确认其时效性。
如需了解基于同一服务器构建的完整智能体,请参阅我们的使用 CrewAI 构建房地产 AI 智能体指南。
确保 Zillow 数据完整且为最新状态
在记录进入数据仓库之前,请将每次运行的结果与 Zillow 报告的总数进行比较。下面的检查还会标记错误行、重复房源和缺失的价格历史记录。随后可使用有变更房源的站点地图,缩小重复运行的范围。
验证每条记录
200 响应只能确认请求成功,并不能确认数据完整。下面的验证器保存为 validate.py它会分离错误行、删除重复房源,并标记曾经售出但没有价格历史记录的房屋。它还会将超过 24 小时前采集的记录视为过期,并将记录数与 Zillow 报告的总数进行比较:
"""Checks to run on Zillow records before they reach the warehouse."""
from datetime import datetime, timedelta, timezone


def validate(rows: list[dict], reported_total: int | None = None,
             max_age_h: int = 24) -> dict:
    errors = [r for r in rows if r.get("error_code") or r.get("error")]
    records, seen = [], set()
    for r in rows:
        if r in errors or r.get("zpid") in seen:
            continue
        seen.add(r.get("zpid"))
        records.append(r)
    # A home that sold before has price history, so missing history is a gap, not a fact.
    history_gaps = [r["url"] for r in records
                    if (r.get("lastSoldPrice") or r.get("dateSoldString"))
                    and not r.get("priceHistory")]
    cutoff = datetime.now(timezone.utc) - timedelta(hours=max_age_h)
    stale = [r["url"] for r in records
             if datetime.fromisoformat(r["timestamp"].replace("Z", "+00:00")) < cutoff]
    report = {"records": len(records), "error_rows": len(errors),
              "duplicates": len(rows) - len(errors) - len(records),
              "history_gaps": history_gaps, "stale": len(stale),
              "retry": [e.get("input", {}).get("url") for e in errors]}
    if reported_total:
        report["coverage"] = round(len(records) / reported_total, 3)
    return report
run_pipeline.py 脚本会对韦恩堡运行发现任务,然后验证数据行:
"""Discover every listing in one Zillow search, then validate the result."""
import json
import time

from validate import validate
from zillow_api import discover

start = time.time()
rows = discover("https://www.zillow.com/fort-wayne-in/")
report = validate(rows, reported_total=1295)  # Zillow's total, e.g. from search_page()
print(f"{len(rows)} rows in {round((time.time() - start) / 60, 1)} min")
counts = {k: (len(v) if isinstance(v, list) else v) for k, v in report.items()}
print(json.dumps(counts))
json.dump(rows, open("fort_wayne.json", "w"))
发现任务返回了 1,295 行,验证器将其中 1,270 行保留为记录:
1295 rows in 12.9 min
{"records": 1270, "error_rows": 25, "duplicates": 0, "history_gaps": 0, "stale": 0, "retry": 25, "coverage": 0.981}
在 Zillow 报告的 1,295 条房源中,覆盖率为 98.1%。此次运行没有重复项,也没有任何记录未通过价格历史检查。该检查只标记曾经售出的房屋,因此会忽略从未有过价格历史的房屋,例如新建住宅方案。
数据中缺少“已售”价格并不一定是抓取错误。在休斯敦的 8 条房源中,2 条“已售”事件都没有价格,这符合预期,因为得克萨斯州的成交价格不属于公开记录。
将价格历史检查所标记的所有 URL 发送到 Full Properties 爬虫,并重新提交 retry URL。对于仍然缺少完整记录的房源,搜索页面爬虫的结果包含价格、卧室数和地址。
仅刷新发生变化的房源
Zillow 的 robots.txt 为每种房源状态列出了一个站点地图索引。经纪人发布的待售房源索引中包含 latest.xml.gz 站点地图。此脚本 changed_listings.py 会通过网络解锁器 API 读取该地图,并保留印第安纳州的房源。运行前,请在控制面板中创建网络解锁器区域并将其名称填入脚本:
"""List recently changed Zillow listings in one state, from a sitemap linked from robots.txt."""
import gzip
import os
import re

import requests

SITEMAP = "https://www.zillow.com/xml/sitemaps/us/hdp/for-sale-by-agent/latest.xml.gz"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


def unlock(url: str, attempts: int = 2) -> bytes:
    # replace "web_unlocker" with the name of your Web Unlocker zone
    payload = {"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"}
    for _ in range(attempts):  # retry once on a transient error
        resp = requests.post("https://api.brightdata.com/request", headers=HEADERS,
                             json=payload, timeout=180)
        # Web Unlocker returns the target's own status code in this header
        if resp.headers.get("x-brd-status-code") == "200":
            return resp.content
    raise RuntimeError(f"{url}: {resp.headers.get('x-brd-status-code')} "
                       f"{resp.headers.get('x-brd-error')}")


body = unlock(SITEMAP)
# the file may arrive already decoded
xml = (gzip.decompress(body) if body[:2] == b"\x1f\x8b" else body).decode()
entries = re.findall(r"<loc>([^<]+)</loc>\s*<lastmod>([^<]+)</lastmod>", xml)
indiana = [(url, mod) for url, mod in entries if re.search(r"-IN-\d{5}/", url)]
dates = [mod for _, mod in entries]
print(f"{len(entries)} changed listings nationwide, {len(indiana)} in Indiana")
print("oldest change:", min(dates), "| newest:", max(dates))
print(indiana[0][0])
该文件列出了全美 50K 条有变更的房源,其中 1,014 条位于印第安纳州:
50000 changed listings nationwide, 1014 in Indiana
oldest change: 2026-09-24T14:08:00Z | newest: 2026-09-27T07:51:00Z
https://www.zillow.com/homedetails/600-W-Cyprus-Cir-Bloomington-IN-47403/94517948_zpid/
一个站点地图文件最多可列出 50K 个 URL,而这 50K 项变更覆盖了约 3 天。因此,每日运行时可以只重新采集你所在区域中自上次运行后发生变化的房源,从而降低成本。每次向 collect() 发送 20 个 URL,或通过一个 /trigger 任务发送全部 URL。该文件列出的是发生变化的房源,而不是 Zillow 上的每套房屋。
4 个待售索引中的站点地图列出了搜索页面爬虫发现的 1,154 条韦恩堡房源中的 749 条,占 65%。217 条新建房源中没有任何一条出现。使用站点地图确定要重新采集哪些房源,并使用发现功能查找现有房源。
每种方案在规模化运行时的成本
获取页面成本最低的方法,往往并不是获得完整数据集成本最低的方法。以下每种方案都能返回 Zillow 数据,但它们在完整性以及你仍需完成的工作量方面有所不同。价格为发布时的标价我们的定价页面提供当前价格:
| 方案 | 你的成本 | 结果 | 你仍需完成的工作 |
|---|---|---|---|
在自有 IP 上运行 curl_cffi |
服务器和代理流量 | 430 个页面中成功获取 429 个;搜索限制为 984 条房源;HTML 中通常没有价格历史记录 | 指纹更新、IP 信誉管理、搜索拆分、价格历史记录 |
| 网络解锁器 API | 每 1K 次成功请求 1.50 美元 | 10 个房源页面全部成功,中位耗时 4.5 秒 | 解析、搜索拆分、价格历史记录 |
| 浏览器 API | 每 GB 8 美元 | 每条房源 3.97 MB,约 0.03 美元;会渲染价格历史记录 | 浏览器脚本、解析 |
| Zillow 爬虫 API | 每 1K 条记录 1.50 美元 | 通过一个 URL 找到韦恩堡全部 1,295 条房源;可获取待售和非在售房屋的价格历史记录 | 验证 |
| Zillow 数据集 | 每 1K 条记录最高 2.50 美元,最低订单金额 250 美元 | 市场中有 137.42M 条房产记录,主要为非在售房屋 | 选择更新计划 |
网络解锁器仅对成功的请求收费,并会在 x-brd-status-code 标头中返回目标网站的状态码,因此请在代码中检查该标头。例如,请求不存在的房源时会返回 x-brd-status-code: 404。浏览器 API无需额外代码即可渲染价格历史表,适合需要完整浏览器会话的页面。
DIY 方案还存在表中价格无法体现的维护成本。一位每天为客户运行 Zillow 爬虫的开发者表示,每当 Zillow 推送更新时,该工具每季度都会发生故障。Zillow 的页面揭示了原因:每种房源类型都在 JSON 中使用各自的 GraphQL 操作名称,而旧教程中的卡片选择器(例如 article.list-card)无法匹配任何内容。
数据集的用途不同:Bright Data Zillow 房源数据集包含超过 137M 条房产记录。其中大多数是非在售房屋,适合估值模型以及需要所有房产而非仅待售房屋的研究。买家可以选择每日、每周、每月或自定义计划更新,而爬虫 API 则可按需采集当前房源。
请比较整个数据管道的成本,包括发现、房源详情、价格历史记录和重试,而不是仅比较获取单个页面的成本。我们的托管式与 DIY 网页爬虫指南估算了内部运行爬虫的完整成本。
总结
要获取 Zillow 页面,你需要使用具备浏览器 TLS 指纹的客户端。获取完整数据更加困难,因为每次搜索最多只能返回 984 条房源,而且大多数房源页面会通过第二个请求加载价格历史记录。对于不需要价格历史的小区域一次性任务curl_cffi 爬虫已足够。若要按计划获取每条房源及其价格历史记录,Bright Data Zillow 爬虫 API 可以为你处理这两项工作。
创建免费的 Bright Data 账户使用你所在市场的一个搜索 URL 运行发现任务,并将数据行数与 Zillow 报告的总数进行比较。
常见问题
可以从 Zillow 爬虫数据吗?
可以,前提是你的客户端使用浏览器的 TLS 指纹。Python requests 库会收到 HTTP 403,而模拟 Chrome 的 curl_cffi 则可以获取页面。房源字段位于每个页面嵌入的 JSON 中,因此解析器无需依赖 HTML 布局即可读取这些字段。
为什么 Zillow 不显示所有房源?
Zillow 会限制每次搜索。其分页显示 20 页,但网站实际会提供 24 页、每页 41 条房源,因此一次搜索最多可获取 984 条房源。将大区域拆分为更小的搜索,或使用 Bright Data Zillow 爬虫 API;后者通过一个 URL 找到了韦恩堡的全部 1,295 条房源。
如何获取 Zillow 价格历史数据?
使用 Bright Data Zillow 爬虫 API。其待售房源记录包含价格历史,而 Full Properties 爬虫可返回非在售房屋的价格历史。大多数房源页面会通过第二个请求加载价格历史,因此仅爬虫 HTML 的爬虫工具会遗漏这些数据。如需按邮政编码查看市场趋势Zillow Research 提供免费 CSV。
Zillow 是否提供开放 API?
不提供。Zillow Group 的 API涵盖 MLS 房源、公共记录和 Zestimate,但需要审批,会限制每日调用次数,并限制数据存储。Zillow Research 仅提供免费的市场级 CSV。对于房源级数据,Bright Data Zillow 爬虫 API 可将房源和价格历史作为结构化 JSON 返回。
如何免费爬虫 Zillow?
使用 curl_cffi这是一款可模拟 Chrome 的免费 Python HTTP 客户端。用它缓慢获取房源页面并解析嵌入的 JSON。此方法每次搜索最多只能获取 984 条房源,并且会遗漏大多数价格历史记录。新的 Bright Data 账户每月可获得 5K 免费额度,无需信用卡,足以获取 5K 条 Zillow 爬虫 API 记录。
如何在不编写代码的情况下爬虫 Zillow?
使用托管式爬虫工具的无代码控制面板。在 Bright Data 控制面板中打开 Zillow 爬虫 API,粘贴房源或搜索 URL,然后开始运行。之后可将记录下载为 JSON 或 CSV。对于整个市场,你也可以直接获取现成的 Zillow 数据集,无需自行抓取。
ChatGPT 可以进行网页爬虫吗?
ChatGPT 可以编写爬虫代码但它本身并不适合在没有其他工具的情况下大规模采集 Zillow 数据。AI 智能体可以调用 Bright Data MCP 服务器中的 Zillow 房源工具来获取结构化房源,然后处理返回的 JSON。在智能体引用价格前,请检查每条记录的时间戳。


技术写作者
 5 years experience
Satyam Tripathi 帮助 SaaS 和数据初创公司将复杂技术转化为可执行的内容,提升开发者采用度并增强用户理解。